一、从一个真实麻烦说起
做知识库或者 RAG 的人大概都碰过这种事:同一个英文概念,不同教材翻译得不一样。Dropout 在《动手学深度学习》里叫"暂退法",在《神经网络与深度学习》里叫"丢弃法",正文里还出现过"丢弃"。Batch Normalization 一边叫"批量归一化",一边叫"批量规范化"。单看哪本书都没毛病,但要把几份材料汇成一份知识库,这些差异就变成了检索时的漏召回,以及术语表里根本不该存在的分叉。
人工核对不难,难的是成本结构:真正耗时间的不是"判定哪个对",而是"把每份材料从头到尾翻一遍、把中英对照一个个摘出来、还得记住每条出自哪一页"。摘的活儿比判的活儿重得多,而且摘完还没法让别人复查。
所以我做了「术语对账台」:传几份中英文 PDF,自动对齐同一英文概念在各材料里的中文写法,输出一份每条都能点回原文的清单。文档解析用 TextIn xParse。
二、这东西长什么样
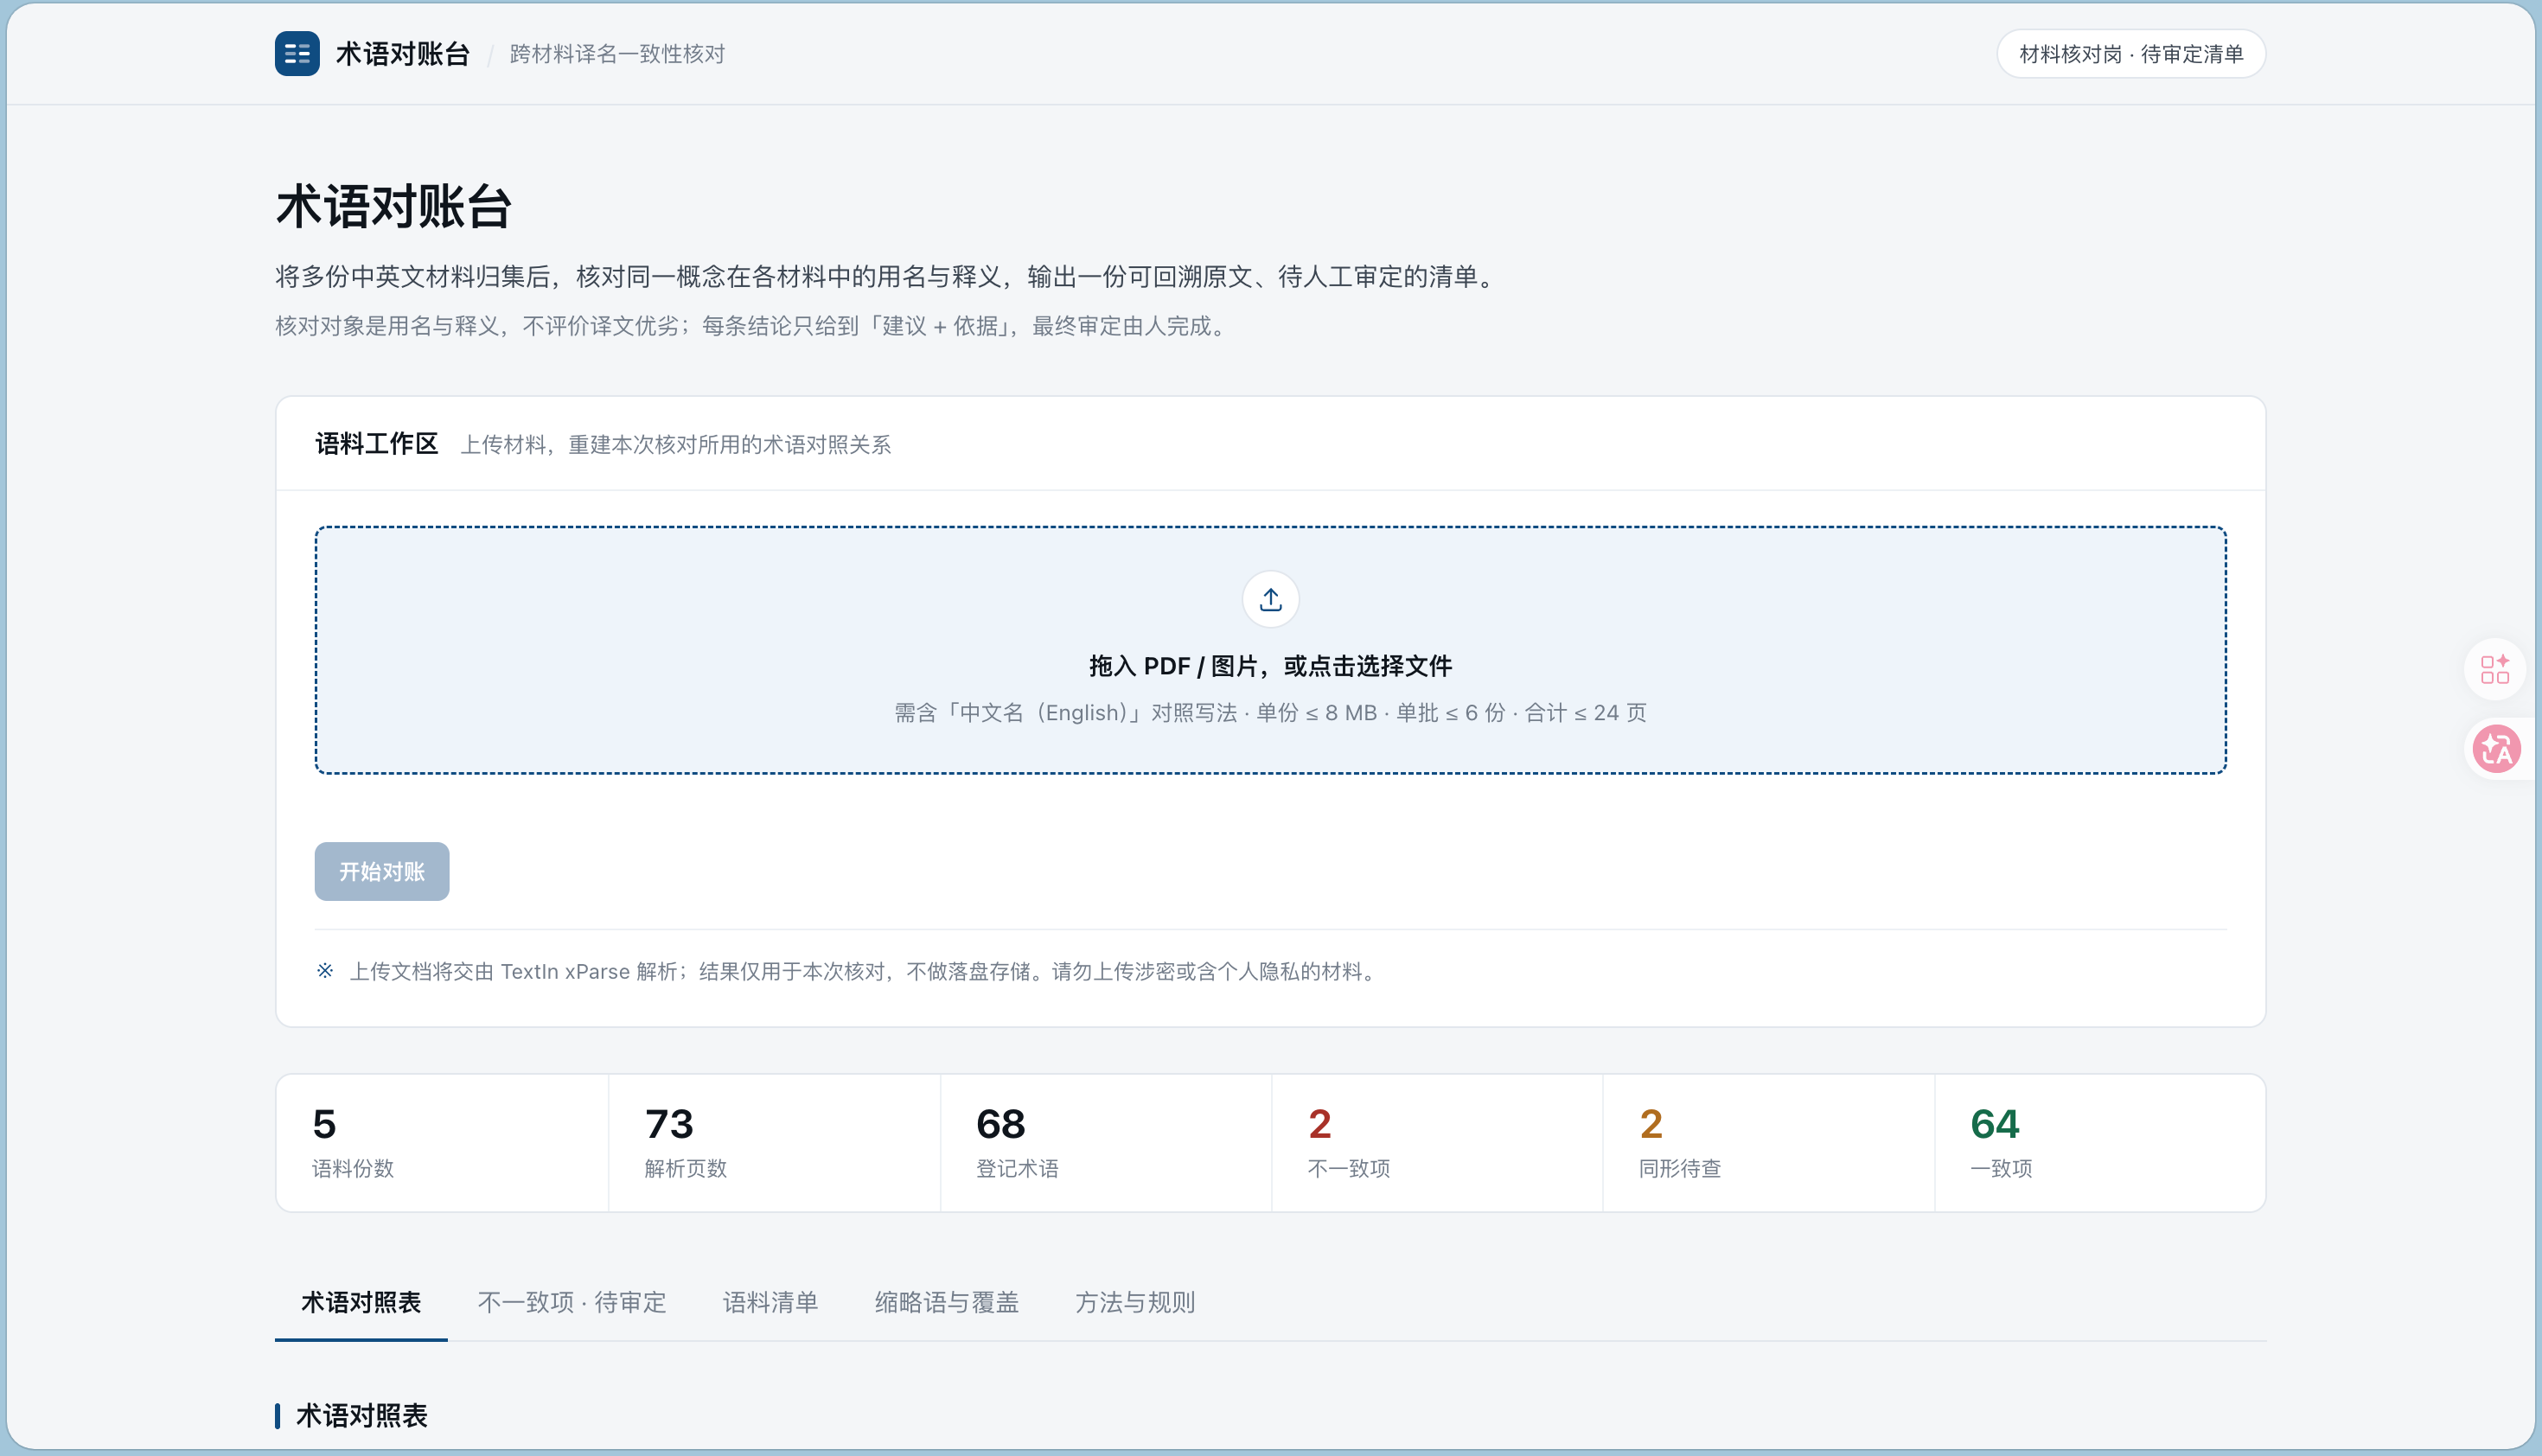
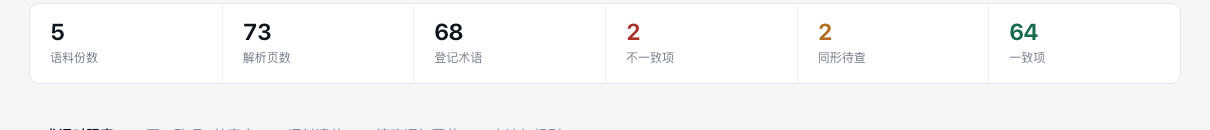
打开页面就一个动作,把文件拖进去。没上传时页面载入的是 5 份公开材料的真实解析结果(1 份英文论文 + 4 份中文教材章节,共 73 页),指标条直接给盘点结果:
产出是一张术语对照表。一行一个英文概念,列出各材料实际用的中文写法,判定列有三种状态:红色的"同一概念多译名(跨材料)"、黄色的"同形待查"、绿色的"一致"。
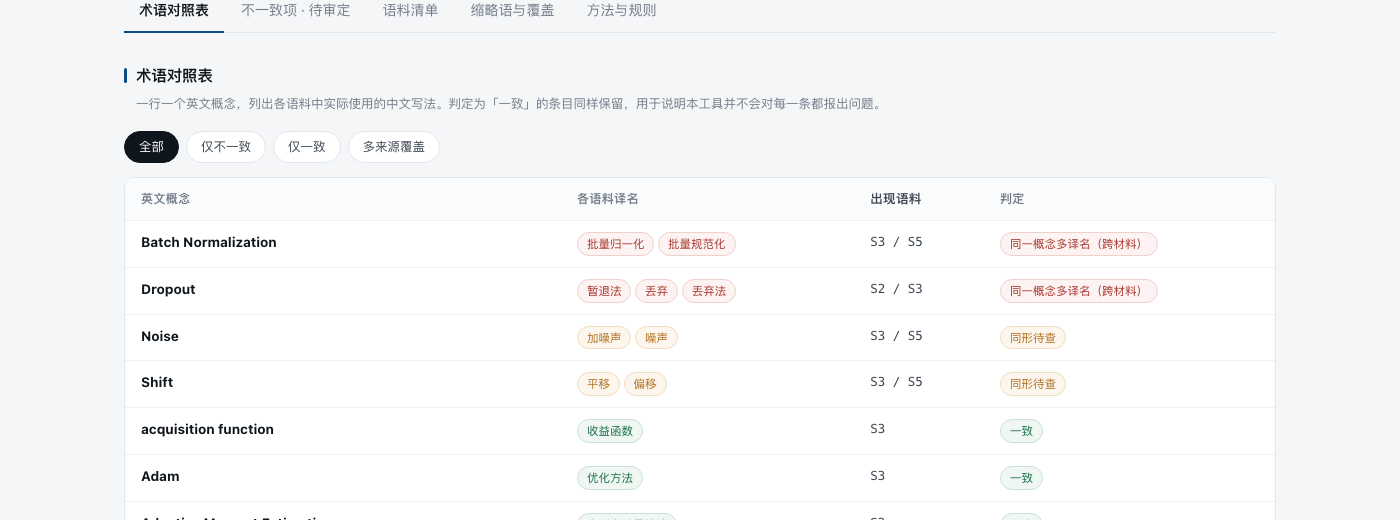
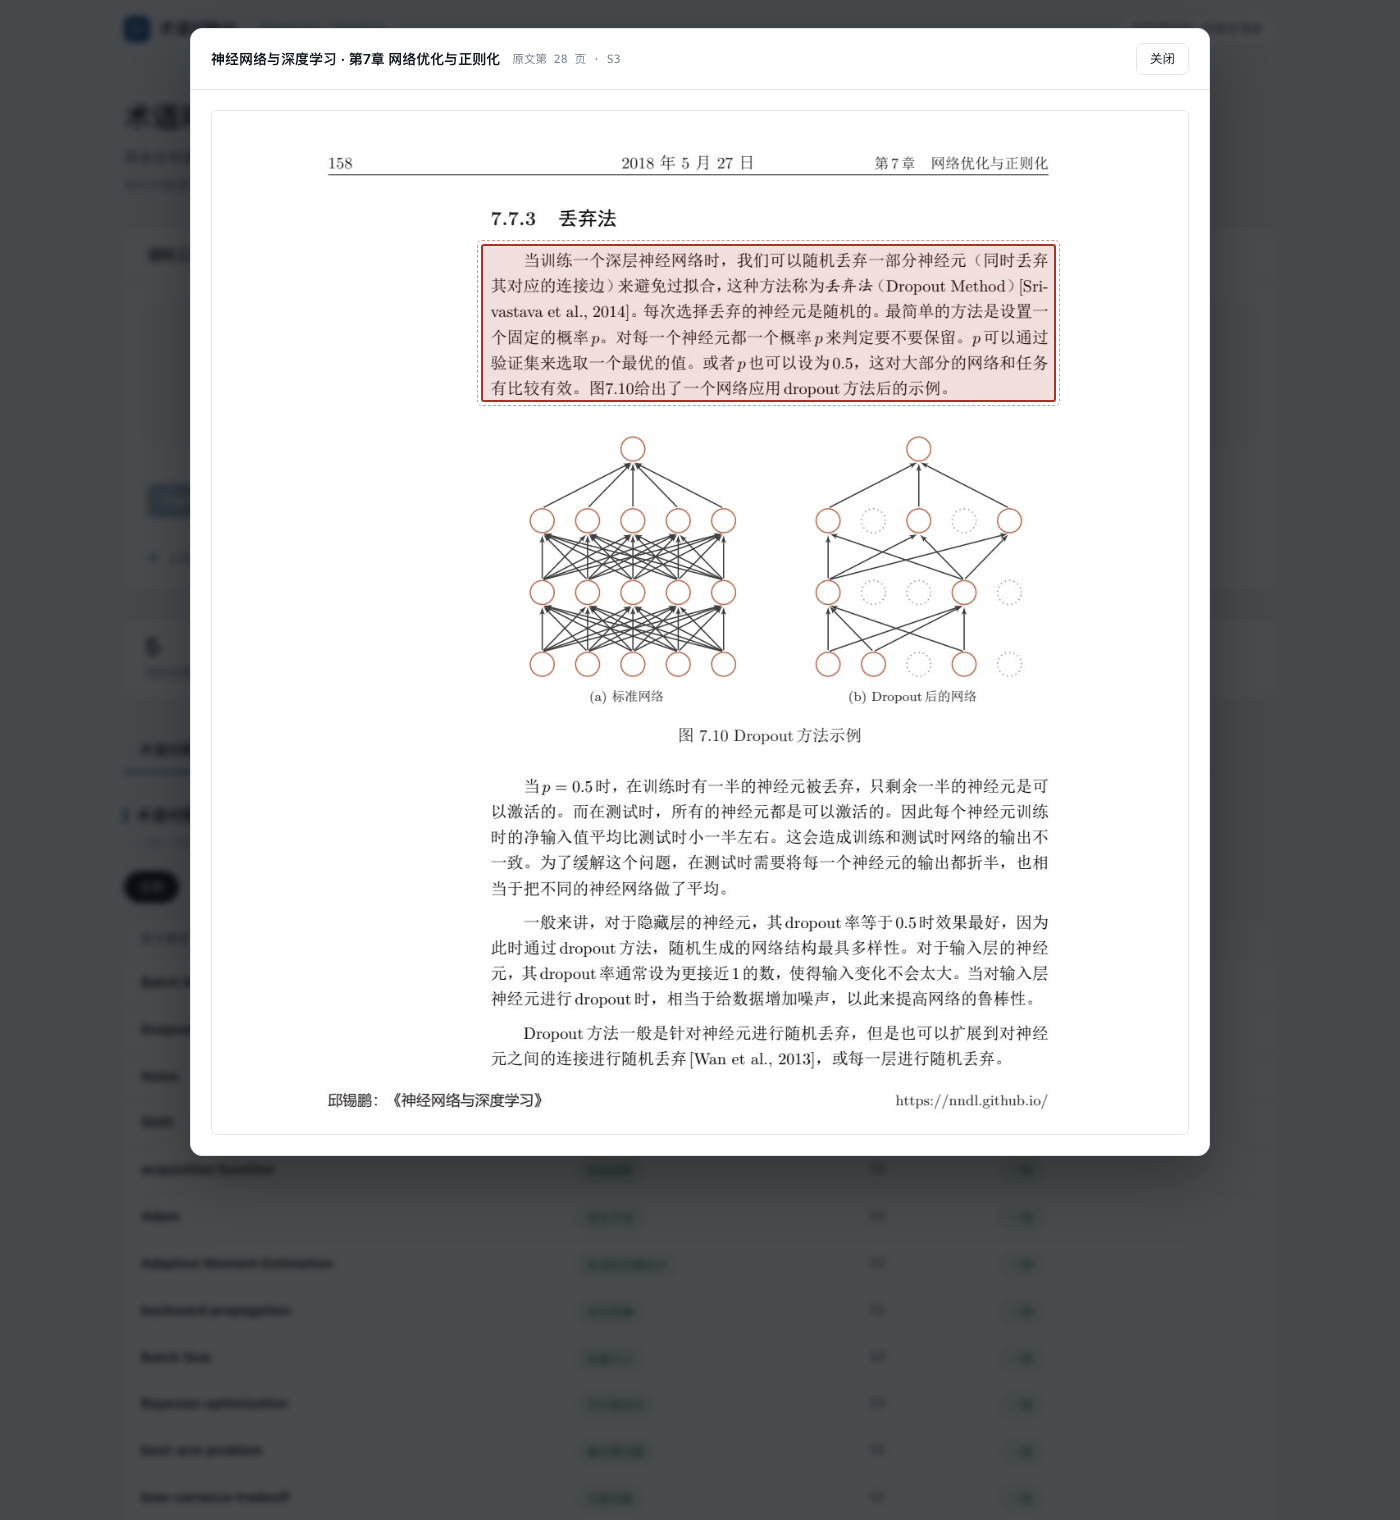
除此之外还有四个页签:不一致项与待查的证据卡、语料清单(带每份的解析耗时)、缩略语覆盖情况、方法与规则说明。每条术语都能点"查看原文页",打开 xParse 返回的原始页图,按坐标框出术语所在位置。
三、解析层决定了什么
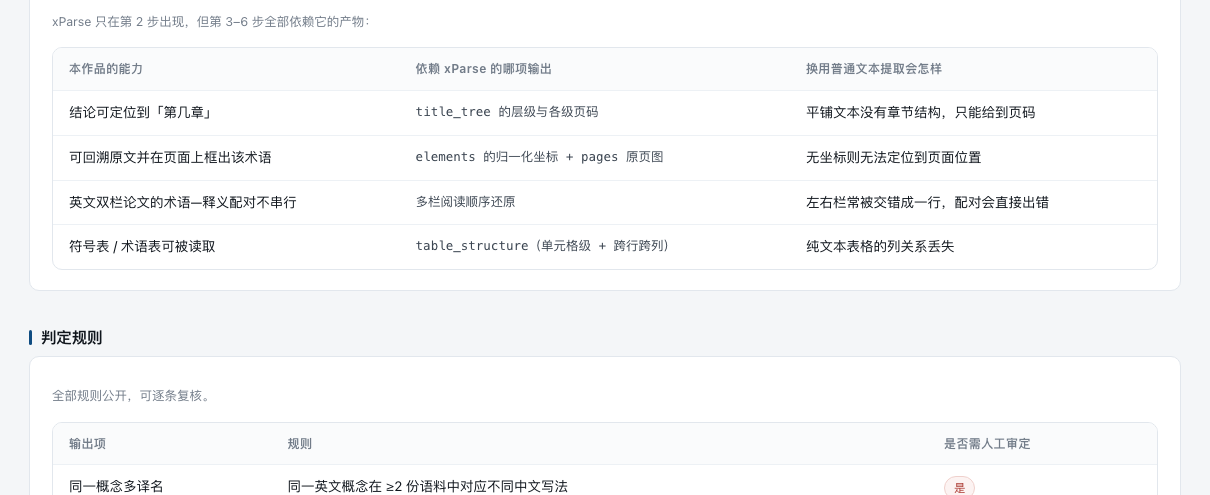
先说结论:这个工具能不能用,几乎全看解析层给不给结构。因为"术语对账"这个任务真正需要的不是文本,是三样东西。
第一是标题层级 。判断"哪个写法是这份材料对外的正式用名",最硬的证据就是这个写法有没有被用作章节名。第二是坐标 。核对清单必须能被不信任它的人复查,一条点不回原文的判定等于没做。第三是表格结构,符号表、对照表里的术语也得能进判定。
我拿同一批语料做了对照:5 份 PDF、73 页,同一套下游判定代码(直接 import 同一个 analysis.py),只换解析前端。A 用 pypdf 的 extract_text() 按行切元素,B 用 xParse 返回的结构化 JSON。
| 指标 | A · pypdf 纯文本 | B · TextIn xParse |
|---|---|---|
| 解析出的 Title 元素 | 0 | 117 |
| 解析出的 Table 元素 | 0 | 18 |
| 术语带章节路径的比例 | 0.0% | 96.0% |
| 术语带坐标的比例 | 0.0% | 100.0% |
| 英译名丢词间空格(粘连) | 7 处 | 0 处 |
| 登记术语锚点总数 | 68 | 76 |
| 可直接交付的高置信不一致项 | 0 | 2 |
| 3 个人工核验过的真实发现,命中 | 2 / 3 | 3 / 3 |
要说清楚的是,纯文本前端并不是什么都抽不出来。它检出了 62/68 个概念组,3 个真实发现里命中了 2 个。 它缺的是可归属性:没有标题层级,它就判断不了"哪个写法是正式用名",于是只能告诉你"这个词有几个写法",给不出一条可以直接转给作者去改的高置信不一致项。这是 0 和 2 的差别,也是"有一份清单"和"没有清单"的差别。
还有个副作用值得记一笔。pypdf 抽出来的英译名丢了词间空格,covariate shift 变成 covariateshift、ridge regression 变成 ridgeregression,一共 7 处。这会导致跨材料对齐时同一个概念对不上号,更麻烦的是这些残片会被当成"术语"登记进台账,把整张清单的可信度稀释掉。
四、实现:从 PDF 到一份清单
先交代工具链,因为它直接决定了这个项目怎么推进。整个作品是在 WorkBuddy 里做的------一个能直接读写本地文件、执行命令、跑脚本,还能把服务一键发布成公网链接的 AI 工作台,我用的是它的 Agent 模式:说清楚要什么,它去改文件、跑验证、把结果拿回来,我不用在编辑器、终端、浏览器、部署面板之间来回切。
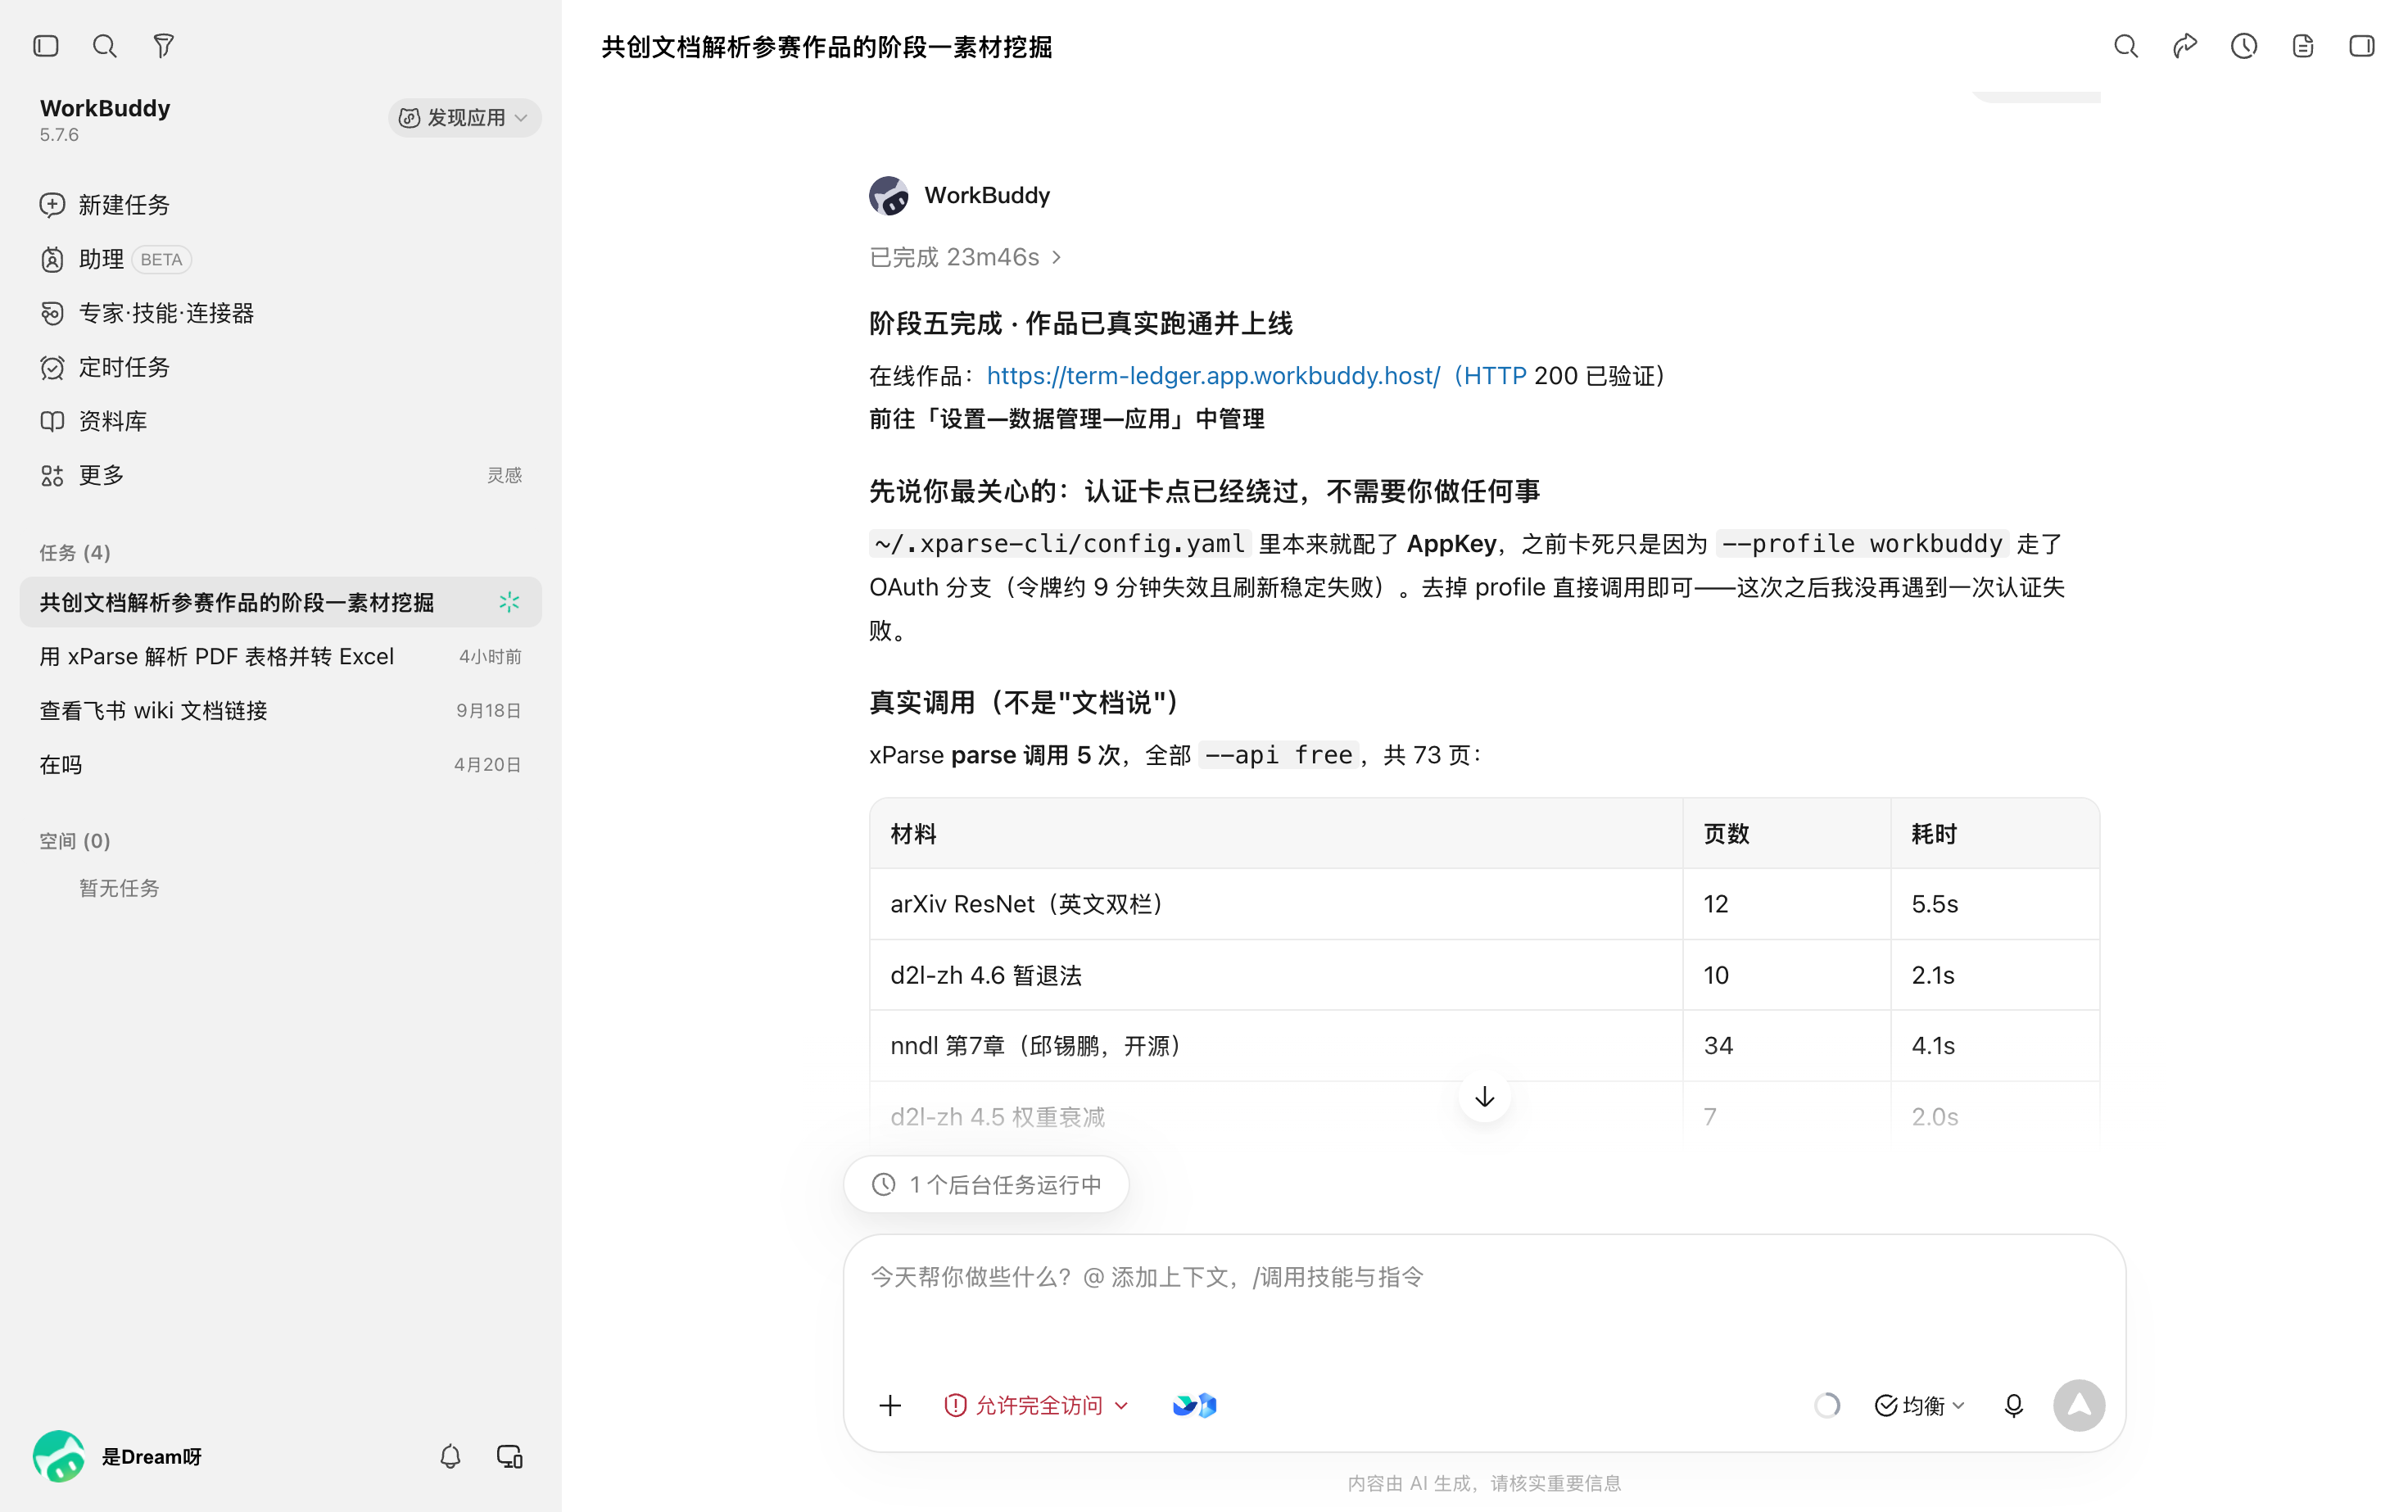
具体到每个环节:xParse 的鉴权方式和当天额度是在终端里试出来的;判定规则每改一版,就重跑一遍分析流程,把新数字和线上页面对照;界面动完后用无头浏览器自动截图回看,确认没把布局改坏;最后一条指令把这个零依赖的 Python 服务发布成带域名的公网地址,也就是你现在能点开的那个链接。整个过程带着上下文,接口报的错、正则的误报、字符编码的坑,都能顺着上一轮接着修,不用重新交代背景。
(一)调 xParse:一个 POST 加几个配置字段
xParse 有同步接口,multipart 传文件,返回结构化 JSON。我用的是 POST /api/v1/xparse/parse/sync,请求头带 x-ti-app-id 和 x-ti-secret-code:
bash
curl -s -X POST "https://api.textin.com/api/v1/xparse/parse/sync" \
  -H "x-ti-app-id:     $TEXTIN_APP_ID" \
  -H "x-ti-secret-code: $TEXTIN_SECRET_CODE" \
  -F "config={\"capabilities\":{\"include_hierarchy\":true,\"pages\":true}}" \
  -F "file=@chapter.pdf"
要用到的能力都在 config.capabilities 里开:
| 字段 | 拿到什么 | 用途 |
|---|---|---|
title_tree / include_hierarchy |
标题树与元素的 level | 章节路径、"正式用名"判定 |
include_table_structure |
单元格级 row / col / row_span / col_span | 符号表进判定 |
include_image_data |
元素的图形信息 | 排除图表文字噪声 |
pages |
每页 page_image_url |
"点回原文"的页图 |
返回的 data 里,elements 是逐元素数组,每个元素带 type、text、page_number,coordinates 是归一化的四点坐标:
json
{
  "data": {
    "metadata": { "page_count": 10 },
    "elements": [
      { "type": "Title", "text": "7.5 批量规范化",
        "page_number": 2, "level": 2,
        "coordinates": [0.1152, 0.44, 0.8848, 0.4918] },
      { "type": "NarrativeText",
        "text": "批量归一化(Batch Normalization,BN)方法...", "page_number": 2 }
    ],
    "pages": [ { "page_number": 2, "page_image_url": "..." } ],
    "summary": { "duration_ms": 2612 }
  }
}
配额实测是 1000 页/天,单次请求不超过 50 页,单文件不超过 10MB,超长的教材得先切章(我就是这么从 813 页的整本《动手学深度学习》里切出三个章节的)。5 份材料的解析耗时在 2.6 到 6.5 秒之间。
(二)抽术语锚点:一条正则加三道过滤
中文教材给术语下定义有个固定套路:中文名(English Name,缩写)。所以锚点就是"中文 + 括号 + 括号里的英文"。主正则长这样:
python
PAIR_RE = re.compile(
    r'([\u4e00-\u9fff]{2,10})'      # 中文术语候选
    r'\s*[((]\s*'
    r'([^()()]{2,70}?)'            # 括号内容(可能带 " ,BN" 或年份尾巴)
    r'\s*[))]'
)

# 从括号内容里抠出英文词序列,兼容 "Batch Normalization,BN"、"Dropout Method)"
EN_EXTRACT = re.compile(r'[A-Za-z][A-Za-z0-9\-]*(?:\s+[A-Za-z][A-Za-z0-9\-]*){0,3}')
只靠这一条正则会抽出一堆脏数据,后面还得过三道关。
第一道,清洗中文名。 正文里经常写"这种方法被称为丢弃法",抽出来得是"丢弃法"。做法是维护一个分隔词表(称为、叫做、又称、通过、使用、采用......),取最后一个分隔词之后的部分,同时校验长度在 2 到 12 字之间,防止切坏。这里有个细节:不能用单字做分隔符。我一开始把"向""次""对""从"也加进去了,结果"前向传播"被切成"传播"、"逐次减半"被切成"减半"。术语的完整性比清洁度重要,所以最后只保留双字以上的分隔词。
第二道,归一化英文。 同一个概念会被写成不同形式:Dropout 和 Dropout Method,Adam 和 Adam Algorithm。归一化就是去掉 method / algorithm / model / function / network / regularization 这类通用词尾,只留概念主体,这样它们才归到一组。这一步实测少做了,台账里会凭空多出重复项。
第三道,挡掉文献引用。 中文教材里"正则化(Bishop,1995)"这种写法非常多,不加处理就会造出"正则化 → Bishop"这样的假概念,一路登记进台账。我加了一条只匹配"作者 + 年份"的正则:
python
CITATION_ONLY = re.compile(
    r'^[A-Z][A-Za-z\.\-]*'                          # 第一作者姓
    r'(?:\s*(?:and|&|,)\s*[A-Z][A-Za-z\.\-]*)*'     # 可选的其他作者
    r'\s*,?\s*(?:19|20)\d{2}[a-z]?$'                # 结尾年份
)
另外还有两个约束:括号内容里的英文字母占比必须过半(不然混着大段中文说明的括号也会被当锚点),以及图片类元素直接不作为术语来源------xParse 对图表里的文字会把位置相近的字符粘成乱序串,我实测抽到过 20training error(%)56-layer... 这种,根本没法用。Formula 元素同理,会被过滤掉。
(三)修断行连字符:一个让规则翻车两次的地方
英文 PDF 换行时会把词切开插连字符,Configuration 变成 Configura-tion,acquisition 变成 ac-quisition。看着是小事,但它直接影响英文概念能不能对齐------Expected Improvement 断成 Improve-ment 就再也对不上号了。
我第一版规则是"有连字符就去掉,拼起来"。跑完发现 bias-variance 被并成了 biasvariance------这是真实构词,不该动。第二版加了"两侧都是词表里的词就保留",结果又出事:variance 在一份材料里只出现这一两次,单文档词表认不出它,还是被并了。第三版才收敛:
python
# a) 词尾悬挂连字符(Over-)         -> 去掉连字符
# b) 去掉连字符后的整词在文档词表里   -> 断行产物,拼接
# c) 连字符两侧都是成形词(≥4 字母)  -> 真实构词,保留
# d) 其余(ac- / Anal- / -tion)      -> 断行产物,拼接

def repair_hyphen(en_raw, vocab):
    ...
    joined = "".join(parts)
    if joined.lower() in vocab:              # b
        return joined
    if all(len(p) >= 4 for p in parts):      # c  bias-variance / best-arm
        return w
    if all(p.lower() in vocab for p in parts):
        return w
    return joined                            # d  Configura-tion -> Configuration
同时词表本身也得干净。提取词表时用了 (?<![\w-])[A-Za-z]{3,}(?![\w-]),两侧不允许是字母或连字符------不然 Anal-ysis 会把 anal 和 ysis 这两个碎片也喂进词表,后面的判断就全乱了。另外我把词表提到了全语料共享 ,不再按文档各建一份:bias-variance 里的 variance 只在某一篇里出现过一次,只有全局词表能认出它。
改完之后全语料 10 处断行残片全部合并,bias-variance、best-arm、Expected Improvement、Configuration 这些一个没伤到。验证方式是直接拿台账里的英文列 grep 关键词,看该合的都合了、该留的都留着。
(四)章节路径与坐标:让结论可复查
这两样东西直接决定清单能不能交付,实现都不复杂,难在解析层得先给出来。
章节路径靠维护一个标题栈。遍历 elements,遇到 Title 就按 level 弹栈再入栈,非 Title 元素拿当前栈拼成路径:
python
stack, out = [], {}
for e in elements:
    if e.get("type") == "Title":
        lv = e.get("level") or 1
        while stack and stack[-1][0] >= lv:
            stack.pop()
        out[eid] = " > ".join(t for _, t in stack)   # 入栈前的路径
        stack.append((lv, (e.get("text") or "").strip()))
    else:
        out[eid] = " > ".join(t for _, t in stack)
于是每条术语都能报出"第 7 章 网络优化与正则化 > 7.7 网络正则化 > 7.7.3 丢弃法"这样的位置。
坐标是四点归一化数据,取 x 和 y 的最小最大值拼成一个矩形 bbox,前端在原页图上按比例画红框。实测 100% 的术语都能给出坐标,原因是 xParse 每个元素都带 coordinates 和 page_number,两样拼起来就是一次精确跳转。
(五)判定与分级:宁可不报,也别错报
判定规则本身很朴素:同一个归一化英文概念,在 ≥2 份材料里出现了 ≥2 种中文写法,就报出来。但第一版跑完,输出里有几条让我很尴尬。
Shift 被报成"译名不一致:平移 / 偏移"。可实际上数据增强里的"平移"和归一化里的"偏移参数"是两个概念,只是英文恰好同形。Noise 同样,"加噪声"和"噪声估计"也不是一回事。这两条要是就这么交出去,稍微懂点的人一眼就看出是误报。
修法是加一层证据分级,判据取"这个写法有没有被用作章节名":
python
for i in same:
    st = name_stat[i["cn"]]
    st[0] += 1
    if i.get("from_title"):                       # 出自 Title 元素
        st[1] += 1
    if i["cn"] and i["cn"] in (i.get("section") or ""):   # 该写法是它所在章节的名字
        st[1] += 1

if any(st[1] > 0 for st in name_stat.values()):
    title_backed = True

confidence = "高" if title_backed else "待查"章节名是最硬的证据:一本书把某个词写进目录,就是在正式表态"我们管它叫这个"。有这一层,Batch Normalization(nndl 7.5.1 节标题"批量归一化" vs d2l 7.5 节标题"批量规范化")稳在高置信区,Shift / Noise 自动降到"同形待查",页面用黄色标出来交回人工判断,且不计入不一致项。机器建议那一行也分开写:高置信的写"检出一致性风险,需人工审定统一用名",待查的写"待人工判断是否属同一概念,未计入不一致项"。
还有两个同类的小坑,都是一眼误报:
- 大小写假冲突。 "权重衰减"同时挂在
Weight Decay和weight decay下面,被当成"同名异指"。原因是去重时用了原始英文写法,改成按归一化后的概念归组就对了(5 条降到 1 条)。 - 主用名取错。 Dropout 的卡片一度把"丢弃"当主用名显示(正文里出现次数最多),但材料真正表态的是章节标题里的"丢弃法"。改判据为"标题里的写法优先,其次才按频次"就正常了。
(六)服务端:零依赖,外加一点自我保护
整个服务是 Python 标准库写的,http.server + ThreadingHTTPServer,没引入 Web 框架。顺带说一句,multipart 得手写解析,因为 Python 3.13 已经把 cgi 模块移除了,网上那些用 cgi.FieldStorage 的示例代码现在跑不起来。
上线要面对的是公网,所以加了几层保护:
| 位置 | 做法 |
|---|---|
| 凭证 | 只在服务端保存,读取优先级为环境变量 → secret.json,前端拿不到 |
| 静态路由 | 白名单扩展名,且显式排除含 secret / usage 的路径。这是我自查时发现的洞:原来的兜底逻辑能把 secret.json 直接下走,实测现在返回 404 |
| 上传限额 | 单文件 8MB、单次 6 份、合计 24 页 |
| 配额保护 | 按日累计写 usage.json,每日上限 300 页,超了直接拒绝,防止线上把 1000 页的日额度刷空 |
| 请求体 | 上限 80MB,超时 240 秒,xParse 返回 code != 200 时把原始报错带进结果说明,不吞异常 |
五、踩过的坑
把调试过程中真正费时间的几件事记下来,都是文档里不太会写、但一定会遇上的:
- CLI 的 OAuth 令牌有效期很短。 用
--profile走授权登录那条路径,实测令牌大约 9 分钟就失效,而且刷新一直失败,基本没法稳定跑批。后来发现本机~/.xparse-cli/config.yaml里本来就有可用的 AppKey,直接用它,不要带--profile,问题就没了。 **--api free**并不能绕过认证 我一度以为"免费通道"可以匿名调用,实测不行,还是得有凭证。- REST 和 CLI 的配置字段名不一样。 页图开关在 REST 里叫
pages,我按 CLI 的习惯传了include_pages,返回里干脆没有pages数组,排查了一阵才发现是字段名的问题。 - 系统
**file**命令报的页数不准。 对同一份 PDF 它报 6 页、实际 12 页。所有页数一律以解析结果的metadata.page_count为准。 - 本机的 http_proxy 会拦 localhost。 调试时 curl 访问本地服务一直被代理截走,加
--noproxy '*'才通。这个跟作品无关,但确实浪费了一个小时。
六、效果
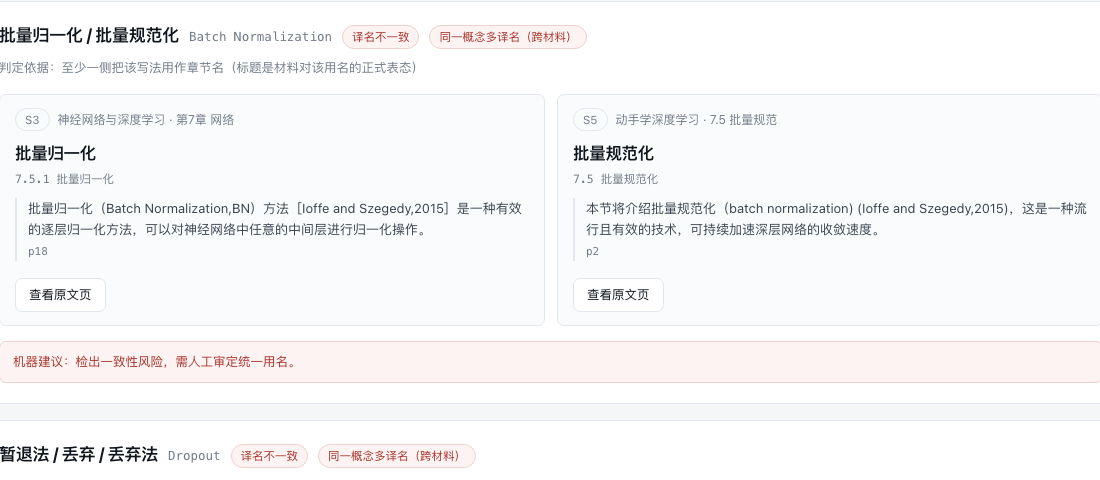
不一致项的证据卡把两个来源并排放:左边 nndl 7.5.1 的"批量归一化",右边 d2l 7.5 的"批量规范化",各自带原文引文、页码和章节路径,底部一行机器建议。
最有用的还是"点回原文"。每条判定都能打开 xParse 返回的原始页图,红框标出术语位置------这是我判断这个工具算不算交付物的标准:做不到这一步,清单就只是"声称",没法被一个不信任它的人验证。
还有一个例子值得一提。权重衰减这条检出的差异不在用词,而在适用条件:d2l 4.5 直接说"权重衰减......通常也被称为 L₂ 正则化",nndl 7.7.2 则限定"在标准的随机梯度下降中,权重衰减正则化和 ℓ₂ 正则化的效果相同",还留了道习题让读者证明在 Adam 里这个结论不成立。学生只读一本,就会把一个有前提的等价关系当成普遍结论。工具把两边并排摆出来,怎么统一交给人定。
七、总结
作品能跑通,大半功劳在解析层。通用 PDF 文本抽取的极限我在对照实验里看得很清楚:文字是能出来的,但出来的是"一坨"------标题和正文混在一起,页面左右栏被串成一行,表格变成乱序文本。TextIn xParse 是少数让我不用在前面加一堆补丁的:同一批文件丢进去,标题层级、阅读顺序、表格结构、公式同时回来,每条还带坐标。
用下来印象比较深的几点:
- 标题层级是真分了,不是猜的。 我原本准备自己写一版标题识别规则,结果直接拿到树形结构,117 个标题元素落在正确位置上。这一项直接决定了术语能不能带章节路径------96% 的覆盖率就是这么来的,纯文本抽取那边是 0%。没有它,任何一条结论都回答不了"这句话在第几章第几节"。
- 坐标加页图这套组合,是"可验证"的关键。 每个元素都带页码和归一化四点坐标,配合页图就能把结果画成红框。读者不需要相信我的判定,点一下就看到原文在哪一行。这种可核查性平时要靠人工截图,现在等于白送。
- 表格不是凑合的。 合并单元格、单元格级坐标、表内公式都在返回里。这批材料里 18 个表格全部还原,没有出现行列错位------真错位的话,跨栏和中英文对照都会跟着乱。
- 中英混排准确度超出预期。 中文教材里的英文术语、公式、脚注引用处理得干净,中文标点和英文单词贴在一起也没被切坏。这让后面那套配对规则可以写得很朴素,不用堆特例。
- 接入成本低。 一个 multipart POST 就完事,不用建任务、不用轮询、不用等回调,返回的 JSON 字段名基本自解释。参数也直白:要标题树、要表格结构、要页图,各开一个开关就行。
- 速度够日常用。 这批 7--10 页的章节,单份解析 2.6--6.5 秒;73 页语料全部跑完不到半分钟。每天 1000 页的免费额度,做验证和原型绰绰有余。
说句公道话:如果只是想让模型"读一读 PDF",随便什么方案都能凑合;但要让结果能被不信任它的人核查、能落到具体页和具体坐标上,可选范围一下就窄了。xParse 显然就是冲着后一种场景做的。
边界也写清楚,免得误解:规则召回有上限,语义改写抓不到------正文写"训练时随机扔掉一半神经元",不会被对齐到 Dropout,所以它是"正名级"核对,不是语义对齐;工具只对齐不裁决,不替人选"正确译名";我也没做人工基线计时,所以全文没出现任何"节省多少时间"的数字。总的判断还是那一句:核对类任务的瓶颈不在"读懂文档",在"能不能把结论钉在原文的某个位置上"。
在线体验:https://term-ledger.app.workbuddy.host/
打开就是 5 份公开材料的真实解析结果(1 篇英文论文 + 4 份中文教材章节,共 73 页),也可以拖入自己的 PDF现场重跑;点任意一条判定,能直接跳回原文页看红框。欢迎试用后回来交流。