文章目录
- [1. LangChain 简介](#1. LangChain 简介)
- [2. 环境搭建](#2. 环境搭建)
- [3. RAG 介绍](#3. RAG 介绍)
- [4. 向量基础概念](#4. 向量基础概念)
- [5. Langchain 调用大语言模型](#5. Langchain 调用大语言模型)
- [6. Langchain 调用流式输出](#6. Langchain 调用流式输出)
- [7. Langchain 调用聊天模型](#7. Langchain 调用聊天模型)
- [8. Langchain 调用消息的简写形式](#8. Langchain 调用消息的简写形式)
- [9. Langchain 调用嵌入式模型](#9. Langchain 调用嵌入式模型)
- [10. 提示词通用模板](#10. 提示词通用模板)
- [11. FewShot 提示词模板](#11. FewShot 提示词模板)
- [12. 模板类的 format 和 invoke](#12. 模板类的 format 和 invoke)
- [13. ChatPromptTemplate 的使用](#13. ChatPromptTemplate 的使用)
- [14. Chain 链的使用](#14. Chain 链的使用)
前置介绍:避免老年人跟不上时代,也是时候开始学习 agent 相关的知识,还是经典的黑马程序员教程开始学习。
1. LangChain 简介
用豆包介绍了下,LangChain 是 2022 年 10 月推出的开源大模型应用开发框架(Python/JS/Java),核心定位是:把 LLM 和外部世界连接起来,用 "组件 + 链" 的方式快速搭建复杂 AI 应用。
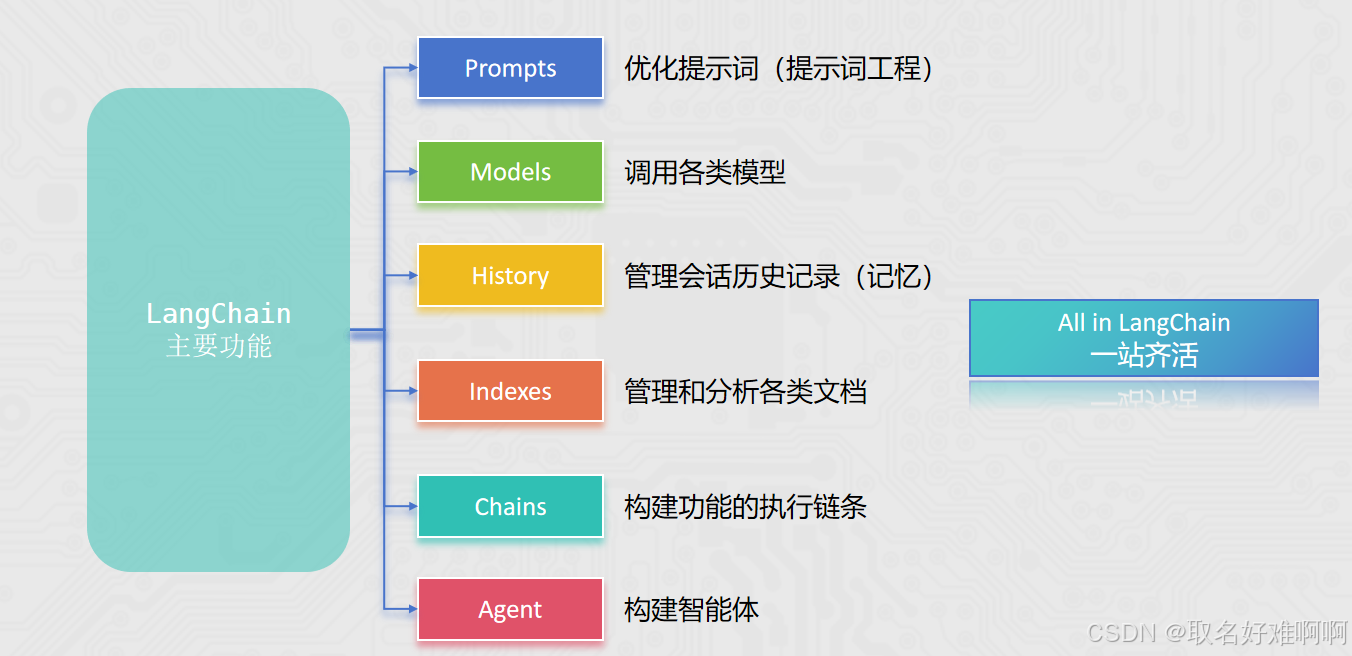
官网地址如下:LangChain 中文文档。
2. 环境搭建
Langchain 本质上也是 python 组件,所以用 pip 命令下载,我用的是下面的命令:
py
pip install langchain==1.2.1 langchain-community==0.4.1 langchain-ollama==1.0.1 langchain-chroma==1.1.0 dashscope==1.25.6 chromadb==1.4.0 bs4 -i https://mirrors.aliyun.com/pypi/simple/3. RAG 介绍
RAG 全称 Retrieval-Augmented Generation,检索增强生成,结合文档检索 + 大模型生成的 AI 问答技术。
LLM 大模型在使用的时候会存在下面一些问题:
- LLM 的知识不是实时的,模型训练好了之后不具备自动更新知识的能力,比如最新的天气情况。
- LLM 领域的知识也是有限的,大模型训练的知识来自于训练数据,这些数据一般不会涉及到私密的专业内部知识,都是互联网公开的和开源的数据集。
- 幻觉问题,LLM 有时候会在回答中生成看似合理但是实际上是错误的信息,RAG 可以加入我们加入的最新检索资料,减少大模型胡编乱造的概率。
- 数据安全问题。
用户和 LLM 的交互工作流如下。
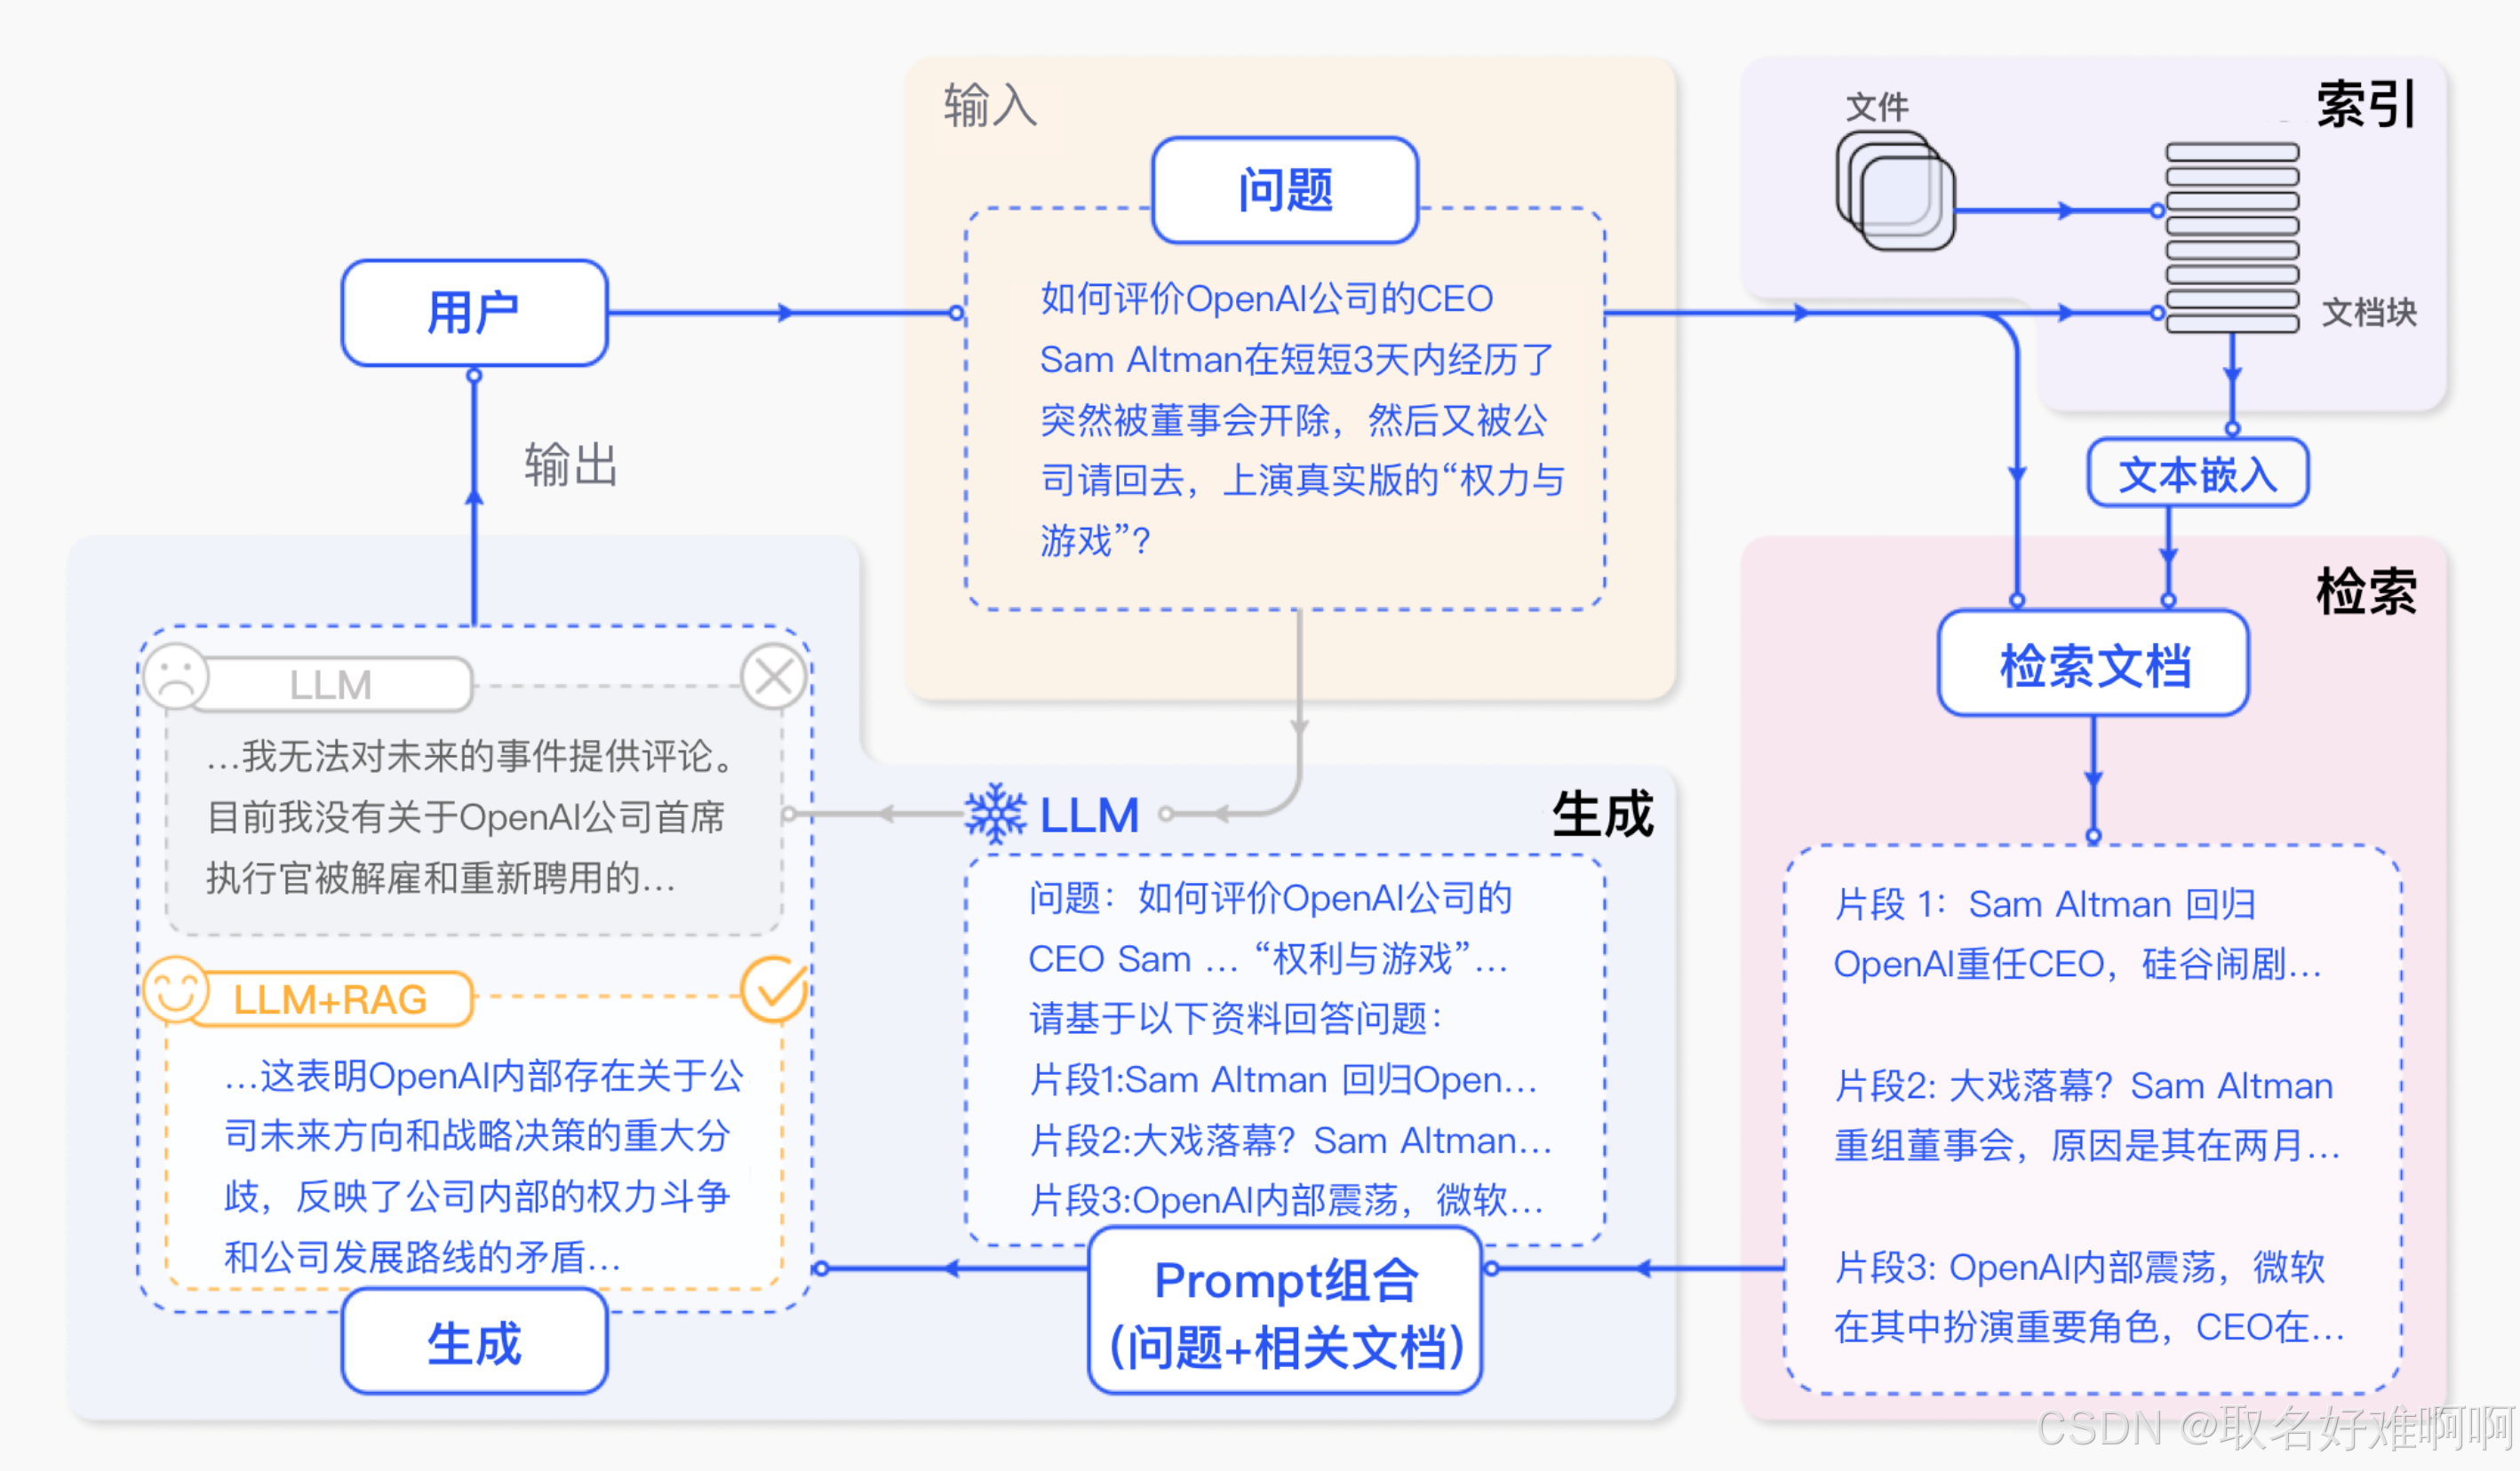
里面文件的维护就是实时维护的,RAG 就是负责维护这部分实时的数据,标准流程就是:
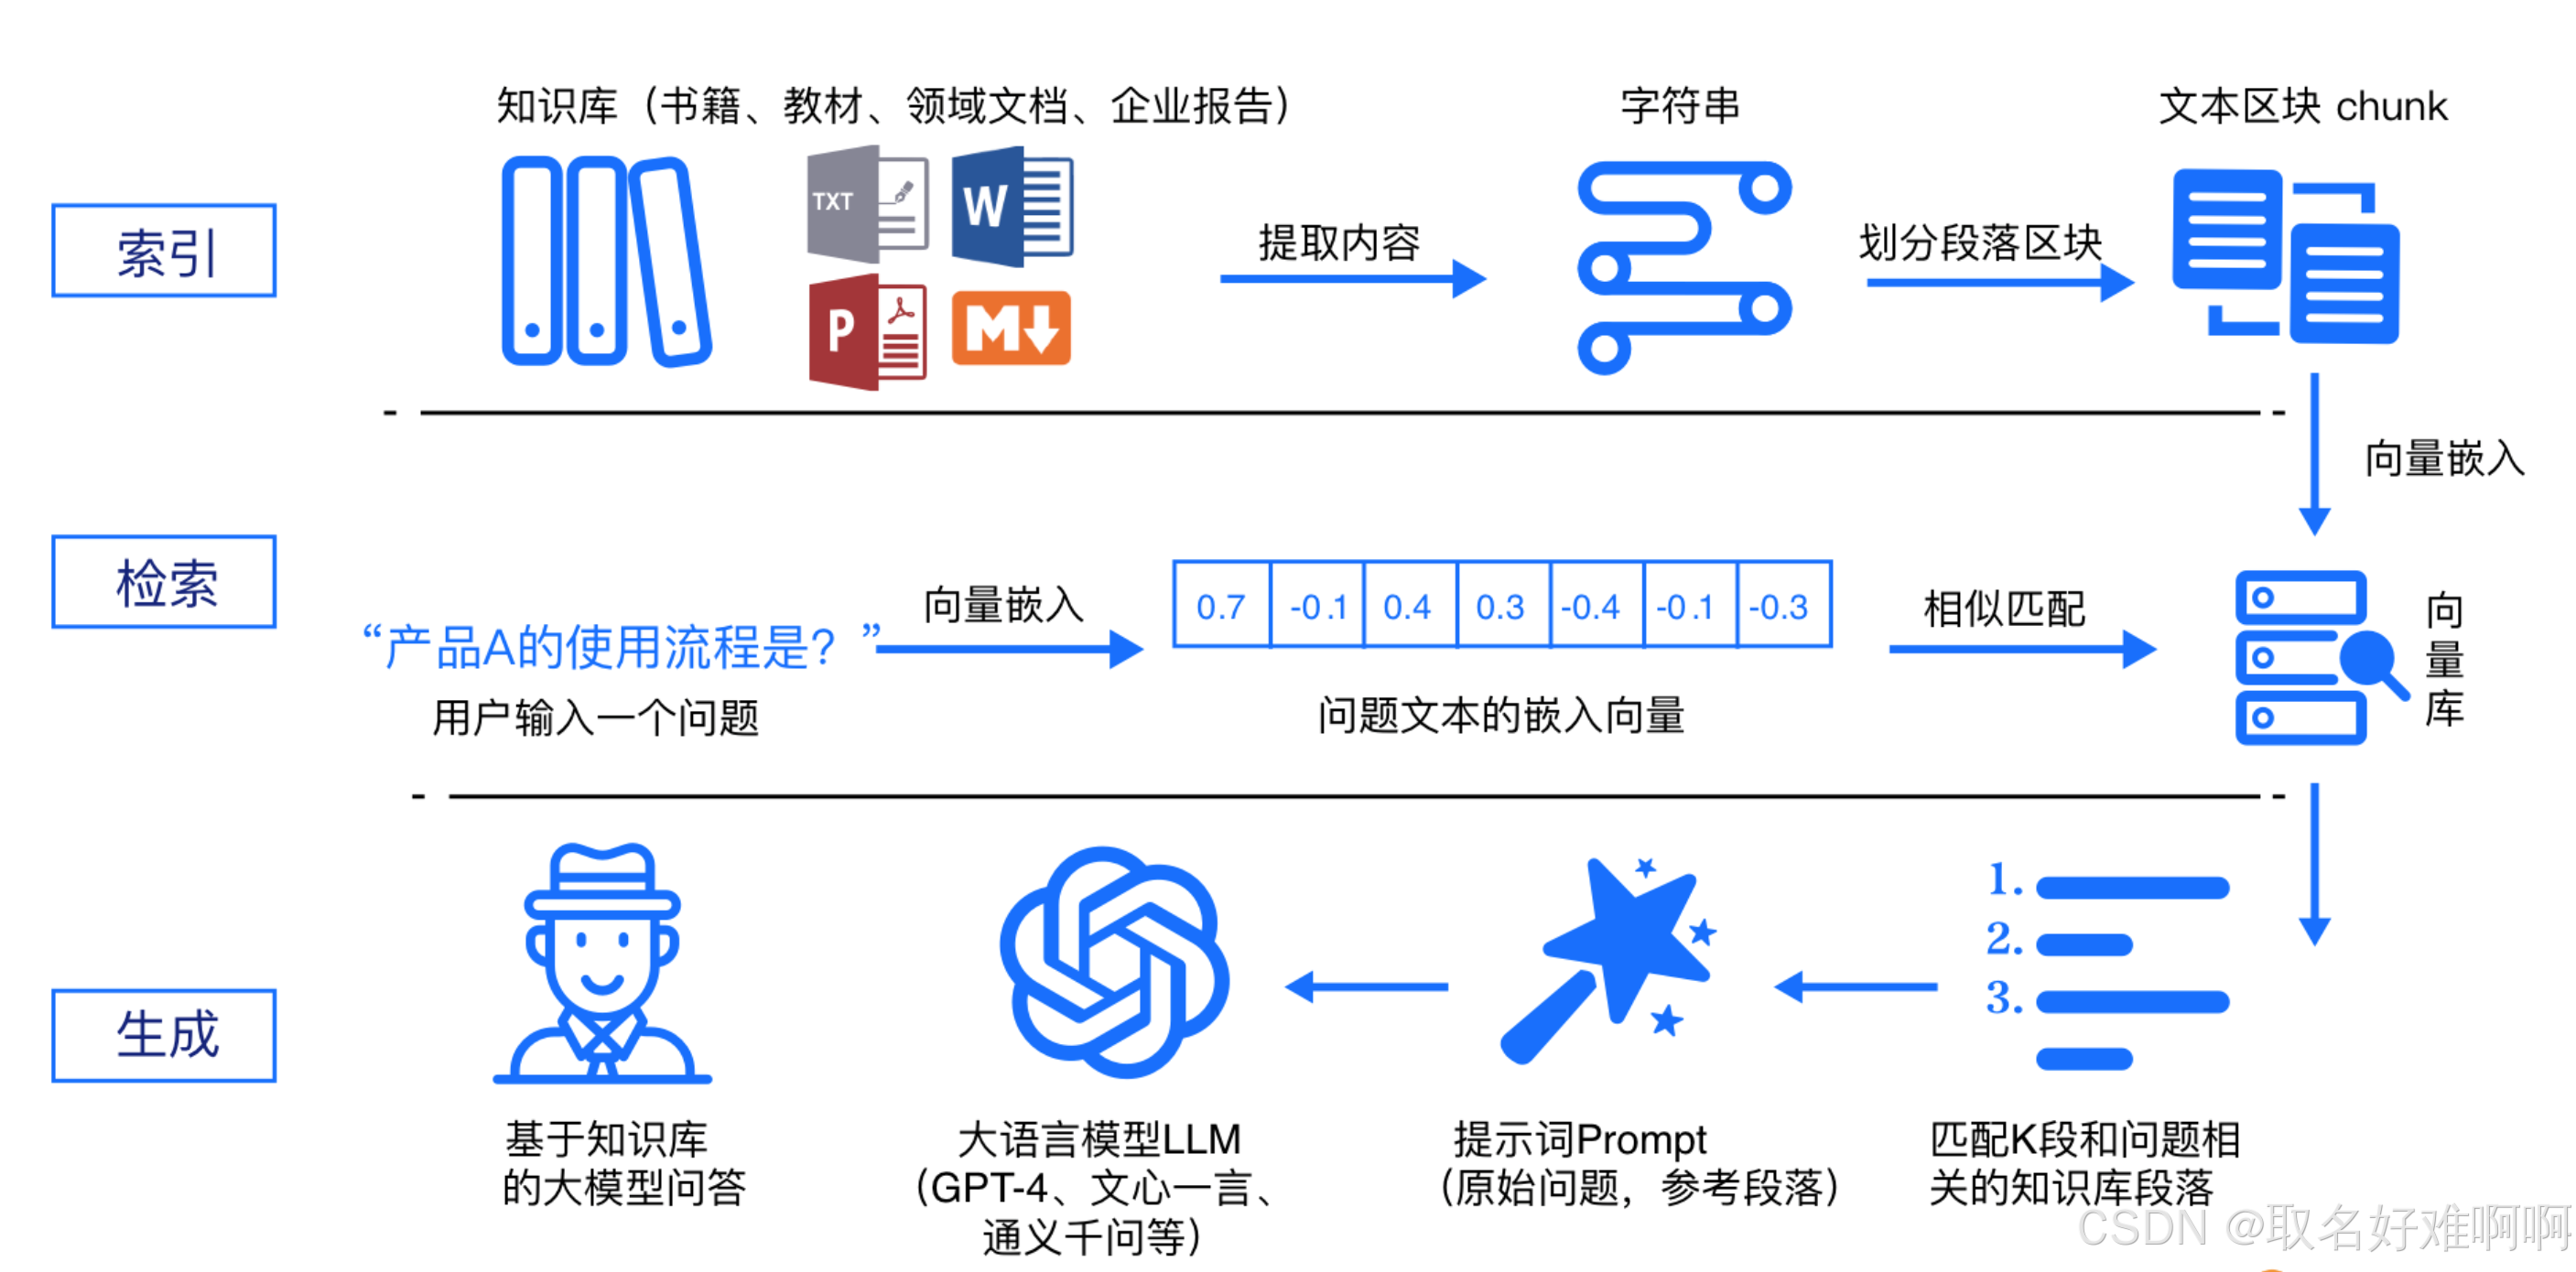
上面图中索引就是程序源源不断从网上或者指定位置获取数据,然后存储到向量数据库中,就是不断更新最新的知识,让大模型能获取到。
用文字简单说明就是:
- 文档预处理:加载 PDF / 网页 / 文本 → 文本切块分割
- 向量化存储:切片生成向量 → 存入向量数据库
- 问题向量化:将用户提问转为向量
- 相似度检索:在向量库中匹配相似文本片段
- 拼接提示词:问题 + 检索上下文组装 prompt
- 模型推理生成:大模型依据真实资料作答
简单来说,RAG 工作分成两条线,离线准备和在线服务。
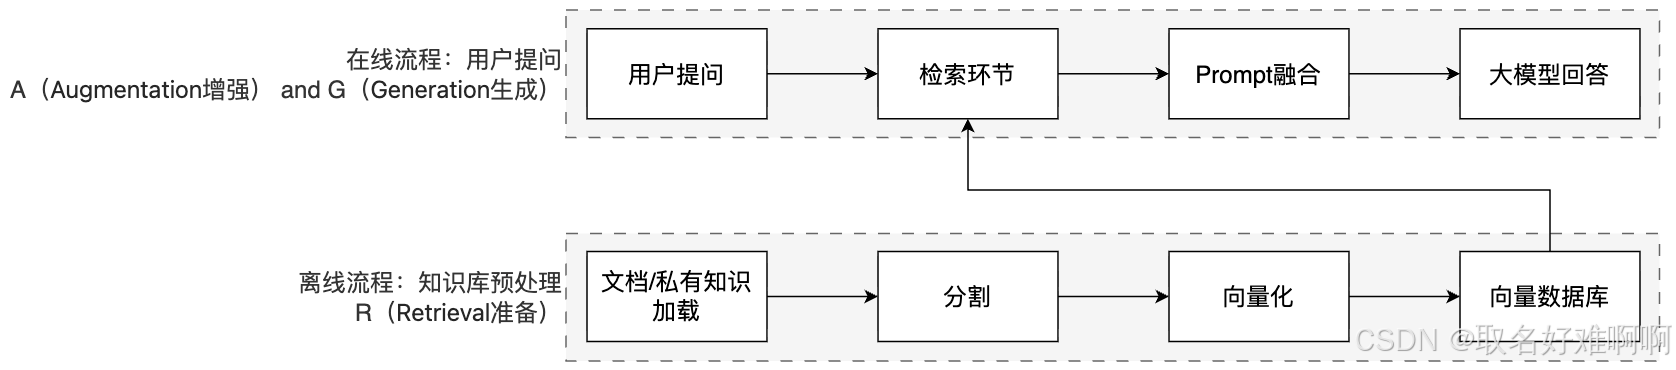
最后总结下流程:索引阶段通过处理多种来源各种格式的文档,提取里面的内容然后切分成标准长度的文本块 chunk,进行嵌入向量化,向量存在向量数据库中,分成下面 5 个步骤:加载文件 -> 内容提取 -> 文本分割,形成 chunk -> 文本向量化 -> 存向量数据库。
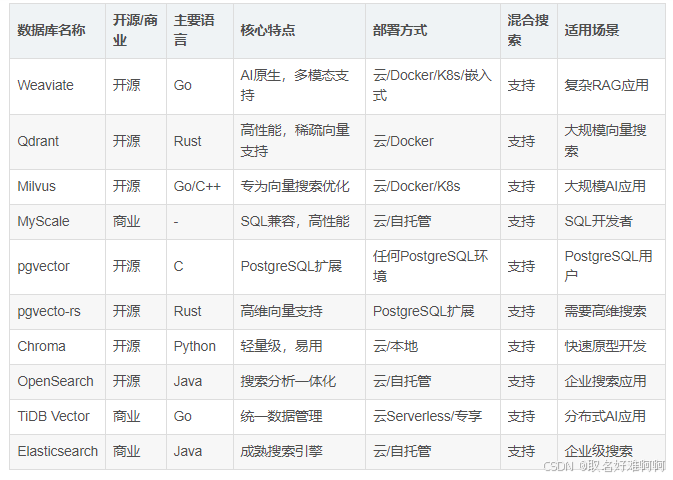
检索阶段,用户输入的查询转化成向量表示,通过相似度匹配从向量数据库里面检索出最相关的文本块,一般可以检索出 top_k 个。
最后生成阶段就是将原始查询和检索的相关文本共同构成提示词 Prompt,输入大语言模型,生成比较精准的具备上下文关联的回答,让大模型生成答案。
4. 向量基础概念
RAG 流程里面向量库是重要的节点。
- 离线流程:知识和信息 -> 向量嵌入(向量化)-> 存入向量库
- 在线流程:用户的提问 -> 向量嵌入(向量化)-> 在向量库中匹配
向量可以看成文本的 数学身份证 ,把文字、句子转成一段固定长度的 数字列表,这串数字就是向量。
举个例子:
- 如何快速学会 RAG
- RAG 如何快速学会
单看文字没法直接对比相似度,计算机不知道怎么根据文字去比对相似度,但是数字可以算距离,所以意思相近的向量数值就挨得比较近,意思无关的就距离远。
至于向量嵌入可以通过文本嵌入模型比如 text-embedding-v1 去完成,通过深度学习等技术从文本里面提取语义特征然后映射成固定长度的数字序列,至于里面的具体原理不用太过于关注,涉及很多深度学习相关的知识。
向量的比较可以通过 余弦相似度算法 去比较,比如我们把下面四个词转成极简的向量,只保留 2 个数字:
- 猫:
[1, 4] - 狗:
[2, 5] - 苹果:
[8, 1] - 香蕉:
[9, 2]
然后我们通过余弦相似度公式计算出值,也就是计算出两个向量夹角的余弦值来衡量相似度,余弦公式的好处就是分子分母里面的 A 和 B 最终会 除以自己的模长 ,也就是都会变成单位向量,这样就能 抛除长度的影响,只看方向 。
cos θ = ( A ⋅ B ) ( ∣ A ∣ ∣ B ∣ ) = ∑ i = 1 n A i B i ∑ i = 1 n A i 2 ⋅ ∑ i = 1 n B i 2 \begin{gather*} \cos\theta = \frac{(A·B)}{(|A||B|)} = \frac{\sum_{i=1}^{n} A_i B_i}{\sqrt{\sum_{i=1}^{n} A_i^2} \cdot \sqrt{\sum_{i=1}^{n} B_i^2}}\end{gather*} cosθ=(∣A∣∣B∣)(A⋅B)=∑i=1nAi2 ⋅∑i=1nBi2 ∑i=1nAiBi
- 夹角 0°,余弦 = 1 → 完全相同
- 夹角越小,数值越趋近 1,相似度越高
- 夹角 90°,余弦 = 0 → 毫无关联
- 夹角 180°,余弦 =-1 → 语义相反
代入公式分别计算:
- 猫狗: 22 17 × 29 ≈ 0.991 \frac{22}{\sqrt{17}\times \sqrt{29}}\approx 0.991 17 ×29 22≈0.991
- 猫苹果: 12 17 × 65 ≈ 0.361 \frac{12}{\sqrt{17} \times \sqrt{65}} \approx 0.361 17 ×65 12≈0.361
- 苹果香蕉: 74 65 × 85 ≈ 0.996 \frac{74}{\sqrt{65} \times \sqrt{85}} \approx 0.996 65 ×85 74≈0.996
可以看到上面的结果,猫狗比较类似,苹果香蕉比较类似,猫和苹果相似度很小。
所以可以看到如果要更精确完成语义匹配,生成向量的维度是一个很重要的指标,比如 text-embedding-v1 模型,可以生成 1536 维的向量(一段文本固定得到1536个数字序列),比较实用。
这里用千问去理解,1536维不是 总token的向量和是1536。
- 每个token的向量维度是1536维: 比如 "我爱机器学习",可能会被切分成 "我", "爱", "机器", "学习" 4 个 token,模型内部会为每个 token 生成一个向量表示,对于 text-embedding-v1,每个 token 会被表示成一个 1536 维的向量。
- 聚合,得到整个句子的向量: 这 4 个 1536 维的 token 向量通过神经网络处理后,最终聚合生成一个 1536 维的向量,这个向量代表整个文本的语义信息。
生成向量的维度越多,就更好的记录文本的语义特征,做语义匹配会更加精准。但是更多向量就会在计算、存储和匹配过程中带来更大的压力,需要在精确和性能之间做平衡,1536 是比较好的选择。
5. Langchain 调用大语言模型
LangChain目前支持三种类型的模型:LLMs(大语言模型)、Chat Models(聊天模型)、Embeddings Models(嵌入模型)。
- LLMs:是技术范畴的统称,指基于大参数量、海量文本训练的 Transformer 架构模型,核心能力是理解和生成自然语言,主要服务于文本生成场景,如 gpt。
- 聊天模型:是应用范畴的细分,是专为对话场景优化的 LLMs,核心能力是模拟人类对话的轮次交互,主要服务于聊天场景,如 chatgpt。
- 文本嵌入模型: 文本嵌入模型接收文本作为输入, 得到文本的向量。
py
from langchain_community.llms.tongyi import Tongyi

# 不选 qwen3-max, 因为 qwen3-max 是聊天模型, qwen-max 是大预言模型
llm = Tongyi(model="qwen-max")

# 发送方法
res = llm.invoke("帮我讲个笑话")
print(res)
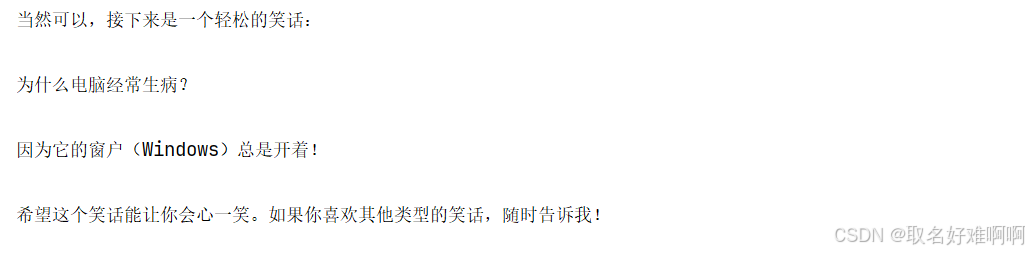
可以看到输出如下。
6. Langchain 调用流式输出
可以看到上面 Langchain 调用 llm 确实非常方便,写法很简洁,将 invoke 返回 stream 就可以了。
go
from langchain_community.llms.tongyi import Tongyi

# 不选 qwen3-max, 因为 qwen3-max 是聊天模型, qwen-max 是大预言模型
llm = Tongyi(model="qwen-max")

# 发送方法
res = llm.stream(input="帮我讲个笑话")
for chunk in res:
    # flush=True 立刻刷新本地缓存, 输出
    # 将每次回复结束符改成空串
    print(chunk, end="", flush=True)
输出如下。
7. Langchain 调用聊天模型
上面属于是调用大语言模型,下面再来看下聊天模型如何调用,聊天模型也是大语言模型,只是针对大语言模型做了优化,支持多轮会话,同样的使用的时候需要按照约定传入合使的值:
- AIMessage: 就是 AI 输出的消息,可以是针对问题的回答 (OpenAI 库中的 assistant 角色)
- HumanMessage : 人类消息就是用户信息,由人给出的信息发送给 LLMs 的提示信息,比如 "实现一个快速排序方法". (OpenAI 库中的 user 角色)
- SystemMessage : 可以用于指定模型具体所处的环境和背景,如角色扮演等。你可以在这里给出具体的指示,比如 "作为一个代码专家" ,或者 "返回 json 格式". (OpenAI 库中的 system 角色)
go
from email import message

from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.messages import HumanMessage, SystemMessage, AIMessage

# 初始化模型
chat = ChatTongyi(model="qwen3-max")

# 准备消息list
messages = [
    SystemMessage(content="你是一个边塞诗人。"),
    HumanMessage(content="写一首唐诗"),
    AIMessage(content="锄禾日当午,汗滴禾下土,谁知盘中餐,粒粒皆辛苦。"),
    HumanMessage(content="按照你上一个回复的格式,在写一首唐诗。")
]

res = chat.stream(input=messages)

# 流式输出
for chunk in res:
    print(chunk.content, end="", flush=True)
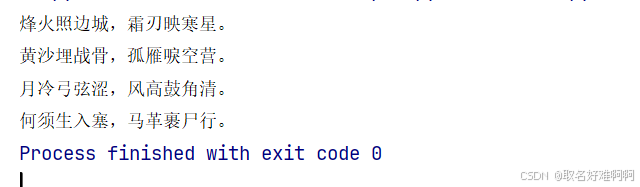
输出如下:
8. Langchain 调用消息的简写形式
上面是以 SystemMessage、HumanMessage、AIMessage 的方式传入消息,我们也可以用简写的方式,同样的在 messages 里面传入二元组封装的信息,第一个参数角色分别是:
- system:SystemMessage 的简写
- ai:AIMessage 的简写
- human:HumanMessage 的简写
第二个参数就是具体的消息了。
go
from langchain_community.chat_models.tongyi import ChatTongyi

# 得到模型对象, qwen3-max就是聊天模型
model = ChatTongyi(model="qwen3-max")

# 消息列表
messages = [
    ("system", "你是一个边塞诗人。"),
    ("human", "写一首唐诗。"),
    ("ai", "锄禾日当午,汗滴禾下土,谁知盘中餐,粒粒皆辛苦。"),
    ("human", "按照你上一个回复的格式,在写一首唐诗。")
]

# stream流式执行
res = model.stream(input=messages)

# 通过.content来获取到内容
for chunk in res:
    print(chunk.content, end="", flush=True)
输出如下:
这两种方式都可以用来传入 message,区别就是如果用这种简写的方式最终还是会转成 AIMessage 这些形式,这个是 LangChain 内部机制转换的。静态好处就是一步到位,不浪费,但是这种简写的方式支持变量注入,因为是动态填充,所以支持内部变量占位符填充。
py
messages = [
	("system", "今天的天气是{weather}"),
	("human", "我的名字是:{name}"),
	("ai", "欢迎{lastname}先生"),
]
9. Langchain 调用嵌入式模型
Embeddings Models 嵌入模型的特点:将字符串作为输入,返回一个浮点数的列表(向量),在 NLP 中 Embedding 的作用就是将数据进行文本向量化。
go
from langchain_community.embeddings import DashScopeEmbeddings

# 创建模型对象 不传model默认用的是 text-embeddings-v1
model = DashScopeEmbeddings()

# 不用invoke stream
# embed_query、embed_documents
print(model.embed_query("我喜欢你"))
print(model.embed_documents(["我喜欢你", "我稀饭你", "晚上吃啥"]))
输出如下:
10. 提示词通用模板
提示词优化在模型应用中非常重要,LangChain 提供了 PromptTemplate 类,用来协助优化提示词。PromptTemplate 表示提示词模板,可以构建一个自定义的基础提示词模板,支持变量的注入,最终生成所需的提示词。
go
from langchain_core.prompts import PromptTemplate
from langchain_community.llms.tongyi import Tongyi

# 提示词模板
prompt_template = PromptTemplate.from_template(
    "{first} + {second} = ?, 你帮我计算结果"
)

# 注入信息, 获取提示词文本
prompt_text = prompt_template.format(first=1, second=2)

# 1 + 2 = ?, 你帮我计算结果
# print(prompt_text)

model = Tongyi(model="qwen-max")
res = model.invoke(input=prompt_text)
print(res)
# 1 + 2 的结果是 3。
上面是基础写法,看起来有点多此一举,因为直接用字符串 f 注入也可以,但是这种写法得到的是一个 PromptTemplate 对象,获取到的 prompt_template 可以加入链,形成链式调用。
go
from langchain_core.prompts import PromptTemplate
from langchain_community.llms.tongyi import Tongyi

# 提示词模板
prompt_template = PromptTemplate.from_template(
    "{first} + {second} = ?, 你帮我计算结果"
)

model = Tongyi(model="qwen-max")

# 获取执行链, 意思就是将 prompt_template 执行结果输入给 model 去执行
chain = prompt_template | model
res = chain.invoke(input={"first": 10, "second": 20})
print(res)
# 10 + 20 的结果是 30。
可以看到上面的意思就是将变量传递给占位符之后,结果传递给 model 去调用大语言模型的 api,获取结果。
11. FewShot 提示词模板
FewShot 就是我们要给大模型输入一些示例。
py
from langchain_core.prompts import FewShotPromptTemplate

FewShotPromptTemplate(
	examples=None,
	example_prompt=None,
	prefix=None,
	suffix=None,
	input_variables=None
)
参数:
- examples:示例数据,list,内套字典
- example_prompt:示例数据的提示词模板
- prefix:组装提示词,示例数据前内容
- suffix:组装提示词,示例数据后内容
- input_variables:列表,注入的变量列表
py
from sys import prefix

from langchain_core.prompts import PromptTemplate, FewShotPromptTemplate
from langchain_community.llms.tongyi import Tongyi

# 示例的模板
example_template = PromptTemplate.from_template("单词:{word}, 反义词:{antonym}")

# 示例的动态数据注入 要求是list内部套字典
examples_data = [
    # 相当于
    # 单词: 大, 反义词: 小
    # 单词: 上, 反义词: 下
    {"word": "大", "antonym": "小"},
    {"word": "上", "antonym": "下"},
]

few_shot_template = FewShotPromptTemplate(
    # 提示词模板和数据
    example_prompt=example_template,
    examples=examples_data,
    # 提示词例子前面的输入
    prefix="下面我会给出一些反义词实例: ",
    # 提示词例子后面的输入
    suffix="基于上面的示例, 给我: {input_word} 的反义词是什么",
    # 标注变量是什么
    input_variables=['input_word'],
)

# 注入变量
prompt_text = few_shot_template.invoke(input={"input_word": "左"}).to_string()
print(prompt_text)
#下面我会给出一些反义词实例:
# 单词:大, 反义词:小
# 单词:上, 反义词:下
# 基于上面的示例, 给我: 左 的反义词是什么

model = Tongyi(model="qwen-max")

print(model.invoke(input=prompt_text))
# 基于您给出的例子,"左"的反义词是"右"。
12. 模板类的 format 和 invoke
在 PromptTemplate(通用提示词模板)和 FewShotPromptTemplate(FewShot 提示词模板)的使用中,我们使用了如下方法:
go
prompt_text = few_shot_template.invoke(input={"input_word": "左"}).to_string()

prompt_text = prompt_template.format(lastname="张", gender="女儿")
PromptTemplate、FewShotPromptTemplate、ChatPromptTemplate 方法都有这两类方法。
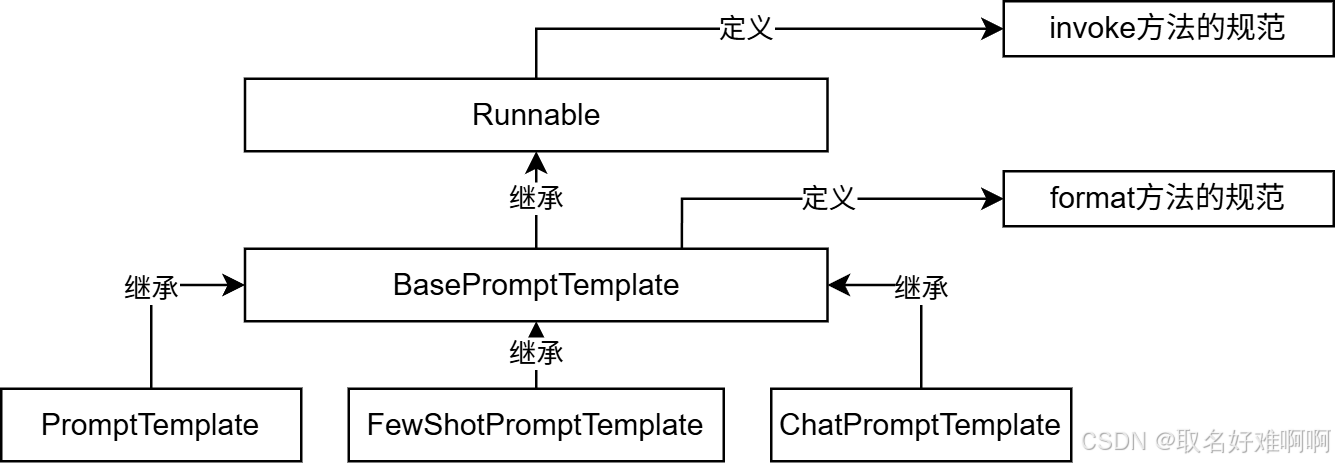
这两个方法的区别就是:
| 区别 | format | invoke |
|---|---|---|
| 功能 | 纯字符串替换,解析占位符生成提示词 | Runnable 接口标准方法,解析占位符生成提示词 |
| 返回值 | 字符串 | PromptValue 类对象,调用 to_string 才能获取到字符串 |
| 传参 | .format(k=v, k=v, ...) |
.invoke("k":v, "k":v, ...) |
| 解析 | 支持解析 {} 占位符 | 支持解析 {} 占位符和 MessagesPlaceholder 结构化占位符 |
13. ChatPromptTemplate 的使用
- PromptTemplate:通用提示词模板,支持动态注入信息。
- FewShotPromptTemplate:支持基于模板注入任意数量的示例信息。
- ChatPromptTemplate:支持注入任意数量的历史会话信息。
通过 from_messages 方法,从列表中获取多轮次会话作为聊天的基础模板,注意 PromptTemplate 类用的 from_template 仅能接入一条消息,而 from_messages 可以接入一个 list 的消息,也就是能够接收更多历史消息。
历史会话信息随着对话进行不断增多,所以历史会话消息需要支持动态注入,from_messages 方法就支持注入历史消息,可以使用
MessagePlaceholder 作为占位符,基于 invoke 动态注入历史会话记录,注意必须是 invoke 方法,format 方法无法动态注入。
go
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_ollama import chat_models

chat_prompt_template = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个边塞诗人,可以作诗。"),
        # 占位符号, 填充历史消息
        MessagesPlaceholder("history"),
        ("human", "请再来一首唐诗"),
    ]
)

history_data = [
    ("human", "你来写一个唐诗"),
    ("ai", "床前明月光,疑是地上霜,举头望明月,低头思故乡"),
    ("human", "好诗再来一个"),
    ("ai", "锄禾日当午,汗滴禾下锄,谁知盘中餐,粒粒皆辛苦"),
]

#  invoke 返回类型是 StringPromptValue
prompt_text = chat_prompt_template.invoke({"history": history_data}).to_string()
# print(prompt_text)

model = ChatTongyi(model="qwen3-max")
res = model.invoke(prompt_text)
print(res.content)

# 黄沙百战穿金甲,
# 不破楼兰誓不还。
# 孤城遥望玉门关,
# 铁马冰河入梦寒。
#
# ------边塞客题
14. Chain 链的使用
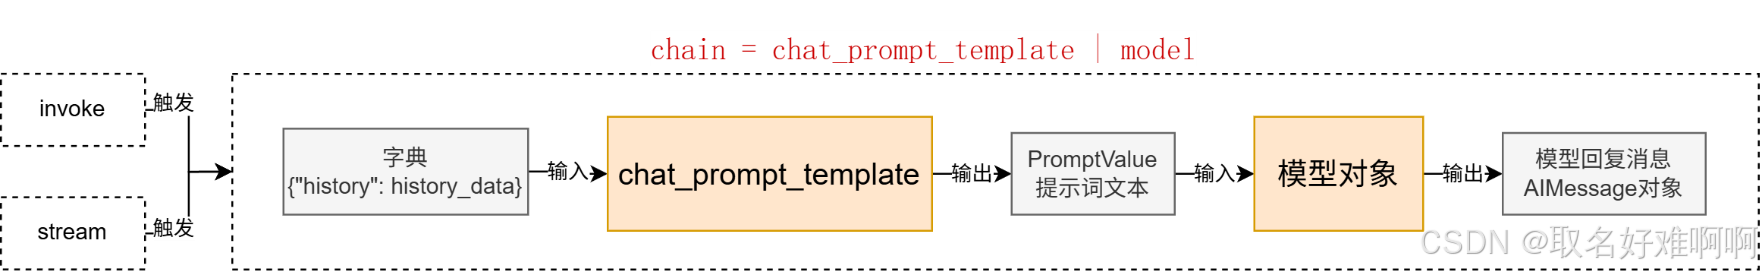
LangChain 链就是 将组件串联,上一个组件的输出作为下一个组件的输入 ,这也是链式调用的核心价值:实现数据的自动化流转与组件的协同工作 ,比如:chain = prompt_template | model。
核心前提: 也就是 Runnable 子类对象才能入链(以及 Callable、Mapping 接口子类对象也可加入(后续了解用的不多)),目前学习到的组件都是 Runnable 的子类。
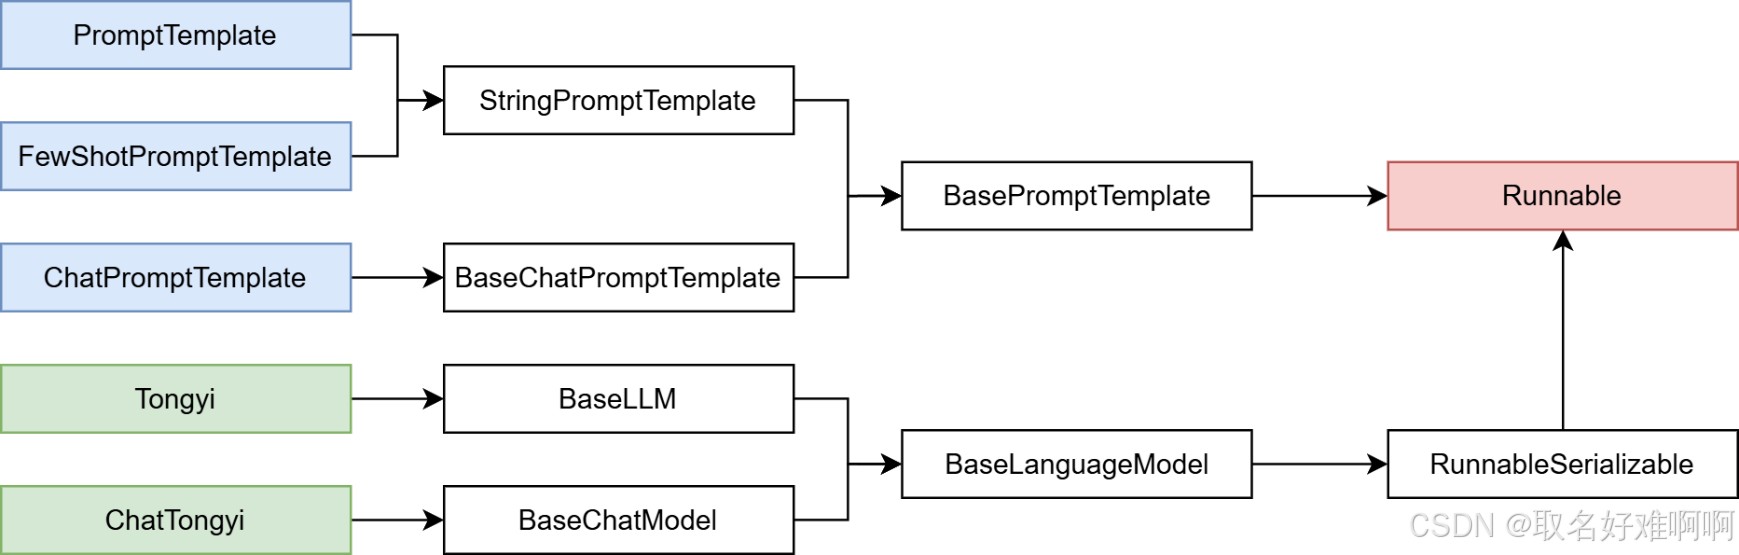
下面是简单的演示。
go
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.runnables import RunnableSerializable
from langchain_ollama import chat_models

chat_prompt_template = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个边塞诗人,可以作诗。"),
        # 占位符号, 填充历史消息
        MessagesPlaceholder("history"),
        ("human", "请再来一首唐诗"),
    ]
)

history_data = [
    ("human", "你来写一个唐诗"),
    ("ai", "床前明月光,疑是地上霜,举头望明月,低头思故乡"),
    ("human", "好诗再来一个"),
    ("ai", "锄禾日当午,汗滴禾下锄,谁知盘中餐,粒粒皆辛苦"),
]

model = ChatTongyi(model="qwen3-max")
# <class 'langchain_core.prompts.chat.ChatPromptTemplate'>
# print(type(chat_prompt_template))

# 创建链, 返回对象是 RunnableSerializable, 其实还是 Runnable 的子类
chain = chat_prompt_template | model

# Runnable 接口, invoke 执行
res = chain.invoke({"history": history_data})
print(res.content)
# 《塞上曲》
# 烽火连天戍角哀,
# 黄沙百战铁衣摧。
# 孤城落日胡笳起,
# 一夜征人尽望乡。

# Runnable 接口, stream 执行
for chunk in chain.stream({"history": history_data}):
    print(chunk.content, end="", flush=True)
# (注:此为拟唐边塞诗风格新作,未袭用古人成句)
# 《塞上曲》
# 黄沙百战穿金甲,
# 不破楼兰终不还。
# 大漠孤烟直如剑,
# 长河落日血浸山。
#
# ------边塞诗人 李骁
可以看到上面的代码就是将提示词模板 ChatPromptTemplate 和 model 构建成了链,然后调用 invoke 执行的时候会将 history_data 首先输入 ChatPromptTemplate,接下来将返回结果 StringPromptValue 输入 model,最终获取到结果。
如有错误,欢迎指出!!!