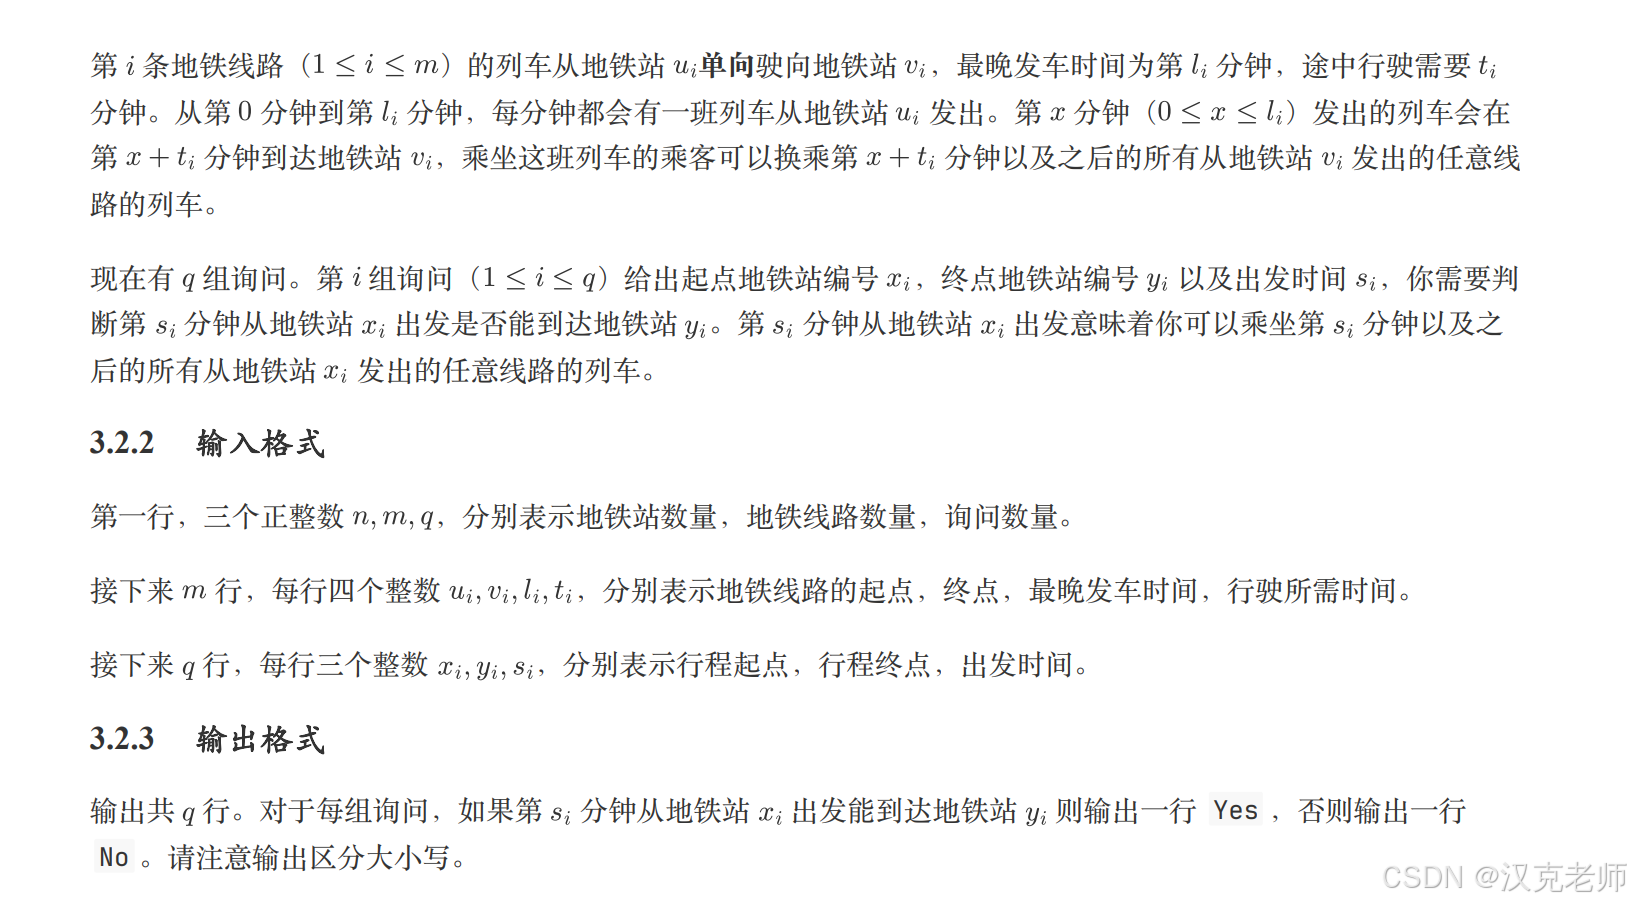
这道 第三部分编程题第二题《末班车》,表面上是在讲"坐地铁",实际上考的是一个非常重要的图论思想:
把"从起点出发能不能到终点"反过来思考:从终点倒着推,计算每个车站"最晚几点出发还能赶到终点"。
这道题非常值得同学们掌握,因为它把 图、最短路、优先队列、反向思维 全部串在了一起。
题目的完整数据范围是:最多 500个地铁站、1000条线路、50万组询问 。所以如果每个询问都重新跑一次普通最短路,会非常慢。我们程序可以采用"每个终点预处理一次,再回答大量询问"的方法。
一、先把题目变成"小朋友坐地铁"
城市里有很多地铁站:
1号站
2号站
3号站
4号站
......每条地铁线路都是单向的。
例如:
1 ─────→ 2假设这条线路:
-
最晚发车时间:3分钟
-
坐车需要:3分钟
那么:
0分钟出发 → 3分钟到
1分钟出发 → 4分钟到
2分钟出发 → 5分钟到
3分钟出发 → 6分钟到
超过3分钟:
4分钟
5分钟
......
就没有车了。
二、最重要的规则:车可以等
这是本题最容易忽略的地方。
假如你:
第2分钟到达2号站。
下一班车最晚5分钟发车。
你当然可以:
2分钟到站
 ↓
等3分钟
 ↓
5分钟坐车
所以:
到达车站以后,可以等待下一班车。
题目规定:
某条线路从0分钟到最晚发车时间,每一分钟都有一班车。
所以只要:
当前时间 ≤ 最晚发车时间
就能赶上这条线路。
三、先看样例
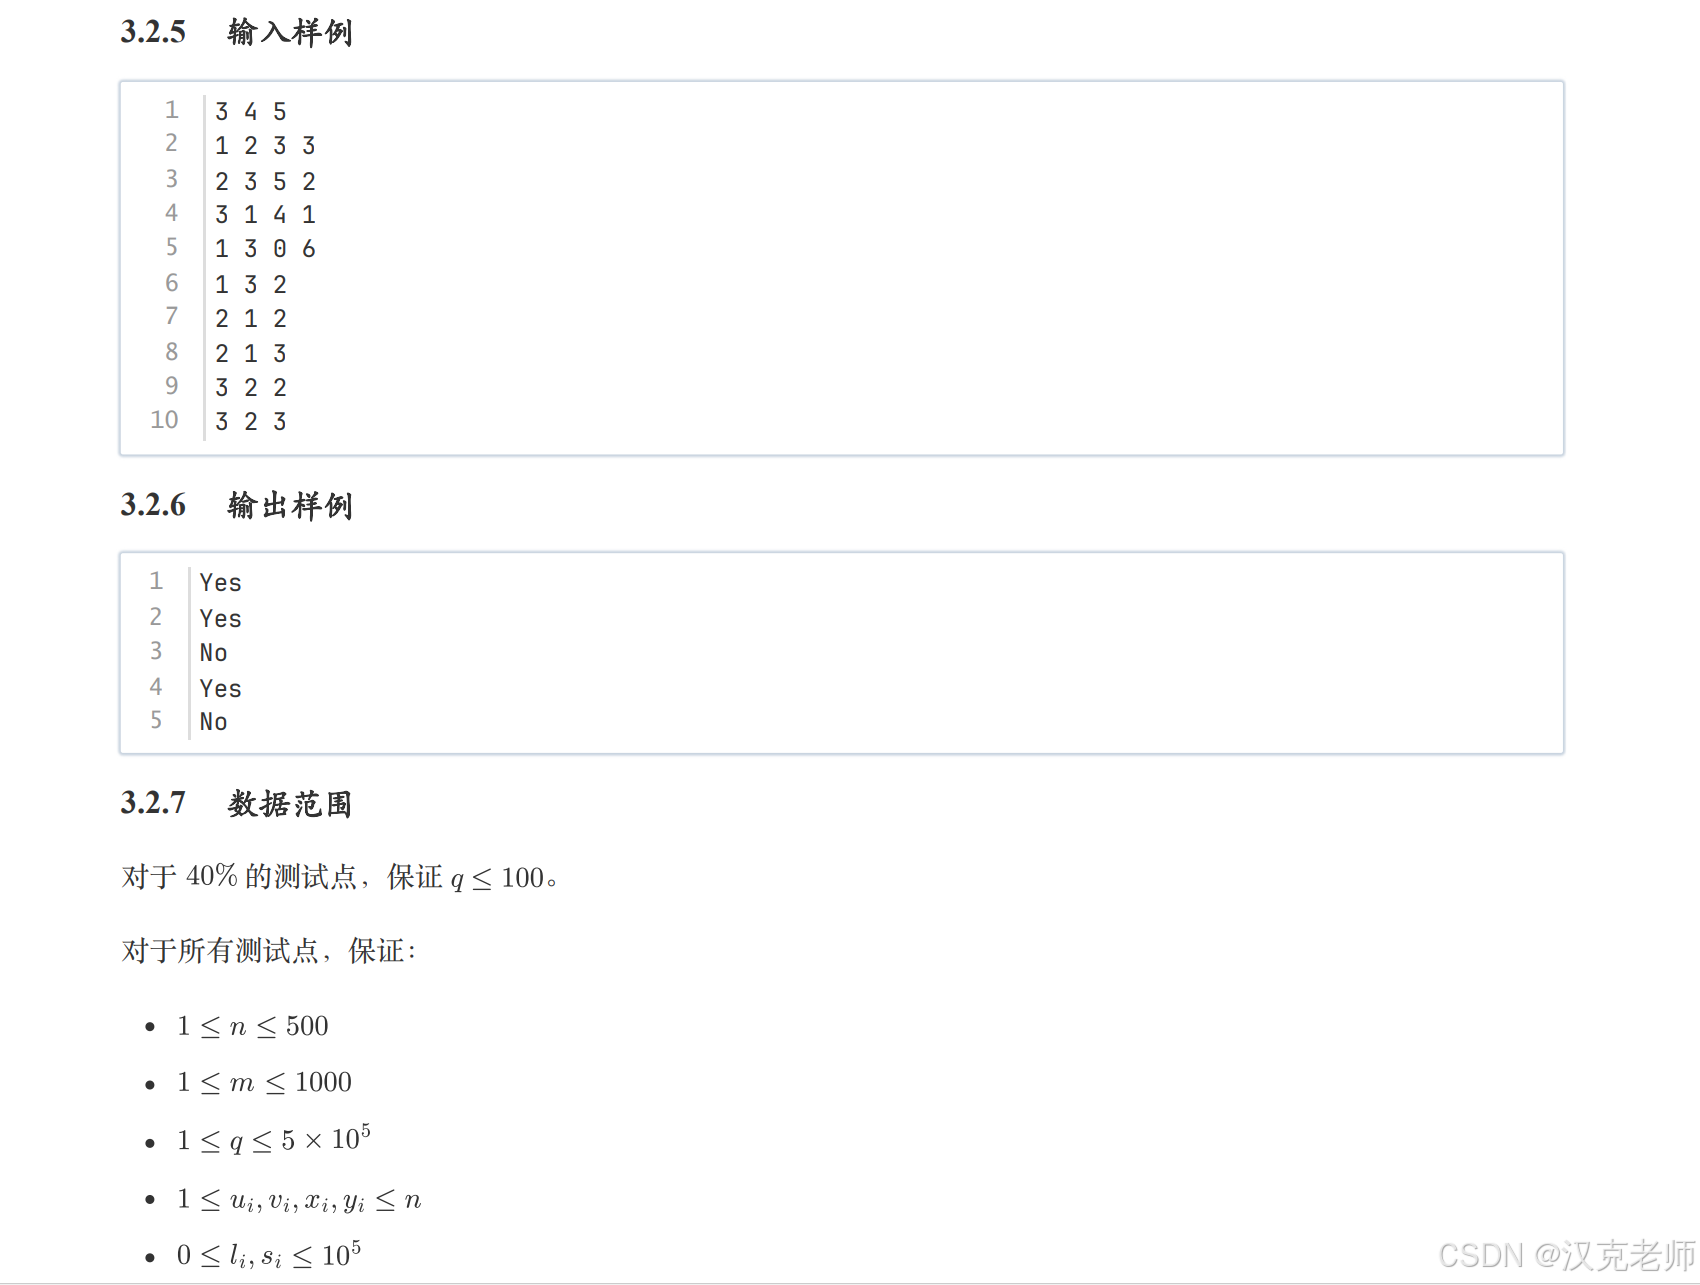
题目的样例是:
3 4 5

1 2 3 3
2 3 5 2
3 1 4 1
1 3 0 6
表示:
线路1
1 → 2最晚3分钟发车,路上3分钟。
线路2
2 → 3最晚5分钟发车,路上2分钟。
线路3
3 → 1最晚4分钟发车,路上1分钟。
线路4
1 → 3最晚0分钟发车,路上6分钟。
所以地图大概是:
       3
   1 ───→ 2
   │       │
   │       │
   ↓       ↓
   3 ←─────
更准确地说:
1 ──→ 2 ──→ 3
↑           │
└───────────┘
四、题目到底问什么?
例如:
1 3 2意思是:
我第2分钟从1号站出发,能不能到3号站?
我们来试:
第一步
2分钟在1号站。
坐:
1 → 2这趟车最晚3分钟发车。
所以可以在2分钟坐车。
3分钟到2号站。
第二步
到了2号站是3分钟。
线路:
2 → 3最晚5分钟发车。
可以等到5分钟再坐。
5分钟出发:
5 + 2 = 77分钟到3号站。
所以:
Yes!
五、如果按照普通思路,怎么想?
我们可能会想:
"那我从1号站开始,一步一步往前走。"
也就是:
当前时间
 ↓
看看有哪些车
 ↓
选择能坐的车
 ↓
到下一个站
 ↓
继续
这就是一个正向思维。
可是问题来了。
题目有:
q ≤ 5×10^5
也就是:
最多50万次询问!
如果每个询问都重新跑一遍图:
第1次:跑一遍
第2次:跑一遍
第3次:跑一遍
......
第500000次:再跑一遍
电脑会累得哭出来。😂
所以必须想办法:
⭐ 一次计算,多次使用!
六、真正厉害的思路:反过来想!
假设现在有一个问题:
我想去3号站。
我们不从1号站往3号站走。
而是站在:
🎯 终点3号站
然后问:
"如果我要最终到达3号站,那么其他车站最晚几点出发还来得及?"
这个问题就漂亮多了!
七、我们计算"最晚出发时间"
假设:
2 → 3这条线路:
-
最晚5分钟发车
-
需要2分钟
那么:
从2号站最晚什么时候出发,还能到3号站?
当然是:
5
因为5分钟出发:
5 + 2 = 7
就能到3号站。
所以:
d[3] = ∞
d[2] = 5
这里:
d[x]表示:从x号站最晚几点出发,还能到达目标站。
八、再往前推一个车站
现在:
1 → 2这条线路:
-
最晚3分钟发车
-
需要3分钟
我们刚才已经知道:
从2号站最晚5分钟出发那么从1号站什么时候出发呢?
如果:
1号站 2分钟出发3分钟到2号站。
当然赶得上。
如果:
1号站 3分钟出发6分钟到2号站。
已经赶不上5分钟那班车了。
所以:
从1号站最晚只能3分钟出发。
于是:
d[1] = 3
d[2] = 5
d[3] = ∞
九、出现一个非常重要的公式
假设有一条线路:
u ─────→ v它有:
-
最晚发车时间:
l -
行驶时间:
t
我们已经知道:
从v最晚
d[v]时间出发,还能完成任务。
那么从u出发,必须满足两个条件。
条件①:不能超过这条车的最晚发车时间
必须:
x ≤ l
条件②:到了v以后还必须来得及
从u出发时间是:
x
坐车需要:
t
到达v:
x + t
必须满足:
x+t ≤ dv
所以:
x ≤ dv−tx
于是两个条件同时满足:
x ≤ l
以及:
x ≤ dv−tx
那么x最大的值就是:
这就是整道题最最核心的公式!
十、用能懂的话解释下这个公式
假设:
u → v你从u坐车到v。
你要同时遵守两个"时间警察":
🚓 警察1
"这班车最晚只能3分钟发车!"
所以:
不能超过 l🚓 警察2
"你到了v以后,还得赶得上后面的车!"
所以:
不能超过 d[v]-t两个警察都说:
"不能超过我的时间!"
那么最终:
听最严格的那个!
所以取:
十一、这就是参考程序里的这一句
参考程序中有:
int w = min(d[u] - t[i], l[i]);这是参考程序是从当前点 u 向前反推,所以变量位置看起来和我们刚才讲的符号稍微不同。
它的本质就是:
计算前一个车站最晚什么时候还能出发。
十二、为什么要"反向思考"?
这是本题最精彩的地方。
普通最短路喜欢问:
最早什么时候到?
例如:
从1号站出发
↓
最早几点到2号站?
↓
最早几点到3号站?
这是:
⏰ "最早到达"
但是本题其实更适合问:
最晚几点出发还能赶上?
也就是:
⏰ "最晚出发"
这两个思维方向是不一样的。
十三、给大家画一张"时间魔法图"
假设:
1 ──3分钟──→ 2最晚3分钟发车。
如果我们从2号站开始倒推:
2号站
 ↑
 ↑  最晚3分钟出发
 ↑
1号站
得到:
d[2] = 5
d[1] = min(3, 5-3)
     = min(3,2)
     = 2
所以:
从1号站最晚2分钟出发。
十四、为什么不是简单的"最晚发车时间减行驶时间"?
这里很容易犯错误。
假设:
1 → 2最晚发车:
3
行驶:
3
如果2号站最晚:
5
那么:
5−3=2
所以1号站最晚2分钟。
但是如果2号站最晚只能:
1
呢?
那么:
1−3=−2
而这条车又规定:
1号站最晚3分钟发车1号站最晚3分钟发车
所以两个限制一起看:
min(3,−2)=−2
意味着:
根本不存在合法的出发时间。
所以程序里专门判断:
if (w < 0)
    continue;
也就是说:
如果推出来的时间已经小于0,这条线路就没办法帮助我们到达终点。
十五、为什么使用优先队列?
现在我们知道:
要从终点开始,一层一层往前推。
但是一个车站可能有很多条线路。
例如:
       → 2
      /
1 → 3
      \
       → 4
我们不断更新:
d[1]
d[2]
d[3]
d[4]
这和Dijkstra非常像。
所以我们可以使用:
🏆 优先队列
程序:
priority_queue<pair<int,int> > q;这里用了C++默认的大根堆。
十六、为什么代码用负数?
你可能注意到了:
q.push(make_pair(-d[u], u));为什么好好的 d[u] 前面要加一个负号?
因为:
C++默认的
priority_queue是大根堆。
也就是说:
最大的数先出来。但是我们希望:
时间最小的先处理。
所以:
5 → -5
10 → -10
3 → -3
那么:
-10
-5
-3
最大的其实是:
-3这就相当于原来的:
3最小的先出来。
所以通过:
-d[u]把大根堆"伪装"成小根堆,这也是一个小技巧。
十七、当然,也可以直接写小根堆
如果同学们已经学过:
greater<pair<int,int> >也可以写:
priority_queue<
    pair<int,int>,
    vector<pair<int,int> >,
    greater<pair<int,int> >
> q;
不过官方的参考程序选择了:
priority_queue<pair<int,int> >然后把时间取负数。
我们可以先理解:
"负号是为了让大根堆模拟小根堆。"
就够了。
十八、还有一个非常重要的技巧:为什么要判断旧数据?
程序里面:
pair<int,int> p = q.top();
q.pop();

if (d[u] != p.first)
    continue;
这里有的同学很容易看懵。
我们讲一个"小纸条"的故事。
📝 每次更新du,就往优先队列里塞一张纸条
比如:
1号站最晚5分钟后来发现:
1号站最晚8分钟那么队列里可能同时存在:
5分钟
8分钟
但是:
5分钟已经是旧消息了。
真正有效的是:
8分钟所以弹出来以后:
if (d[u] != p.first)
    continue;
就是在问:
"这张纸条还是最新的吗?"
如果不是:
扔掉!
十九、现在我们完整走一遍样例
样例线路:
1 → 2,最晚3,耗时3
2 → 3,最晚5,耗时2
3 → 1,最晚4,耗时1
1 → 3,最晚0,耗时6
假设目标是:
🎯 3号站
我们从3号站开始。
第一步:3号站
目标已经到了。
所以:
d3 = +oo
程序里用:
oo = 1e9;表示无限大。
所以:
d[3] = ∞二十、第二步:处理2号站
有:
2 → 3最晚:
5
耗时:
2
3号站:
d3=∞
所以:
d2=min(5,∞−2)
结果:
二十一、第三步:处理1号站
有:
1 → 2线路最晚:
3
耗时:
3
而:
d2=5
所以:
d1=min(3,5−3)
于是我们得到了:
| 车站 | 最晚出发时间 |
|---|---|
| 1 | 2 |
| 2 | 5 |
| 3 | ∞ |
这张表太重要了!
二十二、这张表怎么回答询问?
假设问:
1 3 2意思:
1号站,2分钟出发,能不能到3号站?
我们查:
d[1] = 2然后比较:
2 ≤ 2
成立。
所以:
Yes再问:
1 3 3我们比较:
3 ≤ 2
不成立。
所以:
No这就是:
⭐ 查询只需要比较一次!
二十三、这就是为什么它能处理50万次询问
假设有:
500000个询问。
我们提前把:
d[1]
d[2]
d[3]
......
d[n]
全部算出来。
以后每个询问只做:
if (s <= d[x])
    Yes
else
    No
这就是:
预处理一次,查询很多次。
二十四、但是有一个关键问题
不同的终点:
终点1
终点2
终点3
......
对应的 d[] 不一样。
例如:
我要去3号站。
我们计算:
d3[1], d3[2], d3[3]...如果:
我要去1号站。
就要重新计算:
d1[1], d1[2], d1[3]...所以程序可以做的是:
for (int i = 1; i <= n; i++)
    calc(i, d[i]);
也就是:
把每一个车站都当一次终点,提前计算一遍。
二十五、为什么不按照每个询问计算?
因为:
q ≤ 500000
但:
n ≤ 500
所以:
终点只有500个左右,但询问可能有50万个。
这是一个非常重要的观察。
我们应该:
❌ 错误思路
每个询问
   ↓
跑一次算法
50万次,太慢。
✅ 正确思路
每个终点
   ↓
跑一次算法
   ↓
保存结果

50万次询问
   ↓
直接查表
二十六、这其实是一种非常重要的算法思想
叫:
⭐ 预处理
先花一些时间把答案准备好。
以后:
查询的时候直接拿来用。
生活中也有类似的例子。
📚 查字典
如果每次查一个字都重新造一本字典:
当然很慢。
我们提前把字典做好:
苹果 → apple
香蕉 → banana
西瓜 → watermelon
查询的时候直接查。
💻 算法也是一样
提前计算:
终点3:
1号站 → 最晚2分钟
2号站 → 最晚5分钟
3号站 → 无限
以后:
1 3 0
1 3 1
1 3 2
1 3 3
......
全部可以快速回答。
二十七、参考程序最核心的函数
现在再看:
void calc(int u, int d[])
{
    for (int i = 1; i <= n; i++)
        d[i] = -oo;

    d[u] = oo;

    q.push(make_pair(-d[u], u));

    while (!q.empty())
    {
        pair<int, int> p = q.top();
        q.pop();

        if (d[u] != p.first)
            continue;

        u = p.second;

        for (int i = h[u]; i; i = nx[i])
        {
            int v = to[i];

            int w = min(d[u] - t[i], l[i]);

            if (w < 0)
                continue;

            if (w > d[v])
            {
                d[v] = w;
                q.push(make_pair(d[v], v));
            }
        }
    }
}
虽然看起来复杂,但可以把它翻译成:
选定终点
   ↓
终点的最晚时间 = 无限
   ↓
优先处理最有希望的车站
   ↓
沿着地铁线路反向推
   ↓
计算前一个车站最晚什么时候出发
   ↓
如果更好,就更新
   ↓
继续扩散
二十八、注意:代码为什么是"沿着线路正向存储",却在"时间意义上倒着推"?
这是非常高级、也非常漂亮的地方。
线路本身还是:
u → v程序并没有真的把边改成:
v → u但是我们思考的时候:
已知v最晚时间
 ↓
反推u最晚时间
所以叫:
⭐ 反向推理
不是一定要把图反过来,而是:
从终点的答案倒着推前面的答案。
这个区别同学们一定要理解。
二十九、为什么这有点像Dijkstra?
因为它确实使用了:
priority_queue并且不断进行:
if (w > d[v])
    d[v] = w;
这和Dijkstra的"松弛"思想非常相似。
普通Dijkstra:
不断更新"最短距离"。
这道题:
不断更新"最晚可行时间"。
所以可以把它理解成:
🚇 "最晚出发版Dijkstra"
普通Dijkstra:
求最小
这道题:
求最大
三十、普通Dijkstra和本题对比
| 普通Dijkstra | 本题 |
|---|---|
| 求最短距离 | 求最晚出发时间 |
| 从起点出发 | 从终点倒推 |
min越来越小 |
max越来越大 |
| 优先处理最小距离 | 优先处理当前最优时间 |
| 问"最早几点到" | 问"最晚几点走还来得及" |
这是理解本题最好的方法之一。
三十一、参考程序
#include <cstdio>
#include <algorithm>
#include <queue>

using namespace std;

const int N = 505;
const int E = 1005;
const int INF = 1e9;

int n, m;

int h[N];
int to[E], nx[E];
int l[E], t[E];

int d[N][N];

priority_queue<pair<int, int> > q;


// target:终点
// d[]:保存"到达target时,每个车站最晚几点出发"
void calc(int target, int d[])
{
    for (int i = 1; i <= n; i++)
        d[i] = -INF;

    // 终点本身,当然什么时候到都算成功
    d[target] = INF;

    q.push(make_pair(-d[target], target));

    while (!q.empty())
    {
        pair<int, int> p = q.top();
        q.pop();

        int u = p.second;

        // 旧状态,跳过
        if (-p.first != d[u])
            continue;

        // 枚举u出发的所有线路
        for (int i = h[u]; i; i = nx[i])
        {
            int v = to[i];

            // 计算前一个站最晚什么时候出发
            int w = min(d[u] - t[i], l[i]);

            // 已经无法赶上
            if (w < 0)
                continue;

            // 如果更优,就更新
            if (w > d[v])
            {
                d[v] = w;

                q.push(make_pair(-d[v], v));
            }
        }
    }
}


int main()
{
    int q;

    scanf("%d%d%d", &n, &m, &q);

    // 读入所有地铁线路
    for (int i = 1; i <= m; i++)
    {
        int u, v;

        scanf("%d%d%d%d",
              &u, &v, &l[i], &t[i]);

        // 建立有向边 u -> v
        to[i] = v;
        nx[i] = h[u];
        h[u] = i;
    }

    // 每一个车站都当一次终点
    for (int i = 1; i <= n; i++)
    {
        calc(i, d[i]);
    }

    // 回答所有询问
    while (q--)
    {
        int u, v, s;

        scanf("%d%d%d", &u, &v, &s);

        // s分钟从u出发,
        // 如果不超过"最晚可出发时间",就可以到v
        if (s <= d[v][u])
            printf("Yes\n");
        else
            printf("No\n");
    }

    return 0;
}
三十二、这里有一个非常重要的"数组理解"
看到:
d[v][u]初学者很容易糊涂。
它的含义:
d[v][u]= "如果我要去 v 号站,那么从 u 号站最晚几点出发还来得及?"
所以:
d[3][1] = 2就是:
目标是3号站,从1号站最晚2分钟出发。
查询:
1 3 2就看:
s <= d[3][1]也就是:
2 <= 2所以:
Yes三十四、这道题最值得孩子掌握的4个算法思想
⭐ 思想1:不要每个询问重新跑
看到:
q=5×10^5
就要想到:
查询太多,要预处理。
⭐ 思想2:正着想很麻烦,就倒着想
正向:
"我现在出发,什么时候能到?"
反向:
"我必须什么时候之前到这里,才能赶上后面的车?"
后者更容易计算。
⭐ 思想3:把"最短路"换成"最晚时间"
普通Dijkstra:
最短距离本题:
最晚出发时间核心仍然是:
不断松弛、不断更新最优答案。
⭐ 思想4:优先队列帮助我们快速找到当前最优状态
priority_queue就像一个:
🏆 "时间排行榜"
谁的"最晚可出发时间"最值得优先处理,就先处理谁。
🎯 一张"算法藏宝图"
整道题可以压缩成:
                 🚇 末班车
                    │
                    ↓
              有很多询问
                    │
                    ↓
            每个询问都跑算法?
                    │
                    ↓
                   ❌
                    │
                    ↓
              先做预处理
                    │
                    ↓
          枚举每一个"终点"
                    │
                    ↓
       从终点向前反推最晚时间
                    │
                    ↓
        d[v][u] = 从u到v的
              最晚出发时间
                    │
                    ↓
        u → v,最晚发车 l
        行驶时间 t
                    │
                    ↓
       w=min(l,d[v]-t)
                    │
                    ↓
          优先队列不断松弛
                    │
                    ↓
             全部计算完成
                    │
                    ↓
          每个询问只比较一次
                    │
                    ↓
       s <= d[v][u] → Yes
       s >  d[v][u] → No
🧠 最后一句口诀
末班车,不问"最早到",改问"最晚走";
终点开始向前推,优先队列找最优;
车次时间取最小,所有终点先预处理;
询问来了查数组,一次比较就搞定!
这道题真正的难点不是优先队列本身,而是发现这个非常漂亮的转换:
"能不能到达?"
变成
"最晚什么时候出发还来得及?"
一旦这个思维转换想明白,后面的 d[v][u]、min()、优先队列和50万次询问,就全部串起来了。