rtk(Rust Token Killer)是一个用 Rust 写的单二进制 CLI 代理,2026 年 1 月创建,到 10 月 9 日已有 8.27 万 star,最新正式版是 10 月 2 日的 v0.51.0。它通过 agent 的 hook 拦截 shell 命令,把 git status、cargo test、cat 这类命令改写成 rtk git status、rtk read,执行后只把压缩过的输出交给模型,支持 Claude Code、Codex、Cursor、Gemini CLI 等十几种 agent。仓库简介写的是「LLM token 消耗减少 60-90%」,但官方文档 How RTK Savings Work 一页明确说明,这个比例衡量的是 Bash 输出的字节数,不是全部 token。本文依次讲它的工作方式、节省口径、在 Claude Code 里实际能覆盖多少,以及有损截断带来的风险。
简介和文档之间的这层差别,决定了 rtk 实际能省多少。
rtk 省的是 input token。它删掉的工具输出不会进入对话历史,之后每一轮请求都不用再发这一段,会话越长,累计省得越多。省多少取决于工具输出在每轮上下文里占多大比例。我用本机 Claude Code 最近 30 天、223 个会话、13729 轮请求的日志做了一次估算:工具输出约占每轮 input token 的 20.5%,其余是 system prompt、工具定义和双方的消息;工具输出里 Bash 占 71.5%,Bash 输出中命令能被 rtk 规则匹配的占 36.3%;按 rtk 官方给出的各命令压缩率折算,最多去掉全部工具输出的 18.4%,相当于每轮 input token 少约 4%。output token 它完全不碰。这还是上限,社区的独立测量普遍低于官方压缩率。
rtk 的价值是真实的:社区一份 2100 次的独立测量里,git log 输出被压掉 98%,ls 压掉 72%;跑测试时,它只把失败的用例交给模型。但它压缩的是上下文里的一块,把仓库简介里的 60-90% 当成 token 总量的降幅来预期,结果一定落空。
rtk 的实现原理:用 PreToolUse hook 改写 Bash 命令
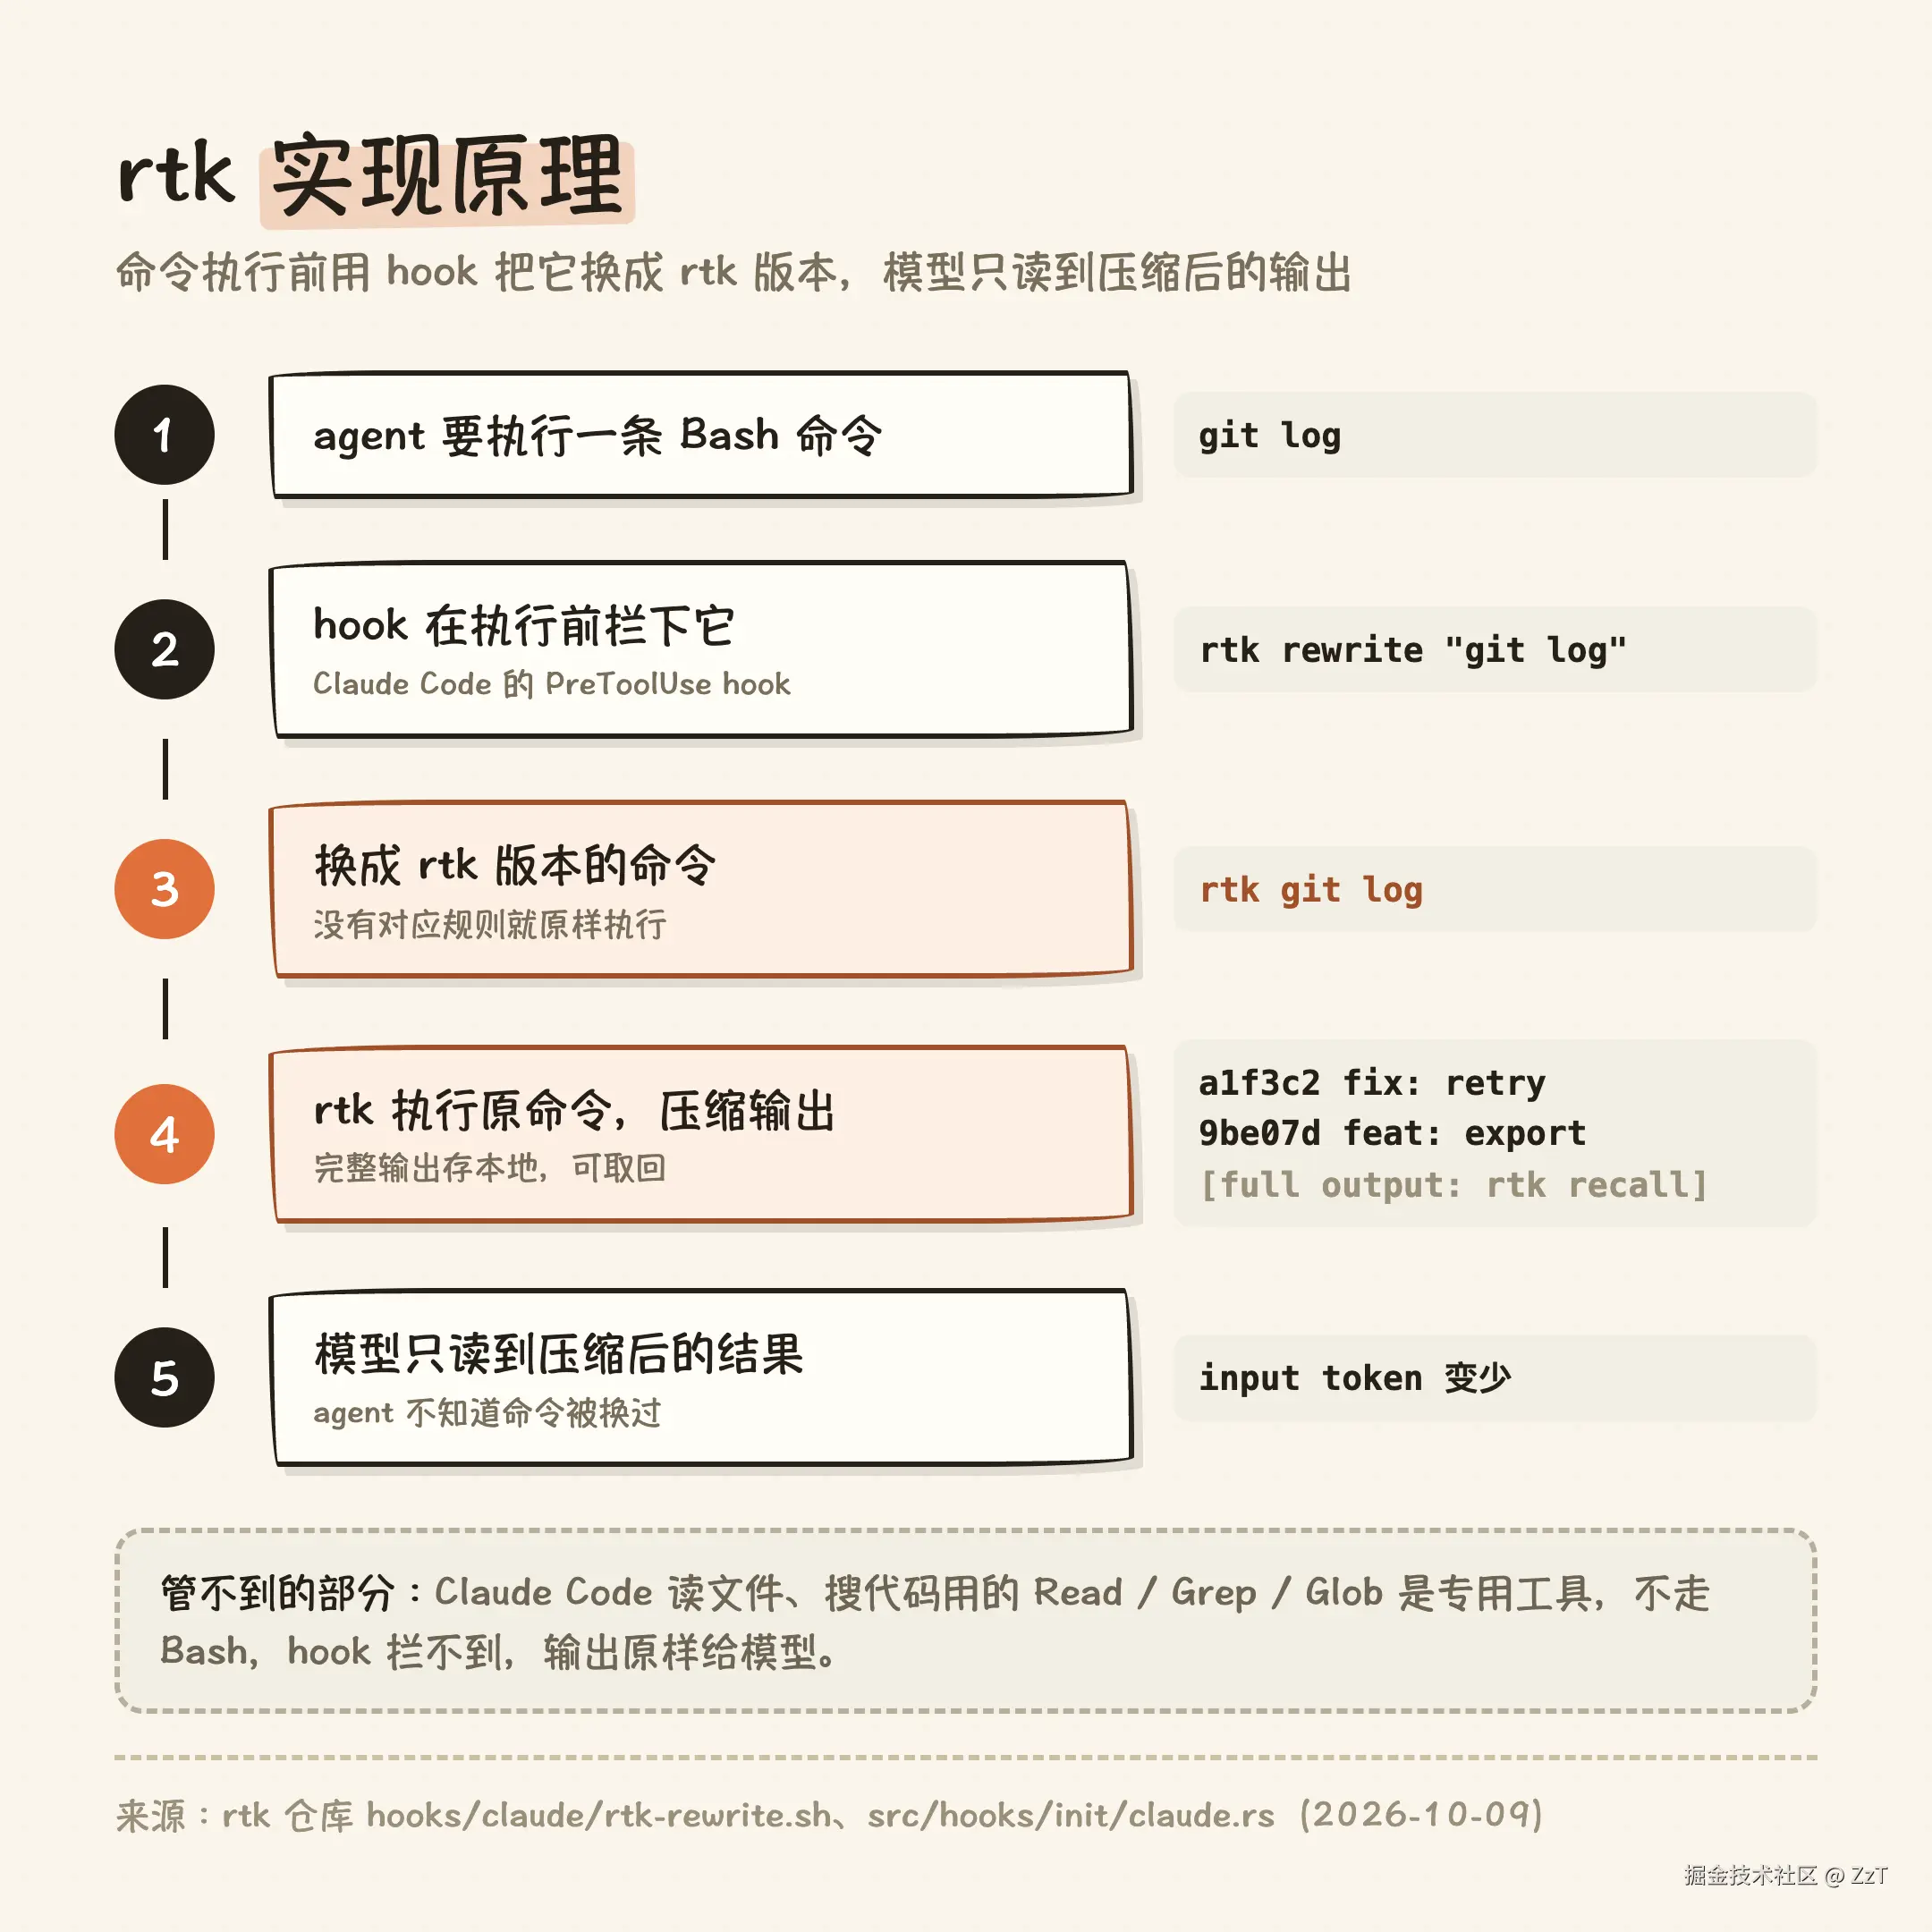
rtk init -g 会在 Claude Code 的 settings.json 里注册一个 PreToolUse hook,matcher 是 Bash。每次 agent 调用 Bash 工具,hook 脚本把命令交给 rtk rewrite,由 Rust 侧的规则表决定怎么处理:
rtk rewrite 退出码 |
含义 | hook 的处理 |
|---|---|---|
| 0 | 有对应规则,且匹配用户的 allow 规则 | 改写命令并自动放行 |
| 1 | 没有对应的 rtk 命令 | 原样执行 |
| 2 | 匹配 deny 规则 | 交给 Claude Code 自己的 deny 处理 |
| 3 | 匹配 ask 规则或没有规则 | 改写命令,但仍弹窗让用户确认 |
改写通过 hook 返回的 updatedInput 完成,agent 并不知道命令被换过。rtk 另外会写一份 RTK.md 引入 CLAUDE.md,默认级别只教模型怎么读压缩后的输出,不提 rtk 本身。
被截掉的内容不会直接丢弃。命令失败或列表被裁剪时,rtk 把完整输出存进本地 SQLite,并在压缩结果末尾附一行 [full output: rtk recall <hash>],agent 需要时可以取回原文。
「60-90%」只针对 Bash 输出字节
仓库简介和官方文档对同一组数字的表述并不一致:
- 简介:reduces LLM token consumption by 60-90% on common dev commands。
- 文档 How RTK Savings Work:cuts up to 90% of the bash output your agent reads,并单独强调这不等于账单减少 90%。
rtk gain 面板上的 token 数也是估算值。rtk 没有内置 tokenizer,按「字节数 ÷ 4」换算,文档说明百分比可信、绝对数不可当成账单。Issue #1973 里有用户的 rtk gain 显示「节省 119.9 亿 token,效率 100%」,原因是 rtk read 读大文件时,把模型本来就不会全部读入的部分也计成了节省。
社区有两份独立测量可以参考。#839(2026-03,v0.33.1)在 5 个仓库上跑了 2100 次,git log 实测 98%、ls 72%,git status 46%、git diff 20%,cat、grep 和 ruff 基本为 0 甚至略增。#4452(2026-10-05)用一个 agent benchmark 测整体效果,节省只有 0.045%。前者是逐命令测压缩率,后者是端到端测整体,两者差了几个数量级:单条命令压得再狠,摊到整个上下文里也只剩一小部分。
一份 30 天日志里 rtk 能覆盖的比例
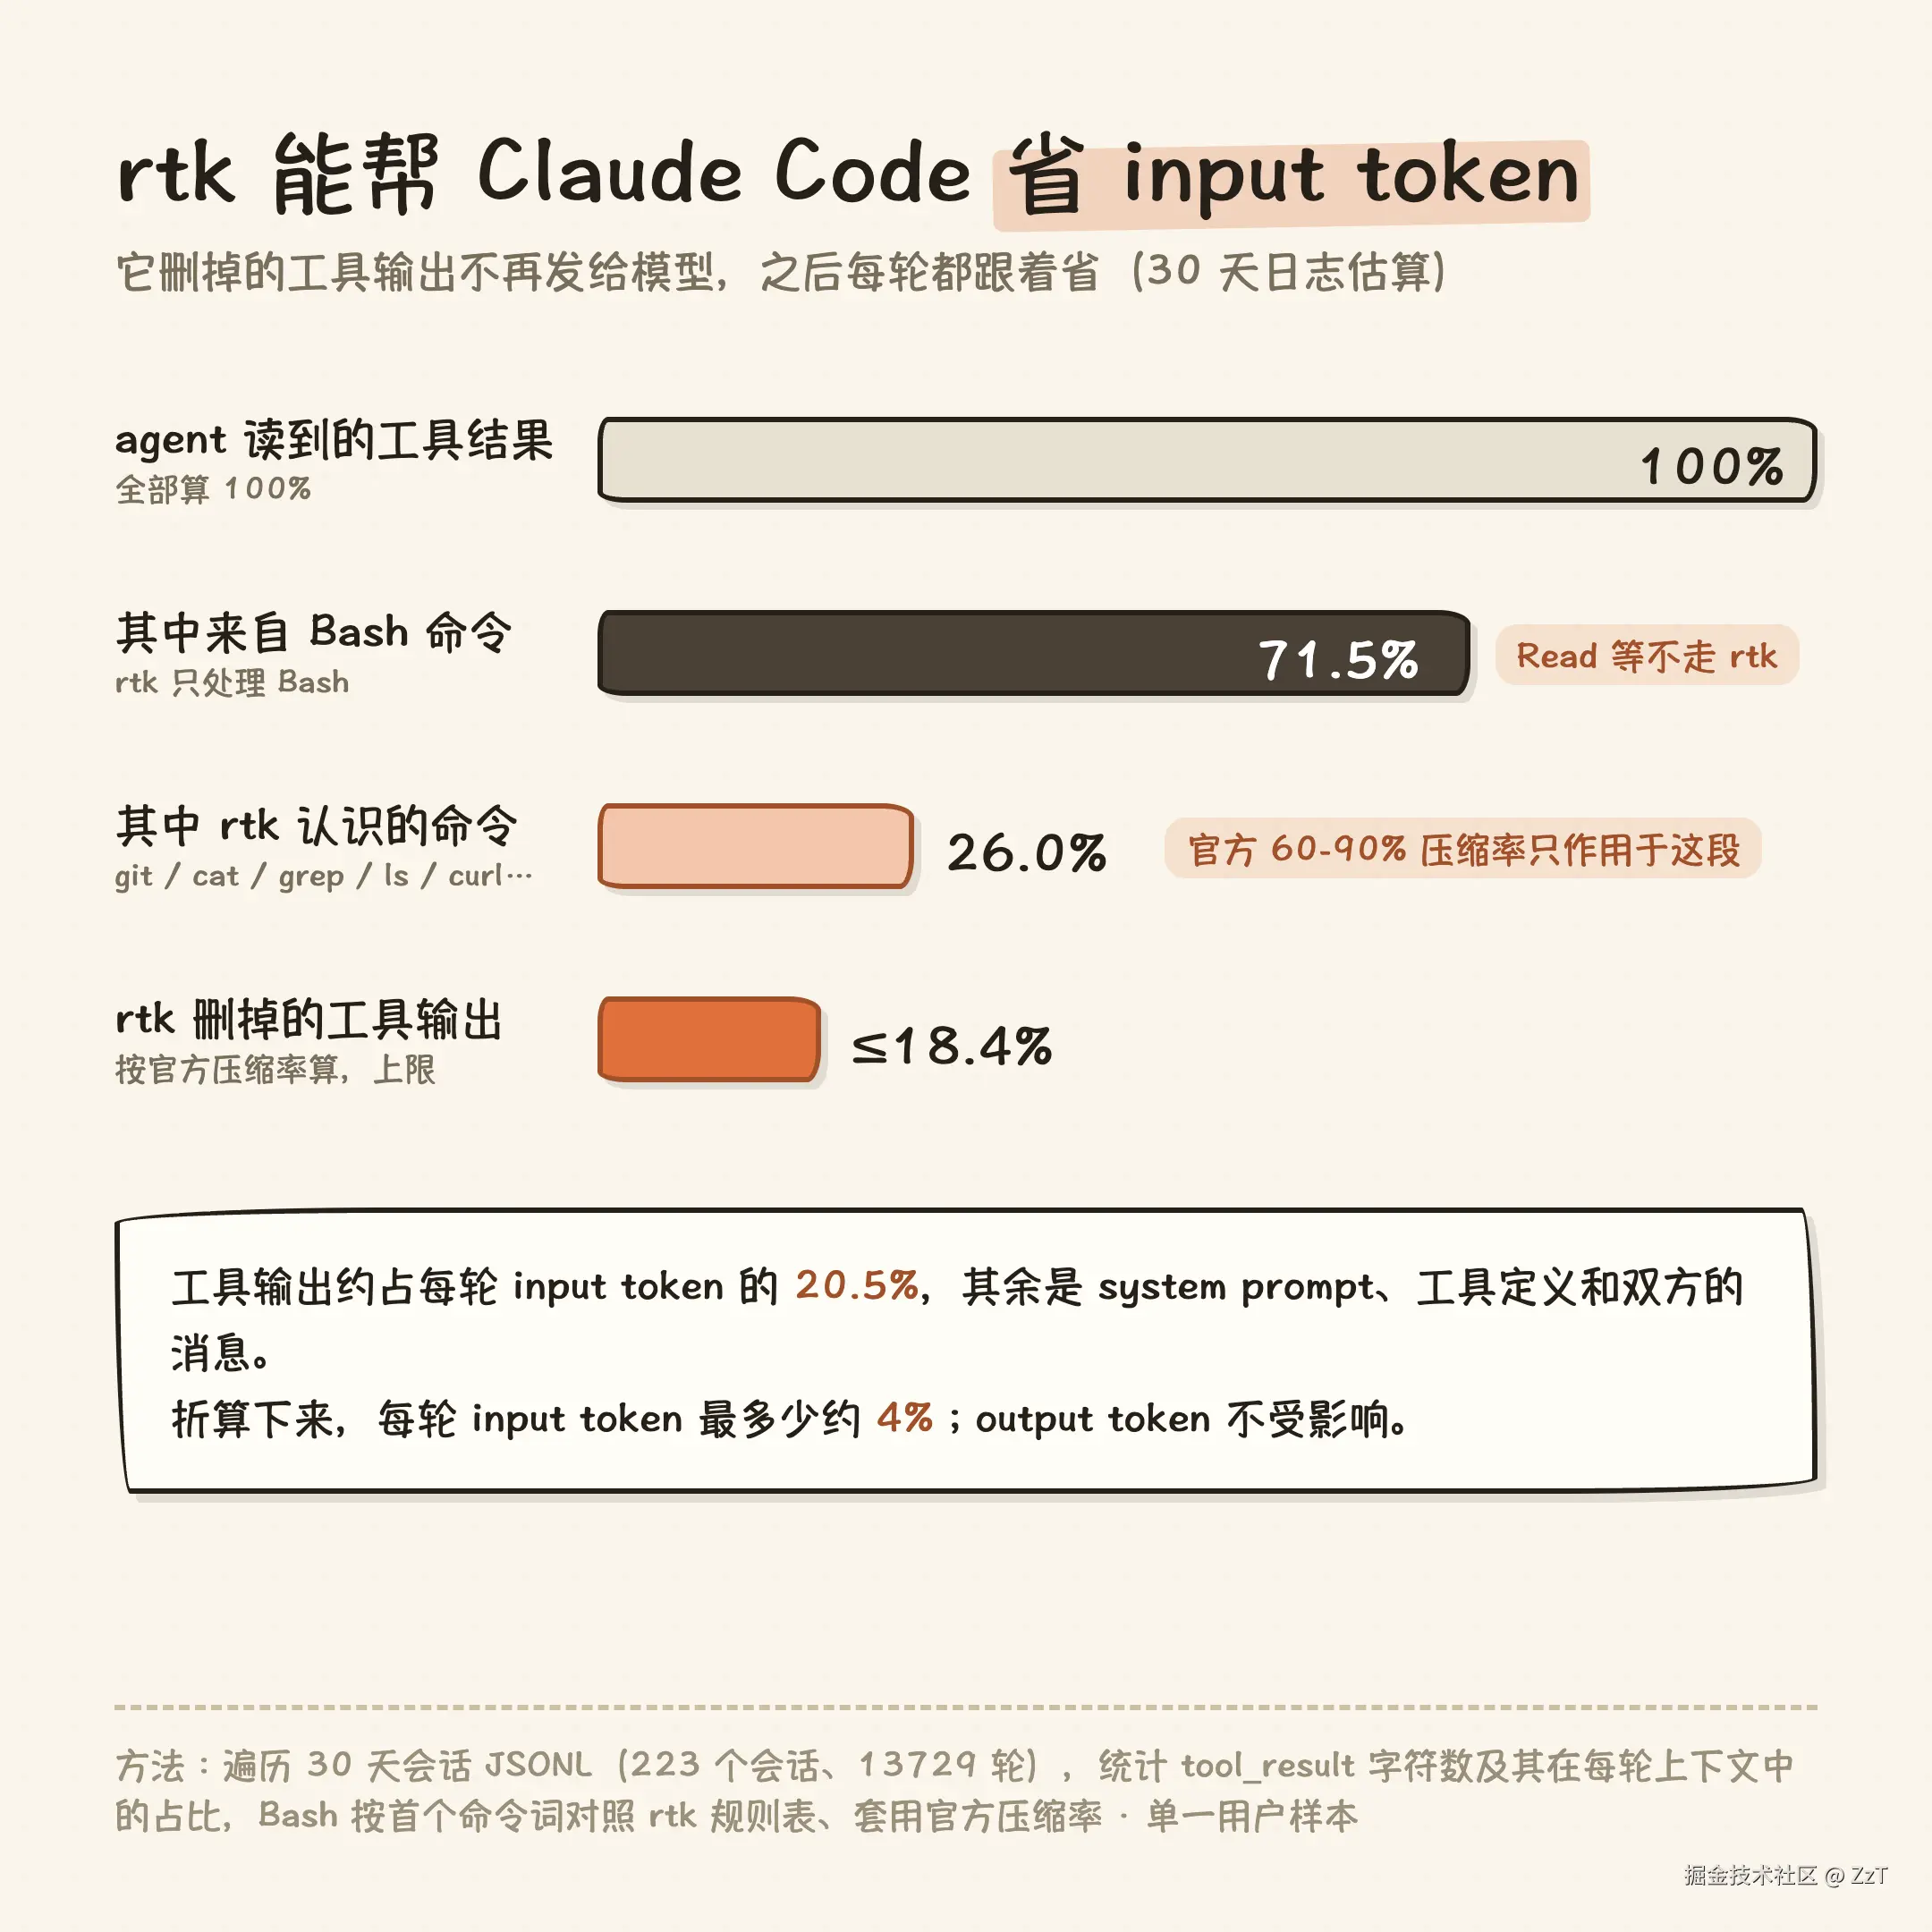
Claude Code 读文件、搜代码有专用的 Read、Grep、Glob 工具,它们不经过 Bash,rtk 的 hook 拦不到。Issue #538 指出,rtk 宣传的高压缩命令里 cat、grep、find 占了大头,而 Claude Code 的 system prompt 要求优先使用专用工具,这部分在 Claude Code 里本来就很少走 Bash。
上一节的估算方法如下:遍历 30 天内的会话 JSONL,按发起调用的工具汇总 tool_result 的字符数;Bash 调用再按首个命令词归类,对照 rtk 的规则表判断能否改写,套用官方文档里各命令的压缩率。结果:
| 环节 | 占比 |
|---|---|
| Bash 输出占全部工具返回内容 | 71.5% |
| Read 工具 | 20.6% |
| Bash 输出中能被 rtk 改写的命令 | 36.3% |
| 按官方压缩率折算,可去掉的 Bash 输出 | 25.7% |
| 折算为全部工具返回内容 | 18.4% |
| 工具输出占每轮 input token | 20.5% |
| 折算为每轮 input token | 约 4% |
这份日志的使用习惯偏重在 Bash 里直接 cat、sed、写循环,Bash 的占比比典型的 Claude Code 会话高。sed、for 循环、echo 和自写的 Python 脚本加起来占 Bash 输出的四成以上,rtk 都不改写。最后一行的算法是:每轮请求时,把此前累计的工具输出(按字符数粗略换算成 token)和该轮实际的 input token 对比,compact 之后重新计数。
Codex 的情况有所不同。Codex 读文件和搜索主要通过 shell 命令完成,没有 Claude Code 那样的专用读取工具,rtk 在 Codex 里能覆盖的比例在结构上会更高。
15 个文件上限与被吞掉的 go vet 报错
压缩分两类:去掉 ANSI 颜色、合并空行、折叠通过的测试,属于无损整理;对结果条数设上限、截断长行,属于有损截断。Issue #1313(2026-04)按当时的源码列出了几处上限:git status 最多显示 15 个修改文件和 10 个未跟踪文件,grep 总计 200 条、每个文件 25 条,git diff 每个文件 10 处改动。作者随后补充,这些截断大多会输出 ... +N more 标记,但模型是否会注意到这个标记,取决于当时的任务。
已经报告的问题包括:
- #2281 (v0.42.0,仍未关闭):Go 的过滤器把真实的
go vet编译错误过滤掉,输出「No issues found」,agent 据此判断检查通过。 - #409 / #831 :clippy 输出里的
help:修复建议被裁掉后,agent 拿不到关键信息,反复用略有不同的参数重跑同一条命令,额外消耗 token。#409 已修复,#831 仍在讨论更通用的处理方式。 - #1005 :
cat被改写成rtk read后,Claude Code 的 Edit 工具认为文件没被读过,编辑失败,agent 只能再读一次。
#1313 提议的「只做无损压缩」开关,目前在社区 fork 里实现,尚未合入主线。主线的缓解手段是前面提到的 recall 存档。
适用场景与安装建议
| 场景 | 建议 |
|---|---|
大量跑测试、构建、git log、gh、docker 的会话 |
适合,这些命令的冗长输出是 rtk 压缩率最高的部分 |
| Codex、Gemini CLI 等主要靠 shell 读写的 agent | 收益高于 Claude Code |
| Claude Code 的常规编码会话 | 收益有限,读文件和搜索走专用工具,不经过 rtk |
| Go 项目,或需要完整 diff 做代码审查 | 用 exclude_commands 排除相关命令,或按需加 RTK_DISABLED=1 |
| 以压缩账单为主要目标 | 优先缩短会话、及时 compact、把检索交给 subagent,rtk 作为补充 |
如果决定试用,有三件事可以先做:
- 装完先跑
rtk gain,再对照服务商后台的实际用量,不要只看 rtk 自己的统计。 - 在
config.toml的[hooks] exclude_commands里排除你依赖完整输出的命令。 - 遥测默认关闭,
rtk init时会询问是否开启,可以用rtk config确认当前状态。
rtk 解决的是「命令输出太啰嗦」这个具体问题,在这个范围内它做得很好。它的节省发生在会话的一个局部,评估时应该拿服务商账单上的数字去衡量,而不是 rtk gain 面板上的百分比。
参考
- rtk-ai/rtk
- How RTK Savings Work
- What RTK Optimizes
- Claude Code hook 实现 rtk-rewrite.sh
- Issue #839:5 个仓库、2100 次测量
- Issue #538:Claude Code 原生工具绕过 rtk hook
- Issue #4452:benchmark 节省 0.045%
- Issue #1313:无损模式与截断风险
- Issue #1973:gain 统计高估
- Issue #2281:Go 过滤器吞掉编译错误
- Issue #409:clippy 修复建议被裁导致重试
- Issue #831:过滤导致重试循环
- Issue #1005:read-before-write 规则被破坏