🧠项目介绍
代码
V1.0
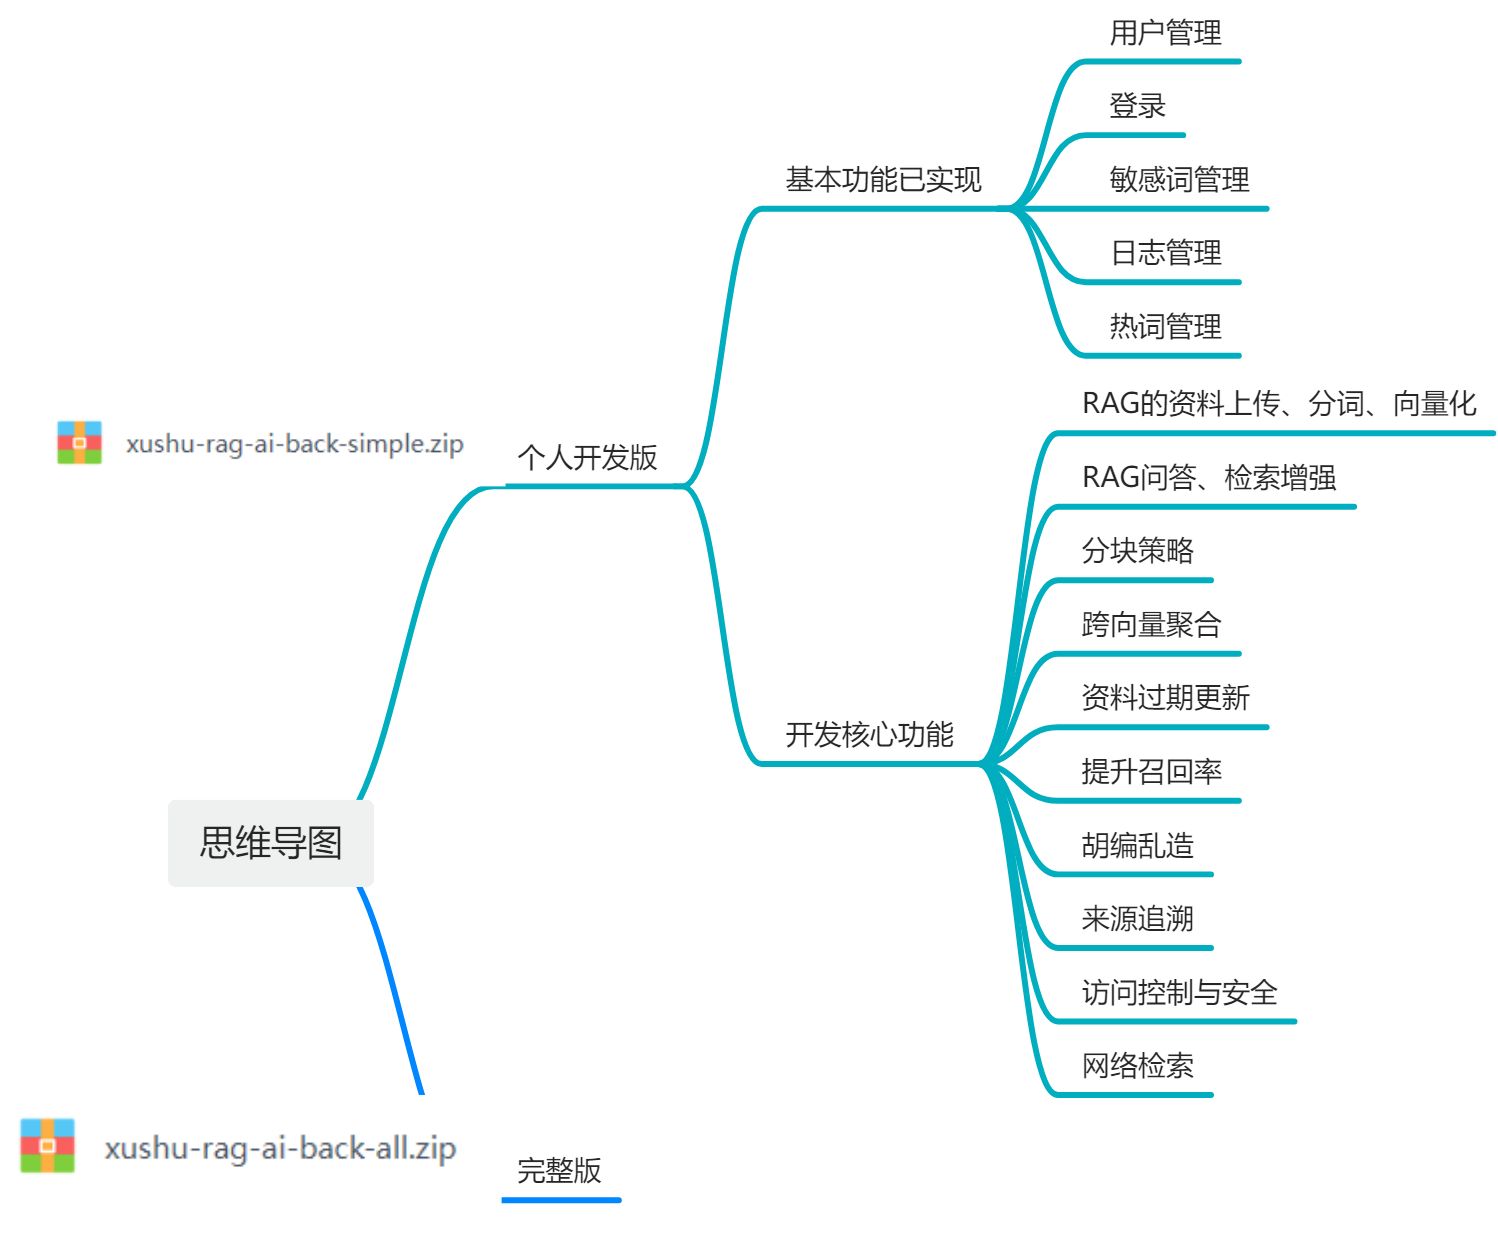
- 基本功能+核心功能
- 前端和后端分开2个文件夹
链接: https://pan.baidu.com/s/1CjcR6gfSflrO73IazWB2Gg
提取码: qij7
V2.0
- 前端和后端在一个文件夹, 方便vibe coding
- 加入supersql实现text-tosql
- 实现跨向量聚合问题
- 实现来源追溯
- 实现文档更新
- 实现提示词约束
- 实现rerank重排序
- 实现文档权限处理
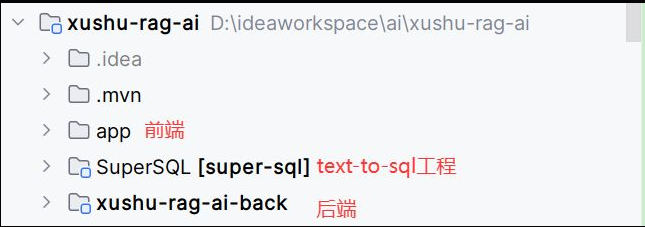
链接: (不对外提供)
V3.0(待完成)
- 实现查询改写
- 实现后置处理
- 实现文档图片处理
- 实现pageindex方式的知识库
核心功能
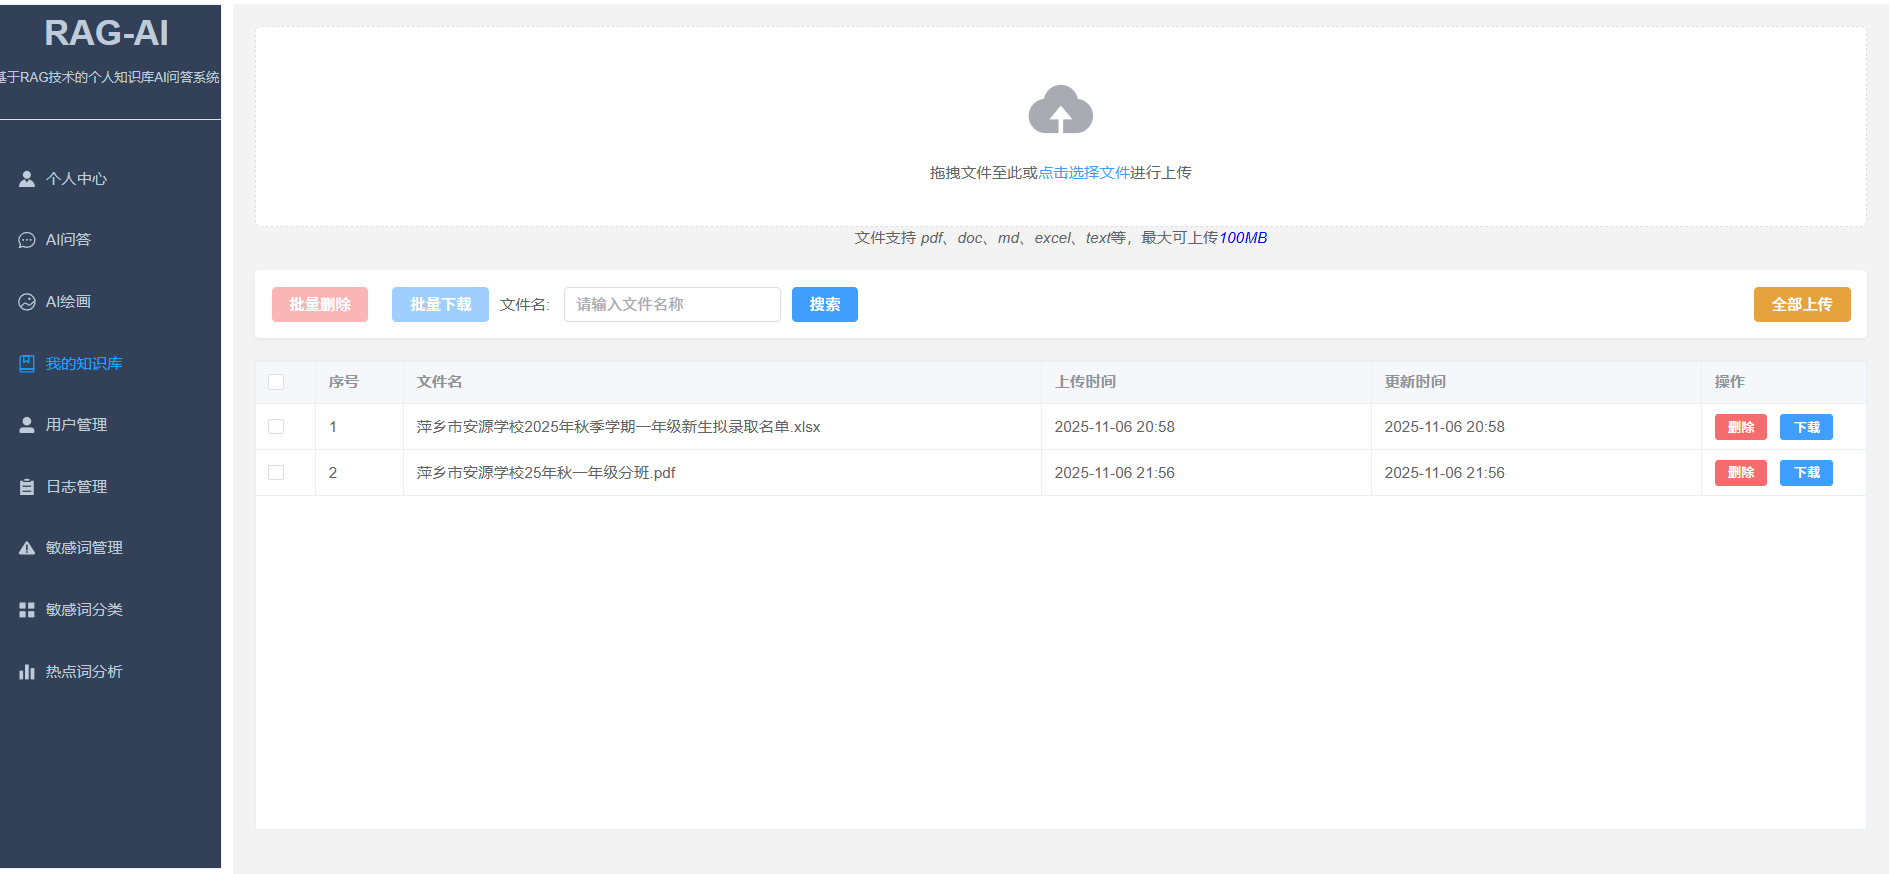
上传资料
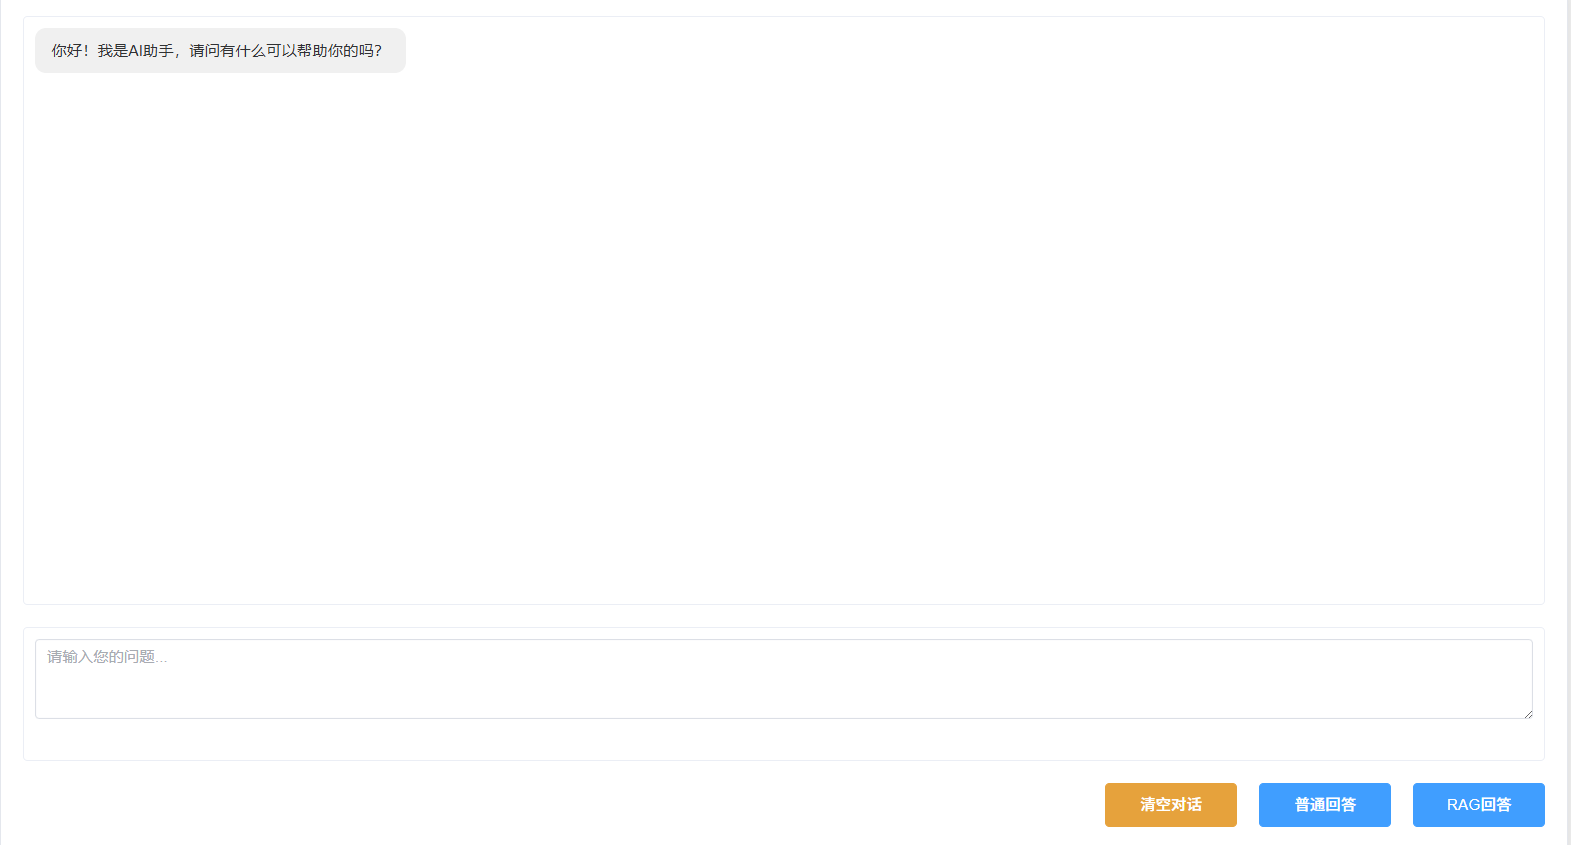
AI对话
其他功能
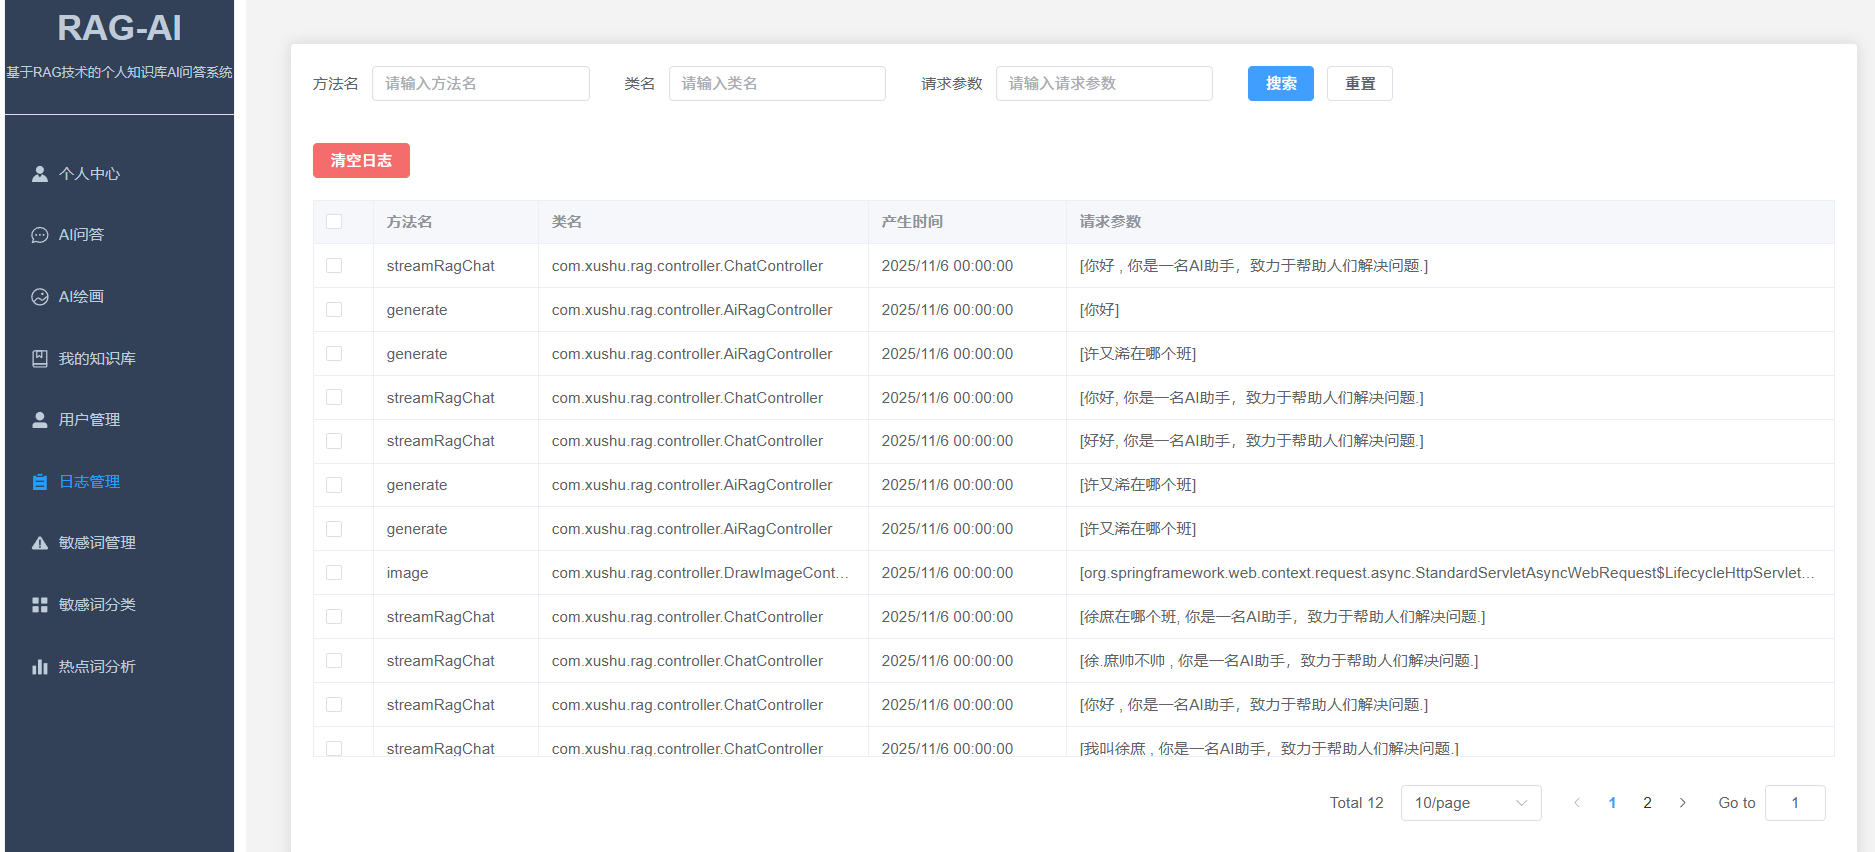
对话记录
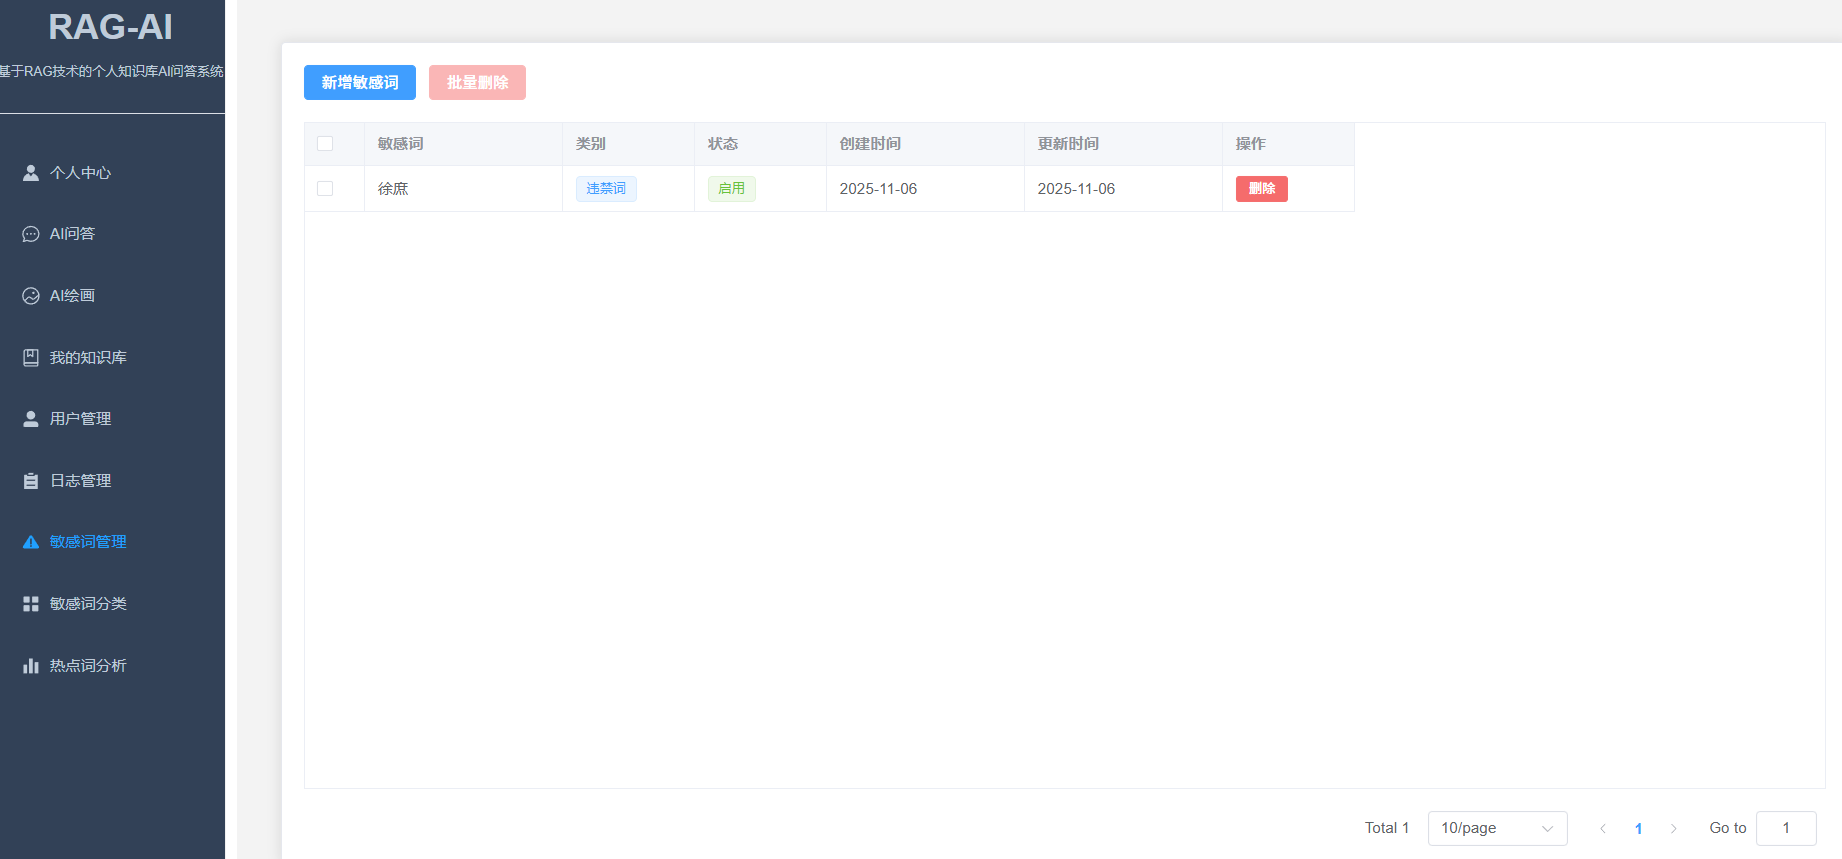
敏感词管理
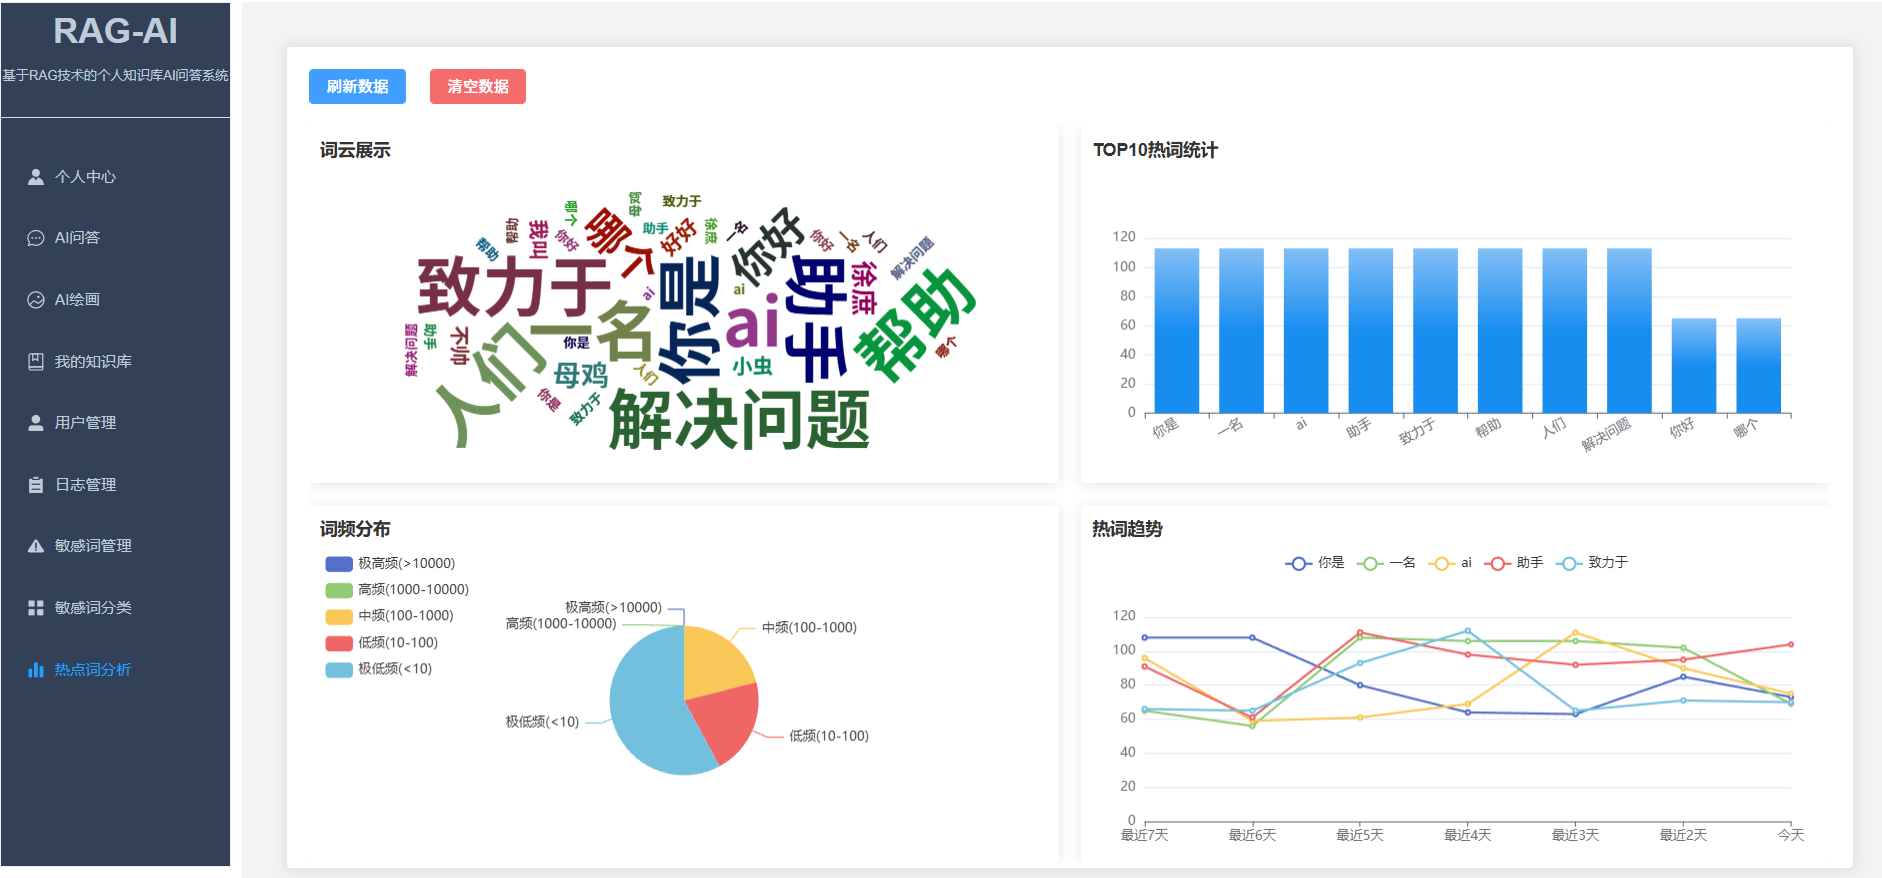
热词统计
前端(提供): Vue 3 + TypeScript + Vite
后端:
- Spring Boot: 3.4.2
- JDK: 17
- spring-ai: 1.0.0 GA
- spring-ai-alibaba: 1.0.0.2
- maven: 3.9.6
- Mysql 5.7
- Milvus(向量存储)
- LLM使用的通义千问
- 对象存储使用阿里云OSS (上传RAG资料)
🧠准备工作
1.1 有SpringAI或者大模型知识的基础
1.2 准备Milvus向量数据库安装
https://www.yuque.com/geren-t8lyq/ncgl94/am3t9qu8wkin39nx?singleDoc# 《Windows系统安装向量数据库Milvus》
1.3 准备阿里云OSS
开通OSS服务
- 登录阿里云官网;
- 将鼠标移至产品标签页,单击对象存储 OSS,打开OSS 产品详情页面;
- 在OSS产品详情页,单击立即开通。
创建存储空间
- 点击网页右上角控制台按钮进入控制台
- 选择我的云产品中的对象存储OSS
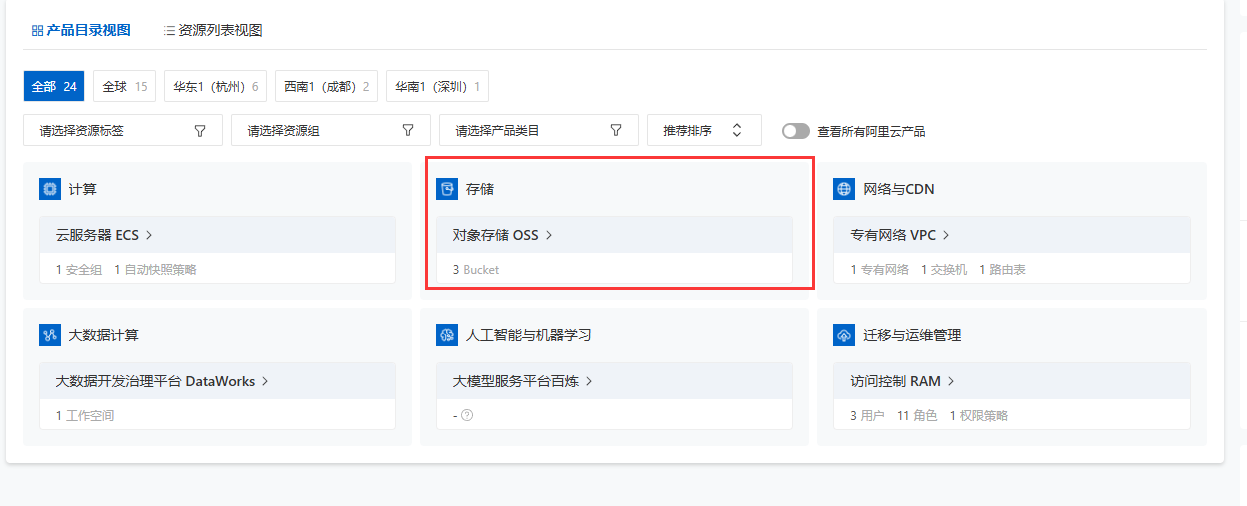
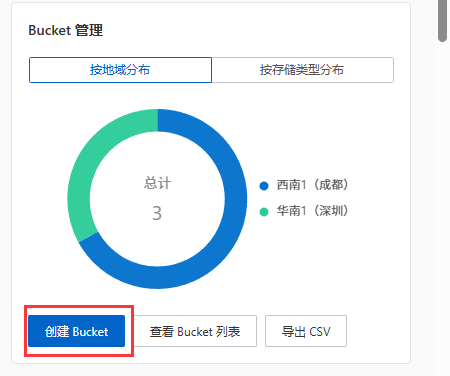
- 点击左侧存储空间的加号新建存储空间
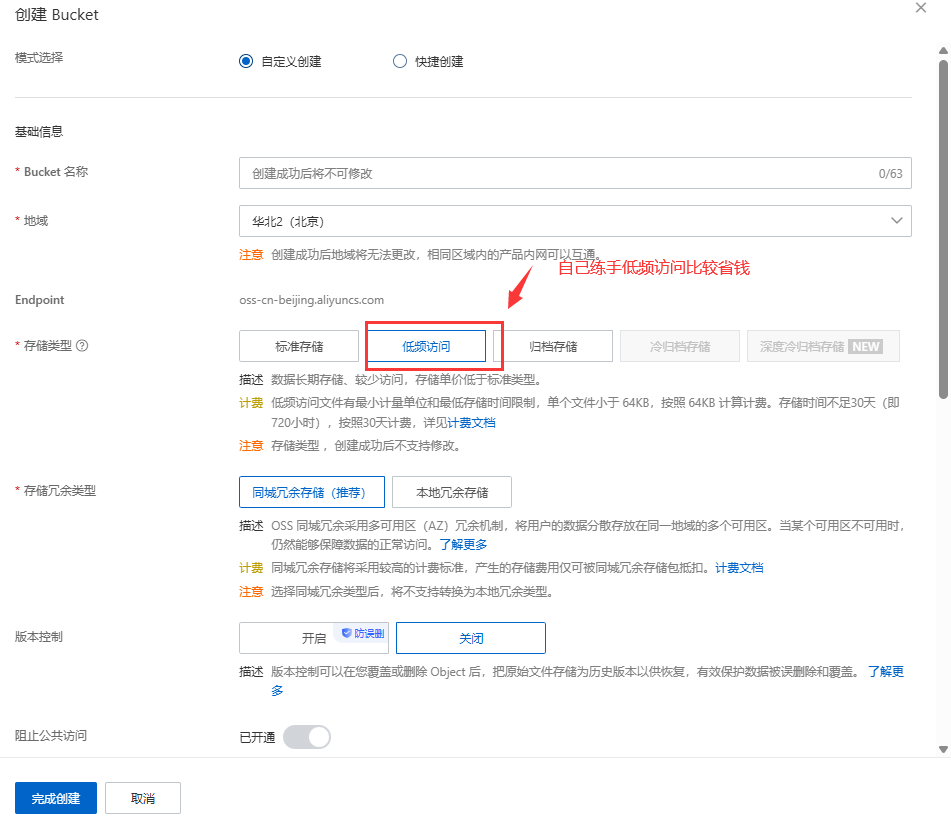
- 新建存储空间
- 全部用默认都没问题
- 我这里改了一下存储类型
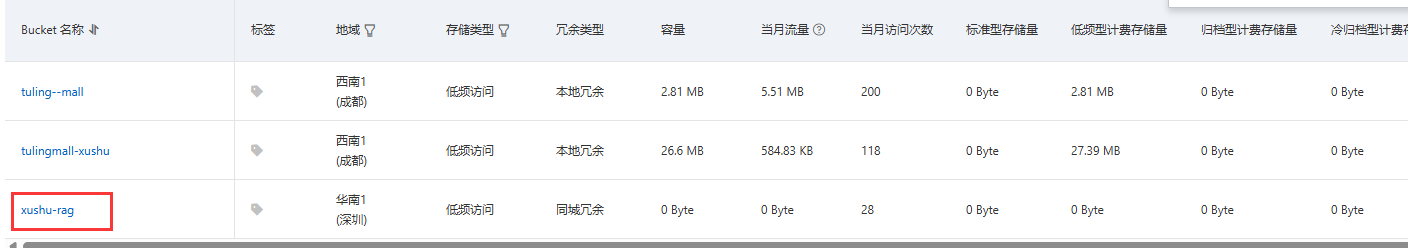
- 这个Bucket名字到时候需要设置到yaml代码里
跨域资源共享(CORS)的设置
由于浏览器处于安全考虑,不允许跨域资源访问,所以我们要设置OSS的跨域资源共享。
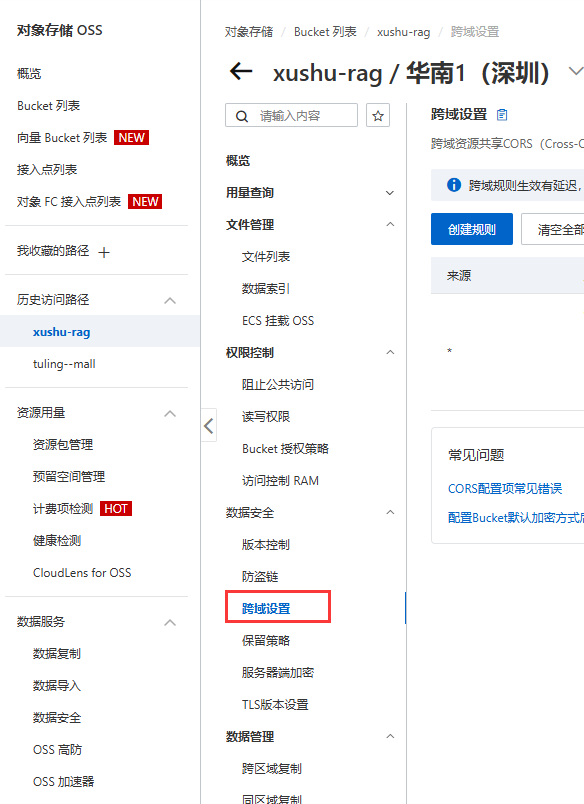
- 选择一个存储空间,打开其基础设置
- 点击跨越设置的设置按钮
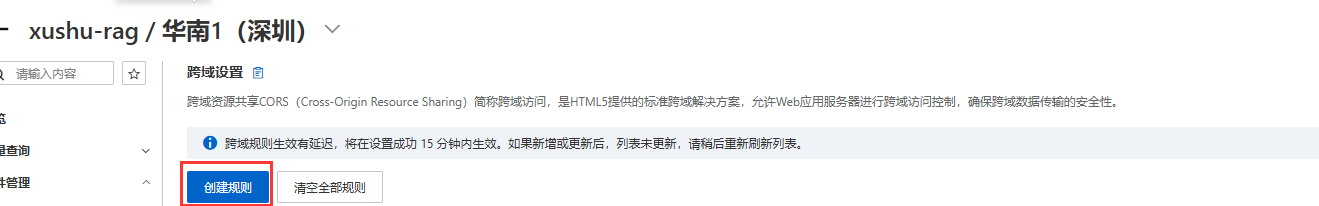
- 点击创建规则
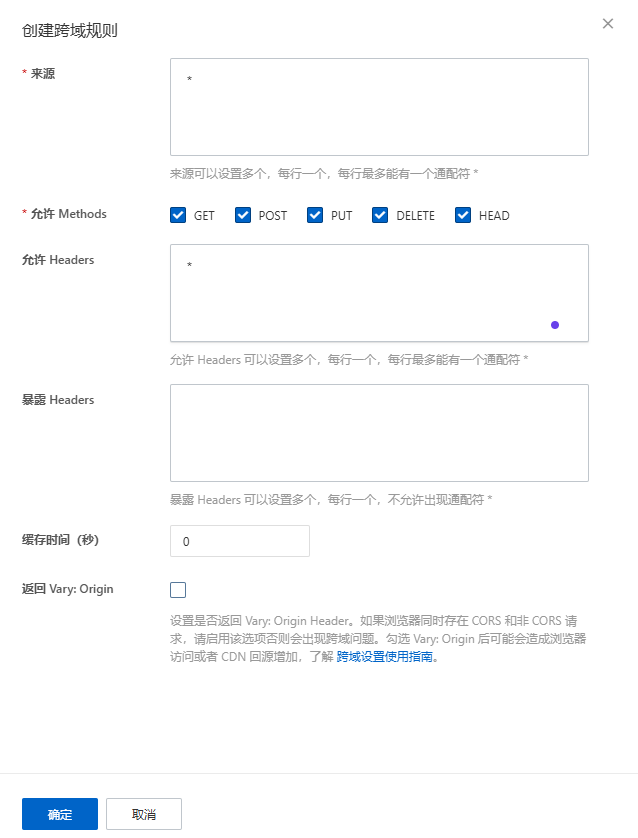
- 进行跨域规则设置
创建access-key-id、access-key-secret
- 右上角头像点击AccessKey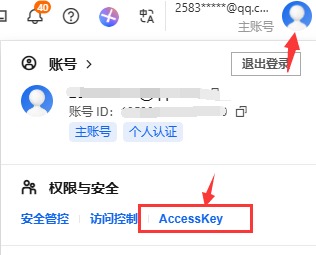
- 创建用户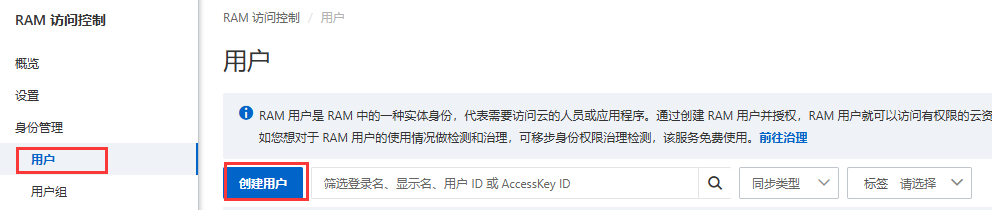
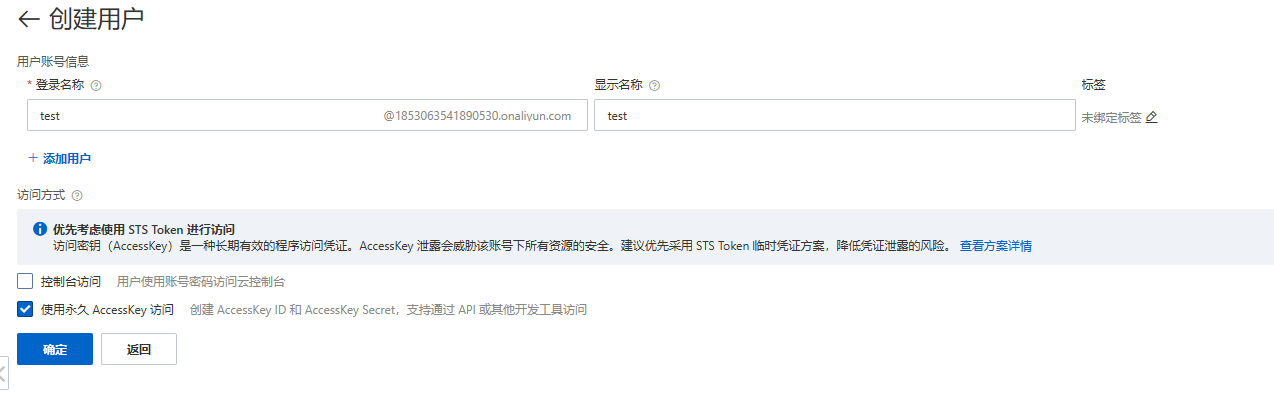
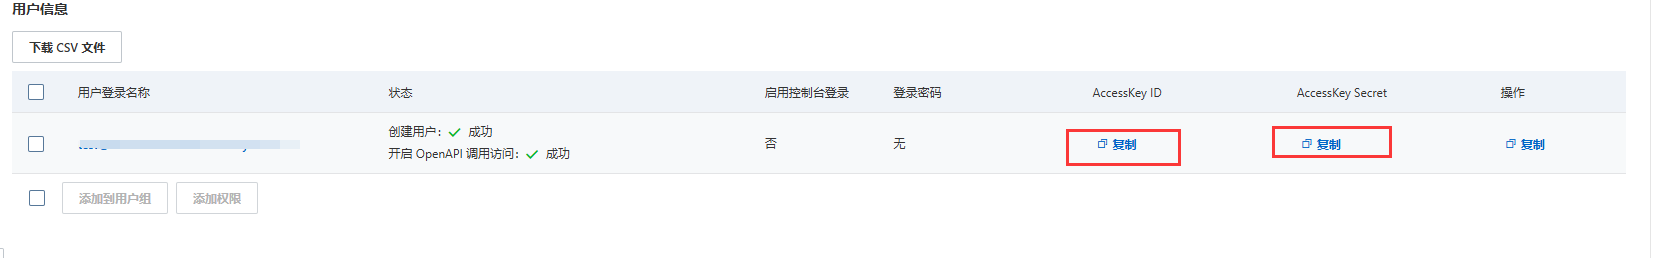
- 得到access-key-id、access-key-secret
- 可以放到环境变量到时候要修改代码的yam配置
1.4 准备通义千问模型
1.5 准备Mysql数据库
- 创建数据库
- 执行脚本:
1.6 准备Redis
这个不做说明
🧠启动项目:
后端
主要修改yaml:
- 修改数据库连接
yaml
  datasource:
    username: root
    password: 123456
    url: jdbc:mysql://localhost:3306/xushu_rag?serverTimezone=UTC
    driver-class-name: com.mysql.cj.jdbc.Driver
type: com.alibaba.druid.pool.DruidDataSource- 修改redis
yaml
  data:
    redis:
      port: 6379              # Redis 服务器端口,默认为 6379
#      password:               # Redis 密码,默认为空
      timeout: 5000ms         # 连接超时时间
      lettuce:
        pool:
          max-active: 8       # 最大连接数
          max-idle: 4         # 最大空闲连接数
          min-idle: 1         # 最小空闲连接数
max-wait: 2000ms- 修改osskey
yaml
aliyun:
  alioss:
    endpoint: oss-cn-shenzhen.aliyuncs.com
    access-key-id: ${alioss.access-key-id}
    access-key-secret: ${alioss.access-key-secret}
bucket-name: xushu-rag-
修改阿里百炼api_key
-
启动
前端
- 确定完成前端环境的搭建(包括vscode安装、nodejs安装、npm镜像)
前端环境准备:https://share.note.youdao.com/s/6i834wpP
- 在VsCode终端窗口中运行命令:npm install,下载相关依赖;
- 可选:修改端口
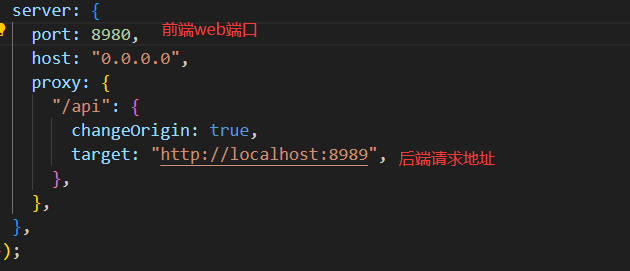
- 运行npm run dev:
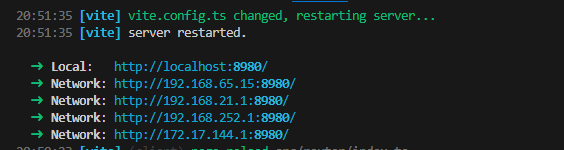
- 登录 admin/admin
🧠开发:
热词统计
- 通过定时任务统计对话日志
java
@Scheduled(cron = "0 0 * * * ?")

public void taskJob() {
    log.info("分词器定时任务开始执行");
    redisTemplate.delete("wordFrequencyList");
    // 获取所有的热词数据
    List<WordFrequency> wordFrequencies = wordFrequencyService.list();
    // 转为 Map key为word value为WordFrequency  判断是否存在
    Map<String, List<WordFrequency>> collectMap = wordFrequencies.stream().collect(Collectors.groupingBy(WordFrequency::getWord));
    StringBuilder text = new StringBuilder();
    // 获取所有日志
    List<LogInfo> list = logInfoService.list((Wrapper<LogInfo>) null);
    for (LogInfo logInfo : list){
        // 将日志中的参数转为字符串
        text.append(logInfo.getRequestParams());
    }
    String result = text.toString();
    // 分词
    Map<String, WordFrequency> newMap= new HashMap<>();
    try (StringReader reader = new StringReader(result)) {
        IKSegmenter segment = new IKSegmenter(reader, true);
        Lexeme lexeme;
        List<WordFrequency> wordFrequencyList = new ArrayList<>();
        List<WordFrequency> updateList = new ArrayList<>();
        while ((lexeme = segment.next()) != null) {
            // 只有一个字
            if (lexeme.getLength() <= 1){
                continue;
            }
            // 字符过长不统计, 没有意义
            if (lexeme.getLength() >=10){
                continue;
            }
            // 不存在的是新热词
            if (!collectMap.containsKey(lexeme.getLexemeText())){
                // 防止重复新增
                if(newMap.containsKey(lexeme.getLexemeText())){
                    WordFrequency wordFrequency = newMap.get(lexeme.getLexemeText());
                    wordFrequency.setCountNum(wordFrequency.getCountNum()+1);
                }
                else {
                    WordFrequency wordFrequency = new WordFrequency();
                    wordFrequency.setWord(lexeme.getLexemeText());
                    wordFrequency.setCountNum(1);
                    wordFrequency.setBusinessType("log");
                    wordFrequency.setCreateTime(new Date());
                    wordFrequency.setUpdateTime(new Date());
                    wordFrequencyList.add(wordFrequency);
                    newMap.put(lexeme.getLexemeText(), wordFrequency);
                }
                // 存在的修改数量+1
            }else if (collectMap.containsKey(lexeme.getLexemeText())){
                WordFrequency wordFrequency = collectMap.get(lexeme.getLexemeText()).get(0);
                wordFrequency.setCountNum(wordFrequency.getCountNum()+1);
                wordFrequency.setUpdateTime(new Date());
                updateList.add(wordFrequency);
            }
        }
        // 新增新热词、修改老热词数量
        wordFrequencyService.saveBatch(wordFrequencyList);
        wordFrequencyService.saveOrUpdateBatch(updateList);

    } catch (IOException e) {
        e.printStackTrace();
        }
    }
}
IKSegmenter------ik-analyzer(****java开源中文分词器)
IK Analyzer是一个开源的,基于java语言开发的轻量级的中文分词工具包。从2006年12月推出1.0版开始, IKAnalyzer已经推出了4个大版本。最初,它是以开源项目Luence为应用主体的,结合词典分词和文法分析算法的中文分词组件。从3.0版本开始,IK发展为面向Java的公用分词组件,独立于Lucene项目,同时提供了对Lucene的默认优化实现。在2012版本中,IK实现了简单的分词歧义排除算法,标志着IK分词器从单纯的词典分词向模拟语义分词衍化。
https://code.google.com/archive/p/ik-analyzer/
对话
xml
<dependency>
  <groupId>com.alibaba.cloud.ai</groupId>
  <artifactId>spring-ai-alibaba-starter-dashscope</artifactId>
  <version>${spring-ai-alibaba.version}</version>
</dependency>
配置
yaml
spring:
  ai:
    dashscope:
      api-key: ${ALI_AI_KEY}
java
@Tag(name = "AiRagController", description = "Rag接口")
@Slf4j
@RestController
@RequestMapping(ApplicationConstant.API_VERSION + "/ai")
public class AiRagController {

    // 对话代理
    ChatClient chatClient;
    VectorStore vectorStore;
    @Autowired
    private SensitiveWordService sensitiveWordService;

    public AiRagController(ChatModel  chatModel) {
        this.chatClient = ChatClient.builder(chatModel)
                // 隐式
                .defaultSystem("""
                        你是"XS"知识库系统的对话助手,请以乐于助人的方式进行对话
                        今天的日期:{current_data}
                        """)
                .build();
    }

    @Operation(summary = "rag", description = "Rag对话接口")
    @GetMapping(value = "/rag")
    @Loggable
    public Flux<String> generate(@RequestParam(value = "message", defaultValue = "你好") String message) throws IOException {

        // 敏感词过滤
        List<SensitiveWord> list = sensitiveWordService.list();

        for(SensitiveWord sensitiveWord: list){
            if (message.contains(sensitiveWord.getWord())){
                return Flux.just("包含敏感词:" + sensitiveWord.getWord());
            }
        }


        Flux<String> content = chatClient.prompt()
                .user(message)  // 用户提示词 显式
                .advisors(a -> a.param("current_data", LocalDate.now().toString()))
                .stream()// 流式方式
                .content();

        return  content;
    }
}
记忆
1.依赖(默认存储在jvm的map中)
java
        <!--对话记忆-->
        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-autoconfigure-model-chat-memory</artifactId>
</dependency>- 为chatClient添加记忆功能
java
public AiRagController(ChatModel  chatModel,ChatMemory chatMemory,
                           VectorStore vectorStore) {
        this.chatClient = ChatClient.builder(chatModel)
                // 隐式
                .defaultSystem("""
                        你是"XS"知识库系统的对话助手,请以乐于助人的方式进行对话
                        今天的日期:{current_data}
                        """)
                .defaultAdvisors(
                        PromptChatMemoryAdvisor.builder(chatMemory).build(),
                        SimpleLoggerAdvisor.builder().build()
                )
                .build();
        this.vectorStore=vectorStore;
}- 按不同用户记忆隔离
java
Flux<String> content = chatClient.prompt()
                .user(message)  // 用户提示词 显式
                .advisors(a -> a.param("current_data", LocalDate.now().toString()))
                //.call() // 同步方式
                .advisors(a -> a.param(ChatMemory.CONVERSATION_ID,userId))
                .stream()// 流式方式
                .content();
RAG
- 依赖
java
   <!--向量数据库 拦截器的支持-->
        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-advisors-vector-store</artifactId>
        </dependency>
        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-starter-vector-store-milvus</artifactId>
        </dependency>


        <dependency>
            <groupId>com.aliyun.oss</groupId>
            <artifactId>aliyun-sdk-oss</artifactId>
            <version>3.17.4</version>
</dependency>- 向量数据库配置
java
spring:
  ai:
    vectorstore:
      milvus:
        client:
          host: "localhost" # default: localhost
          port: 19530 # default: 19530
          username: "" # default: root
          password: "" # default: milvus
        databaseName: "default"
        collectionName: "vector_store" # default: vector_store
        embeddingDimension: 1536 # default: 1536
        indexType: IVF_FLAT # default: IVF_FLAT
        metricType: COSINE # default: COSINE
        initializeSchema: true # 自动创建集合

aliyun:
  alioss:
    endpoint: oss-cn-shenzhen.aliyuncs.com
    access-key-id: ${alioss.access-key-id}
    access-key-secret: ${alioss.access-key-secret}
    bucket-name: xushu-rag
embadding阶段
- 上传资料------>oss------>分词------>(向量化)存储向量数据库------>保存文件名到数据库
java
@Operation(summary = "upload", description = "上传附件接口")
    @PostMapping(value = "file/upload", headers = "content-type=multipart/form-data")
    public BaseResponse upload(@RequestParam("file") List<MultipartFile> files) {
        if (files.isEmpty()) {
            return ResultUtils.error(ErrorCode.PARAMS_ERROR, "请上传文件");
        }

        // 上传文件
        for (MultipartFile file : files) {

            // 上传OSS

            try {
                // 原文件名
                String originalFilename = file.getOriginalFilename();
                // 文件后缀
                String extension = originalFilename.substring(originalFilename.lastIndexOf("."));
                // 随机文件名(OSS)
                String objectName = UUID.randomUUID() + extension;
                String url = aliOssUtil.upload(file.getBytes(), objectName);

                // 向量化
                // 1. 读取文件 txt pdf docx doc
                Resource resource = file.getResource();
                TikaDocumentReader reader = new TikaDocumentReader(resource);
                List<Document> documents = reader.read();
                // 2. 分词
                List<Document> splitDocuments = tokenTextSplitter.apply(documents);
                // 3. 向量化
                // 4. 保存向量 自动调用向量模型向量化方法
                vectorStore.add(splitDocuments);

                // 持久化到数据库
                long currMillis = System.currentTimeMillis();
                aliOssFileService.save(AliOssFile.builder()
                        .fileName(originalFilename)
                        .vectorId(JSON.toJSONString(splitDocuments.stream().map(Document::getId).collect(Collectors.toList())))
                        .url(url)
                        .createTime(new Date(currMillis))
                        .updateTime(new Date(currMillis))
                        .build());

            }
            catch (IOException e) {
                log.error("上传文件失败", e);
                return ResultUtils.error(ErrorCode.SYSTEM_ERROR, "上传文件失败");
            }
            catch (Exception e) {
                log.error("上传文件失败", e);
                return ResultUtils.error(ErrorCode.SYSTEM_ERROR, "向量化失败");
            }
        }
        return ResultUtils.success("文件上传成功");
    }
检索阶段
java
Flux<String> content = chatClient.prompt()
.user(message) // 用户提示词 显式
.advisors(a -> a.param("current_data", LocalDate.now().toString()))
//.call() // 同步方式
.advisors(a -> a.param(ChatMemory.CONVERSATION_ID,userId))
.advisors(QuestionAnswerAdvisor.builder(vectorStore)
.searchRequest(
SearchRequest.builder()
.query(message)
.similarityThreshold(0.1d).topK(5)
.build()
)
.build())
.stream()// 流式方式
.content(); 分块策略
代码写得再好,不如数据洗得好 。你需要建立一套 "数据准入机制":
最佳分块策略?
:::color3
没有绝对的"最佳"分块策略,只有最适合你数据特性和业务场景的策略。
建议提供多种分块策略的选择,让用户自己决定"什么样的数据"用"什么分块策略"
:::
在实际工程落地中,我们有一套**"黄金法则"**和几种主流的演进策略。以下我将从架构角度为你详细拆解。
分块(Chunking)本质上是在做权衡:
- 块太小:检索精准,但缺乏上下文,LLM可能看不懂(比如只检索到"是的,它是。")。
- 块太大:包含太多无关噪音,稀释了语义,且容易超出Embedding模型的窗口限制,增加成本。
2. 主流分块策略详解
1)固定大小分块
生成块的最直观和直接的方法是根据预定义的字符、单词或标记数量将文本分成统一的段。
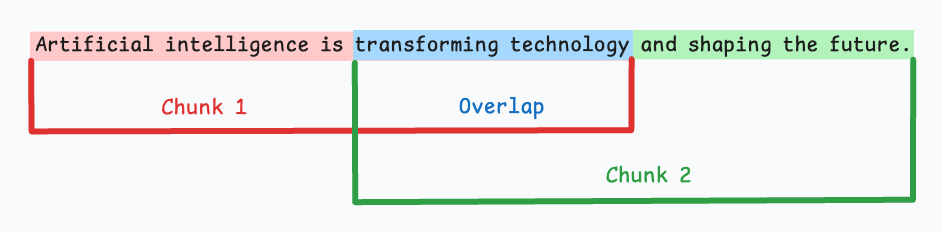
由于直接分割会破坏语义流,因此建议在两个连续的块之间保持一些重叠(上图蓝色部分)。
这很容易实现。而且,由于所有块的大小相同,它简化了批处理。
但有一个大问题。这通常会打断句子(或想法)。因此,重要的信息很可能会分散到不同的块之间。
2)语义分块
这个想法很简单。
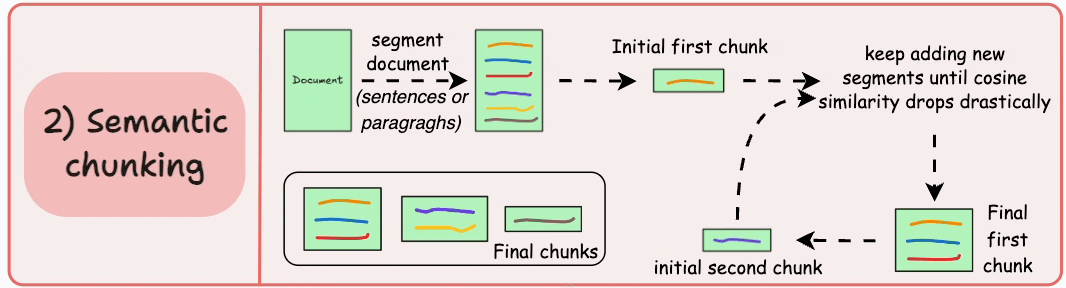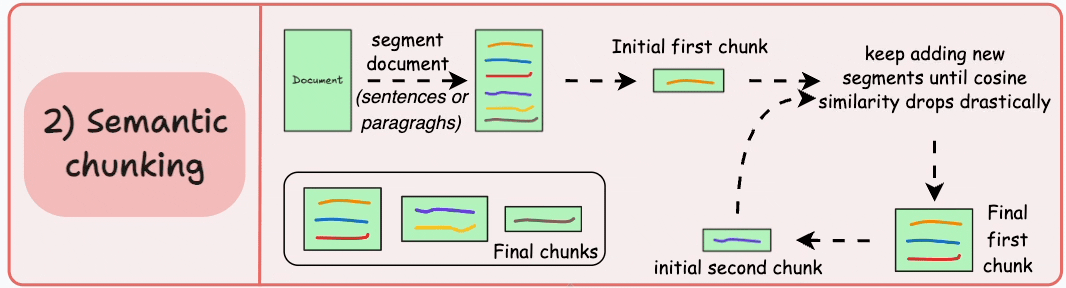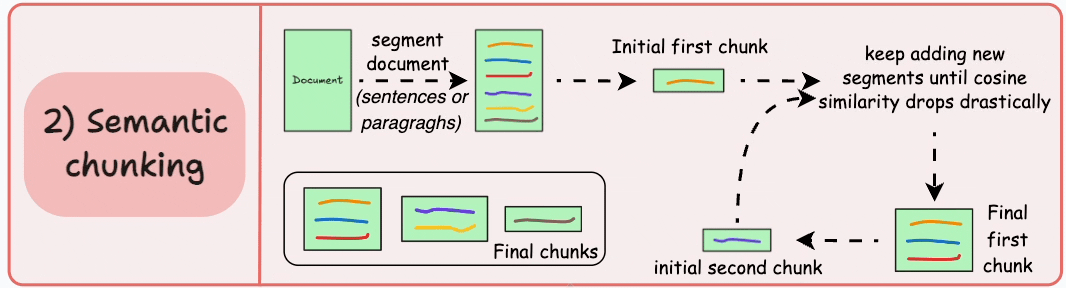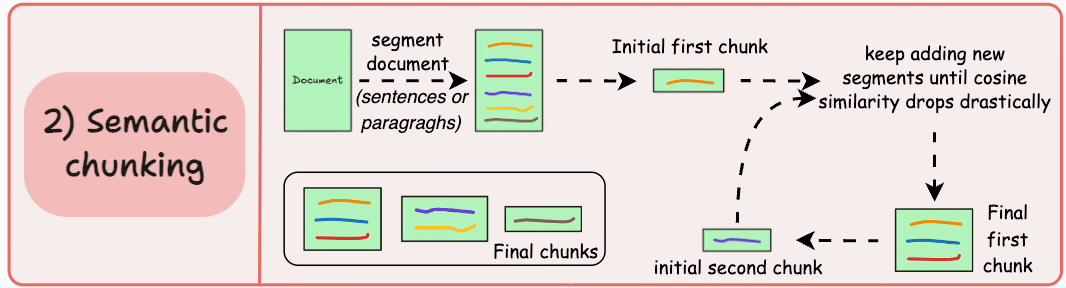
- 根据句子、段落或主题部分等有意义的单位对文档进行细分。
- 接下来,为每个片段创建嵌入。
- 假设我从第一个片段及其嵌入开始。
- 如果第一个段的片段与第二个段的片段具有较高的余弦相似度,则这两个段形成一个块。
- 这种情况一直持续到余弦相似度显著下降。
- 一旦发生这种情况,我们就开始新的部分并重复。
输出可能如下所示:

与固定大小的块不同,这保持了语言的自然流畅并保留了完整的想法。
由于每个块都更加丰富,它提高了检索准确性,进而使 LLM 产生更加连贯和相关的响应。
一个小问题是,它依赖于一个阈值来确定余弦相似度是否显著下降,而这个阈值在不同文档之间可能会有所不同。
3)递归分块
这也很简单。
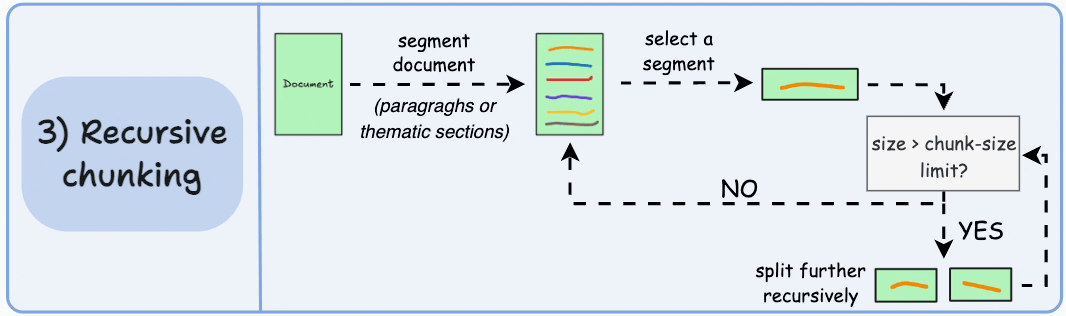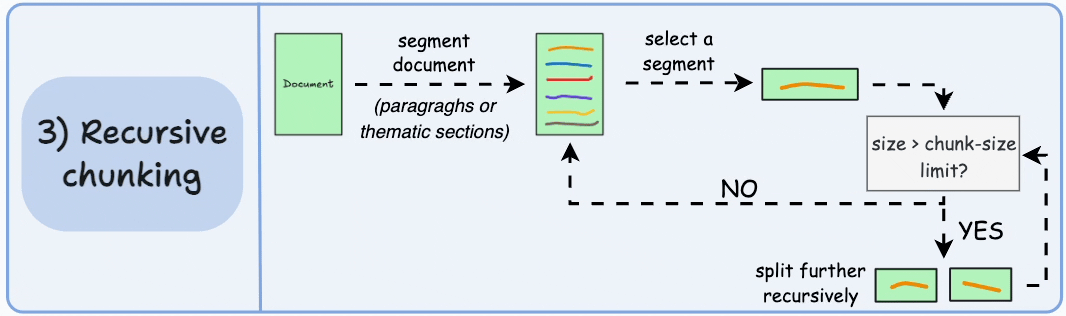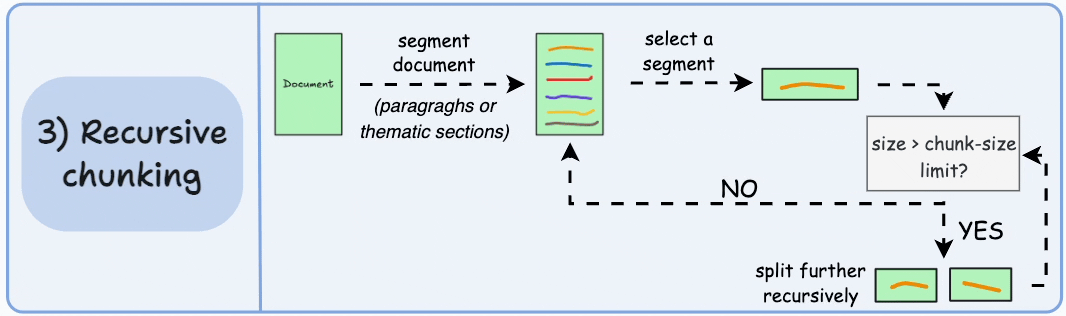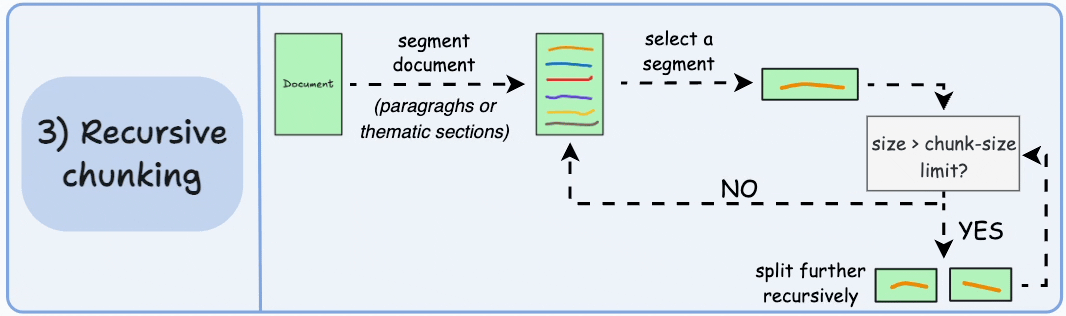
首先,根据固有分隔符(如段落或章节)进行分块。
接下来,如果每个块的大小超出了预定义的块大小限制,则将其拆分成更小的块。但是,如果块符合块大小限制,则不再进行进一步拆分。
输出可能如下所示:

如上图:
- 首先,我们定义两个块(紫色的两个段落)。
- 接下来,第 1 段被进一步分成更小的块。
与固定大小的块不同,这种方法还保持了语言的自然流畅性并保留了完整的想法。
然而,在实施和计算复杂性方面存在一些额外的开销。
4)基于文档结构的分块
这是另一种直观的方法。
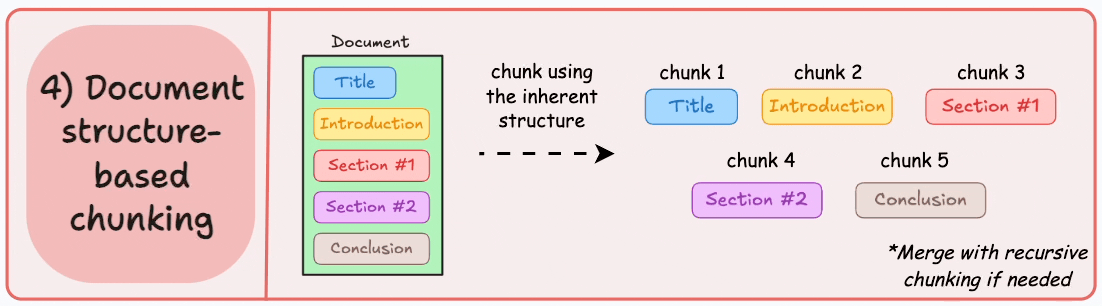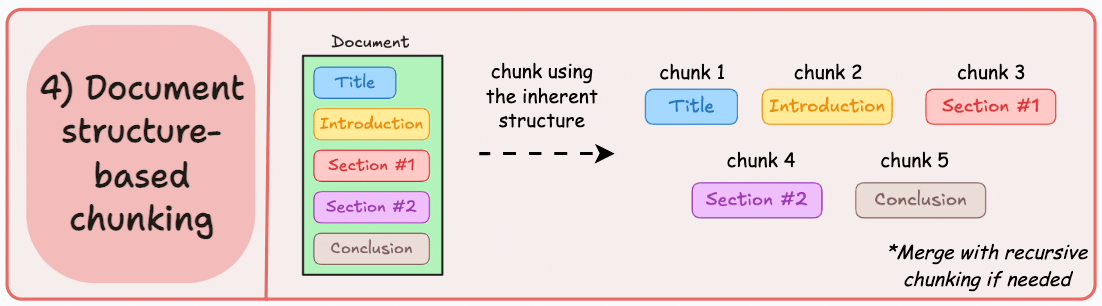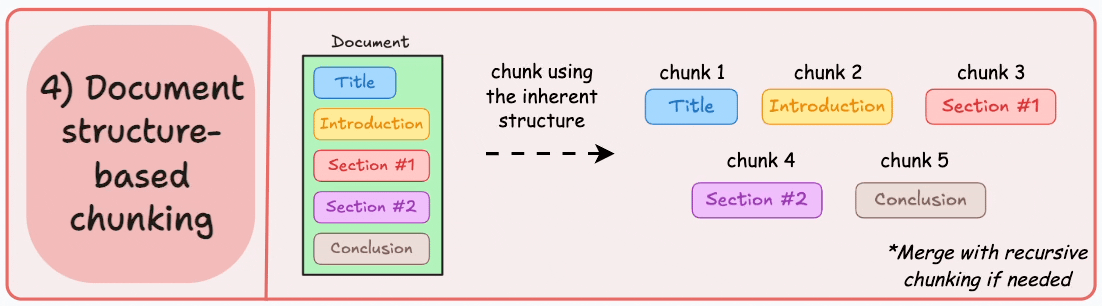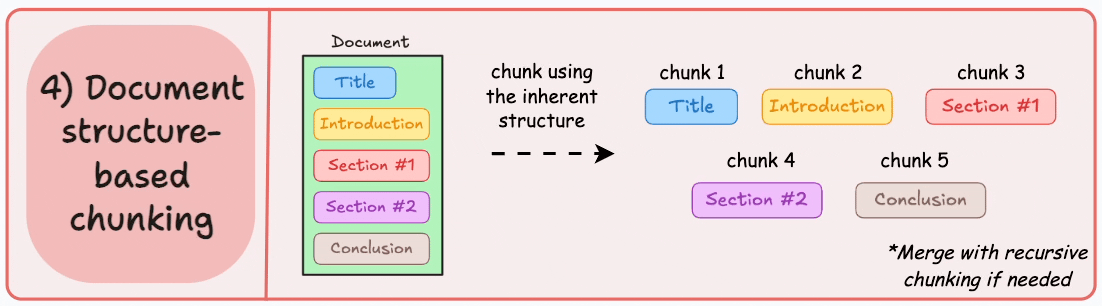
它利用文档的固有结构(如标题、章节或段落)来定义块边界。
这样,它就通过与文档的逻辑部分对齐来保持结构完整性。
输出可能如下所示:
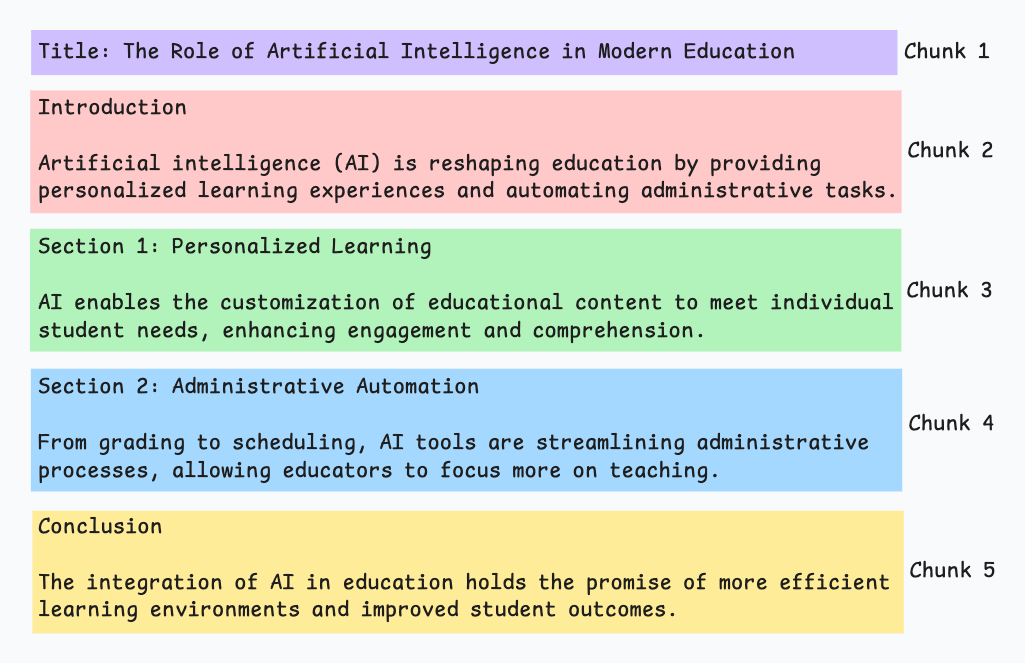
也就是说,这种方法假设文档具有清晰的结构,但事实可能并非如此。
此外,块的长度可能会有所不同,可能会超出模型令牌的限制。您可以尝试使用递归拆分进行合并。
5)基于LLM的分块
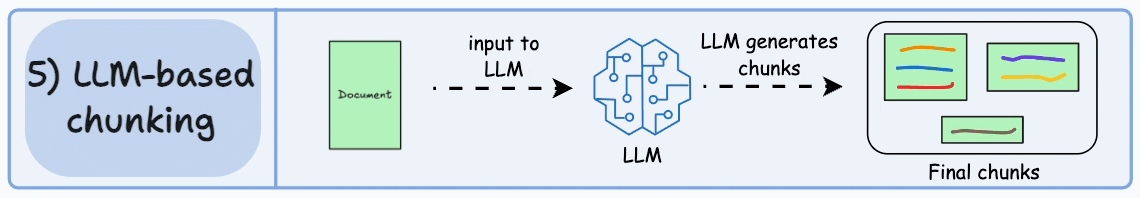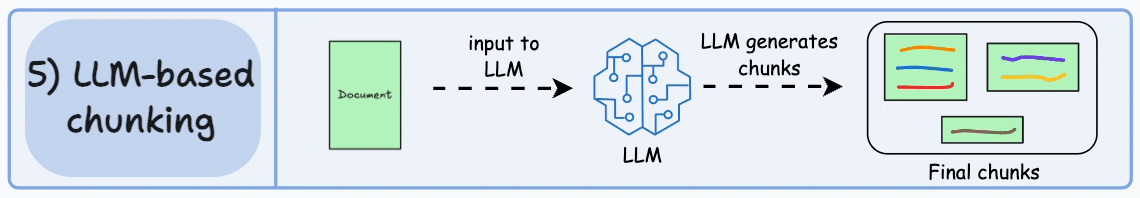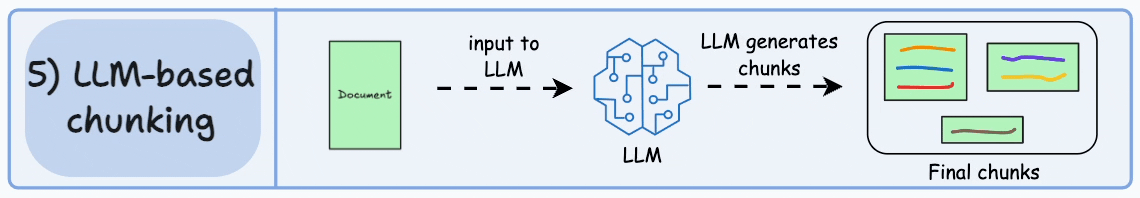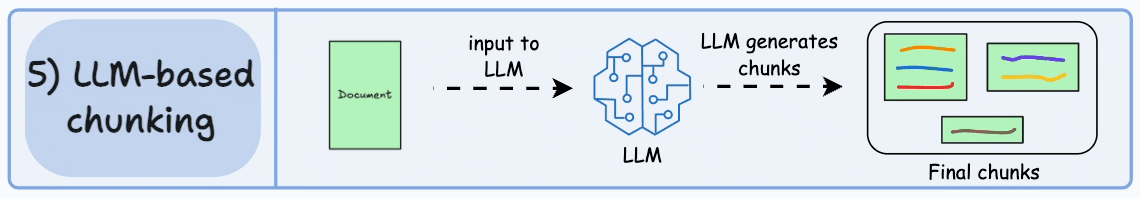
既然每种方法都有优点和缺点,为什么不使用 LLM 来创建块呢?
可以提示 LLM 生成语义上孤立且有意义的块。
显然,这种方法将确保较高的语义准确性,因为 LLM 可以理解超越简单启发式方法(用于上述四种方法)的上下文和含义。
唯一的问题是,它是这里讨论的所有五种技术中计算要求最高的分块技术。
此外,由于 LLM 通常具有有限的上下文窗口,因此需要注意这一点。
每种技术都有其自身的优势和劣势。
我观察到语义分块在很多情况下效果很好,但同样,您需要进行测试。
选择将在很大程度上取决于内容的性质、嵌入模型的功能、计算资源等。
我们很快就会对这些策略进行实际演示。
同时,如果您错过了,昨天我们讨论了构建依赖于成对内容相似性的强大 NLP 系统的技术(RAG 就是其中之一)。
跨向量聚合
| RAG实战:打破 Top-K 限制 如何解决"跨向量聚合"难题? |
|---|
| 🤔**** 痛点: 当用户问"张三出现在哪些班级"时,你的 RAG 系统还在傻傻地用 Top-K 检索全文吗? 本文详解 3 种架构,教你如何用最低成本实现精准统计与全局总结。 |
|---|
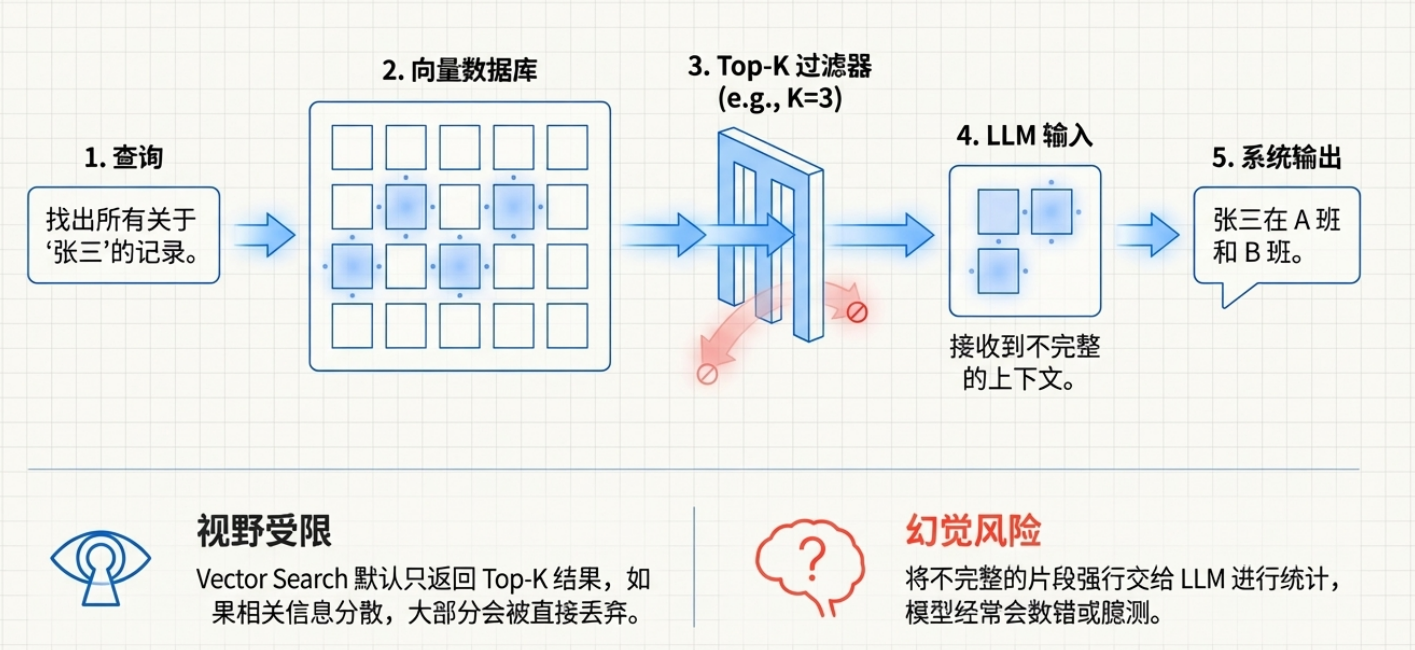
在 RAG 开发中,我们常遇到一个盲区:如何统计分散在大量 Chunk 中的信息?
如果你强行让 LLM 去阅读几十个片段然后"数数",它大概率会一本正经地胡说八道。针对"精准统计"和"全局总结"不同场景,这里有 3 种主流架构模式。
方案一:知识库隔离(KB Isolation)🛡️
这是 Dify 等主流检索增强生成平台的标准做法。
具体实现:
| **1**一个知识库等于一个文件或项目 不要把所有文档都扔进同一个巨大的向量索引。而是按照业务维度(如项目、合同、书籍)创建独立的集合。 |
|---|
| **2**对话时由用户选择知识库 当用户发起对话时,系统会让他先选择"要问哪个知识库"(如"项目 A 知识库"或"合同 B 知识库")。 |
| **3**在小范围内检索 系统只在用户选定的知识库中进行向量检索,彻底避免了"项目 A"的问题被"项目 B"的内容污染。 |
| ✅**** 优点 • 零噪音:物理级隔离 • 运维简单:用户自己选库 • 适合多租户场景 | ⚠️**** 缺点 • 用户体验差:需手动选库 • 无法跨库对比 • 仍受 Top-K 限制 |
|---|
| 🚨**** 但是,隔离知识库并不能解决"聚合"问题! 即使你已经把数据隔离到了"项目 A 知识库",当用户问: "项目 A 有哪些风险点?" 系统依然会遇到 Top-K 限制 : • 向量检索默认只返回 Top 5 个最相关的片段 • 如果"风险点"分散在二十个不同的会议纪要里,剩下的十五个依然会被丢弃 • 大语言模型只能看到五个片段,无法给出"全局总结" 知识库隔离只是解决了"噪音",但没有解决"召回不全"。 |
|---|
更致命的是,如果你的数据本身就是"表格"或"结构化数据",向量检索根本就不是最佳选择。
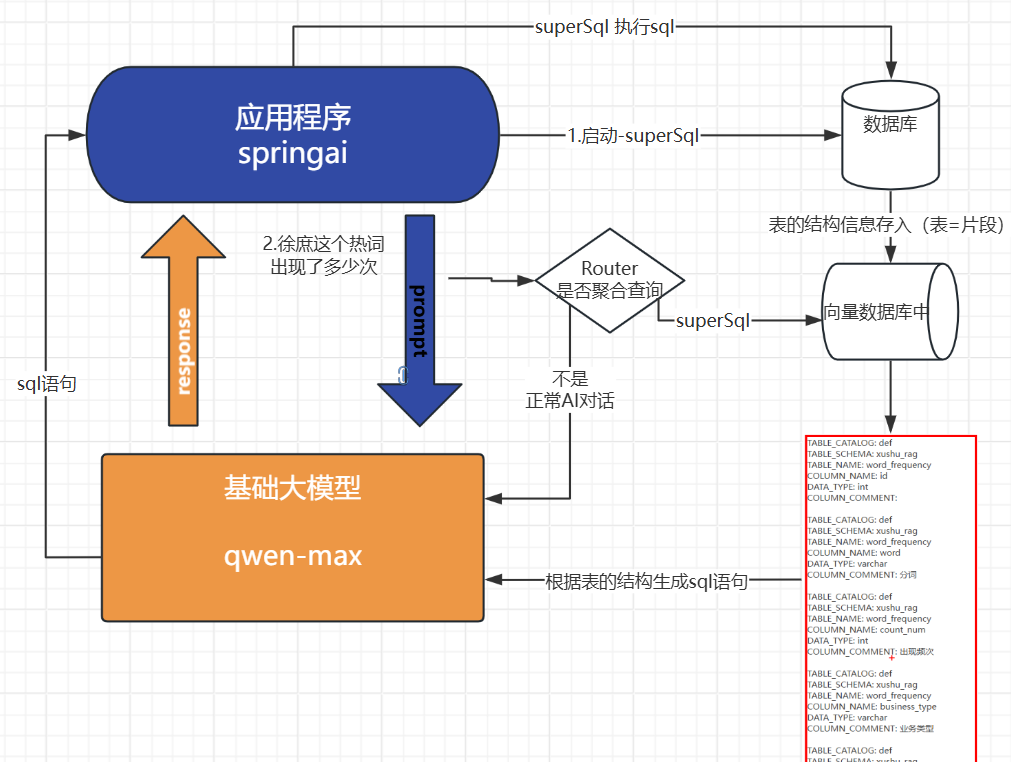
方案二:Text-to-SQL (结构化分流) 🏗️
**核心思路:**数据本身就是表格(如花名册),且查询涉及复杂的数值筛选(如"分数 < 60")。
架构设计:
通过superSql实现text-to-sql: https://github.com/guocjsh/SuperSQL/tree/master/super-sql-console
代码实现
- 克隆supersql代码到项目
- 引入依赖
xml
<dependency>
  <groupId>com.aispace.supersql</groupId>
  <artifactId>super-sql-spring-boot-starter</artifactId>
  <version>1.0.0-M1</version>
</dependency>- supersql配置
yaml
super-sql:
  init-train: false   # 第一次要设置为true ,之后改为true
  scope: ALONE  # ALL 整库训练, ALONE 单库训练
  schemas:
- schema: xushu_rag # 指定数据库- 生成Sql
这里提供2种解决方案:
1. <font style="color:rgb(51, 51, 51);">引入 </font>**<font style="color:rgb(51, 51, 51);">Router (路由)</font>**<font style="color:rgb(51, 51, 51);">,将结构化查询分流到 SQL 数据库。</font>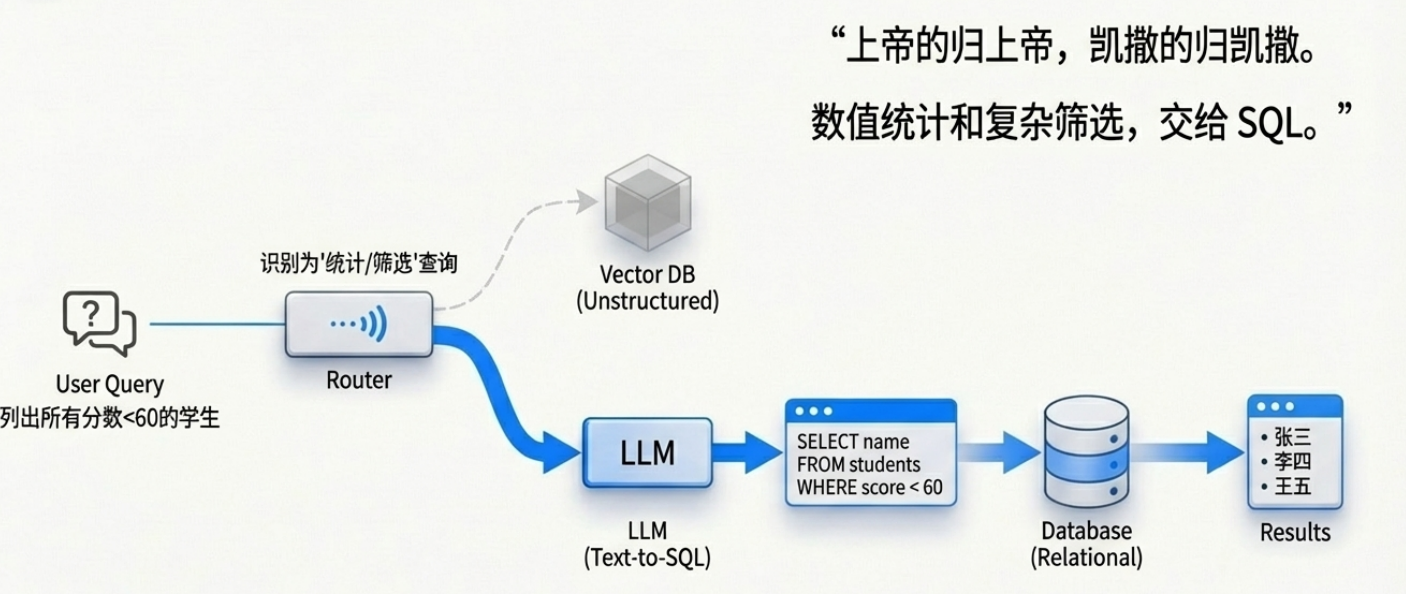
java
boolean isSql= chatClient.prompt()
.system("用户的查询是否涉及统计数据、求和、计数、平均值等聚合操作?")
.user(message)      // 徐庶这个热词出现了多少次
.call()
.entity(Boolean.class);

if(isSql){
    // 生成sql
    String actualSql=sqlEngine
    .setChatModel(chatModel)
    .setOptions(RagOptions.builder().topN(10).rerank(false).limitScore(0.1).build())
    .generateSql(question);
    // 执行sql
    Object object = sqlEngine.executeSql(actualSql);
    // 总结
    return sqlEngine.generateSummary(question,JSON.toJSONString( object));
}2. **通过****<font style="color:#DF2A3F;">Tool</font>**<font style="color:#DF2A3F;"> </font>,定义一个<font style="color:rgb(51, 51, 51);">结构化查询Tool. 进行Text-to-SQL 执行数据库查询。</font>这样LLM在识别到用户的对话涉及聚合,会自动调用tool, 而不需再通过LLM判断是否聚合操作,少一次LLM的远程访问。 推荐!
java
@Service
public class RagTool {


    @Autowired
    private SpringSqlEngine sqlEngine;

    @Autowired
    private ChatModel chatModel;
    @Tool(description = "涉及统计数据、求和、计数、平均值等聚合操作")
    public String getAggregationQuery(@ToolParam(description = "用户的提问") String question) {
        // 是聚合对话
        // 使用 SuperSQL 的 text-to-sql 功能生成实际的 SQL 查询
        String actualSql=sqlEngine
                .setChatModel(chatModel)
                .setOptions(RagOptions.builder().topN(10).rerank(false).limitScore(0.1).build())
                .generateSql(question);
            Object object = sqlEngine.executeSql(actualSql);

        return JSON.toJSONString( object);
    }
}
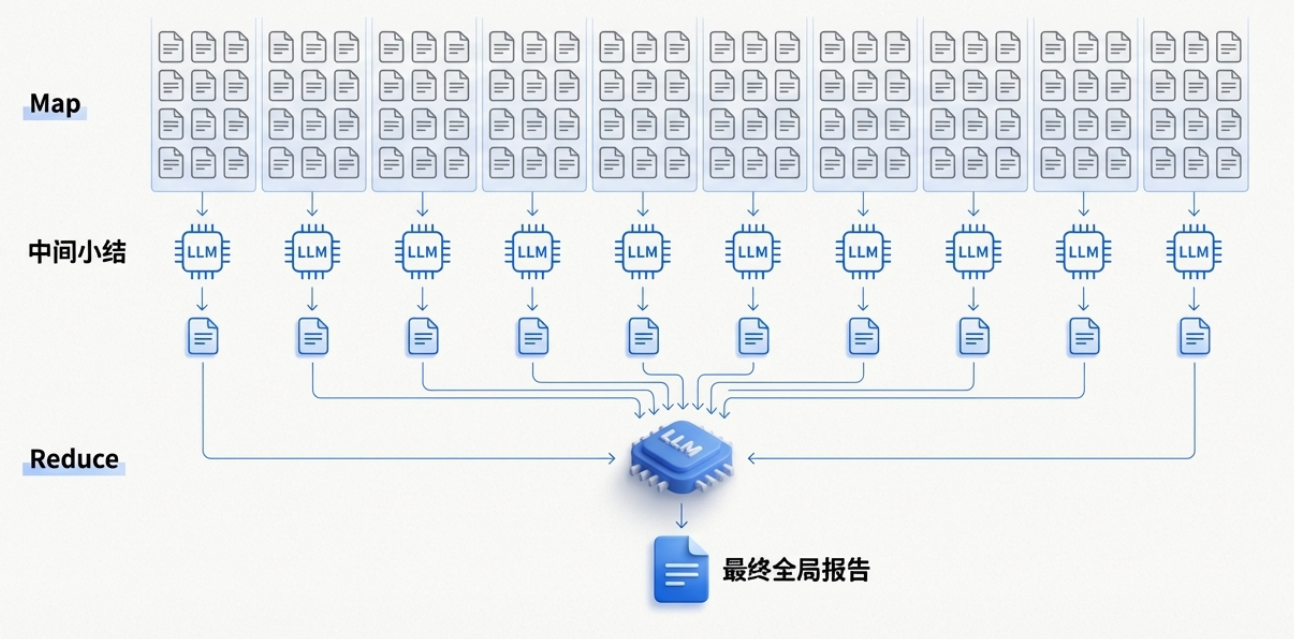
方案三:Map-Reduce (分治总结) 📚
核心思路: 当必须阅读全文才能得出结论(如"总结评语"),且内容超过窗口限制时使用。
📝 总结:你应该选哪种?
| 你的需求 | 推荐方案 | 为什么? |
|---|---|---|
| "张三在哪个班?有几个张三?" | 方案一 (元数据聚合) | 这是最简单的"查找"任务,用代码里的 <font style="color:rgb(38, 38, 38);background-color:rgba(175, 184, 193, 0.2);">Filter</font>+ <font style="color:rgb(38, 38, 38);background-color:rgba(175, 184, 193, 0.2);">Count</font> 解决最快最准。不要用大炮(LLM)打蚊子。 |
| "列出所有数学成绩不及格的学生" | 方案二 (Text-to-SQL) | 涉及数值比较(<60分),向量库做不了,SQL 最擅长。 |
| "综合分析所有班主任对张三的性格评价" | 方案三 (Map-Reduce) | 这需要理解大量文本语义,必须让 LLM 逐个阅读 Chunk 并汇总。 |
| 💡**** 一句话建议 对于大多数项目,务必开启向量库的 Metadata Filter。 用代码去"捞"数据,跳过 LLM 阅读,是性价比之王。 |
|---|
 来源追溯
当RAG对话时, 用户想知道信息来源哪个文件, 这样可信度更高, 可以确定不是大模型胡编乱造,我们就需要告诉用户信息的来源: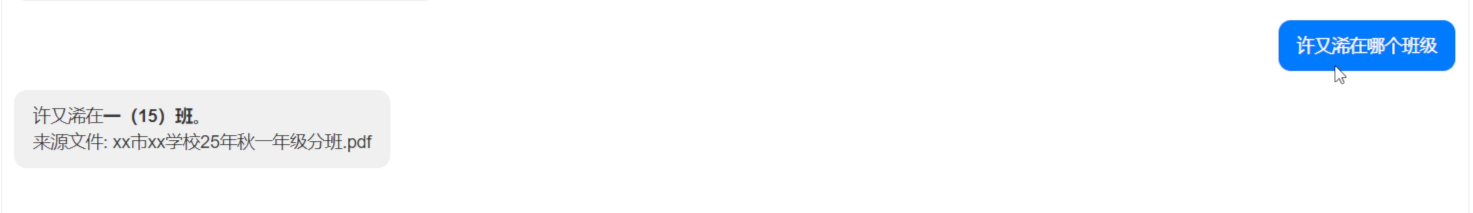
实现步骤:
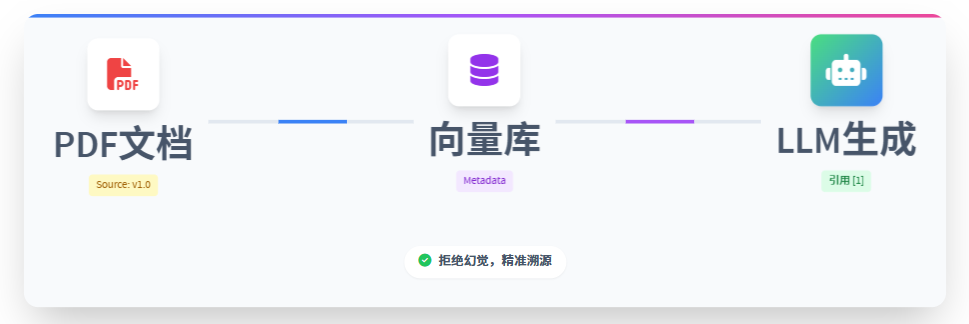
第一步:给片段加入文件信息
在文档切片入库时,千万别只存文本。一定要利用向量数据库的 <font style="color:rgb(0, 0, 0);">Metadata</font> 字段,把文件名(source)"焊死"在每一个切片上。
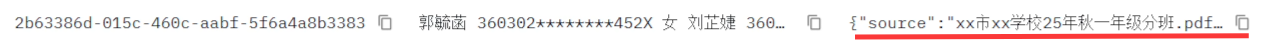
✅**** 实际在我们利用TikaDocumentReader 进行读取文档的时候, 就会自动写入文件名(source)到<font style="color:rgb(0, 0, 0);">Metadata</font> 中
java
TikaDocumentReader reader = new TikaDocumentReader(resource);
List<Document> documents = reader.read();
及时你用别的XXXReader没有写入文件名, 你也可以自己维护
java
documents.forEach(document -> {document.getMetadata().put("source",originalFilename)});第二步:检索时的"显性组装"
LLM 是"盲"的,它看不到 Metadata。所以检索回来后,我们需要用 Java 代码把 Metadata 里的文件名取出来,拼接到文本内容的前面。
**✅**** **这里我建议采用advisor的方式实现, 更加优雅:
- 定义advisor
java
public class MetadataAwareQuestionAnswerAdvisor implements BaseAdvisor {
    private static final PromptTemplate DEFAULT_PROMPT_TEMPLATE = new PromptTemplate("""
			{query}

			Context information is below, surrounded by ---------------------

			---------------------
			{question_answer_context}
			---------------------

			Given the context and provided history information and not prior knowledge,
			reply to the user comment. If the answer is not in the context, inform
			the user that you can't answer the question.
			""");
    @Override
    public ChatClientRequest before(ChatClientRequest baseRequest, AdvisorChain advisorChain) {

        // 获取检索到的文档
        List<Document> documents = (List<Document>) baseRequest.context().get(QuestionAnswerAdvisor.RETRIEVED_DOCUMENTS);

        String userMessage = (String) baseRequest.context().get("userMessage");


        if(!CollectionUtils.isEmpty(documents)) {
            String documentContext = documents == null ? ""
                    : documents.stream().map(doc -> doc.getText()+"\n来源文件:"+doc.getMetadata().getOrDefault("source", "unknown").toString()).collect(Collectors.joining(System.lineSeparator()));

            // 重新构建prompt,在末尾添加source信息

            String augmentedUserText = DEFAULT_PROMPT_TEMPLATE
                    .render(Map.of("query", userMessage, "question_answer_context", documentContext));


            return baseRequest.mutate()
                    .prompt(baseRequest.prompt().augmentUserMessage(augmentedUserText))
                    .build();
        }
        else {
            return baseRequest;
        }
    }

    @Override
    public ChatClientResponse after(ChatClientResponse chatClientResponse, AdvisorChain advisorChain) {
        return chatClientResponse;
    }

    @Override
    public int getOrder() {
        // 优先级最低、因为要保证负责RAG的questionAnswerAdvisor执行完.才能拿到文档信息
        // 为什么不直接设置MAX_VALUE, 因为ChatModelCallAdvisor(负责实际调用AI模型的advisor)也使用了Integer.MAX_VALUE,  如果在他之后,AI对话完成不会执行
        return Integer.MAX_VALUE-1;
    }
}
2.使用:
java
this.chatClient = ChatClient.builder(chatModel)
                // 隐式
                .defaultSystem("""
                        你是"XS"知识库系统的对话助手,请以乐于助人的方式进行对话,
                        如果涉及RAG,请提供文件来源,我会通过source提供给你文件来源,
                        今天的日期:{current_data}
                        """)
                .defaultAdvisors(
                        PromptChatMemoryAdvisor.builder(chatMemory).build(),
                        SimpleLoggerAdvisor.builder().build(),
                        new MetadataAwareQuestionAnswerAdvisor()
                )
                .defaultTools(ragTool)
                .build();
        this.vectorStore=vectorStore;
    }
java
private Flux<String> processNormalRagQuery(List<String> sources, String message) {
        Long userId = BaseContext.getCurrentId();
        ChatClient.ChatClientRequestSpec clientRequestSpec = chatClient.prompt()
                .user(message)
                .advisors(a -> a.param("current_data", LocalDate.now().toString()))
                // 为什么要存userMessage  为了MetadataAwareQuestionAnswerAdvisor中获取
                .advisors(a -> a.param("userMessage", message))
                .advisors(a -> a.param(ChatMemory.CONVERSATION_ID, userId));
        // 如果提供了sources参数,使用向量数据库查询
        if (sources != null && !sources.isEmpty()) {


            SearchRequest.Builder searchRequestBuilder = SearchRequest.builder()
                    .query(message)
                    .similarityThreshold(0.2d).topK(5)
                    // source in ['xxx.pdf','xxxx']
                    .filterExpression("source in "+JSON.toJSONString(sources));

            // 1.自行从vectorStore中查询,自行拼接
            /*List<Document> documents = vectorStore.similaritySearch(searchRequestBuilder.build());
            for (Document document : documents){
                String text = document.getText();
                String source = document.getMetadata().get("source").toString();
                message+=text+"文件来源"+source;
            }*/


            clientRequestSpec=clientRequestSpec.advisors(QuestionAnswerAdvisor.builder(vectorStore)
                    .searchRequest(searchRequestBuilder.build())
                    .build());
        }


        Flux<String> content = clientRequestSpec
                .stream()// 流式方式
                .content();

        return  content;
    }
第三步:引导大模型提供文件来源
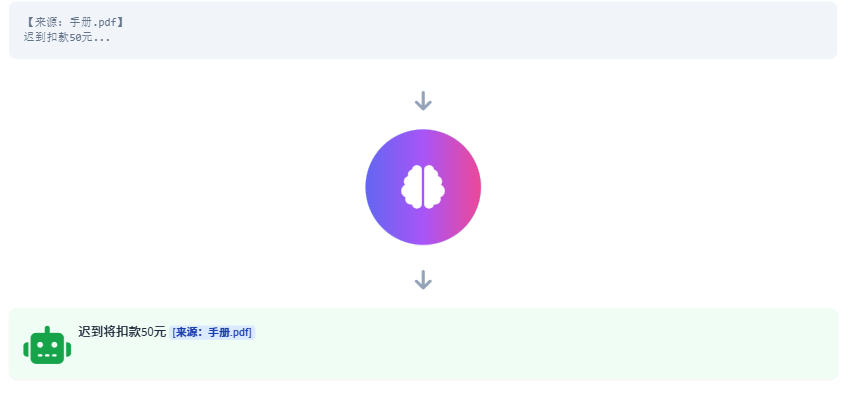
最后,在 System Prompt 中给大模型下达"死命令",如果不设置大模型可能不会告诉用户。
java
this.chatClient = ChatClient.builder(chatModel)
// 隐式
.defaultSystem("""
你是"XS"知识库系统的对话助手,请以乐于助人的方式进行对话,
如果涉及RAG,请提供文件来源,我会通过source提供给你文件来源,
今天的日期:{current_data}
""")
.defaultAdvisors(
PromptChatMemoryAdvisor.builder(chatMemory).build(),
SimpleLoggerAdvisor.builder().build(),
new MetadataAwareQuestionAnswerAdvisor()
)
.defaultTools(ragTool)
.build(); 资料过期更新
很多开发者试图去"修补"向量数据:找到旧文档的几百个切片,逐一对比,只更新变动的部分。**千万别这么做!**这会让数据碎片化,且无法回滚。
最佳实践是 根据不同场景选择不同方案:
场景1:文档版本迭代 (Update)
典型案例 :公司的《报销制度》每年更新一次,你需要将知识库中的旧条款替换为新条款。
❌ 传统误区:原地修补
很多开发者试图去"修改"向量数据:找到旧文档对应的几百个 Chunk,逐一对比内容,只更新变动的部分。 这在工程上是灾难性的:逻辑极其复杂,容易产生数据碎片,且一旦新版有误,无法回滚。
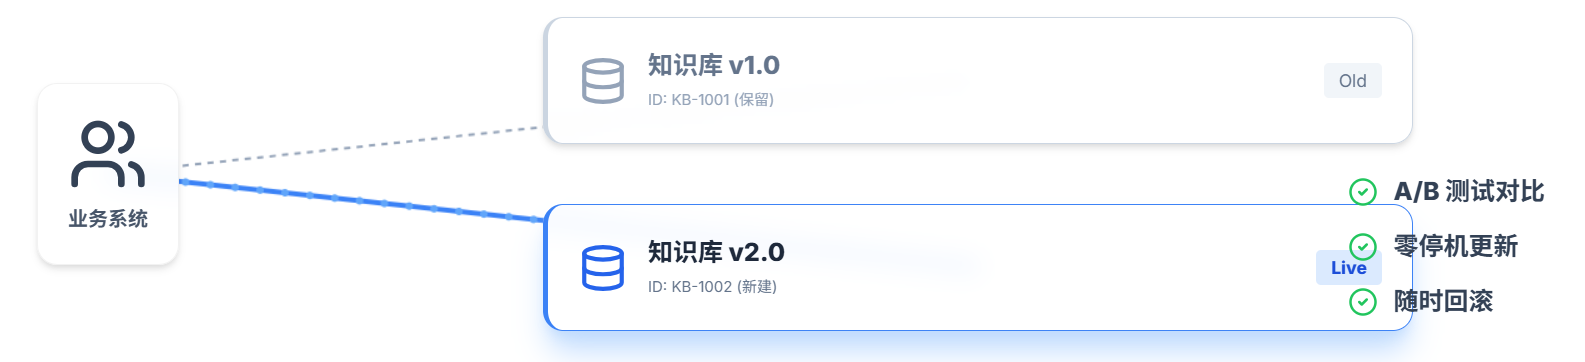
✅**** 解决方案:策略一 ------ 版本隔离 (Version Isolation)
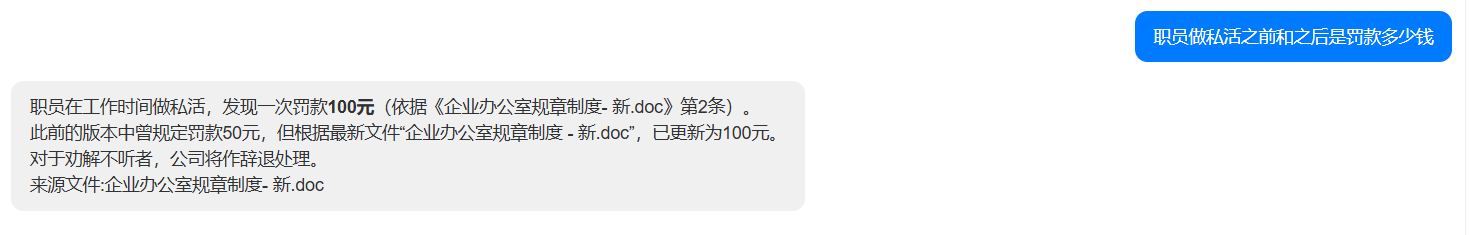
如果按照之前知识库隔离的方案, 一个文件=一个知识库, 其实如果文件更新了只需要创建一个新的知识库即可.完全不是问题, 并且以后想做新旧对比, 只需选择新旧的知识库进行RAG问答即可。
:::info
关键是: 你需要做好来源追溯。 要不然大模型不知道哪个片段是哪个文件。
:::
场景2:传错文件(Delete)
典型案例 :运营人员误将一份包含"高管薪资"的涉密 Excel 上传到了公开知识库,必须立即、彻底地删除。
✅**** 解决方案: 我们需要**"全链路清洗"**:
| 1 | 业务 DB 锁定 标记状态为 Deleting,阻断新查询 |
|---|---|
| ↓ | |
| 2 | 向量库狙击 WHERE file_id = 'xxx' DELETE ALL |
| ↓ | |
| 3 | OSS 物理粉碎 调用 S3/MinIO 接口彻底删除源文件 |
直接删除文件即可, 删除的时候顺带删除向量数据库的数据,目前我们的文件已经关联了documentid.能轻松删除:
java
    @Override
    @Transactional(rollbackFor = Exception.class)
    public BaseResponse deleteFiles(List<Long> ids) {
        List<AliOssFile> aliOssFiles = aliOssFileMapper.selectByIds(ids);
        if (ids.isEmpty()) {
            return ResultUtils.error(ErrorCode.PARAMS_ERROR, "请选择文件");
        }
        int count = aliOssFileMapper.deleteBatchIds(ids);
        if (count == 0) {
            return ResultUtils.error(ErrorCode.OPERATION_ERROR, "删除失败");
        }
        for (AliOssFile aliOssFile : aliOssFiles) {
            List<String> vectorIds = JSON.parseArray(aliOssFile.getVectorId(), String.class);
            vectorStore.delete(vectorIds);
            aliOssUtil.deleteOss(aliOssFile.getUrl());
        }

        return ResultUtils.success("成功删除"+ count + "个文件");
    }