文章目录
- [1. 国内外大模型](#1. 国内外大模型)
- [2. 开源大模型](#2. 开源大模型)
-
- LLaMA
- [2.1 概念](#2.1 概念)
- [2.2 优点](#2.2 优点)
- [2.3 缺点](#2.3 缺点)
- [2.4 典型代表](#2.4 典型代表)
- [3. 闭源大模型](#3. 闭源大模型)
-
- [3.1 概念](#3.1 概念)
- [3.2 优点](#3.2 优点)
- [3.3 缺点](#3.3 缺点)
- [3.4 典型代表](#3.4 典型代表)
- [4. 如何选择?](#4. 如何选择?)
1. 国内外大模型
下⾯是当前国内外最主流的模型阵营梳理:
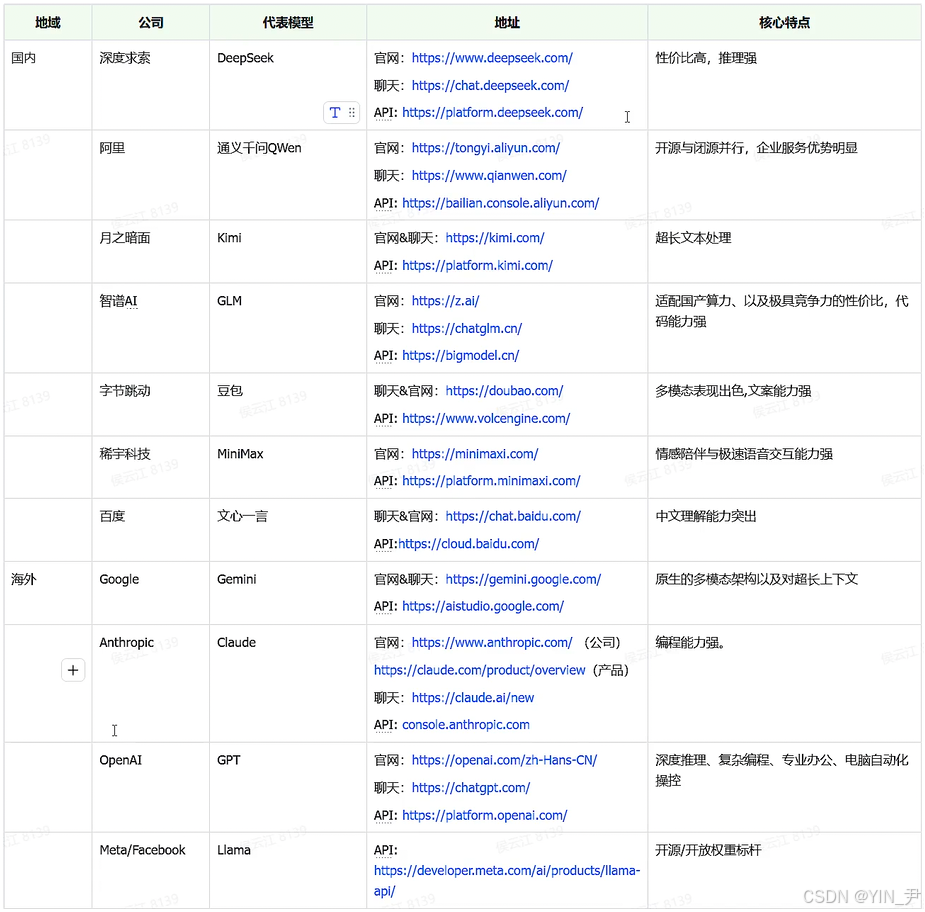
大家可以自行体验
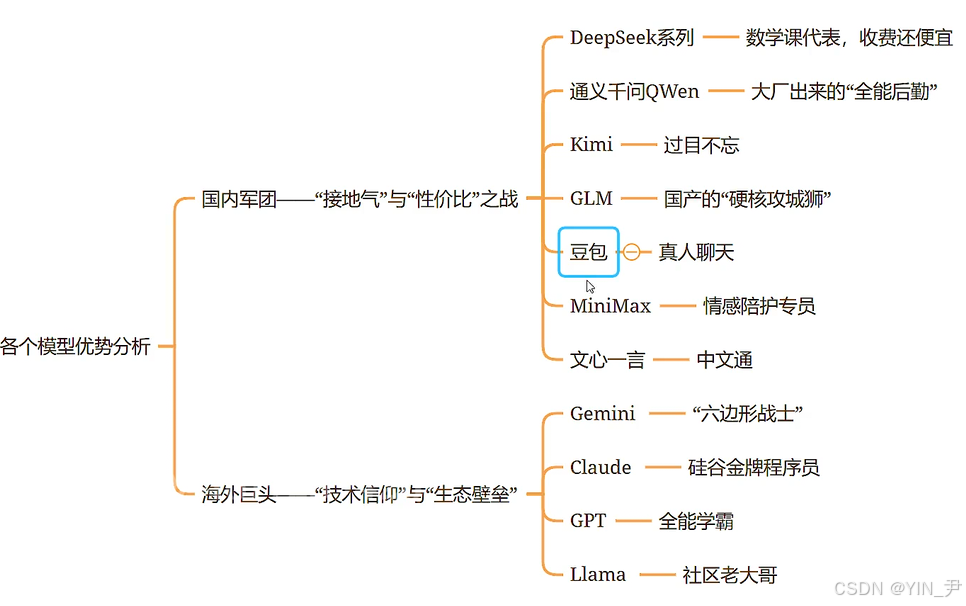
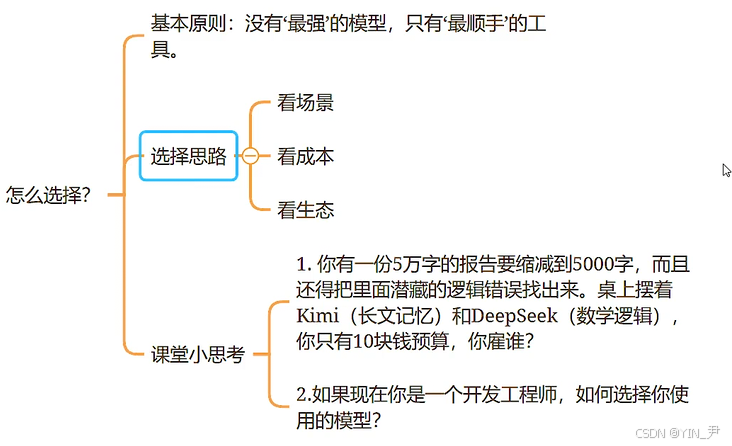
这么多的模型,如何选择呢?
2. 开源大模型
LLaMA
LLaMA 是什么?
LLaMA 的全称是 "Large Language Model Meta AI",直译就是 "Meta 公司的大型语言模型"。
简单说,它是 Meta(原来的 Facebook)开发的一款 "通用语言 AI大模型"。
但它和 ChatGPT、文心一言有个本质区别:完全开源 。你可以把 ChatGPT 想象成 "苹果手机"------成品直接给你用,功能强大但封闭,你没法改它的核心逻辑;而 LLaMA 更像 "安卓系统"------Meta把模型的核心代码、训练框架都公开了,任何人都能下载、修改、二次开发。
举个直观的例子:如果一家小公司想做一款 "电商客服 AI",用 ChatGPT 得花钱调用 API,还受限于平台规则;但用
LLaMA,他们可以下载基础模型,再用自己的客服对话数据 "调教" 它,最后部署在自己的服务器上,不仅免费,还能完全适配自己的业务。
Meta 当初开源 LLaMA 的初衷也很明确:打破大公司对大模型的垄断,让更多开发者、中小企业能参与到 AI 创新中 。就像把 "AI 造车的图纸" 免费公开,普通人也能试着改装出自己的 "专属汽车"。
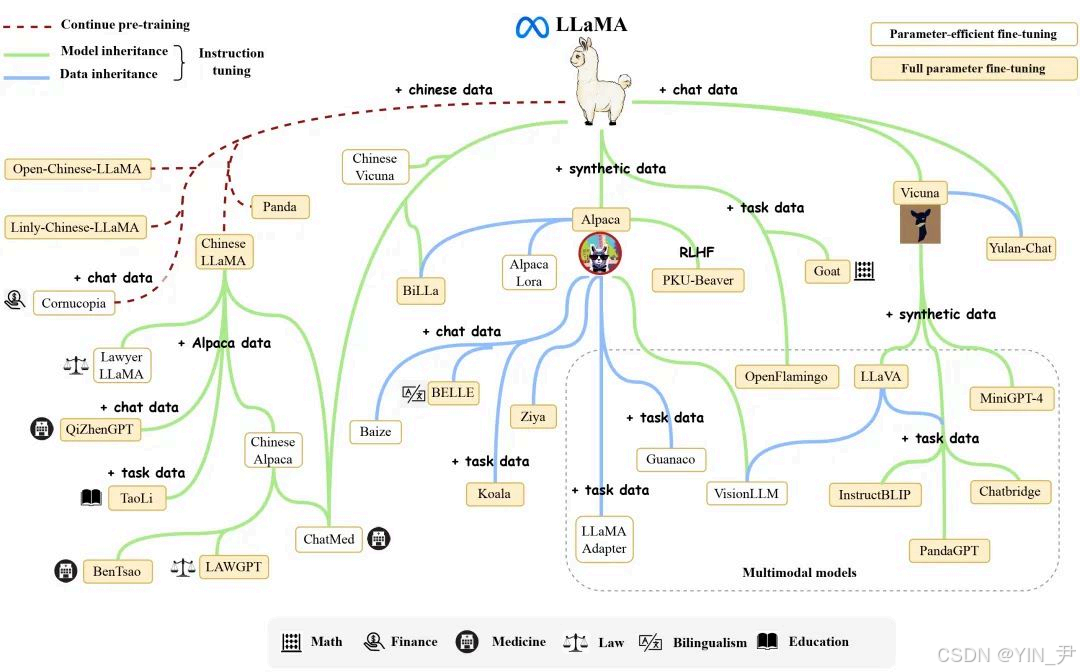
由于模型开源且性能优异,Llama迅速成为了开源社区中最受欢迎的大模型之一,以Llama为核心的生态圈也由此崛起。与此同时,众多研究者将其作为基座模型,进行了继续预训练或者微调,衍生出了众多变体模型(见下图),极大地推动了大模型领域的研究进展。
2.1 概念
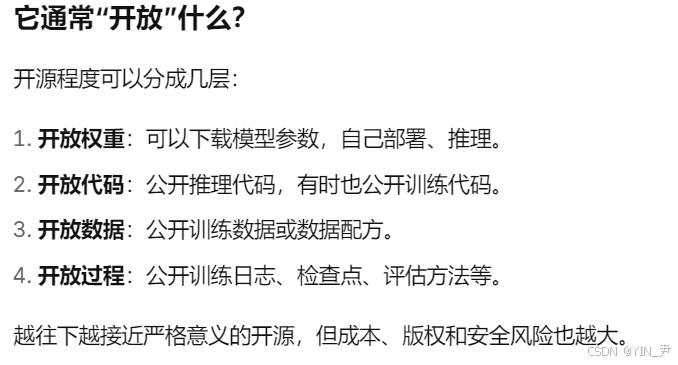
开源大模型,简单说就是:把大型人工智能模型的模型权重、代码、架构、训练方法等公开出来,允许别人下载、运行、修改、微调、再发布,甚至商用------但具体能做什么,要看它的许可证。
不过要强调一点:现在很多所谓"开源大模型",其实更准确叫开放权重模型。因为真正的"开源"不仅包括模型参数,还应包括训练数据、训练脚本、训练过程、检查点等;而多数厂商只公开了权重和推理代码。
2.2 优点
数据安全与隐私:
这是最核心的优势。模型可以完全部署在企业内部的本地服务器或私有云上,敏感数据不出域 ,杜绝了数据被厂商用于训练或泄露的风险,尤其适合金融、医疗、政务等高合规要
求行业。
成本可控:
虽然初期需要采购GPU服务器,但一旦部署完成,推理成本极低。对于大规模、高频次调用的场景,长期总拥有成本远低于按API调用次数付费的闭源模型。
高度的定制化:
开发者可以获取模型权重,针对特定垂直领域进行微调,甚至修改模型架构。这种"自主可控"的能力,让企业能构建差异化的核心竞争力。
透明与持久性:
模型权重下载后即属于用户,不会因为厂商倒闭、政策变动或接口升级而无法使用,不存在"供应商锁定"风险。
2.3 缺点
技术门槛高:
需要企业具备较强的AI工程化能力,包括GPU运维、分布式推理框架、显存优化等技术栈,普通中小企业难以独立驾驭。
隐形成本高:
虽然模型权重免费,但高性能GPU服务器的采购、机房电费、专业运维人员的薪资构成了较高的隐性成本。
生态碎片化:
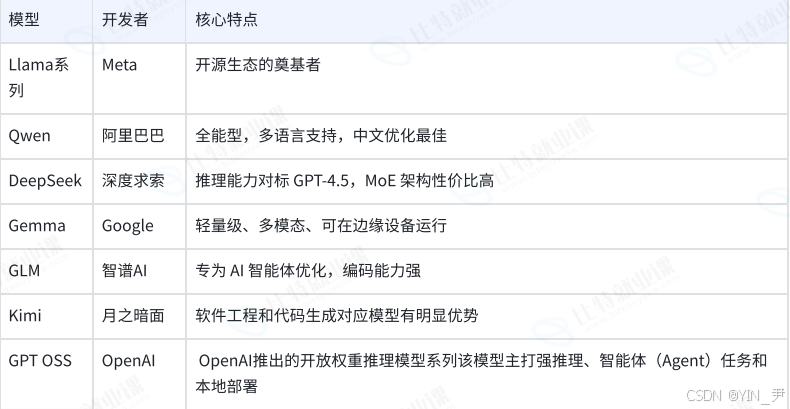
市面上模型版本众多(Llama、Qwen、DeepSeek等),质量参差不齐,选型试错需要耗费大量精力,且缺乏统一的技术标准。
2.4 典型代表
3. 闭源大模型
3.1 概念
闭源大模型,是指模型权重、训练数据、训练代码、完整架构和训练过程等核心内容不公开,由开发公司自己控制,用户只能通过厂商提供的 API、网页/App、云服务或商业授权 来使用的大模型。它有时也叫"专有模型"。
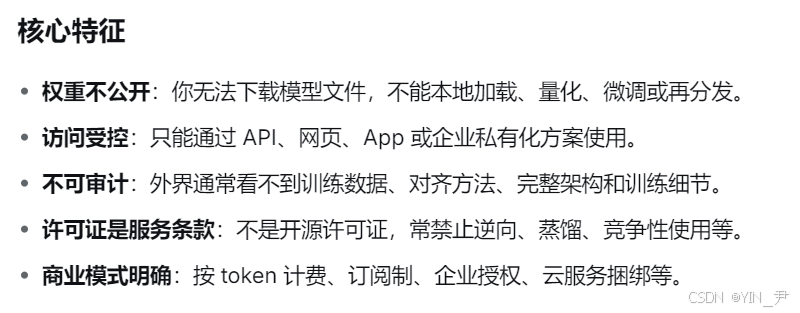
一句话理解:你只能用它的能力,但拿不到模型本身。
3.2 优点
开箱即用:
无需关注底层硬件和部署细节,注册账号获取API Key即可通过几行代码调用,极大降低了AI应用的入门 槛。
初期成本低:
对于初创团队或验证阶段的项目,无需在硬件上投入巨额资本,采用按量付费模式,资金灵活性高。
性能天花板高:
头部闭源厂商(如OpenAI、Anthropic)通常拥有最顶尖的算力和未公开的算法技术,在多模态识别、复杂逻辑推理等任务上,通常保持着略微领先的"上限"性能。
维护成本低:
由厂商负责模型的版本更新、安全补丁和算力扩容,用户无需操心底层基础设施的稳定性。
3.3 缺点
数据合规风险:
将业务数据通过API传输给第三方厂商,可能面临数据出境、数据被用于模型训练、隐私泄露等合规红线。许多大型企业明令禁止将内部数据上传至闭源API。
长期成本不可控:
一旦业务量上涨,API调用费用呈线性增长,成本可能远超自建开源模型。此外,厂商随时可能涨价或更改计费策略。
缺乏定制能力:
用户只能通过提示词或有限的微调接口来影响模型行为,无法针对专属业务逻辑进行深度定制,难以形成独特的竞争壁垒。
供应商锁定:
业务深度依赖特定厂商的API,一旦该厂商服务中断、政策变更或停止服务,迁移成本极高,甚至导致业务停摆。
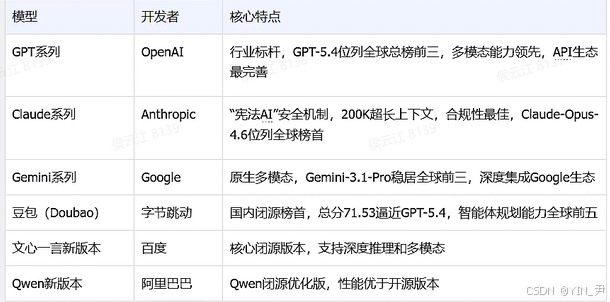
3.4 典型代表
4. 如何选择?
选开源 :如果你的业务涉及核心数据、敏感信息,或者长期调用量非常大,且团队具备一定的工程能力。
选闭源:如果你是快速验证想法、开发轻量级应用,或者团队缺乏GPU或者运维能力,追求最短的上线时间。
目前随着DeepSeek等高性能开源模型的出现,两者的性能差距已大幅缩小,越来越多的企业开始采用"核心业务私有化部署开源模型 + 非核心业务调用闭源API"的混合架构