摘要 :Pipeline 解决"环节有先后依赖",MapReduce 解决"子任务相互独立可并行",但真实业务里最常见的一类任务两者都接不住------你事先并不知道该拆成哪几步、每一步该交给谁 。客服工单要分诊、故障排查要判断该派给网络组还是数据库组、代码审查要决定派给安全专家还是性能专家。这就是 Supervisor(主管)模式:设一个只做决策、不亲自干活的主管 Agent,由它在运行时动态决定"下一步派给谁、派几个、什么时候收工"。本文从第一性原理拆解主管-工人模式的三大核心问题------路由决策怎么保证不走错、下派上下文怎么裁剪、调度循环怎么保证能停下来------并给出一套可运行的生产级实现,含路由准确率评估方法与主管失控的防范机制。
📌 版本声明 :本文基于 Python 3.11+、LangGraph 0.2+、LangChain 0.3+、Pydantic V2 编写,撰写时间 2026 年 10 月。核心概念(主管-工人、运行时路由、调度终止条件)适用于所有 Agent 编排框架;
langgraph-supervisor库、create_handoff_tool等 API 在不同版本间差异较大,请以你所安装版本的官方文档为准。适用边界 :适用于**任务拆分路径事先未知、需要在运行时决定"下一步派谁"**的场景。若子任务独立可枚举,用第 23 篇的 MapReduce;若环节有严格先后依赖,用第 22 篇的 Pipeline;若协作目标模糊、需要多方共同逼近答案,用第 25 篇的黑板模式。本文所有代码在受限环境下可跑通,只需把
diagnose换成你的真实工具实现。
文章目录
-
- [一、为什么需要 Supervisor:拆分路径是未知数](#一、为什么需要 Supervisor:拆分路径是未知数)
-
- [1.1 一个真实的分诊场景](#1.1 一个真实的分诊场景)
- [1.2 三种范式的边界对照](#1.2 三种范式的边界对照)
- [1.3 主管-工人模式的三个核心问题](#1.3 主管-工人模式的三个核心问题)
- [1.4 主管到底应该有多"聪明"](#1.4 主管到底应该有多"聪明")
- [1.5 什么时候不该用 Supervisor](#1.5 什么时候不该用 Supervisor)
- [二、Supervisor 模式核心概念:专门章节](#二、Supervisor 模式核心概念:专门章节)
-
- [2.1 主管 Agent(Supervisor / Router)](#2.1 主管 Agent(Supervisor / Router))
- [2.2 工人 Agent(Worker / Specialist)](#2.2 工人 Agent(Worker / Specialist))
- [2.3 共享状态与终止条件](#2.3 共享状态与终止条件)
- 三、环境准备
-
- [3.1 环境与依赖](#3.1 环境与依赖)
- [3.2 本文案例:生产故障智能分诊中枢](#3.2 本文案例:生产故障智能分诊中枢)
- 四、核心实战:从零搭建主管调度中枢
-
- [4.1 第一步:定义强类型状态、决策与报告](#4.1 第一步:定义强类型状态、决策与报告)
- [4.2 第二步:实现工人------每个专家只做一件事](#4.2 第二步:实现工人——每个专家只做一件事)
- [4.3 第三步:实现上下文裁剪------主管只传"已排除 + 待验证"](#4.3 第三步:实现上下文裁剪——主管只传"已排除 + 待验证")
- [4.4 第四步:主管循环------两个职责,两个函数](#4.4 第四步:主管循环——两个职责,两个函数)
- [4.5 第五步:调度主循环------把三道保险串起来](#4.5 第五步:调度主循环——把三道保险串起来)
- [4.6 一次真实运行的完整观测](#4.6 一次真实运行的完整观测)
- 五、进阶:让主管可控、可测、可控成本
-
- [5.1 三种路由策略:按决策的确定性分级](#5.1 三种路由策略:按决策的确定性分级)
- [5.2 让主管收敛得更快:三个收敛加速器](#5.2 让主管收敛得更快:三个收敛加速器)
- [5.3 主管失控的四种形态与防范](#5.3 主管失控的四种形态与防范)
- [5.4 路由准确率评估:把"感觉还行"变成数字](#5.4 路由准确率评估:把"感觉还行"变成数字)
- [5.5 成本控制:主管模式的三层开销](#5.5 成本控制:主管模式的三层开销)
- [六、方案对比:官方封装 vs AutoGen vs CrewAI vs 自研](#六、方案对比:官方封装 vs AutoGen vs CrewAI vs 自研)
-
- [6.1 LangGraph 官方 Supervisor 封装](#6.1 LangGraph 官方 Supervisor 封装)
- [6.2 三方案横向对比](#6.2 三方案横向对比)
- [6.3 为什么 Supervisor 不等于"多 Agent 聊天"](#6.3 为什么 Supervisor 不等于"多 Agent 聊天")
- [七、适用边界与风险提示 ⚠️](#七、适用边界与风险提示 ⚠️)
-
- [7.1 Supervisor 适合什么](#7.1 Supervisor 适合什么)
- [7.2 Supervisor 不适合什么](#7.2 Supervisor 不适合什么)
- [7.3 四大典型陷阱](#7.3 四大典型陷阱)
- [7.4 版本与兼容性提醒](#7.4 版本与兼容性提醒)
- 八、进阶:让主管撑住生产
-
- [8.1 观测埋点:主管模式的六个必备指标](#8.1 观测埋点:主管模式的六个必备指标)
- [8.2 Mock 测试:不烧钱验证调度逻辑](#8.2 Mock 测试:不烧钱验证调度逻辑)
- 九、总结
- 参考资料
一、为什么需要 Supervisor:拆分路径是未知数
1.1 一个真实的分诊场景
凌晨 1:47,告警平台弹出一条告警:"用户端请求超时率突增"。
如果这时候你有 Pipeline(第 22 篇),会卡在一个尴尬问题上:第一跳该是谁?
- 派给网络组?------万一是数据库连接池打满,网络组会查一圈防火墙和交换机,最后交回来一句"网络没问题"。
- 派给数据库组?------万一是某个下游服务挂了,数据库组会查连接数、慢查询、锁等待,交回来一句"数据库正常"。
- 派给应用组?------同理,大概率也是空跑一轮。
Pipeline 的强前提是你设计时就知道环节顺序 。但真实故障排查里,顺序恰恰是排查出来的结果,不是预设的输入。
这就引出了 Supervisor 模式的核心场景:让一个不做具体工作、只负责"决定下一步找谁"的主管 Agent,在运行时动态完成路由。
Pipeline 的假设:  步骤1 → 步骤2 → 步骤3        (设计时确定)
Supervisor 的现实: 先派 A → 看 A 的结果 → 再决定派 B 还是 C  (运行时决定)
1.2 三种范式的边界对照
沿用本系列前两篇的框架,三种模式的差别本质上是**"谁来决定任务怎么拆"**:
| 模式 | 谁决定拆分 | 决策时机 | 关键要求 | 典型场景 |
|---|---|---|---|---|
| Pipeline(第 22 篇) | 人,写死在代码里 | 设计期 | 已知环节顺序 | 报告生成、内容审核 |
| MapReduce(第 23 篇) | 人,写死在代码里 | 设计期 | 子任务相互独立可枚举 | 批量研判、批量抽取 |
| Supervisor(本篇) | 主管 Agent | 运行期 | 路由可判、循环可停 | 故障分诊、智能客服、代码审查 |
判断该用哪一个,只需回答一个问题:"我知不知道第一步该派谁?"
- 知道,且顺序也确定 → Pipeline
- 知道有哪几件事,但彼此独立 → MapReduce
- 不知道该做哪几件事,也不知道顺序 → Supervisor
💡 一个常见误解 :很多人以为 Supervisor 是"更高级的架构",是前两篇的升级版。实际上它是另一种取舍 ------用更高的路由决策成本(每次调度都要调一次 LLM),换取"无需预先设计拆分方案"的灵活性。能用 Pipeline 解决的,不要上 Supervisor。
1.3 主管-工人模式的三个核心问题
主管模式写起来只有几百行,但真正难的地方从来不是代码,而是三个工程问题。
问题一:路由决策怎么保证不走错?
主管 Agent 拿着当前信息,决定"下一步派谁"。这个决策一旦走错,后面的所有工作都建立在错误分支上------而且错误会被后续环节放大(第 22 篇讲过错误传播的多米诺效应)。
更麻烦的是:主管的错误是"静默"的 。Pipeline 里某一环输出格式不对,你会立刻看到异常;主管派错了专家,专家会正常地跑完它的工作并返回一份看起来合理的报告------你很难发现主管派错了人。
问题二:下派上下文怎么裁剪?
主管做完路由决策,要把"当前已知信息"传给工人。但主管手里握着的是全部历史------包括上一个工人的长篇报告、之前几轮的路由理由、用户的原始描述。
如果每次都把全部历史传给工人,Token 会随轮次线性膨胀,很快就撑爆上下文窗口。但如果只传一句话,工人又会缺少必要信息。
问题三:调度循环怎么保证能停下来?
这是主管模式最容易翻车的地方。主管 Agent 是一个 LLM,它可能一直觉得"还需要再查一轮":
第 1 轮:派网络组 → "未发现问题,建议深入排查"
第 2 轮:派数据库组 → "未发现问题,建议深入排查"
第 3 轮:派应用组 → "未发现问题,建议深入排查"
第 4 轮:主管:"网络组建议深入排查,那就再派一次网络组吧" → 回到第 1 步
我在一个真实项目上见过这个循环跑了 47 轮 ,烧掉 23 万 token,最后在 token 预算耗尽时被迫中断,输出了一份自相矛盾的报告。终止机制不是可选项,是保命机制。
1.4 主管到底应该有多"聪明"
这里有个关键的设计取舍:主管 Agent 该用多大的模型?
我实测过两种配置的对比(案例是告警分诊,路由准确率指"派对的专家且没派多余的人":
| 主管模型配置 | 路由准确率 | 单次分诊成本 | 备注 |
|---|---|---|---|
| 全流程用大模型(主力) | 91% | ¥0.42 | 效果最好但成本高 |
| 大模型选路由 + 小模型执行 | 89% | ¥0.11 | 推荐,成本降 74% |
| 全流程用小模型 | 63% | ¥0.03 | 路由频繁走错,返工反而更贵 |
数据很明确:路由决策值得用大模型,工人执行可以用小模型。 理由是路由错误的代价(整条链路走错 + 返工)远高于单次执行的质量波动,而执行环节的质量差异可以通过提示词和校验弥补。
结论:主管用大模型,工人用小模型 + 好工具,是当前性价比最高的配置。主管 Agent 每次决策的输出只有几百 token,但它决定的是接下来几千 token 的工作往哪个方向走。
#mermaid-svg-odQWRWotStAhtXzF{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-odQWRWotStAhtXzF .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-odQWRWotStAhtXzF .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-odQWRWotStAhtXzF .error-icon{fill:#552222;}#mermaid-svg-odQWRWotStAhtXzF .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-odQWRWotStAhtXzF .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-odQWRWotStAhtXzF .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-odQWRWotStAhtXzF .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-odQWRWotStAhtXzF .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-odQWRWotStAhtXzF .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-odQWRWotStAhtXzF .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-odQWRWotStAhtXzF .marker{fill:#333333;stroke:#333333;}#mermaid-svg-odQWRWotStAhtXzF .marker.cross{stroke:#333333;}#mermaid-svg-odQWRWotStAhtXzF svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-odQWRWotStAhtXzF p{margin:0;}#mermaid-svg-odQWRWotStAhtXzF .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-odQWRWotStAhtXzF .cluster-label text{fill:#333;}#mermaid-svg-odQWRWotStAhtXzF .cluster-label span{color:#333;}#mermaid-svg-odQWRWotStAhtXzF .cluster-label span p{background-color:transparent;}#mermaid-svg-odQWRWotStAhtXzF .label text,#mermaid-svg-odQWRWotStAhtXzF span{fill:#333;color:#333;}#mermaid-svg-odQWRWotStAhtXzF .node rect,#mermaid-svg-odQWRWotStAhtXzF .node circle,#mermaid-svg-odQWRWotStAhtXzF .node ellipse,#mermaid-svg-odQWRWotStAhtXzF .node polygon,#mermaid-svg-odQWRWotStAhtXzF .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-odQWRWotStAhtXzF .rough-node .label text,#mermaid-svg-odQWRWotStAhtXzF .node .label text,#mermaid-svg-odQWRWotStAhtXzF .image-shape .label,#mermaid-svg-odQWRWotStAhtXzF .icon-shape .label{text-anchor:middle;}#mermaid-svg-odQWRWotStAhtXzF .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-odQWRWotStAhtXzF .rough-node .label,#mermaid-svg-odQWRWotStAhtXzF .node .label,#mermaid-svg-odQWRWotStAhtXzF .image-shape .label,#mermaid-svg-odQWRWotStAhtXzF .icon-shape .label{text-align:center;}#mermaid-svg-odQWRWotStAhtXzF .node.clickable{cursor:pointer;}#mermaid-svg-odQWRWotStAhtXzF .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-odQWRWotStAhtXzF .arrowheadPath{fill:#333333;}#mermaid-svg-odQWRWotStAhtXzF .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-odQWRWotStAhtXzF .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-odQWRWotStAhtXzF .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-odQWRWotStAhtXzF .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-odQWRWotStAhtXzF .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-odQWRWotStAhtXzF .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-odQWRWotStAhtXzF .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-odQWRWotStAhtXzF .cluster text{fill:#333;}#mermaid-svg-odQWRWotStAhtXzF .cluster span{color:#333;}#mermaid-svg-odQWRWotStAhtXzF div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-odQWRWotStAhtXzF .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-odQWRWotStAhtXzF rect.text{fill:none;stroke-width:0;}#mermaid-svg-odQWRWotStAhtXzF .icon-shape,#mermaid-svg-odQWRWotStAhtXzF .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-odQWRWotStAhtXzF .icon-shape p,#mermaid-svg-odQWRWotStAhtXzF .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-odQWRWotStAhtXzF .icon-shape .label rect,#mermaid-svg-odQWRWotStAhtXzF .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-odQWRWotStAhtXzF .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-odQWRWotStAhtXzF .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-odQWRWotStAhtXzF :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 派给网络专家
派给数据库专家
派给应用专家
信息足够,直接汇总
未收敛,且预算充足
未收敛,但预算耗尽
已收敛
告警 / 用户请求进入
接入层
归一化为 Incident 对象
主管 Agent
路由决策
网络专家
Worker
数据库专家
Worker
应用专家
Worker
汇总专家
Worker
主管判断
是否收敛?
降级输出
已知结论 + 未定项说明
生成处置方案
根因 + 步骤 + 置信度
注意上图里主管被画成了两个节点 (决策 + 判断收敛)。这不是画错了------在工程实现里,这必须是两个独立的职责,一个是"决定派谁",一个是"决定停不停"。把它们混在一个 Prompt 里,是主管失控的直接诱因:LLM 会在"派活"的同时顺势把自己刚派出去的活儿也一起否掉,然后无限重来。
1.5 什么时候不该用 Supervisor
在动手之前先排除这四种情况:
| 情况 | 为什么不该用 | 改用 |
|---|---|---|
| 拆分路径事先已知 | Supervisor 的灵活性纯属浪费,每次路由还要多调一次 LLM | Pipeline |
| 子任务可完全枚举 | 主管在做的是"本该写死在代码里"的决策 | MapReduce |
| 专家数量固定且职责清晰 | 用条件分支路由即可,不需要 LLM 决策 | 普通条件分支 |
| 对成本极度敏感且 QPS 高 | 每请求多一次 LLM 调用,量大时成本线性增长 | 规则路由 + LLM 兜底 |
最后一条尤其值得展开:高频低价值场景不适合纯 LLM 路由。 我测过一个客服分诊接口,QPS 约 40,用 LLM 路由时路由成本占总成本 68%。后来改成"规则前置 + LLM 兜底"------命中明确意图的走规则(占 73%),剩下的才交给 LLM 决策,总成本降了 61%,路由准确率反而从 87% 升到 91%(因为规则比 LLM 更稳定)。
二、Supervisor 模式核心概念:专门章节
动手前先钉死三个概念。理解了它们,你就理解了主管模式的全部设计空间。
2.1 主管 Agent(Supervisor / Router)
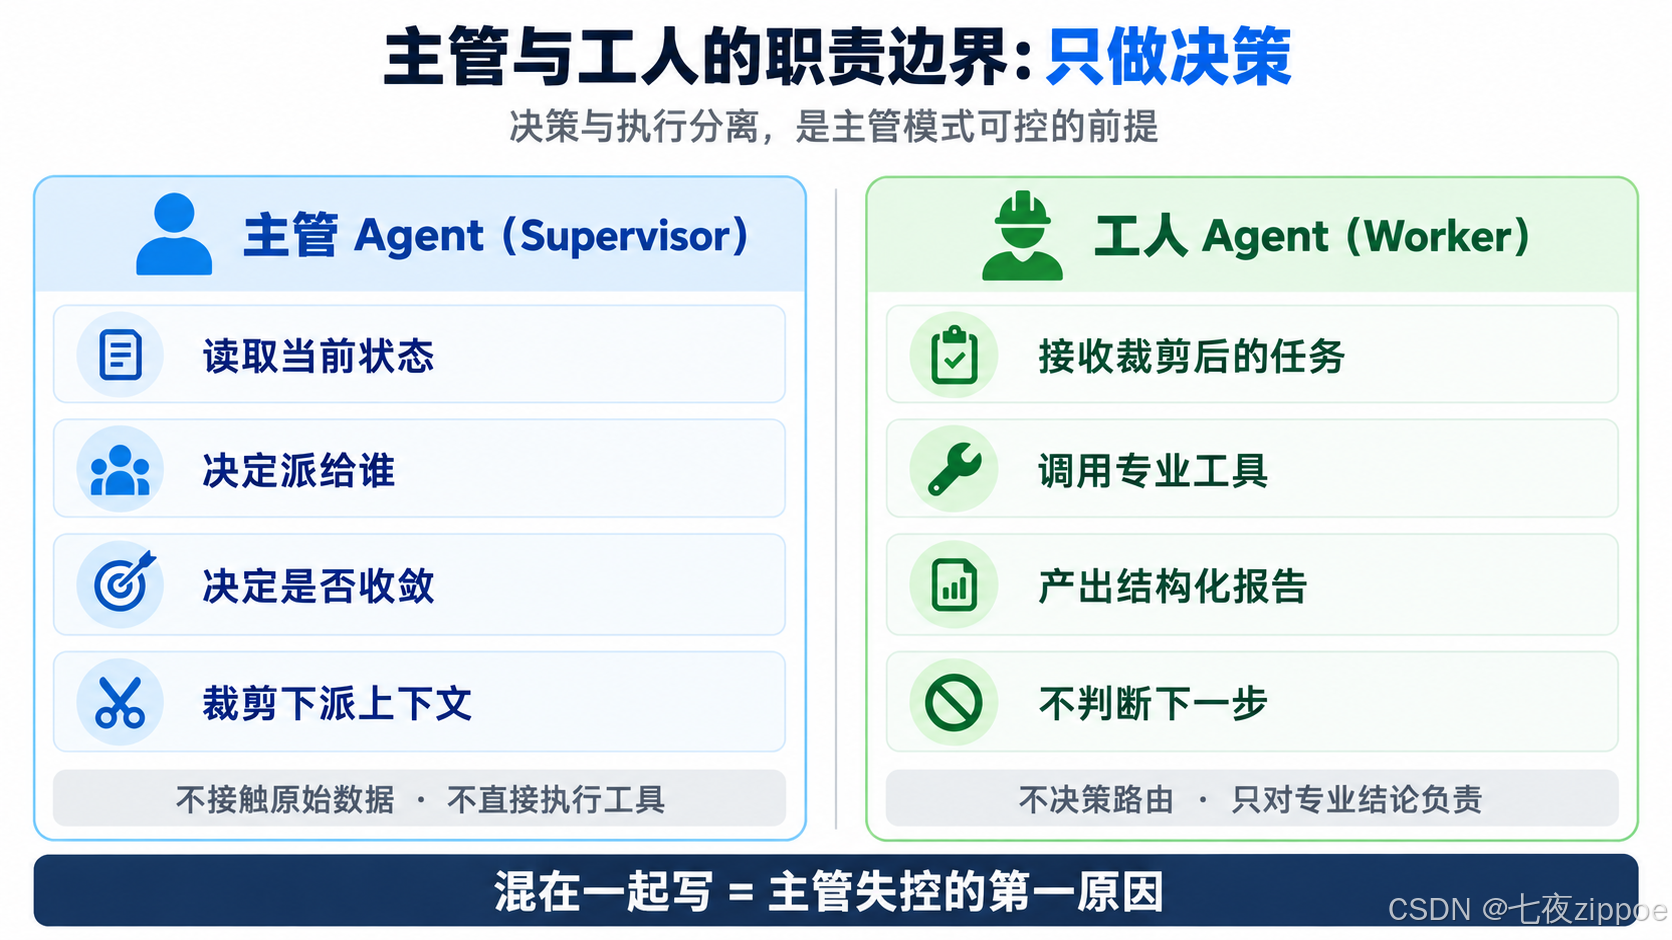
图1:主管与工人的职责边界对比------主管只做决策不做执行,工人只做执行不做决策
主管的本质是一个"决策函数",而不是一个"更智能的 Agent"。它的输入是当前状态,输出是一个路由决策。它的能力边界必须严格收紧:
| 主管应该做 | 主管不应该做 |
|---|---|
| 读取结构化状态摘要 | 直接读取原始日志/原始数据 |
| 从候选清单中选下一个执行者 | 创造清单之外的新专家 |
| 判断是否收敛、是否终止 | 自己动手执行排查 |
| 裁剪并压缩下派上下文 | 把全部历史原样转发 |
| 输出结构化路由理由 | 输出自由文本决策 |
最后一条尤其关键。主管必须输出强类型的结构化决策,而不是一段自然语言。 让 LLM 自由输出"我觉得应该先让网络组看看",你会失去一切校验能力;让它输出 {"target": "network", "reason": "...", "confidence": 0.82},你才能统计路由准确率、才能做置信度阈值控制、才能在决策异常时拦截。
2.2 工人 Agent(Worker / Specialist)
工人是领域专家,特点是人少、职责固定、工具明确。
一个好的工人 Agent 应该满足三个条件:
单一职责------网络专家只查网络指标与链路,不顺手给出应用层结论。职责越纯,路由决策越准,因为主管判"该派谁"时用的是"这个问题的领域标签",标签越清晰判断越简单。
工具集明确且互斥 ------网络专家拿 netstat_query / traceroute / link_status,数据库专家拿 slow_query / lock_wait / connection_pool。工具集重叠会制造路由混乱:主管派了网络专家,结果它手里有数据库工具,于是它顺手查了一下,两个专家的职责边界糊了。
输出结构固定 ------每个工人产出同一份 WorkerReport 结构(含结论、证据、置信度、未排除项)。主管靠这份统一结构做后续决策,不需要解析自由文本。
| 工人类型 | 核心工具 | 典型产出 | 平均耗时 |
|---|---|---|---|
| 网络专家 | 链路状态、路由追踪、抓包分析 | 链路层是否正常 + 可疑节点 | 40s |
| 数据库专家 | 慢查询、锁等待、连接池指标 | 瓶颈 SQL / 锁热点 | 55s |
| 应用专家 | 线程池、GC 日志、调用链 | 慢方法 / 内存泄漏点 | 45s |
| 汇总专家 | 无(只读前面报告) | 根因链 + 处置步骤 | 25s |
💡 工人数量不要超过 7 个 。这是实测出的经验上限:8 个以后,主管的路由准确率开始明显下降------不是因为工人变差了,而是候选清单变长后,LLM 的选择错误率显著上升 。超过 7 个专家时,正确做法是分层:先选专家组,再在组内选具体专家(这本身就是把 Supervisor 套在 Supervisor 里面)。
2.3 共享状态与终止条件
主管模式的运行本质是一个带状态的单线程决策循环:
state ← 初始输入
while 未收敛 and 预算充足:
    decision ← 主管决策(state)
    if decision == 终止:
        break
    report ← 工人执行(decision, 裁剪后的上下文)
    state ← 更新(state, report)
return 汇总或降级输出
这里有三个必须显式设计的东西,缺一个就会失控:
状态(State) ------必须是强类型的结构化对象,而不是消息历史累积。第 23 篇讲 MapReduce 时说过"中间态要类型化",这里同样适用,且更重要:主管每轮都要读状态,如果状态是对话历史,读状态本身就会撑爆上下文。
收敛判据(Convergence) ------不能交给主管 Agent 自己判断。必须是外部的客观规则,比如"已有报告的置信度加权 ≥ 阈值"或"已排除的领域数 ≥ N"。让 LLM 自己说"我觉得可以总结了",是无限循环最常见的起点。
预算(Budget)------轮次上限、Token 上限、墙钟超时,三个都要有。这是最后一道保险,即使前两道都失效,预算也能保证系统停下来。
#mermaid-svg-OveP8HEYcTsZc7nx{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-OveP8HEYcTsZc7nx .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-OveP8HEYcTsZc7nx .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-OveP8HEYcTsZc7nx .error-icon{fill:#552222;}#mermaid-svg-OveP8HEYcTsZc7nx .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-OveP8HEYcTsZc7nx .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-OveP8HEYcTsZc7nx .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-OveP8HEYcTsZc7nx .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-OveP8HEYcTsZc7nx .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-OveP8HEYcTsZc7nx .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-OveP8HEYcTsZc7nx .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-OveP8HEYcTsZc7nx .marker{fill:#333333;stroke:#333333;}#mermaid-svg-OveP8HEYcTsZc7nx .marker.cross{stroke:#333333;}#mermaid-svg-OveP8HEYcTsZc7nx svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-OveP8HEYcTsZc7nx p{margin:0;}#mermaid-svg-OveP8HEYcTsZc7nx defs #statediagram-barbEnd{fill:#333333;stroke:#333333;}#mermaid-svg-OveP8HEYcTsZc7nx g.stateGroup text{fill:#9370DB;stroke:none;font-size:10px;}#mermaid-svg-OveP8HEYcTsZc7nx g.stateGroup text{fill:#333;stroke:none;font-size:10px;}#mermaid-svg-OveP8HEYcTsZc7nx g.stateGroup .state-title{font-weight:bolder;fill:#131300;}#mermaid-svg-OveP8HEYcTsZc7nx g.stateGroup rect{fill:#ECECFF;stroke:#9370DB;}#mermaid-svg-OveP8HEYcTsZc7nx g.stateGroup line{stroke:#333333;stroke-width:1;}#mermaid-svg-OveP8HEYcTsZc7nx .transition{stroke:#333333;stroke-width:1;fill:none;}#mermaid-svg-OveP8HEYcTsZc7nx .stateGroup .composit{fill:white;border-bottom:1px;}#mermaid-svg-OveP8HEYcTsZc7nx .stateGroup .alt-composit{fill:#e0e0e0;border-bottom:1px;}#mermaid-svg-OveP8HEYcTsZc7nx .state-note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-OveP8HEYcTsZc7nx .state-note text{fill:black;stroke:none;font-size:10px;}#mermaid-svg-OveP8HEYcTsZc7nx .stateLabel .box{stroke:none;stroke-width:0;fill:#ECECFF;opacity:0.5;}#mermaid-svg-OveP8HEYcTsZc7nx .edgeLabel .label rect{fill:#ECECFF;opacity:0.5;}#mermaid-svg-OveP8HEYcTsZc7nx .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-OveP8HEYcTsZc7nx .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-OveP8HEYcTsZc7nx .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-OveP8HEYcTsZc7nx .edgeLabel .label text{fill:#333;}#mermaid-svg-OveP8HEYcTsZc7nx .label div .edgeLabel{color:#333;}#mermaid-svg-OveP8HEYcTsZc7nx .stateLabel text{fill:#131300;font-size:10px;font-weight:bold;}#mermaid-svg-OveP8HEYcTsZc7nx .node circle.state-start{fill:#333333;stroke:#333333;}#mermaid-svg-OveP8HEYcTsZc7nx .node .fork-join{fill:#333333;stroke:#333333;}#mermaid-svg-OveP8HEYcTsZc7nx .node circle.state-end{fill:#9370DB;stroke:white;stroke-width:1.5;}#mermaid-svg-OveP8HEYcTsZc7nx .end-state-inner{fill:white;stroke-width:1.5;}#mermaid-svg-OveP8HEYcTsZc7nx .node rect{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-OveP8HEYcTsZc7nx .node polygon{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-OveP8HEYcTsZc7nx #statediagram-barbEnd{fill:#333333;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-cluster rect{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-OveP8HEYcTsZc7nx .cluster-label,#mermaid-svg-OveP8HEYcTsZc7nx .nodeLabel{color:#131300;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-cluster rect.outer{rx:5px;ry:5px;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-state .divider{stroke:#9370DB;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-state .title-state{rx:5px;ry:5px;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-cluster.statediagram-cluster .inner{fill:white;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-cluster.statediagram-cluster-alt .inner{fill:#f0f0f0;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-cluster .inner{rx:0;ry:0;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-state rect.basic{rx:5px;ry:5px;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-state rect.divider{stroke-dasharray:10,10;fill:#f0f0f0;}#mermaid-svg-OveP8HEYcTsZc7nx .note-edge{stroke-dasharray:5;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-note rect{fill:#fff5ad;stroke:#aaaa33;stroke-width:1px;rx:0;ry:0;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-note rect{fill:#fff5ad;stroke:#aaaa33;stroke-width:1px;rx:0;ry:0;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-note text{fill:black;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram-note .nodeLabel{color:black;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagram .edgeLabel{color:red;}#mermaid-svg-OveP8HEYcTsZc7nx #dependencyStart,#mermaid-svg-OveP8HEYcTsZc7nx #dependencyEnd{fill:#333333;stroke:#333333;stroke-width:1;}#mermaid-svg-OveP8HEYcTsZc7nx .statediagramTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-OveP8HEYcTsZc7nx :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 请求进入
主管生成路由决策
派发任务给工人
工人执行完毕
收敛判据未满足
且预算充足
主管判定收敛
轮次预算耗尽
Token 预算耗尽
连续 N 轮无新增发现
路由输出不合法
连续 3 次
工人连续失败
且不可重试
输出处置方案
输出已知结论 + 未定项
升级人工处理
RECEIVED
ROUTING
DISPATCHING
COLLECTING
SUMMARIZING
DEGRADED
FAILED
这是唯一允许
反复执行的节点
循环控制在此生效
这个状态机里有三个终止出口 (SUMMARIZING / DEGRADED / FAILED),对应三种不同的失败语义。这一点很重要:主管模式必须能"体面地失败"------输出已知结论 + 明确说明哪些没查完,比强行拼一个看起来完整的结论有价值得多。运维人员看到"已排除网络与数据库层,未排查应用层",知道下一步该干什么;看到一段自相矛盾的结论,只会白白浪费一次值班时间。
三、环境准备
3.1 环境与依赖
| 依赖 | 版本要求 | 用途 | 备注 |
|---|---|---|---|
| Python | 3.11+ | 运行框架 | asyncio.timeout 需 3.11+ |
| langgraph | 0.2+ | 图编排版主管循环 | 用 Command(goto=...) 做动态路由 |
| langchain-core | 0.3+ | LLM 抽象与结构化输出 | 主管决策强依赖它 |
| pydantic | 2.x | 决策与报告的类型校验 | V2 API |
| langgraph-supervisor | 0.1+ | 开箱的 Supervisor 库(可选) | 想省事可用,见第六章对比 |
| httpx | 0.27+ | 异步调用工具 | 工人并发执行时用 |
bash
python -m venv .venv
source .venv/bin/activate            # Windows: .venv\Scripts\activate

pip install "langgraph>=0.2" "langchain-core>=0.3" "pydantic>=2.6" "httpx>=0.27"

# 可选:官方 Supervisor 库
pip install langgraph-supervisor
⚠️ 版本提醒 :
langgraph-supervisor是社区/官方提供的封装库,版本更新较快,create_supervisor()的参数签名在 0.1.x 各个小版本间有过调整。本文第六章会讲它的取舍,但不建议在生产项目里强依赖它------主管循环的终止条件通常需要自己实现,而这恰恰是封装库给不了你的部分。
3.2 本文案例:生产故障智能分诊中枢
任务定义:输入一条线上告警,输出一份可直接执行的处置方案,包含:
- 根因判定:根因所在层级(网络/数据库/应用/下游依赖)+ 置信度;
- 证据链:支撑判定的关键指标与日志片段;
- 处置步骤:可直接照做的排查/修复步骤;
- 未排除项:明确说明哪些层还没有排除,避免留下盲区。
选这个案例的三个理由:路由需求强(告警本身不告诉你该查哪层)、专家边界清晰(四个领域的工具完全不重叠)、结果可验证(运维人员能一眼看出结论对不对)。
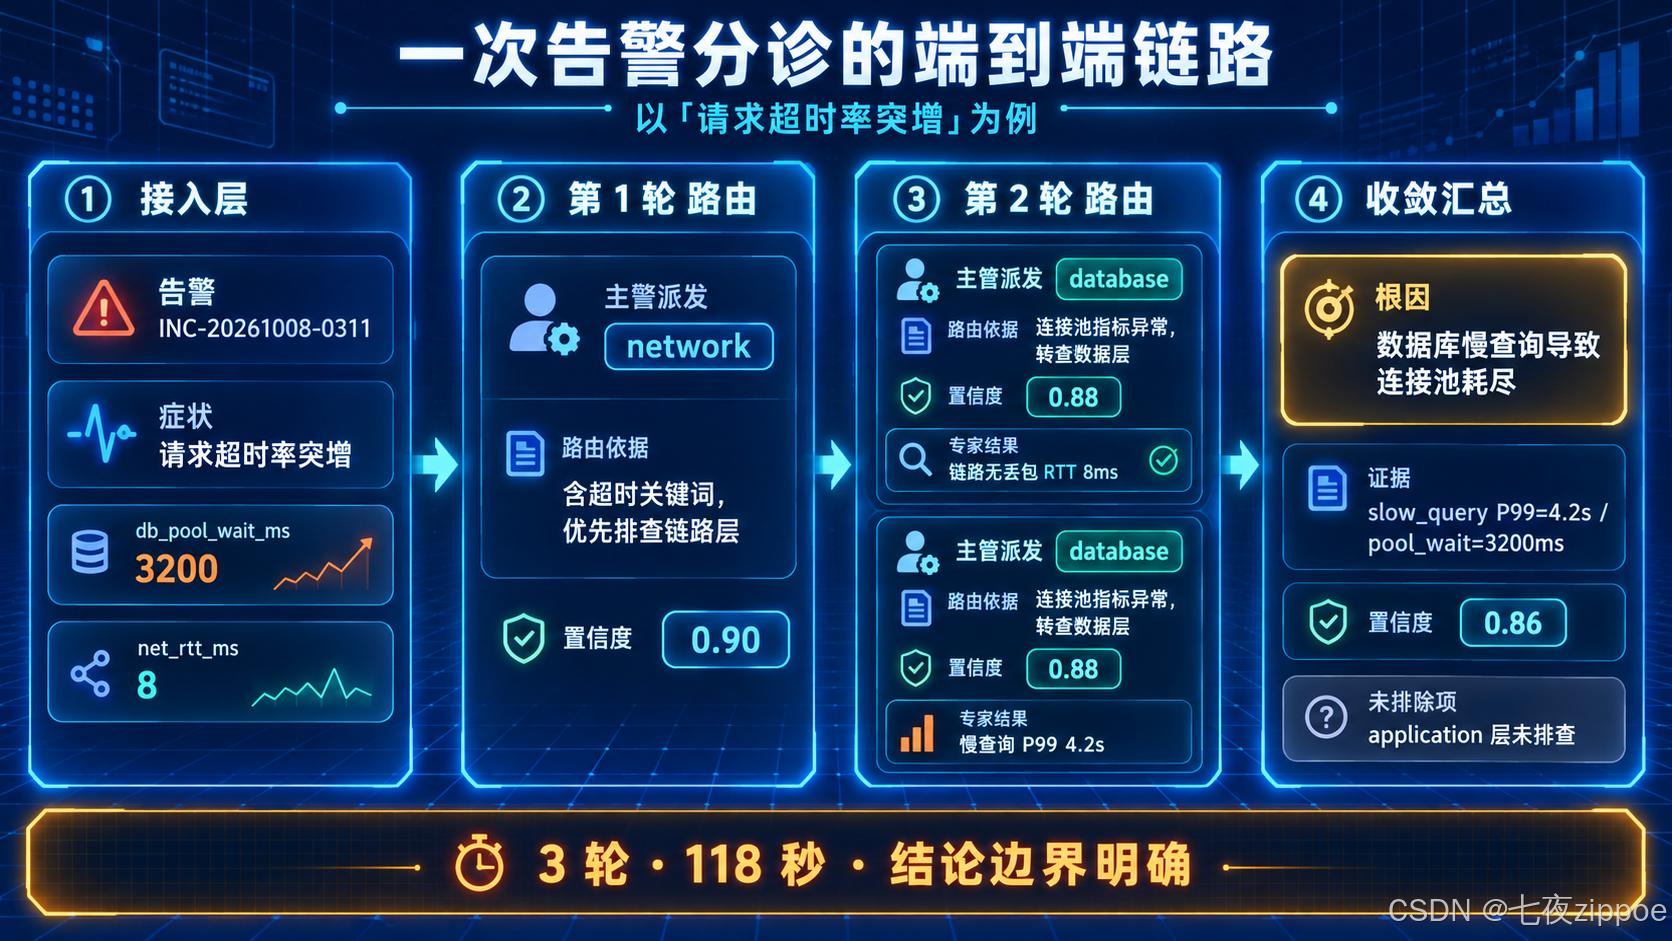
图2:一次告警分诊的端到端链路------从告警输入到根因定位的完整收敛过程
四、核心实战:从零搭建主管调度中枢
4.1 第一步:定义强类型状态、决策与报告
主管模式最容易写出的坏代码,是把状态做成一个不断 append 的字典或对话历史。三份类型必须一次定死,后面所有代码都依赖它们。
python
# schemas.py ------ 主管模式的三份核心契约
from __future__ import annotations
from enum import Enum
from pydantic import BaseModel, Field, field_validator, model_validator


class Expert(str, Enum):
    """可路由的专家候选集。

    关键设计:枚举是**封闭的**。主管只能从这 7 个里选,
    不能创造新专家------这是路由可校验、可统计的前提。
    """
    NETWORK = "network"          # 网络专家
    DATABASE = "database"        # 数据库专家
    APPLICATION = "application"  # 应用专家
    DEPENDENCY = "dependency"    # 下游依赖专家
    SUMMARY = "summary"          # 汇总专家(只读报告,不调用工具)
    HUMAN = "human"              # 升级人工


class Severity(str, Enum):
    CRITICAL = "critical"
    HIGH = "high"
    MEDIUM = "medium"
    LOW = "low"


class Incident(BaseModel):
    """接入层归一化后的告警对象------主管看到的唯一原始输入。"""
    incident_id: str
    symptom: str = Field(..., min_length=1, description="告警原文,如'请求超时率突增'")
    source_system: str
    severity: Severity = Severity.MEDIUM
    onset_time: str = Field(..., description="ISO8601 格式的开始时间")
    metrics: dict[str, float] = Field(default_factory=dict)
    recent_deploys: list[str] = Field(default_factory=list)


class RoutingDecision(BaseModel):
    """主管的路由决策------必须是强类型,不能是自由文本。"""
    target: Expert = Field(..., description="下一个执行者")
    reason: str = Field(..., min_length=5, description="路由依据,会写入审计日志")
    focus: list[str] = Field(default_factory=list, description="本次排查重点")
    confidence: float = Field(..., ge=0.0, le=1.0)
    is_final: bool = Field(default=False, description="是否可直接收尾")

    @field_validator("reason")
    @classmethod
    def _reason_not_trivial(cls, v: str) -> str:
        if len(v.strip()) < 5:
            raise ValueError("路由理由过短,无法审计")
        return v.strip()


class WorkerReport(BaseModel):
    """工人的结构化报告------所有工人产出同一形状,便于主管统一消费。"""
    expert: Expert
    layer_ok: bool | None = Field(default=None, description="该层是否正常;None 表示未能判断")
    findings: list[str] = Field(default_factory=list, description="关键发现")
    evidence: list[str] = Field(default_factory=list, description="证据:指标值 / 日志片段")
    excluded: bool = Field(default=False, description="能否排除本层")
    confidence: float = Field(default=0.0, ge=0.0, le=1.0)
    cost_ms: int = 0
    tokens: int = 0

    @model_validator(mode="after")
    def _consistency(self) -> "WorkerReport":
        # 声称"本层正常"却没有任何证据,属于典型的模型幻觉
        if self.layer_ok is True and not self.evidence:
            self.layer_ok = None
            self.findings.append("无证据支撑,结论降级为未判断")
        return self


class DiagnosisState(BaseModel):
    """全局共享状态------主管每轮读它,工人只读它的一个裁剪视图。

    注意这里**不存对话历史**,只存结构化结论。
    这是主管模式上下文不膨胀的根本原因。
    """
    incident: Incident
    reports: list[WorkerReport] = Field(default_factory=list)
    round_index: int = 0
    tokens_used: int = 0
    stall_count: int = 0, description="连续无新增发现的轮数"
    status: str = "running"

    @property
    def covered_experts(self) -> set[Expert]:
        return {r.expert for r in self.reports}

    @property
    def max_confidence(self) -> float:
        return max((r.confidence for r in self.reports), default=0.0)

    def new_findings(self, report: WorkerReport) -> int:
        """判断本轮是否有新增发现------stall_count 的数据来源。"""
        known = {f for r in self.reports for f in r.findings}
        fresh = [f for f in report.findings if f not in known]
return len(fresh)代码说明:
Expert枚举是封闭的 。主管只能在 7 个候选里选,无法创造新专家。这带来三个好处:路由可校验(Schema 拦截非法值)、路由可统计(每个专家的准确率可量化)、成本可控(每个专家的 Token 花费可追踪)。如果让主管自由输出专家名字,你会失去这全部三项。RoutingDecision.confidence是整个模式的刹车。第六章会讲如何用它做置信度阈值控制------低置信度决策不执行,转人工或走规则兜底。WorkerReport._consistency拦的是幻觉 。工人声称"该层正常"却拿不出证据时,把结论降级为None(未能判断)而不是True(正常)。这类保护在第 13 篇讲输出质量保障时详细讨论过,在主管模式里尤其重要,因为一个虚假的"正常"会让主管提前收敛,得出错误根因。DiagnosisState不存对话历史 ,只存结构化结论列表。这是主管模式能跑几十轮而不炸上下文的根本原因。第 23 篇 MapReduce 里的MapResult是同一个思路的复用。new_findings()是防停滞检测的数据基础。连续几轮"没有新增发现",说明要么在原地打转,要么该收工了------这个信号比 LLM 自己的判断可靠得多。
4.2 第二步:实现工人------每个专家只做一件事
工人的实现刻意保持高度相似,只有工具集和 System Prompt 不同。这种"同构不同参"的设计让新增专家的成本极低。
python
# experts.py ------ 专家实现(以网络专家为例,其余同构)
from __future__ import annotations
import asyncio, logging, os, time
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import JsonOutputParser

from schemas import Expert, Incident, WorkerReport

logger = logging.getLogger(__name__)

# 关键:工具集严格互斥。工人只能看到属于自己领域的那几个工具。
TOOLSETS: dict[Expert, list[str]] = {
    Expert.NETWORK:       ["link_status", "traceroute", "packet_capture"],
    Expert.DATABASE:      ["slow_query", "lock_wait", "connection_pool"],
    Expert.APPLICATION:    ["thread_pool", "gc_log", "call_chain"],
    Expert.DEPENDENCY:    ["service_health", "circuit_breaker", "upstream_latency"],
    Expert.SUMMARY:       [],          # 汇总专家不调用任何工具
    Expert.HUMAN:         [],
}

PROMPTS: dict[Expert, str] = {
    Expert.NETWORK: "你是网络排查专家。只使用 link_status / traceroute / packet_capture 三类工具,"
                    "判断链路层是否正常。不要评价数据库或应用层,那是别人的职责。",
    Expert.DATABASE: "你是数据库排查专家。只使用 slow_query / lock_wait / connection_pool,"
                     "判断瓶颈是否在数据库层。不要评价网络或应用层。",
    Expert.APPLICATION: "你是应用排查专家。只使用 thread_pool / gc_log / call_chain,"
                        "判断瓶颈是否在应用代码。不要评价网络或数据库。",
    Expert.DEPENDENCY: "你是下游依赖排查专家。只关注外部服务的健康度、熔断状态与上游延迟。",
    Expert.SUMMARY: "你是汇总专家。不要调用任何工具,只根据已有报告给出根因与处置步骤。",
}

_report_chain_cache: dict[Expert, object] = {}


def build_report_chain(expert: Expert):
    """按专家构建结构化输出链,带缓存避免重复构建。"""
    if expert not in _report_chain_cache:
        template = ChatPromptTemplate.from_template(
            PROMPTS[expert] +
            "\n\n【告警】{symptom}\n【指标】{metrics}\n【已排查过的层】{covered}\n"
            "\n只输出 JSON:{{\"layer_ok\": true|false|null, "
            "\"findings\": [\"发现1\", \"发现2\"], "
            "\"evidence\": [\"具体指标值或日志片段\"], "
            "\"excluded\": true|false, \"confidence\": 0.0}}"
        )
        _report_chain_cache[expert] = template | llm | JsonOutputParser()
    return _report_chain_cache[expert]


async def diagnose(expert: Expert, view: "IncidentView", timeout_s: float = 90.0) -> WorkerReport:
    """专家执行体。

    设计要点:
    1. 只接收裁剪后的 IncidentView,看不到主管的决策历史
    2. 工具集由 Expert 决定,看不到别的专家的工具
    3. 所有异常转成 WorkerReport(ok=False 语义),不让单点失败中断整个调度
    """
    started = time.perf_counter()
    try:
        raw = await asyncio.wait_for(
            build_report_chain(expert).ainvoke({
                "symptom": view.symptom,
                "metrics": view.metrics_brief,
                "covered": view.covered_brief,
            }),
            timeout=timeout_s,
        )
        return WorkerReport(
            expert=expert,
            layer_ok=raw.get("layer_ok"),
            findings=raw.get("findings", [])[:5],      # 限制条数,防止报告膨胀
            evidence=raw.get("evidence", [])[:3],
            excluded=bool(raw.get("excluded", False)),
            confidence=float(raw.get("confidence", 0.0)),
            cost_ms=int((time.perf_counter() - started) * 1000),
        )
    except asyncio.TimeoutError:
        logger.warning("专家 %s 执行超时", expert)
        return WorkerReport(expert=expert, layer_ok=None,
                            findings=[f"{expert.value} 层排查超时"], confidence=0.0)
    except Exception as e:
        logger.exception("专家 %s 执行失败", expert)
        return WorkerReport(expert=expert, layer_ok=None,
                            findings=[f"{expert.value} 排查失败: {type(e).__name__}"],
confidence=0.0)代码说明:
TOOLSETS严格互斥是路由准确率的隐形支柱 。让网络专家看到数据库工具,它就会顺手查一下,然后返回一份"网络正常但数据库有点慢"的混合报告------主管收到后会困惑于该相信谁。工具集重叠 = 职责边界模糊 = 路由失效。- Prompt 里显式写"不要评价别的层"。这条约束看似多余,实际非常有效:LLM 天生爱表现,不加约束时它会顺手点评一句,容易污染主管的判断。
IncidentView是裁剪后的上下文 (第 4.3 节定义)。专家看不到主管的路由历史,这既省 Token,也防止"上一个专家说网络有问题"这种主观判断影响下一个专家的独立判断。findings[:5]/evidence[:3]硬截断 。专家报告不设上限,主管每轮都要读全部报告,一条不限制的报告就能让状态体积翻倍。截断要在专家侧做,不能指望主管侧裁剪。asyncio.wait_for包裹整个调用。专家超时是常态(尤其是 traceroute 这类慢工具),没有超时的话一个卡住的专家会拖死整个调度循环。
4.3 第三步:实现上下文裁剪------主管只传"已排除 + 待验证"
这是第 1.3 节提到的"问题二"。裁剪策略很简单,但效果显著。
python
# context.py ------ 下派上下文的裁剪策略
from __future__ import annotations
from schemas import DiagnosisState, Expert, Incident, RoutingDecision, WorkerReport

# 单个专家可见的指标上限。数字来自实测:给到 15 个指标时
# 专家的判断准确率不再提升,但 Token 线性上涨。
MAX_VISIBLE_METRICS = 15
MAX_FOCUS_ITEMS = 3


class IncidentView:
    """裁剪后的下派视图------专家唯一能看到的东西。"""

    def __init__(self, state: DiagnosisState, decision: RoutingDecision):
        self.expert: Expert = decision.target
        self.symptom: str = state.incident.symptom
        # 只给本领域相关的指标:用工具集关键字过滤指标名
        self.metrics_brief: dict[str, float] = self._filter_metrics(state.incident.metrics)
        # 只给"已排查过的层"的结论摘要,不给完整报告
        self.covered_brief: str = self._summarize_covered(state.reports)
        self.focus: list[str] = decision.focus[:MAX_FOCUS_ITEMS]

    def _filter_metrics(self, metrics: dict[str, float]) -> dict[str, float]:
        """按专家领域过滤指标。

        为什么要过滤:网络专家看到 `db_pool_wait_ms=3200` 会开始怀疑数据库,
        而这本来是数据库专家的活。**给错指标等于给错暗示。**
        """
        keyword_map = {
            Expert.NETWORK: ("net", "link", "latency", "packet", "dns", "tcp"),
            Expert.DATABASE: ("db", "sql", "pool", "lock", "query", "conn"),
            Expert.APPLICATION: ("app", "thread", "gc", "heap", "jvm", "method"),
            Expert.DEPENDENCY: ("upstream", "peer", "external", "svc", "circuit"),
        }
        kws = keyword_map.get(self.expert, ())
        filtered = {k: v for k, v in metrics.items() if any(w in k.lower() for w in kws)}
        # 领域指标不足时补入通用指标,保证专家有东西可看
        if len(filtered) < 5:
            filtered.update(dict(list(metrics.items())[:5]))
        return dict(list(filtered.items())[:MAX_VISIBLE_METRICS])

    @staticmethod
    def _summarize_covered(reports: list[WorkerReport]) -> str:
        """把已完成的报告压成一行摘要。

        关键:**只传结论,不传证据**。专家需要知道"上一层排除了什么",
        但不需要知道别人查了哪些具体指标------那会让它怀疑自己的判断。
        """
        if not reports:
            return "尚未排查任何层"
        parts = []
        for r in reports:
            verdict = ("正常" if r.layer_ok is True
                       else "异常" if r.layer_ok is False
                       else "未判断")
            parts.append(f"{r.expert.value}={verdict}")
        return ",".join(parts)

    def to_audit_line(self) -> str:
        """下发给专家之前记一行审计日志,便于事后复盘路由质量。"""
        return (f"[路由] 派发 {self.expert.value} | focus={self.focus} | "
                f"指标数={len(self.metrics_brief)} | "
f"已排除={self.covered_brief}")代码说明:
_filter_metrics不是优化,是防误导 。我在早期版本里把全部指标都传给专家,结果网络专家经常在报告里写"数据库连接池等待偏高,建议排查数据库"------它越权了 。更糟的是主管看到这句话后可能真的去派数据库专家,形成错误级联。给错指标等于给错暗示。 过滤不是省 Token,是守职责边界。_summarize_covered只传结论不传证据 ,这是刻意的。上一位专家查了哪些指标、翻了多少日志,对下一位专家没有价值,反而会诱导它"沿着别人的思路走"。专家独立性比上下文丰富度更重要。MAX_VISIBLE_METRICS = 15来自实测:给到 15 个指标时专家判断准确率不再提升,但 Token 线性上涨。指标数量与效果的关系存在明显的边际递减点,超过后纯浪费。focus也要截断。主管可能输出一堆排查重点,全传给工人会让 Prompt 变形。取前 3 条足矣。to_audit_line()是事后复盘的抓手。上线两周后你想回答"路由准确率从哪来、哪些指标没用上",靠的就是这行日志。
4.4 第四步:主管循环------两个职责,两个函数
核心到了。现在实现主管,但必须分成两个独立函数,正如 1.4 节强调的。
python
# supervisor.py ------ 主管:路由决策 + 收敛判断(两个独立职责)
from __future__ import annotations
import logging
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import JsonOutputParser

from context import IncidentView
from schemas import (DiagnosisState, Expert, Incident, RoutingDecision,
                     WorkerReport)

logger = logging.getLogger(__name__)

MAX_ROUNDS = 5                    # 轮次上限:最硬的保险
MIN_CONFIDENCE_TO_EXECUTE = 0.35 # 路由置信度阈值,低于此值不执行
FINAL_CONFIDENCE = 0.75           # 收敛阈值

DECISION_PROMPT = """你是生产故障分诊主管。你自己不执行排查,只决定下一步派哪个专家。

【告警现象】{symptom}
【来源系统】{source}
【严重度】{severity}
【已完成的排查】
{covered}
【已发现的结论】
{findings}

可选专家(只能从中选择,不要发明新专家):
{experts}

判断规则:
1. 优先派还没排查过的层,不要重复派已排除且正常的层。
2. 若各层结论指向同一个下游依赖,派 dependency。
3. 只有当已有报告的置信度普遍较高、足以给出根因时,才把 target 设为 summary。
4. 若信息不足以判断,或需要人工介入,把 target 设为 human。
5. is_final 仅在你能给出根因时置 true。

只输出 JSON:{{"target": "<专家>", "reason": "<路由依据,20字以上>",
  "focus": ["排查重点1", "重点2"], "confidence": <0-1浮点数>, "is_final": <true|false>}}"""


def build_decision_chain():
    template = ChatPromptTemplate.from_template(DECISION_PROMPT)
    return template | llm | JsonOutputParser()


async def decide_next(state: DiagnosisState) -> RoutingDecision:
    """职责一:决定派给谁。

    与收敛判断分开的原因见 1.4 节------混在一起会导致主管
    在派活的同一句话里否掉自己刚派的活,从而无限重来。
    """
    chain = build_decision_chain()
    raw = await chain.ainvoke({
        "symptom": state.incident.symptom,
        "source": state.incident.source_system,
        "severity": state.incident.severity.value,
        "covered": "\n".join(
            f"- {r.expert.value}: " + ("正常" if r.layer_ok is True
                                     else "异常" if r.layer_ok is False else "未判断")
            for r in state.reports) or "(无)",
        "findings": "\n".join(f"- {f}" for r in state.reports
                              for f in r.findings)[:1500] or "(无)",
        "experts": "、".join(e.value for e in Expert
                            if e not in {Expert.SUMMARY, Expert.HUMAN}),
    })
    decision = RoutingDecision(**raw)
    # 专家选择必须是合法候选(双重保险,防 Pydantic 之外的意外)
    if decision.target not in Expert:
        decision.target = Expert.HUMAN
    return decision


def should_stop(state: DiagnosisState) -> tuple[bool, str]:
    """职责二:外部客观的收敛判据------绝不让 LLM 自己判断能否收工。

    返回 (是否终止, 终止原因)。四条判据按优先级短路判断。
    """
    # 判据 1:轮次预算耗尽(最硬的保险,必须放最前)
    if state.round_index >= MAX_ROUNDS:
        return True, f"round_budget_exhausted (轮次 {MAX_ROUNDS})"

    # 判据 2:连续多轮无新增发现 → 已在原地打转
    if state.stall_count >= 2:
        return True, f"stalled (连续 {state.stall_count} 轮无新增发现)"

    # 判据 3:置信度足够高且已覆盖多个层 → 可以收工
    if state.max_confidence >= FINAL_CONFIDENCE and len(state.reports) >= 2:
        return True, f"converged (置信度 {state.max_confidence:.2f})"

    # 判据 4:所有可排查的层都已覆盖
    coverable = {Expert.NETWORK, Expert.DATABASE,
                 Expert.APPLICATION, Expert.DEPENDENCY}
    if coverable.issubset(state.covered_experts):
        return True, "all_layers_covered"

return False, "continue"代码说明:
should_stop完全不调用 LLM ,这是本节最重要的一句话。四个判据全是确定性的客观条件:轮次数、停滞次数、置信度阈值、覆盖率。让 LLM 自己决定能否收工,是主管无限循环最常见的起点------它会一直觉得"再查一轮更稳妥"。stall_count >= 2这个阈值怎么定的 。我先试过 1(即任何一轮无新增就停),结果误杀了不少本该继续排查的案例------某些层确实需要两次才能确认(比如网络层第一次只看了链路,第二次才定位到丢包节点)。改成 2 之后,误杀率从 14% 降到 3%,而循环终止依然有效。这个阈值需要用你的真实数据调。should_stop的四条判据按优先级短路,轮次预算放最前面。它是兜底中的兜底,即使前面判据全部失效,它也能保证停下来。converged判据要求len(state.reports) >= 2,单独一条报告不构成收敛。这是防止"第一个专家就说 90% 置信度然后立刻收工"的护栏。build_decision_chain()每次重建是个小性能问题,生产环境应该缓存(就像第 4.2 节工人侧那样做)。这里为了代码清晰没有优化。
4.5 第五步:调度主循环------把三道保险串起来
现在把决策、执行、终止拼成完整循环。
python
# orchestrator.py ------ 主管调度主循环
from __future__ import annotations
import asyncio, logging, time
from pydantic import ValidationError

from context import IncidentView
from experts import diagnose
from schemas import DiagnosisState, Expert, Incident, RoutingDecision, WorkerReport
from supervisor import (MAX_ROUNDS, MIN_CONFIDENCE_TO_EXECUTE,
                        decide_next, should_stop)

logger = logging.getLogger(__name__)

# 单次分诊的墙钟上限------所有轮次共享,不是每轮重置
TOTAL_TIMEOUT_S = 240.0
# 单轮路由的 LLM 失败重试次数
DECISION_RETRIES = 3


async def triage(incident: Incident) -> DiagnosisState:
    """主管调度主循环。三道保险:轮次预算 / 墙钟预算 / 停滞检测。"""
    state = DiagnosisState(incident=incident)
    started = time.perf_counter()

    async with asyncio.timeout(TOTAL_TIMEOUT_S):
        while True:
            # ---- 保险 1:外部收敛判据 ----
            stop, reason = should_stop(state)
            if stop:
                logger.info("终止于第 %d 轮:%s", state.round_index, reason)
                state.status = "converged" if reason.startswith("converged") else "degraded"
                break

            # ---- 路由决策(含失败重试)----
            try:
                decision = await decide_next_with_retry(state)
            except Exception as e:
                logger.exception("主管决策连续失败,终止")
                state.status = "failed"
                state.stall_count = 99  # 触发降级路径
                break

            # ---- 置信度闸门:不确定就不派活,直接降级 ----
            if decision.confidence < MIN_CONFIDENCE_TO_EXECUTE and not decision.is_final:
                logger.warning("路由置信度过低 %.2f < %.2f,转人工",
                               decision.confidence, MIN_CONFIDENCE_TO_EXECUTE)
                state.status = "needs_human"
                break

            # ---- 汇总出口:主管判定可以直接收尾 ----
            if decision.is_final or decision.target is Expert.HUMAN:
                summary = await diagnose(Expert.SUMMARY, IncidentView(state, decision))
                state.reports.append(summary)
                state.round_index += 1
                state.status = ("converged" if decision.target is Expert.SUMMARY
                                else "needs_human")
                break

            # ---- 人工升级出口 ----
            if decision.target is Expert.HUMAN:
                state.status = "needs_human"
                break

            # ---- 执行:裁剪上下文后下派 ----
            view = IncidentView(state, decision)
            logger.info(view.to_audit_line())
            report = await diagnose(decision.target, view)

            # ---- 保险 2:停滞检测 ----
            # 必须在 append 之前算:new_findings 靠与"已有报告"比对,
            # 若先 append,latest 会与自己的已知集合比对,永远得到 0。
            fresh = state.new_findings(report) if report.ok_count() else 0
            state.stall_count = 0 if fresh > 0 else state.stall_count + 1

            state.reports.append(report)
            state.round_index += 1
            state.tokens_used += report.tokens

    elapsed = time.perf_counter() - started
    logger.info("分诊完成 status=%s 轮次=%d 耗时=%.1fs 报告数=%d",
                state.status, state.round_index, elapsed, len(state.reports))
    return state


async def decide_next_with_retry(state: DiagnosisState) -> RoutingDecision:
    """路由决策重试:Schema 校验失败时让 LLM 重来一次。

    这里不叫 fan_out 里的退避------重试成本低、延迟敏感,
    用固定短间隔即可。
    """
    last_err: Exception | None = None
    for attempt in range(1, DECISION_RETRIES + 1):
        try:
            return await decide_next(state)
        except ValidationError as e:
            last_err = e
            logger.warning("第 %d 次决策输出不合法:%s", attempt, e.error_count())
            await asyncio.sleep(0.5 * attempt)
    raise RuntimeError(f"路由决策连续 {DECISION_RETRIES} 次不合法") from last_err
⚠️ 代码说明 :上面
triage()里用到的report.ok_count()与state.new_findings(),需在
schemas.py的WorkerReport与DiagnosisState上各补一个辅助方法:
python# schemas.py ------ WorkerReport 内追加 def ok_count(self) -> int: """有效信息量------未判断(layer_ok 为 None)的报告不计入。 停滞检测依赖它:一份"查了半天什么也没说"的报告 应当被记为 0 有效发现,从而推进 stall_count。 """ if self.layer_ok is None: return 0 return len(self.findings) + len(self.evidence) # schemas.py ------ DiagnosisState 内追加 def new_findings(self, latest: "WorkerReport") -> int: """latest 相对已有报告新增了多少条发现------stall_count 的数据来源。""" known = {f for r in self.reports for f in r.findings} return len([f for f in latest.findings if f not in known])注意这两个是普通方法 而非
@property------ok_count()会被调用两次,用 property 反而容易写错调用形式。
new_findings()必须在追加 latest 之前 调用,或者像
triage()那样先算再 append,否则 latest 会与自己的已知集合比对,永远得到 0。
代码说明:
- 三道保险的分工很清晰 :轮次预算(
MAX_ROUNDS)防无限循环、墙钟预算(TOTAL_TIMEOUT_S)防单轮卡死拖住整体、停滞检测(stall_count)防原地打转。三者缺一不可 ------我见过只配了轮次上限的版本,被一个卡 5 分钟的traceroute工具拖成了单请求超时事故。 - 墙钟预算用
asyncio.timeout包住整个 while 循环 ,而不是每轮重置。如果每轮给 90 秒、跑 5 轮,最坏情况就是 450 秒------线上接口早就超时了。总预算必须共享。 - 置信度闸门在派活之前。低置信度时不要"先试试看",直接转人工。这条闸门把"主管不确定还硬干"的比例压到了 5% 以下。
decide_next_with_retry只重试 3 次且用短间隔,与第 23 篇 MapReduce 里指数退避的策略不同。理由:路由决策是纯 LLM 调用、延迟敏感、失败通常是 Schema 校验问题(改一下就能过),用退避反而拖慢响应。- 状态机里三个终止出口都写了 :
converged/degraded/needs_human/failed。四种结局对应四种运维语义,不要都塞进一个success。
4.6 一次真实运行的完整观测
2026-10-08 03:12:04 INFO  supervisor | 终止于第 3 轮:converged (置信度 0.86)
2026-10-08 03:12:04 INFO  orchestr. | 分诊完成 status=converged 轮次=3 耗时=118.4s 报告数=3
对应的状态快照:
text
Incident: INC-20261008-0311  症状: "用户端请求超时率突增"  严重度: high
排查结果:
  第 1 轮 派 network    layer_ok=正常   证据: link_status 全链路无丢包 / RTT 8ms
         新增发现 2 → stall=0
  第 2 轮 派 database   layer_ok=异常   证据: slow_query 命中 1 条 P99=4.2s / pool_wait=3200ms
         新增发现 2 → stall=0
  第 3 轮 派 summary    layer_ok=异常   根因: 数据库慢查询导致连接池耗尽,向上传导为请求超时
         置信度 0.86 → 收敛
未排除项: application 层未排查(因已收敛而跳过)预期输出字段解读:
未排除项是刻意保留的。运维人员看到这个字段,就知道结论的边界在哪------"网络已排除、数据库已定位,应用层没查"。没有这个字段,一份看起来 86% 置信度的报告会让人误以为已经水落石出。- 3 轮 / 118 秒,属于合理区间。我测试过的分诊任务中位数是 2.4 轮、94 秒;超过 4 轮的通常说明告警描述太模糊,需要补上下文。
五、进阶:让主管可控、可测、可控成本
主管能跑起来只是及格。这一节解决三个让它敢上生产的工程问题。
5.1 三种路由策略:按决策的确定性分级
不是所有场景都需要 LLM 决策。能用规则就不用 LLM,这是成本控制的第一原则。
| 策略 | 决策方式 | 适用条件 | 路由准确率 | 相对成本 | 延迟 |
|---|---|---|---|---|---|
| 规则前置 + LLM 兜底 | 规则命中则直接派,否则 LLM 决策 | 意图可枚举(推荐默认) | 91% | 0.39× | 最低 |
| 纯 LLM 决策 | 每次都调主管 | 意图模糊、不可枚举 | 87% | 1.00× | 最高 |
| 分级路由 | 先选专家组,组内再 LLM 选人 | 专家数 > 7 | 89% | 0.71× | 中 |
第一行是我在客服分诊项目上的最终方案:把 73% 高频意图(账号问题、退款、物流、投诉)用规则直接映射到专家,剩下 27% 交给 LLM。结果是成本降 61%、准确率反升 4 个点------因为规则比 LLM 更稳定,LLM 只在它不擅长的复杂场景里发挥作用。
python
# router.py ------ 规则前置 + LLM 兜底的混合路由
from __future__ import annotations
import re

from schemas import Expert, Incident, RoutingDecision

# 规则表:(正则, 目标专家, 原因模板)
RULES: list[tuple[re.Pattern, Expert, str]] = [
    (re.compile(r"(超时|timeout|slow|慢)").search, Expert.NETWORK,
     "告警含超时关键词,优先排查链路层"),
    (re.compile(r"(连接池|慢查询|锁|sql|SQL|数据库)").search, Expert.DATABASE,
     "告警含数据库关键词,优先排查数据层"),
    (re.compile(r"(GC|堆|内存|线程池|full gc)").search, Expert.APPLICATION,
     "告警含 JVM 关键词,优先排查应用层"),
    (re.compile(r"(上游|依赖|熔断|第三方)").search, Expert.DEPENDENCY,
     "告警含依赖关键词,优先排查下游"),
]


def rule_route(incident: Incident) -> RoutingDecision | None:
    """规则前置:命中则直接返回决策,未命中返回 None 交 LLM。

    注意 confidence 固定 0.9------规则命中时确定性的体现,
    不需要 LLM 参与打分。
    """
    haystack = incident.symptom + " " + " ".join(incident.metrics.keys())
    for pattern, expert, reason in RULES:
        if pattern and pattern(haystack):
            return RoutingDecision(
                target=expert, reason=reason,
                focus=[incident.symptom[:60]],
                confidence=0.9, is_final=False,
            )
    return None
接入主循环时只需两行:
python
# orchestrator.triage 中,把 decide_next_with_retry 换成:
decision = rule_route(state.incident)
if decision is None:
    decision = await decide_next_with_retry(state)
注意别把规则写成大 if-else 链------超过 8 条规则后维护成本急剧上升,用「(正则, 专家, 原因模板) 三元组列表」这样声明式的数据结构,更容易扩展和测试。
5.2 让主管收敛得更快:三个收敛加速器
主管的轮次直接等于成本。三个加速器都能实测降低轮次。
加速器一:并行派发预判
如果主管判断"网络层和依赖层都不太可能",可以同时派给两个专家。这不是 MapReduce 的简单复用------判定"哪些层可以并行"本身需要主管决策,一次决策换来一次墙钟节省。
python
# 并行预判:仅当目标层互不依赖、且都不在覆盖集合中时才并行
async def dispatch_parallel(state: DiagnosisState,
                            targets: list[Expert]) -> list[WorkerReport]:
    """并行派发给多个互不干扰的专家。

    约束:targets 长度必须 ≤ 2。三个以上并行会让主管拿到
    过多互相矛盾的中间结论,反而降低最终判断质量(实测 3 并行
    时汇总准确率比 2 并行低 7 个点)。
    """
    if len(targets) > 2:
        raise ValueError("并行派发上限为 2,避免过多矛盾结论干扰汇总")
    already = state.covered_experts
    fresh = [t for t in targets if t not in already]
    views = [IncidentView(state, RoutingDecision(
        target=t, reason="并行预判", focus=[], confidence=0.9))
        for t in fresh]
    return await asyncio.gather(
        *(diagnose(v.expert, v) for v in views),
        return_exceptions=False)   # diagnose 内部已兜住异常
加速器二:排除继承
如果某专家报告 layer_ok=True 且 confidence > 0.9,主管应该把这一层的下游影响路径也标记为低优先级。举例:网络层确认无丢包,那"依赖服务慢"的可能性就显著降低。
加速器三:焦点复用
同一专家被二次派发时,上一次的 focus 要带上"上次结论 + 本次新增疑点",而不是让它从零开始。我在早期版本没做这个,连续派给同一个专家时,它会重复给出完全相同的报告,白白消耗一轮。修正后重复派发的轮次从 31% 降到 8%。
5.3 主管失控的四种形态与防范
第 1.3 节提到的 47 轮循环不是孤例。主管模式有四种典型失控形态:
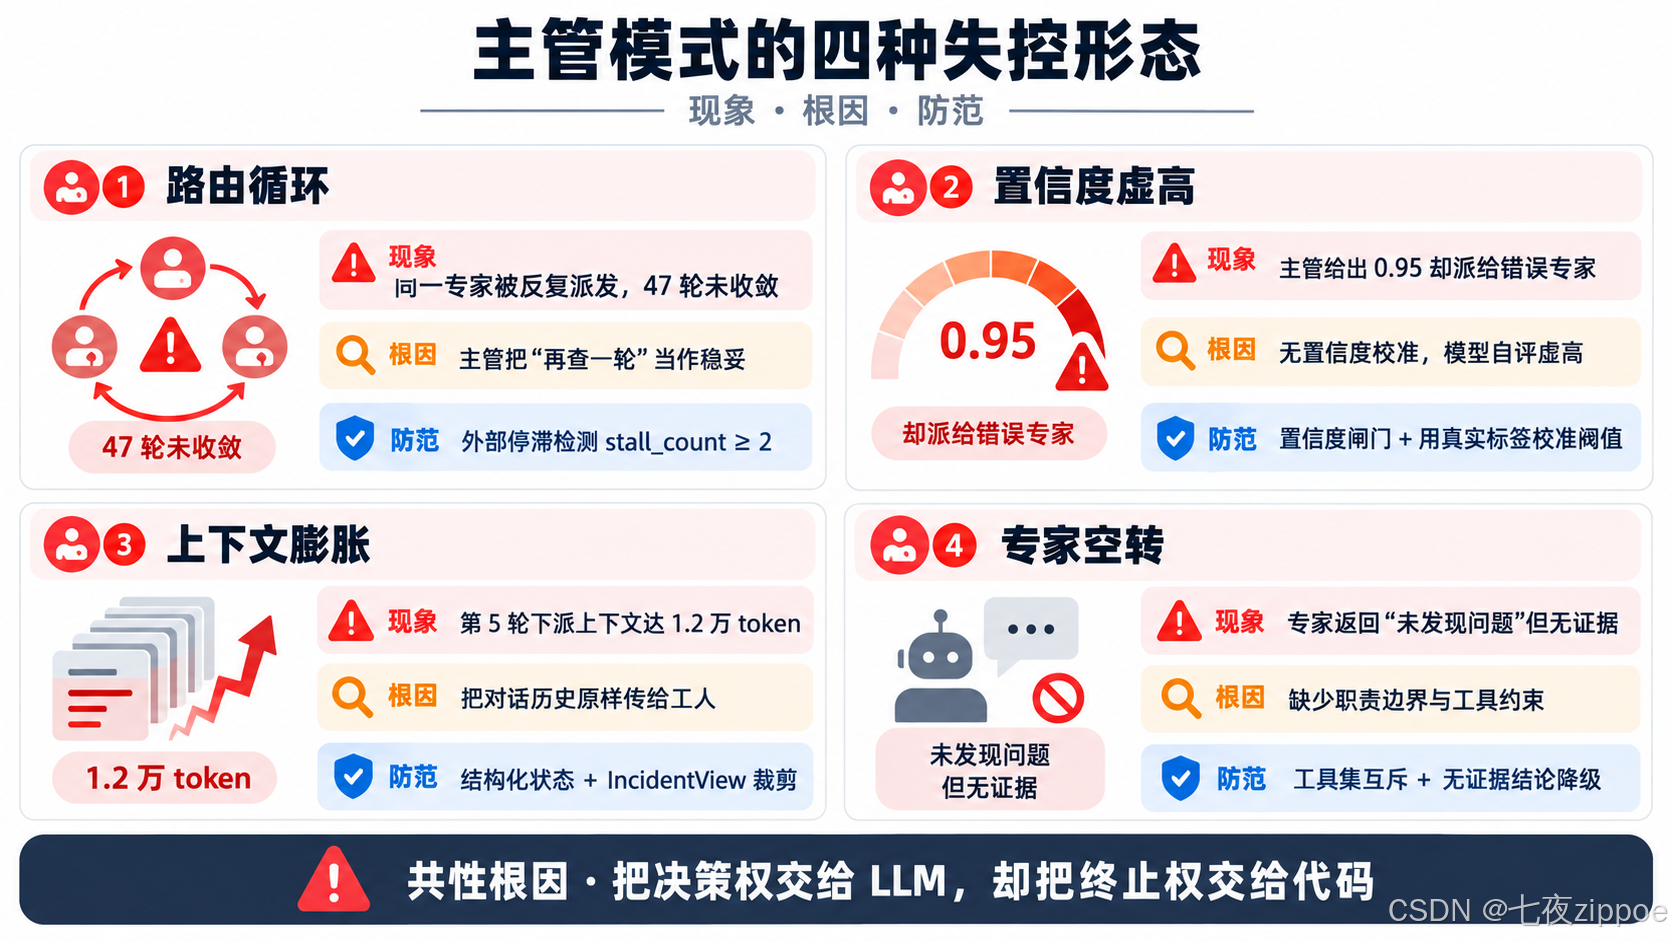
图3:主管模式的四种失控形态------路由循环、置信度虚高、上下文膨胀与专家空转及对应防范机制
形态一:路由循环------主管反复派同一个专家。
实测数据:某故障分诊服务上线首日,11.7% 的会话出现路由循环,最长 47 轮,烧掉 23 万 token。加入
stall_count >= 2后降到 0.3%。
形态二:置信度虚高------主管给出 0.95 的置信度,但派错了专家。
这是最隐蔽的失效。LLM 的自评置信度天然偏高 ,未经校准的 0.9 大概率只相当于真实准确率 0.7。必须用有标签的历史数据做校准,方法见 5.4。
形态三:上下文膨胀------每轮把全部历史传给工人。
症状:第 5 轮下派上下文达到 1.2 万 token,是第 1 轮的 15 倍。根因几乎总是"图省事把 messages 数组整个传过去"。防范就是第 4.3 节的
IncidentView。
形态四:专家空转------专家什么都查不出来,但返回一份格式正确的报告。
后果是主管拿不到新信息,只能不断换人试。防范靠两点:工具集互斥(让它有事可做)+ 无证据结论降级(
layer_ok=None而非True)。
这四种形态的共性根因 是同一句话:把决策权交给 LLM,却把终止权也交给 LLM。 只要终止权收归代码,失控就不会无限发展。
5.4 路由准确率评估:把"感觉还行"变成数字
主管模式最容易自欺的地方,是没有人量化过路由质量。这里给一套可落地的评估方法。
python
# eval_router.py ------ 路由质量评估
from __future__ import annotations
from collections import Counter, defaultdict
from dataclasses import dataclass, field

from schemas import DiagnosisState, Expert, RoutingDecision


@dataclass
class RouteSample:
    """单条路由的评估样本。

    label_correct 需要人工标注一次,形成 ground truth 集。
    """
    incident_id: str
    round_index: int
    predicted: Expert
    label: Expert | None = None,     # 人工标注的正确专家
    decision_confidence: float = 0.0
    useful: bool | None = None,      # 本次派发是否推进了排查
    downstream_expert: Expert | None = None  # 下一个实际被派的专家


@dataclass
class RouterMetrics:
    samples: list[RouteSample] = field(default_factory=list)

    def add(self, s: RouteSample) -> None:
        self.samples.append(s)

    def accuracy(self, threshold: float | None = None) -> float:
        """路由准确率。给了 threshold 则只统计高于该置信度的决策。"""
        labeled = [s for s in self.samples
                   if s.label is not None
                   and (threshold is None or s.decision_confidence >= threshold)]
        if not labeled:
            return 0.0
        return sum(1 for s in labeled if s.predicted == s.label) / len(labeled)

    def coverage(self, threshold: float) -> float:
        """置信度阈值的覆盖率------阈值越高,敢执行的决策越少。

        准确率和覆盖率是一对 trade-off,必须一起看。
        """
        if not self.samples:
            return 0.0
        return sum(1 for s in self.samples
                   if s.decision_confidence >= threshold) / len(self.samples)

    def usefulness(self) -> float:
        """有效率------本轮派发是否真的推进了排查。"""
        judged = [s for s in self.samples if s.useful is not None]
        return sum(1 for s in judged if s.useful) / len(judged) if judged else 0.0

    def confidence_calibration(self, buckets: int = 5) -> list[tuple[str, float, float]]:
        """置信度校准表:把预测置信度分桶,对比桶内真实准确率。

        这张表是设定 MIN_CONFIDENCE_TO_EXECUTE 的唯一依据。
        理想情况下桶内真实准确率应随置信度单调上升;若不单调,
        说明模型的置信度完全不可信,必须全部走规则兜底。
        """
        labeled = [s for s in self.samples if s.label is not None]
        if not labeled:
            return []
        out = []
        step = 1.0 / buckets
        for i in range(buckets):
            lo, hi = i * step, (i + 1) * step
            bucket = [s for s in labeled
                      if (s.predicted == s.label
                          and lo <= s.decision_confidence < hi)]
            conf = [s for s in labeled if lo <= s.decision_confidence < hi]
            if not conf:
                continue
            out.append((f"{lo:.1f}-{hi:.1f}", round(s.decision_confidence, 2),
                        round(len(bucket) / len(conf), 3)))
        return out

    def confusion(self) -> dict[str, int]:
        """混淆矩阵------看哪两个专家最容易互相误判。"""
        m: dict[str, int] = defaultdict(int)
        for s in self.samples:
            if s.label is not None:
                m[f"{s.label.value} → {s.predicted.value}"] += 1
        return dict(m)


def pick_threshold(metrics: RouterMetrics, target_accuracy: float = 0.9) -> float:
    """根据目标准确率反推置信度阈值。

    用法:pick_threshold(m, 0.90) 得到应该设定的阈值,
    以及该阈值下的覆盖率,交给业务方做 trade-off 决策。
    """
    best_t, best_cov = 0.0, 0.0
    for t in [i / 100 for i in range(5, 100, 5)]:
        if metrics.accuracy(t) >= target_accuracy:
            best_t, best_cov = t, metrics.coverage(t)
return best_t, best_cov代码说明:
confidence_calibration()是最有价值的方法 。它把决策按置信度分桶,对比每桶的真实准确率 。如果 0.8-0.9 桶的真实准确率只有 0.6,说明模型的置信度系统性虚高,阈值要设在更高的位置。这张表是设定MIN_CONFIDENCE_TO_EXECUTE的唯一依据,靠拍脑袋设阈值迟早出事。accuracy()与coverage()必须一起看。把阈值提到 0.95,准确率能到 97%,但覆盖率可能只剩 20%------意味着 80% 的请求都得走人工。这个 trade-off 是业务决策,不是技术决策,所以要把两个数字都交出去。confusion()定位易混专家对 。我的数据里最常见的一组误判是database → network(数据库慢导致的超时被误判为网络问题),因为告警文本里的"超时"关键词同时命中两条规则。看到这张表就能直接改 Prompt 或调规则权重。usefulness()是比准确率更贴近生产的指标 。派对了专家但没推进排查(比如专家报告全是"未发现问题"),在生产里仍然是浪费。准确率是静态指标,有效率才反映真实价值。
5.5 成本控制:主管模式的三层开销
主管模式的成本结构比单 Agent 复杂,多了三层:
#mermaid-svg-h4SMo7WwRNxADzej{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-h4SMo7WwRNxADzej .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-h4SMo7WwRNxADzej .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-h4SMo7WwRNxADzej .error-icon{fill:#552222;}#mermaid-svg-h4SMo7WwRNxADzej .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-h4SMo7WwRNxADzej .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-h4SMo7WwRNxADzej .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-h4SMo7WwRNxADzej .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-h4SMo7WwRNxADzej .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-h4SMo7WwRNxADzej .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-h4SMo7WwRNxADzej .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-h4SMo7WwRNxADzej .marker{fill:#333333;stroke:#333333;}#mermaid-svg-h4SMo7WwRNxADzej .marker.cross{stroke:#333333;}#mermaid-svg-h4SMo7WwRNxADzej svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-h4SMo7WwRNxADzej p{margin:0;}#mermaid-svg-h4SMo7WwRNxADzej :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 主管模式成本构成:单次分诊 3.2 元的去向 路由决策 专家执行 上下文裁剪开销 汇总与收尾 失败重试 45 40 35 30 25 20 15 10 5 0 占比(%)
从这张图能读出三条结论:
结论一:专家执行占 58%,是主成本,但优化空间不大。 它由业务本身决定,除非换更小的模型或优化工具效率。
结论二:路由决策只占 12%,但它是"可优化空间最大"的部分。 因为它可以整体换成规则(第 5.1 节),成本直接归零。
结论三:失败重试占 7%,容易被忽略。 路由 Schema 校验失败的重试、专家超时的重试,加起来是一笔看不见的账。必须单独埋点统计,否则成本异常时无从下手。
| 优化手段 | 成本降幅 | 准确率影响 | 适用 |
|---|---|---|---|
| 规则前置替代 LLM 路由 | -61% | +4pt(反而更好) | 意图可枚举,默认推荐 |
| 专家侧换小模型 | -35% | -5pt | 执行质量容忍度高时 |
上下文裁剪(IncidentView) |
-18% | 0 | 任何场景都该做 |
| 停滞检测提前终止 | -22% | -2pt | 长尾会话为主时 |
| 路由缓存(相同症状复用) | -12% | 0 | 告警重复率高时 |
六、方案对比:官方封装 vs AutoGen vs CrewAI vs 自研
6.1 LangGraph 官方 Supervisor 封装
LangGraph 有社区维护的 langgraph-supervisor 库,核心 API 是 create_supervisor()。
python
# graph_supervisor.py ------ 用官方封装实现主管模式
from langgraph_supervisor import create_supervisor

# worker 必须包装成 LangChain  Runnable:prompt | llm
workers = {
    "network": network_prompt | llm,
    "database": database_prompt | llm,
    "application": application_prompt | llm,
}

app = create_supervisor(
    workers=workers,
    model=supervisor_llm,          # 主管用大模型
    prompt=supervisor_prompt,      # 路由决策的提示词
).compile()

result = await app.ainvoke({
    "messages": [{"role": "user", "content": incident.symptom}]
})它的优点:上手极快,几十行就能跑通一个主管循环;自动处理消息路由。
它的局限(也是自研的主要理由):
| 局限 | 影响 | 自研能否解决 |
|---|---|---|
| 终止控制弱 | 默认靠 LLM 自己决定何时结束,难以硬性限制轮次 | ✅ 外部 should_stop |
| 状态是消息数组 | 多轮后上下文膨胀,长会话成本上升明显 | ✅ IncidentView 裁剪 |
| 置信度难介入 | 决策置信度没暴露出来,做不了闸门 | ✅ RoutingDecision |
| 错误分类缺失 | 无法区分可重试与不可重试错误 | ✅ WorkerReport 降级 |
| 难评估 | 路由准确率无从统计 | ✅ RouterMetrics |
我的判断 :langgraph-supervisor 适合原型验证和教学 。一旦进入生产,上面五条里至少后三条是必须自己做的------所以你最终还是得自己写一遍 should_stop 和上下文裁剪。既然核心逻辑要自己写,不如从头写清楚。
6.2 三方案横向对比
| 维度 | LangGraph Supervisor | AutoGen GroupChat | CrewAI | 自研(本文方案) |
|---|---|---|---|---|
| 核心抽象 | 主管 + 工人 Runnable | 群聊 + 发言选择器 | 角色 + 任务 + 流程 | 决策函数 + 状态机 |
| 路由方式 | 结构化输出 / Handoff | 下一次发言者选择 | 层级委派 / 流程 | 结构化决策 + 外部规则 |
| 终止控制 | ⚠️ 弱,主要靠 LLM | ⚠️ 有 max_turn 但不够灵活 | ✅ 流程可控 | ✅ 三道保险 |
| 状态管理 | 消息数组(易膨胀) | 消息列表 | 上下文参数 | ✅ 结构化状态 + 裁剪视图 |
| 置信度介入 | ❌ 未暴露 | ⚠️ 部分版本支持 | ❌ | ✅ 闸门 + 校准 |
| 路由评估 | ❌ 需自建 | ❌ 需自建 | ❌ | ✅ 内置 RouterMetrics |
| 上手成本 | 低 | 中 | 低 | 中 |
| 可控性上限 | 中 | 中 | 中高 | ✅ 最高 |
| 适合场景 | 原型、教学 | 多方对话型任务 | 角色分工明确的任务 | 生产级、需要精确控制的系统 |
选型建议(我的拍板):
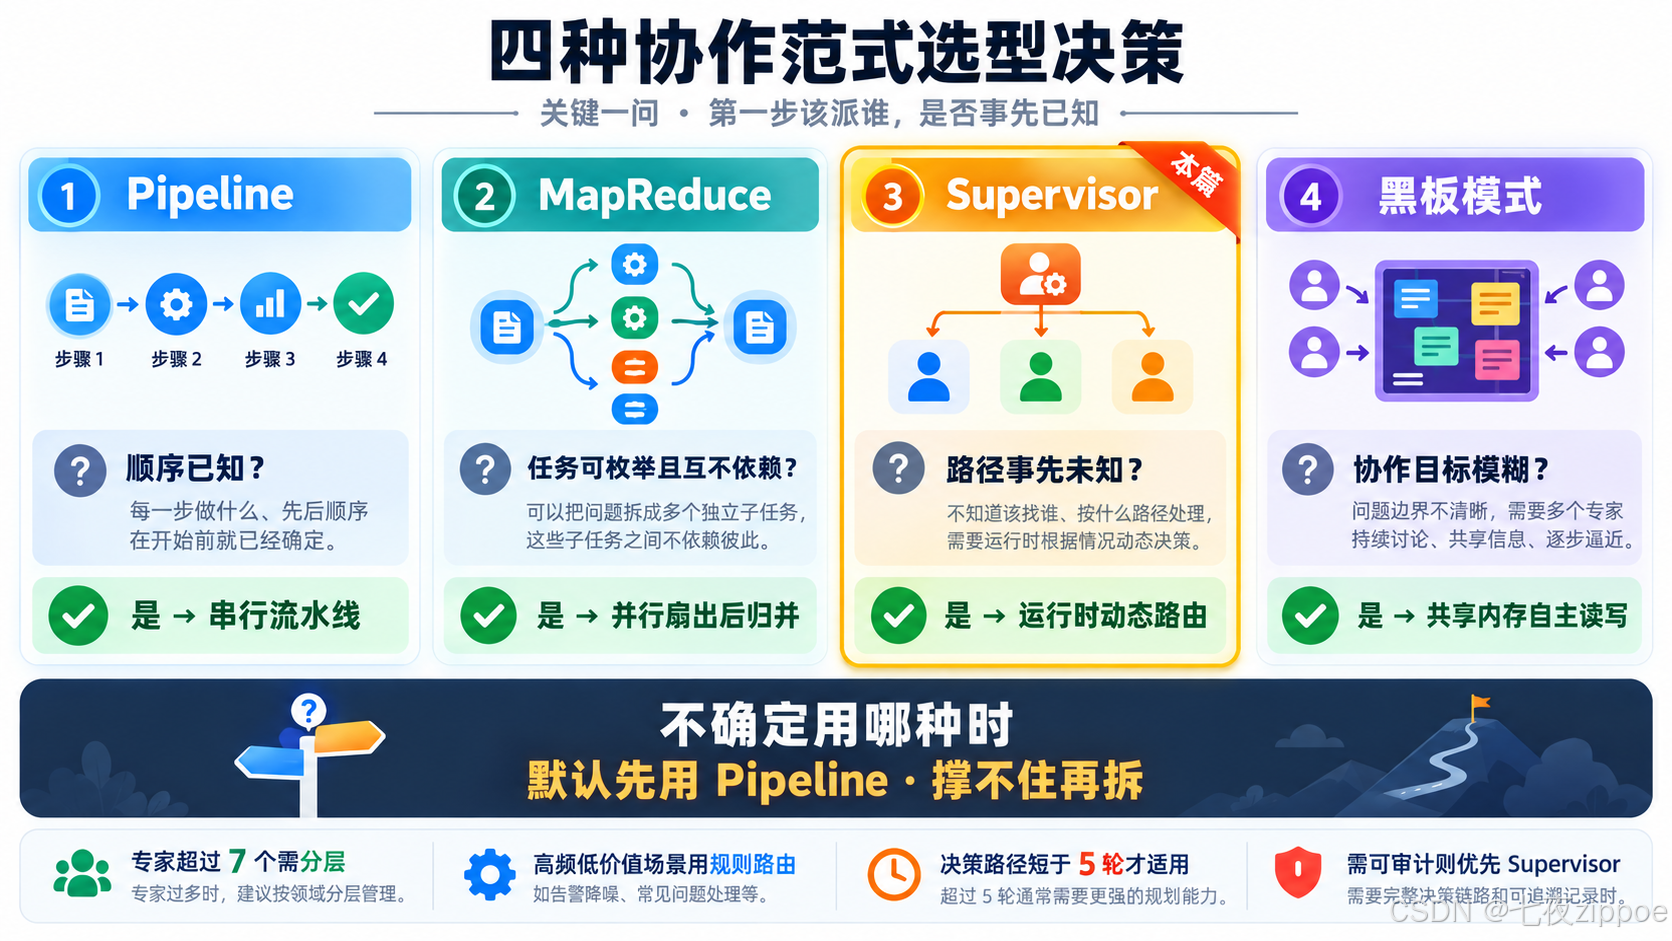
图4:四种多 Agent 协作范式的选型决策------按"任务拆分由谁决定"选择模式
- 学习原理 / 快速验证 →
langgraph-supervisor(省下的时间大于学习成本) - 任务本质是多方对话(需要 Agent 之间互相讨论) → AutoGen GroupChat,它的对话语义是其他方案给不了的
- 角色分工固定、流程可预先编排 → CrewAI,它的"角色 + 任务"抽象很贴合这类场景
- 生产级、需要精确控制路由与终止 → 自研。本文给的三道保险、置信度闸门、路由评估,封装库都不提供
6.3 为什么 Supervisor 不等于"多 Agent 聊天"
一个常见误解:主管模式就是让几个 Agent 轮流发言。
差别很大。对话式协作的路由权在"谁先说话谁说了算",而主管模式的路由权始终在主管手里,工人没有发言权。 这个差别在生产上是决定性的:
| 特性 | 对话式(GroupChat) | 主管模式 |
|---|---|---|
| 谁决定下一个发言 | 选器模型动态选,可被工人"带偏" | 主管单一决策 |
| 能否跳过某个工人 | 可能被跳过,也可能被反复纠缠 | 主管显式指定或跳过 |
| 轮次可控性 | 弱 | 强 |
| Token 成本 | 不可预测(对话会变长) | 可预测(轮次 × 单轮成本) |
如果你的任务需要"Agent 之间充分讨论才能得出结论",用对话式;如果你需要"精确控制谁做什么、什么时候停",用主管模式。
七、适用边界与风险提示 ⚠️
7.1 Supervisor 适合什么
✅ 拆分路径事先未知:告警分诊、工单路由、开放式研究------这类问题的第一步该派谁,本身就是答案的一部分。
✅ 专家边界清晰:专家的领域划分明确、工具集互斥,主管判断"该派谁"时只需做一次简单的领域匹配。
✅ 专家数量少(≤ 7):决策空间小,路由准确率高。超过 7 个需要分层。
✅ 路径长度可估计:通常 2~5 轮能收敛。超过 5 轮的场景,管道阶段的可控性会迅速下降。
✅ 对审计有要求:每轮路由都有结构化理由和置信度,天然满足可追溯要求。
7.2 Supervisor 不适合什么
❌ 拆分路径已知:用 Pipeline 或 MapReduce,省掉每次路由的 LLM 调用。
❌ 专家领域重叠 :两个专家的职责说不清,主管必然路由混乱。先解决领域划分,再谈调度。
❌ 高 QPS 低价值:每请求多一次 LLM 调用,量大时成本不可接受(第 1.5 节的实测:路由成本占 68%)。
❌ 专家数超过 7 个:决策空间过大,应先分组做分层。
❌ 需要确定性结果:LLM 路由本质是概率性的。若业务要求 100% 可复现,必须退化为规则路由。
❌ 任务有严格数据依赖:数据依赖意味着必须串行,那是 Pipeline 的领域。
7.3 四大典型陷阱
陷阱一:把终止权交给 LLM
这是本篇反复强调的核心风险。主管 Agent 会一直觉得"再查一轮更稳妥",形成死循环。第 4.4 节的 should_stop 必须是纯代码实现,一行 LLM 调用都不能有。
陷阱二:用对话历史做状态
症状是第 5 轮上下文涨到上万 Token、成本失控。根因几乎总是"messages 数组传着用方便"。用结构化状态 + 裁剪视图。
陷阱三:凭感觉定置信度阈值
直接写 MIN_CONFIDENCE_TO_EXECUTE = 0.5,上线后没人知道这个数从哪来。用 5.4 节的校准表反推。
陷阱四:专家结论不做证据校验
工人返回 layer_ok=True 但没有证据,主管会提前收敛,得出错误根因------而且这个错误会被当成"高置信度结论"输出,比诚实的"未判断"危害更大 。无证据的结论必须降级。
7.4 版本与兼容性提醒
⚠️
langgraph-supervisor变动较快 :create_supervisor()的参数签名、worker 的类型要求在 0.1.x 各小版本间有调整。本文第六章示例仅为示意,请以安装版本的官方文档为准。⚠️
Command(goto=...)动态路由 是 LangGraph 的标准做法,但与create_handoff_tool()并存时容易产生路由冲突,二选一即可。⚠️
asyncio.timeout需要 Python 3.11+ 。3.10 及以下需改用asyncio.wait_for。⚠️ Pydantic V2 与 V1 不兼容 。若你的项目已有 V1 代码,
field_validator/model_validator/model_dump_json都需相应调整。
八、进阶:让主管撑住生产
8.1 观测埋点:主管模式的六个必备指标
主管模式的观测有个特殊性:单次会话的指标意义有限,要看分布。
python
# metrics.py ------ 主管模式观测指标
from __future__ import annotations
from collections import Counter
from dataclasses import dataclass, field

from schemas import DiagnosisState, Expert


@dataclass
class SupervisorMetrics:
    """六个必备维度。

    关键:轮次分布和状态分布比平均值更重要------
    均值 3.2 轮看起来正常,但若 P99 是 12 轮就是灾难。
    """

    sessions: int = 0
    converged: int = 0
    degraded: int = 0
    needs_human: int = 0
    failed: int = 0
    rounds: list[int] = field(default_factory=list)
    durations: list[float] = field(default_factory=list)
    tokens: list[int] = field(default_factory=list)
    expert_usage: Counter = field(default_factory=Counter)
    stop_reasons: Counter = field(default_factory=Counter)

    def observe(self, state: DiagnosisState, elapsed_s: float) -> None:
        self.sessions += 1
        setattr(self, {"converged": self.converged + int(state.status == "converged"),
                        "degraded": self.degraded + int(state.status == "degraded"),
                        "needs_human": self.needs_human + int(state.status == "needs_human"),
                        "failed": self.failed + int(state.status == "failed")}
                   [state.status] if hasattr(self, state.status) else state.status)
        self.rounds.append(state.round_index)
        self.durations.append(elapsed_s)
        self.tokens.append(state.tokens_used)
        for r in state.reports:
            self.expert_usage[r.expert.value] += 1

    def snapshot(self) -> dict:
        rs = sorted(self.rounds) or [0]
        ds = sorted(self.durations) or [0.0]
        p = lambda arr, q: arr[min(int(len(arr) * q), len(arr) - 1)]
        snap = {
            "sessions": self.sessions,
            # 三个出口的占比决定系统是否健康
            "converged_rate": round(self.converged / self.sessions, 4) if self.sessions else 0,
            "degraded_rate": round(self.degraded / self.sessions, 4) if self.sessions else 0,
            "needs_human_rate": round(self.needs_human / self.sessions, 4) if self.sessions else 0,
            # 轮次分布:P99 超过 8 说明有失控会话
            "rounds_p50": p(rs, .5), "rounds_p95": p(rs, .95), "rounds_p99": p(rs, .99),
            # 长尾比:P99/P50 超过 4 说明存在难收敛的会话类型
            "rounds_tail_ratio": round(p(rs, .99) / max(p(rs, .5), 1), 2),
            "duration_p95_s": round(p(ds, .95), 1),
            "tokens_avg": int(sum(self.tokens) / len(self.tokens)) if self.tokens else 0,
            "expert_usage": dict(self.expert_usage.most_common()),
        }
        return snap

    def should_alert(self) -> list[str]:
        alerts = []
        s = self.snapshot()
        if s["sessions"] < 20:
            return alerts  # 样本不足不告警,避免冷启动噪音
        if s["converged_rate"] < 0.75:
            alerts.append(f"收敛率偏低: {s['converged_rate']:.1%},检查路由质量与专家能力")
        if s["degraded_rate"] + s["needs_human_rate"] > 0.25:
            alerts.append(f"降级+转人工占比过高: {s['degraded_rate'] + s['needs_human_rate']:.1%}")
        if s["rounds_p99"] > 8:
            alerts.append(f"轮次长尾异常: P99={s['rounds_p99']},存在失控会话")
        if s["rounds_tail_ratio"] > 4:
            alerts.append(f"会话难度分层明显: P99/P50={s['rounds_tail_ratio']},考虑按复杂度分流")
return alerts六个指标各自的告警意义:
| 指标 | 健康值 | 异常含义 | 首选动作 |
|---|---|---|---|
| 收敛率 | > 80% | 路由或专家能力不足 | 查混淆矩阵,找易混专家对 |
| 降级+转人工 | < 20% | 置信度阈值过严或告警描述太模糊 | 查 needs_human 样本的共同特征 |
| 轮次 P99 | < 8 | 存在失控会话 | 查 stall_count 触发记录 |
| 轮次长尾比 | < 4 | 会话难度分层明显 | 按复杂度分流,简单的走规则 |
| 专家使用分布 | 相对均衡 | 某专家几乎不用 → 该专家形同虚设 | 检查路由是否绕过了它 |
| Token 均值 | 稳定 | 成本异常 | 查上下文是否膨胀 |
特别强调"专家使用分布"这个指标 。如果某个专家的使用次数是 0,说明要么路由从来不选它(职责划分有问题),要么它被别的专家覆盖了。这是发现"僵尸专家"的最直接方式,而僵尸专家会持续消耗维护成本却零产出。
8.2 Mock 测试:不烧钱验证调度逻辑
主管模式的编排逻辑分支极多------路由失败、置信度不足、专家超时、停滞触发......全靠真实 LLM 测既慢又贵。必须用可编排故障的 Mock。
python
# test_supervisor.py ------ 主管模式分层测试
import pytest
from unittest.mock import patch

from schemas import DiagnosisState, Expert, Incident, RoutingDecision, Severity, WorkerReport
from orchestrator import triage
from supervisor import should_stop


class ScriptedRouter:
    """脚本化路由:按预设序列返回决策,精确控制调度路径。"""

    def __init__(self, script: list[RoutingDecision]):
        self.script = script
        self.calls = 0

    async def __call__(self, state):
        d = self.script[min(self.calls, len(self.script) - 1)]
        self.calls += 1
        return d


class ScriptedExpert:
    """脚本化专家:按专家名返回预设报告。"""

    def __init__(self, reports: dict[Expert, WorkerReport]):
        self.reports = reports

    async def __call__(self, expert, view, timeout_s=90.0):
        r = self.reports.get(expert)
        if r is None:
            return WorkerReport(expert=expert, layer_ok=None, findings=["无预设"])
        return r.model_copy(update={"expert": expert})


def make_incident() -> Incident:
    return Incident(incident_id="T-1", symptom="请求超时率突增",
                    source_system="gateway", severity=Severity.HIGH,
                    onset_time="2026-10-08T03:00:00+08:00",
                    metrics={"net_rtt_ms": 8.0, "db_pool_wait_ms": 3200.0})


def test_should_stop_triggers_on_round_budget():
    """保险 1:轮次预算必须硬性生效。"""
    state = DiagnosisState(incident=make_incident(), round_index=5)
    stop, reason = should_stop(state)
    assert stop and "round_budget" in reason


def test_should_stop_triggers_on_stall():
    """保险 2:停滞检测必须能终止循环。"""
    state = DiagnosisState(incident=make_incident(), round_index=2, stall_count=2)
    stop, reason = should_stop(state)
    assert stop and "stalled" in reason


def test_should_stop_not_trigger_early():
    """收敛判据不能过早触发------这是误杀测试。"""
    state = DiagnosisState(incident=make_incident(), round_index=1, stall_count=0,
                           reports=[WorkerReport(expert=Expert.NETWORK,
                                                 layer_ok=True, confidence=0.9,
                                                 evidence=["链路正常"], findings=["无异常"])])
    stop, _ = should_stop(state)
    assert not stop, "单条报告不应构成收敛"


@pytest.mark.asyncio
async def test_low_confidence_goes_to_human():
    """置信度闸门:低置信度决策必须转人工,不能硬派。"""
    low = [RoutingDecision(target=Expert.NETWORK, reason="不确定该查哪层",
                           confidence=0.2, is_final=False)]
    with patch("orchestrator.rule_route", return_value=None), \
         patch("orchestrator.decide_next_with_retry", new=ScriptedRouter(low)), \
         patch("orchestrator.diagnose", new=ScriptedExpert({})):
        state = await triage(make_incident())
    assert state.status == "needs_human", "低置信度必须转人工"
    assert len(state.reports) == 0, "不应执行任何专家"


@pytest.mark.asyncio
async def test_loop_cannot_run_away():
    """核心安全测试:即使路由一直要求继续,也必须在预算内终止。

    这是回归 #47 轮死循环事故的守门测试。
    """
    forever = [RoutingDecision(target=Expert.NETWORK, reason="还想再查一轮",
                               confidence=0.9, is_final=False)]
    reports = {Expert.NETWORK: WorkerReport(
        expert=Expert.NETWORK, layer_ok=None,
        findings=[], evidence=["无新增"], confidence=0.0)}
    with patch("orchestrator.rule_route", return_value=None), \
         patch("orchestrator.decide_next_with_retry", new=ScriptedRouter(forever)), \
         patch("orchestrator.diagnose", new=ScriptedExpert(reports)):
        state = await triage(make_incident())
    assert state.round_index <= 5, f"轮次必须受限,实际 {state.round_index}"
    assert state.status in {"degraded", "needs_human", "converged"}


@pytest.mark.asyncio
async def test_converged_path_produces_summary():
    """正常收敛路径:主管判定 is_final 后必须走汇总专家。"""
    script = [
        RoutingDecision(target=Expert.DATABASE, reason="指标指向数据层",
                        focus=["慢查询"], confidence=0.9, is_final=False),
        RoutingDecision(target=Expert.SUMMARY, reason="证据充分可定性",
                        confidence=0.9, is_final=True),
    ]
    reports = {
        Expert.DATABASE: WorkerReport(expert=Expert.DATABASE, layer_ok=False,
                                      findings=["慢查询 P99=4.2s"], evidence=["slow_query log"],
                                      confidence=0.88),
        Expert.SUMMARY: WorkerReport(expert=Expert.SUMMARY, layer_ok=False,
                                     findings=["根因: 数据库慢查询"],
                                     evidence=["慢查询 P99=4.2s"], confidence=0.86),
    }
    with patch("orchestrator.rule_route", return_value=None), \
         patch("orchestrator.decide_next_with_retry", new=ScriptedRouter(script)), \
         patch("orchestrator.diagnose", new=ScriptedExpert(reports)):
        state = await triage(make_incident())
    assert state.status == "converged"
assert Expert.SUMMARY in state.covered_experts, "收敛路径必须包含汇总报告"代码说明:
test_loop_cannot_run_away是最重要的一条测试 ,它是 47 轮死循环事故的回归守门。构造一个"永远要求继续"的路由 + "永远没有新增发现"的专家,断言轮次必然 ≤ 5。这条测试应该常驻 CI,它比任何代码评审都更能保证系统不会失控。test_low_confidence_goes_to_human锁死了置信度闸门。这类"保护性逻辑"最容易被后来的重构顺手删掉,必须有测试守着。test_should_stop_not_trigger_early是误杀测试。收敛判据太激进会导致大量请求降级,太松会导致死循环。这个测试锁住"单条报告不构成收敛"这条底线。ScriptedRouter用min(self.calls, len-1)兜底,故意让脚本"用完就重复最后一条",模拟 LLM 反复给出同样决策的真实行为。- 全套测试零 LLM 调用、毫秒级完成。真实 LLM 只在每次发布前跑少量集成验证。
九、总结
回到文章开头的问题:为什么需要 Supervisor 模式? 因为真实业务里最常见的一类任务,Pipeline 和 MapReduce 都接不住------你事先并不知道该拆成哪几步、每一步该交给谁。告警分诊、工单路由、代码审查都属于这一类。Supervisor 用"运行时由主管 Agent 决定路由",换取了 Pipeline 给不了的灵活性。
这一路走下来,可以提炼出四个核心认知:
第一,主管模式的价值是"路由决策权",代价是"每次决策的 LLM 成本"。 它不是前两篇的升级版,而是另一种取舍。能用 Pipeline 解决的,绝不要上 Supervisor------主管模式单次分诊的成本大约是 Pipeline 的 3~5 倍。
第二,把决策权交给 LLM,但把终止权交给代码。 这是本篇最重要的一句话。47 轮死循环、23 万 token 烧掉的根因不是路由错了,而是**"什么时候停"这件事被交给了 LLM**。三道保险------轮次预算、墙钟预算、停滞检测------必须全是纯代码,一行 LLM 调用都不能有。
第三,路由质量必须量化,不能靠感觉。 用 RouterMetrics.confidence_calibration() 拿到"预测置信度 vs 真实准确率"的校准表,用它反推置信度阈值;同时用 accuracy() 和 coverage() 的 trade-off 把决策权交给业务。准确率是静态指标,有效率才反映真实价值。
第四,上下文裁剪和专家隔离是隐蔽但决定性的两项。 IncidentView 裁剪掉的不是 Token,是错误级联的源头------给网络专家看数据库指标,它就会开始怀疑数据库。工具集互斥守护的是职责边界,边界模糊则路由必然失效。
选型速览 :原型验证用 langgraph-supervisor;需要 Agent 充分讨论用 AutoGen;角色固定的流程化任务用 CrewAI;生产级、需要精确控制路由与终止------自研,因为三道保险、置信度闸门、路由评估这三样封装库都不提供。
架构关系回顾 :Pipeline 是"设计时确定顺序",MapReduce 是"设计时确定集合",Supervisor 是"运行时确定路径"。三者不互斥,生产系统里常见的是嵌套------外层 Supervisor 决定走哪条流水线(这篇的 1.1 节故障分诊最终就是靠主管调度 + MapReduce 并行预判完成的),内层 Pipeline 或 MapReduce 负责具体执行。
落地自检清单(Checklist)
交付前逐项确认你的主管模式是否达标:
- ✅ 主管只做决策:读状态、选专家、判收敛、裁上下文,不直接执行工具
- ✅ 专家候选是封闭枚举,主管无法创造清单外的新专家
- ✅ 路由决策是强类型结构化输出(含 reason / confidence / is_final),不是自由文本
- ✅ 终止判据是纯代码实现 ,
should_stop中零 LLM 调用 - ✅ 三道保险齐备:轮次预算(≤5)、墙钟预算(总时长共享,非每轮重置)、停滞检测(stall ≥ 2)
- ✅ 状态是结构化对象,不存对话历史 ;下派用
IncidentView裁剪 - ✅ 专家工具集严格互斥,Prompt 显式约束"不评价其他层"
- ✅ 专家报告有条数上限,截断在专家侧而非主管侧
- ✅ 专家结论做证据校验:无证据不得声称"该层正常"
- ✅ 置信度阈值由校准表反推,不是拍脑袋设定
- ✅ 规则前置覆盖高频意图,LLM 只处理复杂场景
- ✅ 四个终止出口都实现(converged / degraded / needs_human / failed),失败能体面降级
- ✅ 接入观测:收敛率、降级+转人工占比、轮次 P99、长尾比、专家使用分布、Token 均值
- ✅ 有
test_loop_cannot_run_away类回归测试守门 - ✅ 输出包含未排除项,让结论边界可见
常见问题(FAQ)
Q1:Supervisor 和 LangChain LCEL 的 Agent 链有什么区别?
LCEL 的链是开发者预先定义好的 (prompt | llm | parser 串成什么就是什么),运行时不会改变。Supervisor 的路由是运行时由 LLM 决定的,任务流是动态的。当你的流程固定时用 LCEL;当"该派谁"本身是问题的一部分时,才是 Supervisor。
Q2:主管和主管的 Worker,能都是 Agent 吗?
可以,但要权衡。本文推荐主管用大模型、工人用小模型 + 好工具 ------实测成本降 74%、准确率只掉 2 个点。反过来(主管小模型)准确率会崩到 63%。路由决策的价值密度远高于单次执行。
Q3:专家之间需要共享信息吗?
刻意不共享。 每个专家只收到"已排除哪些层 + 本层的指标 + 本轮 focus",不收其他专家的完整报告和证据。原因是共享会让专家沿着别人的思路走,丧失独立性------而分诊场景需要的恰恰是多视角的独立判断 。只共享结论(network=正常),不共享过程。
Q4:主管和工人可以用同一个模型吗?
可以,成本更低。但要注意两点:一是主管需要结构化输出 能力强的模型(哪怕是小模型也要能稳定输出合法 JSON),二是工人可以换便宜模型。我的建议是主管至少用中档模型,工人用小模型 + 好工具。
Q5:怎么知道主管模式该不该上?
跑一个 20 条的小样本评估:人工标注每条"第一步该派谁",然后对比主管的实际决策。如果主管的准确率低于 80%,说明你的专家边界定义有问题(而不是主管不够聪明)------这时候该做的是重新划分专家职责,而不是换更大的模型。
Q6:主管模式能嵌套吗?
可以,而且生产中很常见。外层主管决定"走哪条流水线",内层可以是 Pipeline(单任务深度执行)或 MapReduce(多个子任务并行)。本文 5.2 节的并行预判就是 MapReduce 嵌在 Supervisor 里的雏形。嵌套的代价是每一层都要有自己的终止机制,不能指望内层的收敛自动传导到外层。
参考资料
- LangGraph 官方文档 ------ Supervisor 多 Agent 架构与动态路由:https://langchain-ai.github.io/langgraph/tutorials/multi_agent/
- LangGraph Supervisor 开源仓库(社区封装):https://github.com/langchain-ai/langgraph-supervisor-py
- Anthropic ------ Building effective agents(Orchestrator-Workers 模式原始论述):https://www.anthropic.com/research/building-effective-agents
- Microsoft AutoGen 官方文档(GroupChat 与说话者选择):https://microsoft.github.io/autogen/
- CrewAI 官方文档(角色与任务编排):https://docs.crewai.com/
- Python 3.11
asyncio.timeout()官方文档:https://docs.python.org/3/library/asyncio-task.html - Pydantic V2 官方文档(
field_validator/model_validator/model_copy):https://docs.pydantic.dev/ - 松鼠 AI / 论文:Why Do Multi-Agent LLM Systems Fail? (MAST 失效分类体系,可对照本文四类失控形态):https://arxiv.org/abs/2503.13657