Linux线程深度剖析:轻量级进程、虚拟内存分页、进程线程资源对比
-
- 前言
- 一、到底什么是Linux线程?
-
- [1.1 感性理解:进程与线程的通俗模型](#1.1 感性理解:进程与线程的通俗模型)
- [1.2 Linux独特实现:线程就是轻量级进程LWP](#1.2 Linux独特实现:线程就是轻量级进程LWP)
- 二、理解线程的底层基础:虚拟地址空间与分页内存管理
-
- [2.1 如果没有分页机制:物理内存碎片问题](#2.1 如果没有分页机制:物理内存碎片问题)
- [2.2 页、页框,struct page物理页管理](#2.2 页、页框,struct page物理页管理)
- [2.3 单级页表的实现与致命缺陷](#2.3 单级页表的实现与致命缺陷)
- [2.4 二级页表的设计,CR3寄存器作用](#2.4 二级页表的设计,CR3寄存器作用)
- [2.5 32位二级页表完整地址转换全过程](#2.5 32位二级页表完整地址转换全过程)
- [2.6 MMU硬件单元与TLB快表,解决多级页表查询性能问题](#2.6 MMU硬件单元与TLB快表,解决多级页表查询性能问题)
- [2.7 缺页异常Page Fault](#2.7 缺页异常Page Fault)
-
- [2.7.1 硬缺页 Major Page Fault](#2.7.1 硬缺页 Major Page Fault)
- [2.7.2 软缺页 Minor Page Fault](#2.7.2 软缺页 Minor Page Fault)
- [2.7.3 无效缺页 Invalid Page Fault](#2.7.3 无效缺页 Invalid Page Fault)
- 2.8【面试思考拓展】结合malloc、写时拷贝理解缺页
- 三、线程的优缺点、异常行为以及适用场景
-
- [3.1 线程的优点](#3.1 线程的优点)
- [3.2 线程的缺点](#3.2 线程的缺点)
- [3.3 ⚠️线程异常:一个线程崩溃,整个进程直接退出](#3.3 ⚠️线程异常:一个线程崩溃,整个进程直接退出)
- [3.4 线程适用场景深度解析](#3.4 线程适用场景深度解析)
- 四、进程与线程对比:哪些资源共享,哪些是线程私有?
-
- [4.1 核心概念回顾](#4.1 核心概念回顾)
- [4.2 线程独占(私有)资源](#4.2 线程独占(私有)资源)
- [4.3 所有线程共享的进程级资源](#4.3 所有线程共享的进程级资源)
- 4.4【面试辨析】什么叫单线程进程?
- 六、全文面试考点总结
前言
很多后端开发者写多线程代码,熟练调用pthread_create、pthread_join,却不理解线程在内核到底是什么。面试经常被问到:线程和进程内核层面的区别?为什么线程切换比进程切换快?缺页异常和段错误是什么关系?子线程崩溃会不会导致整个进程退出?
很多教材会直接抛出定义:进程是资源分配基本单位,线程是调度基本单位 ,但很少讲透背后本质。Linux并没有内核原生TCB线程控制块,线程是基于轻量级进程LWP模拟实现 ,资源共享本质就是虚拟地址空间、页表的共享。
如果不理解虚拟地址空间、分页内存、轻量级进程LWP这些底层原理,很多线程相关的面试题只能死记硬背,遇到变形问题就容易出错。读完本文,你可以彻底搞懂:Linux线程内核本质、分页虚拟内存完整工作流程、进程与线程资源划分逻辑,从容应对操作系统线程相关面试。
一、到底什么是Linux线程?
1.1 感性理解:进程与线程的通俗模型
教材经典定义:
- 进程 :内核数据结构 + 代码数据,承担分配系统资源的基本实体。
- 线程 :进程内部的执行分支(执行流),CPU调度的基本单位,线程在进程内部运行。
💡生活化类比:把操作系统资源分配类比社会家庭。
进程 = 家庭 ,家庭是分配社会资源的基本实体;线程 = 家庭里面的每一个人 。
全家人共享房子、家具(进程全部资源);每个人拥有自己私人笔记本、私人物品(线程私有资源);每个人可以独立干活、做不同事情。
- 进程强调独占资源 ;线程强调共享资源,同时保留自己的私有上下文。
📌核心朴素结论(面试口述非常好用)
- Linux内核没有传统操作系统意义上真正的线程,线程由轻量级进程LWP模拟实现。
- Linux可以通过进程(LWP)模拟线程,资源划分本质就是对虚拟地址空间、页表的划分;虚拟地址本身就是资源的代表。
- CPU眼里看到的调度任务永远是
task_struct(PCB),CPU不区分这是进程还是线程。 - 单线程进程:只是进程内部只有一条执行流的特殊情况,main主线程就是这个唯一的执行流。
❓思考问题
- Linux为什么要采用LWP模拟线程这种设计?
- Windows内核是怎么做线程?和Linux实现有什么差异?
Windows内核会区分进程对象EPROCESS和线程对象ETHREAD,内核原生维护TCB线程控制块;而Linux选择复用task_struct,依靠clone系统调用flag标记实现资源共享/拷贝,内核不需要维护两套调度逻辑,实现更简洁。
易错辨析:
❌错误认知:LWP就是用户态pthread_t的ID。
✅正确:
pthread_t是用户态pthread库层面标识,本质用户空间内存地址;LWP是内核task_struct的id,由内核维护,二者完全不是同一个东西。
1.2 Linux独特实现:线程就是轻量级进程LWP
很多操作系统在内核专门设计线程控制块TCB,区分进程PCB和线程TCB。但是Linux内核没有专门为线程设计独立结构体。
Linux内核中,进程和线程全部复用同一个结构体
task_struct(PCB) 。CPU调度器看到的,全部都是task_struct对象。
- 传统独立进程:每个
task_struct绑定独立的mm_struct(虚拟地址空间描述符)- 多线程:同一个进程内多个
task_struct,全部指向同一个mm_struct,共享整套虚拟地址空间,这种task_struct叫做LWP轻量级进程。
Linux进程、多个task_struct线程共用虚拟地址空间示意图
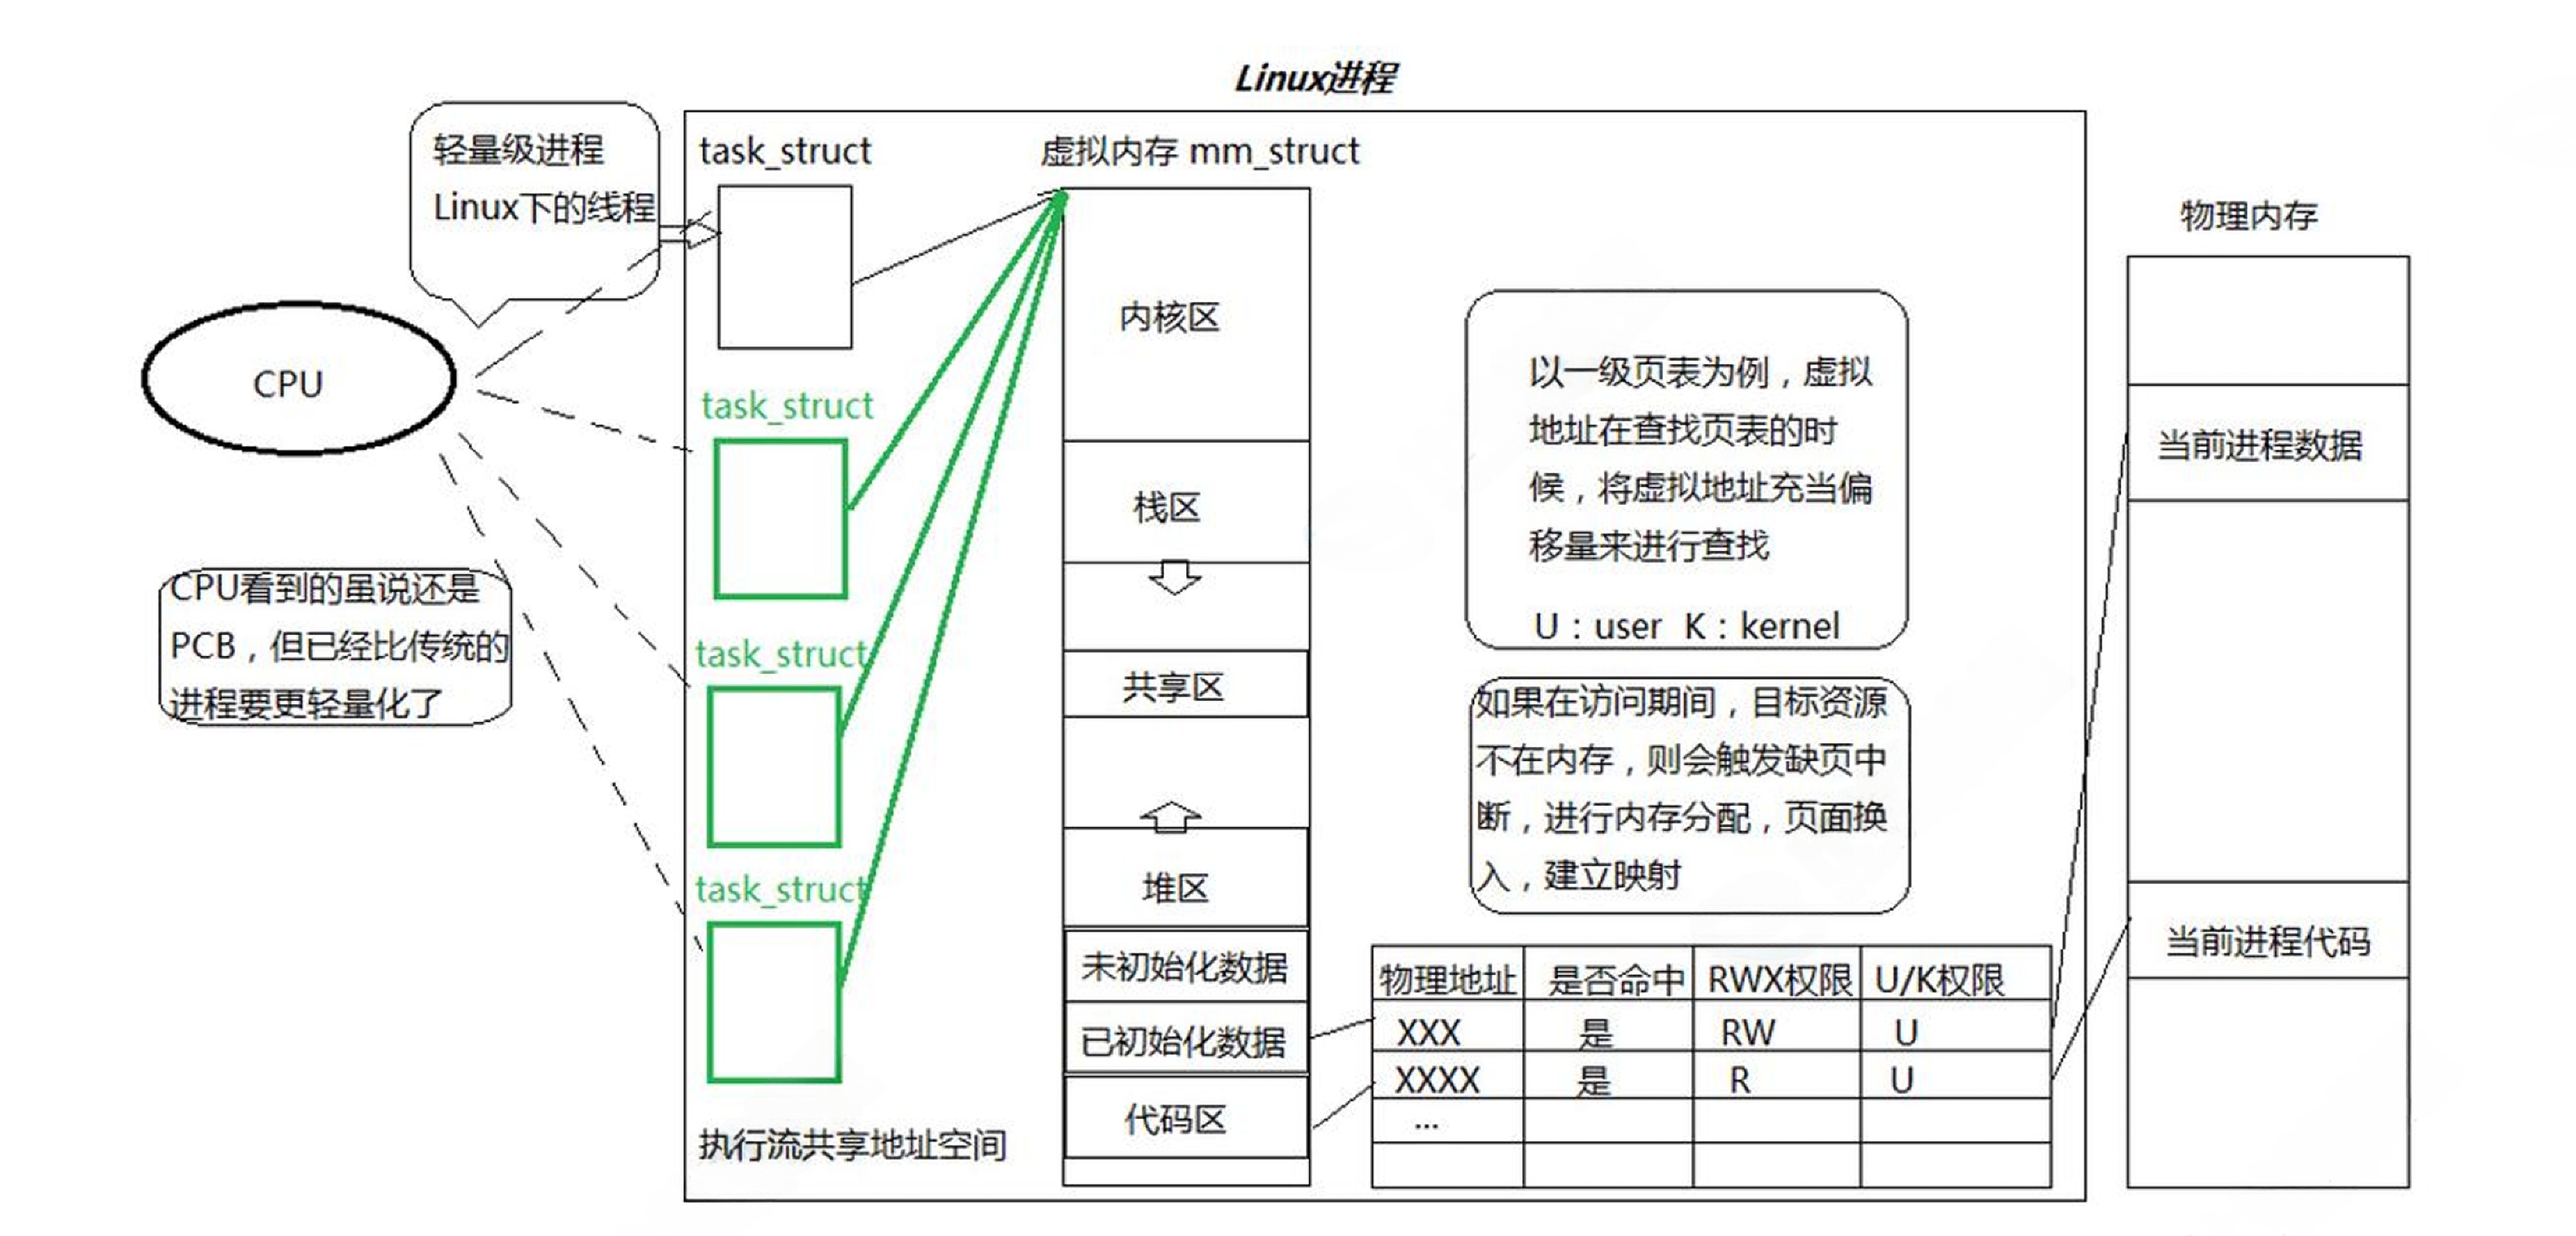
图片内容说明:图中展示
task_struct、mm_struct、虚拟地址空间、物理内存的关系;单进程多线程场景下多个task_struct共用同一个mm_struct,主线程与子线程的内核结构对比。
用户层的pthread库,只是对内核clone系统调用做封装。调用pthread_create,底层调用clone传入特殊标志位,创建共享地址空间的轻量级进程。
主线程同样也是LWP,主线程的LWP ID和进程PID是相等的,使用ps -aL命令可以观察进程内全部LWP。
二、理解线程的底层基础:虚拟地址空间与分页内存管理
说明:要真正懂线程资源划分,必须搞懂虚拟内存分页机制。
✨关键金句:资源划分本质就是地址空间划分;资源共享本质就是虚拟地址的共享,也就是页表条目的共享。线程划分资源,本质就是划分合法虚拟地址范围,操作页表映射。
2.1 如果没有分页机制:物理内存碎片问题
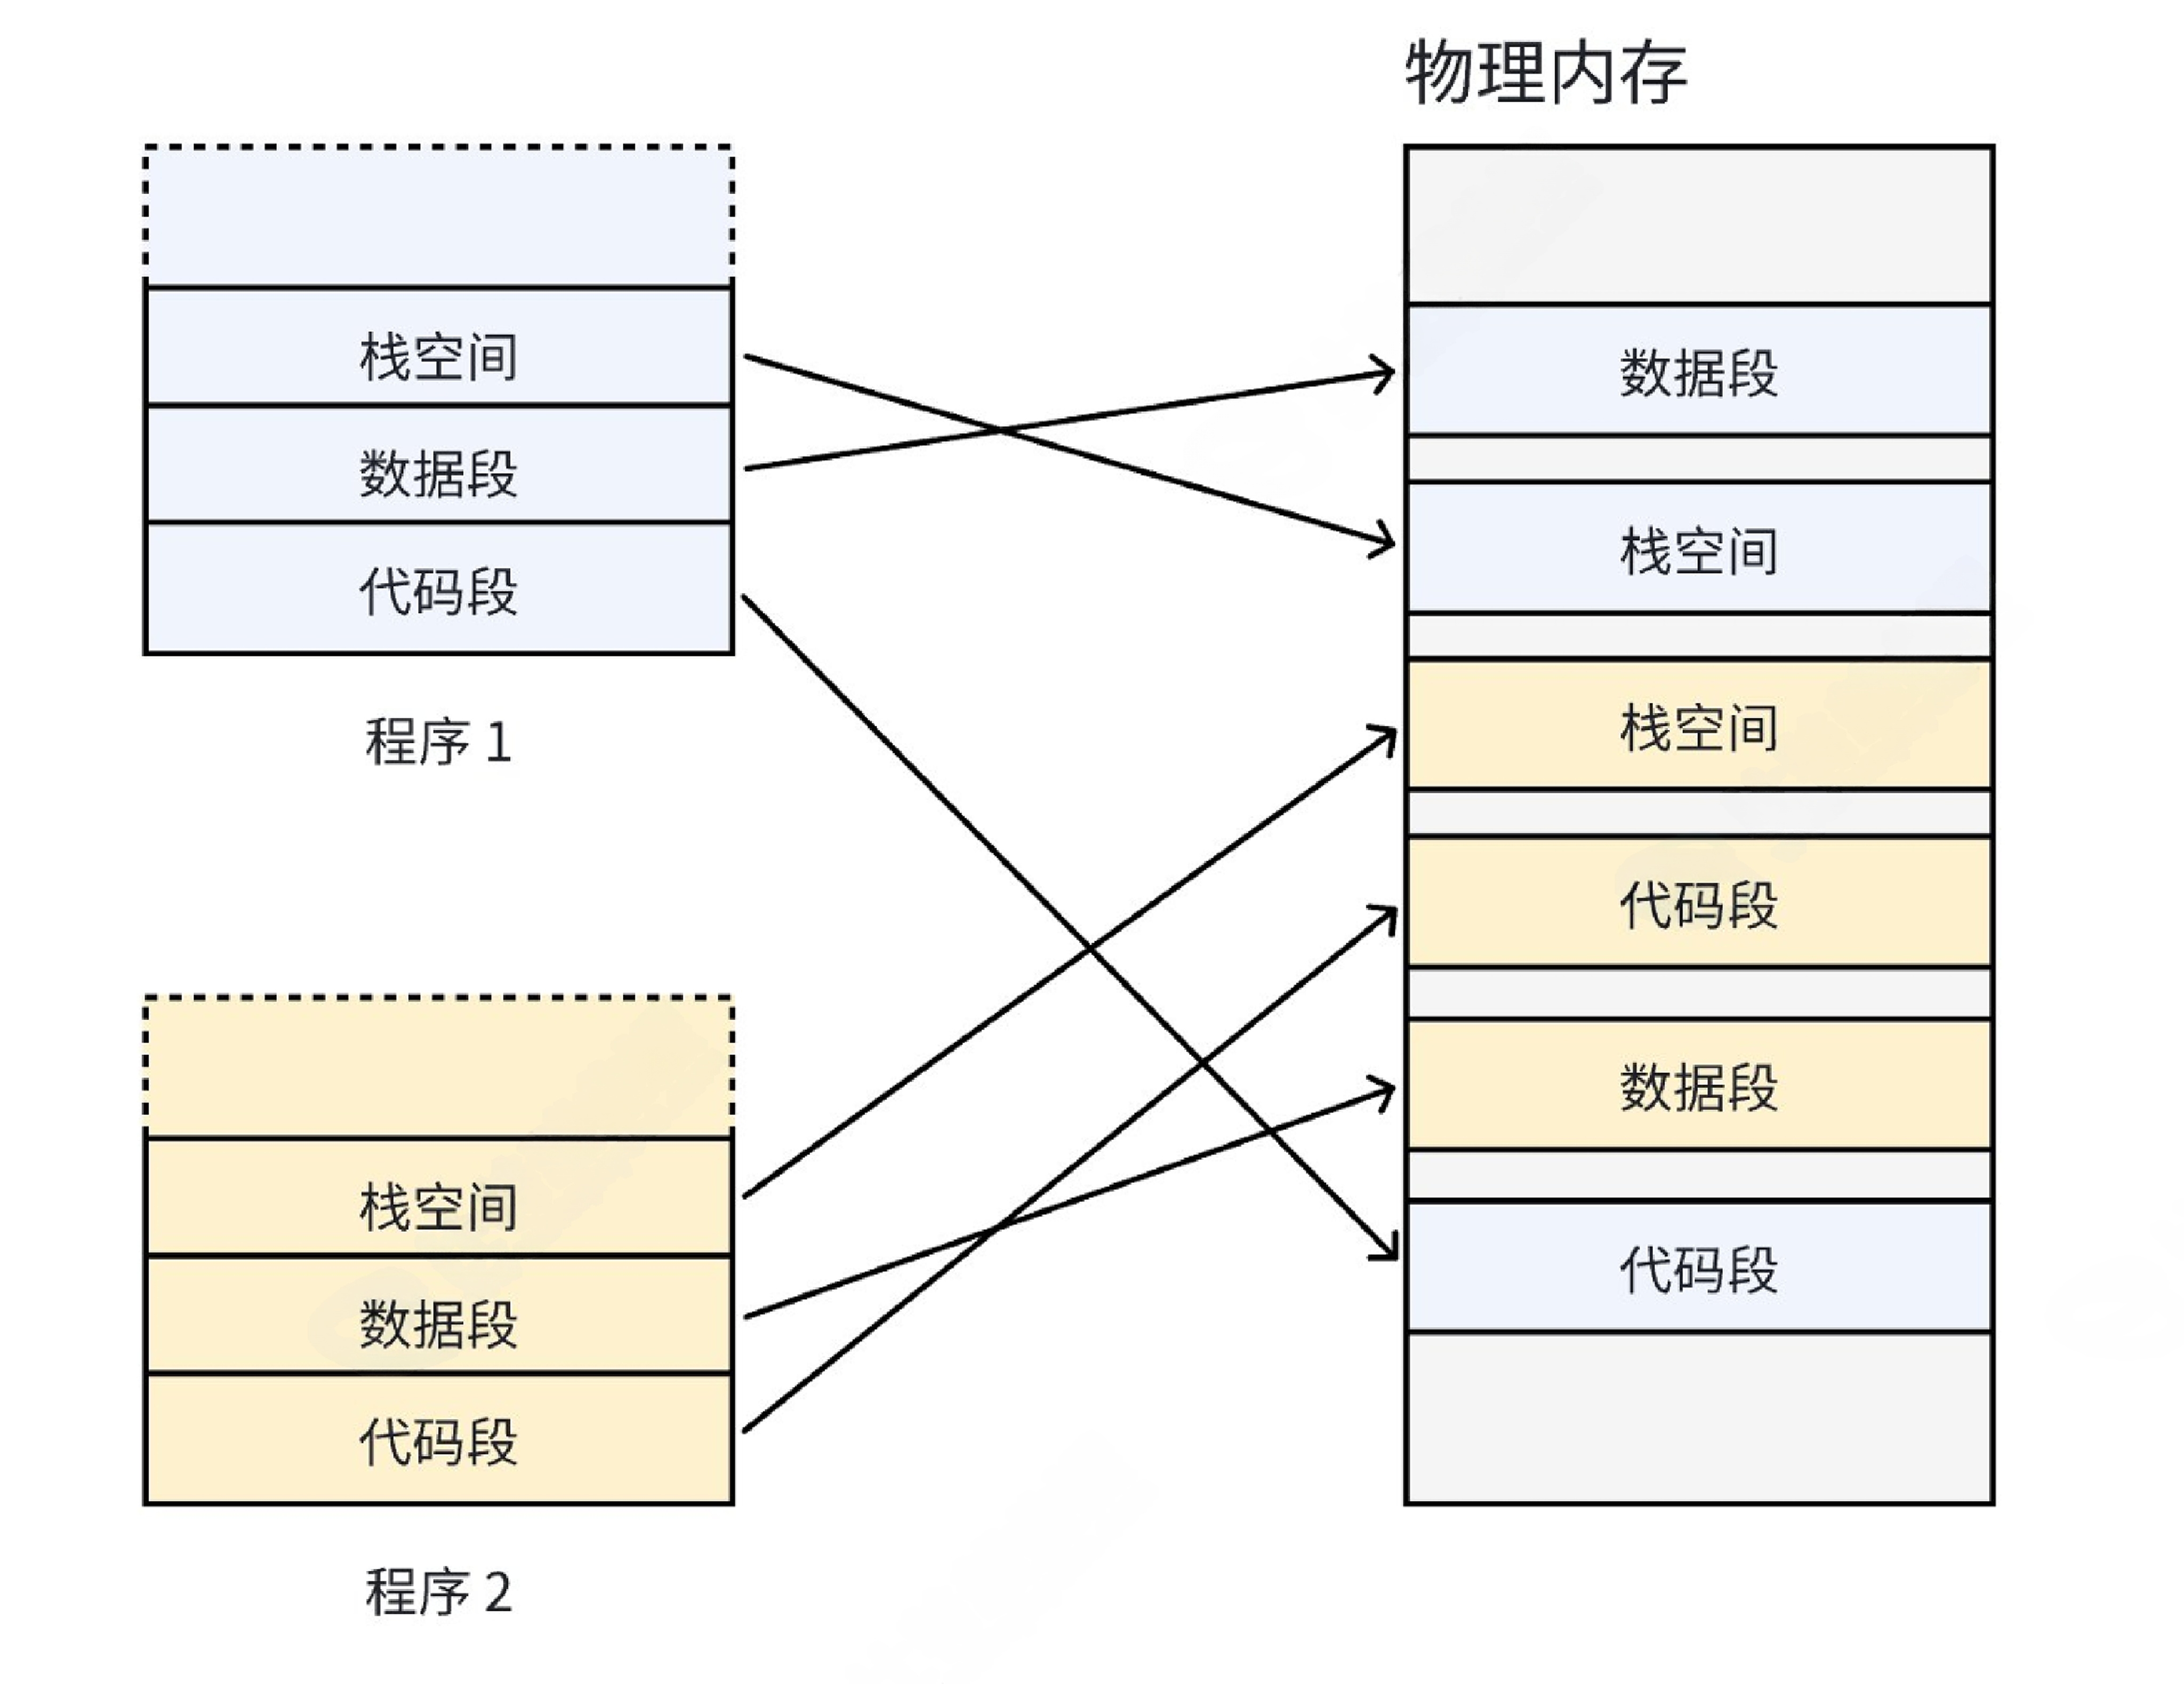
假设操作系统没有虚拟内存、没有分页机制。程序直接访问物理内存,每个程序必须分配一段连续的物理内存 存放代码段、数据段、栈段。
当程序不断创建、退出,内存会不断被分割成大小不一的空闲小块。随着时间推移,会出现大量外部碎片:内存总空闲大小足够,但是没有一块连续物理内存可以满足新程序的内存申请需求,内存明明空闲却分配失败。
无分页机制物理内存分配碎片、4KB页框管理示意图
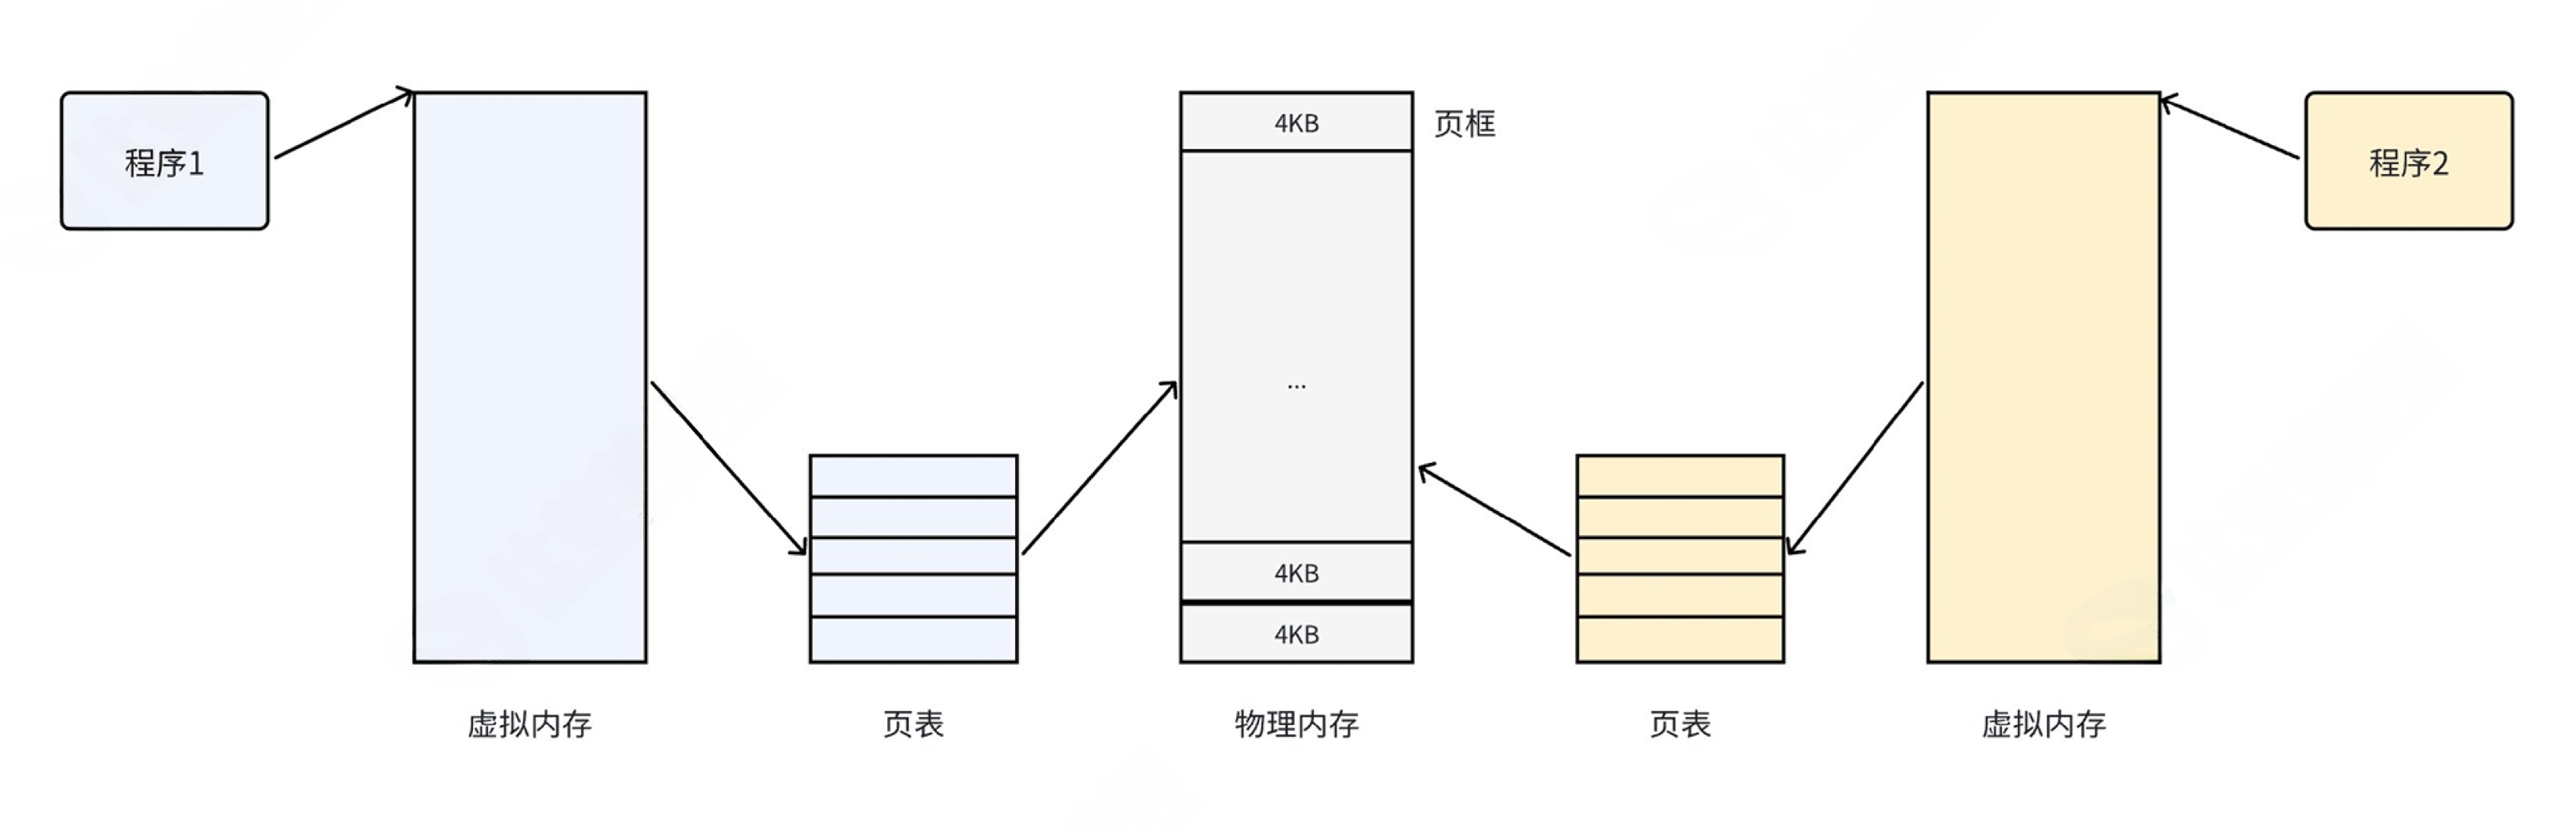
图片内容说明:物理内存分页、struct page,虚拟地址到物理内存映射的基础图示。
我们的理想目标:给进程提供连续的逻辑虚拟地址;物理内存可以使用离散、不连续的物理块。分页存储管理就用来解决这个矛盾。
2.2 页、页框,struct page物理页管理
- 页(Page):逻辑层面,虚拟内存被切分成固定大小的数据块,称为页。
- 页框(Page Frame):物理内存被切分成同样大小的存储区域,称为页框。
Linux默认页大小4KB。32位4G虚拟地址空间,总页数:4GB / 4KB = 1048576。
💡申请物理内存到底在干什么?
内核维护数组
struct page mem[1048576],数组每一项对应一个物理页框。申请物理内存,就是在这个数组里面找到空闲的struct page,拿到数组下标index。
最终物理页起始地址 = index * 4KB;再配合页内偏移,得到完整物理地址。👉不需要在struct page内部保存物理地址,数组下标就等价物理页编号。
Linux内核中,每一个物理页框,都对应一个struct page结构体,用来描述物理页的状态。不需要完整背诵结构体源码,重点理解3个核心成员:
- flags:一组标志位,每一个bit代表物理页状态。比如PG_locked表示页面被锁定,PG_dirty表示脏页(内存修改还没刷回磁盘),PG_uptodate代表页面数据有效。
- _mapcount:引用计数。记录有多少个页表项映射到这个物理页。-1表示该物理页没有任何映射,可以分配使用。写时拷贝机制高度依赖这个计数。
- virtual:该物理页对应的内核虚拟地址;高端内存页面不会永久映射,该字段为NULL,需要动态映射。
简单计算内存开销:4GB物理内存,4KB一页,总共有1048576个物理页。假设每个struct page占40字节,全部结构体只占用约40MB内存。开销很小,内核完全可以承受。
【面试思考】页的大小是不是越大越好?
页太大:页内碎片严重 。程序只需要几字节,也要占用完整4KB页,内存浪费。
页太小:页数量暴增,页表占用内存急剧膨胀;MMU页表遍历次数变多,CPU开销上升。
所以操作系统选择适中的4KB作为默认页大小。
2.3 单级页表的实现与致命缺陷
32位系统虚拟地址空间大小是4GB。如果采用单级页表,每4KB虚拟页对应一个页表项。总表项数量 = 4GB / 4KB = 1048576。每个页表项占4字节,单级页表总大小4MB。
重要:Linux不会使用简单单级页表,单级页表存在硬伤。
- 单级页表要求页表本身必须存放在连续物理内存。当初引入分页就是为了解决连续内存的问题,页表自己却需要连续大块内存,矛盾。
- 按照程序局部性原理,一个进程往往只使用很小一部分虚拟地址。比如一个程序只用10MB内存,单级页表仍然要完整占用4MB,大量页表项闲置,造成内存浪费。
为了解决单级页表的缺陷,Linux使用二级页表(32位x86),把页表进行分层。
32位系统单级页表映射、多级页表整体结构图
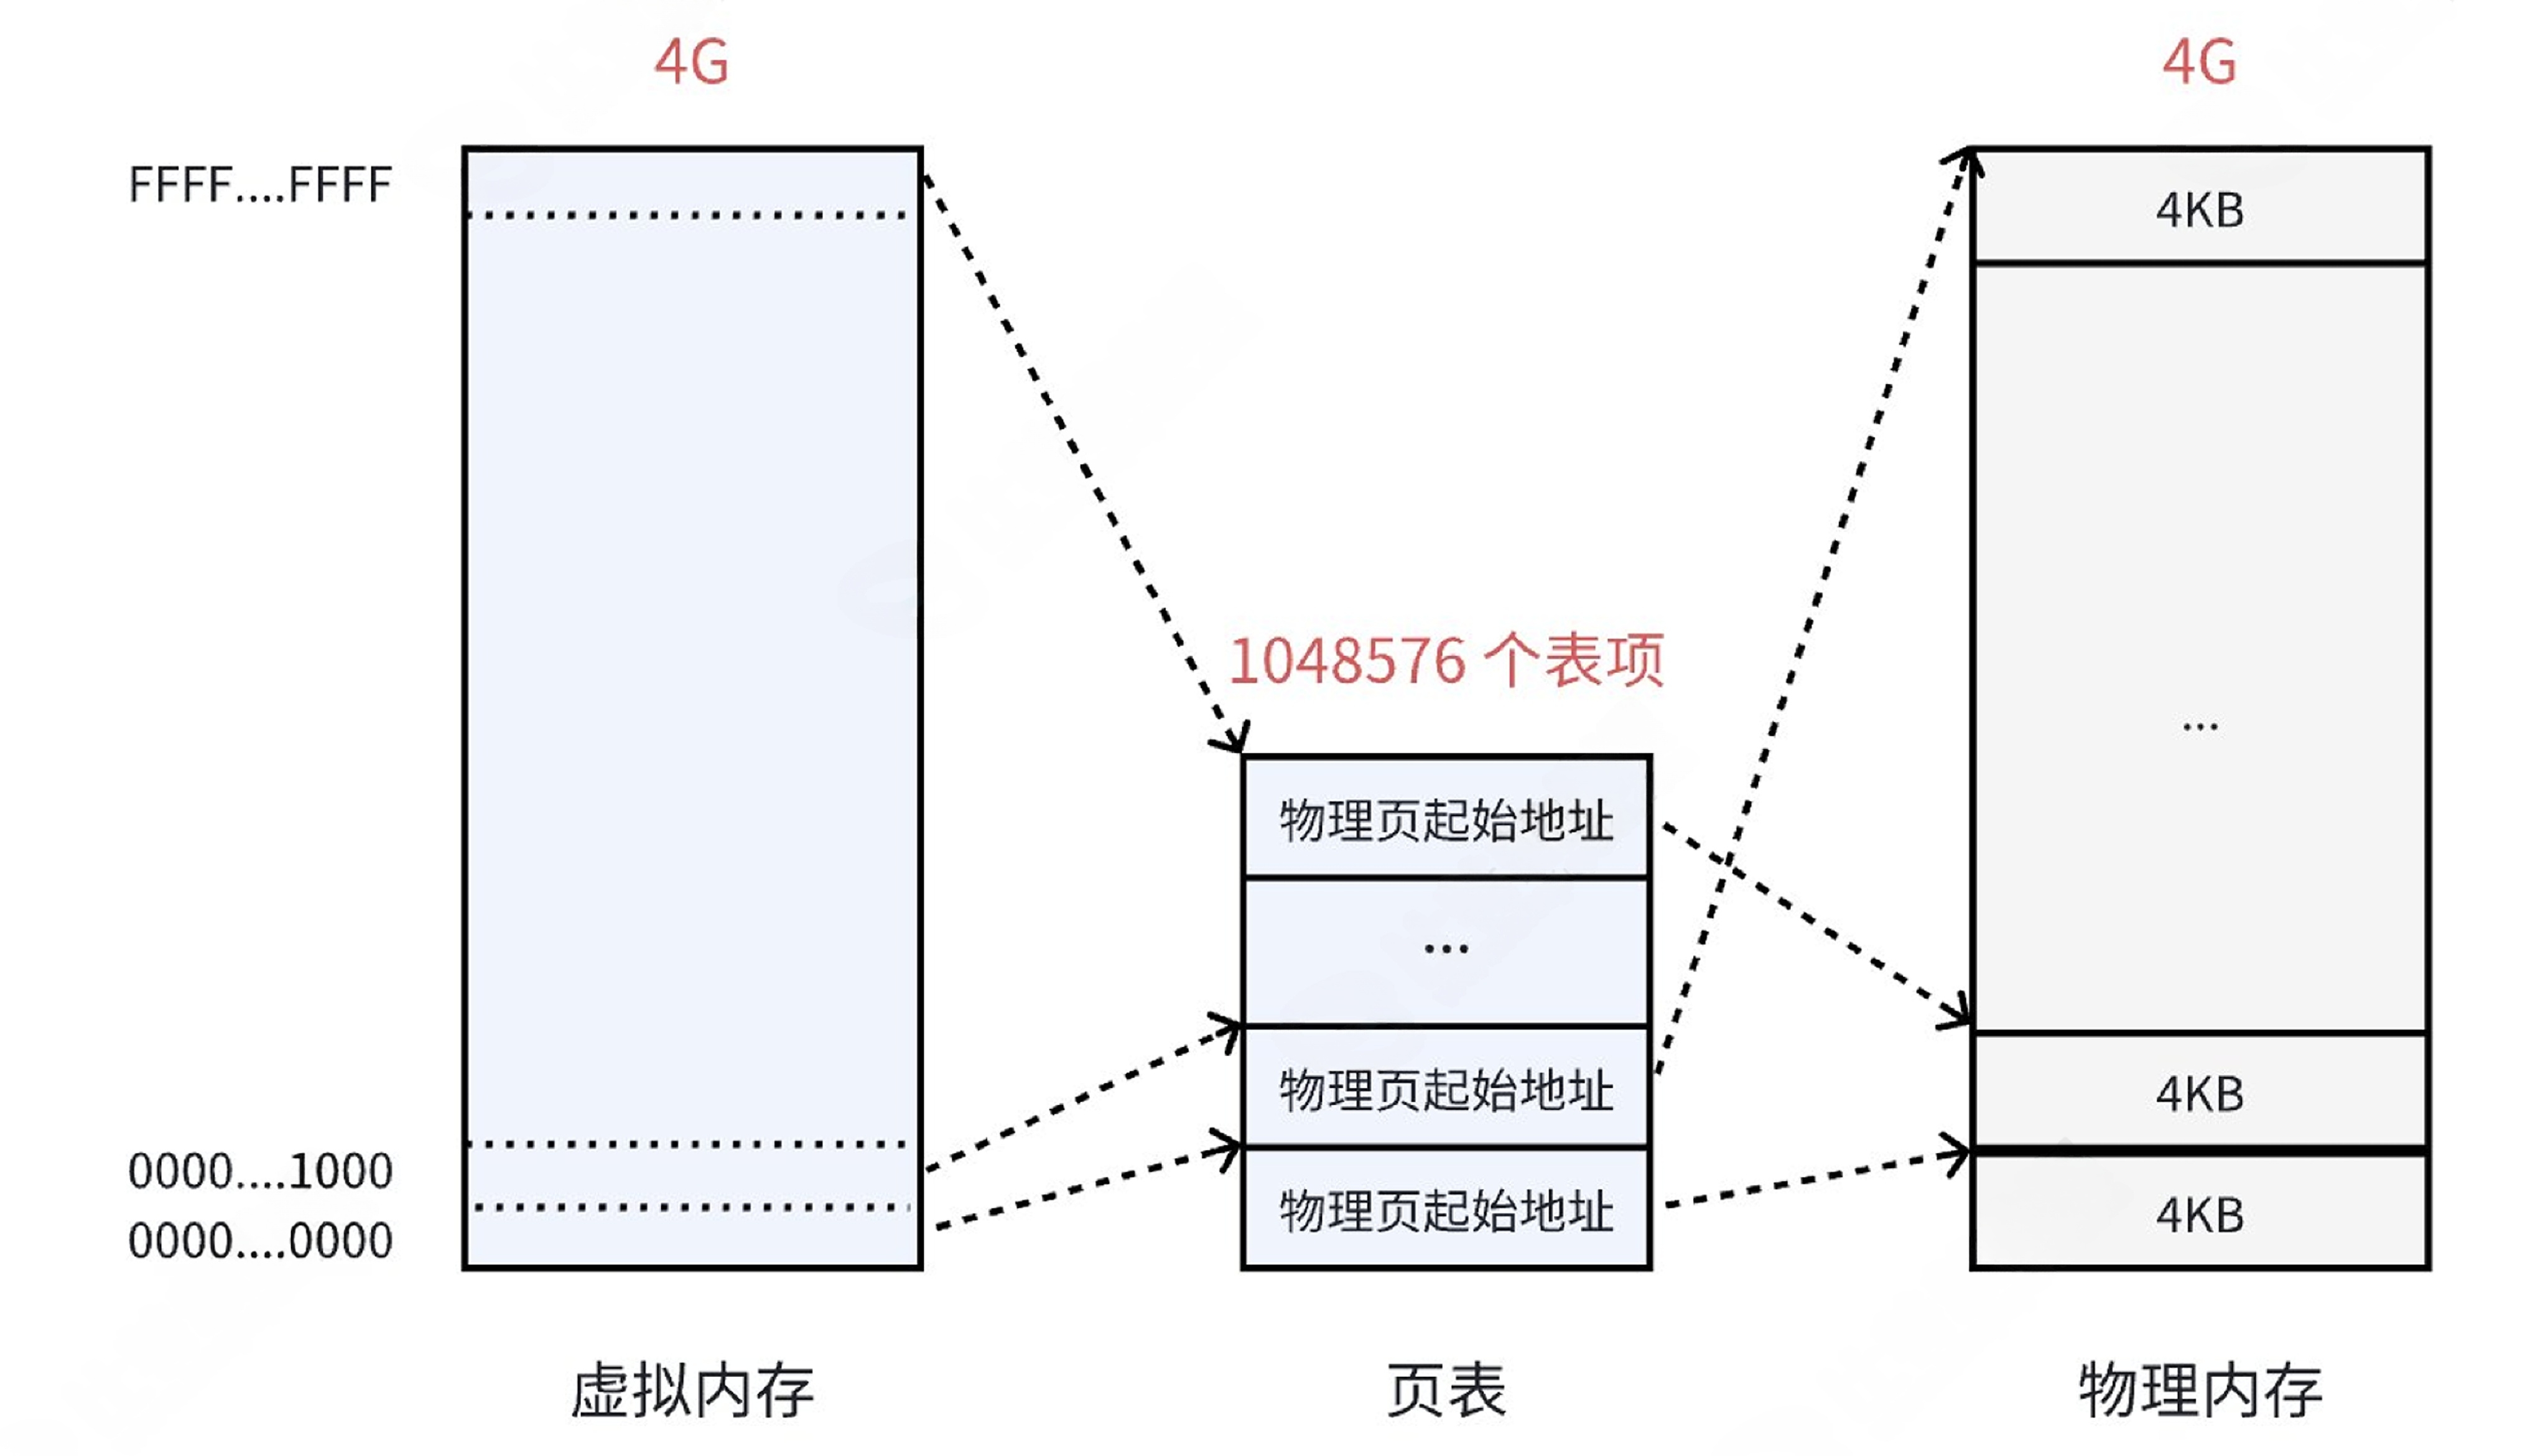
图片内容说明:task_struct/mm_struct,虚拟地址空间分段(内核区、栈、共享区、堆、数据段、代码段),物理内存映射,二级页表整体框架。
2.4 二级页表的设计,CR3寄存器作用
二级页表分为两层:
- 页目录(PGD):顶层,每一项指向一个二级页表。
- 页表(PTE):底层,每一项指向真实物理页框。
CR3寄存器是CPU硬件寄存器,保存当前正在运行进程的页目录的物理地址,属于进程硬件上下文。进程发生切换的时候,操作系统会修改CR3寄存器的值,指向新进程的页目录。
重点!线程切换的时候,不会修改CR3寄存器,因为多线程共享同一个页目录;进程切换必须修改CR3。这就是线程切换开销低的关键根源。
CR3寄存器+二级页目录、二级页表地址拆分示意图
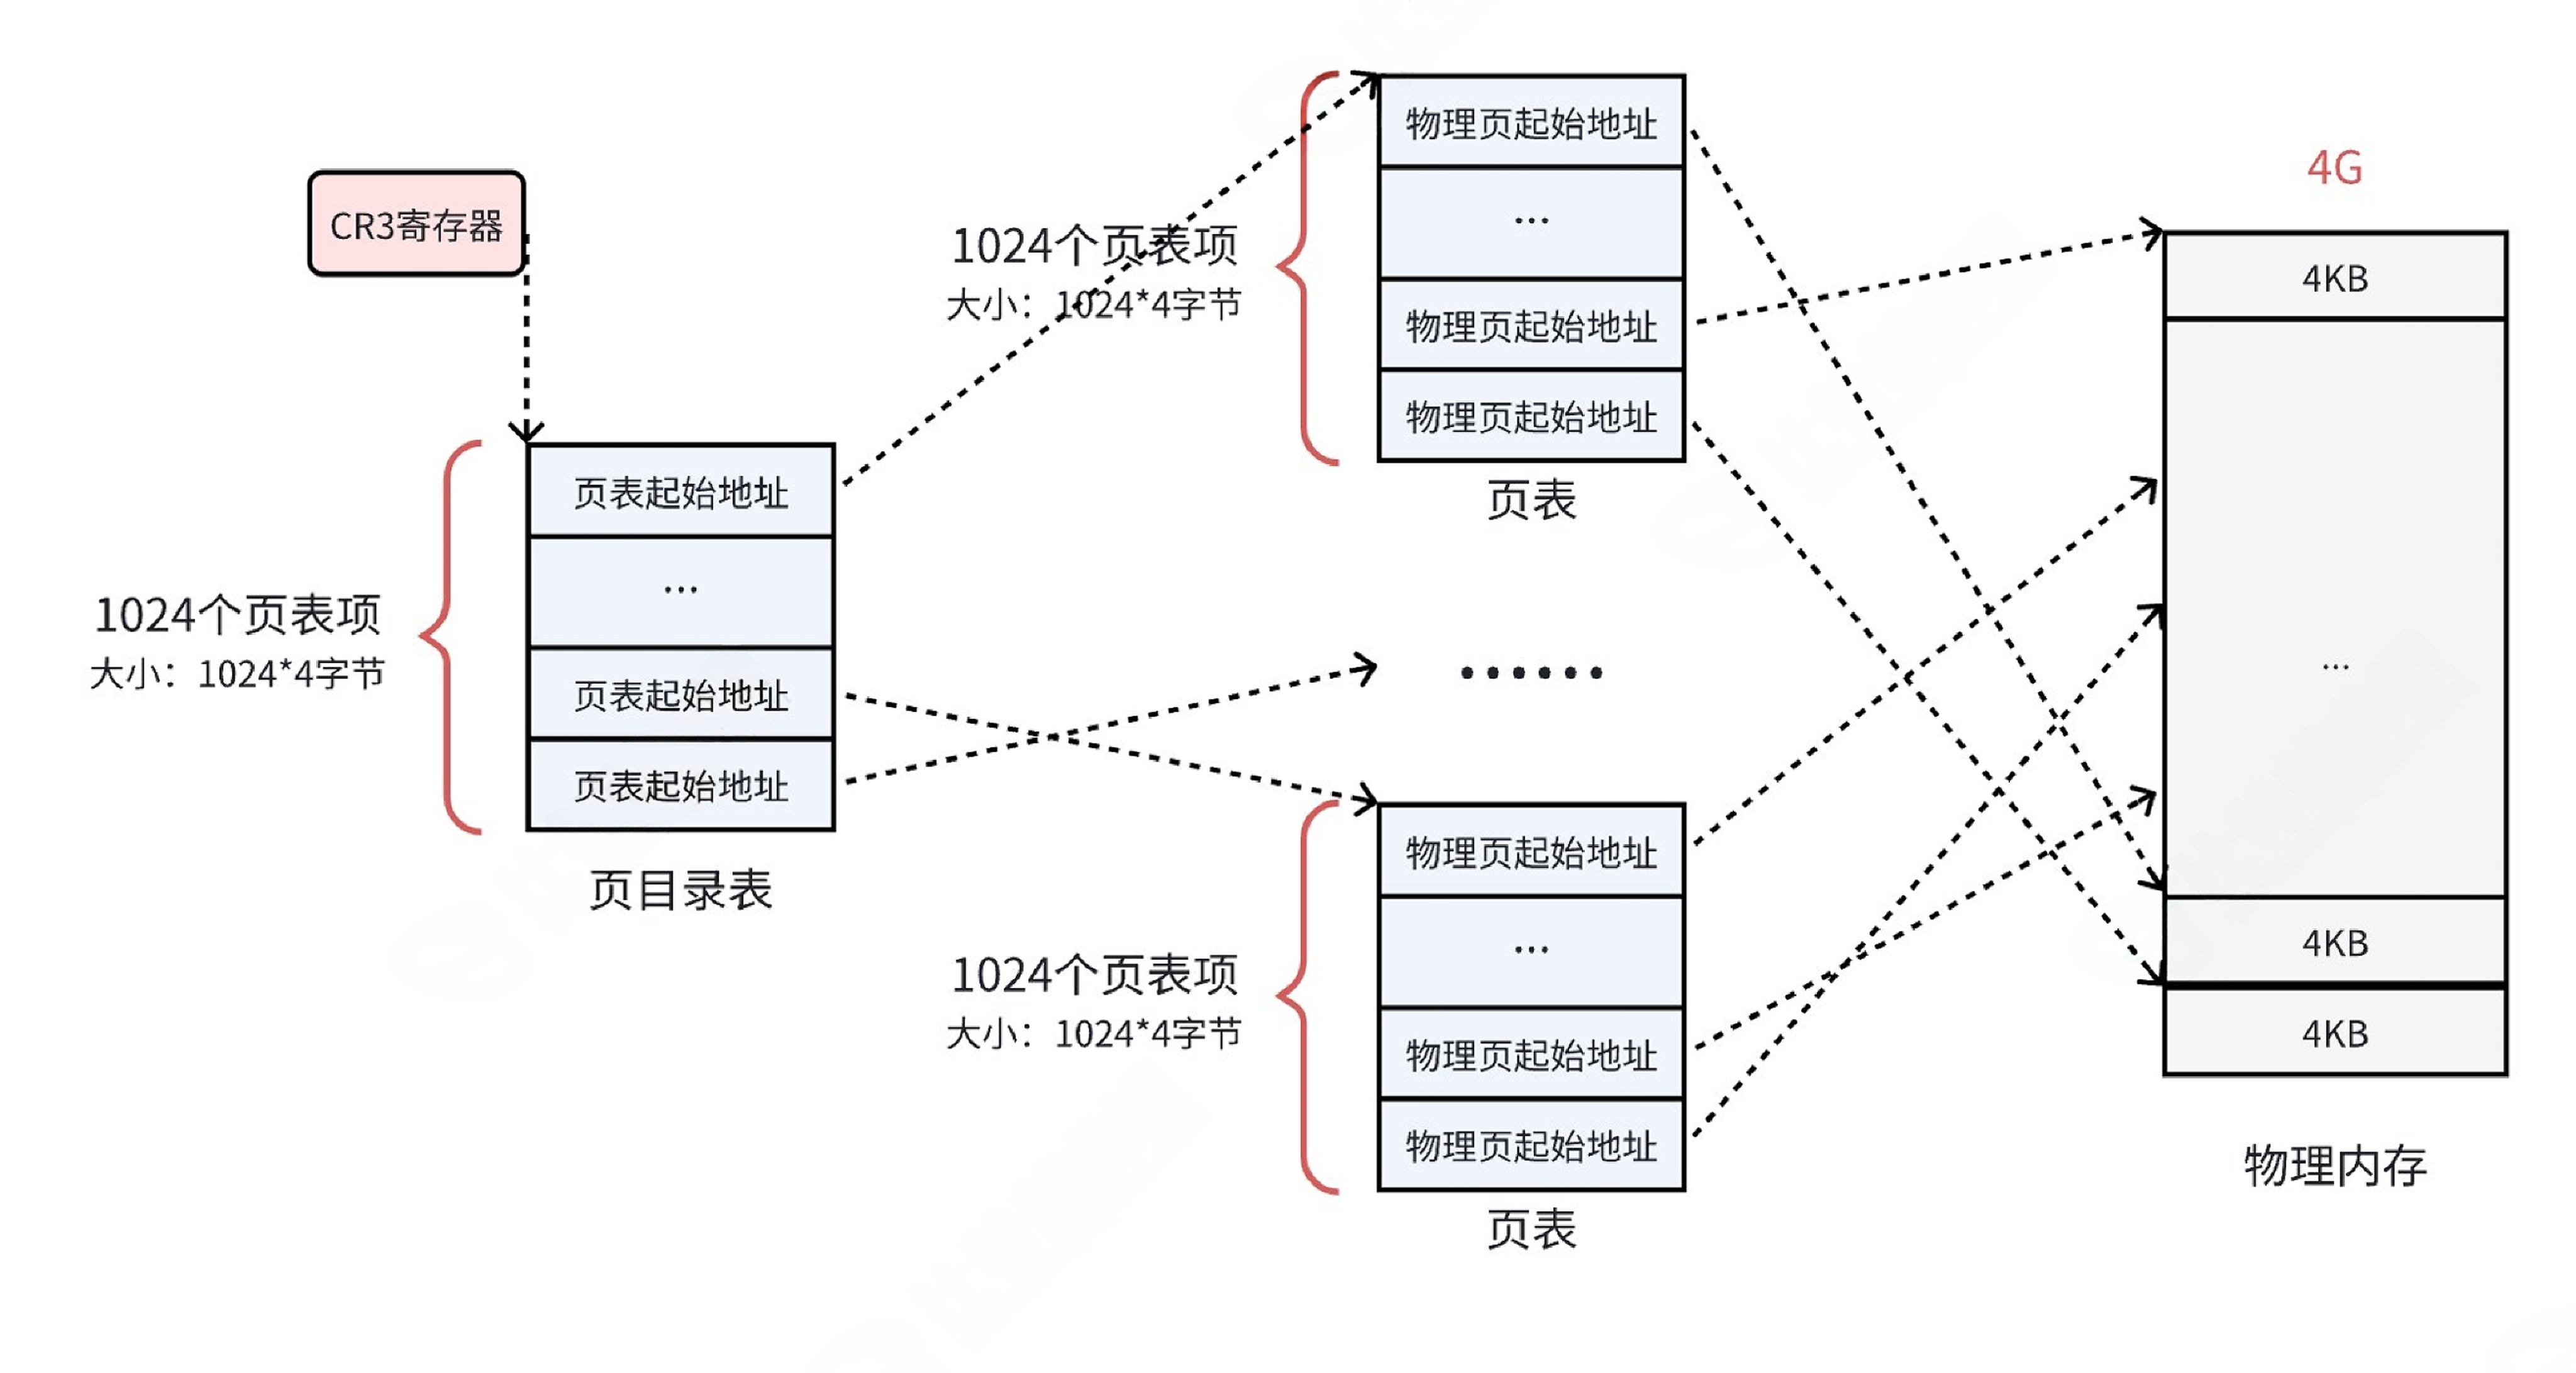
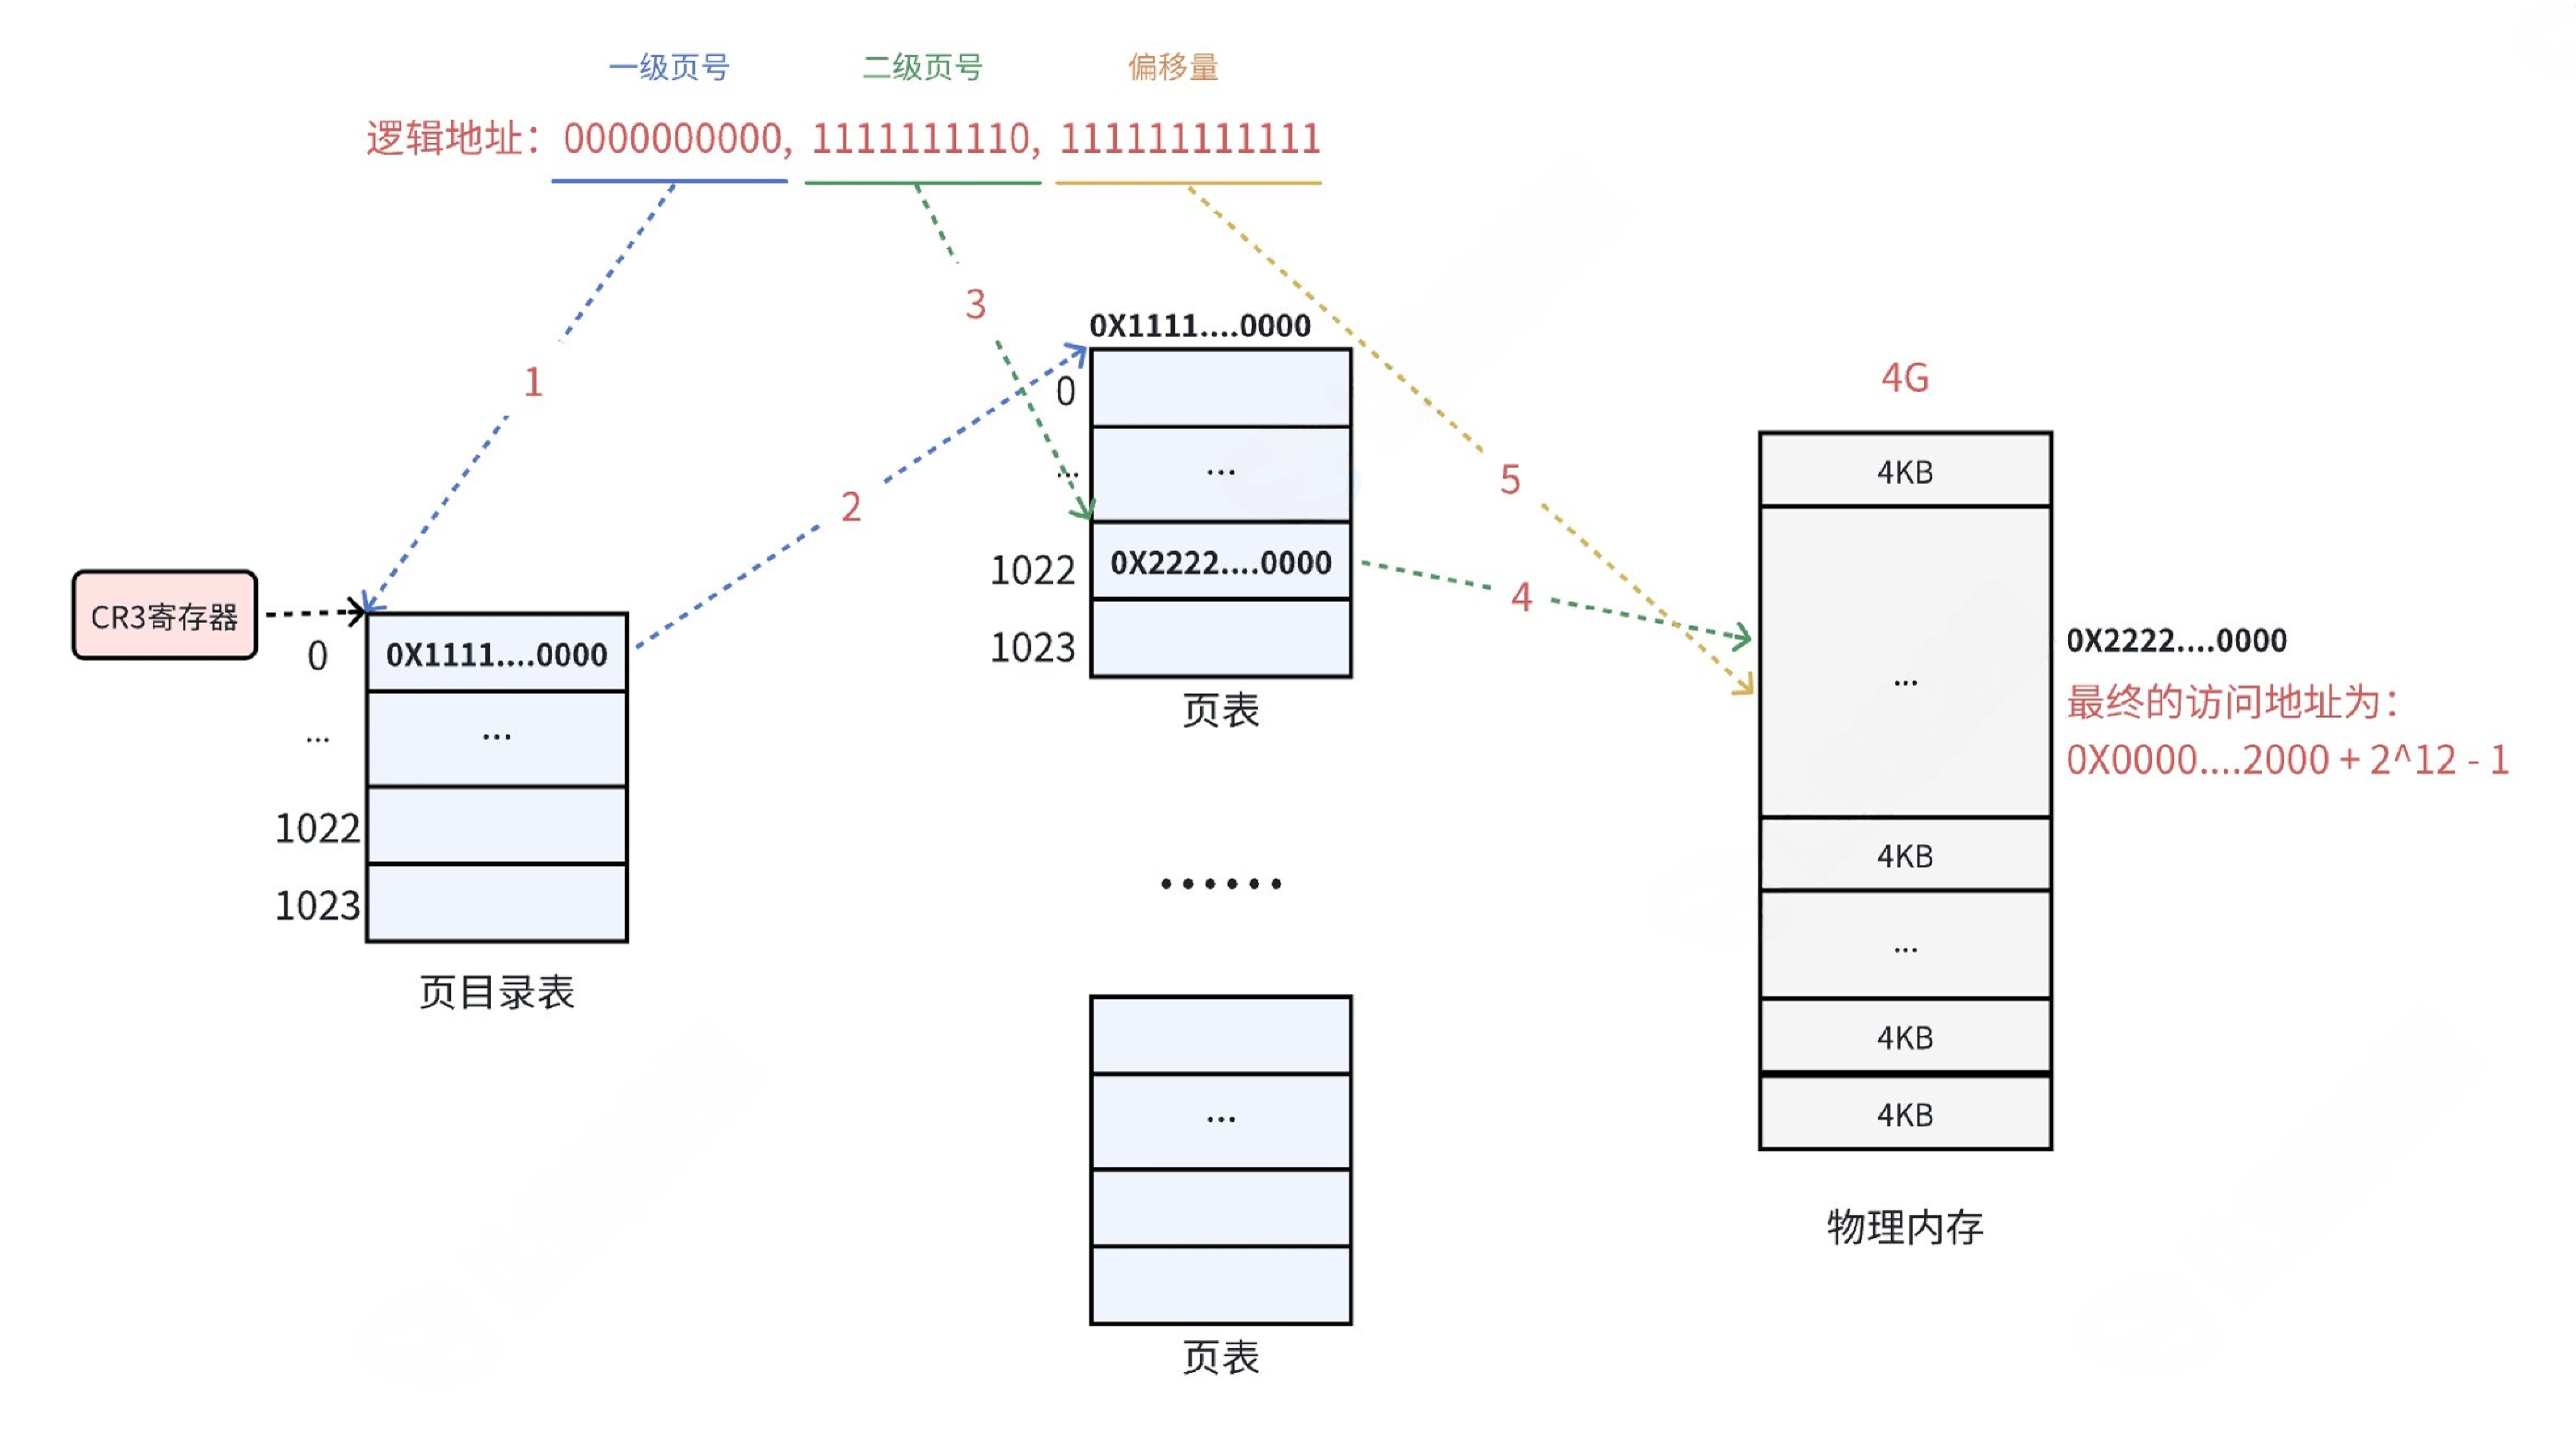
图片内容说明:32位虚拟地址32bit拆分(10+10+12),MMU、CR3,页目录、页表、页内偏移,虚拟地址翻译完整流程。
二级页表的好处:不需要一次性分配全部页表。进程没有使用的虚拟地址,对应的页表可以根本不创建。比如程序只需要12MB内存,仅仅需要3个底层页表,而不是完整1024个页表,极大节省内存。
2.5 32位二级页表完整地址转换全过程
32位,4KB页面,虚拟地址一共32bit,做如下拆分:
- 高10bit:一级页号(页目录索引)
- 中间10bit:二级页号(页表索引)
- 低12bit:页内偏移,虚拟页内部的偏移量,和物理页偏移完全一致,范围0~4095。
MMU硬件完成完整地址转换步骤:
- 读取CR3寄存器,拿到当前进程页目录的物理起始地址。
- 使用虚拟地址高10bit,作为索引,查询页目录,获取对应底层页表的物理地址。
- 使用虚拟地址中间10bit,作为索引,查询底层页表,得到目标物理页框的物理基地址。
- 将物理页框基地址,拼接虚拟地址低12位页内偏移,得到最终完整物理地址。
注意:物理页框的起始地址一定是4KB对齐,低12bit全部为0。页表项中只需要保存物理页高20位即可,剩下bit存放权限位(读、写、用户/内核权限)。
💡拓展理解:写时拷贝、缺页异常、内存申请,背后都在操作页表,重新建立虚拟地址到物理页框的映射关系。
【面试易错辨析】
二级页表访问一次内存,实际上需要三次内存访问:1次访问页目录,1次访问页表,1次访问真正的数据。如果是四级页表,内存访问次数更多。多级页表节省内存,但是增加地址转换的时间开销。
2.6 MMU硬件单元与TLB快表,解决多级页表查询性能问题
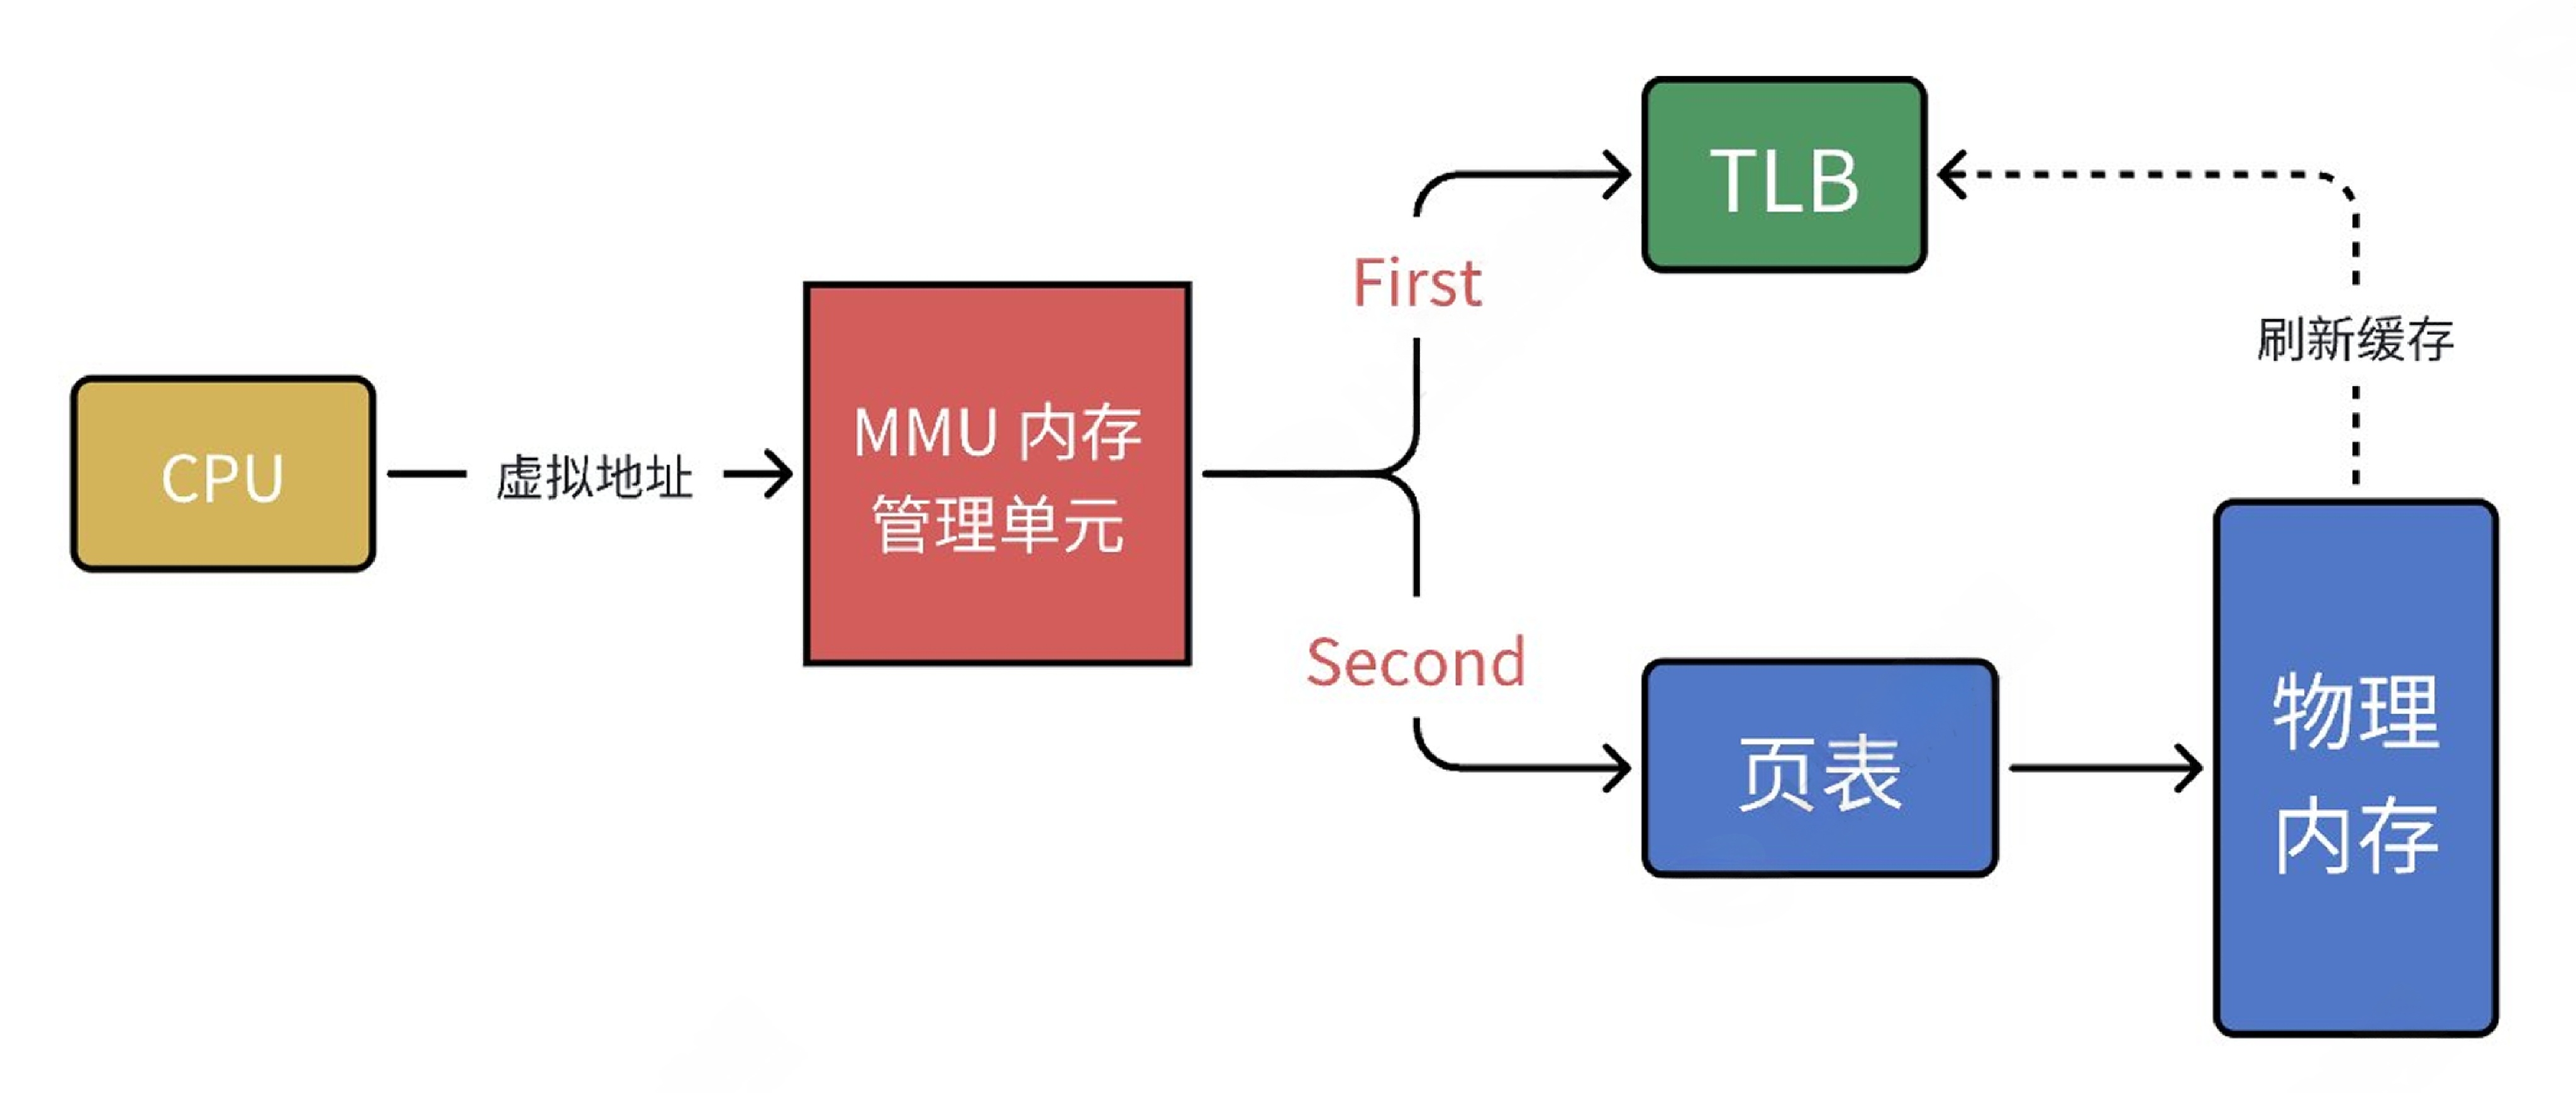
MMU(Memory Manage Unit,内存管理单元),是CPU内部硬件电路,专门负责虚拟地址到物理地址转换,同时做内存权限检查。所有用户程序访问内存,必须经过MMU转换。
多级页表每一次内存访问都要多次读取内存,性能很差。于是引入TLB(Translation Lookaside Buffer,转译后备缓冲器,俗称快表) 。
TLB是CPU内部高速缓存,专门缓存「虚拟页号→物理页框」映射条目。
完整访问流程:
- CPU发出虚拟地址,交给MMU。
- MMU优先查询TLB缓存:
- TLB‑Hit(命中):缓存中存在该虚拟页映射,直接取出物理页框,拼接偏移得到物理地址,直接访问内存,不需要遍历多级页表,速度极快。
- TLB‑Miss(缺失):缓存没有该映射。MMU去内存遍历多级页表完成地址翻译;同时把这条映射存入TLB缓存,供后续访问复用。
重点面试考点:
- 进程切换:修改CR3寄存器,TLB整体刷新失效。旧进程全部缓存的映射全部作废,新进程访问内存大量TLB‑miss,带来很大性能开销。
- 线程切换:同一个进程内部线程切换,CR3寄存器不改变,TLB缓存全部保留有效,不需要刷新。这就是线程切换比进程切换快的关键原因之一。
补充:除TLB之外,CPU的L1/L2/L3数据缓存也会在线程切换时部分保留;进程切换会大量污染缓存。二者叠加,放大进程切换的性能损耗。
2.7 缺页异常Page Fault
MMU查询页表的时候,如果发现页表项present有效位为0,虚拟地址没有合法的物理内存映射,硬件触发缺页异常(Page Fault) 。CPU从用户态切换到内核态,调用内核Page Fault Handler缺页异常处理函数,根据不同情况做不同处理。
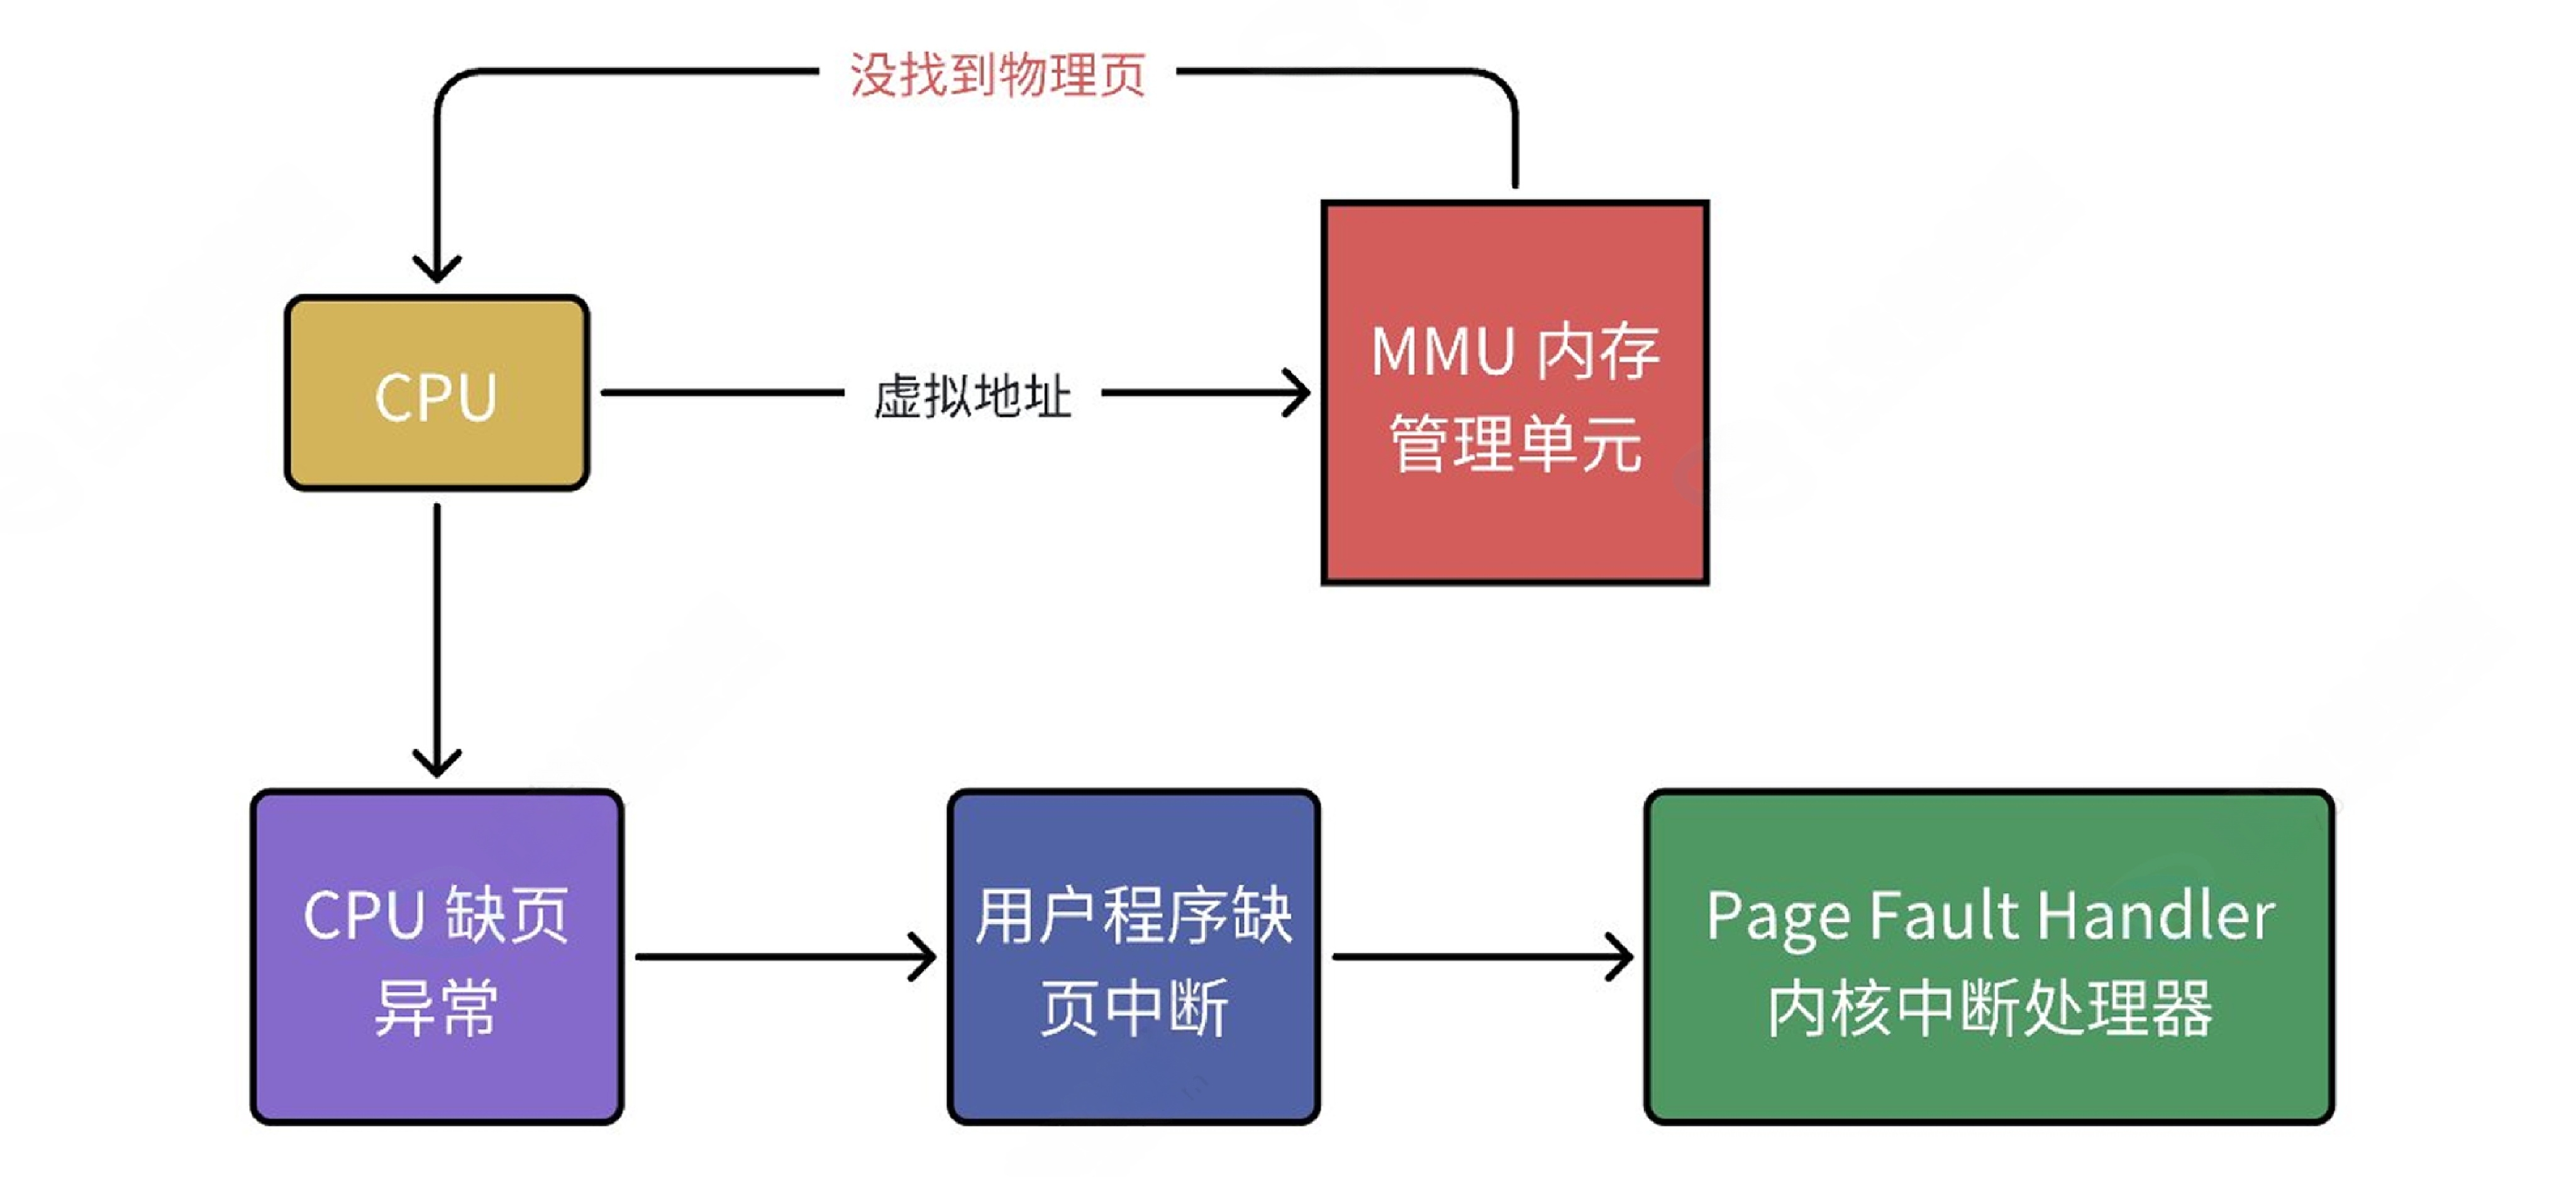
2.7.1 硬缺页 Major Page Fault
物理内存中完全没有该页数据,需要从磁盘读取数据加载到物理内存 。
典型场景:访问磁盘映射文件、页面被swap交换到磁盘。
开销很高,涉及磁盘IO,毫秒级别,会明显拖慢程序性能。
2.7.2 软缺页 Minor Page Fault
页面的数据已经存在物理内存,只是页表还没有建立映射,不需要磁盘IO 。
典型场景:
malloc分配内存之后第一次访问(惰性分配,虚拟地址已经分配,物理页还没分配,第一次访问触发软缺页分配物理页)。- fork之后写时拷贝,父子进程共享物理页,发生写操作触发软缺页复制页面。
- 多进程共享内存,新进程第一次访问共享区域。>
开销小,只需要内存操作,微秒级别。
2.7.3 无效缺页 Invalid Page Fault
访问的虚拟地址根本不在进程合法虚拟地址区间;或者权限不匹配,比如只读页面执行写操作。内核直接向进程发送SIGSEGV信号,也就是我们熟悉的段错误Segment Fault,进程直接终止。
【面试高频辨析】缺页异常≠段错误
软/硬缺页属于正常机制,内核修复之后程序继续运行;无效缺页才会触发段错误,杀死进程。
✨笔记补充重要考点:数组越界不一定会崩溃!如果越界访问刚好落在进程已经合法映射的虚拟页内,操作系统不会捕获,只会默默篡改内存,产生隐蔽bug。只有访问不在合法虚拟地址区间,触发无效缺页,才会段错误崩溃。
2.8【面试思考拓展】结合malloc、写时拷贝理解缺页
很多同学疑惑:malloc(10*1024*1024*1024)申请10GB内存,返回成功,但是top看物理内存占用几乎不上涨?
这就是Linux的惰性内存分配 :malloc/new仅仅在虚拟地址空间划分出一块合法虚拟区间,不会立刻分配物理内存。只有真正读写这块内存的时候,触发缺页异常,内核才分配物理页框。
写时拷贝(COW)也是软缺页典型场景:fork之后父子进程共享全部物理页,页表标记只读。当任意一方修改内存,触发软缺页,内核复制一份新物理页给修改方。
三、线程的优缺点、异常行为以及适用场景
3.1 线程的优点
- 创建销毁代价更小
创建线程,内核只需要新建一个task_struct,分配线程私有栈,复用进程已经存在的mm_struct、页表、文件描述符等全部资源。
创建进程需要完整拷贝(写时拷贝)虚拟地址空间、页表,资源开销远大于线程。 - 线程上下文切换开销远小于进程切换
理解:上下文切换最大损耗是寄存器保存恢复;隐藏损耗是扰乱CPU缓存。进程切换更换页表,TLB全部作废;线程切换共享虚拟地址,TLB不刷新。
- 进程切换:保存寄存器;修改CR3寄存器切换页目录;TLB全部刷新失效;CPU缓存大量失效。直接、间接开销都很大。
- 线程切换:仅仅切换寄存器上下文,栈指针;CR3不变,虚拟地址空间不变,TLB缓存完全保留,不需要刷新。切换的直接开销小,缓存间接开销几乎没有。>
注意:线程切换同样有开销,寄存器保存恢复、内核调度逻辑还是要消耗CPU,只是相比进程切换轻量很多。
- 占用系统资源更少
线程只需要task_struct + 私有栈,不需要独立虚拟地址空间,内存资源消耗远小于进程。 - 充分利用多CPU多核并行计算
多线程可以调度到不同CPU核心真正并行执行,把CPU算力充分发挥。进程当然也可以,但是进程资源开销更大。 - 计算与IO等待可以互相重叠执行
一个线程阻塞等待慢速IO(磁盘、网络),CPU可以调度其他线程执行计算逻辑,不用干等,提升整体吞吐。
3.2 线程的缺点
- 性能损失
如果CPU密集型线程数量远超CPU核心数,大量时间消耗在线程调度切换,大量上下文抢占,反而会降低整体性能,增加同步互斥锁开销。 - 健壮性降低,线程缺少隔离保护
同一个进程的所有线程共享地址空间。一个线程写越界,破坏全局堆、全局变量,直接影响其他全部线程。进程之间有严格地址空间隔离,一个进程崩溃不会干扰其他进程。 - 缺少访问控制粒度
进程是操作系统访问控制的基本单位。很多系统调用作用于整个进程,比如信号处理、工作目录、用户ID。线程调用部分系统调用会影响全部线程,而不是仅仅当前线程。 - 编程、调试难度上升
多线程会遇到竞态条件、死锁、数据竞争,bug复现随机性很强。gdb调试多线程、定位死锁难度远高于单线程程序,引出线程安全的概念。
3.3 ⚠️线程异常:一个线程崩溃,整个进程直接退出
【面试高频易错点】很多人误以为子线程崩溃只会杀死自己,其他线程继续运行。
✅真相:只要进程内部任意一条线程发生异常(除零错误、野指针访问触发段错误),内核发送信号,信号是进程级别的,整个进程收到信号,全部线程一起被销毁退出。
原理:线程异常触发硬件异常,内核生成信号递交给进程。信号处理粒度以进程为单位,只要收到致命信号,操作系统直接回收整个进程的全部资源,进程内所有task_struct(所有线程)全部销毁。主线程崩溃和子线程崩溃效果完全一致。
拓展:能不能做到一个线程崩溃,其他线程继续跑?Linux原生做不到。可以借助子进程、进程隔离方案实现。
3.4 线程适用场景深度解析
1)CPU密集型程序 :大量做计算,CPU满负载。
多线程目的是利用多核CPU真正并行运算。线程数量建议约等于CPU核心数 。
如果线程数量远大于核心,CPU花大量时间做线程切换,性能反而下降。
示例:视频编解码、数值计算、模型推理。
2)IO密集型程序 :大部分时间阻塞等待网络、磁盘IO,CPU经常空闲。
IO阻塞的时候线程让出CPU,其他线程可以继续工作。线程数量可以远大于CPU核心数量。
示例:网络服务器,同时等待大量客户端socket IO。
【面试问答】IO密集型为什么不用多进程?多进程资源开销更大,进程间通信复杂;线程共享地址空间,数据交互简单,资源开销小。
四、进程与线程对比:哪些资源共享,哪些是线程私有?
4.1 核心概念回顾
进程是资源分配的基本单位,线程是CPU调度的基本单位 。
Linux内核视角:进程和线程都是
task_struct。区别就是:传统进程拥有独立mm_struct虚拟地址空间;同一进程的多个线程task_struct指向同一个mm_struct。
4.2 线程独占(私有)资源
每个线程自己独有的资源,其他线程不可直接使用。
| 私有资源 | 简要说明 |
|---|---|
| 线程ID(内核LWP、用户pthread_t) | LWP是内核调度标识;pthread_t为用户库层ID |
| 一组寄存器(上下文) | 保存线程运行时CPU寄存器,线程切换时保存恢复 |
| 线程私有栈 | 保存函数局部变量、函数调用栈帧;子线程栈由pthread库mmap分配,大小默认8M,不可动态增长;主线程栈由内核管理,可以动态扩展 |
| errno变量 | 线程局部变量,每个线程独立,避免多线程相互干扰 |
| 信号屏蔽字 | 每个线程可以设置自己的信号掩码,屏蔽特定信号 |
| 调度优先级 | 线程独立的调度优先级属性 |
| 线程局部存储TLS | pthread_key创建的线程私有全局数据 |
4.3 所有线程共享的进程级资源
同一个进程内全部线程共享这些资源,任意线程修改,其他线程立刻可见。
| 共享资源 | 简要说明 |
|---|---|
| 虚拟地址空间(mm_struct) | 代码段、全局数据段、堆全部共享,可以访问同一个全局变量,调用同一个函数 |
| 文件描述符表 | open打开的fd全部共享,一个线程close(fd)其他线程无法再使用该fd |
| 信号处理方式 | SIG_IGN、SIG_DFL或者自定义信号处理函数,进程全局生效 |
| 当前工作目录cwd | chdir修改工作目录,全部线程生效 |
| 用户ID、组ID(uid/gid) | 用户身份凭证,进程级别 |
| 内存映射(mmap) | 共享库、共享内存映射全部共享 |
4.4【面试辨析】什么叫单线程进程?
我们写普通C/C++程序,只有main函数,这就是单线程进程 。
在内核视角:进程只有一个task_struct(主线程LWP),task_struct绑定mm_struct虚拟地址空间。进程=资源容器 + 唯一执行流。
拓展提问思考:主线程栈和子线程栈有什么区别?
- 主线程栈:内核分配,进程栈,可以动态向下扩展,栈越界可以自动扩充,超过上限才报段错误。
- pthread创建出来的子线程栈:pthread库调用
mmap在共享区申请,默认8MB,大小固定,不能动态增长。栈写满直接栈溢出,触发段错误。
// 简单示意,主线程和子线程栈来源不同
// 主线程栈:内核在创建进程时设置
// 子线程栈:pthread库内部通过mmap(MAP_ANONYMOUS)申请一块匿名内存作为栈
六、全文面试考点总结
整理高频面试问题与记忆清单,复习快速回顾:
-
Linux内核线程本质 :没有专门内核TCB,线程就是LWP轻量级进程,复用task_struct;多线程共享同一个
mm_struct虚拟地址空间。pthread_create底层封装clone系统调用。 -
灵魂面试口述金句:资源划分本质就是虚拟地址空间、页表的划分;资源共享本质就是虚拟地址、页表条目的共享。虚拟地址就是资源的代表。
-
进程与线程核心定义:进程是资源分配的基本单位,线程是CPU调度的基本单位。
-
线程切换为什么比进程切换快?
- 线程切换不修改CR3寄存器,不需要更换页目录,TLB不会整体刷新;进程切换修改CR3,TLB全部失效。
- 线程只切换寄存器上下文;进程切换除寄存器,还要处理地址空间,缓存大量失效,间接开销巨大。
-
二级页表、MMU、TLB工作流程:32位虚拟地址拆分10+10+12;CR3存页目录物理地址;TLB缓存虚实映射,减少页表遍历次数。TLB‑hit直接转换,TLB‑miss遍历多级页表。
-
三类缺页异常区分
- 硬缺页Major:需要磁盘IO;
- 软缺页Minor:内存已有数据,仅建立映射,无磁盘IO(malloc惰性分配、写时拷贝);
- 无效缺页:非法访问,发送SIGSEGV段错误杀死进程。>
拓展:数组越界不一定崩溃,落在合法虚拟页只会篡改内存。
-
线程异常关键点:进程内任意线程崩溃,整个进程全部退出。信号是进程粒度。
-
线程资源表格记忆:哪些私有、哪些共享。子线程栈mmap固定大小,主线程栈可动态扩展。
-
pthread库底层:Linux内核没有线程系统调用,pthread库封装clone;1:1模型,用户线程对应内核LWP;pthread_t是库内地址,不等于LWP。
-
适用场景:CPU密集线程数≈CPU核心数;IO密集线程数可以大于CPU核心。线程过多会带来调度开销,性能下降。
-
易错坑点
pthread_t(用户层ID)不等于内核LWP ID;- malloc成功不代表分配物理内存,惰性分配,访问才触发缺页;
- 内存越界不一定立刻段错误,如果落在合法页只会破坏内存;
- 子线程不要调用exit();pthread_exit参数不能传局部栈地址;
补充面试反问点:虚拟内存分页解决的是什么问题?外部碎片;页表多级分页解决单级页表需要连续内存、内存浪费的问题。
对比Windows与Linux线程实现差异。