Hadoop基础入门到实战:从Python理解MapReduce到HDFS架构与集群搭建
本文从大数据基础概念出发,通过Python代码一步步拆解MapReduce思想,带你从零理解分布式计算的本质;然后深入HDFS架构原理,最后附上Hadoop 3.1.3集群搭建完整教程。适合大数据初学者入门阅读。
📑 目录
- 一、大数据入门:数据怎么存?怎么处理?
- 二、HDFS架构原理深度解析
- 三、MapReduce思想:用Python手撕分布式计算
- [3.1 数据生成:模拟1000万条卡口过车数据](#3.1 数据生成:模拟1000万条卡口过车数据)
- [3.2 传统方式:单机处理的困境](#3.2 传统方式:单机处理的困境)
- [3.3 分治思想:化整为零](#3.3 分治思想:化整为零)
- [3.4 Map阶段:并行局部统计](#3.4 Map阶段:并行局部统计)
- [3.5 Reduce阶段:全局聚合](#3.5 Reduce阶段:全局聚合)
- 四、MapReduce优缺点分析
- [五、Hadoop 3.1.3 集群搭建完整教程](#五、Hadoop 3.1.3 集群搭建完整教程)
- 六、总结
一、大数据入门:数据怎么存?怎么处理?
在正式学习Hadoop之前,我们先思考两个最核心的问题:
数据量越来越大,数据怎么存?数据怎么处理?
这是大数据技术要解决的两个根本问题。我们来看一下大数据技术栈的全景:
数据存储层
| 技术 | 类型 | 说明 |
|---|---|---|
| HDFS | 分布式存储系统 | Hadoop Distributed File System,Hadoop生态的核心存储 |
| OSS / S3 | 对象存储 | 阿里云/亚马逊的对象存储服务,云上常用 |
| Kafka | 消息队列 | 高吞吐的分布式消息系统,用于实时数据管道 |
数据处理层
| 技术 | 类型 | 说明 |
|---|---|---|
| MapReduce | 分布式计算(批处理) | Hadoop原生计算框架,现在基本被淘汰 |
| Spark | 分布式计算(批/流) | 基于内存计算,Scala/PySpark开发,主流框架 |
| Flink | 分布式计算(流处理) | 真正的流批一体,Scala/PyFlink开发,实时计算首选 |
💡 思考 :MapReduce虽然已经基本被Spark/Flink淘汰,但它的分治思想是所有分布式计算框架的基石。理解了MapReduce,再学Spark和Flink就会非常轻松。
完全分布式 vs 伪分布式
在学习Hadoop集群之前,先搞清楚两个概念:
- 完全分布式:数据真正分布在多台物理机器上,每台机器存储一部分数据,同时有多副本机制保证数据安全。即使某台机器挂了,数据也不会丢。
- 伪分布式 :所有进程都运行在同一台机器上,只是模拟了分布式的运行模式,适合学习和开发测试使用。
二、HDFS架构原理深度解析
HDFS(Hadoop Distributed File System)是Hadoop的分布式文件系统,采用主从架构(Master/Slave)。
HDFS核心组件
下面这张图清晰展示了HDFS的主从架构------客户端上传文件时,先通过NameNode获取DataNode地址,然后将数据切块后直接写入DataNode,副本通过管道复制到其他节点:
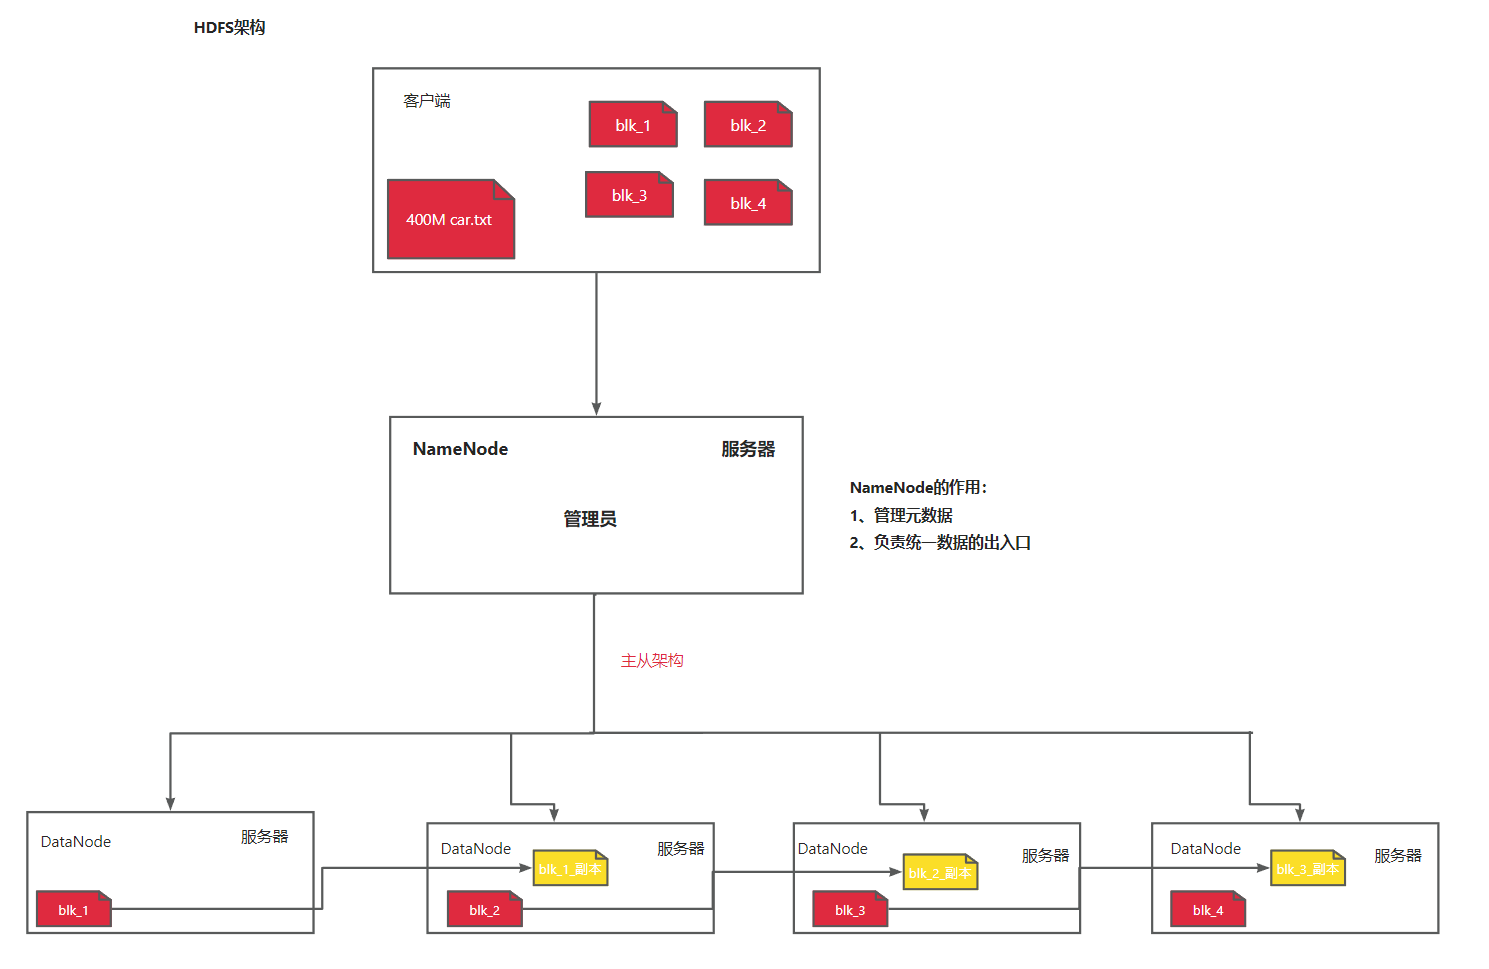
上图展示了一个 400M文件(car.txt) 上传到HDFS的完整过程:
- 客户端将文件切分为 4个block(blk_1 ~ blk_4)
- NameNode(管理员)负责管理元数据、分配存储位置
- 4个 DataNode 各自存储一个主block(红色),同时通过管道复制副本(黄色)到下一个节点
- 形成经典的 主从架构,数据分散存储,多副本保证可靠性
1. NameNode(NN)------ 大管家
NameNode就是Master,是整个HDFS的管理者:
- 管理元数据:文件系统的命名空间(目录树)、文件与数据块的映射关系
- 配置副本策略:决定每个数据块存几个副本、存在哪些节点上
- 管理数据块(block)映射信息:记录每个block存在哪些DataNode上
- 处理客户端的读写请求:客户端要读写数据,先找NameNode要位置信息
⚠️ 注意:NameNode不存实际数据,只存元数据。实际数据存在DataNode上。
2. DataNode(DN)------ 干活的小弟
DataNode就是Slave节点,真正存储数据的地方:
- 存储实际的数据块(block):HDFS默认block大小是128M(Hadoop 2.x以后)
- 执行数据块的读/写操作:客户端直接和DataNode交互读写数据
3. SecondaryNameNode(2NN)------ 助理
SecondaryNameNode不是NameNode的热备,NN挂了它不能马上顶上:
- 辅助NameNode,分担工作量:定期合并Fsimage和Edits文件,推送给NN
- 紧急情况下可辅助恢复NN:但会丢失部分数据
4. Client 客户端
- 文件切分:上传文件时,客户端会将文件切分成一个个block,然后上传
- 与NameNode交互:获取文件的位置信息
- 与DataNode交互:读取或写入数据
- 提供命令管理HDFS :如
hdfs namenode -format(只能执行一次!)
HDFS数据写入流程(以400M文件为例)
假设上传一个400M的文件,block大小为128M:
- 客户端将文件切分成 4个block(blk_1: 128M, blk_2: 128M, blk_3: 128M, blk_4: 16M)
- 客户端向NameNode请求上传文件
- NameNode检查权限、路径是否存在,返回可以上传的DataNode列表
- 客户端将block数据通过**管道(pipeline)**写入DataNode
- 每个block默认存3个副本(副本数可配置),分布在不同节点上
💡 为什么集群一般是奇数台?
这涉及到Hadoop的高可用(HA)机制。NameNode HA使用ZooKeeper进行Active/Standby选举,而ZooKeeper的过半机制要求至少奇数台节点才能正常选举。
三、MapReduce思想:用Python手撕分布式计算
光说不练假把式。下面我们用纯Python代码一步步实现MapReduce的核心思想,让你真正理解"分而治之"的魅力。
🎯 需求:统计1000万条卡口过车数据中,每个城市的车流量。
数据格式(CSV):
车牌号,卡口编号,城市,车辆品牌,道路编号,速度,行驶方向
京M64330,G9832,广州,福特,R487,21,上行
京X15611,G0159,杭州,丰田,R627,115,上行
京N63546,G8214,天津,奔驰,R608,37,下行
3.1 数据生成:模拟1000万条卡口过车数据
首先,我们生成测试数据。代码很简单,就是随机生成各字段:
python
#!/usr/bin/env python
# -*- coding: UTF-8 -*-
"""
使用python代码生成卡口过车数据,保存到 txt 文件中
数据字段:车牌号、卡口编号、城市、车辆品牌、道路编号、车辆速度、行驶方向
"""
import random
import string

# 生成随机车牌号
def generate_plate_number():
    provinces = ["京"]
    letters = string.ascii_uppercase
    numbers = ''.join(random.choices(string.digits, k=5))
    return random.choice(provinces) + random.choice(letters) + numbers

# 生成随机卡口编号
def generate_gateway_id():
    return 'G' + ''.join(random.choices(string.digits, k=4))

# 生成随机城市
def generate_city():
    cities = ["北京", "上海", "广州", "深圳", "杭州", "成都", "武汉", "南京", "重庆", "天津"]
    return random.choice(cities)

# 生成随机车辆品牌
def generate_car_brand():
    brands = ["丰田", "大众", "本田", "宝马", "奔驰", "奥迪", "比亚迪", "特斯拉", "现代", "福特"]
    return random.choice(brands)

# 生成随机道路编号
def generate_road_id():
    return 'R' + ''.join(random.choices(string.digits, k=3))

# 生成随机车辆速度
def generate_speed():
    return random.randint(20, 120)

# 生成随机行驶方向
def generate_travel_direction():
    directions = ["上行", "下行"]
    return random.choice(directions)

# 生成一条记录
def generate_record():
    return f"{generate_plate_number()},{generate_gateway_id()},{generate_city()},{generate_car_brand()},{generate_road_id()},{generate_speed()},{generate_travel_direction()}"

# 批量生成并保存
def generate_and_save_records(file_path, num_records):
    with open(file_path, 'w', encoding='utf-8') as file:
        for _ in range(num_records):
            file.write(generate_record() + "\n")

if __name__ == "__main__":
    file_path = "data/datagateway_records2.txt"
    num_records = 10000000  # 生成1000万条记录
    generate_and_save_records(file_path, num_records)
    print(f"已生成 {num_records} 条卡口过车数据")
📊 1000万条数据大概有 几百MB,足够体现大数据处理的特点了。
3.2 传统方式:单机处理的困境
先来看看传统的单机处理方式------一次性把所有数据读到内存,然后遍历统计:
python
# 统计每个城市的车流量
with open("data/datagateway_records2.txt", mode="r", encoding="utf-8") as file:
    cars = [line.strip() for line in file.readlines()]

# 提取城市字段
citys = [line.split(",")[2] for line in cars]

# 统计数量
city_num = {}
for city in citys:
    if city not in city_num:
        city_num[city] = 1
    else:
        city_num[city] += 1

print(city_num)问题来了:
- ❌ 内存不够:如果数据是100G,你的机器内存只有16G,一次性读取直接OOM(内存溢出)
- ❌ 速度太慢:单线程处理,CPU利用率低
- ❌ 容错性差:处理到一半程序崩了,前面白干
这就是大数据场景下,单机处理的天花板。怎么办?分而治之!
3.3 分治思想:化整为零
核心思路:把一个大文件拆成很多小文件,每个小文件单独处理,最后把结果合并。
这就是MapReduce的精髓------分(Map) + 合(Reduce)。
先来看第一步:拆分大文件。
python
# 体验分而治之 -- 分治
# 将大文件按每10000行拆分成小文件

with open("data/datagateway_records2.txt", mode='r', encoding='utf-8') as f:
    page = 0  # 分割文件的序号
    # 打开第一个分割文件
    split_f = open(f"data/split/part-{page}", mode='w', encoding='utf-8')
    count = 0  # 计数器

    line = f.readline()
    while line:
        count += 1
        split_f.write(line)
        line = f.readline()

        # 每10000行换一个文件
        if count == 10000:
            print(f"已生成:part-{page}")
            count = 0
            page += 1
            split_f.close()
split_f = open(f"data/split/part-{page}", mode='w', encoding='utf-8')拆分效果:
- 1000万条数据 ÷ 10000条/文件 = 1000个小文件
- 文件名:
part-0,part-1,part-2, ...,part-999 - 每个小文件只有几万行,内存完全装得下
💡 在真实的Hadoop中,这个拆分是由HDFS的InputFormat自动完成的,默认按block拆分。每个split对应一个Map任务。
3.4 Map阶段:并行局部统计
文件拆好了,接下来就是Map阶段------对每个小文件独立进行统计。
每个Map任务处理自己的那份数据,产出中间结果(城市 -> 数量):
python
# map阶段:对每个分片文件进行局部统计
# map阶段的输出作为reduce阶段的输入

import os

base_dir = "data/split/"
files = os.listdir(base_dir)

# 循环处理每一个文件(模拟多个Map任务并行执行)
for file in files:
    file_path = base_dir + file

    with open(file_path, mode='r', encoding='utf-8') as f:
        lines = [line.strip() for line in f.readlines()]
        # 提取城市字段
        citys = [line.split(",")[2] for line in lines]
        # 局部统计
        city_num = {}
        for city in citys:
            if city not in city_num:
                city_num[city] = 1
            else:
                city_num[city] += 1

        # 保存Map阶段的输出结果
        with open(f"data/map/{file}", mode='w', encoding='utf-8') as w_f:
            for city, num in city_num.items():
                w_f.write(f"{city},{num}\n")
        print(f"{file_path}: 处理完成!")
Map阶段做了什么?
-
输入:1000个分片文件(每个10000行)
-
处理:每个分片独立统计城市车流量
-
输出:1000个结果文件,每个文件内容类似:
北京,980
上海,1020
广州,995
...
🚀 并行处理 :在真实Hadoop集群中,这1000个Map任务可以同时在不同节点上运行,处理速度大大提升!这就是分布式计算的威力。
3.5 Reduce阶段:全局聚合
Map阶段产出了1000个局部统计结果,最后一步就是Reduce阶段------把所有局部结果合并成最终的全局结果。
python
# reduce阶段:合并所有map阶段的输出,得到最终结果

import os

base_dir = "data/map/"
files = os.listdir(base_dir)

# 最终结果字典
city_num = {}

# 循环读取每一个map输出文件
for file in files:
    file_path = base_dir + file
    with open(file_path, mode="r", encoding="utf-8") as f:
        lines = [line.strip() for line in f.readlines()]
        # 累加每个城市的数量
        for line in lines:
            city = line.split(",")[0]
            num = int(line.split(",")[1])

            if city not in city_num:
                city_num[city] = num
            else:
                city_num[city] += num

# 保存最终结果
with open("data/reduce/part-0", mode="w", encoding="utf-8") as w_f:
    for city, num in city_num.items():
        w_f.write(f"{city},{num}\n")
最终输出 (data/reduce/part-0):
北京,999856
上海,1000234
广州,999789
深圳,1000112
杭州,999654
成都,1000421
武汉,999876
南京,1000098
重庆,999543
天津,1000417
完美!10个城市,每个城市约100万条数据,加起来正好约1000万条。
MapReduce整体流程图
原始大文件(1000万行)
        │
        ▼
   ┌─────────┐
   │  拆分   │  →  1000个分片文件 part-0 ~ part-999
   └─────────┘
        │
        ▼
   ┌─────────┐
   │ Map阶段 │  →  1000个Map任务并行处理,各产出局部统计结果
   └─────────┘
        │
        ▼
   ┌─────────┐
   │  Shuffle │  →  按key分组(相同城市的数据送到同一个Reduce)
   └─────────┘
        │
        ▼
   ┌─────────┐
   │Reduce阶段│  →  合并累加,产出最终结果
   └─────────┘
        │
        ▼
   最终结果文件
💡 Shuffle阶段:上面的Python示例中我们简化了Shuffle过程。真实MapReduce中,Shuffle是Map输出到Reduce输入之间的过程,包括分区、排序、合并等操作,是MapReduce的"心脏"。
四、MapReduce优缺点分析
✅ 优点
- 高可扩展性和分布式处理能力:可以轻松扩展到上千台节点,处理PB级数据
- 高容错性:某个节点挂了,任务会自动迁移到其他节点重试
- 成熟的生态集成:和HDFS、Hive、HBase等无缝集成
- 简单易用的编程模型:开发者只需要写Map和Reduce函数,底层细节由框架处理
- 适合大规模的批量数据:离线批处理的经典方案
❌ 缺点(为什么被淘汰)
- 实时处理能力不足:基于磁盘,延迟高,只能做离线批处理
- 资源利用率低:Map任务全部完成才能开始Reduce,中间有等待
- 编程模型的局限性:只能写Map和Reduce,复杂逻辑(如Join、迭代)实现困难
- 集群管理调度的效率问题:MapReduce 1.x的JobTracker单点瓶颈
🔥 所以现在主流用什么?
- 批处理:Spark(基于内存,比MapReduce快10~100倍)
- 流处理:Flink(真正的流批一体,低延迟、高吞吐)
五、Hadoop 3.1.3 集群搭建完整教程
理论学完了,下面来实操------搭建Hadoop 3.1.3完全分布式集群。
环境准备
- 3台Linux虚拟机(CentOS 7 / Ubuntu均可)
- 主机名:master、node1、node2
- JDK 1.8+(Hadoop运行依赖Java)
- 关闭防火墙、配置主机名映射
步骤1:上传解压 + 配置环境变量
shell
# 上传并解压
tar -xvf hadoop-3.1.3.tar.gz -C /usr/local/soft/

# 配置环境变量
vim /etc/profile

# 添加以下内容:
export HADOOP_HOME=/usr/local/soft/hadoop-3.1.3
export PATH=$PATH:$HADOOP_HOME/sbin:$HADOOP_HOME/bin

# 使配置生效
source /etc/profile

# 验证
hadoop version
步骤2:修改配置文件
需要修改的配置文件都在 $HADOOP_HOME/etc/hadoop/ 目录下:
| 配置文件 | 作用 |
|---|---|
core-site.xml |
核心配置文件 |
hadoop-env.sh |
环境变量(配置JAVA_HOME) |
hdfs-site.xml |
HDFS配置文件 |
yarn-site.xml |
YARN配置文件 |
workers |
子节点列表(Hadoop 3.x以前叫slaves) |
💡 这里列出了需要修改的文件,具体配置内容根据集群情况调整。如果是学习用的伪分布式,配置更简单。
步骤3:初始化HDFS
shell
# 格式化NameNode(只执行一次!执行多次会导致集群ID不一致)
hdfs namenode -format
⚠️ 重要提醒 :
hdfs namenode -format只能在第一次搭建时执行一次!如果反复执行,会导致NameNode和DataNode的clusterID不一致,DataNode启动失败。
步骤4:配置免密登录
Hadoop集群启动时,master需要远程登录到子节点启动进程,所以要配置SSH免密登录:
shell
# 生成密钥(一路回车即可)
ssh-keygen

# 将公钥同步到所有节点(包括自己)
ssh-copy-id master
ssh-copy-id node1
ssh-copy-id node2

# 测试免密登录
ssh node1
步骤5:启动Hadoop集群
shell
# 一键启动HDFS + YARN
start-all.sh

# 查看进程(每个节点上执行)
jps

# master上应该有:NameNode、ResourceManager、SecondaryNameNode
# node上应该有:DataNode、NodeManager
Web UI地址
启动成功后,可以通过Web界面查看集群状态:
| 服务 | 地址 | 说明 |
|---|---|---|
| HDFS UI | http://master:9870/ |
查看HDFS文件系统、DataNode状态 |
| YARN UI | http://master:8088/ |
查看YARN资源、应用程序运行状态 |
注意:Hadoop 3.x的HDFS UI端口是9870 ,Hadoop 2.x是50070,别搞混了!
关闭集群
shell
stop-all.sh六、总结
本文从大数据的两个核心问题出发,系统讲解了Hadoop基础:
- 大数据全景:数据存储(HDFS/OSS/Kafka)+ 数据处理(MapReduce/Spark/Flink)
- HDFS架构:NameNode(管理者)、DataNode(存储)、SecondaryNameNode(辅助)、Client(客户端)
- MapReduce思想:通过Python代码一步步实现了"拆分→Map→Reduce"的完整流程,理解分治思想
- MapReduce优缺点:虽然被淘汰,但思想是分布式计算的基石
- Hadoop 3.1.3搭建:从解压配置到启动集群的完整步骤
🎯 学习建议:先理解MapReduce的思想(分而治之),再学Spark/Flink会事半功倍。因为Spark的RDD、Flink的DataSet/DataStream,本质上都是对MapReduce模型的优化和扩展。