✍✍计算机毕设指导师**
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
⚡⚡有什么问题可以在主页上或文末下联系咨询博客~~
⚡⚡Java、Python、小程序、大数据实战项目集](https://blog.csdn.net/2301_80395604/category_12487856.html)
⚡⚡文末获取源码
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
Steam游戏平台市场与玩家行为数据分析系统-简介
本系统基于Python语言开发,底层依托Hadoop与Spark大数据框架,构建了一个完整的Steam游戏平台市场与玩家行为数据分析平台。后端采用Django框架提供接口服务,数据存储使用MySQL,前端结合Vue与Echarts实现数据可视化展示。系统主要针对Steam平台的游戏数据和玩家评价数据进行多维度的剖析。在市场分析层面,涵盖了游戏类型分布、价格结构、发行趋势以及平台支持情况,帮助用户了解当前游戏市场的整体格局。在玩家行为与反馈分析方面,系统通过统计游玩时长、并发峰值和评价规模,结合TF-IDF算法提取评价文本中的核心热词,并利用情感词典对玩家评价进行正负面打分分类。为了进一步发现数据内在关联,系统引入了FP-Growth算法挖掘游戏标签之间的共现关联规则,同时运用K-Means算法对游戏进行聚类分析,根据好评率、在线峰值和游玩时长等指标将游戏划分为不同群体。整个数据处理流程借助Pandas和NumPy进行清洗与标准化,Spark SQL用于复杂指标的聚合计算,最终将计算结果输出至数据库并通过图表直观呈现,为理解游戏市场规律和玩家偏好提供了一套实用的数据工具。
Steam游戏平台市场与玩家行为数据分析系统-技术
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
数据库:MySQL
Steam游戏平台市场与玩家行为数据分析系统-背景
随着Steam作为主流PC游戏平台的不断发展,平台上积累了海量的游戏属性信息和玩家评价数据,这些数据背后其实藏着玩家的真实喜好和市场的走向趋势。过去大家看一款游戏到底火不火、好不好,多半凭感觉或者只看个总评数,不太清楚具体哪些标签更吸引人,或者玩家评论里最关心的痛点是什么。现在单平台上的游戏数量越来越庞大,光靠人工去翻看评论和对比价格、平台支持这些信息,效率太低也看不过来。大数据技术刚好能解决这种海量数据处理慢、分析不到位的问题,把Hadoop和Spark这些工具用在游戏数据分析上是顺理成章的事情。做这个课题也是想试着用平时学到的大数据处理方法,去实际跑一遍真实的游戏平台数据,看看能不能把那些散乱的文本和数值整理得明明白白,找出点有用的规律,也算是对大学几年学的东西做个检验。
这个课题的实际意义其实挺接地气的。一方面,它能把复杂的游戏数据拆解成直观的图表,比如通过标签关联规则能看出玩家更喜欢什么类型的玩法组合,通过情感分析能知道大家对游戏不满的点主要集中在哪,这对以后想从事游戏运营或者市场分析的同学来说,算是个不错的参考案例。另一方面,从做毕业设计的角度看,它把Hadoop、Spark这些大数据框架和Python的机器学习算法(像K-Means、TF-IDF)串起来跑了一遍,是个比较完整的数据处理练习。虽然系统功能肯定比不上企业级的专业数据分析平台,处理的数据量也有局限,但对于巩固大数据开发流程和锻炼动手能力还是有实在帮助的,做出来的东西也能当个简单的数据看板用,不至于太虚。
Steam游戏平台市场与玩家行为数据分析系统-视频展示
Hadoop的Steam游戏平台市场与玩家行为数据分析系统
Steam游戏平台市场与玩家行为数据分析系统-图片展示
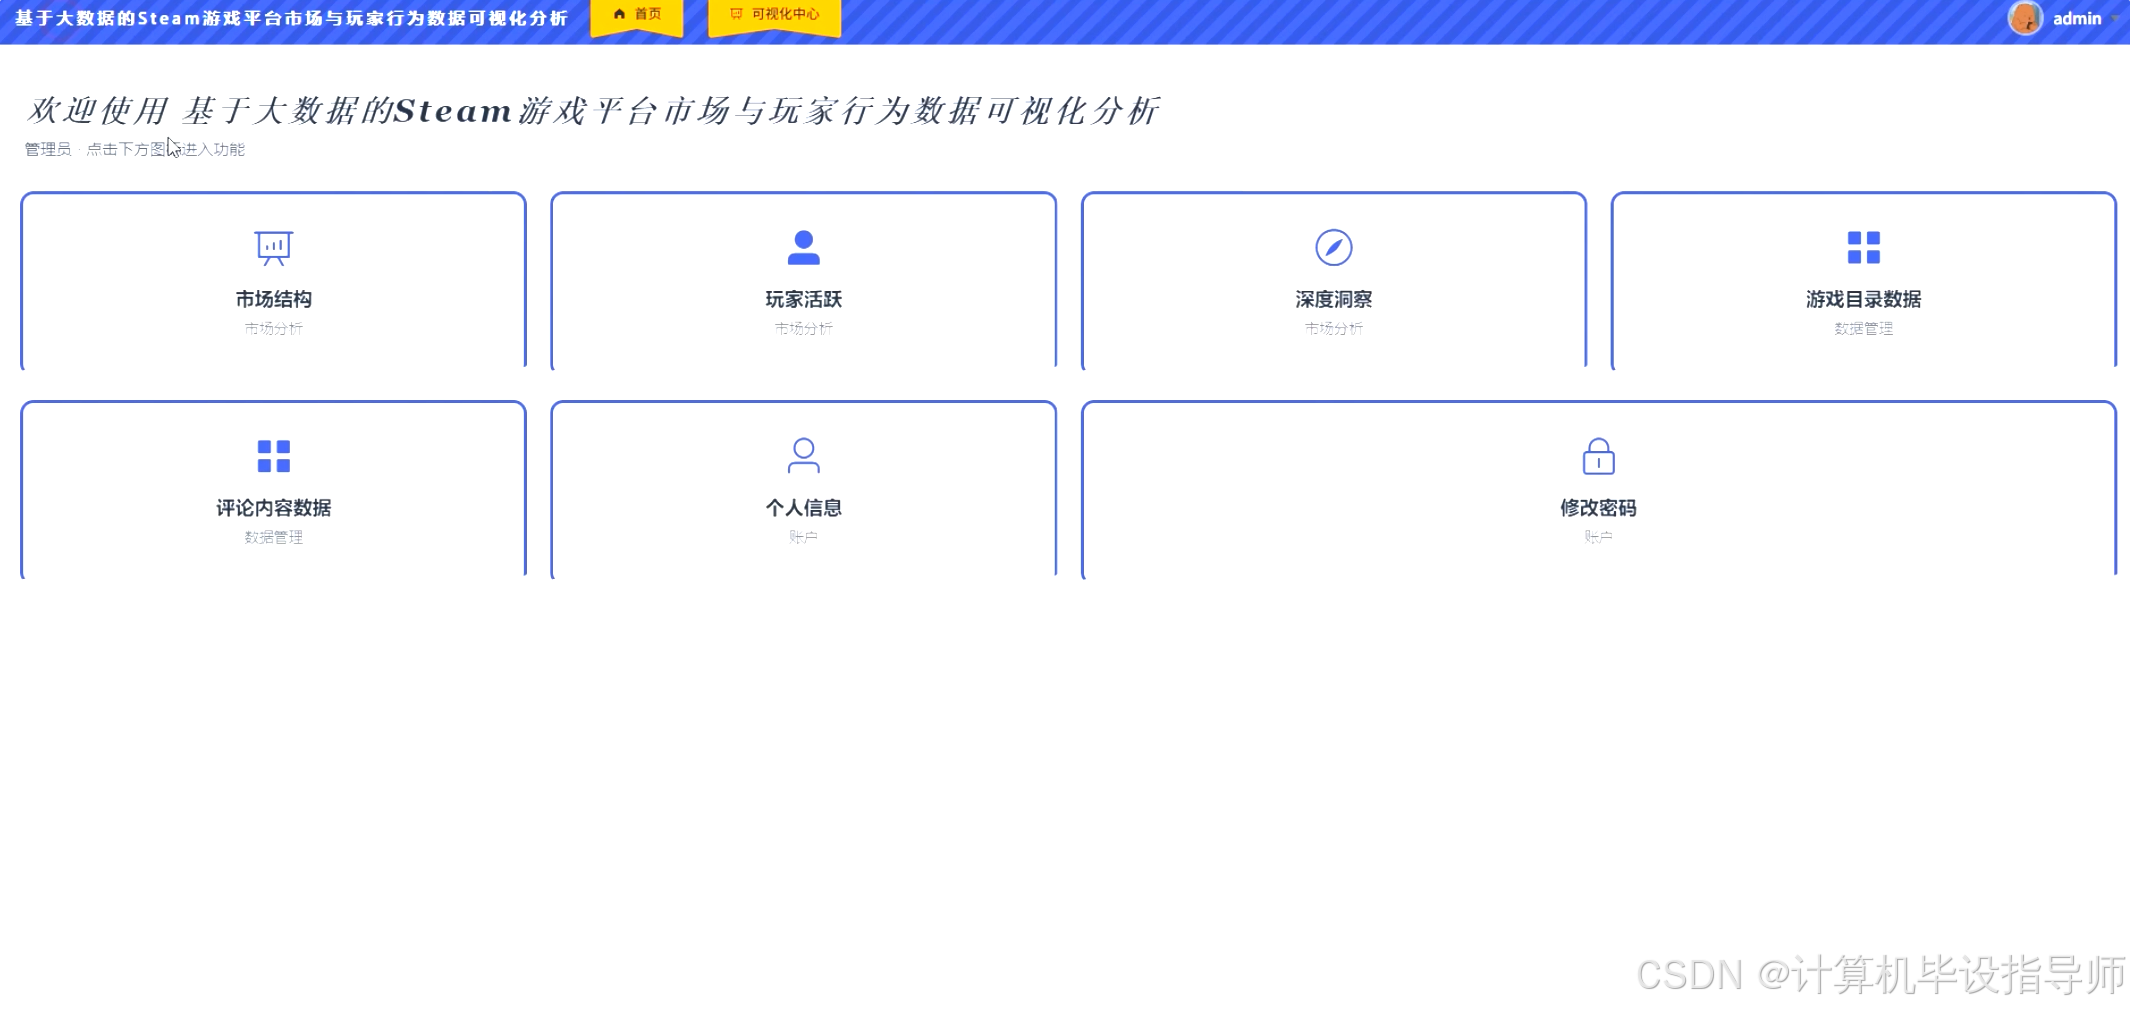
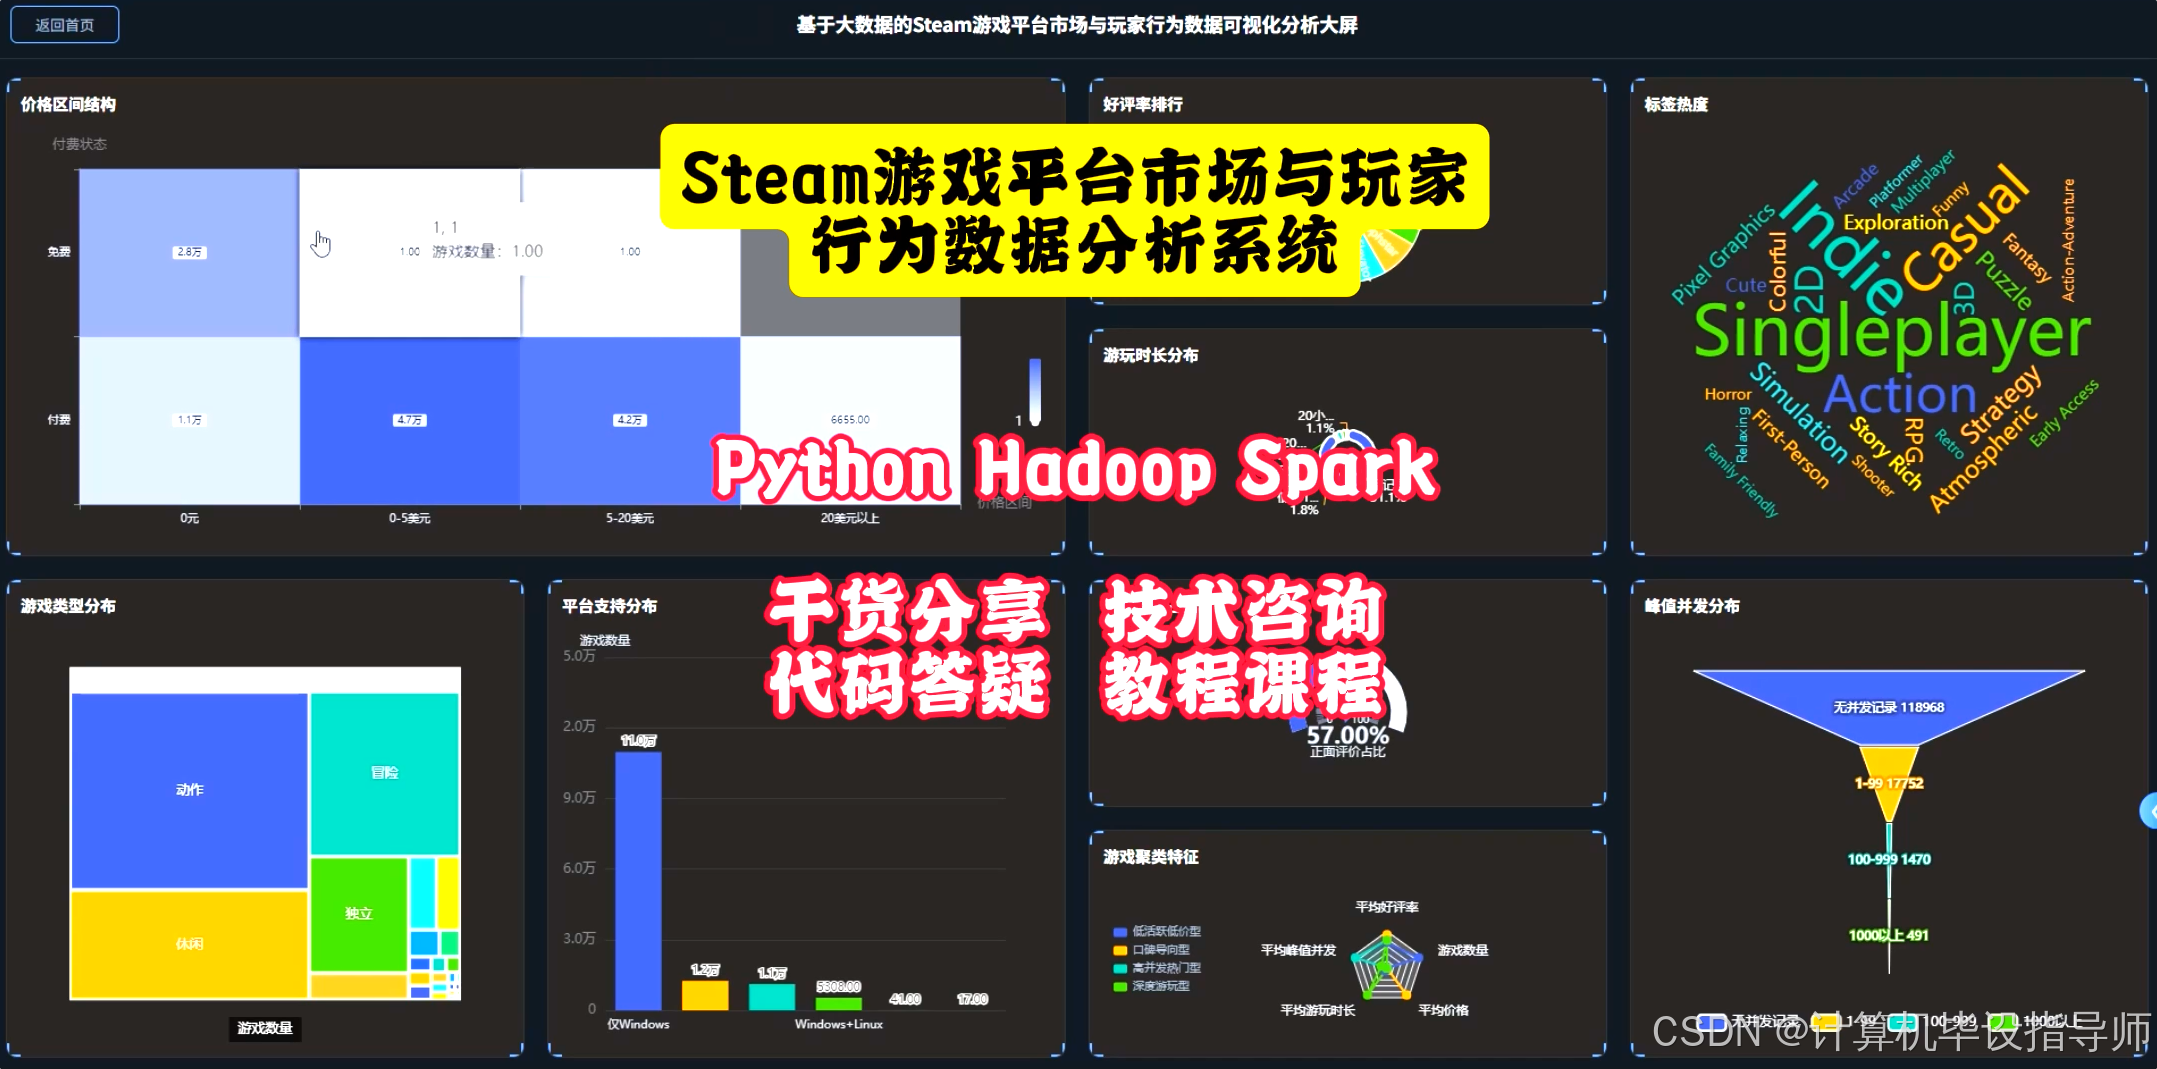
Steam游戏平台市场与玩家行为数据分析系统-代码展示
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, length, udf
from pyspark.sql.types import ArrayType, StringType, MapType
from pyspark.ml.feature import VectorAssembler, StandardScaler, Tokenizer, HashingTF, IDF
from pyspark.ml.clustering import KMeans
from pyspark.ml.fpm import FPGrowth
import numpy as np
spark = SparkSession.builder.appName("SteamGameAnalysisSystem").config("spark.sql.shuffle.partitions", "4").config("spark.driver.memory", "2g").getOrCreate()
def process_game_clustering(df_games):
    feature_cols = ["positive", "negative", "peak_ccu", "average_playtime_forever", "dlc_count", "price"]
    df_clean = df_games.na.drop(subset=feature_cols)
    assembler = VectorAssembler(inputCols=feature_cols, outputCol="features_raw")
    df_assembled = assembler.transform(df_clean)
    scaler = StandardScaler(inputCol="features_raw", outputCol="features", withMean=True, withStd=True)
    scaler_model = scaler.fit(df_assembled)
    df_scaled = scaler_model.transform(df_assembled)
    kmeans = KMeans(k=4, featuresCol="features", predictionCol="cluster_id", seed=42)
    model = kmeans.fit(df_scaled)
    df_clustered = model.transform(df_scaled)
    pandas_df = df_clustered.select("app_id", "name", "cluster_id").toPandas()
    return pandas_df.to_dict('records')
def process_tag_association(df_games):
    df_tags = df_games.filter(col("tags").isNotNull() & (col("tags") != "[]"))
    parse_udf = udf(lambda x: x.strip("[]").replace("'", "").split(", "), ArrayType(StringType()))
    df_items = df_tags.withColumn("tag_array", parse_udf(col("tags"))).select(col("app_id").alias("id"), col("tag_array").alias("items"))
    fpGrowth = FPGrowth(itemsCol="items", minSupport=0.05, minConfidence=0.3)
    model = fpGrowth.fit(df_items)
    df_rules = model.associationRules
    pandas_rules = df_rules.toPandas()
    result = []
    for index, row in pandas_rules.iterrows():
        result.append({
            "antecedent": list(row['antecedent']),
            "consequent": list(row['consequent']),
            "confidence": float(row['confidence'])
        })
    return result
def process_review_tfidf(df_reviews):
    df_text = df_reviews.filter(col("reviews").isNotNull() & (length(col("reviews")) > 5))
    tokenizer = Tokenizer(inputCol="reviews", outputCol="words")
    df_words = tokenizer.transform(df_text)
    hashingTF = HashingTF(inputCol="words", outputCol="rawFeatures", numFeatures=10000)
    df_tf = hashingTF.transform(df_words)
    idf = IDF(inputCol="rawFeatures", outputCol="features")
    idf_model = idf.fit(df_tf)
    df_tfidf = idf_model.transform(df_tf)
    def extract_top_terms(vec):
        indices = vec.indices
        values = vec.values
        if len(indices) == 0:
            return {}
        sorted_idx = np.argsort(values)[-30:]
        return {int(indices[i]): float(values[i]) for i in sorted_idx}
    extract_udf = udf(extract_top_terms, MapType())
    df_top = df_tfidf.withColumn("top_terms", extract_udf(col("features")))
    pandas_top = df_top.select("top_terms").limit(100).toPandas()
    return pandas_top.to_dict('records')
Steam游戏平台市场与玩家行为数据分析系统-结语
做计算机毕设卡壳的同学,欢迎去主页找UP主交流沟通,主页有更多详细的大数据项目资料。如果觉得这个基于Hadoop的Steam数据分析系统对你有启发,记得一键三连支持一下!大家在评论区聊聊你们毕设都选了啥题目,遇到啥坑了,UP主看到都会尽量回复解答的,一起顺利通关毕业设计!
实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
如果遇到具体的技术问题或其他需求,你也可以问我,我会尽力帮你分析和解决问题所在,支持我记得一键三连,再点个关注,学习不迷路!~~