作者:来自 Elastic Luca Wintergerst
在数据现有的存储位置构建和观测 AI agent。从 Elastic Agent Builder 开始。你也可以立即开始**免费云试用,或在你的 本地计算机**上试用 Elastic。
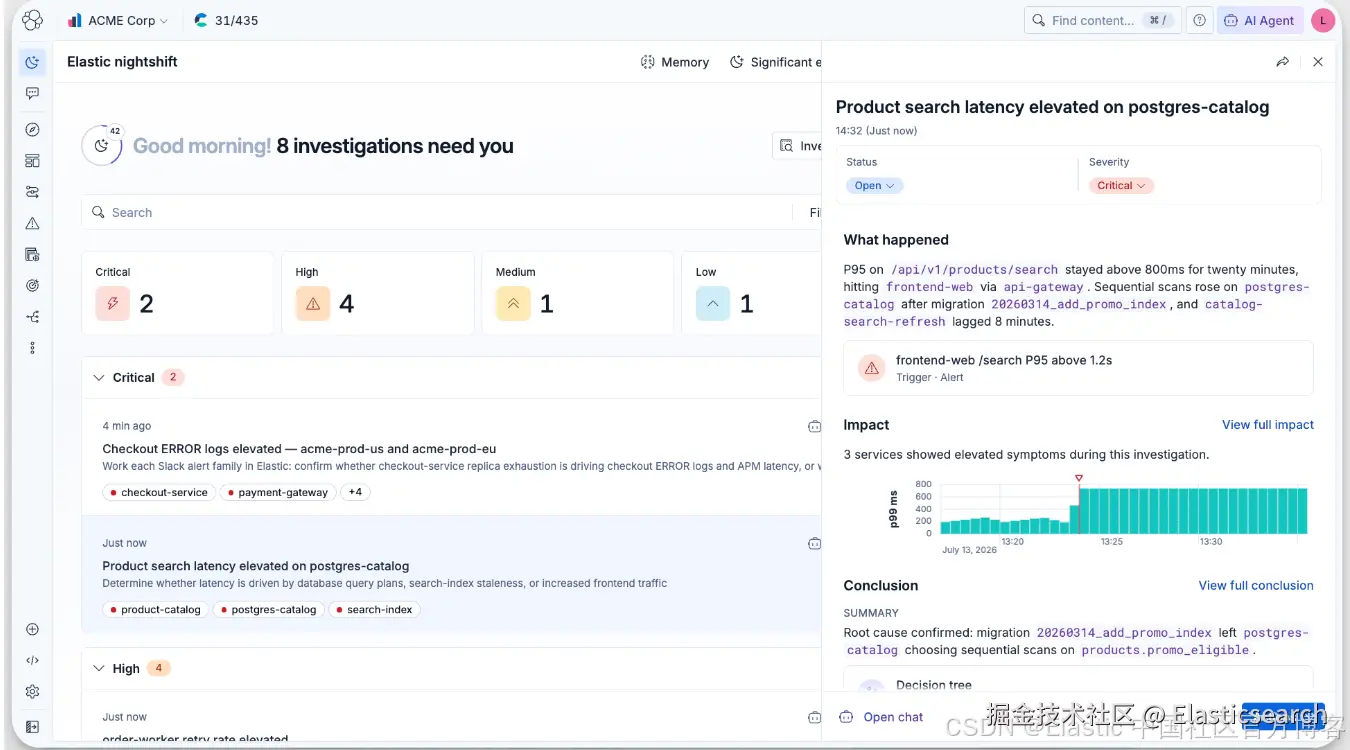
今天,我们宣布推出 Elastic® nightshift AI SRE 的 Private Preview。它内置于 Elastic Observability 中,能够与你的团队并肩工作,发现、调查并解决生产环境中的问题。在推广期内,Serverless 上的 Private Preview 免费提供。点击此处加入候补名单 →
生产环境的变化速度已经超过了监控工具的跟进速度。团队以前所未有的速度交付软件,其中越来越多的代码由 AI 编写。然而,保持生产环境健康仍然是一项需要人工完成的工作。有人必须编写能够捕获问题的告警规则,弄清楚每条告警触发的原因,然后应用修复方案。他们需要了解的许多信息,只存在于少数工程师的头脑中。每次发布都会改变需要监控的内容,而这项工作已经成为瓶颈。
Elastic nightshift AI SRE 与你的团队并肩工作,全面掌握你的系统上下文。它全天候监控你的遥测数据,并检测各种问题,包括没有任何告警规则能够覆盖的未知问题。它会像经验丰富的站点可靠性工程师(SRE)一样调查故障事件,针对你的遥测数据(例如日志、指标、trace 和性能分析数据)验证假设,排除无效的调查方向,并提供根因证据。随后,它会推荐修复方案来解决问题,并在你需要时自动应用该方案。
在每个步骤中,它都会使用与你的数据和系统最相关的上下文。这些上下文基于你的遥测数据、代码、运维手册等内容构建。它会主动从你的数据、以往的故障事件以及企业知识中学习。而且,与你和你的团队一样,每当它检测到故障事件或调查一条告警时,其调查准确性都会不断提高。此外,你可以通过 Kibana UI、终端、你选择的 agent,或其他任何你工作的地方与它协作。
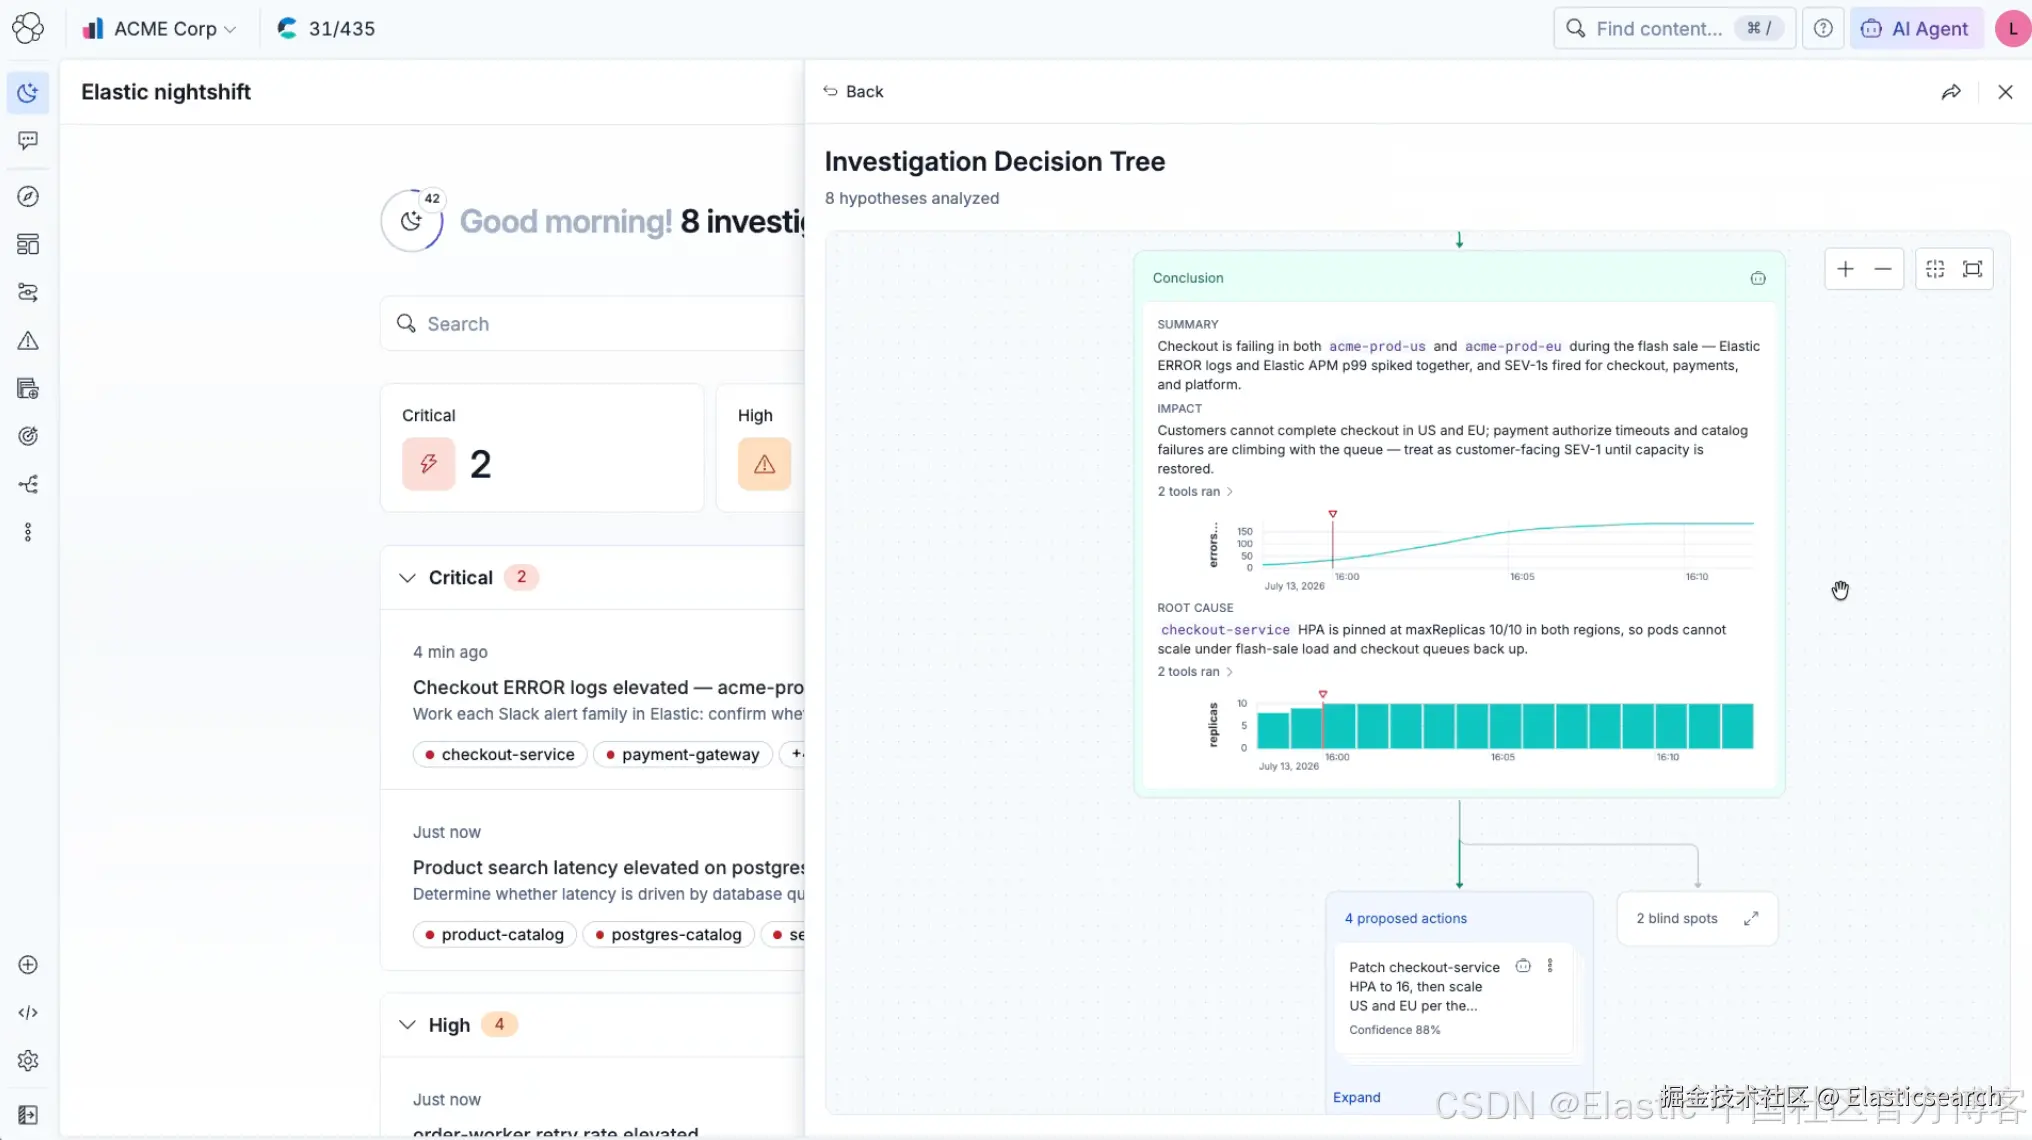
在构建这个系统时,赢得你的信任对我们来说至关重要。如果你已经使用 大语言模型 (LLM)一段时间,就会知道其中一些模型往往表现得过于自信。使用 Elastic nightshift AI SRE 时,你不只是获得结论,还可以查看 agent 为得出结论所执行的每一个步骤,并在需要时深入查看原始数据,如下方动画所示。你可以**点击此处**查看本文的交互版本。
 Elastic nightshift SRE www.bilibili.com/video/BV1KG...
Elastic nightshift AI SRE 的工作原理
Elastic nightshift 由四个协同工作的引擎组成(你也可以单独使用它们):Context、Detection、Investigation 和 Remediation。例如,你可以让它调查现有监控工具发出的告警,而无需启用 Detection。
| 引擎 | 功能 | 触发条件 | 你将获得什么 |
|---|---|---|---|
| Context(上下文) | 根据遥测数据、代码、运维手册和 Wiki 构建有关你所处环境的知识 | 从获得访问数据和系统的权限后,就会持续运行 | 实体、关系,以及关于以往故障事件的长期记忆,供其他三个引擎使用 |
| Detection(检测) | 持续评估遥测数据,标记需要关注的问题,无需编写或维护告警规则 | 在为 Serverless 中的数据完成配置后,始终保持运行 | 将跨服务的相关信号归并为一个重要事件,并指出受影响的系统部分 |
| Investigation(调查) | 并行验证针对日志、指标、trace 和性能分析数据提出的假设,区分症状与根因 | 任何告警,无论是在 Elastic 中触发,还是由已连接的工具触发;也可以选择由重要事件触发 | 使用通俗语言描述的根因、受影响的服务、建议采取的操作,以及无法验证的信息盲区 |
| Remediation(修复) | 选择一个 workflow 或 connector 操作,并填入适用于当前故障事件的参数,或者提供可供你运行的命令 | 调查完成后 | 提供一个供你审核后再执行的修复方案(也可以根据你的选择自动应用) |
!\[\](https://i-blog.csdnimg.cn/direct/c9696f33580f44029dbf96a483e2dc78.png) 来自任何地方的遥测数据和告警,用于检测和调查。
最重要的是,你无需迁移数据就能使用它。这些 agent 运行在 Elastic Observability Serverless 上,并连接到遥测数据和告警现有的存储系统中。预计在今年晚些时候推出技术预览版时,它将支持:
-
Elastic Observability Serverless 中的数据(是否向其中发送数据由你决定)。
-
Elastic Cloud Hosted(ECH)部署。
-
自行管理的集群(前提是 Elasticsearch 端点已正确开放)。
-
主流第三方可观测性工具。
-
主流遥测数据存储系统和数据库。
加入候补名单时,请告诉我们你最希望支持哪些第三方工具、遥测数据存储系统和数据库,以便我们据此确定优先级。此外,我们也正在制定计划,以便在自管理环境中部署所有这些功能。今年晚些时候,我们会分享更多信息。
Context Engine:让 AI SRE 了解你的系统
当一位经验丰富的 SRE 加入一个新团队时,他会带来自己的技能,却不会自动了解这个团队的系统。他们需要花费数周时间学习系统架构、运维手册和以往故障事件的历史,还要了解哪些服务总是频繁产生告警或噪声。让 SRE 能够快速开展工作的关键在于两者的结合:多年的经验,以及对所负责系统的深入了解。
AI agent 也是如此。LLM 能够带来一定的经验,却不了解你的系统。缺少上下文时,agent 必须花费时间和 token 弄清楚各个部分如何相互关联,然后才能着手解决实际问题。
Context Engine 会在故障事件发生之前,为 Elastic nightshift 提供这些知识。它是将整个系统连接起来的上下文层。
统一单复数指代和 SRE 表述明确技术预览版支持范围的主语
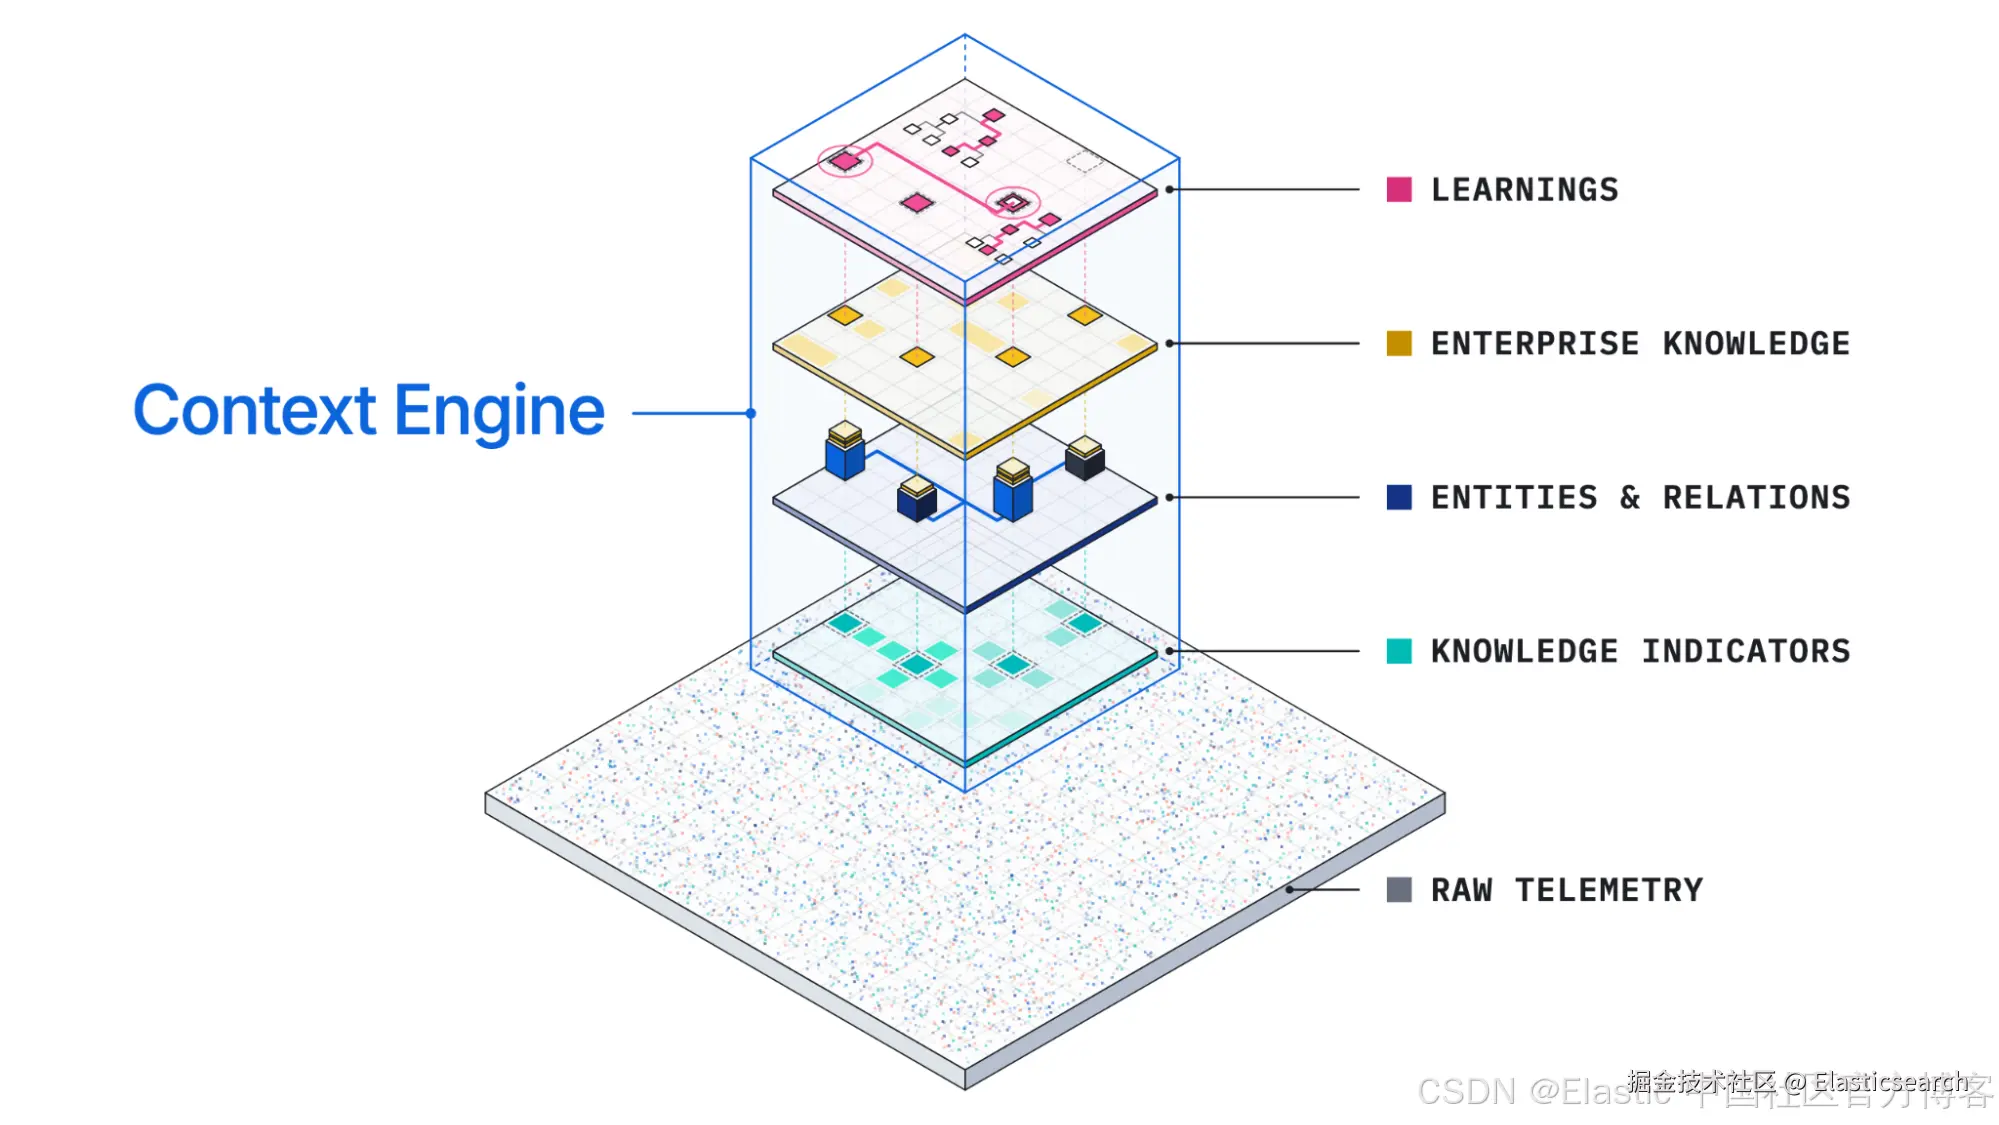
Context Engine 通过三种方式构建知识:
-
提前构建。 一旦获得访问你的数据和系统的权限,它就会从遥测数据中提取知识,包括你所处环境中的实体(例如服务和主机)以及它们之间的关系。它还可以从 GitHub 等系统中读取你的 Wiki、运维手册和代码。
-
从自身工作中学习。 每次调查和检测都会丰富它的长期记忆,记录发生了什么以及什么措施解决了问题。
-
从你的交互和输入中学习。 你可以针对检测结果提供反馈,也可以向它提供事后分析文档。你还可以手动上传重要信息。
记住这些事实,与前文所述的调查能力提升有所不同。Context Engine 记住的是你的环境中哪些情况属实,而 Investigation Engine 则不断改进调查问题的方式。
Elastic 能够高效地存储遥测数据,因此你可以保留未经采样的数据,而 agent 可以搜索整个数据保留期内的所有数据。由于这些遥测数据及其构建的知识都与 agent 一起存储在 Elastic 上,因此 agent 可以回溯到其结论背后的原始数据。
Investigation Engine:基于任何告警进行 AI 根因分析
告警不断堆积,而每一条重要告警最终仍然需要由工程师处理。他们必须手动梳理日志、指标、trace 和近期变更,之后才能考虑修复方案。
你的新 AI SRE 同事会通过 Investigation Engine 承担这项工作。无论告警是在 Elastic 中触发,还是由你已连接的其他工具触发,都可以自动启动调查。接下来,它会像一名优秀的值班工程师一样开展工作:
-
检查发生了哪些变更。
-
针对故障原因提出假设。
-
使用日志、指标、trace 和性能分析数据并行验证这些假设。
-
跟进有证据支持的线索,舍弃缺乏证据支持的线索。
-
区分症状与根因。
-
逐步确定最有可能的根因。
-
提出修复方案。
我们的 Investigation Engine 的核心逻辑源自 Elastic 收购的 Deductive AI,并在 Deductive 多年来 自动化 调查故障事件的三年研究成果基础上进一步发展。
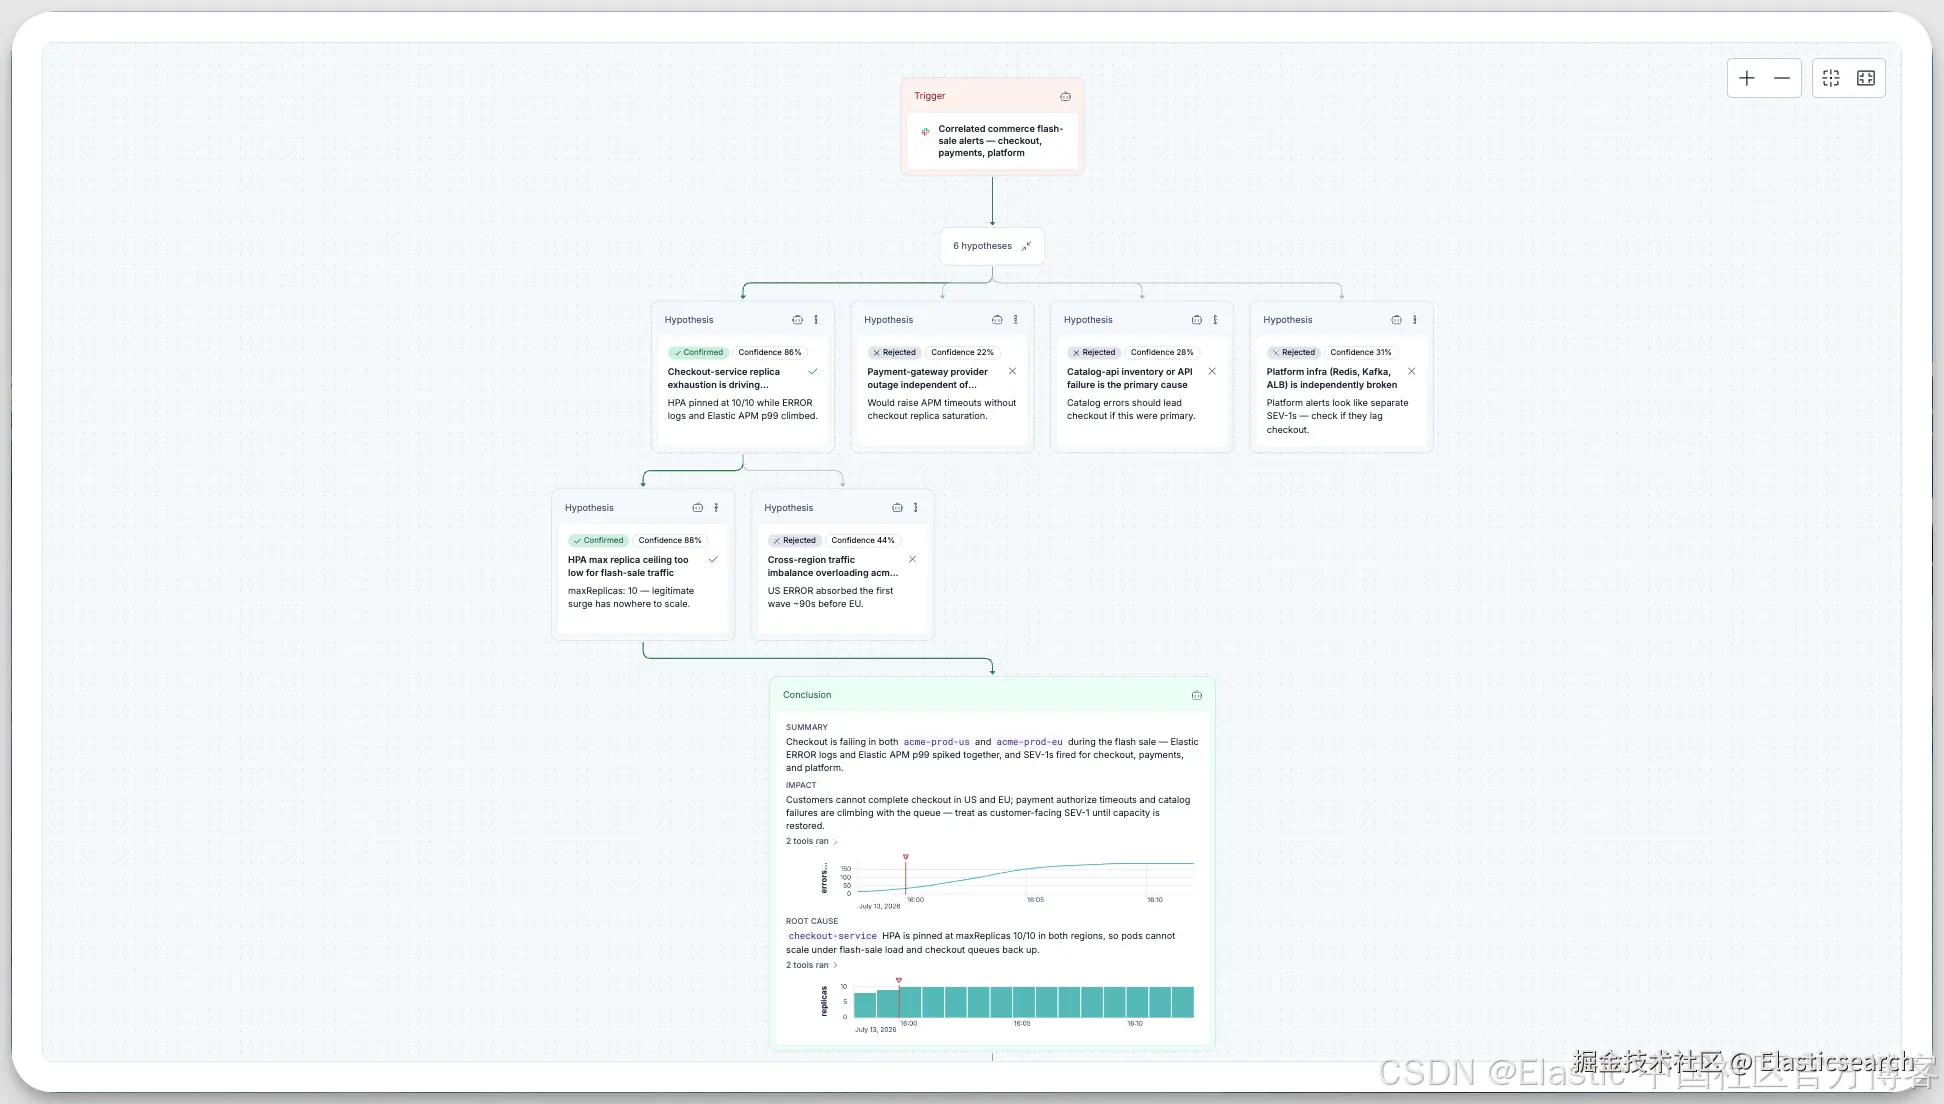 一次调查会评估多个假设,逐步锁定根因。
nightshift agent 会规划一个步骤,并调用工具来执行该步骤。它会观察返回的结果,并在继续下一步之前,根据证据核验自己的结论。在多次调查过程中,它会逐渐学会哪些路径能够找到有用的证据并取得成功,因此每经历一次故障事件,它的调查能力都会有所提升。
前面我们谈到过,使用 agentic 系统时,建立信任非常重要,而这就是赢得你信任的一个例子。你可以展开调查中的任意步骤,查看背后的推理过程以及 agent 执行的查询。你还可以查看这些查询所针对的原始数据。
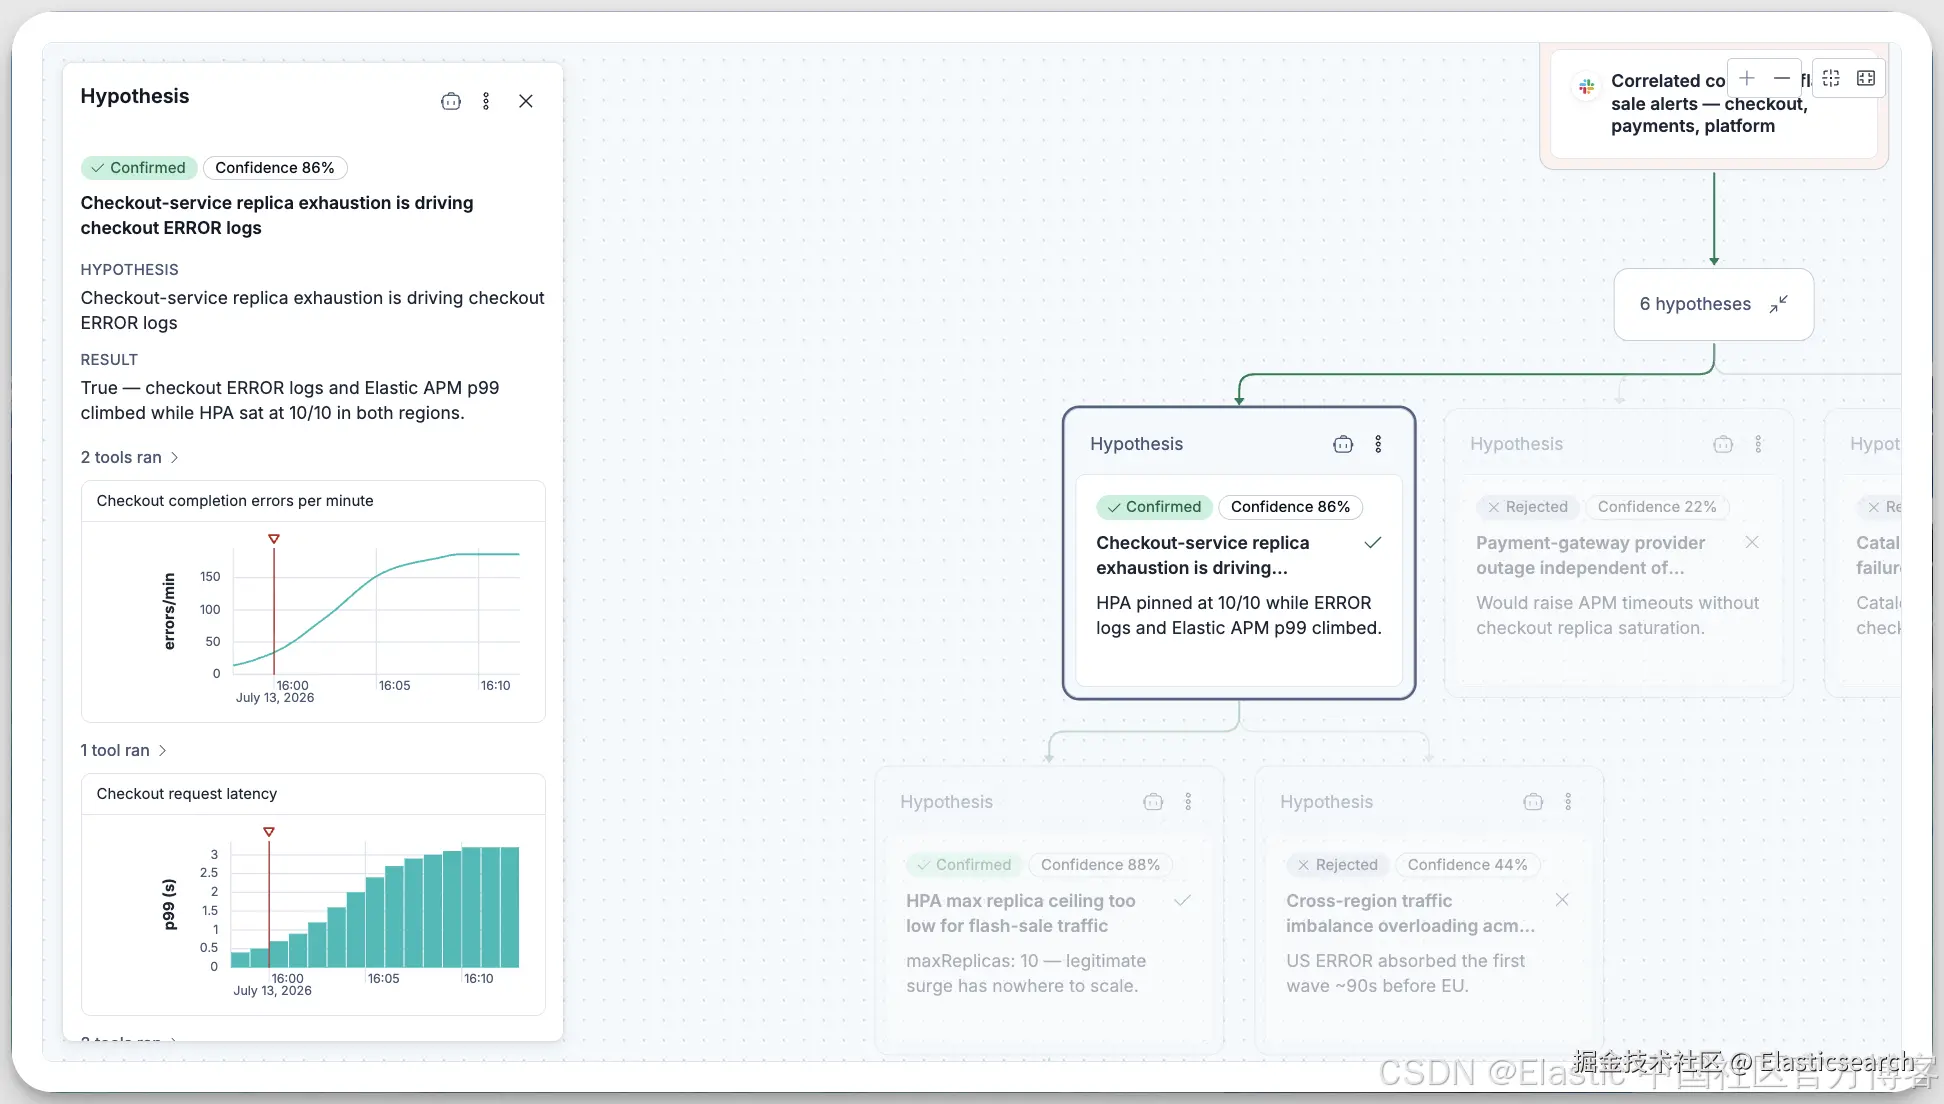 检查调查过程中的证据。
调查完成后,你将获得:
-
结论。 用通俗易懂的语言说明根因,以及我们建议立即采取的修复措施。
-
影响范围。 哪些服务受到影响,以及每个服务存在多少个问题。
-
建议操作。 后续步骤,每项操作都需要等待你审核。
-
信息盲区。 agent 无法验证的内容,让你清楚了解其结论的可信范围。
Detection Engine:如何捕获没有告警规则的故障事件?
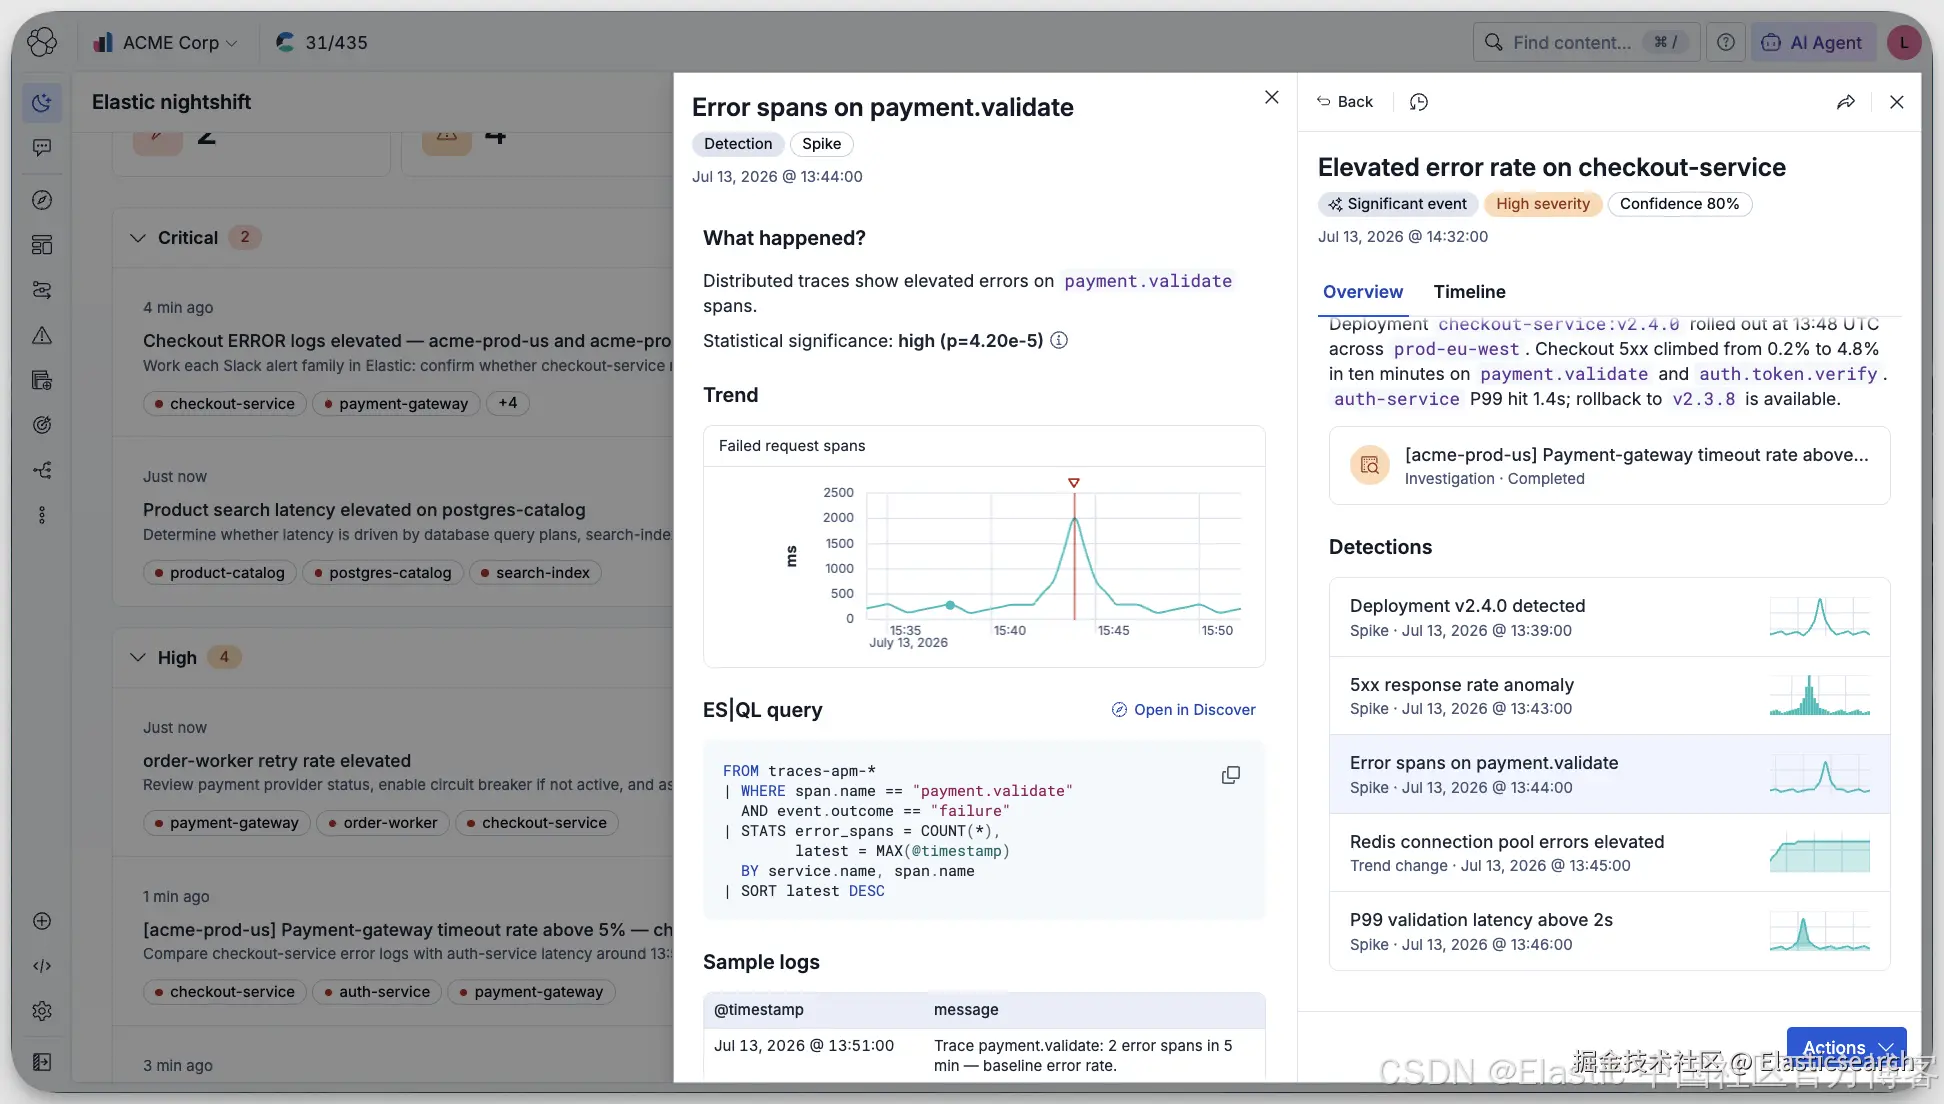
最棘手的故障事件往往是那些从未触发过告警的事件。因此,服务性能逐渐下降,用户开始察觉异常,而监控系统却始终没有动静。对于尚未设想过的故障,没有人能够提前编写相应的告警规则;即使告警确实触发了,相关信号也可能散落在多个服务中,每个服务都单独发出告警。
你的新同事也会通过 Detection Engine 承担这项工作。它会持续评估你的遥测数据,并标记需要关注的问题。你无需编写或维护任何告警规则。当多个服务中出现相关信号时,它会将这些信号归并为一个重要事件,并展示背后的相关信号以及受到影响的系统部分。如果你愿意,还可以设置为由重要事件自动启动调查,这样等到有人查看时,调查就已经开始了。
Remediation Engine:根据诊断结果自动修复
过去,可观测性通常止步于诊断阶段。它可以告诉你出了什么问题,最终也能说明问题的原因,但修复工作仍然需要你自己完成。运维手册自动化只能重复执行别人预先编写好的修复操作,而实际发生的故障事件很少会完全按照脚本设定的流程发展。
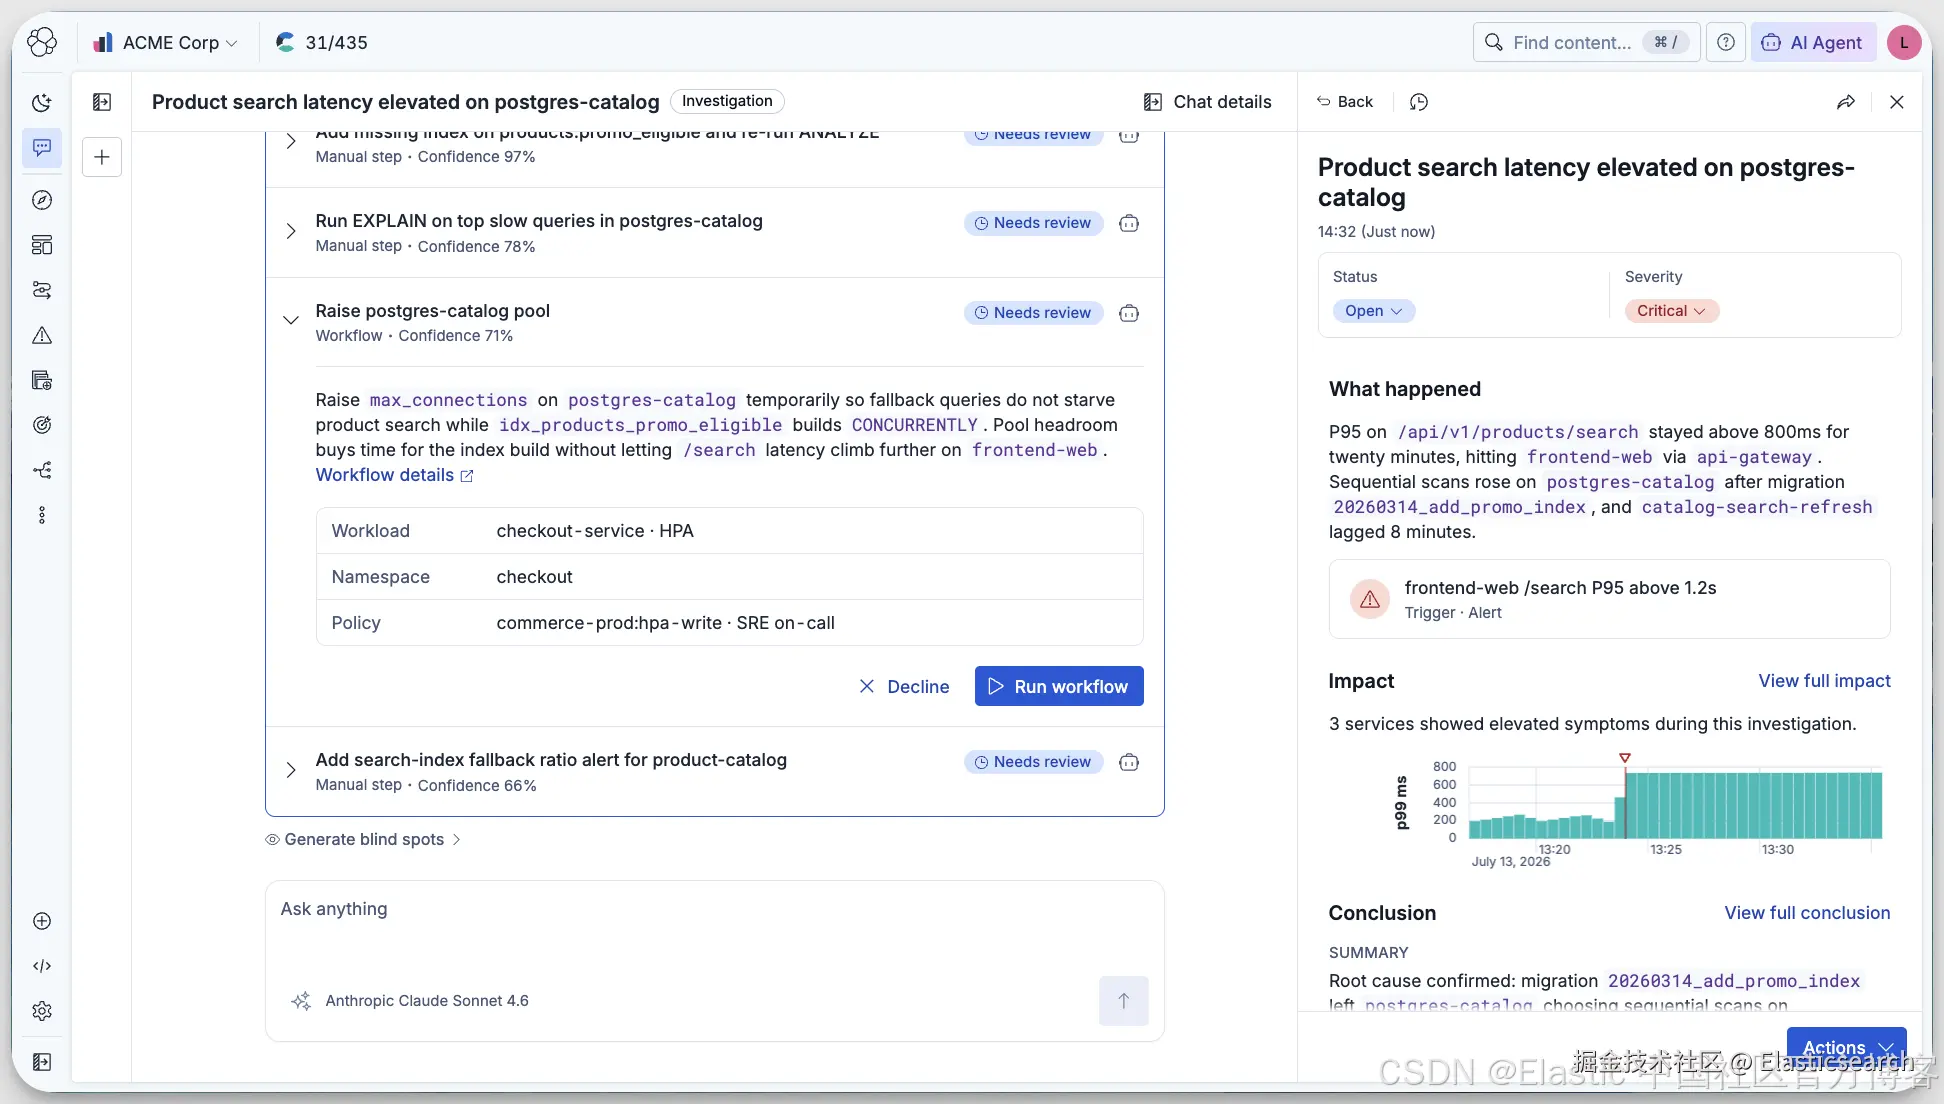
你的这位新同事也会通过 Remediation Engine 承担这项工作,并推荐修复方案。它可以从你在 Elastic Workflows 中已有的 workflow 或 connector 操作中选择一项,并填入适用于当前故障事件的参数;也可以提供命令或操作说明,供你复制到终端或编程 agent 中执行。
与运维手册脚本不同,这些操作及其参数是根据当前故障事件的诊断结果生成的。你可以决定让它自主完成多少工作:在执行之前审核每项操作及其所选参数,也可以允许它自动应用修复方案。
在 Kibana、终端或 Slack 中使用 AI SRE
Kibana 始终是 Elastic nightshift 的核心使用入口,我们也会持续优化使用体验。Elastic nightshift 主页会按照严重程度列出团队尚未解决和近期的调查,让值班人员能够一目了然地了解哪些问题需要关注,以及哪些问题已经处理完毕。
不过,越来越多的工程师希望直接通过自己日常使用的工具来使用我们的产品,例如终端、编程 agent 或聊天频道。我们也正在积极拥抱这一趋势:
-
Elastic CLI。 你将能够从终端或 Claude、Cursor、Codex 等编程 agent 中接手一项调查,并继续处理后续工作。如果使用 Model Context Protocol(MCP)连接 agent 更简单,你也可以选择这种方式。
-
Slack。 我们正在构建 Slack 集成,让 Elastic nightshift 像一位同事一样融入你的频道。它会在团队日常交流的地方发布已完成的调查结果,并回答相关问题。更重要的是,它会从 Slack 中的每次交互中学习。你可以补充上下文来引导它继续调查,也可以在 Slack 讨论串中发布根因分析或事后分析文档,从而自动触发学习循环。它会利用所有这些信息不断改进,以便更好地应对下一次故障事件。
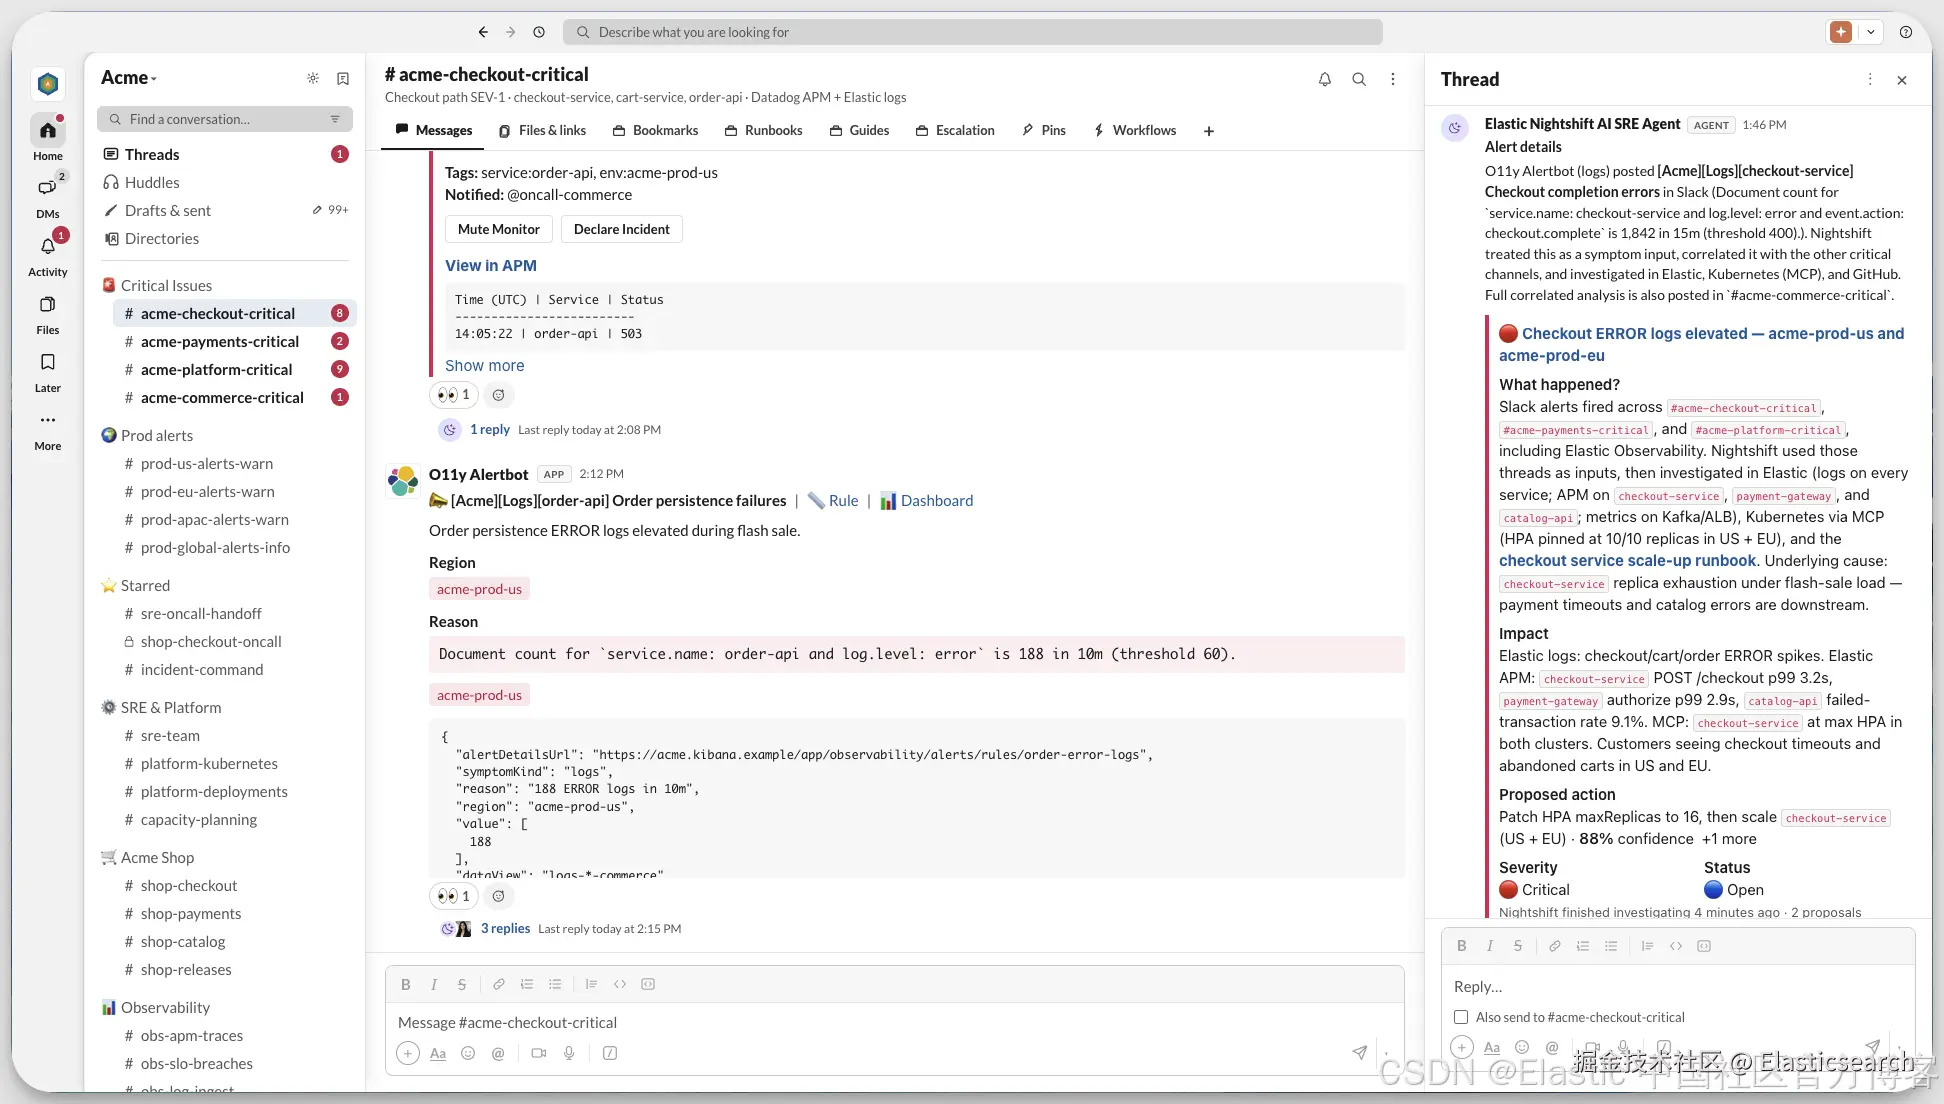 Elastic nightshift 在 Slack 中响应,关联告警并自动开展调查。
加入 AI SRE Private Preview 候补名单
Elastic 自己的 SRE 团队已经在生产环境中使用 Elastic nightshift,而团队成员在使用过程中积累的经验会直接反馈到产品中。通过 Private Preview,我们将向更多团队开放这一产品。
-
谁可以加入: 现有 Elastic 用户,在早期访问期间免费使用。
-
包含哪些内容: 预览上述四个引擎的功能,并且每周都会推出更多能力。
-
我们希望你做什么: 提供真实、坦诚的反馈。我们将与参与预览的团队直接合作,你提供的反馈将影响我们接下来的开发方向。
-
后续计划: 预计今年晚些时候在 Elastic Cloud Serverless 上推出技术预览版。
原文:AI SRE: How Elastic nightshift detects and fixes incidents | Elastic Observability Labs