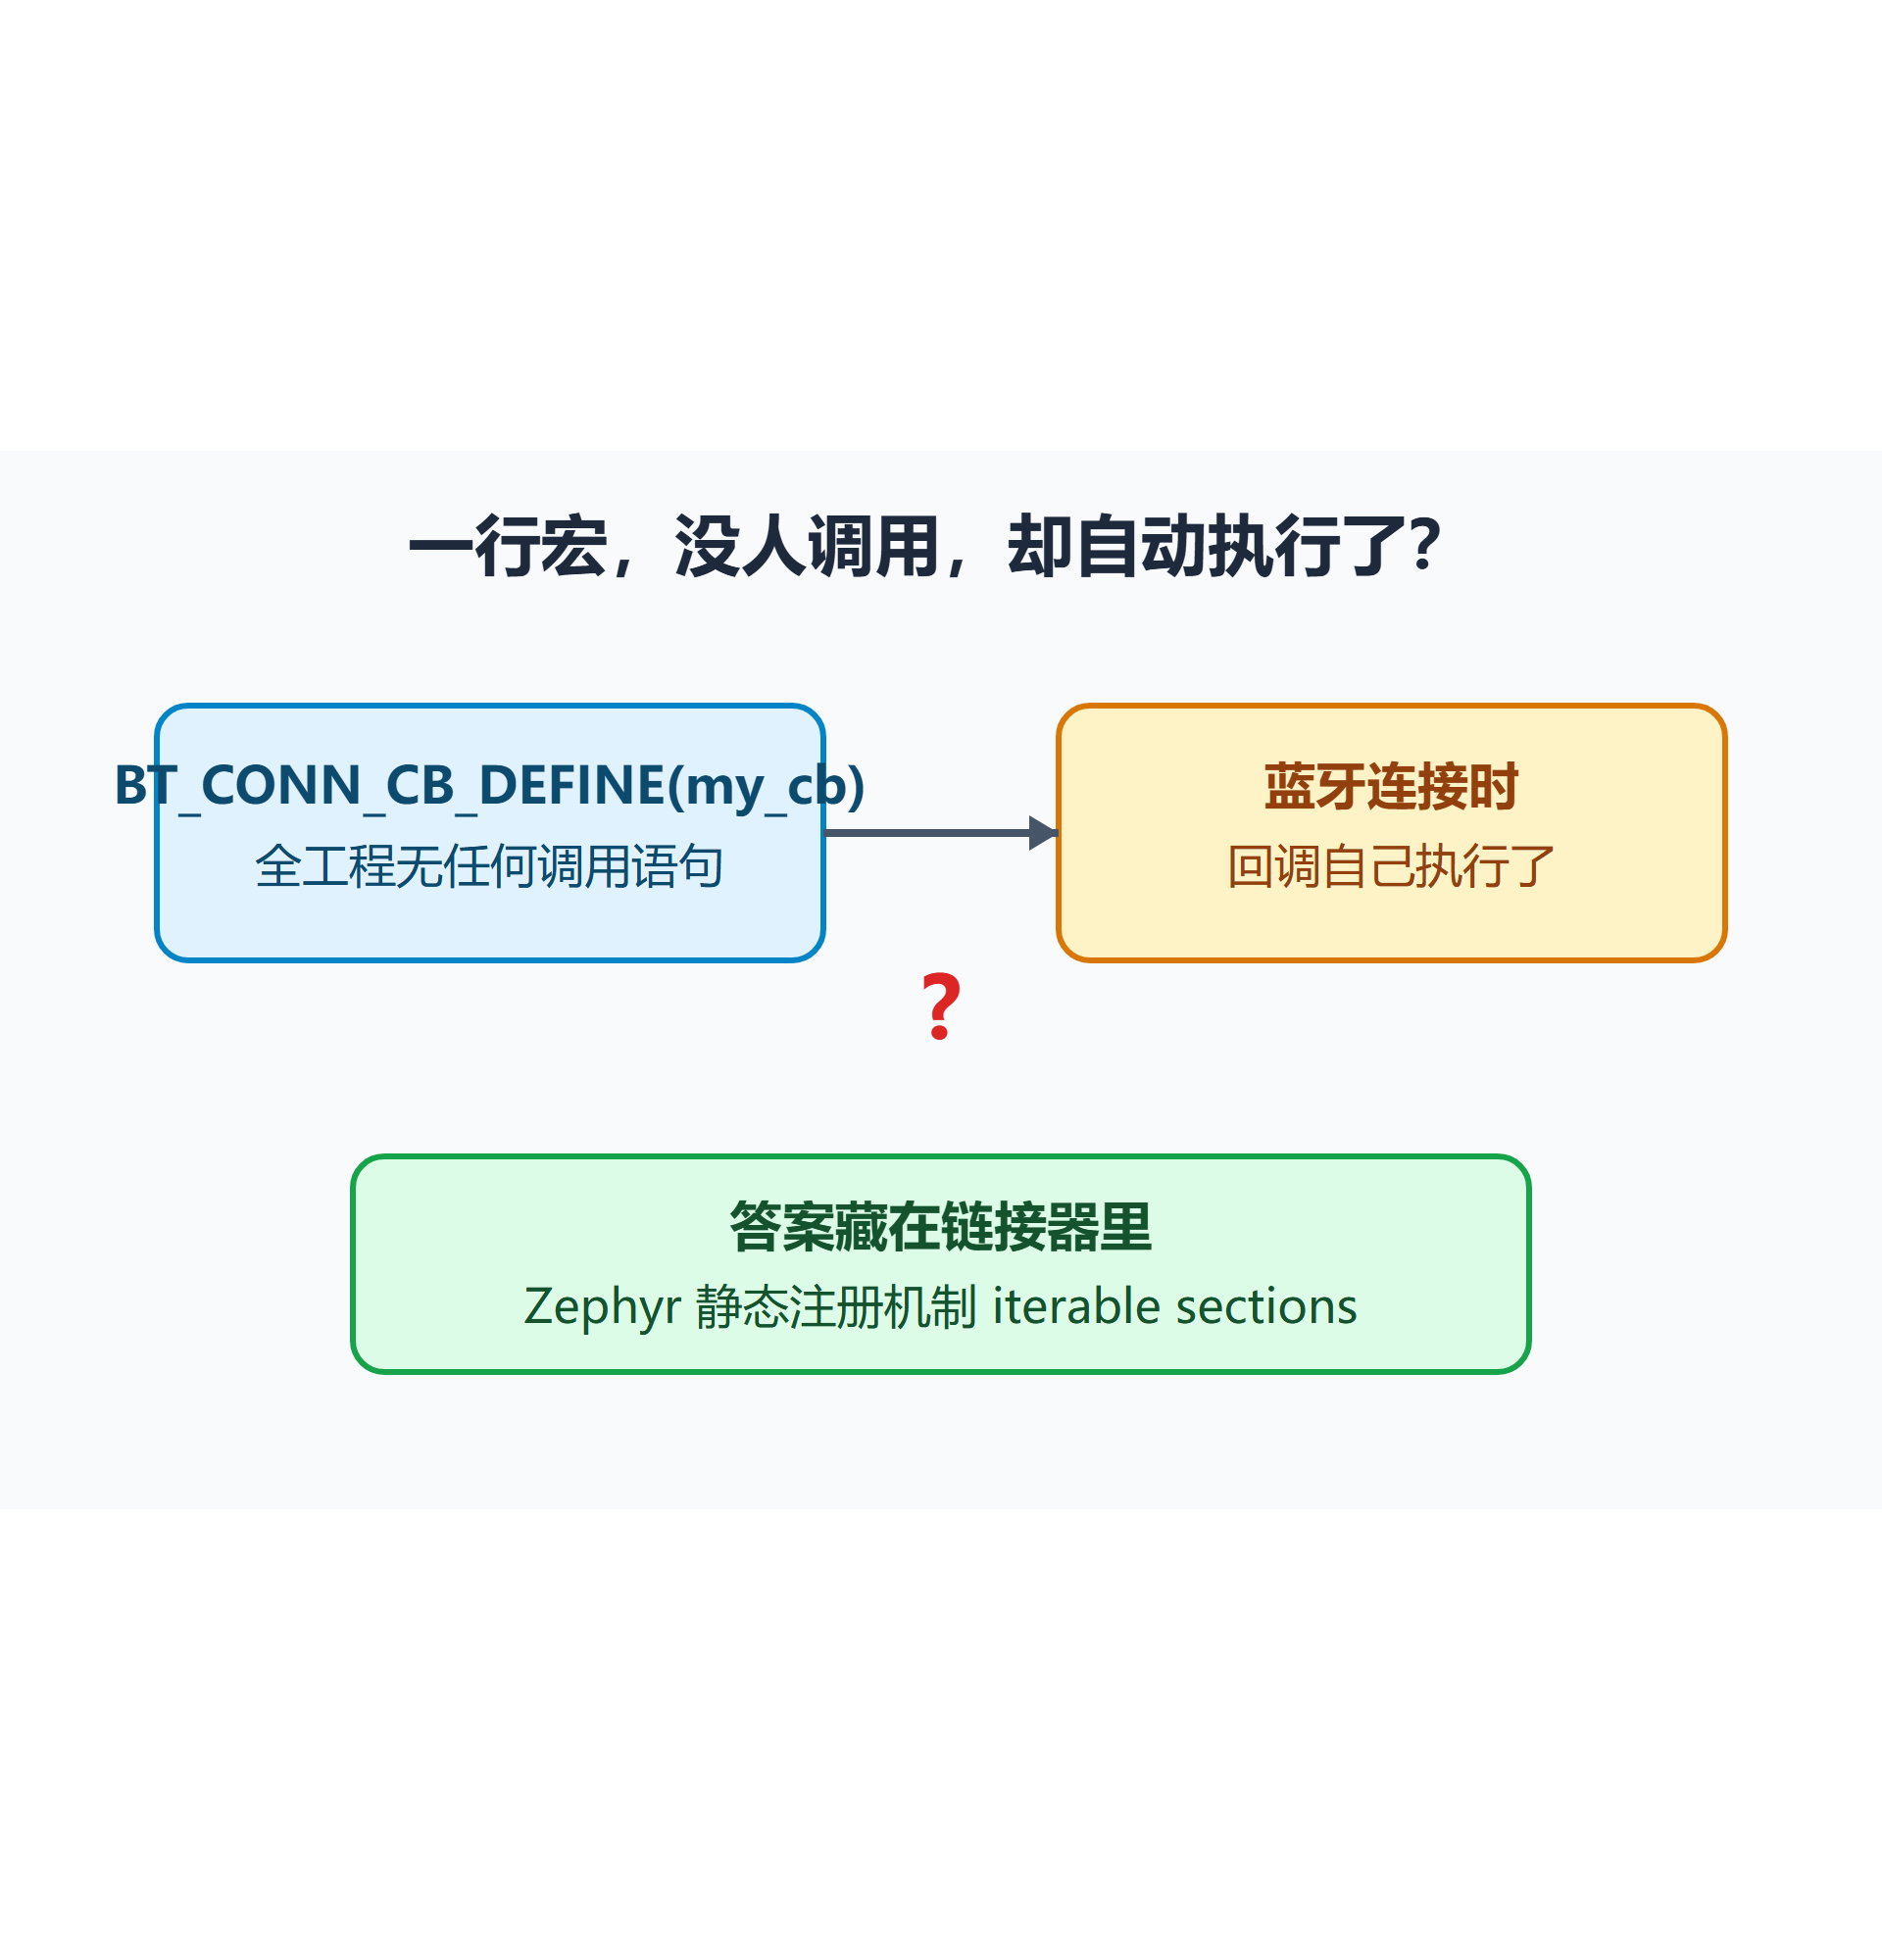
在 Nordic 的 nRF Connect SDK 里写 BLE 应用的时候,我在 conn.c 里翻过一段让我愣了一下的代码:应用源文件里就一行 BT_CONN_CB_DEFINE(my_callbacks),这个结构体在整个工程里没有任何一行代码显式调用它 ,可是蓝牙一连接,里面的 connected 回调就执行了。
注册了一个结构体,没人取、没人调,它自己就生效了。这不是灵异事件,是 Zephyr 的一套通用基础设施在干活------静态注册(iterable sections) 。你在 NCS 里天天在用它,只是可能没意识到:SYS_INIT 为什么不用在 main() 里调就自动执行?SHELL_CMD_REGISTER 为什么加一行就多一条命令?BT_GATT_SERVICE_DEFINE 定义的服务为什么自动生效?全是同一套机制。
这篇文章把它拆开讲清楚。机制一句话:任意源文件里用一个宏声明一个结构体,编译期它被放进专属链接器 section,链接期被收集到一块连续内存并打上起止边界符号,运行期框架用遍历宏在边界内逐个取出调用------无需显式 register(),写完宏就自动生效。
一、先看物理布局:注册的东西到底放在哪
第一个要回答的问题:这些注册项在固件镜像里是怎么摆的?是和普通代码混在一起,还是有专门的地方?
有专门的地方。 用 objdump -h 看一个 nRF54 + NCS 构建的 BLE 应用固件,输出节选如下:
Idx Name          Size      VMA       LMA
  0 rom_start     0000047c  00011800
  1 text          00054418  00011c80    <- 代码
  3 initlevel     000000e8  000660a0    <- SYS_INIT 注册项,独立分区
  4 device_area   00000168  00066188    <- 设备对象,独立分区
 12 bt_l2cap_fixed_chan_area ...        <- 蓝牙 L2CAP 通道
 13 bt_conn_cb_area 0000028  00066c34    <- BT_CONN_CB_DEFINE 回调
 14 bt_gatt_service_static_area ...     <- GATT 服务
 17 shell_root_cmds_area ...            <- shell 命令
 22 rodata        00014120  00066fe0    <- 普通只读数据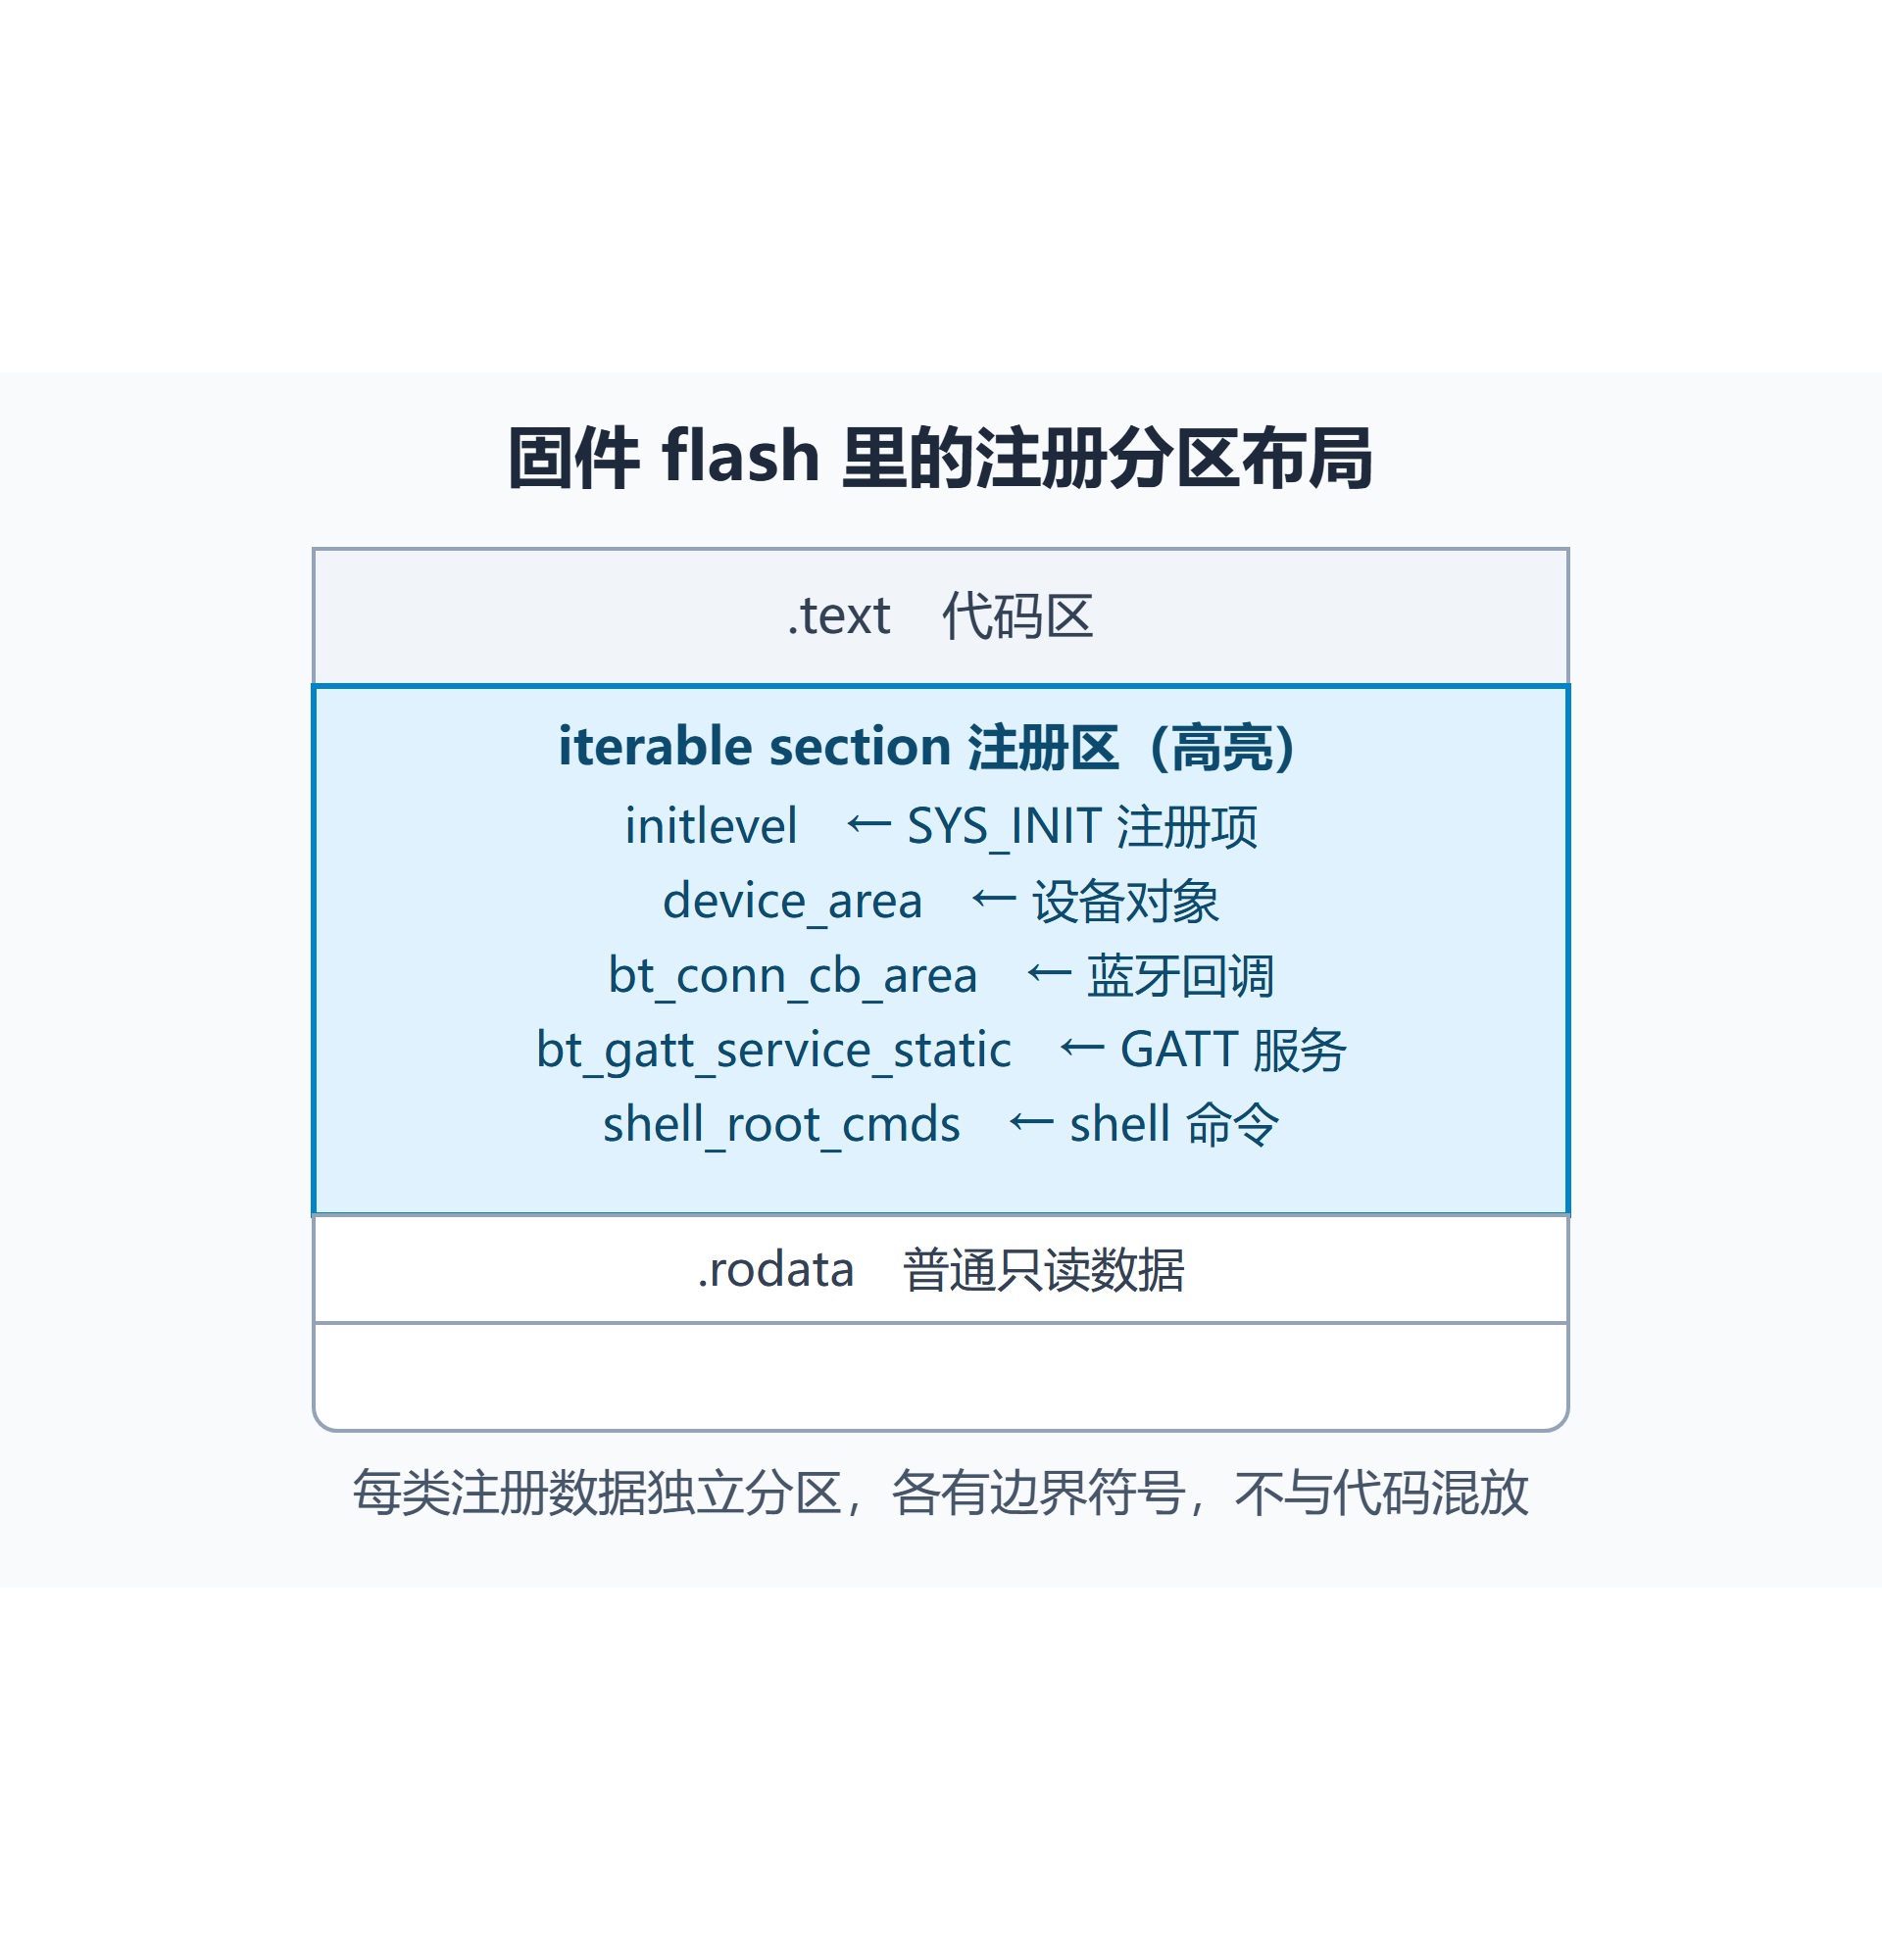
三个观察:
- 每类注册数据是一个独立的、命名的输出 section (
initlevel、device_area、bt_conn_cb_area、shell_root_cmds_area......),各有自己的名字、大小、地址,不是混在.text或.rodata里。 - 它们集中夹在
.text(代码)和.rodata(普通只读数据)之间,占一段连续 flash。 BT_CONN_CB_DEFINE的注册项就在bt_conn_cb_area里------我那个"没人调用却执行"的回调,物理上就躺在这里。
为什么不直接放 .rodata?
.rodata 是编译器自动收集的普通只读数据------字符串、const 变量,什么类型都有,混在一起。而框架要在运行期遍历注册项,需要三样东西 .rodata 给不了:
- 确定的起止边界,才能知道从哪遍历到哪;
- 同类型连续排列,指针步进才能正好踩到下一个元素;
- 不被链接器当垃圾丢弃 ------这些变量没有被任何代码直接引用,链接器的
--gc-sections默认会把它们扔掉。
所以 Zephyr 给每类注册数据开一个独立的命名 section,单独收集、单独保活。
分区大小是多少?没有预设,是"收集多少算多少"
ITERABLE_SECTION_ROM(type, ...) 在链接器脚本里不写死大小。一个分区的大小 = 链接期收集到的所有同类元素之和,由"有多少个源文件用了注册宏"决定。
拿 initlevel(SYS_INIT 分区)实测验证:nm 取出边界符号地址,_init_list 起 0x660a0、止 0x66188,大小 0xe8 = 232 字节;再看每个 __init_* 符号大小都是 8 字节(一个 struct init_entry),共 29 个------29 × 8 = 232,严丝合缝。没有任何预设容量,注册多少,分区就多大。
二、三层拆解:编译期、链接期、运行期各干什么
机制分三层协作,每层只干一件事。
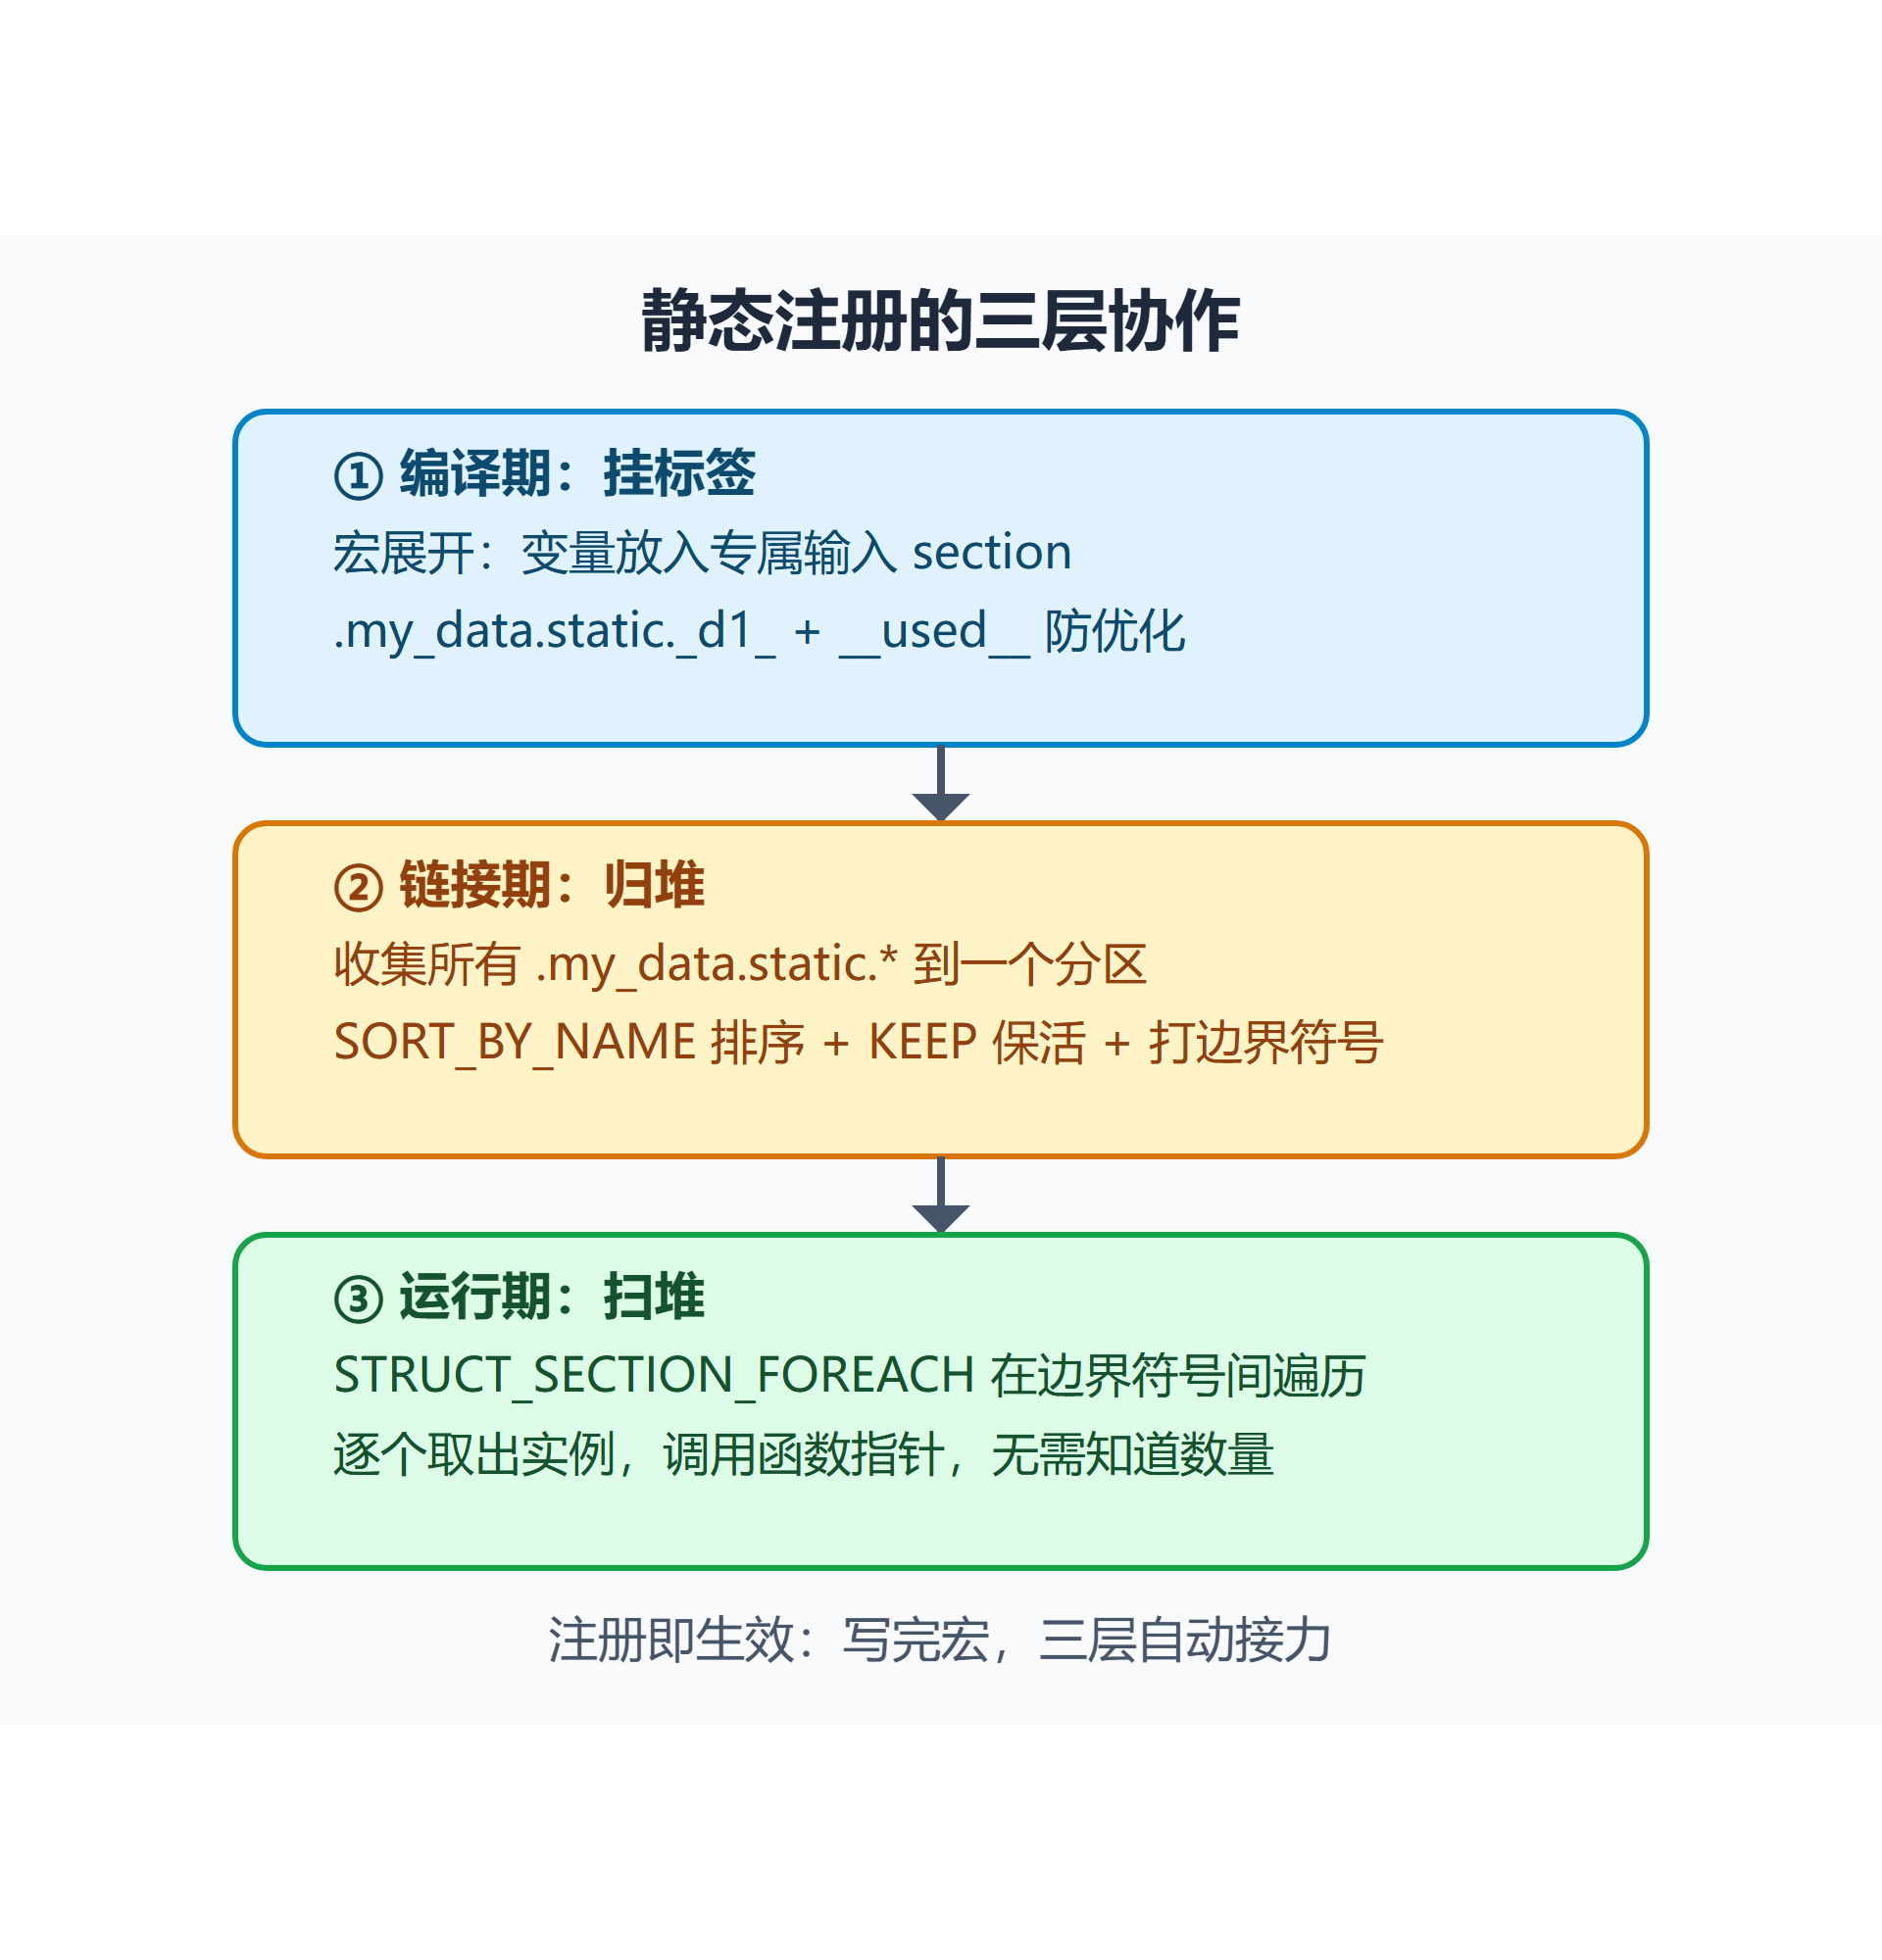
编译期:宏把变量塞进专属 section
以 STRUCT_SECTION_ITERABLE(my_data, d1) 为例,展开链走三层:
#define TYPE_SECTION_ITERABLE(type, varname, secname, postfix) \
    Z_DECL_ALIGN(type) varname \
    __in_section(_##secname, static, _CONCAT(postfix, _)) __used __noasan

/* Z_DECL_ALIGN(type) = __aligned(__alignof(type)) type */
/* ___in_section(a,b,c) = __attribute__((section("." a "." b "." c))) */
最终完全展开:
__aligned(__alignof(struct my_data)) struct my_data d1
    __attribute__((section(".my_data.static._d1_")))
    __attribute__((__used__))
    = { .a = 1, .b = 2 };
两个细节值得注意:
- section 名拼成
.my_data.static._d1_------类型名 + 固定的 static 段 + 变量名,这是 Zephyr 的命名规范,后面链接器就按这个模式通配收集; __used__防止编译器把这个"没被直接引用"的变量优化掉。
加 const 前缀就放 ROM(省 RAM,XIP 系统直接在 flash 上读);不加放 RAM。对应地,链接器侧要用 ITERABLE_SECTION_ROM 或 ITERABLE_SECTION_RAM。
链接期:收集、排序、打边界
链接器脚本里的声明长这样:
my_data_area :
{
    _my_data_list_start = .;
    KEEP(*(SORT_BY_NAME(.my_data.static.*)));
    _my_data_list_end = .;
} > ROMABLE_REGION
三件事:
- 通配收集 :所有源文件里
.my_data.static.*的输入 section,不管在哪个 .c 里,全收进my_data_area这一个输出 section------这就是"注册项散在各源文件也能聚起来"的原因; - 按名排序 :
SORT_BY_NAME按变量名字典序排,遍历顺序稳定,不依赖链接顺序; - 打边界符号 :
_my_data_list_start/_my_data_list_end钉在首尾,这就是运行期遍历的起止点。KEEP则阻止--gc-sections把整段当垃圾丢掉,和编译期的__used__是双保险。
运行期:在两个边界之间遍历
STRUCT_SECTION_FOREACH(my_data, d) 展开后等价于:
for (struct my_data *d = &_my_data_list_start;
     d < &_my_data_list_end;
     d++)
{
    /* 你的循环体 */
}
起点取边界符号,终点和边界符号比较,指针 ++ 每次自动跳 sizeof(struct my_data)------全程不需要知道有几个元素 。新增一个注册宏,_list_end 自动右移,循环自动多跑一次;删一个就少跑一次。代码和链接器脚本都不用改。
这就是我那个蓝牙回调的秘密:BT_CONN_CB_DEFINE(my_callbacks) 把结构体放进 bt_conn_cb_area,conn.c 里的事件处理代码用 STRUCT_SECTION_FOREACH 遍历这个分区、逐个调用回调------"没人调用"是错觉,调用方在框架里,而且不点名调你,是把整个分区的人都叫一遍。
三、你身边全是它的应用
这套机制是 Zephyr 的通用基础设施,NCS 里遍地都是:
| 你写过的宏 | 它进的那个分区 | 谁在遍历 |
|---|---|---|
SYS_INIT(fn, level, prio) |
initlevel |
启动流程按 level/prio 逐个调用 |
BT_CONN_CB_DEFINE(...) |
bt_conn_cb_area |
蓝牙连接事件分发 |
BT_GATT_SERVICE_DEFINE(...) |
bt_gatt_service_static_area |
GATT 服务注册 |
SETTINGS_STATIC_HANDLER_DEFINE(...) |
settings_handler_static |
配置加载时按名匹配回调 |
SHELL_CMD_REGISTER(...) |
shell_root_cmds |
shell 启动时识别命令 |
理解了这一层,NCS 里那些"写一行宏就自动生效"的写法就都不神秘了------它们全是同一套编译期分区 + 链接期收集 + 运行期遍历。
四、几个常见疑问
Q:为什么 __used__ 和 KEEP 都要,一个不够吗? 不够。变量没被代码直接引用,编译器会优化掉(__used__ 拦),链接器 --gc-sections 会丢 section(KEEP 拦)。两道关卡在不同阶段,缺一个都活不到运行期。
Q:多个注册项的执行顺序谁说了算? SORT_BY_NAME 按变量名字典序,和链接顺序无关,多次构建稳定。需要特定顺序就用命名控制(01_handler、02_handler)。
Q:注册项跨多个源文件,能收集到一起吗? 能,这正是机制的核心------各源文件的输入 section 名遵守同一命名模式,链接器一个通配全收。
Q:section 名里那段 static 是什么? 表示"静态注册"(编译期固定),区别于运行期动态注册。链接器的收集通配模式就是按这个命名约定写的,自定义分区也必须遵守。
写在最后
回到开头:那行"没人调用却执行"的宏背后,是 Zephyr 用链接器做出来的一个注册表系统------编译期挂标签,链接期归堆,运行期扫堆。掌握它之后自然会有下一个问题:能不能自己开一个这样的分区,让业务模块也做到"注册即生效"?
能。下一篇就讲怎么在 NCS 工程里自定义一个 iterable section:从定义结构体、写链接器片段、接 CMake 到遍历调用,附完整可跑的示例和踩坑排查清单。
有用的话点个在看,让更多工程师看到。你在 NCS 里还发现过哪些"写一行宏就自动生效"的写法?评论区聊聊。
标签 :Zephyr Nordic 蓝牙开发 链接器 嵌入式