一、引言
在大数据系统中,SQL 几乎成了事实标准接口。无论底层是关系数据库、数据湖、消息队列、KV 存储、搜索引擎还是 OLAP 引擎,用户往往都希望通过统一 SQL 查询数据。
但不同系统的数据模型、执行能力和优化策略差异很大 ;如果每个系统都从头实现 SQL Parser、Validator、Optimizer、Cost Model、JDBC Driver、Adapter,就会造成大量重复建设。Apache Calcite 的出现,正是为了把这些通用能力抽象出来,成为一个可复用、可嵌入、可扩展的查询优化基础设施。
二、核心定位
Apache Calcite 是一个动态数据管理框架,它提供 SQL 解析、校验、关系代数表示、查询优化、JDBC 接入、适配器机制等能力,但不负责数据存储、数据处理算法和元数据仓库,这使它更像数据库内核中的"查询理解与优化层",而不是完整数据库系统。
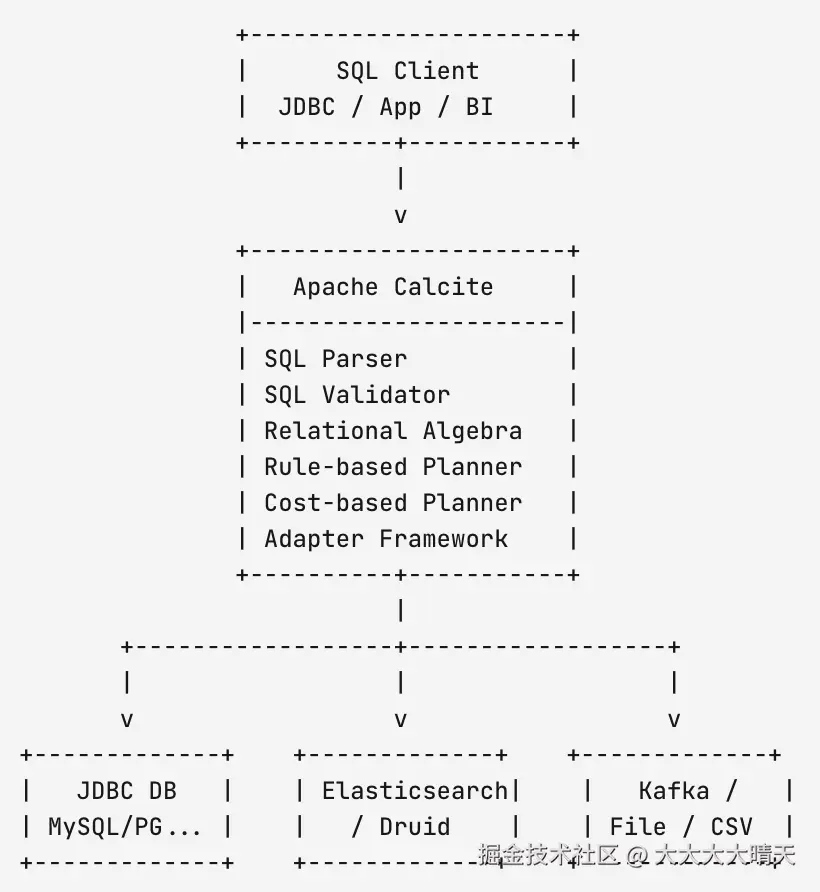
Calcite 定位为"构建高性能数据库的基础",它具备三类核心能力:标准 SQL、查询优化,以及"Any data, anywhere"的多数据源连接与下推能力。Calcite 负责把 SQL 转换为可优化的关系表达式,再通过规则、代价模型和适配器,把查询尽可能转换成目标系统能高效执行的计划。
三、架构原理
Calcite 的核心链路可以简化为:
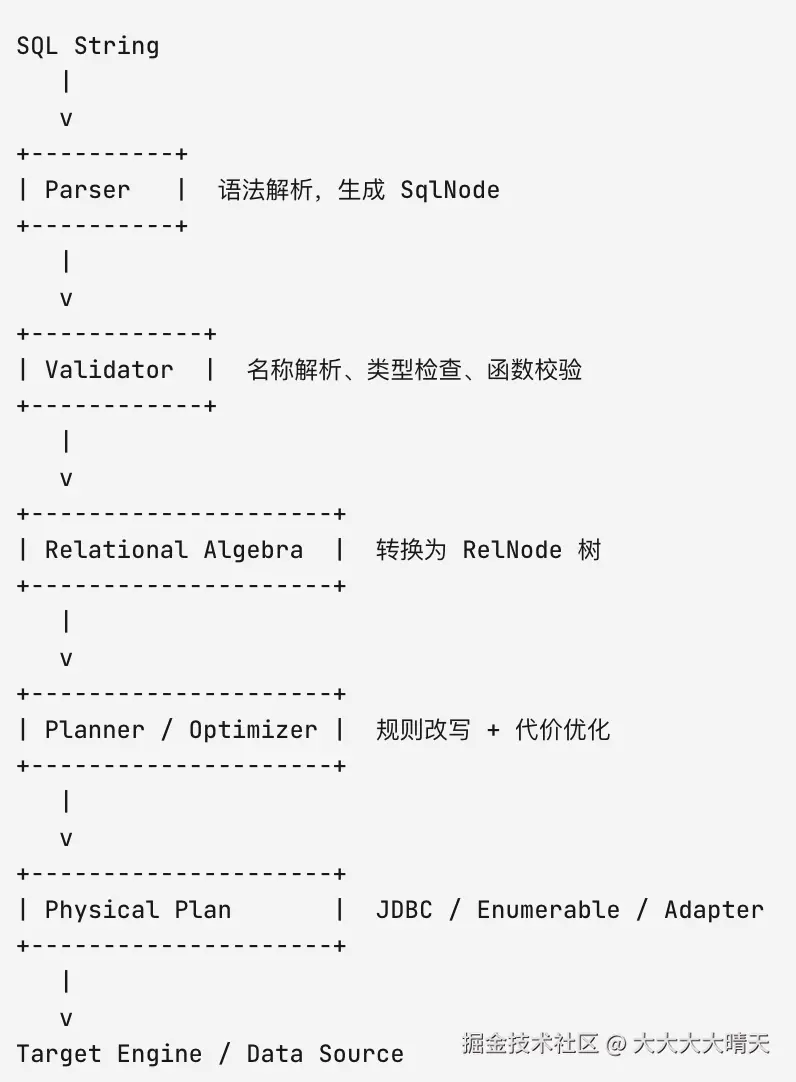
关系代数是 Calcite 的核心,每个查询都会被表示为关系操作符树;SQL 可以被翻译为关系代数,也可以直接通过 API 构造关系表达式。
1.Parser
Parser 负责把 SQL 字符串解析为语法树。SqlParser 会把 SQL 字符串解析成 parse tree,但只执行最基本的语法校验;每个语法树节点都是SqlNode ,Parser 只回答 这段 SQL 在语法上是否能被识别。
2.Validator
Validator 负责进一步确认 SQL 是否语义合法,例如:
| 校验项 | 示例 |
|---|---|
| 表是否存在 | emp 是否在 schema 中 |
| 字段是否存在 | name、deptno 是否存在 |
| 类型是否匹配 | deptno = 'abc' 是否需要类型转换 |
| 函数是否合法 | 函数名、参数数量、返回类型 |
| 聚合是否合法 | GROUP BY 与非聚合字段是否合法 |
Parser 解决"看不看得懂",Validator 解决"说得对不对"。
3.RelNode
通过校验后,SQL 会被转换为关系代数树,也就是 Calcite 中的RelNode 。例如:
sql
SELECT name
FROM emp
WHERE deptno = 10
可抽象为:
scss
LogicalProject(name)
  |
LogicalFilter(deptno = 10)
  |
LogicalTableScan(emp)
RelBuilder 可以通过scan 、project 、filter 、aggregate 等方法构造关系表达式,并打印出LogicalTableScan、LogicalProject 、LogicalFilter 、LogicalAggregate 等关系操作符。
4.Planner
Planner 是 Calcite 最关键的部分。它会基于规则对关系表达式进行等价变换,例如:
scss
原始计划:

Project(name)
  |
Filter(deptno = 10)
  |
TableScan(emp)

优化后:

Project(name)
  |
TableScan(emp, pushedFilter=[deptno = 10])
Planner rules 会使用保持语义不变的数学等价关系来转换表达式树;例如,如果过滤条件不引用另一侧输入,就可以把 Filter 下推到 inner join 的某个输入侧。
Calcite 优化查询的方式是反复应用 planner rules,并由 cost model 指导优化过程,最终生成语义等价但成本更低的表达式。
四、关系代数
关系代数是 Calcite 的中间表示,也是它能支持多种 SQL 方言、多种数据源、多种执行引擎的关键。SQL 是入口语言,RelNode 是中间语言,Adapter 是出口语言。Calcite 中的RelNode 就类似查询领域的 IR。
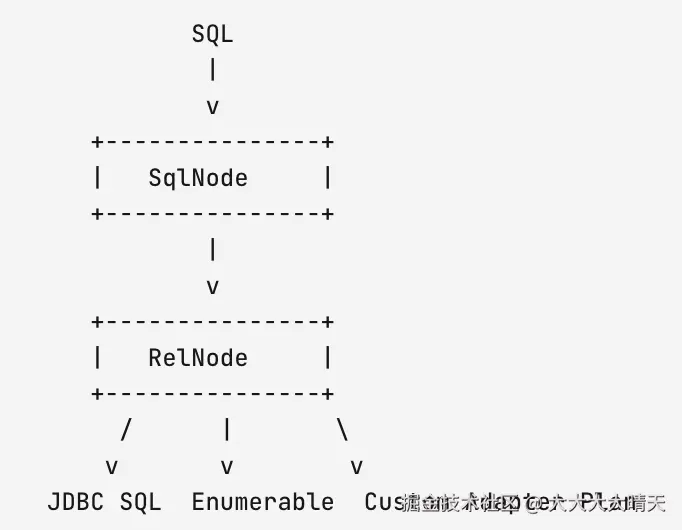
这种设计有几个好处:
| 好处 | 说明 |
|---|---|
| 解耦 SQL 与执行引擎 | SQL 不直接绑定某个存储系统 |
| 统一优化入口 | 不同数据源都可以复用优化框架 |
| 便于规则扩展 | 新数据源可添加自己的下推规则 |
| 便于多引擎接入 | 同一个逻辑计划可转成不同物理计划 |
Calcite 的规划过程是可扩展的,用户可以添加自己的关系操作符、planner rules、cost model 和统计信息。
五、适配器机制
Calcite 的 Adapter 是连接外部数据源的核心机制,Schema adapter 允许 Calcite 读取某类数据,并把这些数据作为 schema 中的 tables 呈现出来。
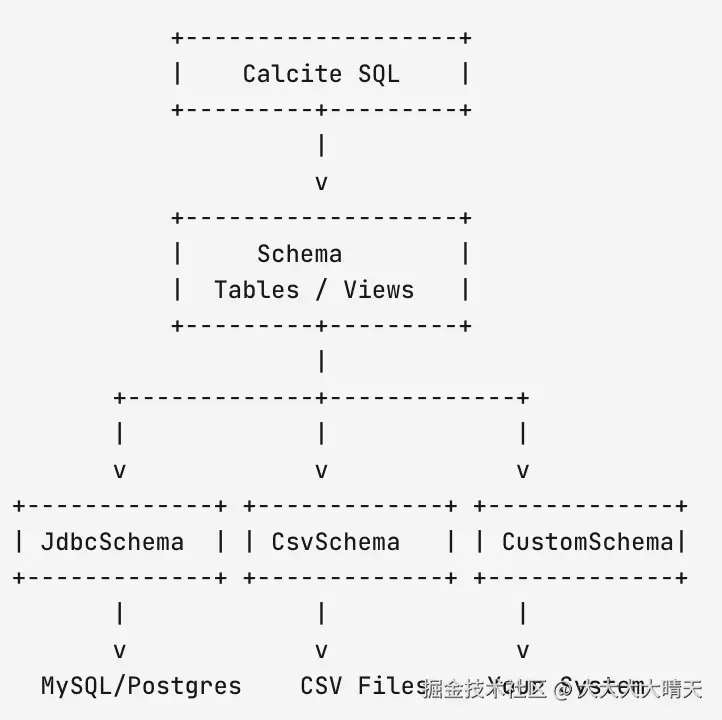
官方列出的适配器包括 Arrow、Cassandra、CSV、Druid、Elasticsearch、File、Geode、InnoDB、JDBC、MongoDB、OS、Pig、Redis、Spark、Splunk、Kafka 等。
适配器通常要解决三类问题:
| 问题 | 说明 |
|---|---|
| 元数据暴露 | 有哪些库、表、字段、类型 |
| 数据访问 | 如何 scan、filter、project、aggregate |
| 能力下推 | 哪些操作能交给底层系统执行 |
例如,把ReflectiveSchema 替换为JdbcSchema 后,同一条 SQL 就可以通过 JDBC 执行,Calcite 会使用优化规则把JOIN 和GROUP BY 推给源数据库执行。
六、查询优化
Calcite 的优化可以粗略分为两类:
| 优化类型 | 说明 | 示例 |
|---|---|---|
| 规则优化 | 基于等价变换规则 | 谓词下推、投影裁剪 |
| 代价优化 | 基于统计与成本模型选择更优计划 | Join 顺序选择、物理实现选择 |
一个典型优化过程如下:
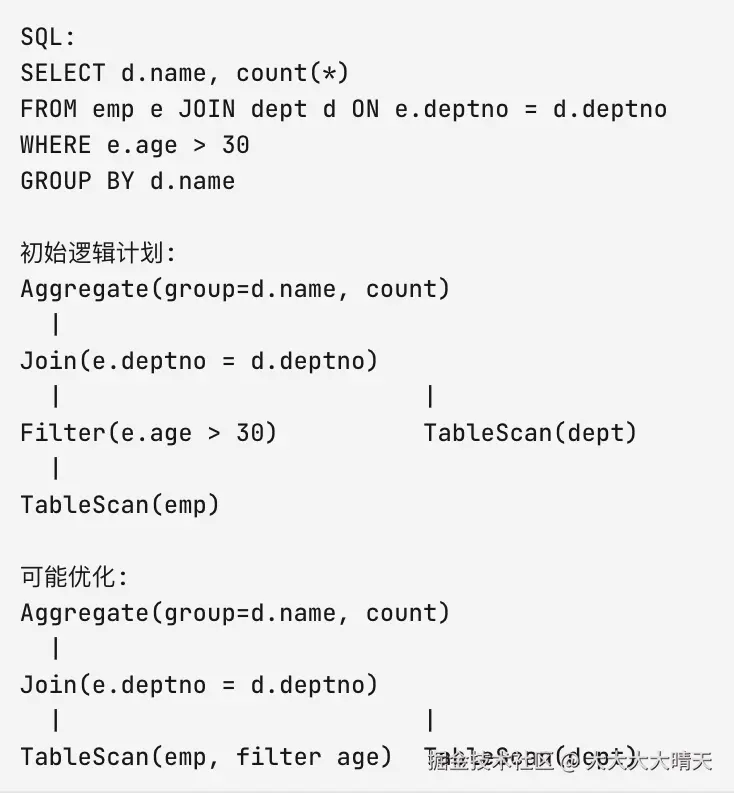
planner rule 会查找查询树中的模式,例如某类 table 上方的 project,然后用新的节点替换匹配节点以实现优化;如果你希望让自己的数据源支持高效 SQL 访问,就需要定义 schema/table,并添加规则让访问更高效。这也是 Calcite 对大数据系统特别有价值的地方:它不仅能解析 SQL,还提供了一套可扩展的优化框架,让每个引擎把自己的能力声明出来。
七、功能特性
| 功能 | 说明 |
|---|---|
| SQL Parser | 解析 SQL 文本 |
| SQL Validator | 校验表、字段、类型、函数 |
| Relational Algebra | 用 RelNode 表达查询计划 |
| Query Optimizer | 规则优化与代价优化 |
| JDBC Driver | 通过 JDBC 方式连接 Calcite |
| Adapter Framework | 接入多种外部数据源 |
| JSON/YAML Model | 通过模型文件声明 schema、table、view |
| Extensible Rules | 自定义优化规则 |
| Extensible Operators | 自定义函数、操作符、聚合函数 |
| SQL Dialect | 定制 SQL 方言与生成逻辑 |
官方 SQL 支持范围包括SELECT 、FROM 、JOIN 、WHERE 、GROUP BY 、GROUPING SETS 、聚合函数、COUNT(DISTINCT ...) 、FILTER 、HAVING 、ORDER BY 、集合操作、子查询、窗口聚合和LIMIT 等。
另外,Calcite core 支持 SQL 查询和 DML 操作,但不支持 DDL,例如CREATE SCHEMA 或CREATE TABLE ;DDL 支持位于可选的calcite-server 模块中。
八、适用场景
Calcite 的优势不是"开箱即用替代 MySQL/Spark/Flink",而是作为查询引擎、数据平台或联邦查询系统的基础组件。
- 构建 SQL 查询引擎:如果你正在构建一个自研 OLAP 引擎、湖仓查询服务、指标平台或数据服务层,Calcite 可以提供 SQL 解析、语义校验和优化能力。
- 数据虚拟化:Calcite 很适合做多源数据访问入口。例如一个查询可能同时访问 MySQL、Elasticsearch 和文件系统。
- SQL 方言转换:Calcite 拥有 SQL parser、validator、relational algebra 和 dialect 机制,因此可以把一种 SQL 解析成统一表示,再生成另一种数据库方言的 SQL。
- 自定义数据源接入:当你有一个非标准数据源,例如内部 API、日志索引、KV 存储、自研列存格式,希望对外提供 SQL 查询能力时,可以通过自定义 schema/table/adapter 暴露给 Calcite。
当然,Calcite 也有明显边界。
| 不适合场景 | 原因 |
|---|---|
| 想直接部署一个完整数据库 | Calcite 不负责持久化存储和完整执行引擎 |
| 只需要简单 SQL 解析 | Calcite 能做,但可能偏重 |
| 希望自动优化所有数据源 | 优化效果依赖 adapter、规则、统计信息 |
| 希望开箱即用支持复杂 DDL | core 不支持 DDL,需要 server 模块或自定义扩展 |
| 希望替代 Spark/Flink 执行计算 | Calcite 是优化框架,不是通用分布式执行引擎 |
Calcite 适合做"查询大脑",不适合单独做"完整身体"。
九、小结
Apache Calcite 的价值,在于把数据库和大数据系统中通用而复杂的 SQL 解析、校验、关系代数建模、规则优化、代价优化和数据源适配能力抽象成一个可复用框架。它不试图成为一个完整数据库,而是成为许多数据库、查询引擎和数据平台可以共享的基础内核。
未来,随着企业数据源越来越多样化,湖仓、实时数仓、搜索分析、向量检索、联邦查询、数据虚拟化等场景会持续增长。Calcite 这类"无存储、重优化、强扩展"的查询框架,会越来越像大数据基础设施中的编译器前端和优化器中枢。
如果你正在做数据平台、SQL 网关、联邦查询、自研引擎或指标服务,Calcite 值得深入学习;如果你只是想找一个可直接部署的数据库,那么 Calcite 不是终点,而是构建终点的底座。