单卡5090跑125B 大模型:Strata 把服务器级 MoE 拉进普通 PC
作者:吴佳浩
撰稿时间:2026-10-08
测试环境:
- GPU:RTX 5090(32GB VRAM,驱动 617.14,PCIe Gen5 ×8)
- CPU:AMD Ryzen 9 9950X
- Memory:94GB RAM
- Storage:NVMe SSD
- OS:Windows 11(10.0.26200)
- Engine:Strata v0.1.40.2(CUDA 13.0)
- Model:Qwen3.8-Flash-Next IQ3_S(125B 级 MoE,24,576 experts)
引言
面向工程师与研究者的体系化分析。 不止讨论「跑起来了没有」,更追问「这件事对本地部署意味着什么、代价又落在哪一层」。 125B 级 MoE 模型过去只活在几百 GB 显存的服务器上。Strata 把它拉进了一台游戏 PC:不租云、不调 API、数据不出本机。 本文用一次完整实测回答三个问题------它怎么做到的、真实性能是多少、值不值得用,并把过程中三处真实故障的根因一并摊开。
注:全文所有性能数字均为本机实测,未经验证的推测会明确标注为推测。因为阿拉好奇所以我们一道来白相相,看看是徒有虚名,还是真的结棍。
目录
- 问题的本质:显存装不下时的必然选择
- [Spill 机制:把平方复杂度问题转成带宽问题](#Spill 机制:把平方复杂度问题转成带宽问题 "#%E4%BA%8Cspill-%E6%9C%BA%E5%88%B6%E6%8A%8A%E5%B9%B3%E6%96%B9%E5%A4%8D%E6%9D%82%E5%BA%A6%E9%97%AE%E9%A2%98%E8%BD%AC%E6%88%90%E5%B8%A6%E5%AE%BD%E9%97%AE%E9%A2%98")
- 部署实录:三个真实故障的根因推导
- 接口验收:推理验证与健壮性
- [性能基准:首 Token、Decode、预填](#性能基准:首 Token、Decode、预填 "#%E4%BA%94%E6%80%A7%E8%83%BD%E5%9F%BA%E5%87%86%E9%A6%96-tokendecode%E9%A2%84%E5%A1%AB")
- 长上下文:全深度召回的意义
- 硬件资源占用:瓶颈的定量定位
- 稳定性与并发:排队语义的实证
- 优化建议与工程取舍
- 总结
一、问题的本质:显存装不下时的必然选择
Strata 的意义可以先用一句话讲清:它让一个原本必须住在服务器机柜里的模型,住进了一台游戏 PC。 而且不是演示级的小模型,是 125B 级、24,576 个 experts 的 MoE;跑起来之后,你的数据一个字节都不用离开本机。
这件事值得认真拆解,是因为「服务器」与「消费级显卡」之间那道鸿沟是可量化的。所以这一章先把算术摆出来。
1.1 先算清楚这道题的边界
125B 级 MoE 模型放进 IQ3_S(3.5-bit)量化后,权重总量是 83.6 GB:
| 分片 | 字节数 | SHA-256(官方公布,已比对通过) |
|---|---|---|
| shard1 | 54,817,524,224 | 4c1eb2ceb4915e1192f4f386021897bde56a97f40a0bb78bb86465e0f7d2aca3 |
| shard2(PLE 表) | 28,800,138,432 | 316b46f3a2dbd68c900f43136ab9449f9dcc3725dfd8c794847c204bc161e113 |
而 RTX 5090 的显存是 32,607 MiB,约 31.8 GiB。83.6 GB 塞进 31.8 GiB,缺口是 2.6 倍。 这不是调参能解决的问题,是算术问题。
1.2 「塞不下」有三种应对,只有一种能保住质量
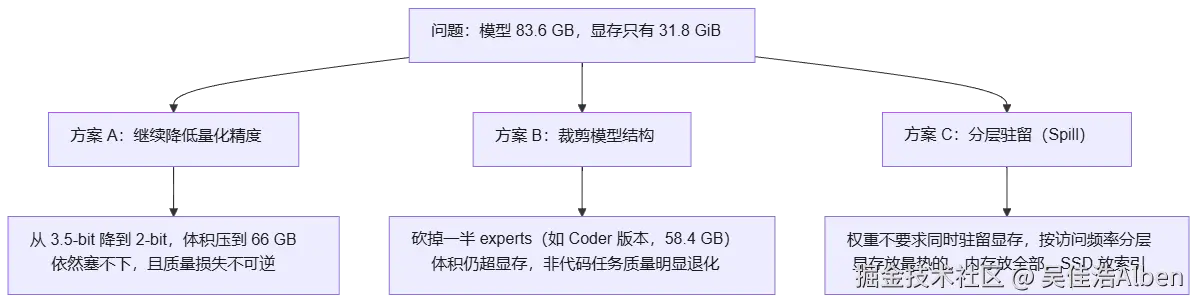
方案 C 是唯一既保住全部 experts、又能跑起来的路径。它的代价很明确:把「显存不够」的问题,换成了「带宽够不够」的问题。
1.3 这个交易为什么划算:MoE 的稀疏性
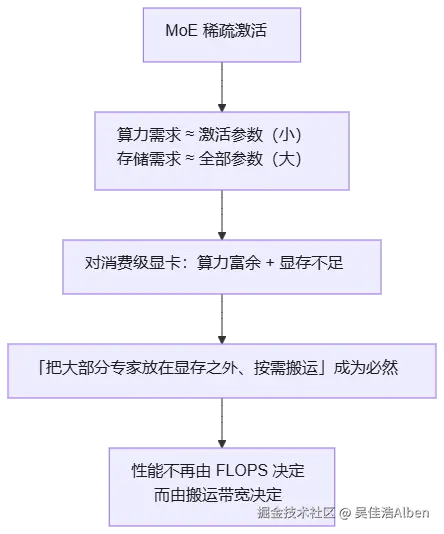
MoE 的关键性质是稀疏激活:模型有 24,576 个 experts,但每个 token 只路由到其中极少数。这带来一个反常的结果:
markdown
稠密模型:算力 ∝ 总参数量
MoE 模型:算力 ∝ 激活参数量(远小于总量)
         显存 ∝ 总参数量(没有变少)
MoE 把「算力」和「显存」解耦了。 它降低了算力需求,但没有降低存储需求。所以 MoE 天然就是「存不下、但算得动」的形态------而这恰恰是消费级显卡的处境:算力富余(实测功耗只用掉 1/3),显存贫瘠。
二、Spill 机制:把平方复杂度问题转成带宽问题
2.1 三层存储的实际配置
启动后的引擎日志给出了这台机器上的真实分层:
yaml
experts loaded: 46.84 GiB at 0.24 GiB/s (228 s so far)
expert cache auto: 24.52 GiB free → 9527 slots → 收缩至 11784 slots / 22.36 GiB
mtp: draft layer loaded, 835 MiB of VRAM (experts 675, dense 111)
KV streaming: 32768 of 131072 cells per QSA layer in VRAM, the K/V in 1.55 GiB of pinned RAM
整理成架构图:
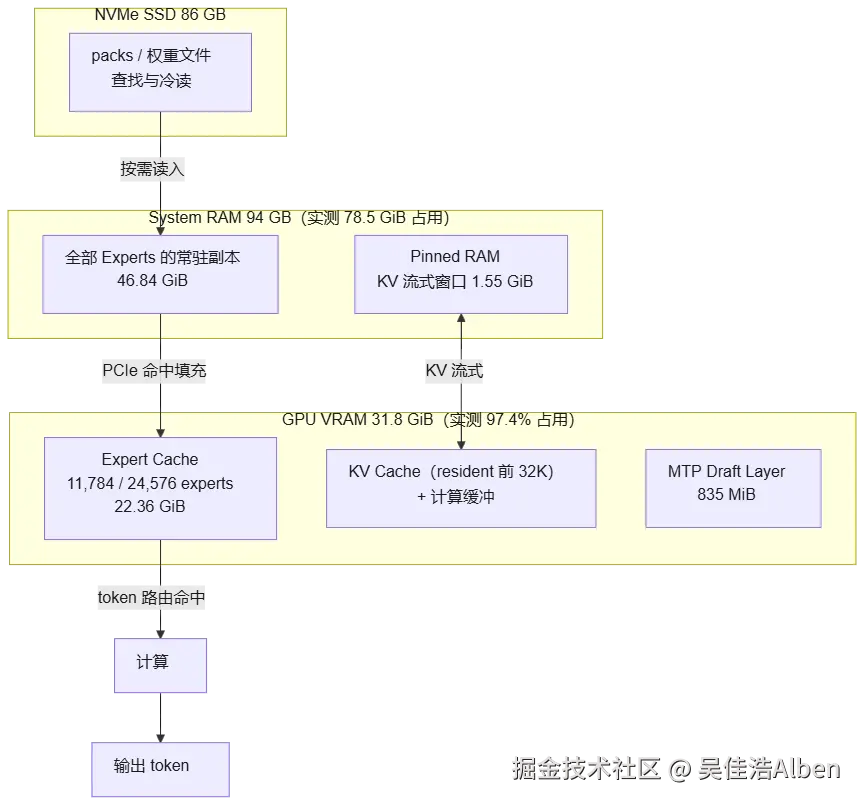
三层各自承担不同职责,而层与层之间的搬运就是全部性能代价的来源。这张图里有两个关键的数字指标,后面会展开:专家缓存命中率、KV 流式命中率。
2.2 KV 缓存是第二个隐性瓶颈
长上下文下还有第二个增长项:KV 缓存。它随序列长度线性增长,而上下文窗口开到 131,072 时不可忽略。这台机器的配置是:
bash
--kv int8                     # 每 cell 1,056 字节(q4_0 为 576)
--kv-resident 32768           # 只把前 32,768 个 cell 锁在显存
超出 32K 的部分走 RAM 流式,用 1.55 GiB 的 pinned RAM 做窗口。这是一个显式取舍:用「长上下文时略慢」换「显存里能多放专家」。 它的实际效果在第 5 章与第 7 章用数据说话。
2.3 猜测---校验:为什么能快 1.6--1.8 倍
Spill 架构下 decode 是逐 token 的,每个 token 都要搬一次专家。工程上的破解办法是投机解码:用小模型(MTP draft layer)先猜接下来几个 token,再用大模型一次性并行校验。
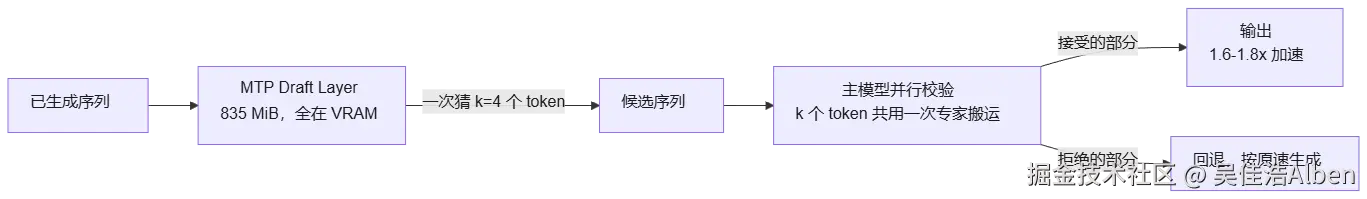
关键收益在于多个 token 共享一次专家搬运 :搬运成本被摊薄,摊薄倍数取决于接受率。这里埋了一个测量陷阱------接受率取决于待生成文本的可预测性,所以 decode 速度本质上会随内容波动。这一点在第 5.3 节诚实展开。
三、部署实录:三个真实故障的根因推导
这一章是本文最该看的部分。三个故障都不是「配置写错了」这种低级问题,而是上游代码的隐含假设 与静默的数据损坏,其中两个会直接导致「看起来成功、实际是坏的」。
3.1 故障一:解释器与环境变量污染
安装脚本会自己找 Python。这台机器上 py -3 指向一个损坏的解释器:
vbnet
py -3 -c "print(1)"
→ Fatal Python error: init_fs_encoding: failed to get the Python codec
  ModuleNotFoundError: No module named 'encodings'
同时宿主工具链会向子进程注入 PYTHONPATH。两者叠加的后果是:新建的 venv 会继承错误的模块搜索路径 ,pip list 显示的包根本不是 venv 里的。
验证方法很直接,看 venv 解释器真正看见了哪些 site-packages:
bash
# 错误方式:继承了宿主 PYTHONPATH,输出里会混进宿主目录
./.venv/Scripts/python.exe -c "import sys; [print(p) for p in sys.path]"

# 正确方式:清空后只剩自己的 site-packages
env -u PYTHONPATH -u PYTHONHOME ./.venv/Scripts/python.exe \
  -c "import sys; [print(p) for p in sys.path if 'site' in p]"
# → G:\strata\.venv\Lib\site-packages
另一个坑是路径形式。Windows 原生 Python 不认 MSYS 风格路径:
bash
python -m venv /g/strata/.venv        # ← exit 0,但目录根本没建
python -m venv "G:/strata/.venv" # ← 正确静默失败是最贵的失败:它不报错,只在下游某处突然炸掉。
3.2 故障二:setup.py 的 Content-Length 假设(最严重)
模型有 83.6 GB,下载是必经环节。第一次下载 shard2(28.8 GB)时,脚本在 19.3 GB 处「成功完成」了。
源码:
python
# setup.py:1348
if not total or have >= total:                     # total 来自 HEAD 的 Content-Length
    break
...
if total and part.stat().st_size != total:         # ← total == 0 时,这个校验被整体跳过
    fail(f"could not finish downloading ...")
part.replace(dst)                                  # 改名成"正式文件"
meta = ms_meta(*ms)
if meta is not None and meta[1]:
    verify_sha256(dst, meta[0], meta[1])
else:
    mark(dst)                                      # ← 无哈希可校验,写一个只含时间戳的标记
而 ModelScope 的 resolve 端点在 HEAD 时不返回 Content-Length。于是:
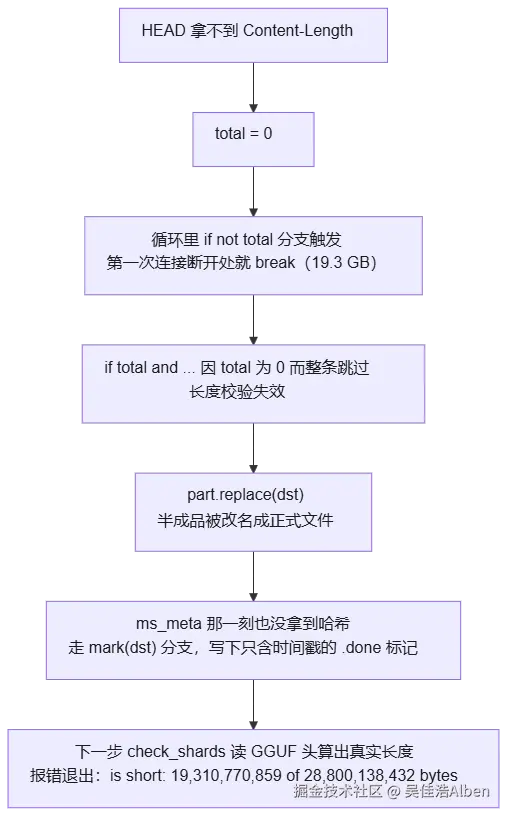
真正的危险不是那次报错,而是那个 .done 标记。 它的语义是「这一步已完成」:
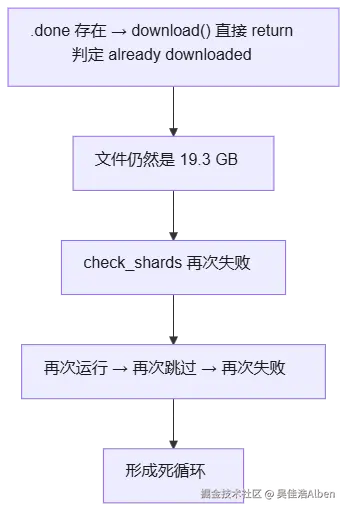
教训:进度标记的语义必须比文件还严格。 任何「先标记完成、后校验」的顺序,都会在失败时留下毒标记。正确顺序是:校验通过 → 才写标记。
处置办法:删掉毒标记,改用自写下载器,尺寸与哈希取自 ModelScope API 自己公布的值(28,800,138,432 / 316b46f3...),完全不依赖 HEAD。
3.3 故障三:静默数据损坏,以及我自己的一个错误结论
重下到正确长度后,哈希校验失败:
got      8ae37d5797657c00e47cc61eefc88c5b574e7798807d7920a443115b46b2da39
expected 316b46f3a2dbd68c900f43136ab9449f9dcc3725dfd8c794847c204bc161e113
长度完全正确,内容错误。 这类损坏最难查,因为它骗过了所有基于长度的检查。
根因在于下载器只检查了状态码,没检查区间对齐:
python
# 有缺陷的版本
if have and r.status != 206:
    f.seek(0); f.truncate(); have = 0        # 只判断"服务端是否忽略了 Range"
f.write(b)                                    # 然后无条件追加
一旦 CDN 返回 206 但区间起点不是请求的偏移 (缓存代理错位是常见成因),错位的字节会被当成「文件的这一段」直接追加进去。修法是校验 Content-Range 的起点:
python
cr = r.headers.get("Content-Range") or ""
cr_start = int(cr.split()[1].split("-")[0]) if cr.startswith("bytes ") else None
if have and (status != 206 or (cr_start is not None and cr_start != have)):
    # 服务端忽略了 Range,或返回区间起点不是我要的偏移 → 丢弃重来
    f.seek(0); f.truncate(); have = 0
更值得说的是我中间判断错的那一次
为了省下重下 28.8 GB 的时间,我试过「分段探测 + 定点修复」:从 CDN 抽 6 个偏移各取 64 KB,与本地逐字节比对,结果 6/6 全 MATCH,于是我判定这个文件「COHERENT、可以续传」。
这个结论是错的。
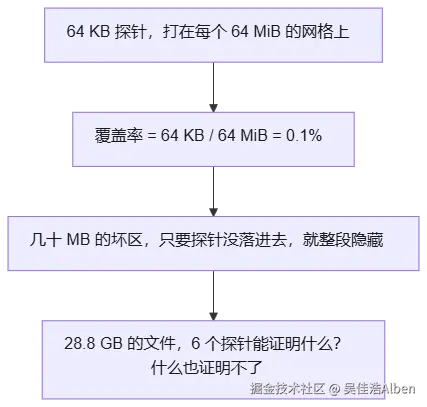
平行扫描跑完 200/430 个块(0--13.35 GB)一个不匹配都没有 ,而全量哈希明确判定文件是坏的------两个结果放在一起,正好说明稀疏采样在原理上无法证明大文件的完整性。
于是删档重下。重下后哈希一次通过。
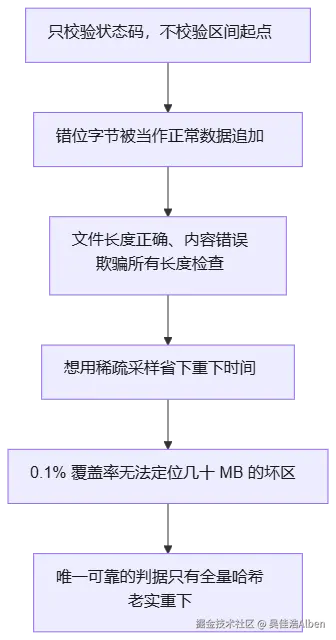
这条经验可以脱离本项目单独成立:大文件完整性只认全量哈希;任何采样率低于「可能坏区大小 / 文件大小」的探测,都只是心理安慰。
3.4 部署收口
bash
# 1. 取源码
git clone --depth 1 https://github.com/Niko1221/Strata.git G:/strata

# 2. 建隔离 venv(绕开坏解释器 + 清空 PYTHONPATH + 原生路径)
env -u PYTHONPATH -u PYTHONHOME /f/mambaforge/python -m venv "G:/strata/.venv"

# 3. 硬件自检
env -u PYTHONPATH -u PYTHONHOME ./.venv/Scripts/python.exe setup.py --check

# 4. 安装(HuggingFace 不可达,走 ModelScope)
env -u PYTHONPATH -u PYTHONHOME \
  HF_ENDPOINT=https://hf-mirror.com STRATA_SOURCE=modelscope \
  ./.venv/Scripts/python.exe setup.py --yes --family qwen --model IQ3_S \
     --source modelscope --no-start

# 5. 启动
env -u PYTHONPATH -u PYTHONHOME ./.venv/Scripts/python.exe serve/server.py \
--engine strata --config "G:/strata/strata-iq3_s.json" --port 8080安装产物:iq_pack.py 打包出 1079 tensors(302 native,arena 1.43 GiB)、tokenizer vocab 248,320 / merges 247,587;MTP draft 量化打包 5,214 MB(31 个张量),引擎加载时读取 2,695 MiB/s、占 835 MiB 显存。磁盘占用:代码+引擎 850 MB;模型数据 86 GB,明细为 models 78 GB / mtp 6.5 GB / packs 1.5 GB。
下载源是实测选出来的,不是随手选的:
| 源 | 单连接实测 |
|---|---|
| mirrors.aliyun.com | 0.45 MB/s |
| mirrors.tuna.tsinghua.edu.cn | 1.55 MB/s |
| registry.npmmirror.com | 1.75 MB/s |
| ModelScope CDN | 3.29 MB/s(最快) |
并对 ModelScope CDN 单独做了并行扫描:1 连接 1.73 → 4 连接 4.46 → 8 连接 4.97 → 16 连接 5.26 MiB/s ,每连接速度反而下降 (1.73 → 0.22 MiB/s)。说明瓶颈是每 IP 封顶而非服务端限速------并行下载无法提速,换源也不会更快。
冷启动实测 :专家装载 46.84 GiB @ 0.24 GiB/s = 228 s,加上 GPU 专家缓存填充,到 /health 返回 loaded: true 约 3 分钟。
四、接口验收:推理验证与健壮性
部署完成不等于能用。这一章用最小代价确认三件事:接口活着、输出是真的、坏输入不会把服务搞崩。
4.1 接口自检
| 端点 | 实测响应 | 判定 |
|---|---|---|
/health |
{"status":"ok","max_context":131072,"model":"qwen3.8-flash-next-iq3_s","images":false,"api_key":false,"loaded":true,"service":"strata"} |
PASS |
/v1/models |
qwen3.8-flash-next-iq3_s,status=loaded,n_ctx=131072,输入/输出模态均为 text |
PASS |
/metrics |
返回 engine / live / requests / conversation_cache / requests_kept / totals / hardware / hardware_static 八组 | PASS |
api_key: false 说明服务只监听 127.0.0.1 且未启用密钥------这与上游安装文档的默认安全姿态一致:不设密钥就不对外暴露。
4.2 首个真实 completion
请求体:
json
{"model": "strata", "max_tokens": 200, "temperature": 0, "seed": 42,
 "reasoning_effort": "none", "cache_prompt": false,
 "messages": [{"role": "user",
"content": "Explain in three sentences why a mixture-of-experts model can run on a consumer GPU."}]}| 指标 | 实测 |
|---|---|
| HTTP | 200 |
| wall | 3.862 s |
| prompt_n / generated | 31 / 92 |
| 引擎 prefill | 56.7 tok/s |
| 引擎 decode | 27.9 tok/s |
| usage | prompt_tokens 31 / completion_tokens 92 / total_tokens 123 / cached_tokens 0 |
| finish_reason | stop |
| 输出 | 一段关于稀疏激活与「每 token 只激活一小部分参数」的正确三句解释 |
注意这个 27.9 tok/s。 它比第 5 章稳态的 64--68 tok/s 低一半以上,因为它量的是冷启动后的第一个请求。把首请求数字和稳态数字混在一起引用,是这类测试最常见的误读。
4.3 流式首 Token 复测
同一路径改用 SSE 流式,客户端独立计时:
| 指标 | 实测 |
|---|---|
| 客户端 TTFT | 1.1104 s |
| wall | 2.715 s |
这一条与第 5 章六档 sweep 里 1K 档的 1.92 s 属同一量级;差异来自提示长度(此处仅十余 token)。它顺带说明一件事:TTFT 里真正可压缩的是预填,固定开销只占很小一块。
4.4 健壮性探针
| 请求 | 实测结果 | 判定 |
|---|---|---|
空 messages 数组 |
HTTP 400 ,{"error":{"type":"invalid_request_error","message":"No messages provided."}} |
正确拒绝 |
| 正常短请求 | HTTP 200,返回 chatcmpl-edb74ab1112a4ed7bbe2371b |
正确响应 |
坏输入被明确拒绝、正常请求不受影响,没有出现「一次错误请求导致后续全部失败」的情况。
五、性能基准:首 Token、Decode、预填
5.1 测量方法(以及为什么必须说清)
基准数字只有在方法公开时才有意义。本次测量遵守以下约束:
| 约束 | 做法 |
|---|---|
| 每个测量真实读取全量提示 | 每次请求带唯一首行 + cache_prompt=false,引擎回传 cache_n = 0 |
| 预热不计入 | 每档 1 次预热 + 3 次测量,取中位 |
| 吞吐来源 | 取引擎自身的 timings(prompt_per_second / predicted_per_second) |
| 首 Token 延迟 | 客户端 SSE 独立实测,不取服务端自报值 |
| 思考模式固定 | reasoning_effort: none,避免思考 token 长度污染对比 |
5.2 六档实测
| 提示长度 | 实际 prompt tokens | Prefill 中位 (tok/s) | Decode 中位 (tok/s) | Decode 区间 | 客户端 TTFT 中位 |
|---|---|---|---|---|---|
| 1K | 1,035 | 593.1 | 55.4 | 53.4 -- 59.7 | 1.92 s |
| 4K | 4,226 | 685.8 | 37.8 | 36.1 -- 45.5 | 5.98 s |
| 16K | 17,662 | 1,214.7 | 91.9 | 56.2 -- 101.4 | 15.58 s |
| 32K | 33,349 | 1,232.7 | 70.2 | 67.5 -- 98.9 | 28.54 s |
| 64K | 63,910 | 1,065.6 | 87.3 | 82.1 -- 105.7 | 62.57 s |
| 128K | 128,846 | 1,032.6 | 65.4 | 54.2 -- 65.5 | 131.41 s |
5.3 原始数据里的一个形态差异:长档位以 tool_calls 收尾
这一条不属于性能规律,但不该被忽略:32K / 64K / 128K 三档的 finish_reason 全部是 tool_calls,而 1K / 4K / 16K 是 stop 或 length。 长提示之下,模型倾向以工具调用形式收尾,而不是直接给出文本结尾。
这意味着长档位统计的「生成 token 数」里包含工具调用的 JSON 结构,与其他档位不是同一种输出形态------跨档比较 decode 时,这一点同样要纳入考虑。
5.4 三条可解释的规律,以及一条必须承认的缺陷
规律一:预填在 16K 附近翻倍。
bash
686 tok/s (4K)  →  1,215 tok/s (16K)  ≈ 1.8 倍

原因:预填分块策略在长提示上切换到大分块
     短提示逐块读,长提示按最大 8,192 token/块吞吐
     拐点实测落在 4K 与 16K 之间
规律二:64K 之后预填回落。
scss
1,233 (32K) → 1,066 (64K) → 1,033 (128K)

原因:--kv-resident 32768 只把前 32K 的 KV 锁在显存
     超出部分走 RAM 流式,预填需要逐块取 KV
     这是"显存换容量"的显式代价
规律三:TTFT ≈ 预填时间 + 常数。
scss
1K  → 1.92 s      (1,035 / 593  ≈ 1.75 s)
32K → 28.54 s     (33,349 / 1,233 ≈ 27.0 s)
128K → 131.41 s   (128,846 / 1,033 ≈ 124.8 s)

TTFT 基本等于把提示读一遍的时间,与"约每分钟读 30,000 token"的估计一致
必须承认的缺陷:Decode 的跨长度对比不可靠。
上表里 4K 的 37.8 低于 16K 的 91.9,看起来反直觉。两个原因,都不是「16K 更快」:
arduino
原因一:投机接受率随内容而变
  MTP 候选是否被接受,取决于待生成文本的可预测性
  不同 run 生成内容不同 → decode 天然波动
  → 跨长度比较只能作参考
  → 同档 min-max 区间才是它真实的不确定范围(如 16K:56.2-101.4)

原因二:"缓存未热"这个解释不成立
  看似可以怪 4K 测得早、缓存还没热,但原始数据不支持:
  1K 的 3 次测量排在 4K 之前,decode 反而更高(53.4-59.7 vs 36.1-45.5)
  若真是冷启动所致,更早的 1K 应该更慢 ------ 事实相反
  → 4K 的低值同样只能归因于投机接受率的 run 间波动
结论:不要把 decode 当作随上下文长度单调变化的曲线来解读。它的分母里有一个依赖生成内容的变量(投机接受率),而它既不正比于提示长度,也不随缓存变热而单调上升。
六、长上下文:全深度召回的意义
6.1 测什么
「支持 128K 上下文」这句话本身没有信息量------真正要问的是:第 100K 个 token 上的信息,模型在输出时还能不能用? 于是用大海捞针:从仓库源码与文档构造长文,把暗号插进 10%/50%/90% 三个位置,贪心解码、关闭思考,问暗号。
6.2 结果:9/9
| 长度 | prompt tokens | depth 10% | depth 50% | depth 90% |
|---|---|---|---|---|
| 8K | 8,064 | ✅ FOUND(9.7 s) | ✅ FOUND(9.6 s) | ✅ FOUND(8.3 s) |
| 32K | 32,894 | ✅ FOUND(38.3 s) | ✅ FOUND(41.3 s) | ✅ FOUND(21.3 s) |
| 128K | 125,833 | ✅ FOUND(147.7 s) | ✅ FOUND(185.6 s) | ✅ FOUND(162.1 s) |
6.3 为什么「全深度命中」比「128K 支持」更有价值
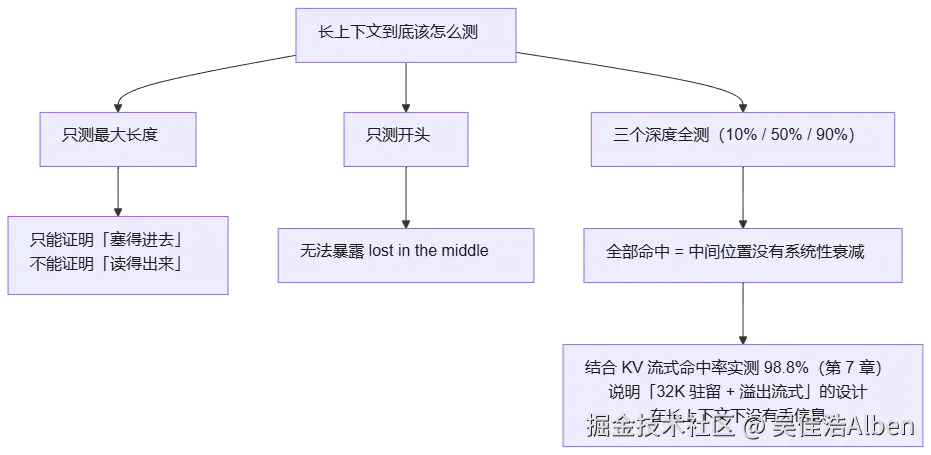
KV 命中率 98.8% 是这里的关键旁证。 它告诉我们:虽然 KV 在 32K 之后是流式的,但流式窗口的局部性好到几乎没有真的从 RAM 里读------这也是长上下文召回能全命中的系统层原因。
七、硬件资源占用:瓶颈的定量定位
采样 1 Hz,基准阶段 2,400 s / 2,280 个采样点。
| 指标 | min | 中位 | max | 解读 |
|---|---|---|---|---|
| VRAM 占用 | 31,556 MiB | 31,747 MiB | 31,938 MiB | 总 32,607 MiB → 97.4% 打满 |
| GPU 利用率 | 1% | 99% | 100% | mean 85.3%(请求间隙归零拉低) |
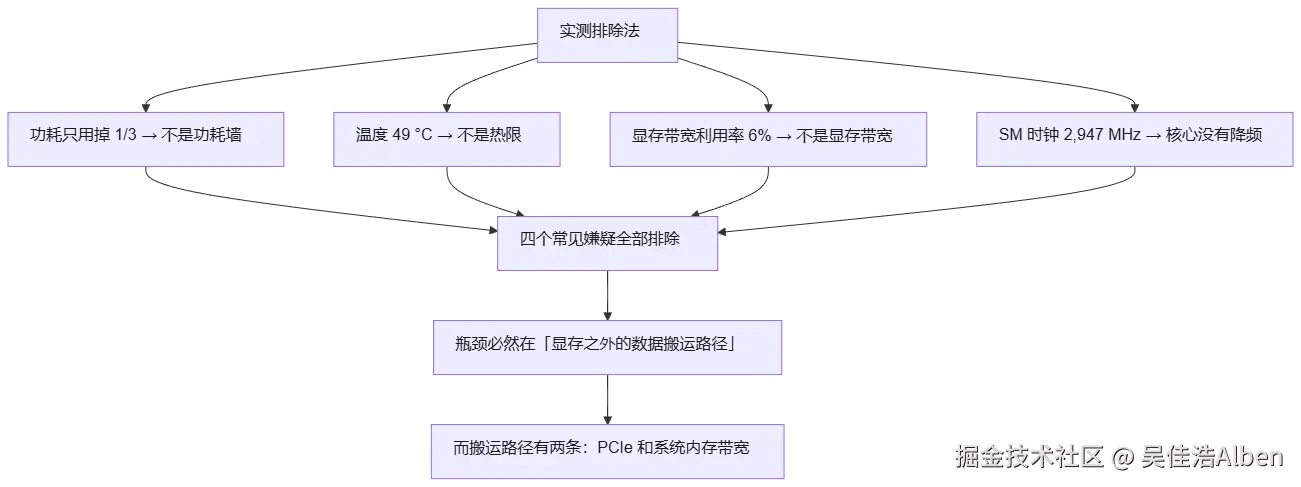
| 显存控制器利用率 | 0% | 6% | 21% | 显存带宽不是瓶颈 |
| 功耗 | 75 W | 192.6 W | 265 W | 上限 600 W → 仅用 32--44% |
| 温度 | 39 °C | 49 °C | 55 °C | 远未触发热限 |
| 系统 RAM | 75.8 GiB | 78.5 GiB | 81.2 GiB | 94 GB 的 83.7% |
| SM 时钟 | 2,602 MHz | 2,947 MHz | 2,962 MHz | 接近满频 |
第二份采样覆盖长上下文与稳定性阶段(750 点 / 789.9 s),数字与基准阶段一致,说明这套负载下的资源画像稳定,不是某一阶段的偶发读数:
| 指标 | 中位 | max |
|---|---|---|
| VRAM 占用 | 31,573 MiB | 31,657 MiB |
| GPU 利用率 | 99% | 100% |
| 功耗 | 180.6 W | 213.4 W |
| 温度 | 49 °C | 52 °C |
| 系统 RAM | 75.9 GiB | 76.6 GiB |
7.1 这组数字是在做排除法
7.2 引擎自身的运行统计给出更硬的证据
sql
decode expert cache hit rate: 95.3% (58084 hits / 60919 lookups)
                             91.3% (52751 hits / 57749 lookups)
   → 2.4% / 5.3% 的专家走 PCIe 取,而非 VRAM
KV streaming: 98.83% / 98.67% of block reads hit VRAM
   → 仅 1.5 MiB 来自 RAM
strata serve: 96 MiB of VRAM free with everything loaded - LOW:
   requests may stall; add --vram-reserve-mib 1116 to the config's args
三条读出来的事实:
| 事实 | 数值 | 含义 |
|---|---|---|
| 专家缓存命中率 | 91--95% | 绝大多数专家在 VRAM;但 2.4--5.3% 要走 PCIe |
| KV 流式命中率 | 98.8% | 长上下文几乎全部命中显存,设计有效 |
| 显存余量告警 | 仅剩 96 MiB | 低于引擎建议的 700 MiB 保留,存在潜在卡顿 |
命中率背后藏着一个更值得算的数字
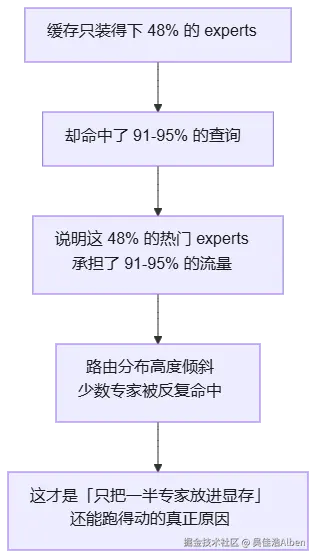
把命中率和缓存容量放在一起看,能推出一个不显眼、但决定优化方向的事实:
缓存覆盖率=24,57611,784=48.0%实测命中率=91.3%∼95.3%
两者之间的落差,就是路由分布的偏斜程度:
再算单次未命中的搬运成本:
单个 expert 体积=11,78422.36 GiB≈1.94 MiB
而 PCIe 5.0 的理论单向带宽是 ×16 约 63 GB/s、×8 约 31.5 GB/s。这台机器的专家搬运通道,上限只有标准配置的一半------而它承载的偏偏是「把模型从内存搬进显存」这个唯一的性能决定因素。
这组数字合起来指向同一个结论:优化这台机器的正确方向不是提高算力,而是提高这 48% 的命中率、或拓宽这条 PCIe 通道。
7.3 PCIe 才是这台机器的短板
引擎自检与驱动查询双向印证了同一个事实:
ini
[引擎自检] the GPU's PCIe link reads 8 of its 16 lanes right now
[nvidia-smi] pcie.link.gen.current = 5
             pcie.link.width.current = 8
             pcie.link.width.max = 16
Gen5 ×8 意味着理论上限只有 ×16 的一半。而专家搬运正好跑在这条链路上------2.4--5.3% 的专家要走 PCIe,这部分带宽被砍半。
这里需要把「实测」与「推测」分开说清:
- 实测:链路确实跑在 ×8;专家 2.4--5.3% 走 PCIe;功耗/温度/显存带宽都远未饱和。
- 推测(需修好插槽后 A/B 才能定量):修到 ×16 应当有收益,但具体增益本文不宣称。仓库另一份同型号参考(RTX 5090 + 5800 系列 CPU,PCIe Gen4 ×16)用同量化档跑出约 1,200 tok/s 预填,与本机 Gen5 ×8 接近;这既可能说明预填主要受 CPU/分块策略约束,也可能说明对照条件不够干净,不足以据此下结论。
八、稳定性与并发:排队语义的实证
8.1 连续请求:0 错误,但有冷启动爬坡
12 次连续请求(256 token 上限),12/12 成功、0 错误。但要报告一个现象:
arduino
run 1: 29.9 tok/s     run 2: 48.8     run 3: 56.4     run 4: 58.5
run 5: 64.3           run 6-12: 63.9 - 67.7(稳定平台)

前 4-5 次请求比稳态慢 30-55%,之后稳定在 64-68 tok/s
decode 中位 64.2 tok/s,含爬坡的 CV 17.3%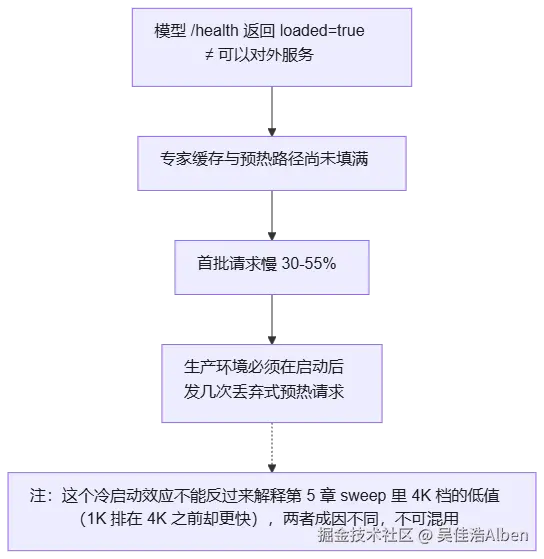
另外两个只有翻原始 run 才看得见的细节:
- 短请求从第 2 次起就复用了前缀缓存 :run 1 是
prompt_n=36 / cache_n=0,run 2--12 变成prompt_n=7 / cache_n=29。这 12 次「连续请求」里只有第 1 次是真正全量读取提示的,后 11 次都吃了会话前缀缓存------读上面那组数字时需要知道这一点。 - 12 次请求只产生了 6 个不同输出 (sha256 去重后)。每次请求的 seed 不同(100--111),输出随之变化;
deterministic=False是测试设计的结果,不构成引擎不确定性的证据。
8.2 并发扫描:吞吐不涨,延迟线性拉长
| 并发 | 聚合吞吐 | 请求延迟中位 | 首次延迟 | 错误 |
|---|---|---|---|---|
| 1 worker | 64.04 tok/s | 4.03 s | 3.82 s | 0 |
| 2 workers | 63.72 tok/s | 8.03 s | 3.97 s | 0 |
| 4 workers | 60.47 tok/s | 16.47 s | 4.11 s | 0 |
arduino
1 → 2 → 4 workers
聚合吞吐:64.04 → 63.72 → 60.47   (几乎不变,甚至略降)
延迟中位:4.03  → 8.03  → 16.47   (严格线性)
首次延迟:3.82  → 3.97  → 4.11    (不变)

结论:并发不提升吞吐,只排队
      每 worker 的首个请求立即执行,其余顺序等待
      这是引擎默认"一次处理一个请求"语义的直接证据
原始量如下:c1 生成 768 token / 11.99 s,c2 1536 token / 24.11 s,c4 3072 token / 50.8 s;单请求 decode 中位分别为 65.1 / 65.95 / 62.65 tok/s。单请求速度几乎不变,变的只是等待时长,与上面的结论一致。
这解释了为什么不能靠加客户端来解决慢的问题 :单张显卡的专家搬运带宽是共享的,多客户端只会把等待拉长。真要并行,必须显式开 --parallel 并用显存换(每槽约 0.6 GB VRAM,从专家缓存里扣)。
九、优化建议与工程取舍
按预期收益排序,每条都给出依据与代价。
| # | 建议 | 依据 | 代价 / 验证方式 |
|---|---|---|---|
| 1 | PCIe 从 ×8 修到 ×16 | 引擎自检 + nvidia-smi 双向确认 width.current=8 / max=16;2.4--5.3% 专家走 PCIe |
零金钱成本,一次开机。检查插槽是否 CPU 直连 ×16、是否与 M.2 共享 lane、BIOS bifurcation |
| 2 | 加 --vram-reserve-mib 1116 |
引擎自身告警:仅剩 96 MiB,低于建议的 700 MiB 保留 | 少放一点专家或降 --max-context;消除长尾卡顿 |
| 3 | 试 --prefill auto:32768 |
仓库同型号参考实测在 14.7K--28.9K 提示上比 auto 快 14--25%,不影响 decode;本机预填拐点恰在 4K→16K 之间 |
改一个参数后 A/B |
| 4 | 启动后预热再对外服务 | 实测前 4--5 次请求慢 30--55% | 启动脚本加几次丢弃式请求 |
| 5 | 多客户端时配 --conversation-cache-mib 8192 |
上游 setup 自己提示:不加会重读约 90% 的提示 | 占少量显存 |
| 6 | KV 显存化的取舍 | 64K 后预填从 1,233 掉到 1,066/1,033,因 32K 以上 KV 走 RAM | 放大 --kv-resident,或改 --kv q4_0(576 B/cell vs 1,056)用少量精度换更多 KV 驻留 |
| 7 | 单用户保持 parallel=1 |
实测并发 64.0 → 63.7 → 60.5,吞吐不涨延迟线性涨 | 多客户端才开 --parallel 2 |
| 8 | 不要做功耗墙 / 超频调优 | 193--265 W of 600 W、49 °C,离限值很远 | 调这些没有收益 |
| 9 | 可选:--calibrate |
会实测几个引擎参数并保留最快组合,仓库在 Coder 上实测 +7% | 5--10 分钟 |
9.1 显存与长上下文的取舍矩阵
这是 Spill 架构下最核心的一组工程取舍,值得单独列出来:
| 目标 | 调整方向 | 收益 | 代价 |
|---|---|---|---|
| 更快的 decode | 让更多专家进 VRAM | 专家命中率↑,PCIe 流量↓ | 得从别处让出显存 |
| 更长的可用上下文 | --max-context↑ |
能塞更多文本 | KV 变多,挤占专家缓存 |
| 长提示预填更快 | --kv-resident↑ |
减少 KV 流式 | 挤占专家缓存 |
| 省显存 | --kv q4_0 |
每 cell 1,056 → 576 字节 | KV 精度下降 |
| 多客户端 | --parallel 2 |
能同时解码 | 每槽约 0.6 GB 显存,单请求变慢 |
这五个目标互相挤压同一块 31.8 GiB 的显存。 没有全局最优解,只有针对具体工作负载的最优解------这也是为什么第 9 条 --calibrate 值得跑:它用实测代替猜。
9.2 要不要换更小的量化档?
本文只测了 IQ3_S。换 Q2_0 / IQ2_XS 会把体积降到 66--68 GB,但:
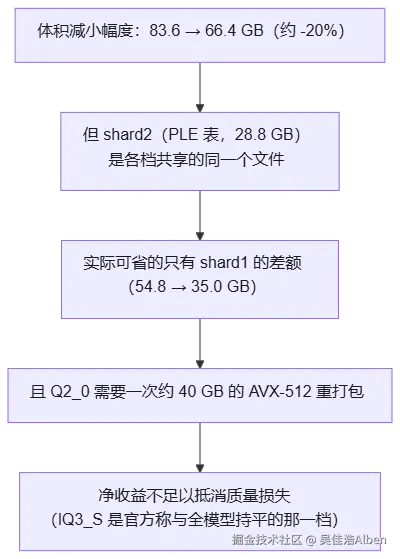
所以本文的选择是 IQ3_S,而不是"能跑就行"的最小档。
十、总结
核心推导链
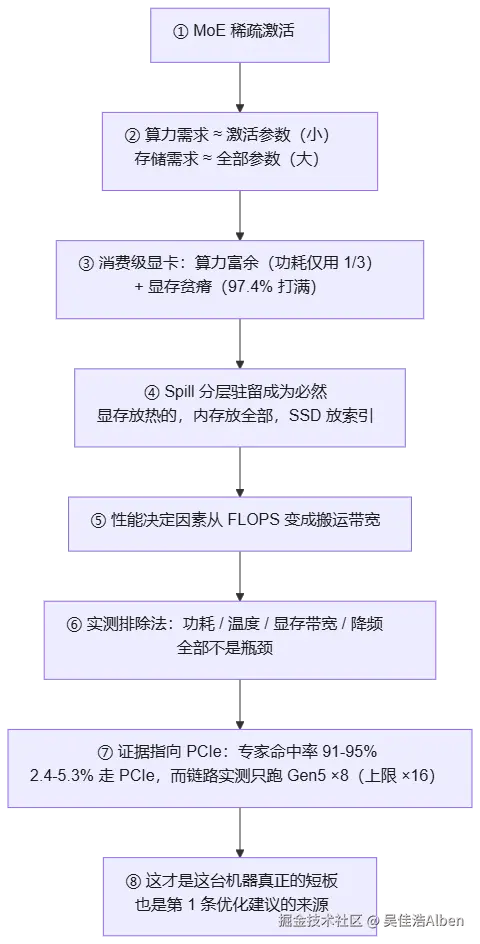
一句关键判断
消费级显卡跑 125B MoE,难的不是让它算得动------它算得动,功耗只用掉三分之一; 难的是让数据搬得动。所以真正的调优点不在算力,而在搬运路径:PCIe 宽度、专家缓存命中率、KV 驻留策略。
全部实测数据一览
| 类别 | 关键结果 |
|---|---|
| 首 Token 延迟 | 1.92 s(1K)· 28.54 s(32K)· 131.41 s(128K) |
| Decode | 稳态 64--68 tok/s;单次区间 53--106 tok/s |
| Prefill | 593(1K)→ 1,233(32K) → 1,033 tok/s(128K) |
| 长上下文召回 | 8K/32K/128K × 深度 10/50/90% = 9/9 全命中 |
| KV 流式命中率 | 98.8%(仅 1.5 MiB 来自 RAM) |
| 专家缓存命中率 | 91--95% |
| 稳定性 | 12/12 成功、0 错误;前 4--5 次慢 30--55%(冷启动) |
| 并发 | 1/2/4 workers 聚合 64.0 → 63.7 → 60.5,延迟 4.0 → 8.0 → 16.5 s |
| 资源占用 | VRAM 31,747 / 32,607 MiB(97.4%) 、GPU 99%、功耗 192.6 W / 600 W、49 °C、RAM 78.5 / 94 GiB |
| 冷启动 | 专家装载 46.84 GiB @ 0.24 GiB/s = 228 s;到 /health 就绪约 3 分钟 |
本文的测量限制
列出这些是为了让上面的数字能被正确使用:
- Decode 跨长度不可直接比较:受投机接受率与缓存热度影响(5.4)。
- 4K 档 decode 偏低的原因未定论:曾归因于「测量顺序靠前、缓存未热」,但排在其前的 1K 反而更快,该解释不成立;剩余最可能的解释是投机接受率的 run 间波动。
- 未做固定 seed 的确定性测试 :稳定性测试中每次请求换了 seed,
deterministic=False属测试设计所致,不构成引擎不确定性的证据。 - 只测了 IQ3_S 一档,不能跨量化档外推。
- 没有与 llama.cpp 等其他引擎横向对比:表中全部是 Strata 的绝对值。
- 未测多卡、未测 vision (本次部署
images: off)。 - 资源采样率 1 Hz:亚秒级尖峰可能漏采。
- 客户端 TTFT 含 HTTP 与分词开销 :服务端自身的
prompt_ms已随每次请求记录,可交叉核对。 - 单机、单网络环境:下载速率受本机出口带宽限制(实测聚合封顶约 5.26 MiB/s,16 条并行连接不提速 → 每 IP 封顶),与引擎本身无关。
附录一:六档 sweep 的全部原始 run
正文取的是中位与区间;这里是 18 次测量的每一个原始值,包含服务端自报的 prompt_ms(预填耗时)、每次实际生成的 token 数与 finish_reason。
| 档位 | run | prompt_n | prefill tok/s | 服务端 prompt_ms | 生成 tok | decode tok/s | wall s | 客户端 TTFT s | finish_reason |
|---|---|---|---|---|---|---|---|---|---|
| 1k | 1 | 1,035 | 611.3 | 1,693.1 | 130 | 53.4 | 4.14 | 1.9411 | stop |
| 1k | 2 | 1,035 | 566.1 | 1,828.3 | 130 | 55.4 | 4.186 | 1.9209 | stop |
| 1k | 3 | 1,035 | 593.1 | 1,745.2 | 130 | 59.7 | 3.942 | 1.8609 | stop |
| 4k | 1 | 4,226 | 689.3 | 6,131.1 | 142 | 45.5 | 9.277 | 6.323 | stop |
| 4k | 2 | 4,226 | 685.8 | 6,161.7 | 256 | 36.1 | 13.267 | 5.5384 | length |
| 4k | 3 | 4,226 | 674.7 | 6,263.9 | 179 | 37.8 | 11.023 | 5.9789 | stop |
| 16k | 1 | 17,662 | 637.6 | 27,701.5 | 222 | 56.2 | 31.725 | 17.6846 | stop |
| 16k | 2 | 17,662 | 1214.7 | 14,540.7 | 224 | 101.4 | 16.817 | 14.953 | stop |
| 16k | 3 | 17,662 | 1236.8 | 14,279.9 | 222 | 91.9 | 16.754 | 15.5758 | stop |
| 32k | 1 | 33,349 | 1243.6 | 26,816.2 | 94 | 67.5 | 28.33 | 28.538 | tool_calls |
| 32k | 2 | 33,349 | 1208.2 | 27,601.6 | 186 | 70.2 | 30.367 | 28.8359 | tool_calls |
| 32k | 3 | 33,349 | 1232.7 | 27,052.6 | 170 | 98.9 | 28.87 | 26.7174 | tool_calls |
| 64k | 1 | 63,910 | 1065.6 | 59,975.7 | 42 | 105.7 | 60.57 | 66.1798 | tool_calls |
| 64k | 2 | 63,910 | 949.6 | 67,302.2 | 51 | 82.1 | 68.127 | 60.2617 | tool_calls |
| 64k | 3 | 63,910 | 1141.2 | 56,001.4 | 60 | 87.3 | 56.906 | 62.5729 | tool_calls |
| 128k | 1 | 128,846 | 1032.6 | 124,777.3 | 143 | 65.4 | 127.379 | 144.1314 | tool_calls |
| 128k | 2 | 128,846 | 1098.6 | 117,283.6 | 49 | 54.2 | 118.608 | 131.4074 | tool_calls |
| 128k | 3 | 128,846 | 1008.7 | 127,738.9 | 179 | 65.5 | 130.893 | 118.2726 | tool_calls |
附录二:稳定性与并发的全部原始数据
连续 12 次请求
| # | prompt_n | cache_n | 生成 tok | decode tok/s | wall s | finish_reason | 输出 sha256 |
|---|---|---|---|---|---|---|---|
| 1 | 36 | 0 | 256 | 29.9 | 9.519 | length |
3d068a586493adb3 |
| 2 | 7 | 29 | 256 | 48.8 | 5.35 | length |
63afd2f37fa5e99e |
| 3 | 7 | 29 | 256 | 56.4 | 4.61 | length |
813cae4bc5639853 |
| 4 | 7 | 29 | 256 | 58.5 | 4.473 | length |
97c0e665f97ca853 |
| 5 | 7 | 29 | 256 | 64.3 | 4.113 | length |
0a2bcb27d08ab6c8 |
| 6 | 7 | 29 | 256 | 66.6 | 3.954 | length |
813cae4bc5639853 |
| 7 | 7 | 29 | 256 | 65.7 | 3.977 | length |
09553781c46164ea |
| 8 | 7 | 29 | 256 | 63.9 | 4.114 | length |
09553781c46164ea |
| 9 | 7 | 29 | 256 | 67.7 | 3.855 | length |
3d068a586493adb3 |
| 10 | 7 | 29 | 256 | 64.5 | 4.106 | length |
63afd2f37fa5e99e |
| 11 | 7 | 29 | 256 | 64.1 | 4.095 | length |
813cae4bc5639853 |
| 12 | 7 | 29 | 256 | 64.4 | 4.072 | length |
3d068a586493adb3 |
并发扫描(每 worker 3 次请求)
| 并发 | 聚合 tok/s | 请求数 | tokens | span s | 延迟 min | 延迟 中位 | 延迟 P90 | 延迟 max | 单请求 decode 中位 | 错误 |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 64.04 | 3 | 768 | 11.99 | 3.82 | 4.03 | 4.029 | 4.133 | 65.1 | 0 |
| 2 | 63.72 | 6 | 1536 | 24.11 | 3.966 | 8.03 | 8.128 | 8.142 | 65.95 | 0 |
| 4 | 60.47 | 12 | 3072 | 50.8 | 4.109 | 16.47 | 17.638 | 17.713 | 62.65 | 0 |
长上下文召回明细
| 长度 | 深度 | prompt tokens | 耗时 s | 命中 |
|---|---|---|---|---|
| 8k | 10% | 8,064 | 9.7 | ✅ FOUND |
| 8k | 50% | 8,064 | 9.6 | ✅ FOUND |
| 8k | 90% | 8,065 | 8.3 | ✅ FOUND |
| 32k | 10% | 32,896 | 38.3 | ✅ FOUND |
| 32k | 50% | 32,894 | 41.3 | ✅ FOUND |
| 32k | 90% | 32,894 | 21.3 | ✅ FOUND |
| 128k | 10% | 125,833 | 147.7 | ✅ FOUND |
| 128k | 50% | 125,833 | 185.6 | ✅ FOUND |
| 128k | 90% | 125,834 | 162.1 | ✅ FOUND |
包主:这台机器的数字就摆在这里了。如果你也在消费级显卡上跑过大 MoE,欢迎把你的专家缓存命中率、PCIe 宽度和 decode 数字发给我