大家好,我是孟健。今天刚结束本地开发工作流的压测调试,坐下来整理这篇记录。
很多同行经常问我:本地跑大模型写代码,到底能不能替代云端 API?如果你的印象还停留在本地 27B 模型只能吐出 14 tok/s、光是等补全就足以打断思路的阶段,那么这套基于投机解码与底层计算图优化的方案,值得你重新算一笔账。
这篇文章面向正在搭建本地 AI 辅助编程环境、关注推理延迟与代码资产隐私的工程师。看完本文,你不仅能理清 27B 模型在工作站硬件上跨越到近 160 tok/s 的底层链路,还能看清当前参数量下的代码质量边界与硬件选型成本。
01、本地 27B 模型的吞吐瓶颈:从 14 tok/s 说起
在日常工程交付中,云端代码补全 API 最大的痛点从来不是单次调用的费用,而是代码资产出境的合规风险与网络往返带来的断流感。但退回本地部署,往往又会陷入算力墙的尴尬。
据相关开发者实测数据,在配备 M3 Ultra 的 Mac Studio 上通过 Ollama 跑 Qwen3.8-27B Q4_K_M,模型权重占用约 17 GB,实测常规持续生成速度仅维持在 14 tok/s 上下。在单 token 交互场景下,这个速率不仅谈不上无感,甚至会严重干扰开发者的心流。
显存放得下只是及格线,生成延迟能不能咬住键盘敲击的节奏才是真正的分水岭。
常规自回归解码受限于内存带宽(Memory Bandwidth Bound),每一次生成都需要把全部权重完整搬运一遍。这决定了如果只依赖传统单步推理,仅靠硬堆消费级硬件,解码延迟根本拉不开质的差距。
02、拆解 159.4 tok/s:投机解码与引擎层的系统重构
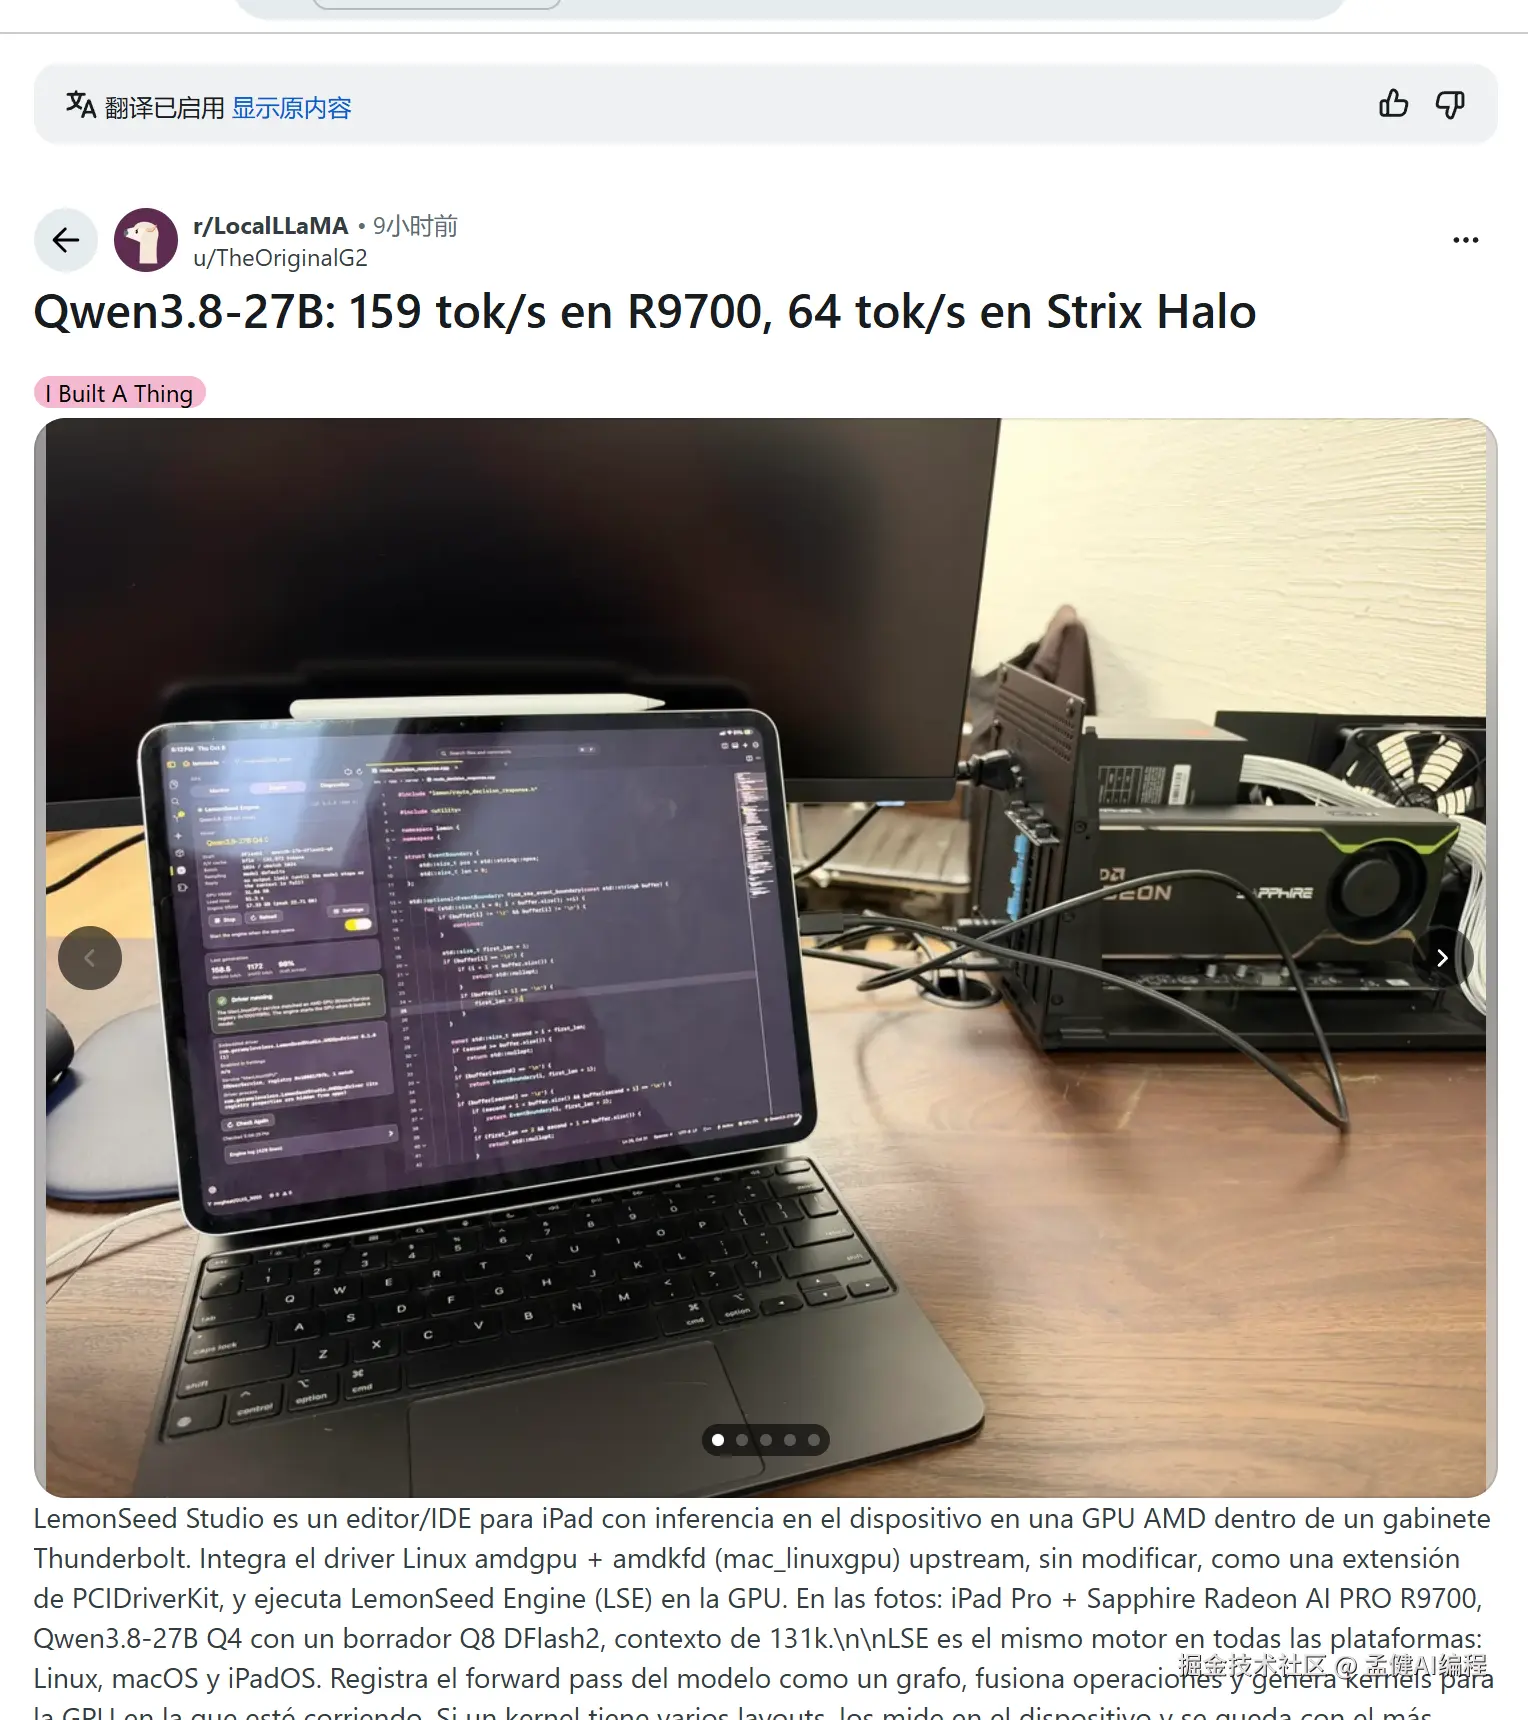
改变发生在 2026 年 10 月 9 日 Reddit 社区披露的一组基准数据中。测试者在专业工作站显卡 Sapphire Radeon AI PRO R9700 上,使用 LemonSeed Engine (LSE 0.5.8) 搭配 Q8 DFlash2 投机解码机制,驱动 Qwen3.8-27B Q4 跑出了令人意外的吞吐成绩:
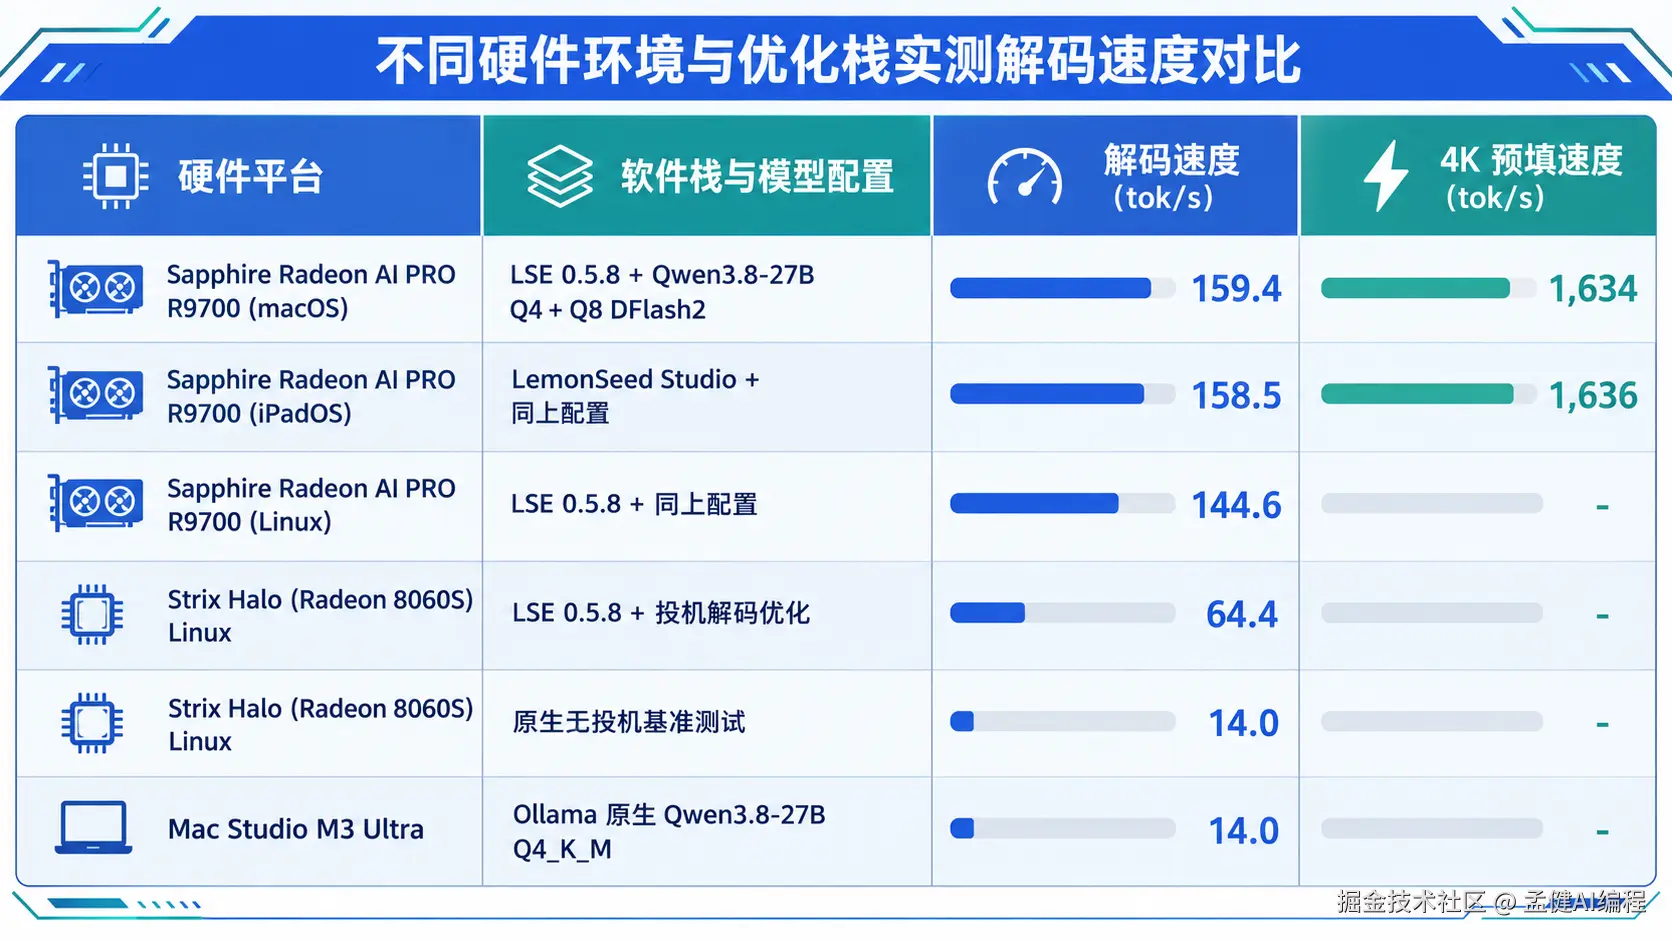
在 macOS 下,代码提示解码速度达到 159.4 tok/s;在 iPadOS(LemonSeed Studio)下测得 158.5 tok/s;在 Linux 环境下测得 144.6 tok/s。而在 Strix Halo (Radeon 8060S) 移动平台上,同配置解码速度也达到了 64.4 tok/s,相比该芯片 14.0 tok/s 的原生基准翻了数倍。
很多开发者误以为这是纯粹的显卡算力突破。跑出高帧率不等于算力无中生有,极致吞吐的本质是对硬件计算特征的精准裁剪与调度。
这里的质变依赖于两层关键工程改造:
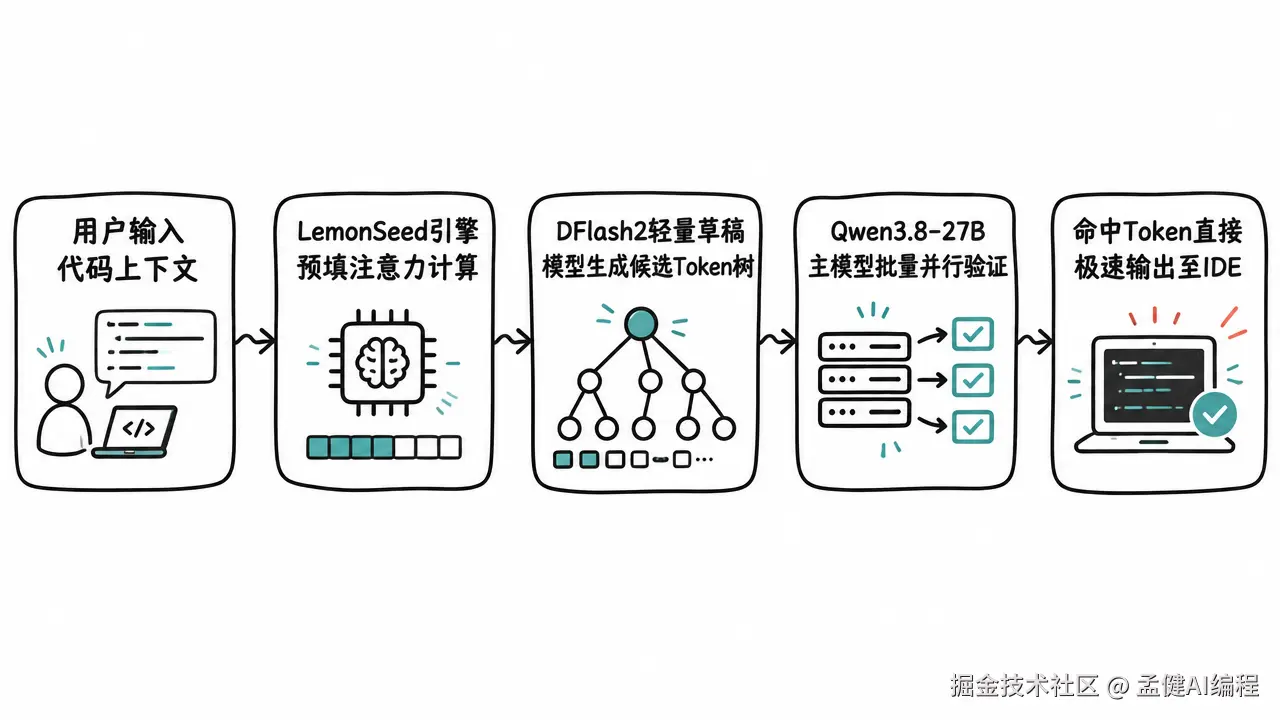
第一层是投机解码(Speculative Decoding)。系统引入 Q8 精度的 DFlash2 小模型作为 Draft Model 预测候选词树,再由 27B 目标模型在单次前向传播中并行验证整棵草稿树。由于代码语法结构具有极高的局部确定性,草稿接受率大幅提升,原本受内存带宽约束的串行解码被转化为受计算单元约束的并行验证。
第二层是引擎级算子融合。LemonSeed Engine 0.5.8 默认开启了草稿树验证,并在 Strix Halo (gfx1151) 架构上针对性实现了 gate/up GEMM 算子融合,配合预填注意力阶段的双查询瓦片(Dual-Query Tiling)优化。数据表明,其在 Sapphire Radeon AI PRO R9700 上的 4K 上下文预填速度达到了 1,634 tok/s(macOS),即便扩展到 32K 长上下文,预填速度依然保持在 1,401 tok/s。
bash
# LemonSeed Engine 0.5.8 典型环境配置启动示例
lse-serve \
  --model qwen3.8-27b-q4.gguf \
  --draft-model dflash2-q8.gguf \
  --enable-gemm-fusion \
  --context-size 32768 \
  --threads 8
通过将小模型草稿与大模型单步并行校验结合,推理延迟被压缩进了 10 毫秒以内的感知盲区,这也让本地实时行内补全具备了工程可用性。
03、降温时刻:代码质量评分与硬件投入的安全边际
看到 159 tok/s 的数字,很多团队可能会冲动地下单硬件,试图立刻全面替换云端 Claude 或 GPT 代码栈。但作为技术管理者,我们需要主动为技术狂热降温,回到客观指标来算账。
速度快不等于可用性高,推理吞吐从来不代表逻辑推理上限。
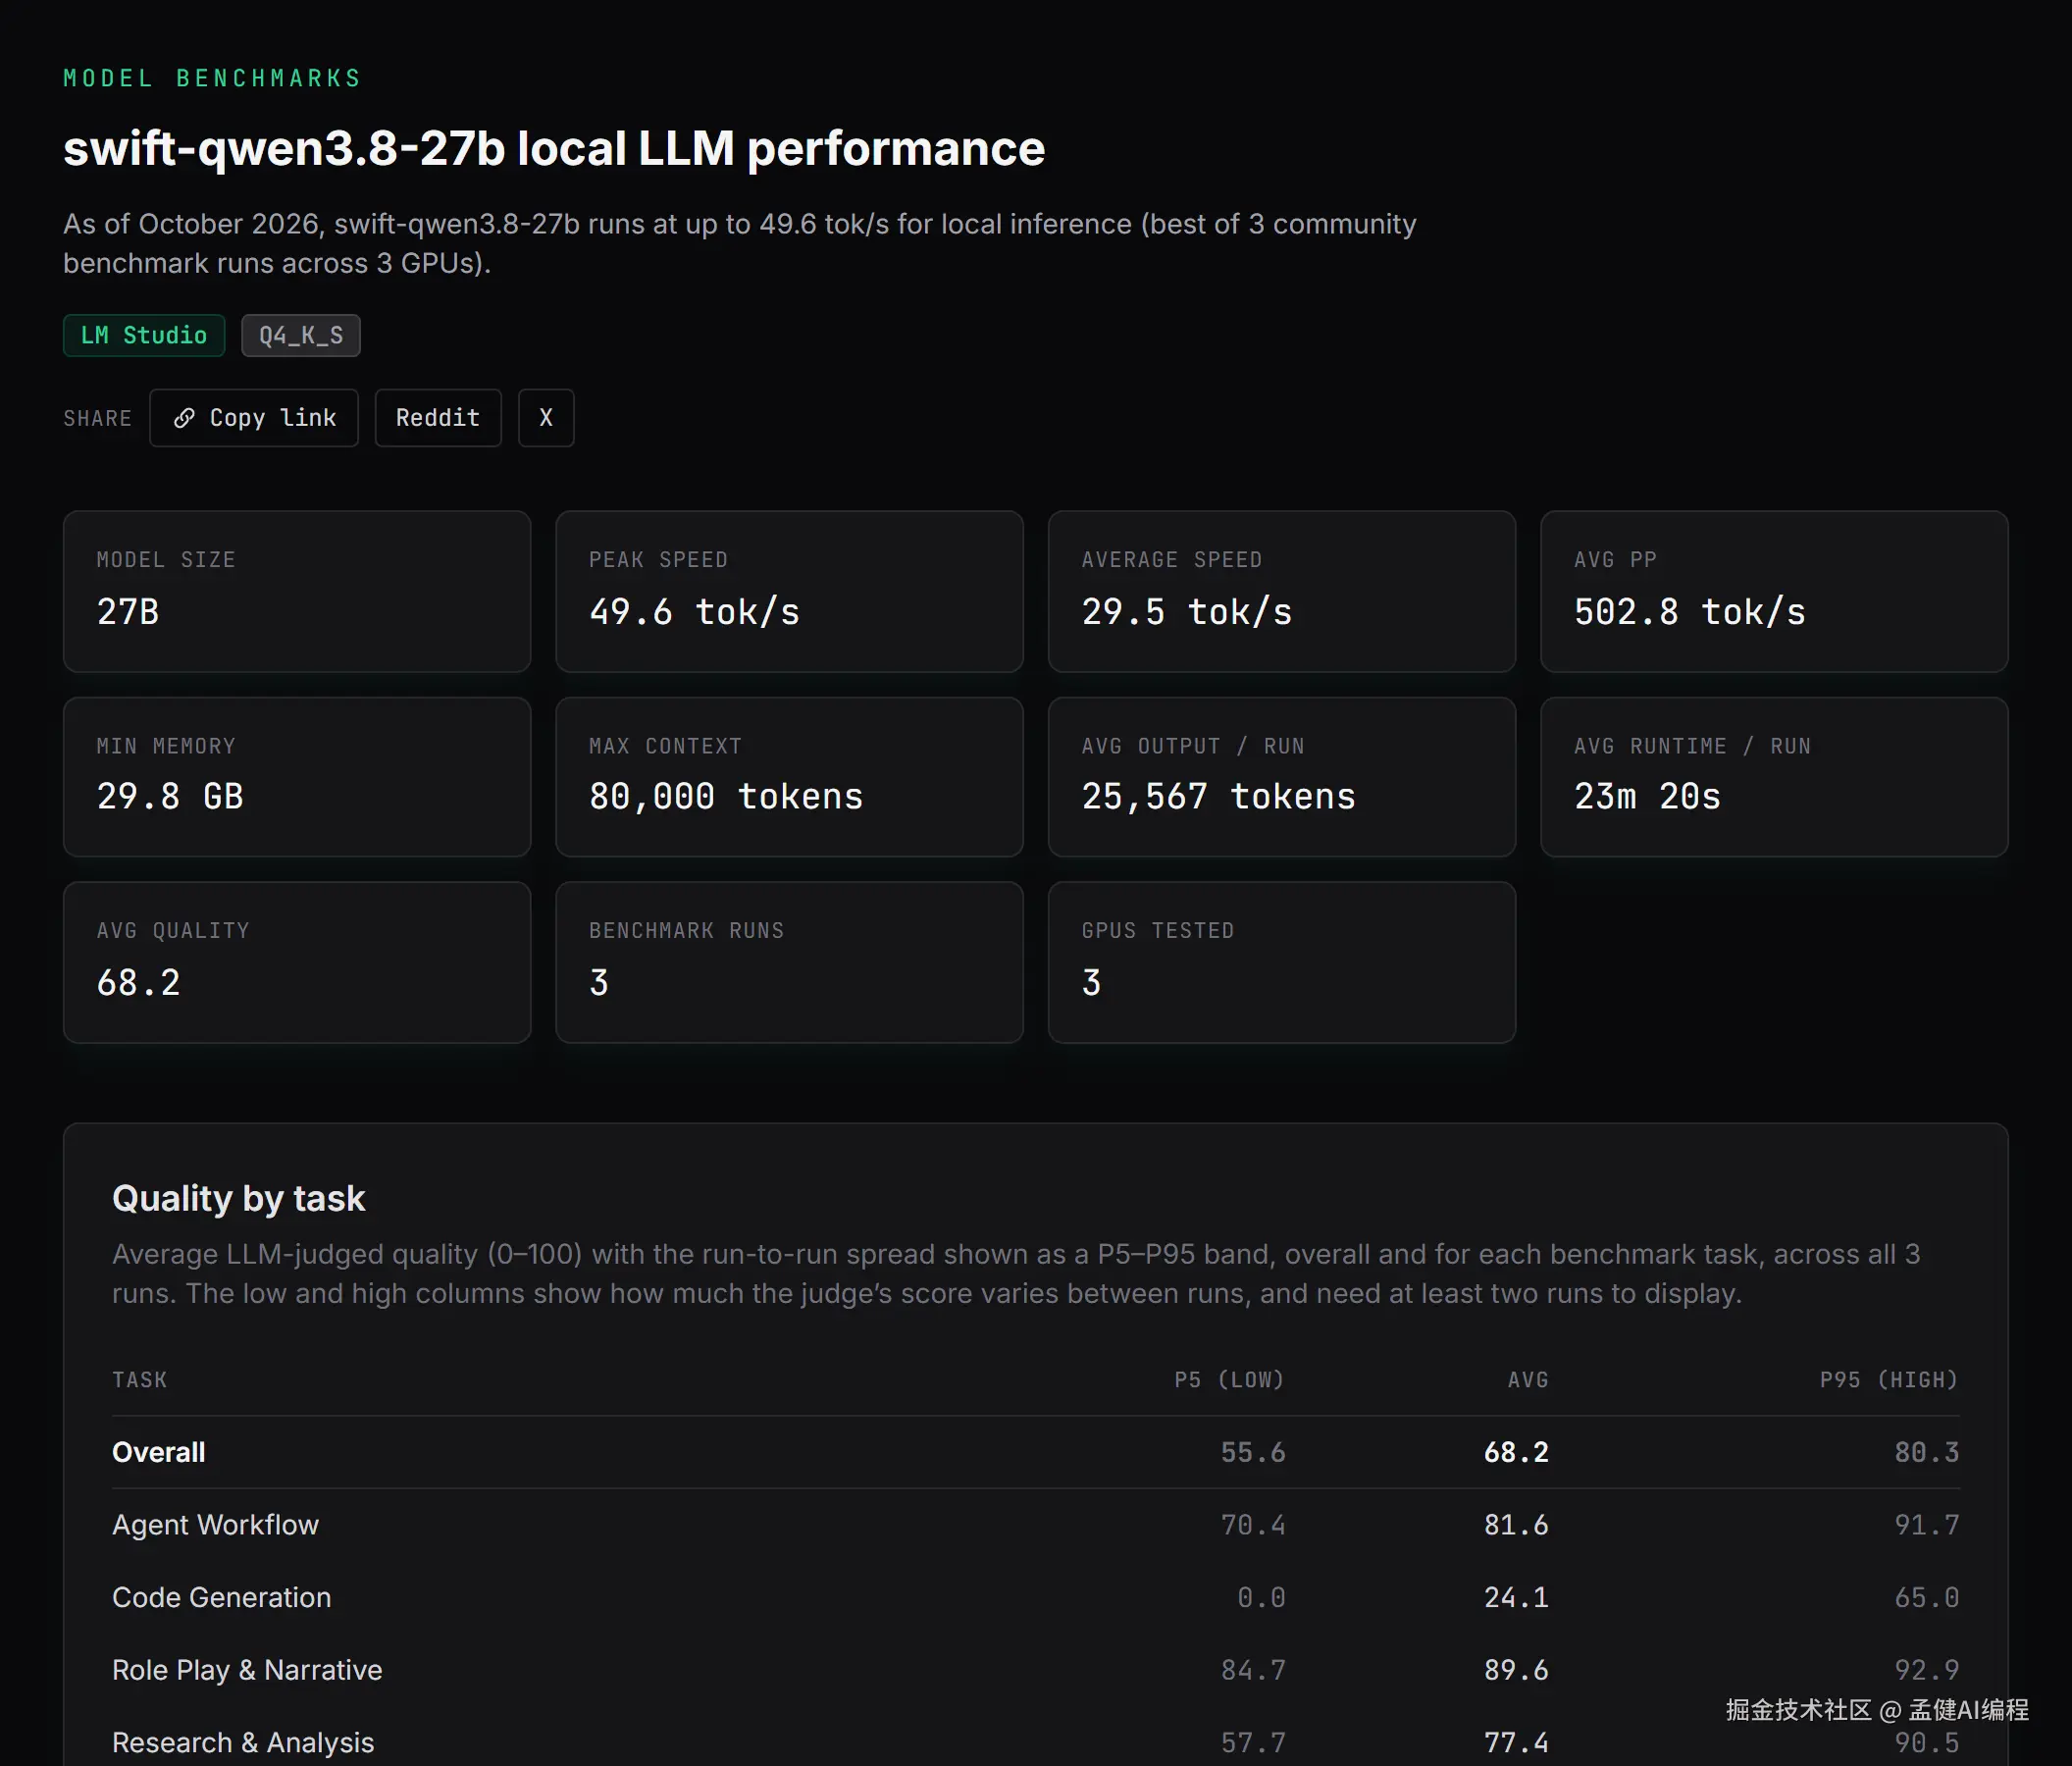
据 llm-bench.io 在 2026 年 9 月 21 日发布的评测数据,swift-qwen3.8-27b 虽能测得 49.6 tok/s 的峰值速度,在角色扮演(89.6/100)和智能体工作流(81.6/100)方面表现亮眼,但在代码生成(Code Generation)基准上的平均质量得分仅为 24.1/100。与此同时,Qwen3.8 27B 虽然在 2026 年 9 月 28 日获得了 AMD 硬件的 Day 0 级支持并接入 LM Studio,但 27B 级别模型处理高并发、多文件交叉架构重构时,幻觉率依然显著高于头部千亿级云端模型。
硬件成本同样是现实门槛:Reddit 上跑出近 160 tok/s 依赖的是专业工作站显卡 Sapphire Radeon AI PRO R9700 高带宽外接,手头几千块的普通轻薄本根本做不到开箱即用。若脱离专用加速引擎与投机解码,普通硬件依然会在 14--30 tok/s 的区间徘徊。
盲目追求纯本地大模型闭环,可能会陷入"买了昂贵硬件,却只能生成低质补全"的负向收益陷阱。
04、构建务实的混合工作流:本地交付与云端兜底
面对这种技术演进,理性的工程策略不是"非此即彼",而是做减法,重新划定边界:
- 敏感业务与行内快速补全归本地:利用已支持 Day 0 部署的 LM Studio 或 LemonSeed Engine,在拥有合适 GPU 算力的机器上加载 Qwen3.8-27B 与草稿模型,专注于对隐私敏感的核心代码仓单行补全、高频模版函数编写与即时语法纠错,彻底切断核心商业机密泄露的风险。
- 复杂架构设计与多轮重构交云端:将复杂的系统级设计、跨服务排错继续留给云端强模型,依靠其成熟的推理能力完成全局决策。
把确定性交给本地算力,把复杂度留给头部智能,这才是独立开发者在成本、安全与效率之间保持安全边际的最优解。
下一阶段,我会在本地环境中深入测试更多开源草稿模型与主力模型的权重协同率。欢迎大家点赞、收藏本文,如果你在本地部署 Qwen3.8 或配置投机解码时踩到了其他硬件兼容坑,欢迎在评论区交流。
👋 我是孟健,前腾讯 T11、前字节技术 Leader,现在全职做 AI 编程。
🔥 更多 AI 编程实战:
- GitHub:@mengjian-github
- 专栏:AI编程实战
- 这期的完整清单:评论区回复「资料包」,我把领取方式发你
觉得有用?点赞+收藏 就是最大支持 🙏
本文由作者借助 AI 辅助整理,内容经作者实测与审校。