大多数边缘 AI/ML(人工智能/机器学习)工作负载适合在 CPU 上运行,但对于少数 CPU 无法胜任的工作负载而言,加速器就显得尤为重要。Raspberry Pi 用户有多种加速方案可供选择,包括我们自家的 AI HAT+ 和 HAT+ 2,以及来自更广泛的 Raspberry Pi 生态系统的产品。在本文中,我们在 Sixfab 和 DEEPX 的朋友将探讨如何在使用 Sixfab AI HAT+ 的 Raspberry Pi 5 上运行视觉和紧凑型语言 AI,以及 3 瓦功耗的 NPU 能在边缘设备上带来哪些可能。
Raspberry Pi 已经让数以百万计的工程师、学生和创客接触到了 AI 开发。下一步则是从"仅在演示中运行一次"的模型,转变为能够持续观察、理解和响应的智能系统------并且不依赖于持续的云连接。
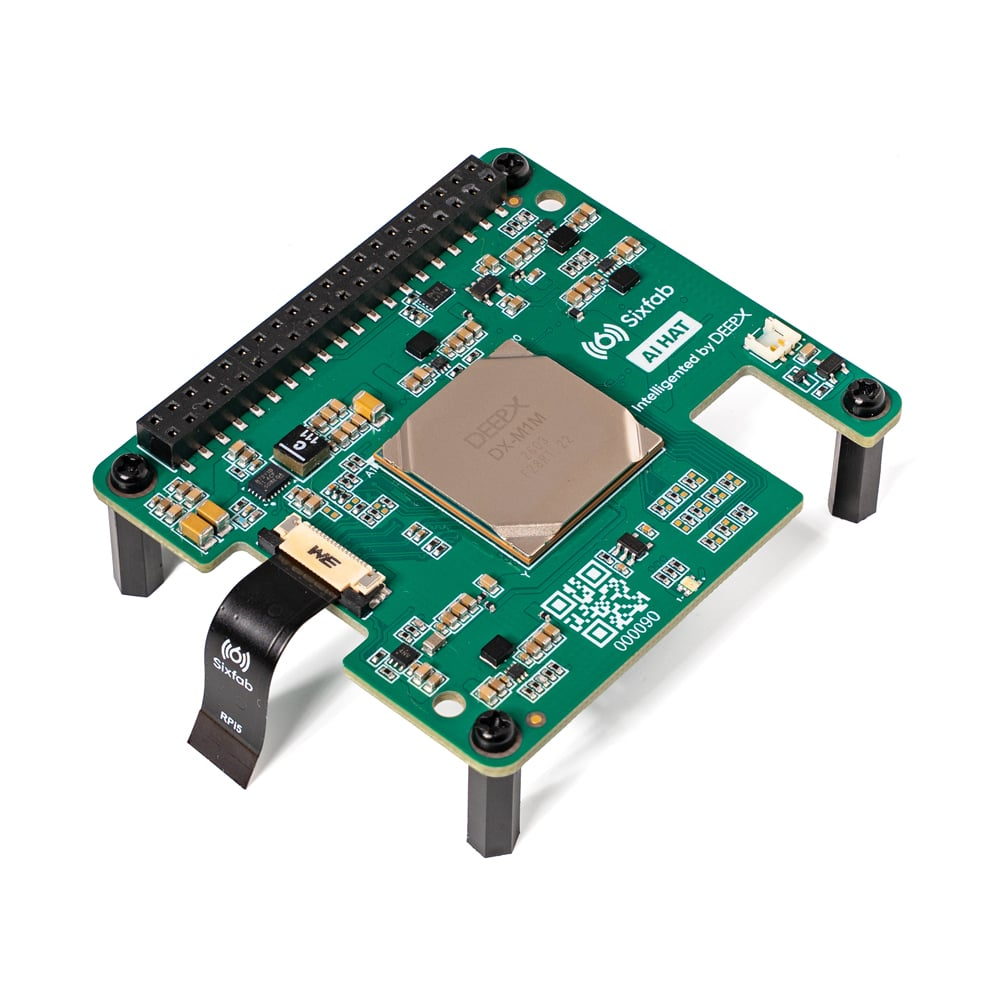 适用于 Raspberry Pi 5 的 Sixfab AI HAT+ 是一款基于 DEEPX DX-M1M NPU 构建的第三方 AI 加速扩展板。它在典型的 NPU 持续功耗约为 3W 的情况下,增加了 25 TOPS 的专用 AI 加速能力,同时让 Raspberry Pi 的 CPU 可以空出来处理摄像头操作、应用逻辑、连接和设备控制。在本文中,我们想向您展示这种组合真正擅长的领域,它不适合在哪些情况下使用,以及如何在几分钟内完成从首次启动到首次推理的全过程。
为什么强调的是"3 瓦"而不是"TOPS(算力)"数值?
峰值的 TOPS 数据在营销上很吸引人,但大多数边缘产品的成败往往取决于它们的功耗和热预算。真实的系统仍然需要为 Raspberry Pi 本身、摄像头、存储、网络以及设备实际控制的任何组件留出余量。一个在持续负载下功耗能保持在 3W 左右的加速器,意味着更小的外壳、更简单(通常是无源的)散热方案,以及可以持续运行而不是短暂爆发式运行的 AI 模型。
正是这种能效让本地 AI 在最关键的场景中变得切实可行:如智能摄像头、机器人、工业设备和分布式传感器。在这些场景下,云端延迟、连接稳定性或数据隐私问题往往会成为限制性因素。
工程说明: 约 3W 的数据指的是 25 TOPS 的 DX-M1M 版本在典型持续负载下的 NPU 功耗,而不是整个系统的整机壁垒功耗。请始终测量您最终的 Raspberry Pi 配置,包括实际接入的摄像头、存储、工作负载和散热方案的功耗。
一个 NPU 应对三类智能
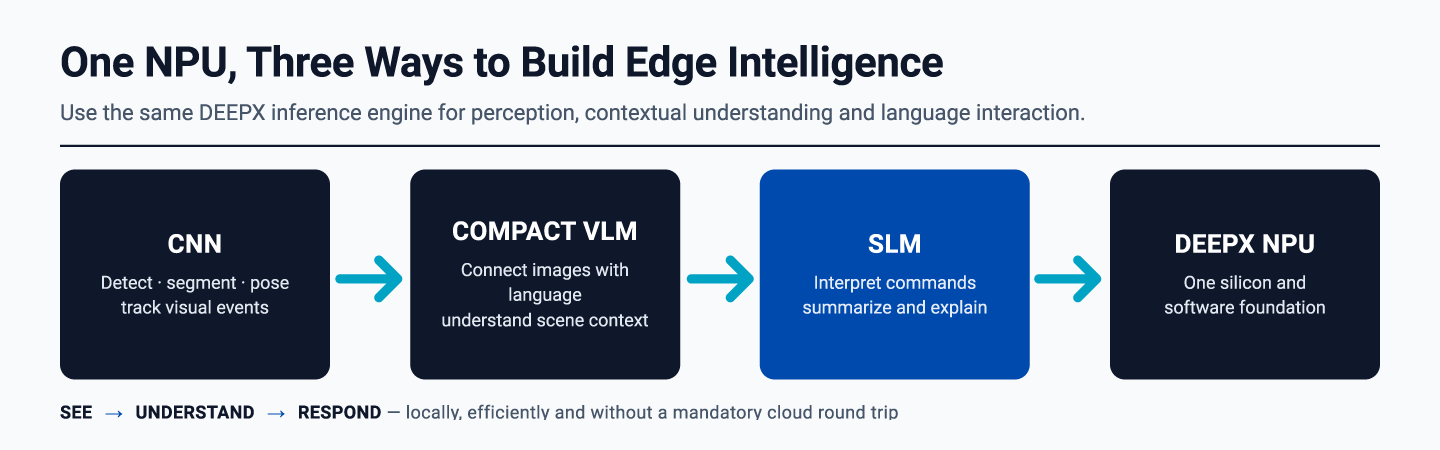
大多数边缘产品都是从"感知"开始的:CNN(卷积神经网络)检测物体、分割工作区域、估计人体姿态或标记异常事件。而下一代边缘系统还需要理解上下文并表达它所看到的内容。DX-M1M 的设计初衷就是通过单块芯片和一套工具链来支持这一完整的旅程。
CNN:高效的视觉感知
目标检测、分类、分割、姿态估计、深度和图像增强能够将摄像头的像素转化为结构化事件。DEEPX ModelZoo 提供了预优化的示例模型------包括 YOLO 系列检测器、分割和姿态模型------且 DX-Stream 能帮助您将它们组装成基于 GStreamer 的摄像头处理流水线。
紧凑型 VLM:将视觉与意义相连
紧凑型视觉语言模型(VLM)在视觉结果的基础之上增加了上下文理解能力:例如描述一个场景、回答关于图像的具体问题,或者用自然语言解释事件------这一切都在本地处理,没有任何数据会离开设备。
SLM:与边缘系统对话
小型语言模型(SLM)可以解释用户的命令、总结本地发生的事件或生成简明的解释,从而为摄像头、机器人和机器创建一个自然的交互接口,而无需将每次交互都上传到云端。
内存情况如何?
开发者在边缘端运行语言模型时,首先会问的一个问题就是可用内存有多少,以及能装下多大的模型。DX-M1M 模块搭载了 2GB 的模块专用 LPDDR4x 内存,可以轻松同时支持 VLM 和 SLM 工作负载以及视觉模型。
准确度比峰值基准测试更重要
只有当模型针对您的应用程序实际面临的图像和条件依然保持准确时,边缘 AI 的性能才有意义。DEEPX 将 INT8 优化视为一个对准确度敏感的工程过程,而不仅仅是一个简单的转换步骤:
-
从已知的 FP32 准确度基线和明确定义的应用程序指标开始。
-
使用真实部署环境中的代表性数据进行校准------而不仅仅是干净的样本图像。
-
使用 DX-COM 将模型编译和优化为便于移植的
.dxnn部署工件。 -
比较最终 Raspberry Pi 系统上的准确度、延迟、功耗和热表现。
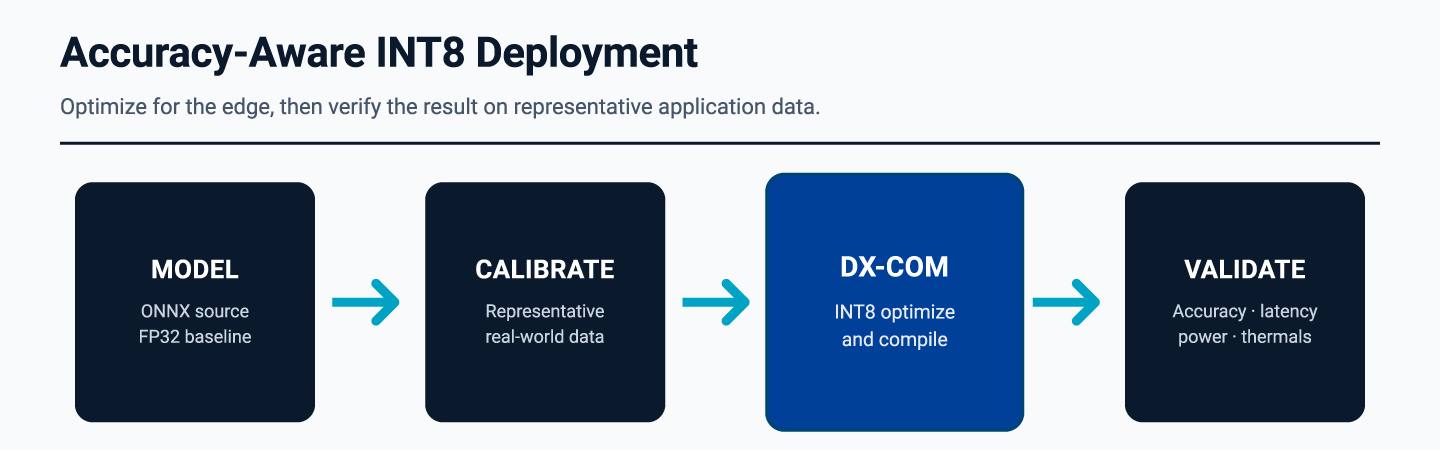
这在边缘摄像头实际面临的困难条件中尤为重要:如低光、眩光、运动模糊、遮挡和异常拍摄角度。令人信服的结果应该同时展示出能效的提升和对应用准确度的保留。
它到底有多快?
数据胜过形容词。以下数据是在运行 Sixfab 官方发行版软件的 Raspberry Pi 5(8GB)上测量的,对比了 DX-M1M 和 DX-M1 两款 NPU:
| 工作负载 | DX-M1M (NPU) | DX-M1 (NPU)* |
|---|---|---|
| mobilenet_v2, 240×240 | 2361 FPS | 3223 FPS |
| deeplabv3plus, 512×512 | 155 FPS | 231 FPS |
| Qwen3-1.7B, 96 预填充 tokens | 首字延迟(TTFT): 599.04 ms 生成速度(TPS): 4.64 tok/s | 首字延迟(TTFT): 544.58 ms 生成速度(TPS): 11.60 tok/s |
* DX-M1 使用的是 LPDDR5,而 DX-M1M 使用的是 LPDDR4X,这导致了由于内存带宽不同而产生的性能差异。
从首次启动到首次推理
理解该平台最快的方法是验证硬件,运行预打包的模型,并观察 NPU 的工作情况。在 Raspberry Pi OS 上只需运行:
sudo apt update && sudo apt install apt-repo-sixfab
sudo apt update && sudo apt install sixfab-dx
dxrt-cli -s        # confirm device and software status
run_hello_world    # run a packaged example
dxtop              # observe the NPU in real time
在那之后,你可以选择一个经过优化的 ModelZoo 工作负载,或者通过 DX-COM 导入你自己支持的 ONNX 模型。生成的 .dxnn 文件可以通过 DX-RT 的 C++ 或 Python API 运行,与此同时你的 Raspberry Pi 应用程序可以继续处理摄像头、业务逻辑、用户界面、网络和控制操作。
软件栈一览
| 组件 | 它的作用 |
|---|---|
| DX-COM | 优化受支持的 ONNX 模型并将其编译为 DEEPX 的 .dxnn 工件。 |
| DX-RT | 在目标设备上通过 C++ 或 Python API 运行 .dxnn 模型。 |
| DX-Stream | 构建基于 GStreamer 的捕获、推理和后处理流水线。 |
| ModelZoo | 涵盖检测、分类、分割、姿态等领域的预优化示例集。 |
| dxrt-cli / dxtop | 供用户一目了然地查看设备状态、利用率、温度、时钟频率和内存。 |
你能用它构建什么?
从家里开始。工作台上的摄像头可以识别你的 3D 打印何时失败,并向你发送一张附有单行描述的快照消息;前门的摄像头可以区分快递员、邻居的猫和闲逛的人,并在每晚于本地生成全天事件的总结;或者打造一个花园/宠物监视器,它只会在发生值得关注的事情时才向你发出警报。所有这些应用都遵循同一个循环:CNN 观察事件,紧凑型 VLM 添加上下文理解,SLM 对其进行解释或理解你的下一条命令,最后由你的 Raspberry Pi 应用程序来做决定并采取行动。
同样的架构可以扩展到专业的部署场景中:在减少云依赖的情况下,在智能摄像头中实现持续的本地检测;在生产线旁进行低功耗的视觉质量和安全监控;在 Raspberry Pi 运行 ROS 2 和控制逻辑的同时,让机器人具备环境感知和紧凑的多模态智能;以及在零售和智能空间中执行具有隐私保护意识的停留和行为分析。
它不适合做什么
就像任何边缘加速器一样,AI HAT+ 并不试图与云端推理竞争。那些需要广泛的世界知识、超长对话上下文或持续学习能力的应用程序,将始终在计算和内存几乎不受限制的云端运行得更好。DX-M1M 最适合在摄像头或传感器旁运行"范围明确、永远在线"的智能应用------在这类场景中,隐私、延迟、离线操作和个位数瓦特的功耗预算才是决定设计的真正刚需。客观地认识这一边界,正是使该平台在其适用范围内值得信赖的原因。
社区与下一步
你需要深入了解的所有资源都是公开的:DX-AllSuite 和 ModelZoo 都开源在 GitHub 上,DEEPX 开发者门户网站托管着文档、指南和支持渠道,您可以在那里提出问题并提交 issue。