当AI智能体在实验室表现出色,却在真实业务场景中频频"翻车",问题的根源可能不在模型,而在训练环境本身。
AI智能体如今已能够执行多步骤任务、处理复杂工作流,并在动态的现实环境中做出决策。强化学习(Reinforcement Learning, RL)也已成为训练这些智能体的主流方法。然而,设计拙劣的RL环境会产生脆弱且不可预测的智能体,而设计良好的环境则能培养出在现实世界中能力出众且真正有用的智能体。
高质量RL环境:AI进步的"新瓶颈"
如今,AI进步的瓶颈已超越数据本身,而在于如何构建丰富、真实且代表现实复杂性的RL环境。如果没有这种环境设计的高保真度,团队可能会训练出在受控条件下表现良好、但在实际部署时出现各种不可预知状况的智能体。
学术研究也证实了构建优良RL环境的重要性:研究发现,能够适应多样化任务场景和交互环境的灵活RL训练框架可显著提升智能体性能。只有在智能体面对构建良好(能真实代表现实工作流复杂性)的RL环境时,当前模型能力与现实任务需求之间的差距才会真正显现。
**澳鹏全新推出电子书:《强化学习环境:澳鹏的方法论与金融领域深度探讨》(Reinforcement Learning Environments: Designing High-Fidelity Training Grounds for Smarter AI Agents)。**本书系统阐述了澳鹏一套经过验证的RL环境设计方法论,旨在产生高保真的奖励信号,从而推动智能体性能的实质性提升。
两大核心组件:任务与验证器
澳鹏的方法论结合了深厚的领域专业知识与可扩展的结构化体系,围绕两个关键组件构建:模拟真实专业工作流的任务,以及为模型训练生成精确奖励信号的验证器。
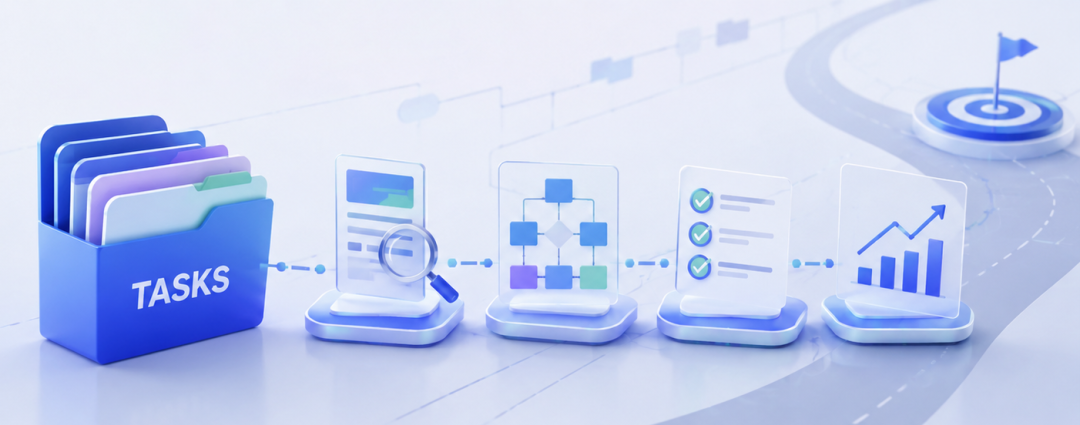
**▲任务(Tasks):**澳鹏拥有广泛的成品任务库,专为在自有训练体系中运行的模型构建者设计。此外,针对特定领域、复杂度、专业角色及工作流,澳鹏还提供定制任务数据集
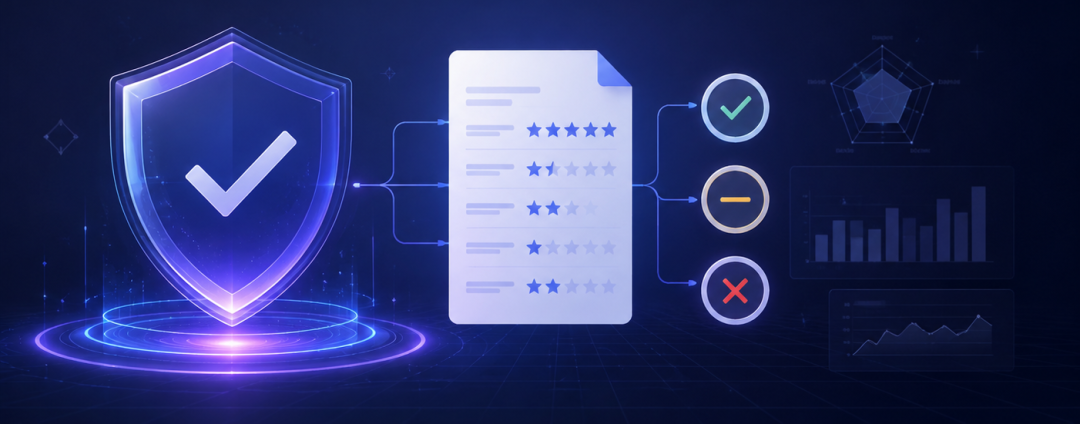
**▲验证器(Verifiers):**程序化验证器为具有客观正确答案的任务提供基于规则的自动化评估。基于量表(Rubric)的验证器提供多维评估,同时支持负向奖励信号,使模型构建者能够对不良行为进行明确惩罚。每条评分细则均经过严格的精炼流程,包括原子性测试、对抗性漏洞检查、评分一致性验证以及覆盖范围映射。
**本书揭示了一个关键发现:**在针对预设的现成金融任务进行测试时,某先进模型约88%的任务四次尝试均未通过,而这些差距只有在智能体面对反映现实复杂性的环境测试时才会显现。
《强化学习环境:澳鹏的方法论与金融领域深度探讨》
前沿的方法论:系统阐述任务与验证器双核心的RL环境设计框架
严谨的质检流程:详解量表精炼、对抗性测试、评分一致性等验证器优化闭环
金融领域实战经验:揭示实验中模型的任务失败率及具体失效模式