1 背景与创新点
《Lakebase: Serverless Postgres over Open Lake Storage》由 Databricks 团队发表于 PVLDB 2026。Lakebase 沿用 PostgreSQL 处理事务,目标是满足四项需求:1
-
长期保存数据库数据。
-
按负载启动、扩缩和关闭计算资源。
-
从已有数据库状态创建独立测试分支。
-
分析引擎在独立资源上读取共享数据。
1.1 PostgreSQL 实例的计算与持久化职责
单机 PostgreSQL 将 SQL 执行、事务、缓存和磁盘管理集中在一个实例中。 表与索引按页面组织,WAL(预写日志)记录修改,用于故障后的页面恢复。事务提交要求相应 WAL 可靠保存,修改后的页面可以随后刷盘。1
这套结构已经能够长期保存数据,但计算、缓存和本地存储围绕同一个实例管理。 按峰值配置 CPU 和内存,会在低负载时产生闲置;停机后保留数据,也不自动解决按负载扩缩、快速启动和缓存恢复的问题。这些能力需要额外的资源管理与恢复机制。1
另外两项需求也需要额外能力配合。准备带有已有 Schema(表结构)和数据的独立测试环境,依赖备份恢复、复制或快照,耗时取决于数据量与实现;代码的 Git 分支无法隔离共享数据库中的修改。分析查询若在同一实例执行,会与在线事务争用 CPU、内存和 I/O;转到其他引擎,则需要解决数据复制或共享访问。1
1.2 短生命周期负载、分支需求与多引擎访问
论文观测到许多 Compute(执行 PostgreSQL 的计算节点)活跃不足 10 秒,部分项目具有很深的分支关系,数据库状态仍需供后续使用。 常驻计算增加闲置开销,反复准备 VM、复制和恢复数据又会拖慢启动。因此,Serverless 需要由平台管理资源,支持按负载扩缩、闲置关闭和快速唤醒。1
Agent 会反复生成代码、执行迁移和测试不同方案,每次迭代都需要隔离代码与数据库状态。 例如,给订单表增加字段时,希望在独立分支上修改表结构和历史记录,原库继续提供服务。分支与弹性的需求早已存在,Agent 进一步提高了环境创建和销毁的频率。1
Aurora、Socrates、AlloyDB 已经分离计算与存储。 按论文的比较口径,这种分离主要发生在厂商内部,分析仍需经数据库接口读取,或同步出另一份数据:前者占用数据库资源,后者需要维护同步与新鲜度,并保存另一份数据。Lakebase 因而希望让其他引擎在独立资源上直接读取一致的数据库状态。1
1.3 设计选择与对应代价
Lakebase 将持久化状态放入对象存储,利用其低成本、大容量及云服务管理的复制与耐久性,使数据和历史版本独立于 Compute 保留。不过,OLTP 小事务要求毫秒级响应,页面又会频繁修改,对象存储难以直接承接全部页面读取和日志提交。1
因此,Safekeeper 跨 AZ(可用区)复制 WAL,多数派落盘后完成事务提交,再异步上传日志;Pageserver 保存历史、重建页面并缓存热数据,也为新 Compute 提供启动材料。缩短前台路径的代价,是持续维护这些服务及日志复制、页面生成和上传进度。1
Pageserver 用 LSN(WAL 流中的字节位置)标记版本,分支引用父分支在指定位置之前的历史。 父子分支共享创建前的 Schema 和数据,之后独立记录修改;子分支不影响父分支,也不自动接收父分支的新写入。共享历史避免了创建时复制整库的等待与重复存储,仍需承担历史容量、后台整理和深层祖先链读取的开销。1
计算弹性依赖缓存:关闭 Compute 后再次启动需要恢复热数据,缩小内存可能使工作集(当前负载持续访问的数据)放不进缓存,增加远端读取。Lakebase 同时估算 CPU 和工作集需求,并预热 VM 以缩短唤醒时间;平台需要提前准备资源,查询性能仍取决于缓存状态。1
开放的 PostgreSQL 页面格式为分析直读提供基础,减少 PostgreSQL Compute 的执行负担。 外部引擎仍要理解页面、日志和元数据,检查事务可见性并刷新失效缓存;共享存储的访问路径和资源竞争也仍需评估。1
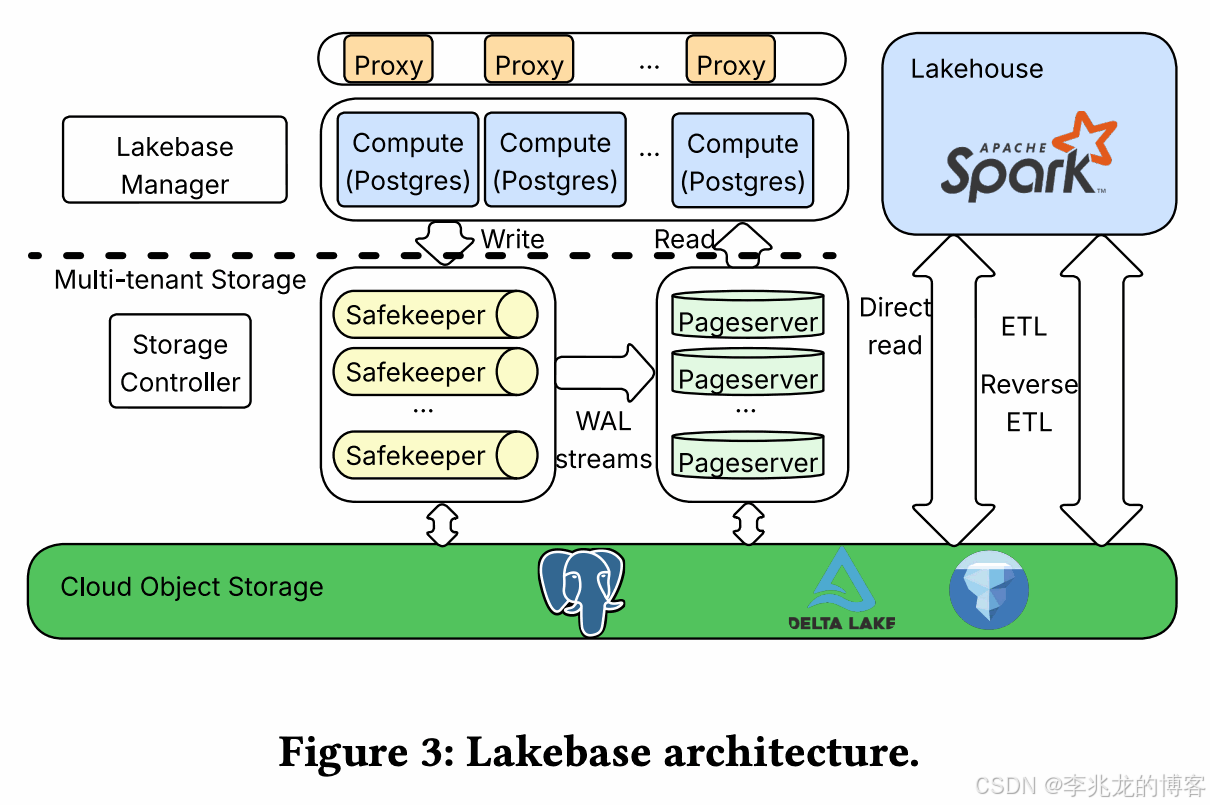
图 1:论文 Figure 3,第 4387 页。Compute 执行查询,Safekeeper 复制日志,Pageserver 提供页面,对象存储保存长期状态;Lakehouse 通过专门读写路径接入。1
每个数据库实例保留一个 PostgreSQL Primary(写主节点),可增加只读副本;Pageserver 随数据增长分片。1
2 存储版本与计算生命周期的分离
2.1 WAL 提交、页面生成与恢复位置
Compute 通过定制的 SMGR(PostgreSQL 存储管理接口)访问页面,并使用本地 SSD 缓存。 页面写入更新本地缓存,持久性由 WAL 保证。WAL proposer 将日志发送给分布在三个 AZ 的三个 Safekeeper,收到多数派落盘确认后推进 Commit LSN。新的 Primary 必须先以更高的 Term 获得多数派认可,防止两个 Compute 同时作为写主节点。1
这条提交路径不等待对象上传。 Safekeeper 随后将已提交的 WAL Segment 上传到对象存储,Pageserver 则摄入 WAL 并保存为 Layer File(存储 WAL 增量或完整页面的持久化文件,具体分为 Delta Layer 和 Image Layer)。事务提交时日志已由多数派持久化,日志备份和 Layer File 上传各自继续推进。1
因此,需要区分几个进度。Commit LSN 表示复制协议已经确认的日志位置;Pageserver 的 Last Record LSN 表示内存中已摄入的位置,Flush LSN 表示已刷入本地 Layer File 的位置,Remote Consistent LSN 表示 Layer File 已上传、可从远端恢复的位置。将这些进度合并成一个已持久化状态,会掩盖读等待和故障恢复所需的工作。1
Compute 启动时取得精简的 Basebackup(启动所需的元数据),将恢复起点设为 Pageserver 已摄入的 Last Record LSN;后续所需页面由 Pageserver 提供,启动时不必重新拷贝整库。这是计算节点的启动路径。1
Pageserver 的故障恢复则依赖另一个 AZ 中预先准备的 Hot Standby(备用 Pageserver 节点),过程包括:1
-
故障前预取。 主 Pageserver 将 Snapshot(存储树及元数据的快照)和 Layer File 上传到 Object Storage。Hot Standby 提前从 Object Storage 下载 Snapshot 和近期使用的 Layer File,存入自己的本地 SSD。文件下载发生在主节点仍正常运行时,数据来源是共享对象存储。
-
故障后接管。 Storage Controller(负责组件放置与故障切换的控制服务)检测到主 Pageserver 不可用后,通知另一 AZ 的 Hot Standby 接管。接管节点使用自己的本地缓存和仍可访问的 Object Storage 提供页面;这条路径不需要等故障 AZ 恢复,也不依赖再去读取旧节点的本地盘。
-
补足日志进度。 接管节点仍可能落后于已提交的日志位置。对于尚未归档的 WAL,跨 AZ 的多数派落盘确保单个 AZ 失效后仍有幸存 Safekeeper 保存日志;已归档的 WAL 则保存在 Object Storage 中。接管后的 Pageserver 从可用 Safekeeper 继续摄入 WAL;页面所需的日志尚未摄入时,
GetPage@LSN仍需等待追赶。
这里的加速来自预先运行的 Hot Standby 和已缓存的热数据,省去了故障后从零准备节点与缓存的工作。实际恢复仍包含故障检测、请求切换和 WAL 追赶;若 Compute 也在故障 AZ 中,还要恢复计算节点。论文未披露 Layer File 的热度判定与预取刷新协议,也未给出 Pageserver Failover 的独立耗时,Compute 启动低于 500 ms 的结果不能用作这一指标。1
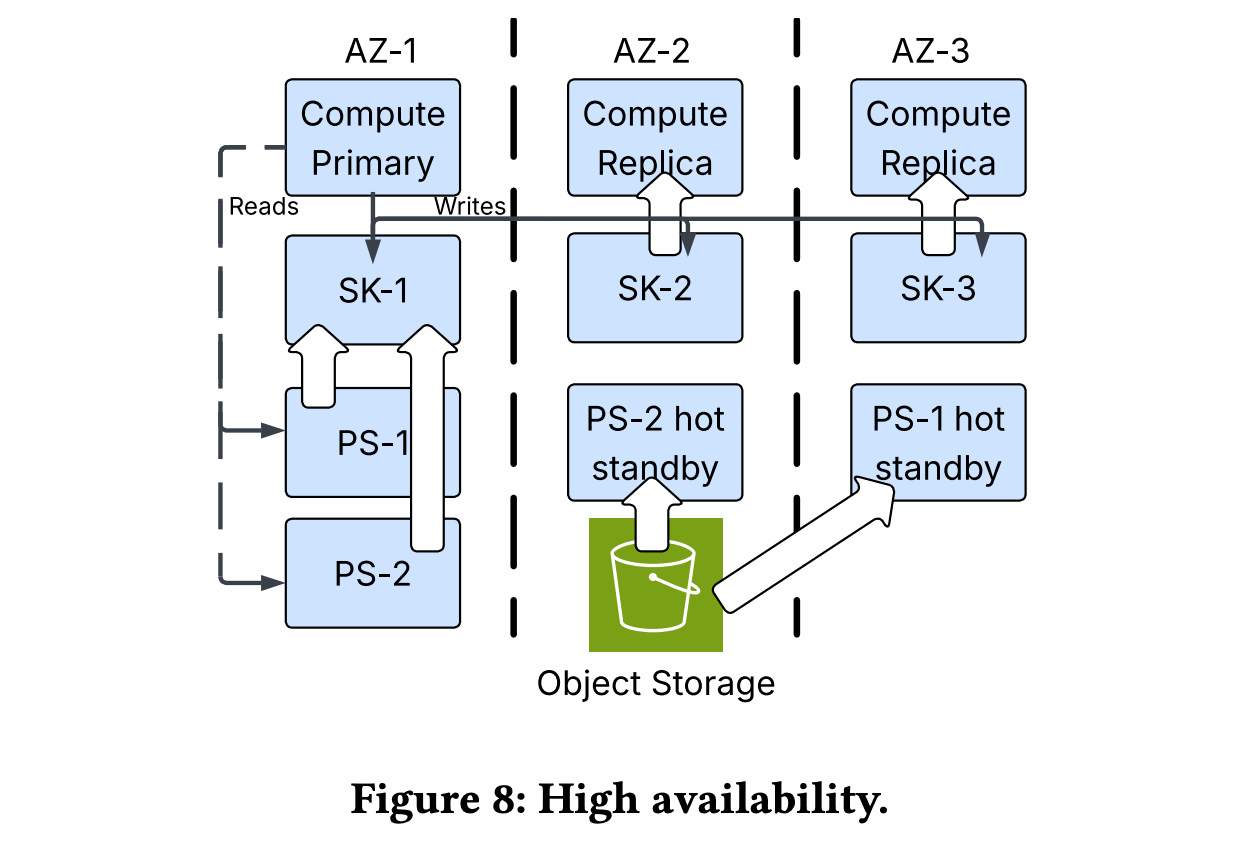
图 2:论文 Figure 8,第 4391 页。图中 PS-1、PS-2 位于 AZ-1,各自的 Hot Standby 位于 AZ-3、AZ-2,并从 Object Storage 预取数据;三个 Safekeeper 分布在三个 AZ。该恢复场景以幸存 AZ、对象存储和控制服务仍可用为前提。1
存储落后仍然会影响前台。 Pageserver 将摄入、刷盘、上传进度经 Safekeeper 反馈给 proposer,任一进度落后 Commit LSN 超过阈值时,proposer 就限制写入。这个背压同时约束页面读取等待和恢复工作量,也意味着存储整理能力仍是持续写入吞吐的一部分。1
2.2 页面与 LSN 组成的二维存储
WAL 记录页面修改,Redo 恢复页面。 PostgreSQL 用 Page 保存表和索引数据;涉及页面修改的 WAL 记录携带 Block Reference(关系文件标识、文件类别和页号)、操作类型及重放数据,LSN 标记日志顺序。一条 WAL 可以涉及多页,一页也可能被多条 WAL 修改。从已有完整页面出发,按 LSN 重放相关记录,就能恢复后续版本;WAL 在特定条件下也携带 Full-page Image。重放结果仍是标准 PostgreSQL 页面,Compute 继续按事务快照判断记录可见性。2345
Pageserver 提供版本化页面与启动材料。 GetPage@LSN 在指定 Timeline 内按页面 Key 和 LSN 返回页面:Key 标识哪一页,例如某张表或索引的第 42 页;LSN 指定该页的历史版本。页面 Key 与行主键的粒度不同,论文未展开其具体编码。另一个接口 GetBaseBackup 提供 Compute 启动所需的精简元数据。1
存储按 Key/LSN 组织,WAL 摄入与页面物化分开。 Pageserver 持续从 Safekeeper 摄入 WAL,先追加到内存缓冲,达到大小或时间阈值后刷成 Delta Layer,保存一个 Key 范围、一个 LSN 区间内的原始 WAL,无须立即 Redo。Image Layer 则保存一个 Key 范围在某个 LSN 上的完整页面。读请求从较早的 Image 重放相关 Delta;后台 Compaction 也用这一过程生成新 Image,缩短后续重放链,代价是完整页面重写。1
Layer File 构成类似 LSM-tree 的二维存储。持久文件保存在 Object Storage,每个 Timeline 的远端 Index File 记录文件清单;本地 SSD 缓存 Layer File,按 LRU 淘汰,缺失时再从远端下载。1
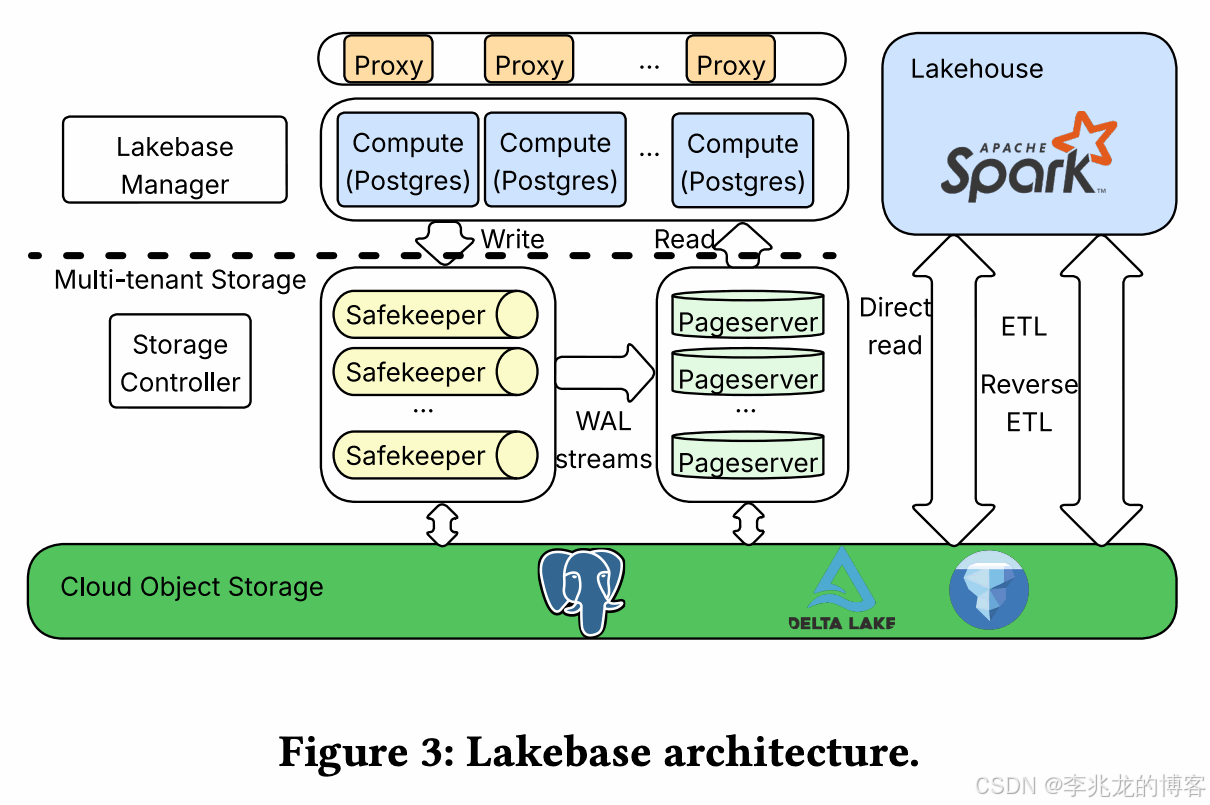
图 3:论文 Figure 5,第 4389 页。读取指定版本时,先找到较早的完整页面,再应用目标 LSN 之前的增量日志。1
读取等待 WAL 摄入,Not-modified-since LSN 减少无关等待。 Pageserver 尚未摄入所需 WAL 时,GetPage@LSN 会阻塞,等待 Last Record LSN 追上;无须等日志刷成 Delta Layer、生成 Image 或上传文件。WAL 由 Timeline 持续消费,论文未描述每个读请求另行触发一次 WAL 拉取。1
请求携带 Request LSN(目标版本)和 Not-modified-since LSN(Compute 保证该页从此位置到目标版本之间未变化),Pageserver 只需摄入到后者。例如,二者分别为 300 和 100,而 Pageserver 已摄入到 200,就能返回该页,无须等待 200--300 的无关日志;未摄入到 100 时仍需等待。数值仅用于示意。1
Not-modified-since LSN 由 Compute 的固定大小 LwLSN Cache 维护,映射页面与对应 LSN。脏页淘汰时记录该页自身的 LSN;发送 GetPage 时,命中则使用缓存值,未命中则用全局 last-written LSN 作保守上界,可能多等待一些日志。收到页面后,再更新本地页面缓存和 LwLSN Cache。1
2.3 时间线分支与历史回收
一个 Project 对应一个存储 Tenant,其中每个 Timeline 表示一条独立的数据库历史。 Timeline ID 标识这条历史,LSN 标记其中的位置;指定 Timeline 和 LSN,才能定位具体版本的数据库状态。创建分支时,新增具有自己 ID 的 Timeline,并记录父 Timeline ID 和 Branch LSN,元数据操作为 O ( 1 ) O(1) O(1)。1
父 Timeline ID 和 Branch LSN 属于需要持久保留的分支元数据。 关于保存位置,论文写明 Pageserver 将存储树及元数据的 Snapshot 上传到 Object Storage,并在远端维护 Timeline 的 Index File,记录 Layer File 清单及相关元数据。页面与增量日志保存在 Layer File 中;Timeline ID 用于标识所属历史,不包含这些数据。论文未展开 ID 与祖先引用的具体文件路径或序列化结构。1
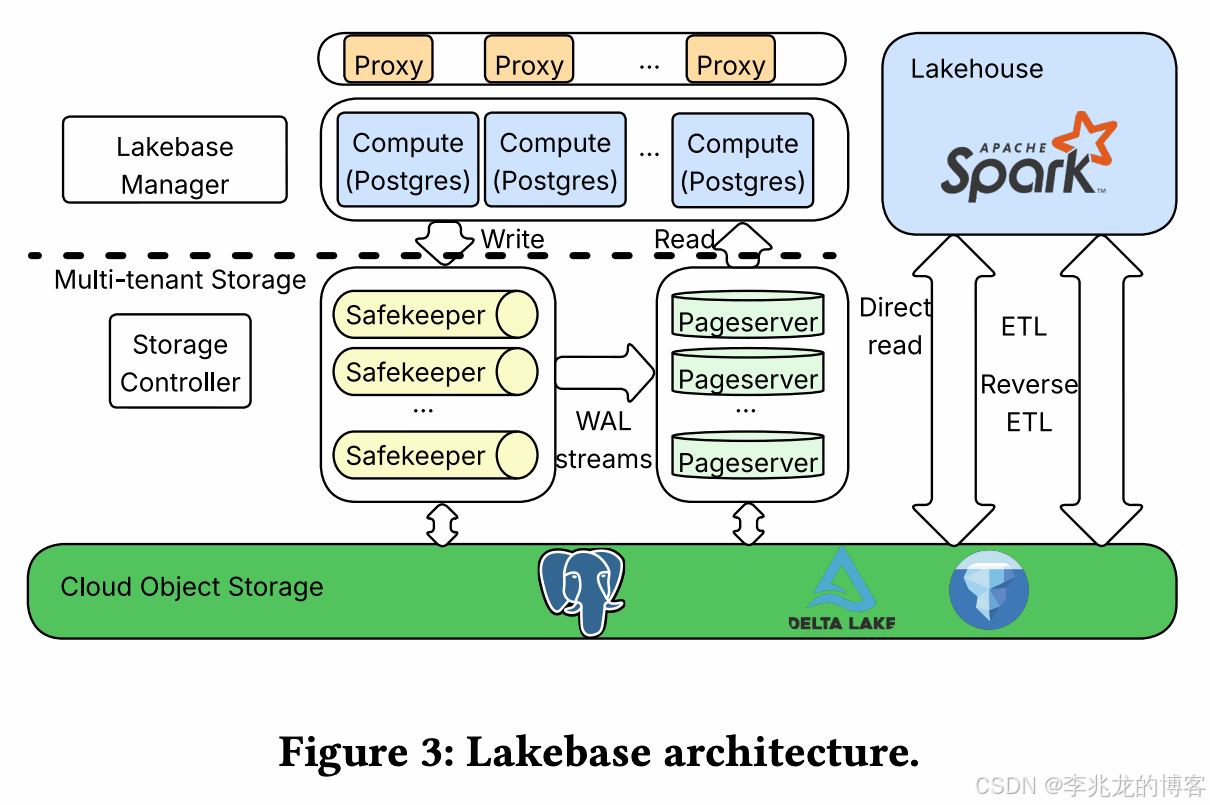
图 4:论文 Figure 4,第 4389 页。Database Log 表示父分支日志,Branch Log 表示子分支日志;标号 11 及虚线箭头标出 Branch LSN,即分叉位置。1
图中的父子分支共享 Branch LSN 及此前的历史和物理存储,之后各自在自己的 Timeline 中记录新增 WAL。 读取子分支时,Pageserver 先查子 Timeline 的 Layer File;缺少所需页面或历史时,再沿父 Timeline 查找,并只使用父分支在 Branch LSN 及此前的历史。因此,父分支在分叉后的写入不会自动进入子分支。1
分叉位置限制在父分支的 PITR 窗口内,以保证创建时能够重建所有页面;该位置尚未提交的事务按恢复中的未完成事务处理,在子分支中不可见。1
论文将同一 Tenant 的 Timeline 放在同一组 Pageserver 上,便于读取共享祖先数据。分支创建不需要复制整库,后续修改、页面重建、历史保留仍然消耗资源;祖先链很深时,读取还可能遍历更多 Timeline。
Detach 可以在元数据层快速完成,祖先数据由后台异步复制到分离后的分支。 这个操作能够减少长期依赖父链的影响,但不能据此将脱离父分支理解成没有数据整理成本。论文版本也不支持分支合并,发散的物理数据库状态需要应用层处理冲突。1
GC 除了遵守 PITR 窗口,还必须保留后续页面重建所需的数据。 固定在历史 LSN 的 Static Replica 使用租约阻止所需版本被回收。数据库分支、历史读取与 GC 共用这套版本管理,生命周期必须一起考虑。
2.4 工作集驱动的扩缩容与预热资源池
Compute 运行在 NeonVM 管理的 QEMU/KVM VM 中,CPU、内存和磁盘支持原地调整。 PostgreSQL 的 Shared Buffers 大小固定,Lakebase 额外维护可调整的磁盘支持缓存,借助操作系统 Page Cache 使用内存,缓存也随扩缩容同步调整。1
Autoscaler 每 5 秒采集指标,分别估算 CPU、缓存和内存需求,取三者要求的最大规模。 扩缩单位为 1 GiB 内存及相应比例的 CPU。只观察 CPU 利用率不够:工作集放不进缓存时,远端页面读取会增加,缩容可能进一步降低有效吞吐。
为估算工作集,缓存使用修改后的 HyperLogLog,为桶中的各 bit 记录相应哈希观测的最近时间戳,使系统能够近似统计不同时间窗口访问过的唯一页面数。Autoscaler 检查过去 1--60 分钟的页面访问增长,寻找工作集趋于稳定的位置,并通过加权减小抖动。另外还有每 100 ms 检查内存压力的快速扩容路径。1
Scale-to-zero 默认在连续 5 分钟没有查询后关闭 Compute。 新连接先由 Proxy 暂存,再从预热 VM 池分配 Compute,取得 Basebackup 并启动 PostgreSQL,随后转发连接、调整 VM 大小。重启保留的是已进入存储层的状态,原 Compute 的热缓存不会随之完整恢复。用户看到的快速唤醒,依赖平台提前准备 VM 和存储侧恢复材料。1
2.5 分析直读与批量数据导入
Direct Access 允许 Lakehouse//RT、Spark 等引擎绕过 PostgreSQL Compute,从对象存储或 Pageserver 读取页面。 Lakehouse//RT 在目标 LSN 上读取一致页面,通过 SIMD 解析和 MVCC 检查形成 Arrow Batch,再以关系与页面范围为键缓存在内存中。Pageserver 使用 Roaring Bitmap 表达两个 LSN 之间修改过的页面,分析引擎只刷新失效页面。1
共享的是数据库页面及其版本信息,分析算子仍由独立引擎执行。论文实现获得了向量化、并行聚合和分析查询优化的收益,也保留了访问路径的限制:当前 Direct Access 只支持顺序扫描,部分依赖索引的查询会落后于 PostgreSQL。
反方向的大批量导入使用 Direct-to-Storage(DTS)。 Spark Executor 并行生成符合 PostgreSQL 格式的页面并上传对象存储,Compute 最后通过事务中的 Relation Swap 发布新表内容,Swap 的 WAL 仍由 Safekeeper 复制。页面预先使用冻结的可见性元数据,在能看到这次切换的事务快照中可见。原子性落在 Relation 粒度,执行 Snapshot Load 时,针对目标表的并发 DML 会被拒绝。1
这条路径适合初始加载或批量刷新。持续增量同步则读取 Delta Change Feed 并更新 PostgreSQL;从 Lakebase 向 Lakehouse 同步,论文使用 wal2delta 将逻辑解码结果写为 SCD Type 2 历史表。批量直写、增量同步和分析直读有各自的提交与执行路径,不能仅凭共用对象存储就视为同一种操作。
3 实验配置、结果与适用条件
3.1 启动与扩缩容
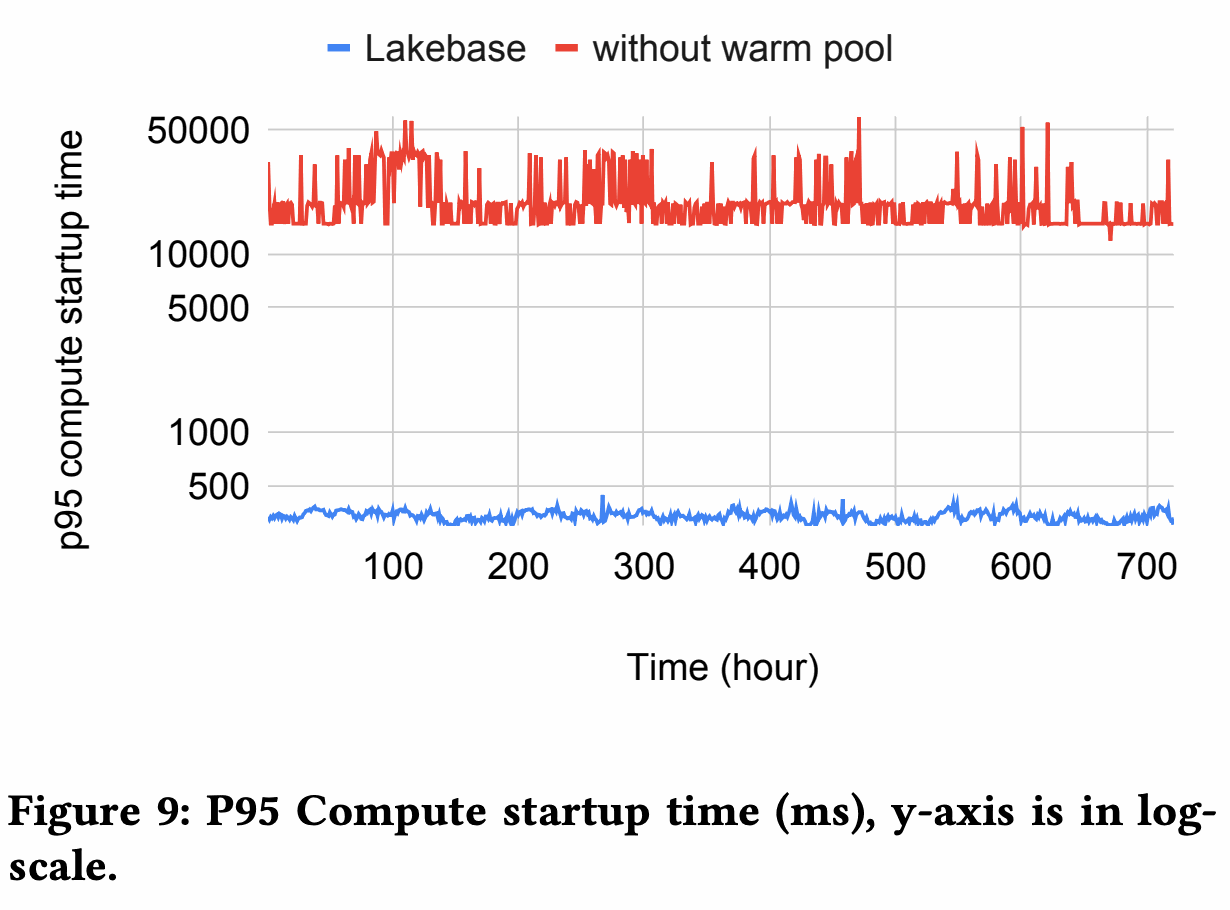
图 5:论文 Figure 9,第 4394 页。纵轴是启动 P95,单位为 ms,使用对数刻度;横轴为生产观测时间。1
论文第 7.1 节的生产观测中,Compute 启动 P95 持续低于 500 ms。 典型分解为 Basebackup 约 100 ms、Safekeeper 同步和写主身份确认约 5 ms、启动 Compute 约 150 ms、配置不到 5 ms。这些阶段的典型耗时用于解释来源,不能相加后当作端到端 P95。第 5.3 节另外使用了 Median 口径,本文以 Figure 9 对应的 P95 结果为准。1
启动测试使用预热 VM 池,并将恢复起点放到 Pageserver 已摄入的位置。它测量的是 Compute 启动,不能外推为数据库冷缓存已经预热、任意首条查询也能在 500 ms 内结束,更不能将分支元数据的常数复杂度等同于完整应用环境准备耗时。
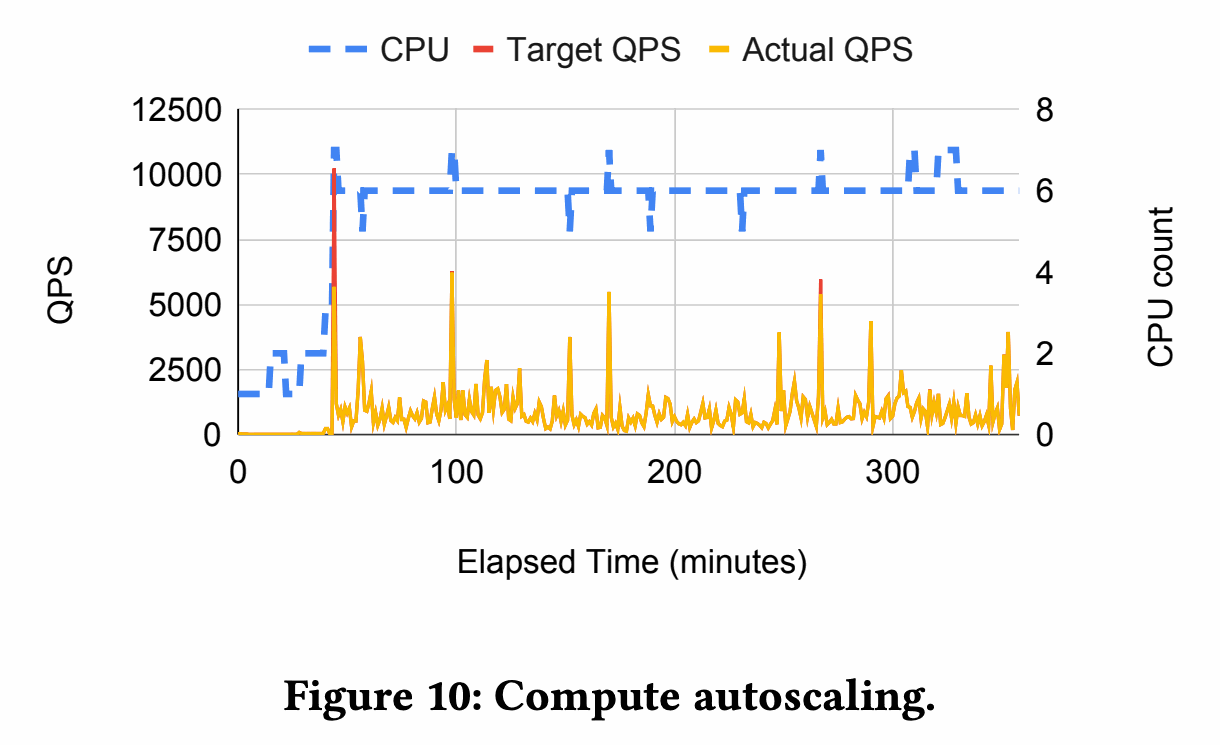
图 6:论文 Figure 10,第 4394 页。左轴为 QPS,右轴为 CPU 数;虚线为 CPU 配置,实线表示目标与实际吞吐。1
扩缩容实验从生产股票交易应用提取负载,使用按目标 QPS 发起请求的开放式模拟,CPU 配置范围为 1--7。 第 44 分钟,目标负载由 32 QPS 突增到约 10K QPS,缓存命中率降到 30% 以下,系统将 CPU 增至上限,同时扩大缓存。论文报告实际 QPS 基本跟随目标负载;与固定 7 CPU 相比,弹性实例前期因缓存更小而稍慢,稳定后延迟接近,总 CPU-hours 更少。1
这里缺少可直接用于成本核算的 CPU-hours 节省比例,也没有完整的请求尾延迟分布。图能说明该负载下容量随需求变化,尚不足以量化其他负载的节省幅度。
3.2 缓存充足条件下的 OLTP 吞吐
OLTP 实验使用 HammerDB TPROC-C,每 vCPU 配置 16 个 Warehouse,Virtual User 从 1 按二的幂递增到 512,每个用户访问全部 Warehouse。整个工作集能够放入 DRAM,结果取 NewOrder P95 不超过 20 ms 时的峰值 NOPM,即每分钟完成的 NewOrder 事务数。1
| 配置档位(vCPU) | Gen-1 NOPM(千) | Gen-2 NOPM(千) | Lakebase NOPM(千) |
|---|---|---|---|
| 1 | --- | 9.0 | 23.3 |
| 4 | 92.6 | 61.7 | 86.8 |
| 16 | 118.3 | 265.7 | 331.3 |
| 24 | 96.8* | 407.5 | 515.6 |
表 1:转录自论文 Table 1,第 4395 页。Gen-1 为运行在跨 AZ 同步复制磁盘上的 PostgreSQL,Gen-2 为存算分离数据库,均未披露具体产品名。Gen-1 不提供 1 vCPU 档位;标记为星号的结果实际使用 32 vCPU,与另外两组一样配置 384 个 Warehouse。1
Lakebase 相对 Gen-2 在 1 vCPU 下约为 2.6 倍,在 24 vCPU 下高约 26%。 论文将收益归因于日志复制路径的 CPU 开销、页面物化外移及较低的 WAL 量。不过,4 vCPU 时 Lakebase 的 86.8K NOPM 低于 Gen-1 的 92.6K,结果本身并不支持所有配置都更快。
更大的限定是缓存。 论文另外报告,其评估中的 Compute 缓存命中率通常高于 98.5%,大量请求不会走到远端页面重建路径。这个实验验证了热工作集上的事务处理能力,对冷启动、工作集超过缓存、长 WAL 链或深层分支下的读延迟,仍需要独立测试。匿名基线和 vCPU 档位也不足以复算完整的服务性价比。1
3.3 分析直读与批量导入
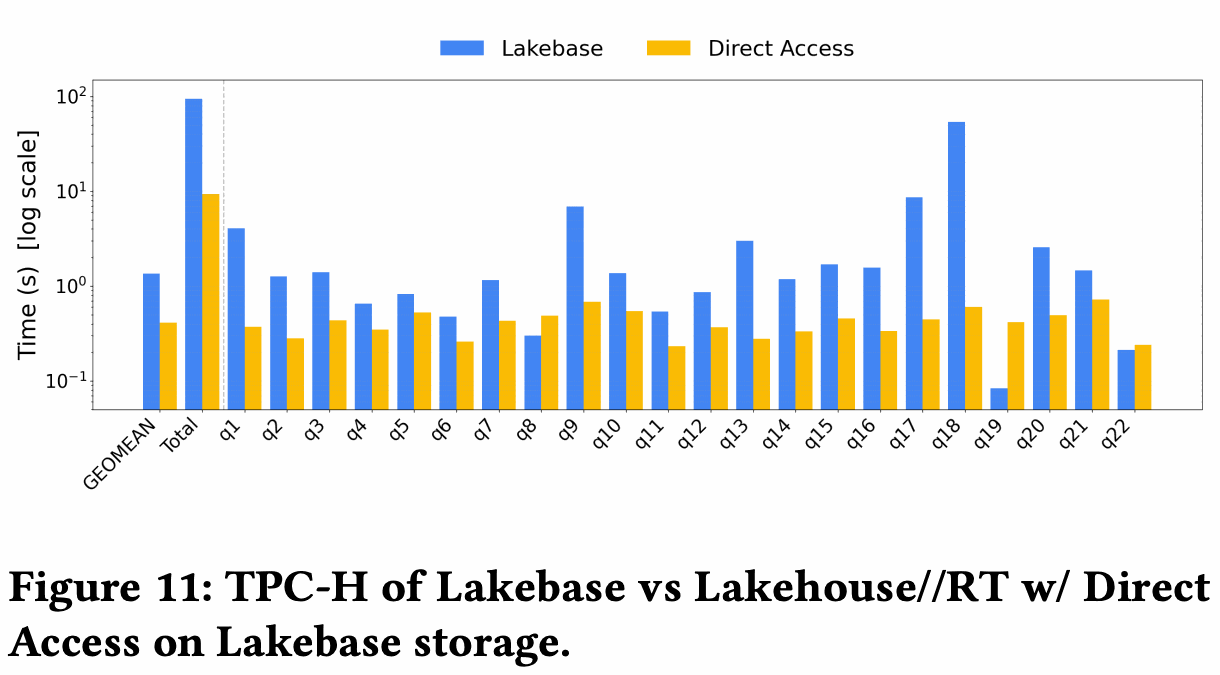
图 7:论文 Figure 11,第 4395 页。TPC-H Scale Factor 为 10,两种执行方式使用相同的 Lakebase 存储和相同硬件资源;纵轴为耗时,使用对数刻度。1
Direct Access 的总执行时间缩短约 10 倍,查询延迟的几何平均改善约 3 倍。 这是两个不同统计口径。Q1 约快 11 倍,主要受益于并行聚合;Q17 约快 19 倍,涉及将子查询改写为 Join 的计划优化;Q18 接近 90 倍。数据同时说明,提升来自存储访问、解析、执行器与优化器的组合,无法仅归因于绕过 PostgreSQL Compute。1
Q8 和 Q19 更慢,因为 PostgreSQL 可以利用 Index Nested-loop Join,而 Direct Access 当前只有顺序扫描。并发加入 400 QPS OLTP 后,Direct Access 扫描因缓存失效变慢至约 1.76 倍耗时。论文报告主库写延迟未受影响;这个混合负载结果支持计算分离的隔离收益,共享存储在更高并发下的竞争仍需另测。1
DTS 实验加载由 Text 和 Integer 混合列组成、每行约 1 KB 的表。 相对 COPY,5 GB 时 Heap-write 阶段加速 2.6 倍,100 GB 时为 7.9 倍,1 TB 时达到 73.3 倍。论文衡量的是 Heap-write 时间,并利用 Spark 横向扩展;不能将 73.3 倍推广为包含索引构建、统计信息更新、资源成本在内的完整导入收益。1
4 结束语
-
共享日志之后,副本如何构建决定恢复代价。 Lakebase 的 Pageserver 主副本负责构建并上传 Layer File,Hot Standby 从 Object Storage 下载 Snapshot 和热数据。这里各副本的 WAL 摄入、页面物化和缓存进度可以不同步;事务提交仍由 Safekeeper 多数派持久化保证。接管时,备用 Pageserver 需要补齐请求涉及的 Layer File,还可能需要追赶尚未形成 Layer File 的 WAL;未归档 WAL 从幸存 Safekeeper 获取,已归档 WAL 则可以从 Object Storage 获取。不能把主副本上传完成的位置当成数据库已经提交的位置。1
论文中的预取是在故障前持续下载热数据,不需要提前知道哪台机器会挂。我对快速恢复的保留在于:预取覆盖了多少工作集、备用节点落后多少 WAL,仍然决定突发故障后的实际恢复成本。故障通常没有足够的准备窗口,不能把故障后临时搬数据当成主要恢复方案。这里不展开 Perseus 一类 Fail-slow 检测机制。6
共享日志副本这套东西我们两年前就在玩了。Lakebase 的备用副本主要复用主副本已经构建的文件,我们选择让每个副本独立消费共享日志、独立构建存储。这样会多花日常构建的 CPU 和 I/O,但故障时幸存副本已经有自己的可用状态,恢复路径更短。我们当时优先选择的就是这个取舍。
-
分支的复杂度取决于状态模型。 数据库要做分支,Agent 状态存储也要做分支,两者的约束差很多。我们的状态存储在单个 Session 内保证
messageid单调递增,用混合逻辑时钟(HLC)组织多机写入,保留统一可排序的 ID;Session 内没有消息删除,历史可以按追加记录处理。分支只需要维护自身branch_id、父分支及分叉点的messageid,读取时把祖先链上的可见区间合起来。例如 B 从 A 的
:fork位置分叉,读取 B 中晚于:cursor的消息,可以将下面的条件下推到存储:sqlsession_id = :session AND messageid > :cursor AND ( (branch_id = :B AND messageid > :fork) OR (branch_id = :A AND messageid <= :fork) )这里用 OR 合并不同分支的区间。祖先更多时,每个祖先都有自己的上下界,不能把不同
branch_id的条件用 AND 串起来。在 Session 范围内建立(branch_id, messageid)二级索引,再按 ID 排序或取末尾 N 条,buildcontext、getLastN、listmessage就能复用这套可见性条件。Lakebase 的 Timeline 也保留父引用和分叉位置,但它保存的是不断修改的 PostgreSQL 页面。一个页面的 Delta 通常要依赖此前的 Image 才能重建,子 Timeline 的增量记录未必包含这个基底,
GetPage@LSN因而需要沿父链继续查找分叉点之前的 Image 和 Delta。论文可以确认:每个 Timeline 有自己的页面 Key/LSN 二维索引空间、Layer File 集合和远端 Index File,Compaction 与 GC 也主要按 Timeline 独立推进;同一 Tenant 的 Timeline 共用 Pageserver 部署。至于内存里具体用了哪种树、是否对应独立的树对象实例,论文没有展开。1 消息分支是在几个可见区间里取完整记录,页面分支还要跨历史重建同一个可变对象。 -
Agent 应用数据库要单独算一种存储形态。 TiDB X、Lakebase,包括最近 TDSQL 面向 Agent 的产品方向,补上了 Agent 应用数据存储这一层。178 之前《从一到无穷大 #71》讨论的状态存储、制品存储、沙箱和可观测,主要围绕 Agent 自身的执行过程、产物与证据;这里关心的是 Agent 创建和运行的应用所依赖的业务数据库。Agent 可以生成应用,也可以反复修改 Schema、建立测试分支、丢掉失败环境,最后留下需要长期运行的业务系统。应用数据的事务、隔离和生命周期,值得单独作为产品问题讨论。
-
大规模分析,我更愿意直接写入独立 AP 存储。 论文中的 Direct Access 读取 PostgreSQL 页面,将其解析成 Arrow Batch,按 Relation 和 Page Range 缓存在内存中,并按页面修改信息刷新缓存。1 对大规模、持续更新的分析负载,我认为继续依赖行式页面、反复解析并维护这份缓存没有必要。论文里的小规模实验已经能看到更新导致缓存失效的代价,我更愿意直接保留适合分析的持久化布局。
OLTP 与 AP 使用各自的存储方式,把需要分析的数据直接写入独立 AP 存储,Agent 应用数据和状态数据的分析可以共用一个 AP 计算引擎。这也是我现在主攻的方向 。论文 §6.3 本身也提供了
wal2delta同步到 Lakehouse 的路径,Direct Access 只是其中一种选择。1Habitat 将在线存储的变更通过 CDC 送到独立 Rockset 实例,供复杂查询使用,这种在线服务与分析副本分开的做法很值得参考。9 在我要处理的 Agent 场景里,相比沙箱和 LLM 的开销,多保留一份适合 AP 的数据,存储成本不是大问题。我更在意分析能否高效扩展,以及它会不会反过来影响在线请求。
5 参考资料
1 Jasraj Dange、Andrei Dragus、Ali Ghodsi 等:Lakebase: Serverless Postgres over Open Lake Storage,PVLDB 19(12),4385--4398,2026,DOI:10.14778/3827998.3828040。本文架构、机制、实验与原图均以该版本为准。
2 PostgreSQL Global Development Group:PostgreSQL 18 Documentation --- Database Page Layout。用于说明 PostgreSQL 表、索引页面与行记录的粒度,不作为 Lakebase Key 编码的依据。
3 PostgreSQL Global Development Group:PostgreSQL 18 Documentation --- WAL Internals。用于说明 WAL 的日志顺序、Redo 与 Full-page Image。
4 PostgreSQL 官方源码:REL_18_STABLE --- xlogrecord.h。用于核对 WAL 的操作类型、Block Reference 与页面定位信息。
5 PostgreSQL 官方源码:REL_18_STABLE --- heapam_xlog.c。用于核对 WAL Redo 恢复标准 PostgreSQL 页面的通用机制,不代表 Lakebase 使用该版本或相同模块部署。
6 USENIX FAST '23:Perseus: A Fail-Slow Detection Framework for Cloud Storage Systems。用于区分 Fail-slow 检测与突发故障恢复,本文不展开其机制。
7 PingCAP:Lakebase vs. TiDB X: Separation of Compute and Storage。用于核对 Agent 应用对数据库创建、分支和弹性生命周期的需求。
8 腾讯云:AI 原生数据平台 TDSQL Nexa。官方产品定位包含 Coding Agent、Data Agent、事务与分析等场景;本文只引用这一产品方向,未核验其全部架构和性能主张。
9 OpenAI:Rapidly scaling online storage to serve over 1 billion ChatGPT users,2026-09-11。用于核对 Habitat 通过 CDC 将变更送入独立 Rockset 实例、提供复杂查询视图的设计。