第八章:Agent 记忆与状态管理
记忆是智能的核心特征。一个没有记忆的 Agent,每次交互都面对全新世界;具备良好记忆系统的 Agent,能记住用户偏好、学习历史模式、保持跨会话上下文连贯。本章从记忆类型划分到存储设计,从压缩策略到遗忘机制,给出一个完整的记忆架构设计。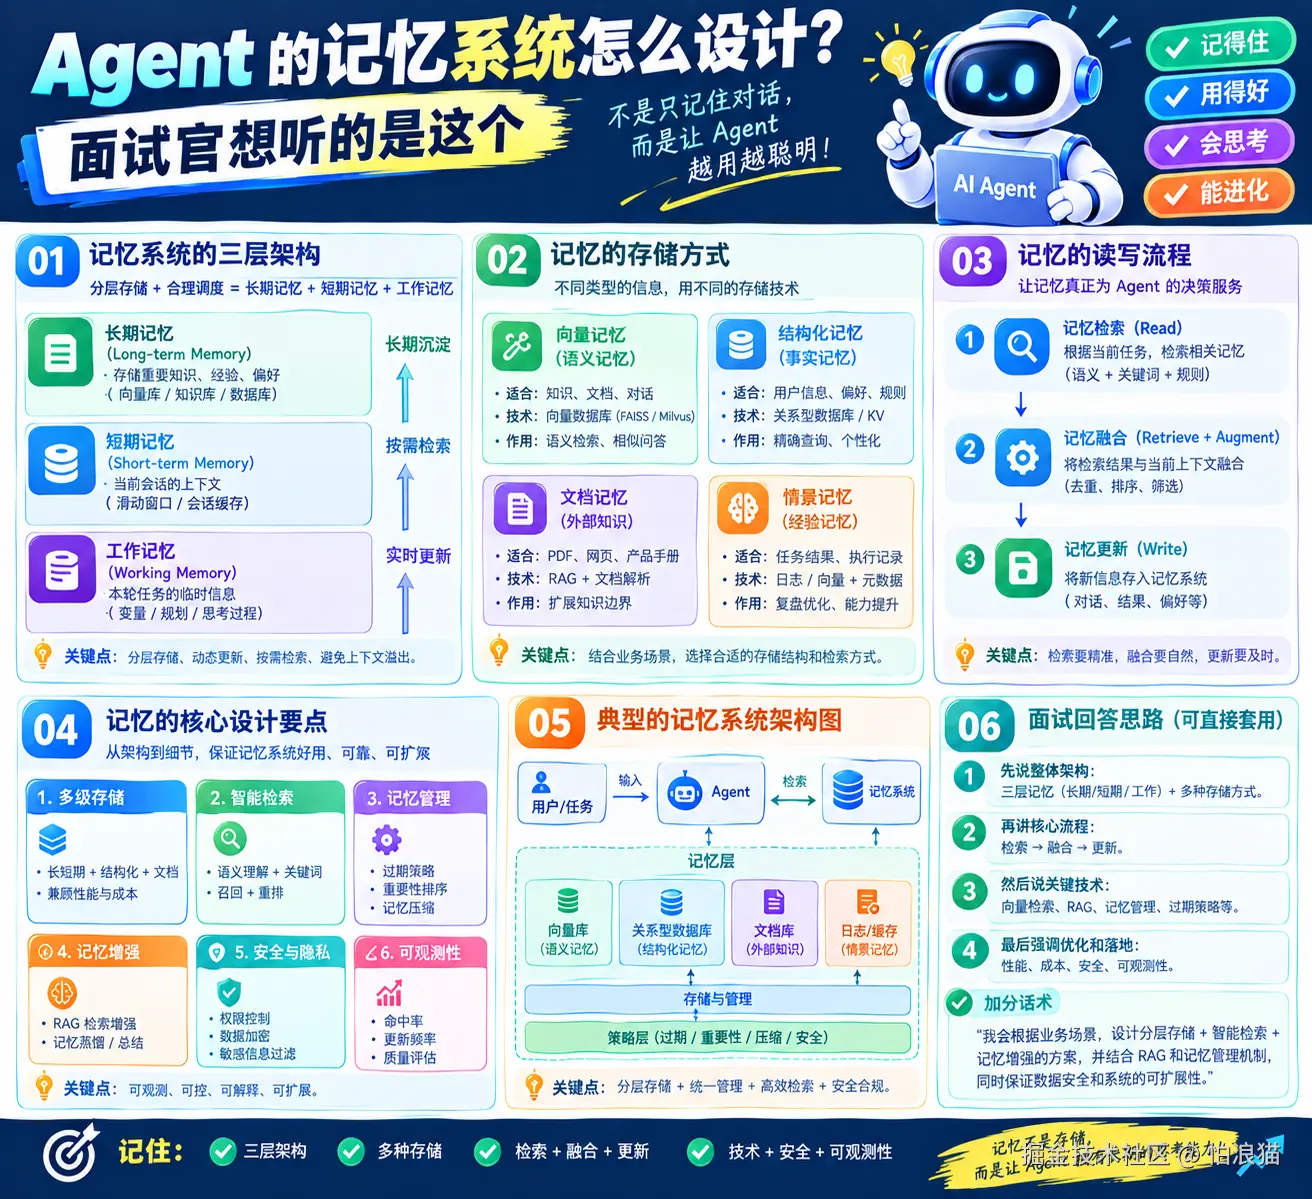
8.1 Agent 记忆类型:短期、长期与工作记忆
AI Agent 的记忆系统借鉴了认知科学中感觉记忆、短期记忆和长期记忆的分类框架,但根据自身特点做了调整和扩展。
三种核心记忆类型
Agent 的记忆通常分为三种类型:短期记忆(Short-term Memory)、长期记忆(Long-term Memory)和工作记忆(Working Memory)。这三种记忆各自承担不同的职能,协同构成完整的记忆体系。
短期记忆对应 Agent 在当前会话中的上下文窗口。最近的消息历史保存在这里,访问速度快、信息完整度高,但容量受限于 LLM (Large Language Model, 大语言模型) 的上下文窗口大小。一旦会话结束或上下文溢出,信息就丢失了。
长期记忆是跨会话持久化保存的信息,存储用户偏好、历史决策、学习到的知识等。不受会话边界限制,任意时刻可检索调用,容量大、持久性强,但访问需要经过检索过程,速度相对较慢。
工作记忆是 Agent 在执行具体任务时临时维护的一组相关信息。比如多步推理时需要记住中间结果、待办事项和当前进度。工作记忆可以是短期记忆的子集,也可以是从长期记忆中检索出的信息与当前上下文的临时组合。
记忆类型的对比
| 维度 | 短期记忆 | 工作记忆 | 长期记忆 |
|---|---|---|---|
| 生命周期 | 单次会话 | 单次任务 | 跨会话持久 |
| 存储位置 | 上下文窗口 | 临时变量/缓存 | 数据库/文件系统 |
| 访问速度 | 最快(直接可用) | 快(内存访问) | 较慢(需检索) |
| 容量限制 | 受 token 限制 | 受内存限制 | 理论上无限制 |
| 典型内容 | 对话历史 | 任务中间状态 | 用户偏好、知识库 |
| 持久化 | 否 | 否 | 是 |
短期记忆的管理挑战
短期记忆管理的核心挑战是上下文窗口有限。GPT-4 的 128K tokens 看似很大,长对话场景下仍然会溢出。常见的处理方式有滑动窗口(保留最近 N 条消息)、摘要压缩(将早期对话压缩为摘要)、选择性保留(只留关键信息),各有优劣,需根据场景选择。
python
class ShortTermMemory:
    """短期记忆管理器,基于滑动窗口 + 摘要策略"""

    def __init__(self, max_messages: int = 50, token_limit: int = 8000):
        self.messages = []          # 完整消息列表
        self.max_messages = max_messages  # 最大保留消息数
        self.token_limit = token_limit    # token 上限
        self.summary = ""           # 早期对话摘要

    def add_message(self, role: str, content: str):
        self.messages.append({"role": role, "content": content})
        self._evict_if_needed()

    def _evict_if_needed(self):
        """超出容量时,将最旧的消息压缩为摘要"""
        if len(self.messages) > self.max_messages:
            old_msgs = self.messages[:10]
            self.summary = self._compress(old_msgs)
            self.messages = self.messages[10:]

    def get_context(self) -> str:
        """获取当前可用的上下文"""
        parts = []
        if self.summary:
            parts.append(f"[Earlier conversation summary]: {self.summary}")
        for msg in self.messages:
            parts.append(f"{msg['role']}: {msg['content']}")
        return "\n".join(parts)
工作记忆的实践意义
工作记忆在复杂任务执行中尤为重要。以代码编辑 Agent 为例,重构大型文件时需要维护:当前修改的函数名、已完成修改点、待修改位置列表、依赖关系图。信息在任务执行中不断更新,任务完成后即丢弃。
工作记忆通常采用结构化格式而非自然语言文本,这样 Agent 可以精确更新和查询特定字段,不用担心自然语言歧义。
python
class WorkingMemory:
    """工作记忆:任务执行期间的临时状态管理"""

    def __init__(self):
        self.task_stack = []        # 任务栈,支持子任务嵌套
        self.facts = {}             # 已知事实
        self.todo = []              # 待办事项
        self.results = {}           # 中间结果

    def push_task(self, task: dict):
        self.task_stack.append(task)

    def pop_task(self) -> dict:
        return self.task_stack.pop()

    def set_fact(self, key: str, value):
        self.facts[key] = value

    def get_fact(self, key: str):
        return self.facts.get(key)

    def add_todo(self, item: str):
        self.todo.append({"item": item, "done": False})

    def complete_todo(self, index: int):
        if 0 <= index < len(self.todo):
            self.todo[index]["done"] = True
三种记忆类型并非孤立存在,而是形成一条信息流动管道:短期记忆中的信息经筛选和压缩后写入长期记忆,长期记忆中的信息在需要时被检索到工作记忆中参与任务执行。理解三者的协作方式,是设计 Agent 记忆系统的基础。
8.2 长期记忆存储设计:向量、KV 与图数据库
长期记忆的存储设计是 Agent 记忆系统中最核心的工程问题。存储方案直接决定记忆的写入速度、检索效率和可维护性。主流方案有三种:向量数据库、KV (Key-Value, 键值对) 存储和图数据库。
向量数据库:语义检索的首选
向量数据库是当前 AI Agent 长期记忆最常用的存储方案。核心思路是将文本转换为高维向量,通过向量相似度检索找到语义相近的记忆。它天然适配 LLM 的语义理解能力,能实现"模糊匹配"------查询词与存储内容字面不同,语义相近就能命中。
工作流程分三步:写入时,文本经 Embedding 模型转为向量连同元数据存入数据库;检索时,查询文本同样转为向量,在数据库中找最相似的 K 条记忆;返回时,将匹配的记忆文本和相似度分数返回给 Agent。
python
import numpy as np
from dataclasses import dataclass, field
from typing import List, Dict, Optional
import json

@dataclass
class MemoryItem:
    """单条记忆的数据结构"""
    id: str                          # 唯一标识
    content: str                     # 记忆文本内容
    embedding: List[float]           # 向量表示
    metadata: Dict = field(default_factory=dict)  # 元数据
    timestamp: float = 0             # 创建时间戳
    access_count: int = 0            # 访问次数
    importance: float = 0.5          # 重要度评分 [0, 1]


class VectorMemoryStore:
    """基于向量的记忆存储"""

    def __init__(self, dim: int = 1536):
        self.dim = dim
        self.memories: Dict[str, MemoryItem] = {}

    def add(self, item: MemoryItem):
        self.memories[item.id] = item

    def search(self, query_vec: List[float], top_k: int = 5) -> List[MemoryItem]:
        """余弦相似度检索"""
        scores = []
        for mid, mem in self.memories.items():
            sim = self._cosine(query_vec, mem.embedding)
            # 综合相似度、重要度和时间衰减
            final_score = sim * 0.7 + mem.importance * 0.2 + self._recency_bonus(mem.timestamp) * 0.1
            scores.append((final_score, mem))
        scores.sort(key=lambda x: -x[0])
        return [mem for _, mem in scores[:top_k]]

    def _cosine(self, a: List[float], b: List[float]) -> float:
        return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b) + 1e-8)

    def _recency_bonus(self, ts: float) -> float:
        """时间衰减因子,越新得分越高"""
        import time
        age = time.time() - ts
        return max(0, 1 - age / (86400 * 30))  # 30天线性衰减
KV 存储:精确匹配的利器
KV 存储是最简单的方案。每条记忆以键值对形式存储,键是唯一标识或分类标签,值是记忆内容。读写速度极快,适合结构化的、需要精确匹配的信息。
典型场景:用户偏好设置(如"语言=中文"、"回答风格=简洁")、事实性知识(如"用户生日=1990-01-01")、配置信息。不需要语义检索,只需精确查找。
python
class KVMemoryStore:
    """键值对记忆存储,适合结构化信息"""

    def __init__(self):
        self.store: Dict[str, any] = {}

    def set(self, key: str, value):
        self.store[key] = {
            "value": value,
            "timestamp": time.time(),
            "version": self.store.get(key, {}).get("version", 0) + 1
        }

    def get(self, key: str, default=None):
        entry = self.store.get(key)
        return entry["value"] if entry else default

    def delete(self, key: str):
        self.store.pop(key, None)

    def list_keys(self, prefix: str = "") -> List[str]:
        return [k for k in self.store if k.startswith(prefix)]
图数据库:关系记忆的骨架
图数据库的存储方式与前两者截然不同,以节点和边组织信息------节点代表实体或事件,边代表关系。核心优势是能捕捉记忆之间的关联关系,支持多跳推理。
比如 Agent 要记住"用户在去年圣诞节提到了他的女儿小美"。图数据库中,表示为:用户节点 --(has_child)--> 小美节点,用户节点 --(mentioned_at)--> 圣诞节事件节点。查询"用户家庭成员"时,通过图遍历直接找到关联节点。
python
@dataclass
class GraphNode:
    """图节点:实体或概念"""
    id: str
    type: str               # person, event, concept, etc.
    properties: Dict = field(default_factory=dict)

@dataclass
class GraphEdge:
    """图边:关系"""
    source: str             # 源节点 ID
    target: str             # 目标节点 ID
    relation: str           # 关系类型
    properties: Dict = field(default_factory=dict)

class GraphMemoryStore:
    """图数据库记忆存储"""

    def __init__(self):
        self.nodes: Dict[str, GraphNode] = {}
        self.edges: List[GraphEdge] = []

    def add_node(self, node: GraphNode):
        self.nodes[node.id] = node

    def add_edge(self, edge: GraphEdge):
        self.edges.append(edge)

    def get_neighbors(self, node_id: str, relation: str = None) -> List[GraphNode]:
        """获取邻居节点"""
        neighbors = []
        for edge in self.edges:
            if edge.source == node_id:
                if relation is None or edge.relation == relation:
                    neighbors.append(self.nodes.get(edge.target))
            elif edge.target == node_id:
                if relation is None or edge.relation == relation:
                    neighbors.append(self.nodes.get(edge.source))
        return [n for n in neighbors if n]

    def multi_hop_query(self, start_id: str, hops: int = 2) -> List[GraphNode]:
        """多跳查询"""
        visited = {start_id}
        frontier = [start_id]
        for _ in range(hops):
            next_frontier = []
            for nid in frontier:
                for edge in self.edges:
                    other = edge.target if edge.source == nid else (
                        edge.source if edge.target == nid else None
                    )
                    if other and other not in visited:
                        visited.add(other)
                        next_frontier.append(other)
            frontier = next_frontier
        return [self.nodes[nid] for nid in visited if nid in self.nodes]
三种存储方案的对比与选型
| 维度 | 向量数据库 | KV 存储 | 图数据库 |
|---|---|---|---|
| 检索方式 | 语义相似度 | 精确键匹配 | 关系遍历 |
| 写入速度 | 中等(需计算向量) | 最快 | 较慢(需维护关系) |
| 检索精度 | 模糊匹配,适合召回 | 精确匹配 | 关系推理强 |
| 适用场景 | 对话历史、知识库 | 用户偏好、配置 | 实体关系、因果推理 |
| 典型产品 | Pinecone, Milvus | Redis, DynamoDB | Neo4j, NebulaGraph |
| 扩展性 | 好 | 极好 | 一般 |
实际系统通常不会只用一种方案,而是三者结合:向量数据库负责语义检索,KV 存储负责精确查找,图数据库负责关系推理,通过统一的记忆管理器协调工作。
8.3 Memory Compression:记忆压缩与摘要策略
随着 Agent 运行时间增长,记忆数据量持续膨胀。不加控制的话,存储成本线性增长,检索效率显著下降。记忆压缩将冗长的记忆数据浓缩为高信息密度的摘要,是记忆管理中不可或缺的一环。
为什么需要记忆压缩
压缩需求来自三方面压力:存储成本(完整保存一个月对话量可能达数百 MB)、检索效率(向量检索时间复杂度与数据量正相关)、上下文窗口限制(检索到的记忆太长也无法全部放入 LLM 上下文)。
记忆压缩的本质是信息蒸馏------在尽可能保留关键信息的前提下减少数据体积,要求压缩算法能区分"核心信息"和"可丢弃细节"。
压缩策略分类
记忆压缩分三个层次:消息级压缩针对单条消息,去除罜余信息(如 500 字调试日志压缩为"执行命令 X,报错 Y,通过 Z 修复"),通常在消息写入记忆前实时完成;会话级压缩将数十条消息浓缩为结构化摘要,在会话结束时批量执行,用 LLM 生成高质量摘要;跨会话压缩将多次会话摘要再次压缩合并,形成用户级知识沉淀,频率低但跨度大。
python
from dataclasses import dataclass
from typing import List
import time

@dataclass
class CompressedMemory:
    """压缩后的记忆结构"""
    id: str
    summary: str                   # 压缩摘要
    source_ids: List[str]          # 原始记忆 ID 列表
    key_entities: List[str]        # 关键实体
    key_topics: List[str]          # 关键主题
    created_at: float              # 压缩时间
    original_size: int             # 原始字数
    compressed_size: int           # 压缩后字数

    @property
    def compression_ratio(self) -> float:
        if self.original_size == 0:
            return 0
        return 1 - self.compressed_size / self.original_size


class MemoryCompressor:
    """记忆压缩器"""

    COMPRESSION_PROMPT = """请将以下对话历史压缩为简洁的结构化摘要。
要求:
1. 保留所有关键事实、决策和用户偏好
2. 丢弃寒暄、重复内容和无关细节
3. 提取关键实体和主题
4. 输出格式:JSON,包含 summary, key_entities, key_topics 字段

对话历史:
{conversation}
"""

    def compress_conversation(self, messages: List[dict]) -> CompressedMemory:
        """压缩一次会话的记忆"""
        # 1. 拼接对话文本
        conv_text = "\n".join(
            f"{m['role']}: {m['content']}" for m in messages
        )

        # 2. 调用 LLM 生成压缩摘要
        prompt = self.COMPRESSION_PROMPT.format(conversation=conv_text)
        # result = llm.generate(prompt)  # 实际调用 LLM
        result = {
            "summary": "用户咨询了 Agent 记忆系统设计,讨论了短期和长期记忆方案",
            "key_entities": ["用户", "Agent记忆系统", "短期记忆", "长期记忆"],
            "key_topics": ["记忆架构", "存储设计", "压缩策略"]
        }

        original_size = sum(len(m["content"]) for m in messages)

        return CompressedMemory(
            id=f"compressed_{int(time.time())}",
            summary=result["summary"],
            source_ids=[m.get("id", str(i)) for i, m in enumerate(messages)],
            key_entities=result["key_entities"],
            key_topics=result["key_topics"],
            created_at=time.time(),
            original_size=original_size,
            compressed_size=len(result["summary"])
        )

    def merge_compressed(
        self, memories: List[CompressedMemory]
    ) -> CompressedMemory:
        """合并多条已压缩的记忆(跨会话压缩)"""
        combined_text = "\n---\n".join(m.summary for m in memories)
        # 调用 LLM 再次压缩
        # result = llm.generate(self.COMPRESSION_PROMPT.format(...))

        total_original = sum(m.original_size for m in memories)
        return CompressedMemory(
            id=f"merged_{int(time.time())}",
            summary=combined_text[:500],  # 简化示例
            source_ids=[m.id for m in memories],
            key_entities=[],
            key_topics=[],
            created_at=time.time(),
            original_size=total_original,
            compressed_size=len(combined_text[:500])
        )
压缩质量评估
记忆压缩不是简单的文本摘要,要保证压缩后不丢失关键内容。评估压缩质量看三个维度:
信息保留率------压缩后摘要覆盖了多少原始信息。从原始记忆中提取关键事实点,检查是否在摘要中出现,一般要求不低于 80%。
压缩比------原始数据量与压缩后数据量的比值,合理范围 5:1 到 20:1。过高导致信息丢失,过低没有发挥压缩价值。
检索影响度------压缩后记忆在检索时的召回率和准确率不应显著低于原始记忆。如果明显下降,说明压缩策略需调整。
压缩的时机选择
何时触发压缩需要权衡:太频繁增加计算开销(每次压缩都需调用 LLM),太晚导致短期记忆溢出或存储成本过高。常用触发条件包括消息数量阈值(超过 50 条触发会话级压缩)、token 数量阈值(接近上下文窗口 80% 时触发)、时间阈值(每 6 小时一次跨会话压缩)、事件驱动(会话结束时自动触发)。实际系统通常组合使用。
8.4 遗忘机制:有选择地丢弃信息
遗忘和记忆同等重要。不加区分地保留所有信息,存储成本不可控,检索时大量无关记忆会干扰真正有用的信息,"记忆噪音"淹没信号。遗忘机制就是有选择地丢弃低价值信息,让有限资源集中在重要内容上。
遗忘的心理学基础
认知科学中,艾宾浩斯遗忘曲线描述了记忆随时间衰减的规律:没有重复强化的记忆快速遗忘,速度先快后慢。主动抑制理论则认为大脑会主动抑制无关记忆提取以减少干扰。这些理论为 Agent 遗忘机制设计提供了启发。
遗忘策略设计
Agent 的遗忘策略有几种类型。
时间驱动遗忘是最基础的策略。每条记忆有 TTL (Time-to-Live, 生存时间) 属性,超过 TTL 后标记为可遗忘。TTL 长度取决于记忆类型和重要度------日常闲聊 TTL 可能 7 天,用户偏好 365 天,关键决策记录永久不遗忘。
访问频率驱动遗忘借鉴 LRU (Least Recently Used, 最近最少使用) 缓存淘汰思路:长时间未被检索的记忆价值较低,优先遗忘。每条记忆维护 last_accessed 字段,定期清理超时未访问的记忆。
重要度驱动遗忘通过 LLM 或规则引擎对记忆评分,低分优先遗忘。评估维度包括:是否包含用户偏好、是否涉及关键决策、是否被多次引用。
冲突驱动遗忘处理信息更新场景:新记忆与旧记忆矛盾时,旧记忆需更新或遗忘。比如用户先前说"住上海",后来又说"搬到北京了",旧记忆应更新。
| 遗忘策略 | 触发条件 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 时间驱动 | TTL 到期 | 简单可靠 | 不考虑内容价值 | 临时信息、日志 |
| 访问频率驱动 | 长期未访问 | 自动适应用户行为 | 可能误删重要但少用的记忆 | 对话历史、知识片段 |
| 重要度驱动 | 评分低于阈值 | 内容感知 | 评估成本高 | 所有类型记忆 |
| 冲突驱动 | 检测到矛盾信息 | 保持记忆一致性 | 冲突检测复杂 | 事实性记忆 |
| 容量驱动 | 超过存储上限 | 保证系统稳定 | 可能删除有用记忆 | 存储受限场景 |
遗忘机制的代码实现
python
import time
from dataclasses import dataclass
from typing import List, Optional

@dataclass
class ForgettableMemory:
    """可遗忘的记忆条目"""
    id: str
    content: str
    created_at: float
    last_accessed: float
    access_count: int = 0
    importance: float = 0.5        # [0, 1]
    ttl_seconds: float = 86400 * 30  # 默认 30 天
    tags: List[str] = None

class ForgettingManager:
    """遗忘管理器"""

    def __init__(self):
        self.memories: dict = {}

    def should_forget(self, mem: ForgettableMemory,
                      capacity_limit: Optional[int] = None) -> bool:
        """判断一条记忆是否应该被遗忘"""
        now = time.time()

        # 策略 1: TTL 过期
        if now - mem.created_at > mem.ttl_seconds:
            if mem.importance < 0.8:  # 高重要度记忆豁免
                return True

        # 策略 2: 长期未访问
        idle_days = (now - mem.last_accessed) / 86400
        if idle_days > 14 and mem.access_count < 3:
            return True

        # 策略 3: 容量驱动
        if capacity_limit and len(self.memories) > capacity_limit:
            # 当超过容量时,淘汰重要度最低且最久未访问的记忆
            score = self._forget_score(mem)
            if score < 0.3:
                return True

        return False

    def _forget_score(self, mem: ForgettableMemory) -> float:
        """计算遗忘分数,越低越应该被遗忘"""
        now = time.time()
        recency = max(0, 1 - (now - mem.last_accessed) / (86400 * 30))
        frequency = min(1, mem.access_count / 10)
        return recency * 0.3 + frequency * 0.3 + mem.importance * 0.4

    def run_forgetting_cycle(self, capacity_limit: Optional[int] = None):
        """执行一轮遗忘清理"""
        to_remove = []
        for mid, mem in self.memories.items():
            if self.should_forget(mem, capacity_limit):
                to_remove.append(mid)

        for mid in to_remove:
            # 遗忘前可以归档而非直接删除
            del self.memories[mid]

        return len(to_remove)

    def update_on_access(self, memory_id: str):
        """记忆被访问时更新访问记录"""
        if memory_id in self.memories:
            mem = self.memories[memory_id]
            mem.last_accessed = time.time()
            mem.access_count += 1
渐进式遗忘 vs 硬遗忘
遗忘不一定是非黑即白的删除。渐进式遗忘分多个阶段:先降低检索权重,使其不太容易被检索到;再压缩摘要,只保留核心信息;最后才真正删除。好处是后续发现某条记忆有用,还有挽回余地。
硬遗忘是立即删除,适用于明确无用的信息(用户要求删除的隐私数据、明显错误的信息等),不可恢复。
建议默认采用渐进式遗忘,仅在用户明确要求删除或信息被判定为有害时才用硬遗忘。
8.5 跨会话记忆:用户级记忆的持久化
单会话内的记忆管理相对简单,真正的挑战在于跨会话持久化。用户今天上午聊了工作计划,下午来问进度,明天还要继续推进------Agent 必须"记住"之前会话的关键信息,在新会话中正确检索和使用。
跨会话记忆的核心问题
跨会话记忆要解决三个核心问题:信息提取(并非所有对话值得跨会话保留,需筛选值得长期记忆的信息)、信息组织(记忆数量持续增长,需要合理的组织方式保证检索效率)、信息更新(用户情况随时间变化,旧记忆需更新而非简单堆积)。
用户级记忆的数据结构
用户级记忆通常以用户 ID 为命名空间进行隔离,每个用户拥有独立的记忆空间。以下是用户级记忆的典型数据结构。
json
{
  "user_id": "user_001",
  "memories": [
    {
      "id": "mem_20260801_001",
      "type": "preference",
      "content": "用户偏好简洁的回答风格,不喜欢冗长的解释",
      "embedding": [0.12, -0.34, 0.56, "..."],
      "metadata": {
        "source": "session_20260801",
        "confidence": 0.92,
        "category": "communication_style"
      },
      "created_at": "2026-08-01T10:30:00Z",
      "last_accessed": "2026-08-03T14:00:00Z",
      "access_count": 5,
      "importance": 0.85,
      "version": 1,
      "superseded_by": null
    },
    {
      "id": "mem_20260802_002",
      "type": "fact",
      "content": "用户是一名后端工程师,主要使用 Java 和 Go",
      "embedding": [0.23, -0.45, 0.67, "..."],
      "metadata": {
        "source": "session_20260802",
        "confidence": 0.95,
        "category": "user_profile"
      },
      "created_at": "2026-08-02T09:15:00Z",
      "last_accessed": "2026-08-03T15:30:00Z",
      "access_count": 8,
      "importance": 0.9,
      "version": 1,
      "superseded_by": null
    },
    {
      "id": "mem_20260803_003",
      "type": "event",
      "content": "用户提到正在重构一个支付系统,预计两周完成",
      "embedding": [0.34, -0.56, 0.78, "..."],
      "metadata": {
        "source": "session_20260803",
        "confidence": 0.88,
        "category": "work_project"
      },
      "created_at": "2026-08-03T16:00:00Z",
      "last_accessed": "2026-08-03T16:00:00Z",
      "access_count": 1,
      "importance": 0.7,
      "version": 1,
      "superseded_by": null
    }
  ],
  "memory_index": {
    "by_category": {
      "communication_style": ["mem_20260801_001"],
      "user_profile": ["mem_20260802_002"],
      "work_project": ["mem_20260803_003"]
    },
    "by_importance": {
      "high": ["mem_20260802_002", "mem_20260801_001"],
      "medium": ["mem_20260803_003"],
      "low": []
    }
  },
  "last_updated": "2026-08-03T16:00:00Z",
  "total_count": 3
}
记忆提取流程
从会话中提取值得跨会话保留的信息,通常在会话结束时自动执行,分三步:
原始信息筛选------通过规则或 LLM 评估每条消息是否包含值得长期记忆的信息,筛选标准包括用户偏好、事实性信息、决策计划、情感倾向等。
信息结构化------将筛选出的信息转为结构化记忆条目,提取关键实体、分类标签、重要度评分,通常由 LLM 通过精心设计的 prompt 完成。
记忆写入------将结构化记忆条目写入长期存储并更新索引,发现与已有记忆冲突时触发冲突处理流程。
python
class CrossSessionMemoryManager:
    """跨会话记忆管理器"""

    EXTRACTION_PROMPT = """分析以下对话,提取值得长期记忆的信息。
输出 JSON 数组,每个元素包含:
- type: preference/fact/event/skill/relationship
- content: 记忆内容(简洁描述)
- importance: 重要度 [0, 1]
- category: 分类标签

只提取确实值得长期保留的信息,忽略寒暄和临时性内容。

对话内容:
{conversation}
"""

    def extract_memories(self, session_messages: List[dict]) -> List[dict]:
        """从会话消息中提取值得持久化的记忆"""
        conv_text = "\n".join(
            f"{m['role']}: {m['content']}" for m in session_messages
        )

        prompt = self.EXTRACTION_PROMPT.format(conversation=conv_text)
        # 调用 LLM 提取记忆
        # extracted = llm.generate(prompt)
        extracted = [
            {
                "type": "preference",
                "content": "用户偏好用中文交流",
                "importance": 0.8,
                "category": "language"
            },
            {
                "type": "fact",
                "content": "用户在使用 PostgreSQL 数据库",
                "importance": 0.7,
                "category": "tech_stack"
            }
        ]
        return extracted

    def persist_user_memory(
        self, user_id: str, new_memories: List[dict]
    ):
        """将提取的记忆持久化到用户记忆空间"""
        for mem_data in new_memories:
            # 检查是否与已有记忆冲突
            existing = self._find_conflict(user_id, mem_data)
            if existing:
                # 更新已有记忆
                self._update_memory(existing, mem_data)
            else:
                # 写入新记忆
                self._write_memory(user_id, mem_data)

    def load_user_context(self, user_id: str, query: str = "") -> str:
        """在新会话开始时加载用户记忆上下文"""
        if query:
            # 有查询时,基于查询检索相关记忆
            memories = self._semantic_search(user_id, query, top_k=5)
        else:
            # 无查询时,加载高重要度记忆
            memories = self._get_top_memories(user_id, limit=10)

        if not memories:
            return ""

        lines = [f"[User Memory Context]"]
        for mem in memories:
            lines.append(f"- {mem['content']}")
        return "\n".join(lines)
隐私与安全考量
跨会话记忆涉及用户数据长期存储,隐私和安全必须考虑:记忆存储应加密(特别是个人身份信息),用户应拥有对自身记忆的完全控制权(查看、编辑、删除),记忆数据访问需严格权限控制。
可以引入记忆分级机制:公开级(如语言偏好)、个人级(如工作信息)、敏感级(如健康信息),不同等级采用不同存储和访问策略。敏感级记忆可采用本地存储而非云端。
8.6 记忆检索策略:效率与准确性的平衡
记忆检索是记忆系统中最高频的操作。Agent 每次回忆信息,都要从可能数以万计的记忆条目中找到最相关的那几条。检索策略直接决定响应速度和回答质量。
检索的核心挑战
检索面临两个矛盾目标:准确性和效率。准确性要求结果高度相关,不遗漏也不多返;效率要求速度快,不能让用户等数秒。深度语义匹配准确率最高,但记忆库到数万条时计算成本不可接受。分层检索策略是平衡两者的常用方案。
分层检索架构
分层检索将检索过程分多个阶段,逐步缩小候选集:
粗粒度过滤------通过元数据过滤(时间范围、类别标签)将记忆缩小到数百条,毫秒级完成。
向量检索------查询文本转为向量,在候选集中做相似度搜索取 Top-K,通常用 HNSW (Hierarchical Navigable Small World, 分层可导航小世界图) 等近似最近邻算法加速。
精细排序------对 Top-K 候选用多因子评分函数重排序,综合语义相似度、时间衰减、重要度、访问频率。
bash
记忆检索分层架构

用户查询
  |
  v
[第一层: 元数据过滤]  --> 时间/类别/标签过滤
  |                     候选集: ~500 条
  v
[第二层: 向量检索]    --> ANN 近似最近邻搜索
  |                     候选集: ~20 条
  v
[第三层: 精细排序]    --> 多因子重排序
  |                     最终结果: ~5 条
  v
返回给 Agent
python
from typing import List, Optional
import numpy as np

class RetrievalPipeline:
    """分层记忆检索管道"""

    def __init__(self, memory_store):
        self.store = memory_store

    def retrieve(
        self,
        query: str,
        query_vec: List[float],
        top_k: int = 5,
        filters: Optional[dict] = None
    ) -> List[dict]:
        """执行分层检索"""

        # 第一层: 元数据过滤
        candidates = self._metadata_filter(filters)

        # 第二层: 向量检索
        vector_candidates = self._vector_search(
            query_vec, candidates, top_k * 4
        )

        # 第三层: 精细排序
        ranked = self._rerank(
            query, query_vec, vector_candidates, top_k
        )

        return ranked

    def _metadata_filter(self, filters: Optional[dict]) -> List:
        """第一层: 基于元数据的粗过滤"""
        if not filters:
            return list(self.store.memories.values())

        candidates = []
        for mem in self.store.memories.values():
            match = True
            for key, value in filters.items():
                if mem.metadata.get(key) != value:
                    match = False
                    break
            if match:
                candidates.append(mem)
        return candidates

    def _vector_search(
        self, query_vec, candidates, k
    ) -> List:
        """第二层: 向量相似度检索"""
        scores = []
        for mem in candidates:
            sim = np.dot(query_vec, mem.embedding) / (
                np.linalg.norm(query_vec) * np.linalg.norm(mem.embedding) + 1e-8
            )
            scores.append((sim, mem))
        scores.sort(key=lambda x: -x[0])
        return [mem for _, mem in scores[:k]]

    def _rerank(self, query, query_vec, candidates, top_k) -> List[dict]:
        """第三层: 多因子精细排序"""
        import time as _time
        now = _time.time()

        results = []
        for mem in candidates:
            # 语义相似度 (40%)
            vec_sim = np.dot(query_vec, mem.embedding) / (
                np.linalg.norm(query_vec) * np.linalg.norm(mem.embedding) + 1e-8
            )

            # 时间衰减 (20%): 越新越好
            age_days = (now - mem.timestamp) / 86400
            recency = np.exp(-age_days / 30)  # 指数衰减, 半衰期约 20 天

            # 重要度 (25%)
            importance = mem.importance

            # 访问频率 (15%): 常被访问的记忆更可靠
            frequency = min(1.0, mem.access_count / 10)

            final_score = (
                vec_sim * 0.40 +
                recency * 0.20 +
                importance * 0.25 +
                frequency * 0.15
            )

            results.append({
                "memory": mem,
                "score": final_score,
                "components": {
                    "semantic": round(vec_sim, 3),
                    "recency": round(recency, 3),
                    "importance": round(importance, 3),
                    "frequency": round(frequency, 3)
                }
            })

        results.sort(key=lambda x: -x["score"])
        return results[:top_k]
检索质量优化
分层架构之外,还有几个实用技巧:
查询扩展------检索前用 LLM 将原始查询扩展为多个相关查询,分别检索后合并去重,提升召回率,减少查询表述不当导致的遗漏。
记忆去重------同一条信息可能在多次会话中被重复记忆,不做去重会浪费上下文空间。通过计算记忆间向量相似度自动去重。
上下文窗口适配------检索到的记忆不一定全部放入上下文,按相关度从高到低排列,填满 token 预算为止。
8.7 冲突信息处理:新旧记忆的取舍
用户的信息不是静态的------换工作、改偏好、修正之前说过的话。新记忆与旧记忆矛盾时,Agent 需要一套机制检测冲突、评估可信度、做出取舍。
冲突的类型
记忆冲突分几种类型:
事实性冲突最常见。用户之前说"住上海",后来又说"搬到北京了"。处理相对直接:新信息覆盖旧信息,旧信息标记为过期但保留作历史。
偏好性冲突涉及偏好变化。用户之前说"喜欢简洁回答",后来又说"最近学新东西,回答可以详细些"。需要判断是永久变化还是临时调整------如果多个会话持续表达新偏好,可认定为永久变化。
时间性冲突是时间推移导致的信息矛盾。用户上周说"项目下周交付",到这周还没完成。不是信息错误,而是信息有时效性,需在记忆中标注有效期。
来源性冲突出现在多渠道获取信息时。用户在对话中说自己是工程师,但简历记忆中记录的是设计师,需通过信息来源可信度来判断。
冲突检测机制
冲突检测必须自动化。常用方法:基于向量相似度的预筛选、基于实体匹配的规则检测、基于 LLM 的语义判断。
python
class ConflictDetector:
    """记忆冲突检测器"""

    CONFLICT_PROMPT = """判断以下两条记忆是否存在冲突。

记忆 A: {mem_a}
记忆 B: {mem_b}

判断标准:
- 如果两条记忆描述同一实体的不同状态/属性,且无法同时为真,则为冲突
- 如果是不同维度的信息(如偏好 vs 事实),则不冲突
- 如果 B 是 A 的更精确版本,则为更新而非冲突

输出 JSON: {{"conflict": true/false, "type": "fact/preference/time/source", "resolution": "keep_new/keep_old/merge/both"}}
"""

    def detect_conflict(self, new_mem: dict, existing_mem: dict) -> dict:
        """检测两条记忆是否冲突"""
        # 快速预筛选: 向量相似度
        sim = self._cosine_sim(
            new_mem.get("embedding", []),
            existing_mem.get("embedding", [])
        )

        if sim < 0.5:
            # 语义差距大,不太可能冲突
            return {"conflict": False}

        if sim > 0.95:
            # 高度相似,可能是重复
            return {"conflict": False, "duplicate": True}

        # 中等相似度,需要 LLM 判断
        prompt = self.CONFLICT_PROMPT.format(
            mem_a=existing_mem["content"],
            mem_b=new_mem["content"]
        )
        # result = llm.generate(prompt)
        result = {
            "conflict": True,
            "type": "fact",
            "resolution": "keep_new"
        }
        return result

    def _cosine_sim(self, a, b):
        if not a or not b:
            return 0
        import numpy as np
        return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b) + 1e-8)


class ConflictResolver:
    """冲突解决器"""

    def __init__(self):
        self.detector = ConflictDetector()

    def resolve(self, new_mem: dict, existing_mems: List[dict]) -> dict:
        """处理新记忆与已有记忆的冲突"""
        for existing in existing_mems:
            result = self.detector.detect_conflict(new_mem, existing)

            if not result.get("conflict"):
                if result.get("duplicate"):
                    # 重复记忆,跳过或合并
                    return {"action": "skip", "reason": "duplicate"}
                continue

            # 存在冲突,根据解决方案处理
            resolution = result["resolution"]

            if resolution == "keep_new":
                # 新信息覆盖旧信息
                existing["superseded_by"] = new_mem["id"]
                existing["status"] = "outdated"
                new_mem["version"] = existing.get("version", 1) + 1
                return {"action": "add", "reason": "new_overrides_old"}

            elif resolution == "keep_old":
                # 旧信息更可信,忽略新信息
                return {"action": "skip", "reason": "old_more_reliable"}

            elif resolution == "merge":
                # 合并两条记忆
                merged_content = self._merge_contents(
                    existing["content"], new_mem["content"]
                )
                existing["content"] = merged_content
                existing["version"] = existing.get("version", 1) + 1
                return {"action": "update", "reason": "merged"}

            elif resolution == "both":
                # 两者都保留,但标注关系
                new_mem["related_to"] = existing["id"]
                return {"action": "add", "reason": "both_kept"}

        return {"action": "add", "reason": "no_conflict"}

    def _merge_contents(self, old: str, new: str) -> str:
        """合并两条记忆的内容"""
        # 实际应用中可以用 LLM 来智能合并
        return f"{old} [updated: {new}]"
冲突解决的决策框架
冲突解决不是简单的"新的总是对的",需要综合考量:
信息置信度取决于来源------用户直接陈述 > Agent 推断,正式语境(设置页面)> 闲聊。
时间因素也重要。新信息更可能反映当前状态,但用户可能口误后纠正。冲突时不应立即覆盖,可将两条记忆都保留,标注冲突状态,等后续信息确认。
无法自动解决时,Agent 可以主动询问用户确认:"我之前记得您住上海,但您刚提到搬到北京,需要更新吗?"多一次交互,但保证准确性。
8.8 完整记忆架构设计:从理论到实践
前面几节分别讨论了记忆类型、存储方案、压缩策略、遗忘机制、跨会话持久化、检索策略和冲突处理。这些组件如何组合成完整可运行的系统?本节给出端到端架构设计。
架构总览
完整的 Agent 记忆系统由以下层次组成:记忆接入层、记忆管理层、记忆存储层和记忆检索层。每一层承担明确的职责,层与层之间通过清晰的接口交互。
bash
Agent 记忆系统总体架构

+------------------------------------------------------------------+
|                        Agent 核心逻辑                             |
+------------------------------------------------------------------+
         |                                          |
         v                                          v
+------------------+                     +-------------------+
|   记忆接入层      |                     |    记忆检索层      |
|  (Memory Gate)   |                     | (Retrieval Pipe)  |
|                  |                     |                   |
| - 信息提取       |                     | - 元数据过滤      |
| - 重要度评估     |                     | - 向量检索        |
| - 冲突检测       |                     | - 精细排序        |
| - 记忆写入       |                     | - 上下文适配      |
+--------+---------+                     +--------+----------+
         |                                        |
         v                                        v
+------------------------------------------------------------------+
|                         记忆管理层                                |
|                     (Memory Manager)                             |
|                                                                  |
|  +------------+  +-------------+  +--------------+              |
|  | 压缩引擎    |  | 遗忘引擎     |  | 冲突处理器    |              |
|  |(Compressor)|  |(Forgetting) |  |(ConflictRes) |              |
|  +------------+  +-------------+  +--------------+              |
|                                                                  |
|  +---------------------+  +------------------------+            |
|  | 索引管理器           |  | 生命周期管理器          |            |
|  |(Index Manager)      |  |(Lifecycle Manager)    |            |
|  +---------------------+  +------------------------+            |
+------------------------------------------------------------------+
         |
         v
+------------------------------------------------------------------+
|                         记忆存储层                                |
|                    (Storage Layer)                               |
|                                                                  |
|  +----------+  +----------+  +----------+  +----------+         |
|  |向量数据库 |  |KV 存储   |  |图数据库   |  |文件系统   |         |
|  |(Vector)  |  |(KVStore) |  |(Graph)   |  |(Files)   |         |
|  +----------+  +----------+  +----------+  +----------+         |
+------------------------------------------------------------------+
各层职责详解
记忆接入层是入口。Agent 产生新对话或交互时,接入层负责提取值得记忆的信息,执行信息提取、重要度评估、冲突检测和写入,目标是"不遗漏重要信息,也不存储无用噪音"。
记忆管理层是核心调度中枢,管理记忆全生命周期:压缩、遗忘、冲突处理、索引更新、状态维护。通过后台任务定期执行压缩和遗忘,保证记忆库体积可控、内容新鲜。
记忆存储层提供底层持久化能力,封装多种存储引擎,向上层提供统一读写接口。不同类型记忆自动路由:语义记忆→向量数据库,结构化记忆→KV 存储,关系记忆→图数据库。
记忆检索层是出口。Agent 需要回忆信息时,检索层从海量记忆中找最相关内容,执行分层检索流程,平衡效率和准确性。
端到端记忆管理器实现
下面是一个整合了前面各组件的完整记忆管理器示例。
python
import time
import json
from typing import List, Dict, Optional
from dataclasses import dataclass, field

@dataclass
class MemoryRecord:
    """统一记忆记录格式"""
    id: str
    content: str
    type: str                     # preference/fact/event/skill
    embedding: List[float] = field(default_factory=list)
    metadata: Dict = field(default_factory=dict)
    timestamp: float = field(default_factory=time.time)
    last_accessed: float = field(default_factory=time.time)
    access_count: int = 0
    importance: float = 0.5
    status: str = "active"        # active/outdated/archived/deleted
    version: int = 1
    superseded_by: Optional[str] = None
    source_session: Optional[str] = None


class AgentMemorySystem:
    """Agent 完整记忆系统"""

    def __init__(self, user_id: str):
        self.user_id = user_id
        self.short_term: List[dict] = []      # 短期记忆(对话历史)
        self.long_term: Dict[str, MemoryRecord] = {}  # 长期记忆
        self.working: Dict = {}                # 工作记忆
        self.compressor = MemoryCompressor()
        self.forgetting = ForgettingManager()
        self.conflict_resolver = ConflictResolver()
        self.retrieval = RetrievalPipeline(self)

    # ========== 记忆写入 ==========

    def on_message(self, role: str, content: str):
        """消息到达时更新短期记忆"""
        self.short_term.append({
            "role": role,
            "content": content,
            "timestamp": time.time()
        })
        # 短期记忆溢出处理
        if len(self.short_term) > 50:
            self._compact_short_term()

    def on_session_end(self):
        """会话结束时,提取并持久化长期记忆"""
        # 1. 压缩会话记忆
        compressed = self.compressor.compress_conversation(self.short_term)

        # 2. 提取值得长期记忆的信息
        extracted = self._extract_memories()

        # 3. 持久化,处理冲突
        for mem_data in extracted:
            self._persist_with_conflict_resolution(mem_data)

        # 4. 运行遗忘周期
        self.forgetting.run_forgetting_cycle()

        # 5. 清空短期记忆
        self.short_term.clear()

    def _extract_memories(self) -> List[dict]:
        """从短期记忆中提取值得长期保存的信息"""
        # 使用 LLM 提取关键信息
        return [
            {
                "type": "preference",
                "content": "用户偏好简洁回答",
                "importance": 0.8
            }
        ]

    def _persist_with_conflict_resolution(self, mem_data: dict):
        """持久化记忆,自动处理冲突"""
        # 查找可能冲突的已有记忆
        candidates = self._find_potential_conflicts(mem_data)

        result = self.conflict_resolver.resolve(mem_data, candidates)

        if result["action"] == "add":
            record = MemoryRecord(
                id=f"mem_{int(time.time()*1000)}",
                content=mem_data["content"],
                type=mem_data["type"],
                importance=mem_data.get("importance", 0.5),
                source_session=f"session_{int(time.time())}"
            )
            self.long_term[record.id] = record

    def _find_potential_conflicts(self, mem_data: dict) -> List[MemoryRecord]:
        """查找可能与新记忆冲突的已有记忆"""
        candidates = []
        for record in self.long_term.values():
            if record.type == mem_data["type"] and record.status == "active":
                # 同类型的活跃记忆可能是冲突候选
                candidates.append(record)
        return candidates

    # ========== 记忆检索 ==========

    def recall(self, query: str, query_vec: List[float] = None,
               top_k: int = 5) -> List[MemoryRecord]:
        """检索相关长期记忆"""
        results = []
        for record in self.long_term.values():
            if record.status != "active":
                continue
            # 更新访问记录
            record.last_accessed = time.time()
            record.access_count += 1
            results.append(record)

        # 按重要度和时间排序 (简化版)
        results.sort(
            key=lambda r: (r.importance, r.timestamp),
            reverse=True
        )
        return results[:top_k]

    # ========== 上下文构建 ==========

    def build_context(self, query: str = "") -> str:
        """构建当前会话的完整上下文"""
        parts = []

        # 1. 长期记忆上下文
        if query:
            memories = self.recall(query, top_k=5)
            if memories:
                parts.append("[Long-term Memory]")
                for mem in memories:
                    parts.append(f"- {mem.content}")

        # 2. 工作记忆上下文
        if self.working:
            parts.append("[Working Memory]")
            for key, value in self.working.items():
                parts.append(f"- {key}: {value}")

        # 3. 短期记忆上下文 (最近的消息)
        recent = self.short_term[-20:]  # 最近 20 条
        if recent:
            parts.append("[Recent Conversation]")
            for msg in recent:
                parts.append(f"{msg['role']}: {msg['content']}")

        return "\n\n".join(parts)

    # ========== 内部维护 ==========

    def _compact_short_term(self):
        """压缩短期记忆"""
        old_msgs = self.short_term[:30]
        summary = self.compressor.compress_conversation(old_msgs)
        self.short_term = [{"role": "system", "content": f"[Summary] {summary.summary}"}] + self.short_term[30:]

    def get_stats(self) -> dict:
        """获取记忆系统统计信息"""
        active = sum(1 for r in self.long_term.values() if r.status == "active")
        outdated = sum(1 for r in self.long_term.values() if r.status == "outdated")
        return {
            "short_term_count": len(self.short_term),
            "long_term_active": active,
            "long_term_outdated": outdated,
            "working_memory_keys": list(self.working.keys()),
            "total_storage": sum(len(r.content) for r in self.long_term.values())
        }
记忆系统的运行时序
记忆系统各组件在时间维度上的协作关系,典型一次会话的操作时序如下:
会话开始时,Agent 通过 build_context 构建初始上下文:从长期记忆检索与查询相关的记忆,加载到工作记忆,连同最近会话历史组成完整上下文。
会话进行中,用户消息和 Agent 回复写入短期记忆。短期记忆接近溢出阈值时触发压缩,将早期消息压缩为摘要。工作记忆随任务进展更新,记录中间状态和待办事项。
会话结束时执行收尾:从短期记忆提取值得长期保存的信息,检测处理冲突,写入长期存储,执行遗忘周期清理过期记忆,清空短期记忆。
性能优化方向
实际部署中性能瓶颈通常在两处:向量检索和 LLM 调用。向量检索用高效 ANN (Approximate Nearest Neighbor, 近似最近邻) 算法优化,如 HNSW 或 IVF (Inverted File Index, 倒排文件索引)。LLM 调用通过缓存优化------相似的压缩和提取请求直接用缓存结果。
另一个方向是异步化。压缩、遗忘和索引更新不需要在用户等待时同步完成,放到后台执行。只有写入和检索需同步处理,其他操作都可延迟。
本章知识点总结
| 知识点 | 核心内容 | 关键要点 |
|---|---|---|
| 记忆类型 | 短期、长期、工作记忆 | 短期受 token 限制,长期跨会话持久,工作记忆服务当前任务 |
| 存储方案 | 向量数据库、KV 存储、图数据库 | 向量适合语义检索,KV 适合精确匹配,图适合关系推理 |
| 记忆压缩 | 消息级、会话级、跨会话压缩 | 目标是信息保留率和压缩比的平衡,常用 LLM 生成摘要 |
| 遗忘机制 | 时间/频率/重要度/冲突/容量驱动 | 渐进式遗忘优于硬遗忘,高重要度记忆可豁免 |
| 跨会话记忆 | 用户级持久化存储 | 需要信息提取、冲突检测、隐私保护机制 |
| 检索策略 | 分层检索:过滤-向量-精排 | 平衡准确性与效率,支持查询扩展和去重 |
| 冲突处理 | 检测-评估-解决三步走 | 新旧信息不是简单覆盖,需综合考虑置信度和时间 |
| 架构设计 | 接入层-管理层-存储层-检索层 | 四层架构各司其职,支持异步处理和性能优化 |
记忆系统是需要持续迭代的工程。初始版本可以从最简单方案起步------短期记忆用消息列表,长期记忆用向量数据库加 KV 存储,暂不实现图数据库和复杂冲突处理。随场景复杂化逐步引入高级功能,关键是建立可扩展的架构基础,让后续迭代不需要推翻重来。