从 C# WinForms 到 Flask + SQLite:期刊出版 XML 生成器(JATS)重构实践
一个把 Word 稿件一键转成 JATS XML 的小工具,以及把它从桌面端重构成 Web 端的完整过程。
一、背景:编辑部为什么需要它
JATS(Journal Article Tag Suite)是 NISO 制定的期刊文章标记标准,PubMed Central、SciELO、Crossref 这些收录平台都要求以 JATS XML 作为提交格式。
但国内不少期刊编辑部的实际工作流是这样的:
- 作者交来 Word 稿件;
- 编辑按内部约定排好格式;
- 需要向收录库提交时,再由人手工把期刊名、ISSN、DOI、卷期页、作者单位、参考文献等一项项敲进 XML 模板。
问题很直观------同一份信息被录入两遍甚至三遍,重复劳动,且极易出错(参考文献格式尤其容易写歪)。
需求最终收敛成一句话:
给编辑部一个工具,丢进一份「按约定格式写的 Word 稿件」,直接吐出一份合规的 JATS XML。
最初的实现是一套 C# WinForms 桌面程序(src/XmlGenerator),功能是完整的,但落地时有几个现实障碍:
- 只能在 Windows 上装 。程序依赖 .NET Framework 和
DocumentFormat.OpenXml等一堆组件,还要处理 Office 互操作 DLL; - 数据存在 SQL Server 里。为了一个小工具去装数据库,运维成本不成比例;
- 界面难改 。WinForms 是拖拽设计器,改一处布局要动
FrmMain.Designer.cs------光是这个文件就有 68 KB; - 每位编辑都得装一遍。升级一次就要全办公室重装。
于是决定重构成 Flask + SQLite 的 Web 版 :浏览器打开就用,数据落在本地一个 .db 文件里,客户端零安装。
二、它长什么样
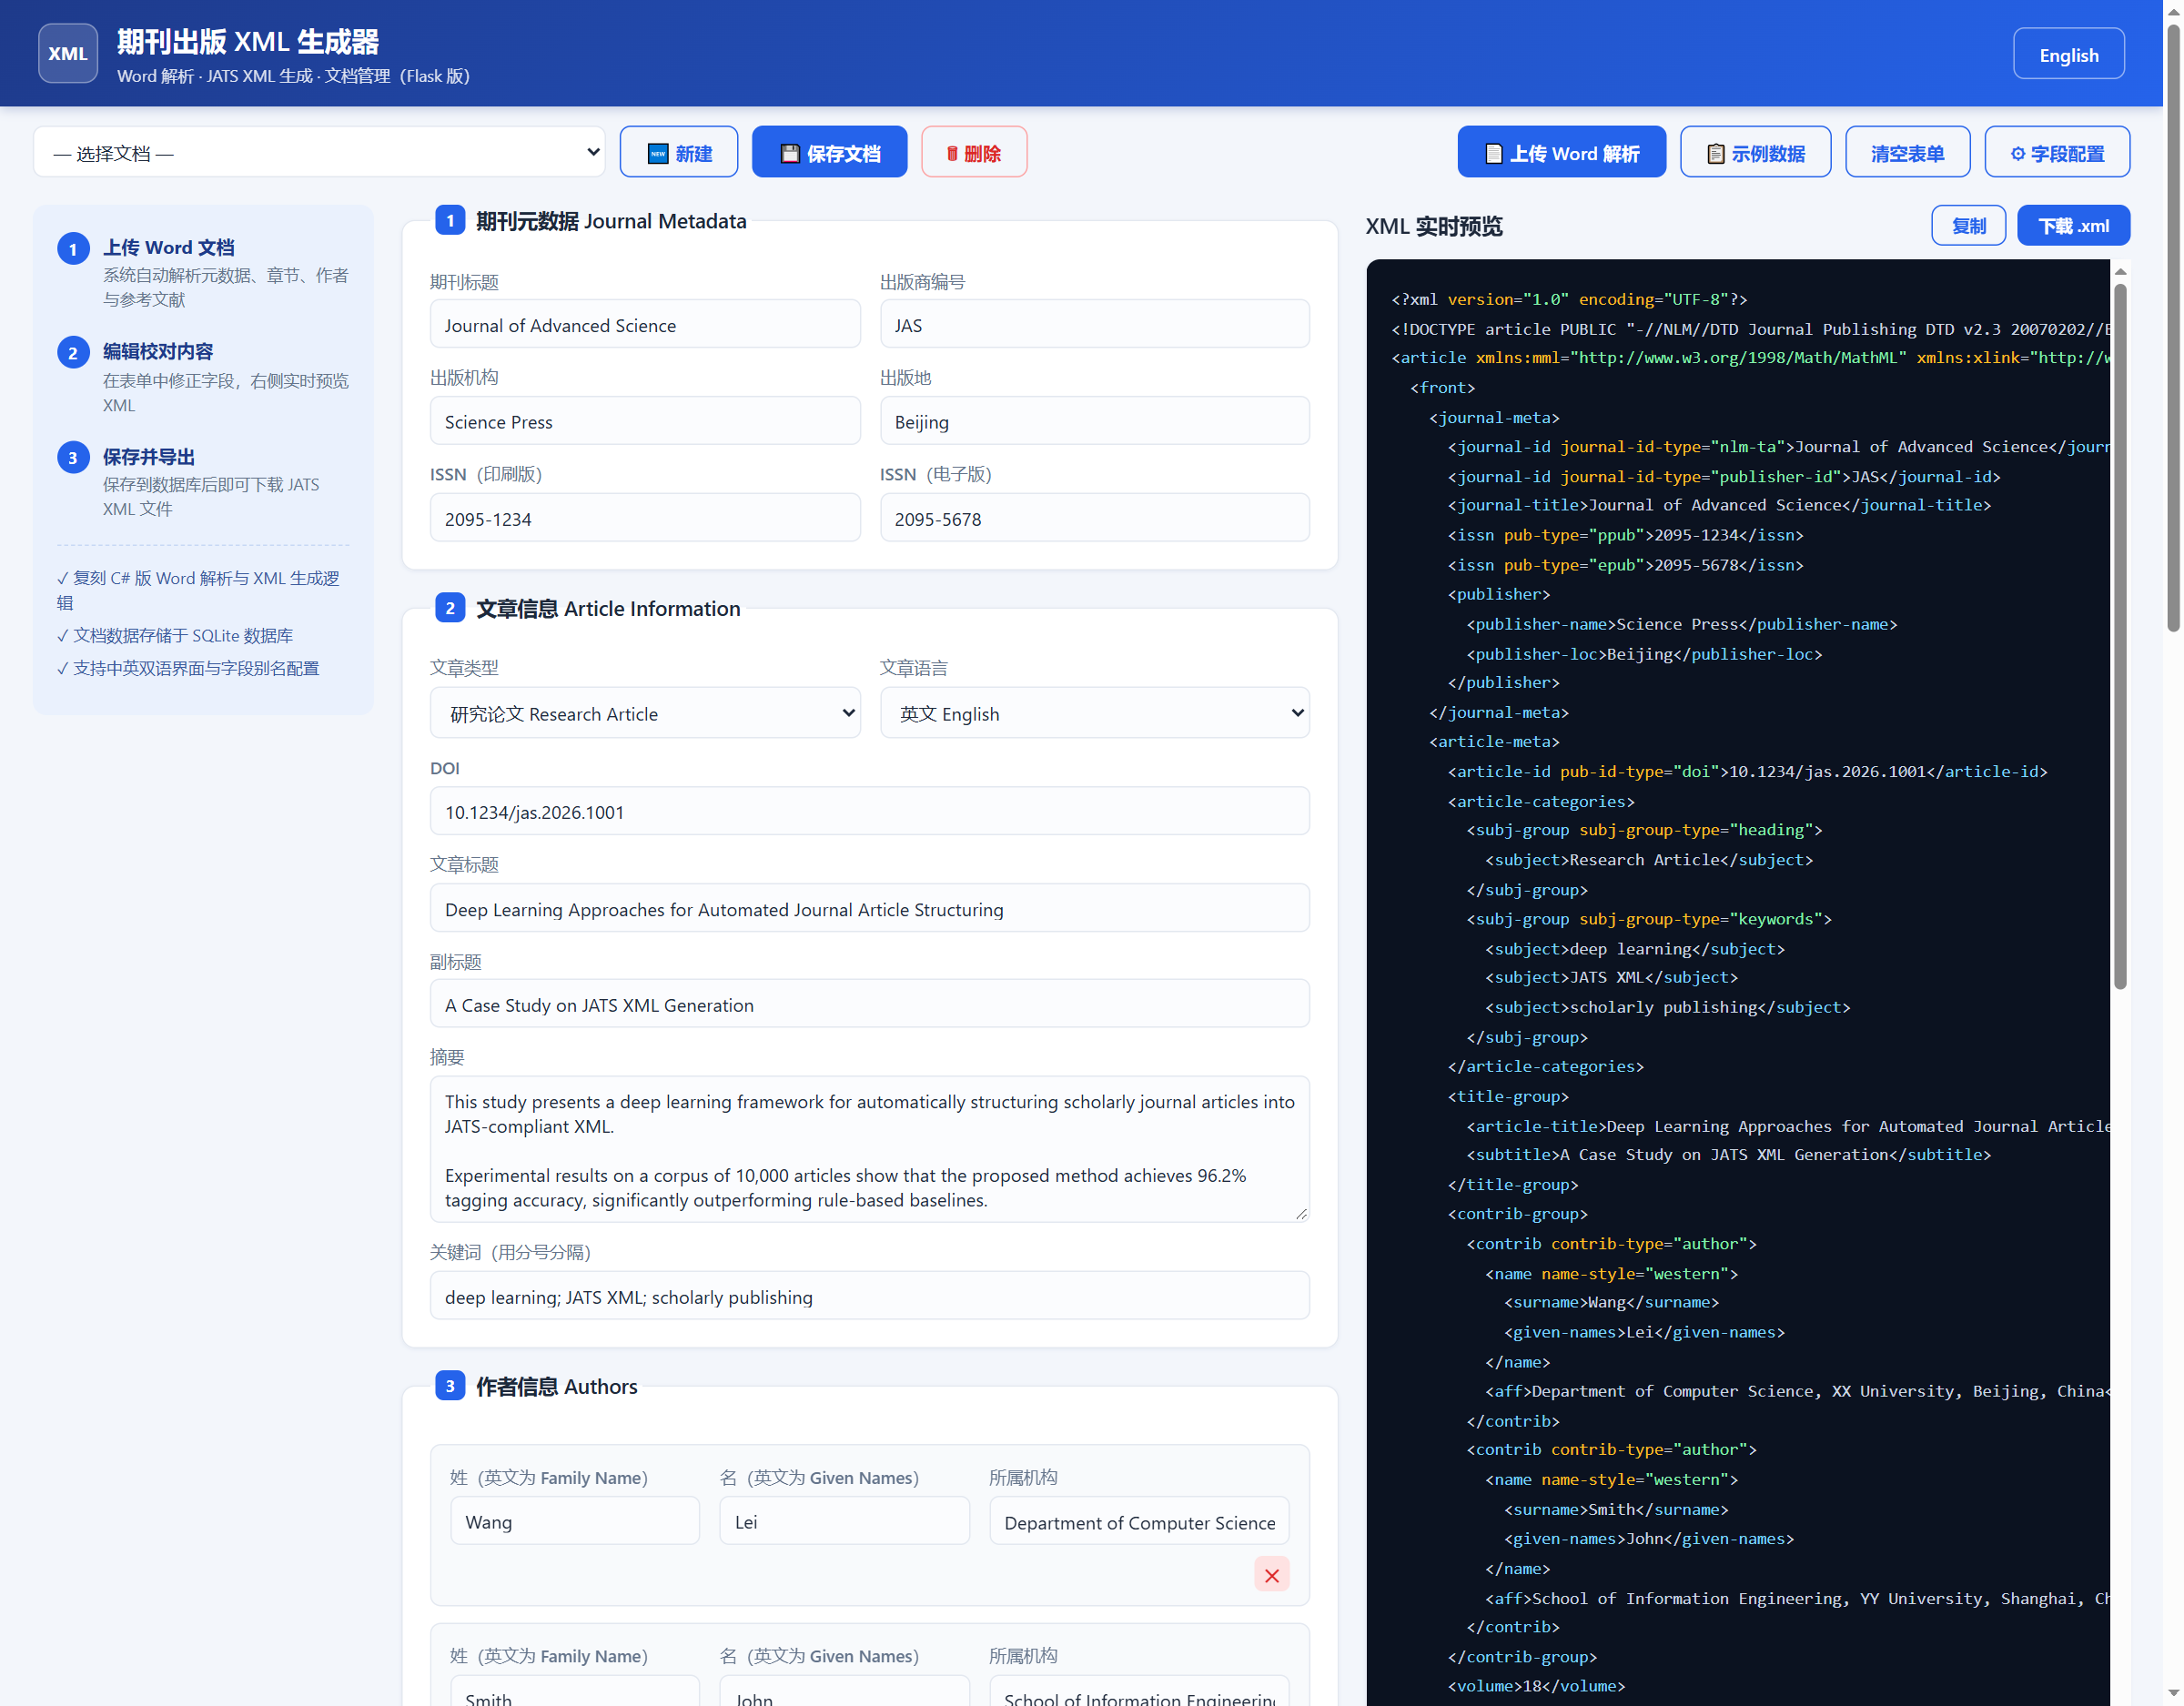
界面是「左中右」三栏:左侧是操作步骤提示,中间是分 8 组的结构化表单,右侧是实时刷新 的 XML 预览。
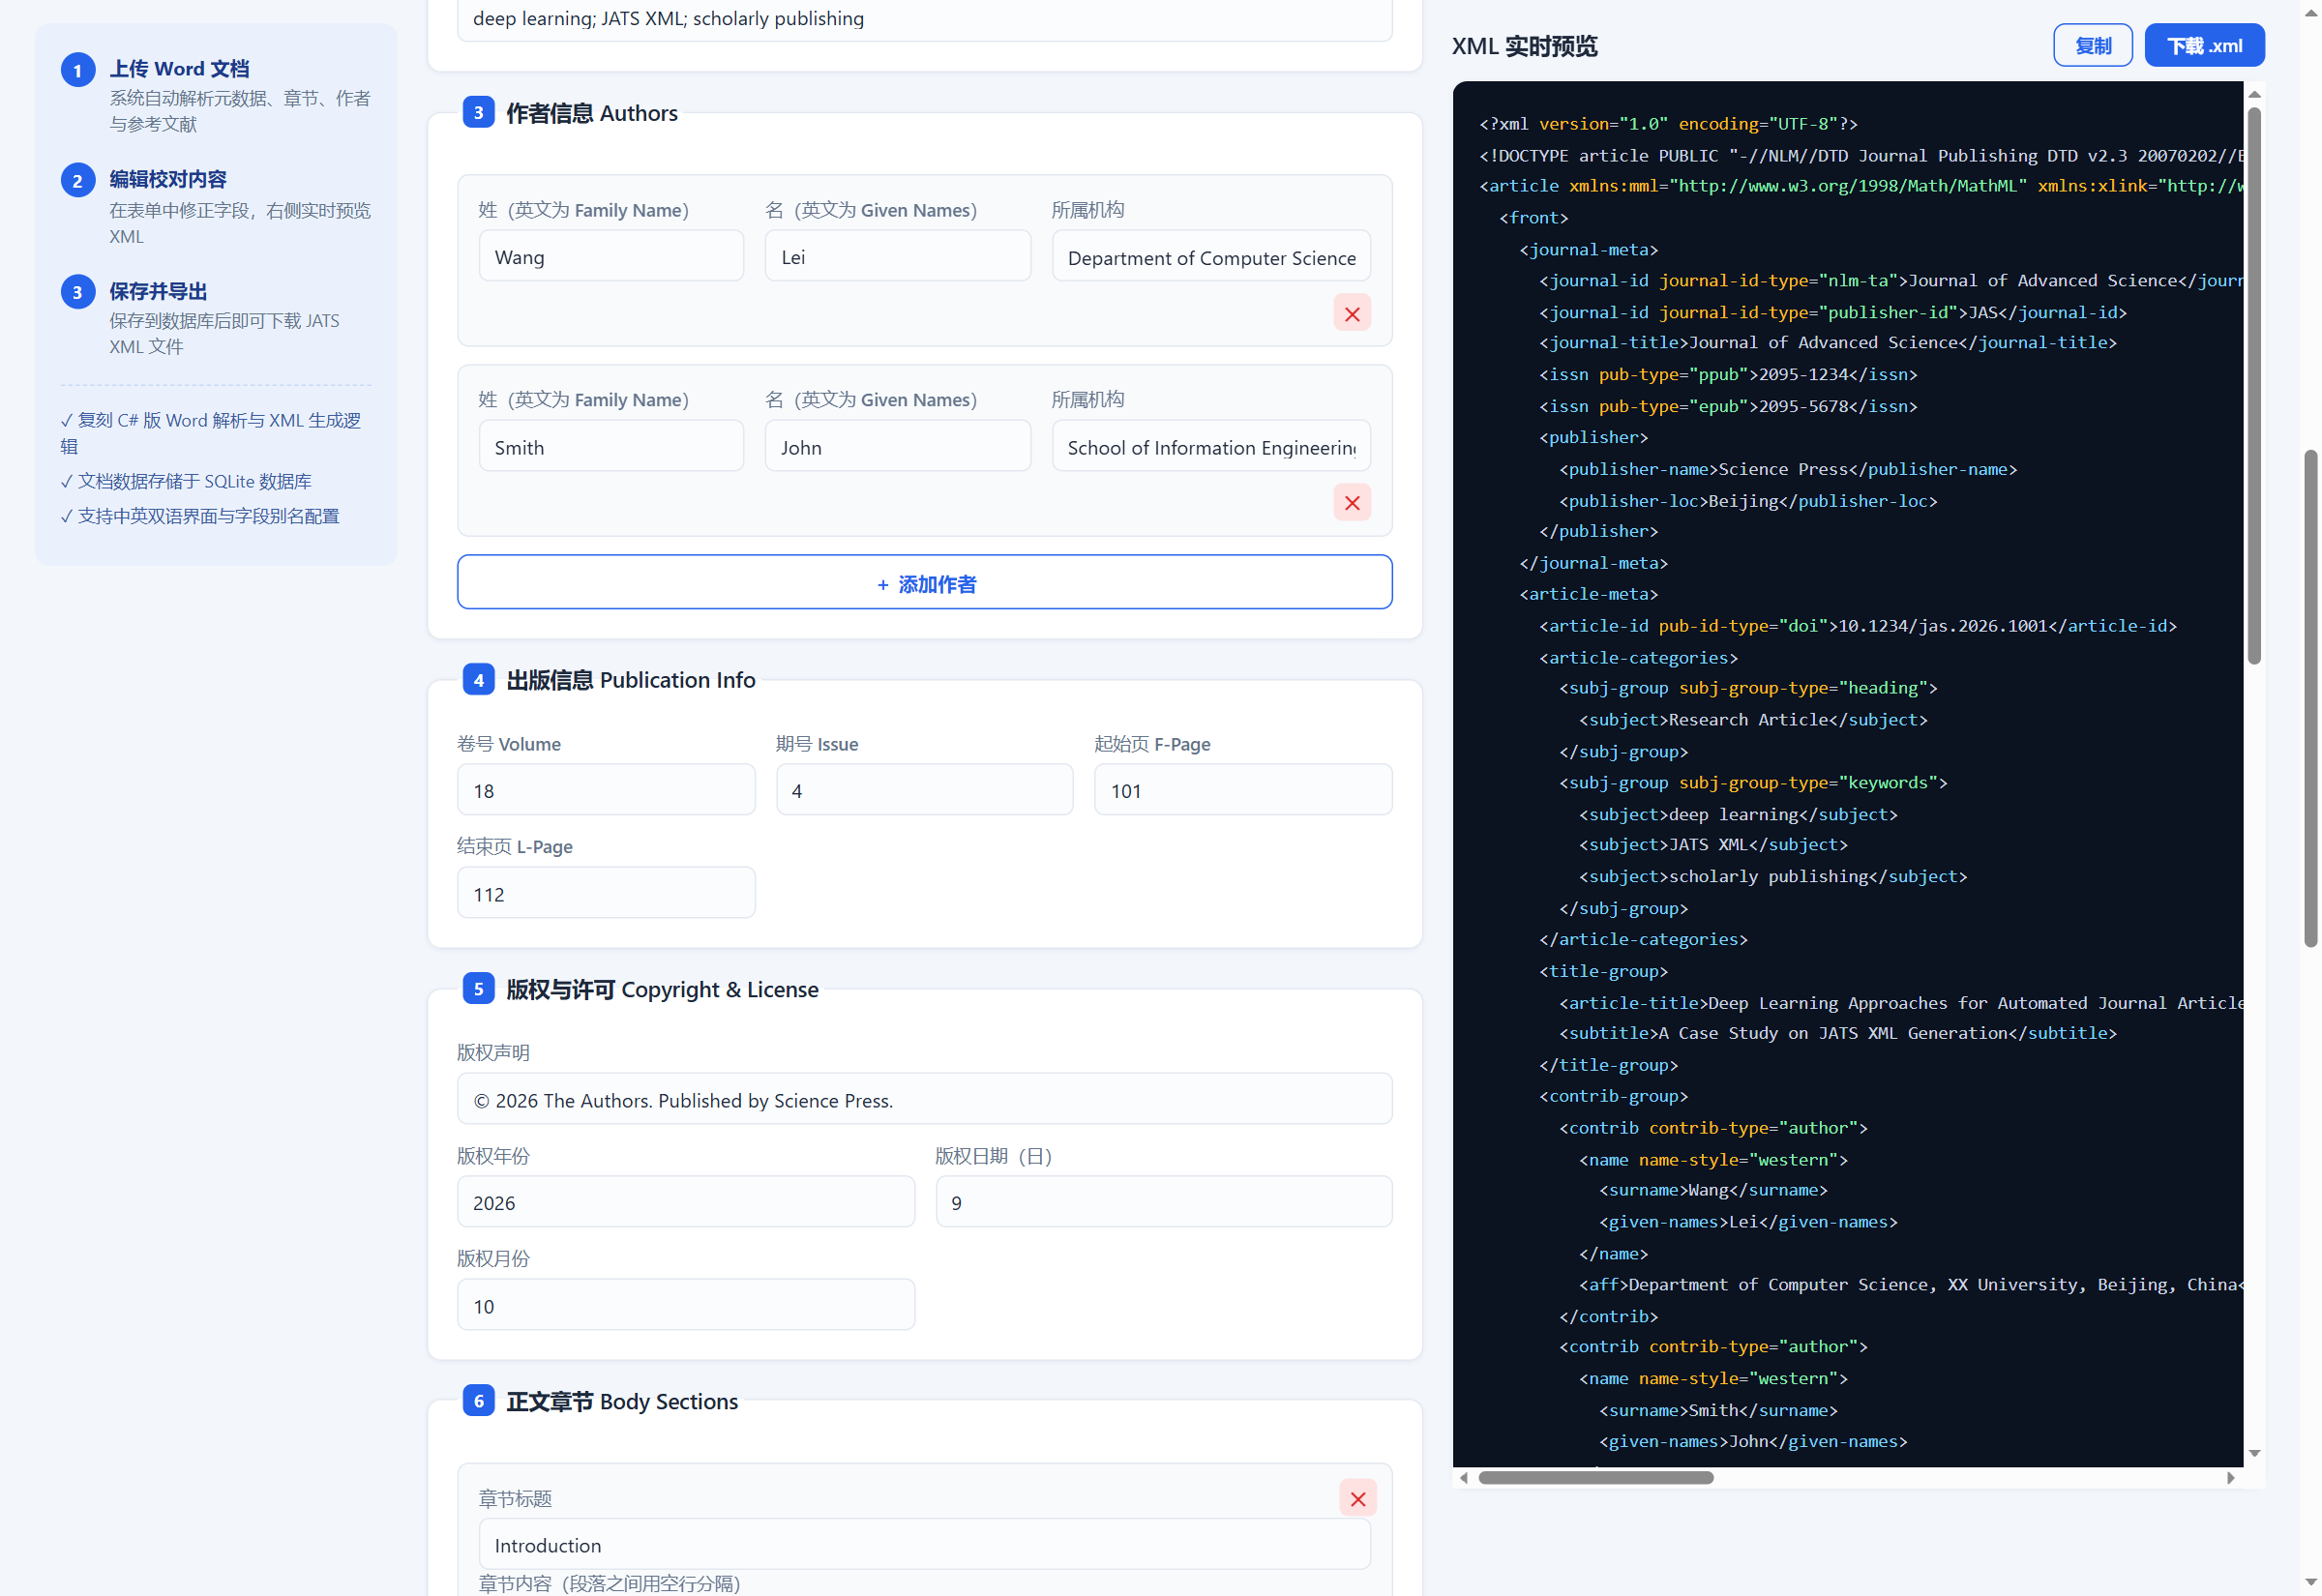
往下滚动是作者、出版信息、版权与许可、正文章节几组表单:
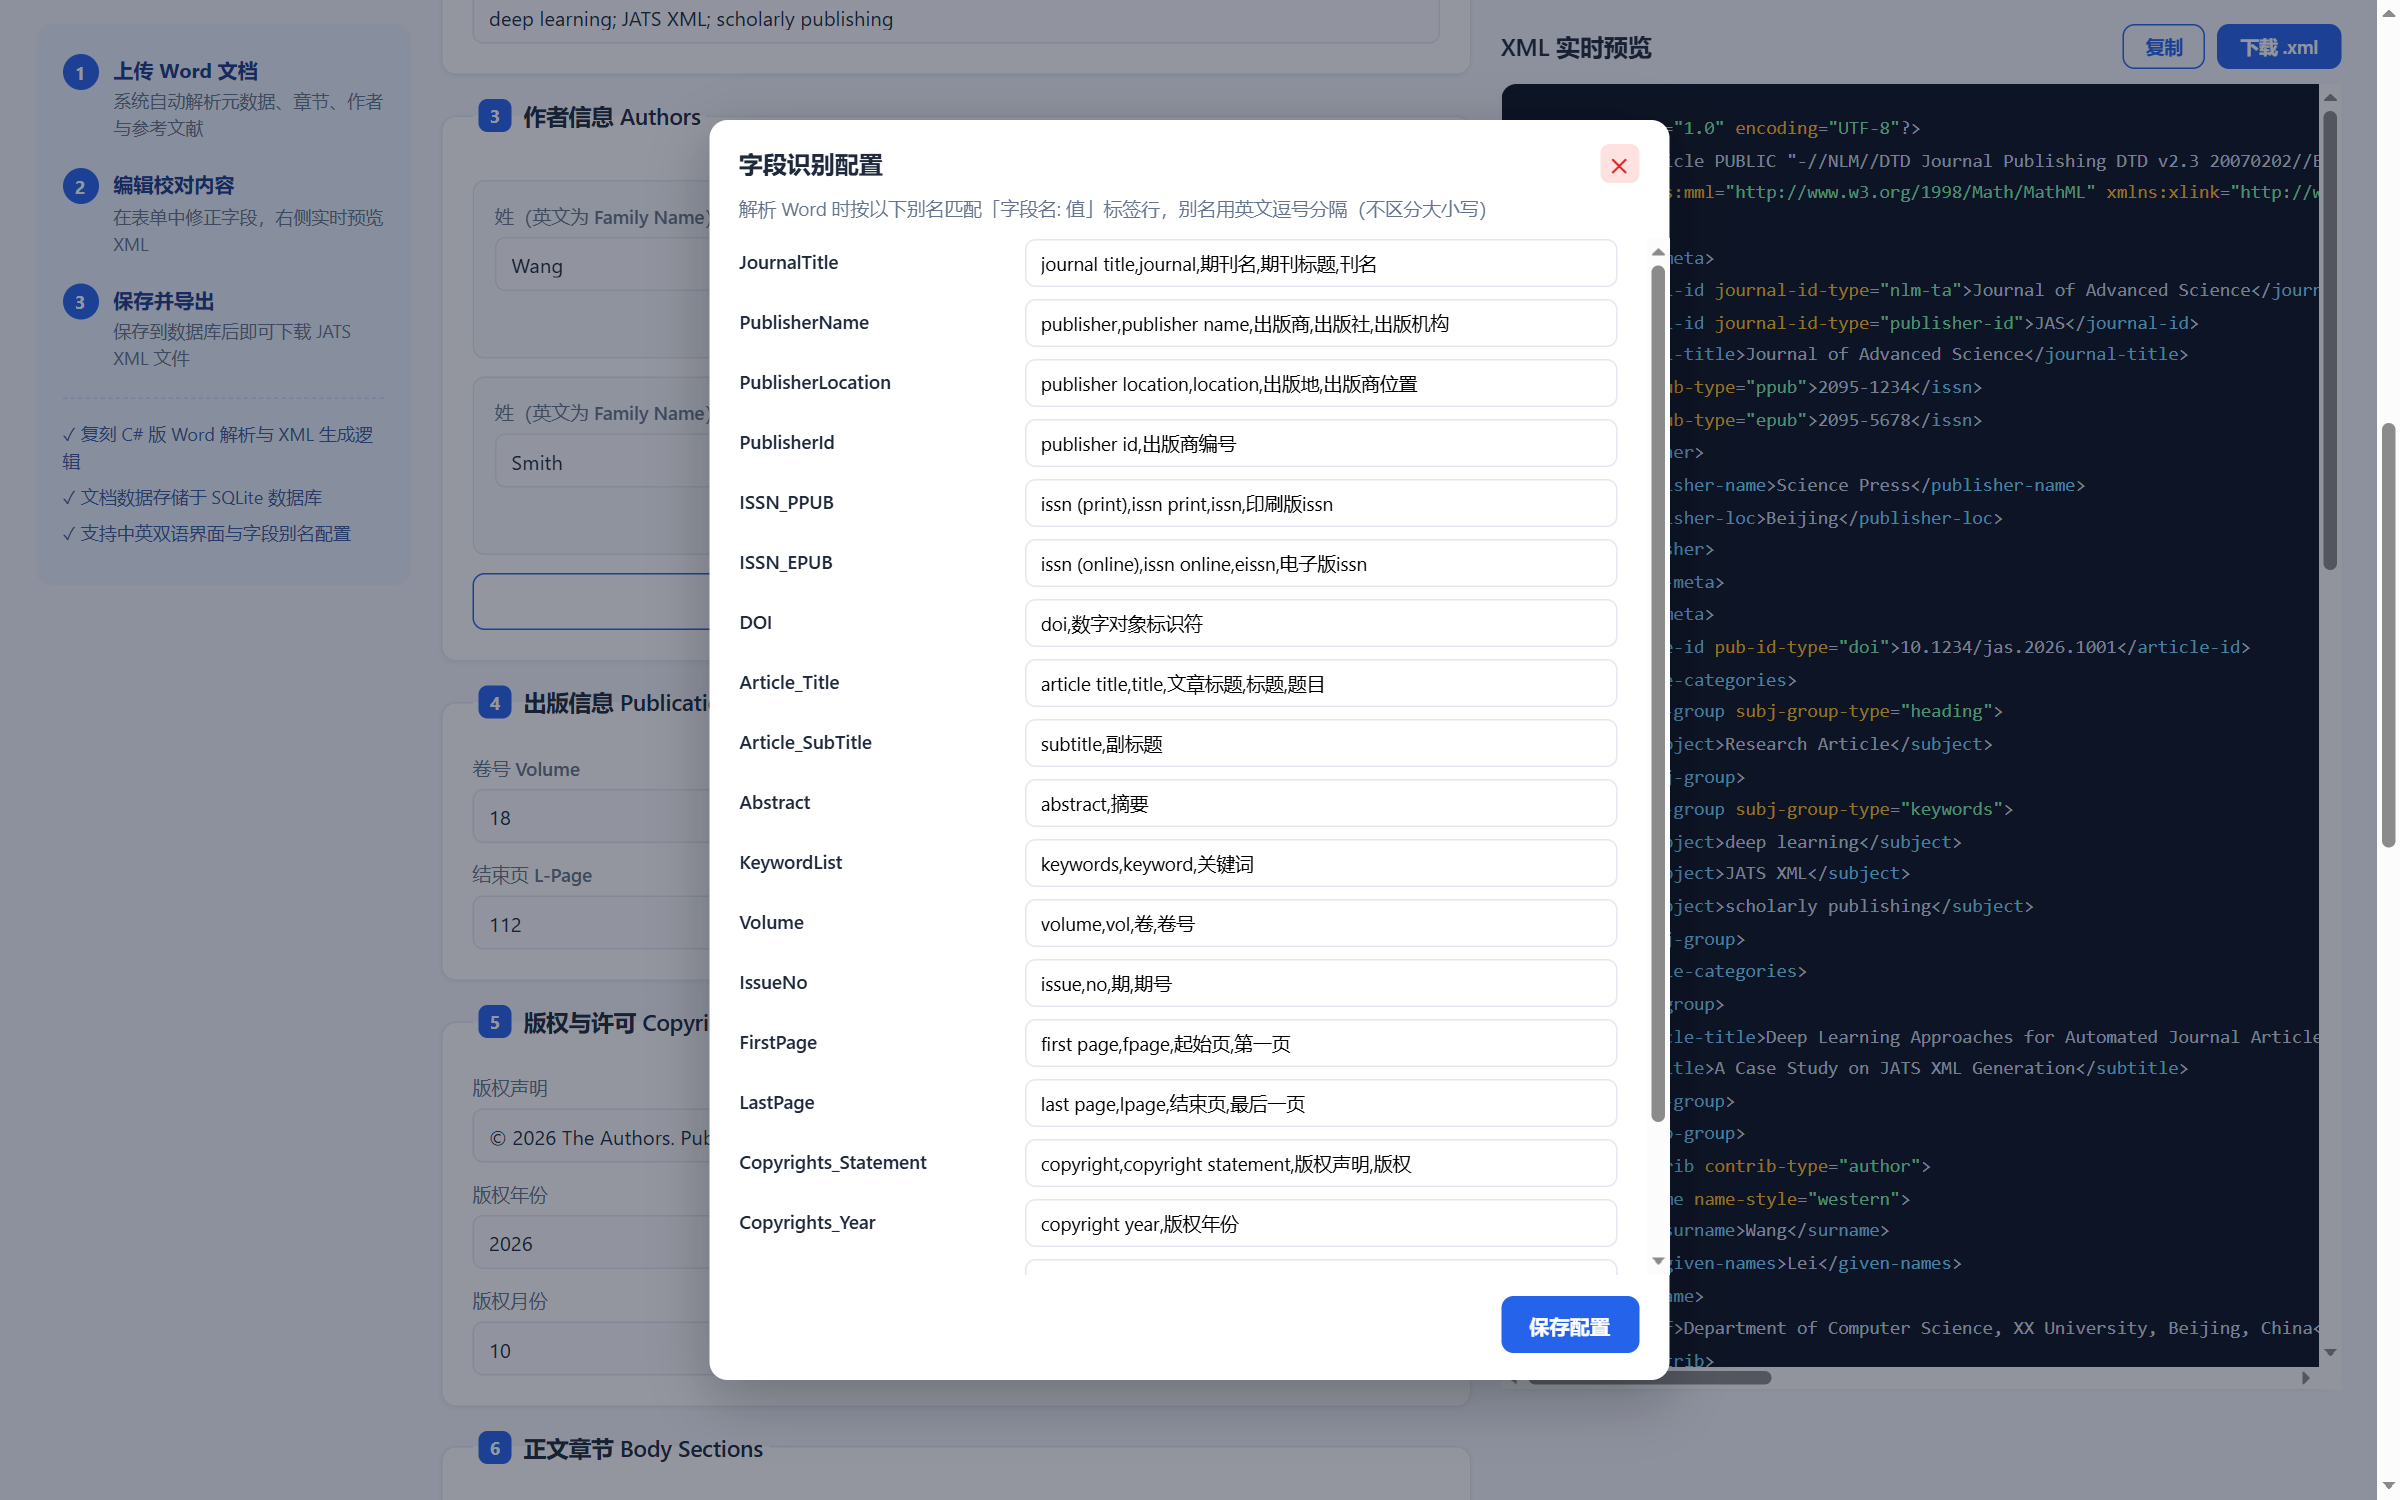
参考文献这一组值得一提------引文不是一坨纯文本,而是被拆成了作者、标题、期刊、年、卷、期、起始页、结束页 8 个结构化字段,这样生成 XML 时才能按 JATS 的要求重新拼装:
三、技术选型:为什么是 Flask + SQLite + 原生 JS
这个工具的核心资产是解析规则和 XML 结构 ,不是并发能力、不是高可用。所以选型标准只有三条:部署简单、逻辑好移植、界面好改。
| 层面 | 选型 | 备选 | 取舍理由 |
|---|---|---|---|
| Web 框架 | Flask | Django / FastAPI | 总共 11 个接口,Flask 够用且代码最少;Django 的 ORM/Admin 属于杀鸡用牛刀 |
| 数据库 | SQLite | SQL Server / MySQL | 单机单用户,一个文件即数据库,拷走就能搬;表结构仍对齐原 C# 版 |
| ORM | Flask-SQLAlchemy | 裸 sqlite3 | 5 张表有级联删除和排序需求,ORM 描述关系更清晰 |
| Word 解析 | python-docx | 调 Word COM / OpenXml SDK | 纯 Python、跨平台、无需装 Office,只读段落文本完全够用 |
| XML 生成 | 手写轻量生成器 | lxml / ElementTree | 见第六节,手写反而更可控 |
| 前端 | 原生 JS | Vue / React | 无构建、无依赖,单页三个文件,双击 index.html 就能改 |
一句话总结:把「重」的部分全部留在服务端的 40 KB Python 里,前端保持零依赖。
四、代码结构
xmlgenerator/
├── app.py              # Flask 路由层:文档 CRUD / 上传解析 / 预览 / 下载 / 字段配置
├── word_parser.py      # Word 解析器:标签行 → 字段、章节标题、作者、参考文献
├── jats_builder.py     # JATS XML 生成器:front / body / back
├── models.py           # 数据模型:doc / author / section / doc_ref / doc_config
├── requirements.txt    # 三个依赖:Flask、Flask-SQLAlchemy、python-docx
├── templates/index.html
├── static/{css,js}     # style.css / app.js / i18n.js
├── data/word/          # 上传的 Word 原件
├── data/xml/           # 生成的 XML 产物
└── jats.db             # SQLite 数据库
后端 4 个文件共 40,118 字节(约 40 KB),前端 4 个文件共 48,772 字节(约 48 KB)。对比之下,C# 版的纯逻辑代码 (19 个 .cs,不含设计器文件)是 135,238 字节(约 132 KB),若把 *.Designer.cs 一起算上是 232,715 字节(约 227 KB)。
| 模块 | 职责 | 对应的 C# 类 |
|---|---|---|
app.py |
HTTP 接口、文件上传下载、会话与事务边界 | FrmMain.cs(事件处理部分) |
word_parser.py |
从 docx 提取结构化数据 | WordDocReader_Regex.cs + ArticleField_*.cs |
jats_builder.py |
数据 → JATS XML 字符串 | JournalArticleXmlGenerator_2.cs |
models.py |
表结构与 DTO 转换 | Model.Doc / author / Section / Doc_Ref / DocConfig |
五、核心实现一:Word 解析
Word 稿件里没有任何语义标记,只有一堆段落文本。所以解析策略是**「约定 + 三遍扫描」**:
约定 :稿件里用 字段名: 值 形式的标签行承载元数据,例如:
Journal Title: Journal of Advanced Science
DOI: 10.1234/jas.2026.1001
Article Title: Deep Learning Approaches for Automated Journal Article Structuring
Keywords: deep learning; JATS XML; scholarly publishing
Author: Wang Lei (Department of Computer Science, XX University)
Reference: [1] Smith J, Doe A. Article title. J Sci. 2024;12(3):45-56.
1 Introduction
1.1 Background
全文按段落取出后,分三遍各管一件事。
5.1 第一遍:标签行 → 字段(可配置的别名映射)
关键设计是别名映射表------字段叫什么由数据库里的配置决定,不写死在代码里:
python
RE_LABEL = re.compile(r'^\s*([^::]{2,30})[::]\s*(.*)$')

def _match_field_label(text, alias_map):
    """判断段落是否为「字段别名: 值」格式的标签行,返回 (字段名, 值) 或 None"""
    m = RE_LABEL.match(text)
    if not m:
        return None
    label = m.group(1).strip().lower()
    value = m.group(2).strip()
    field_name = alias_map.get(label)
    if not field_name:
        return None
    return field_name, value
alias_map 由 DocConfig 表构建,一个字段可以挂多个别名:
python
DEFAULT_FIELD_CONFIGS = [
    ('Article_Title', 'article title,title,文章标题,标题,题目'),
    ('Abstract',      'abstract,摘要'),
    ('KeywordList',   'keywords,keyword,关键词'),
    # ... 共 20 个字段
]
这个「在线可配」的设计是重构时才加的,价值比想象中大------不同期刊的稿件约定不一样,有的写 Abstract,有的写 摘要,有的写 中文摘要。以前这些差异要改代码重新编译,现在打开弹窗加个别名就行。
标签行之后、下一个标签行之前的内容会继续追加到当前字段,因此多行摘要、多段致谢都能正确收集:
python
for text in paragraphs:
    matched = _match_field_label(text, alias_map)
    if matched:
        current_field, value = matched
        _set_field(dto, _FIELD_COLUMNS, current_field, value)
        continue
    # 非标签行:继续追加到当前字段(多行摘要/致谢等)
    if current_field and current_field not in ('Author', 'Reference'):
        _append_field(dto, _FIELD_COLUMNS, current_field, text)
5.2 第二遍:章节标题识别
章节靠编号模式识别,两级:
python
RE_SEC_H1 = re.compile(r'^(\d+)\s+(.+)$')          # 1 引言
RE_SEC_H2 = re.compile(r'^(\d+)\.(\d+)\s+(.+)$')   # 1.1 小节
注意顺序 :必须先匹配二级再匹配一级。因为 ^(\d+)\s+(.+)$ 里 \s+ 要求编号后是空白,1.1 小节 的 1. 后面跟着 1 而不是空白,理论上不会误匹配------但把二级放前面更保险,也让意图更明确。
5.3 第三遍:作者与参考文献的「区域收集」
作者和参考文献是多段落区域,不是单行标签。所以先定位区域边界,再交给专门的解析器:
边界规则是:遇到其他字段的标签行 结束当前区域;遇到单独成行的 References / 参考文献 则切换到文献区域。
python
def _collect_zone(paragraphs, alias_map, field_name):
    zone, collecting = [], False
    for text in paragraphs:
        matched = _match_field_label(text, alias_map)
        if matched:
            if collecting and matched[0] != field_name:
                break                      # 遇到下一个字段标签行,区域结束
            collecting = matched[0] == field_name
            if collecting and matched[1]:
                zone.append(matched[1])
            continue
        if RE_REF_BOUNDARY.match(text):    # 单独成行的 References
            collecting = (field_name == 'Reference')
            continue
        if collecting:
            if RE_SEC_H1.match(text) and field_name != 'Reference':
                break                      # 作者区遇到章节标题即结束
            if RE_SEC_H1.match(text) and field_name == 'Reference' and not RE_REF_NO.match(text):
                break                      # 文献区只被「非序号行」的章节标题打断
            zone.append(text)
    return zone
最后那个 and not RE_REF_NO.match(text) 是有意为之:参考文献区域里本来就可能出现 1. Smith J... 这种以数字编号开头的条目,如果把章节标题规则直接套上去,会把第 1 条文献误判成章节标题而截断整个区域。
作者解析支持两种写法,并且姓/名的拆分对中西文分开处理:
python
def _split_name(name):
    """拆分姓名为姓/名:中文取首字为姓;西文取末词为姓"""
    name = re.sub(r'\s+', ' ', name).strip()
    if re.search(r'[\u4e00-\u9fff]', name):
        return (name[0], name[1:]) if len(name) > 1 else (name, '')
    parts = name.split(' ')
    return (parts[-1], ' '.join(parts[:-1])) if len(parts) > 1 else (name, '')
Wang Lei → surname=Wang, given=Lei;张三 → surname=张, given=三。这是为了对齐 JATS 的 <name name-style="western"><surname>..</surname><given-names>..</given-names></name> 结构。
5.4 参考文献拆解:顺序很关键
一条文献长这样:
[1] Smith J, Doe A. Article title. J Sci. 2024;12(3):45-56.要拆成 8 个字段,必须先摘出「年;卷(期):页」这一段,剩下的再按句点切:
python
seg_re = re.compile(r'(\d{4})\s*;\s*(\d+)\s*(?:\(([^)]+)\))?\s*:\s*(\d+)\s*-\s*(\d+)')
m = seg_re.search(body)
if m:
    ref['year'], ref['volume'], ref['issue'] = m.group(1), m.group(2), m.group(3) or ''
    ref['fpage'], ref['lpage'] = m.group(4), m.group(5)
    body = body[:m.start()].strip().rstrip('.,') + body[m.end():].strip().rstrip('.,')
    body = body.strip('. ').strip()

sentences = [s.strip() for s in body.split('.') if s.strip()]
if sentences:
    ref['journal'] = sentences[-1]            # 最后一段是期刊名
    if len(sentences) >= 3:
        ref['authors'] = sentences[0]
        ref['title'] = '. '.join(sentences[1:-1])
    elif len(sentences) == 2:
ref['title'] = sentences[0]如果反过来先按句点切,2024;12(3):45-56 里的句点、以及标题里可能出现的缩写点,都会把结构打乱。先摘走结构最固定的一段,再处理自由文本------这个思路在很多「半结构化文本抽取」场景都适用。
5.5 解析失败要给提示,不要静默
解析结果连同 warnings 一起返回,界面上以 toast 提示:
python
if not any(dto[k] for k in _FIELD_COLUMNS.values()):
    warnings.append('未从 Word 中识别到任何元数据字段,请检查文档是否含「字段名: 值」格式的标签行,'
                    '或在「字段配置」中调整别名')
if not dto['sections']:
    warnings.append('未识别到章节标题(需形如「1 引言」的编号段落)')
if not dto['references']:
warnings.append('未识别到参考文献(需形如「[1] ...」的段落)')这一步很朴素,但直接决定了好不好用。解析器面对的是千奇百怪的稿件,「没解析出来」和「解析错了」必须让用户看得见,否则他们会以为工具坏了,而实际上是稿件格式不符约定------有了提示,他们自己就能对照着改。
六、核心实现二:JATS XML 生成器
输出结构严格对齐原 C# 版,也符合 JATS Journal Publishing DTD v2.3:
article
├── front
│   ├── journal-meta   (journal-id / journal-title / issn / publisher)
│   └── article-meta   (article-id / categories / title-group / contrib-group /
│                       volume / issue / fpage / lpage / permissions /
│                       abstract / kwd-group / counts)
├── body
│   └── sec × N        (title + p × N)
└── back
    ├── ack
    └── ref-list
        └── ref → mixed-citation
6.1 用 with 语法管理缩进
XML 是本工具的最终交付物,缩进和换行必须稳定(人要审阅、要 diff、要入库)。与其引入 lxml 再配置序列化参数,不如手写一个 20 行的缩进管理器:
python
class _XmlGen:
    """轻量 XML 生成器:维护缩进层级,支持 with 语法嵌套"""

    def __init__(self):
        self._lines = []
        self._depth = 0
        self._indent = '  '

    class _Scope:
        """with 作用域:进入加深缩进,退出时输出对应的闭合标签"""
        def __init__(self, gen, name):
            self._gen = gen
            self._name = name

        def __enter__(self):
            self._gen._depth += 1
            return self

        def __exit__(self, *exc):
            self._gen._depth -= 1
            self._gen._lines.append('%s</%s>' % (self._gen._pad(), self._name))
            return False

    def el(self, name, attrs=None):
        self._lines.append('%s<%s%s>' % (self._pad(), name, self._attrs(attrs)))
        return _XmlGen._Scope(self, name)

    def leaf(self, name, text, attrs=None):
        self._lines.append('%s<%s%s>%s</%s>'
% (self._pad(), name, self._attrs(attrs), escape(str(text)), name))用起来就变成了「所见即所得」的结构描述------代码的缩进层级和 XML 的输出层级完全一致,一眼就能看出生成的文档长什么样:
python
def _build_front(g, doc):
    with g.el('front'):
        with g.el('journal-meta'):
            if _v(doc.get('journalTitle')):
                g.leaf('journal-id', journal_title, {'journal-id-type': 'nlm-ta'})
                g.leaf('journal-title', journal_title)
            if _v(doc.get('issnPpub')):
                g.leaf('issn', doc.get('issnPpub'), {'pub-type': 'ppub'})
            # ...
        with g.el('article-meta'):
            if _v(doc.get('doi')):
                g.leaf('article-id', doc.get('doi'), {'pub-id-type': 'doi'})
# ...转义直接用标准库:xml.sax.saxutils.escape 处理文本、quoteattr 处理属性------自己拼字符串时最容易漏掉的就是转义,直接借标准库就绕开了这个坑。
6.2 枚举值必须校验,非法值静默降级
article-type 是受控词表,值写错会让下游解析失败:
python
ARTICLE_TYPES = {
    'research-article', 'review-article', 'case-report', 'brief-report',
    'editorial', 'letter', 'correction',
}

article_type = doc.get('articleType') or 'research-article'
if article_type not in ARTICLE_TYPES:
    article_type = 'research-article'
宁可用一个合法的兜底值,也不要生成一份看起来没报错、但下游解不开的 XML。
6.3 参考文献引文的反向拼装
存入时是 8 个字段,输出时按 authors. title. journal. year;vol(issue):fpage-lpage. 拼回一行。每一步都要处理「缺项」------卷号可能没有、期号可能没有、结束页可能没有:
python
def _ref_text(ref):
    parts = []
    for key in ('authors', 'title', 'journal'):
        v = _v(ref.get(key))
        if v:
            parts.append(v if v.endswith('.') else v + '.')

    meta = []
    year = _v(ref.get('year'))
    vol = _v(ref.get('volume'))
    issue = _v(ref.get('issue'))
    fpage = _v(ref.get('fpage'))
    lpage = _v(ref.get('lpage'))
    if year:
        seg = year
        if vol:
            seg += ';' + vol + (('(%s)' % issue) if issue else '')
        if fpage:
            seg += ':' + fpage + (('-' + lpage) if lpage else '')
        meta.append(seg)

    citation = ' '.join(parts)
    if meta:
        citation = (citation + ' ' if citation else '') + ' '.join(meta)
    if citation and not citation.endswith('.'):
        citation += '.'
    return citation.strip()
v if v.endswith('.') else v + '.' 这一行是为了不产生 J Sci.. 这种双点------拼接类逻辑里,「标点归属」永远是最容易出细节 bug 的地方。
七、核心实现三:数据模型
原 C# 版的库结构是 5 张表,重构时表结构照搬,只把 SQL Server 换成 SQLite:
| 表 | 说明 |
|---|---|
doc |
文档主表,约 25 个元数据字段 |
author |
作者(surname / given-names / affiliation / sort_id) |
section |
章节(title / desp / sort_id) |
doc_ref |
参考文献(8 个结构化字段 + sort_id) |
doc_config |
字段别名配置(doc_id 为空 = 全局模板) |
两个细节值得记下来。
一是主键格式 。SQL Server 用的是 uniqueidentifier,Python 侧用 32 位无连字符 GUID 对齐:
python
def new_guid():
    """生成 32 位无连字符 GUID,与 SQL Server uniqueidentifier 对应"""
    return uuid.uuid4().hex
这样迁移数据时不需要做 ID 转换。
二是级联删除 。删文档要连带删掉它的作者、章节、参考文献,交给 ORM 声明式处理,比手写三条 DELETE 可靠:
python
authors = db.relationship('Author', backref='doc', cascade='all, delete-orphan',
                          order_by='Author.sort_id', lazy='joined')
order_by='sort_id' 保证顺序稳定------表单里作者是按行排列的,数据库取出来顺序变了就全乱了;lazy='joined' 则避免了 N+1 查询。
三是保存语义 。文档保存时子表采用全量覆盖(清空后重建),这在单用户编辑场景下比逐条 diff 简单得多,也不容易出「删了一行但数据库还留着」的幽灵数据:
python
def _replace_children(doc, data):
    """全量重建作者/章节/参考文献子表记录"""
    doc.authors.clear()
    for i, a in enumerate(data.get('authors') or []):
        doc.authors.append(AuthorRow(a, i))
    # sections / references 同理
八、前端:零构建的三栏界面
前端没有用任何框架,四个文件、不到 50 KB。这个体量下引入构建工具反而是负担。
几个实现上的取舍:
api() 统一封装 ,顺带把非 2xx 转成异常,业务代码里就不用每次判断 resp.ok:
javascript
async function api(url, options = {}) {
  const opts = { headers: {}, ...options };
  if (opts.body && typeof opts.body !== 'string') {
    opts.body = JSON.stringify(opts.body);
    opts.headers['Content-Type'] = 'application/json';
  }
  const resp = await fetch(url, opts);
  const data = await resp.json().catch(() => ({}));
  if (!resp.ok) throw new Error(data.error || resp.statusText);
  return data;
}
实时预览要做防抖 。表单输入触发 input 事件,如果每次都打后端,打字过程中会连发几十个请求:
javascript
const scheduleRender = debounce(() => renderPreview(), 500);500 ms 的延迟在体感上仍然是「边打边变」,但请求量降了一个数量级。
XML 高亮用轻量正则。不引入 highlight.js(几十 KB 只为渲染一种语言不划算):
javascript
function highlightXml(xml) {
  let s = esc(xml);
  s = s.replace(/(<\/?)([\w.:-]+)/g, '$1<span class="tag">$2</span>');
  s = s.replace(/([\w.:-]+)=("[\s\S]*?")/g, '<span class="attr">$1</span>=<span class="val">$2</span>');
  return s;
}
动态行是「全量收集 / 全量回填」。作者、章节、参考文献的行数不固定,最简单的做法是每次从 DOM 里把所有行读一遍:
javascript
dto.authors = $$('#authorList .row').map((row) => ({
  surname: $('.a-surname', row).value.trim(),
  given: $('.a-given', row).value.trim(),
  aff: $('.a-aff', row).value.trim()
}));
代价是每次读取都要遍历 DOM,但总共几十行数据,完全无感;换来的是没有中间状态,不用维护「哪一行对应哪个对象」。
中英双语 用 data-i18n 属性 + 字典查表,语言偏好存 localStorage:
javascript
$$('[data-i18n]').forEach((el) => { el.textContent = t(el.dataset.i18n); });这里踩了一个坑:切换语言时如果直接重渲染 DOM,动态行里用户填的内容会丢。修法是切换前先 collectData() 存一份,切完再按新语言重建:
javascript
$('#btnLang').addEventListener('click', () => {
  const data = collectData();          // 切换前保存动态行内容
  lang = lang === 'zh' ? 'en' : 'zh';
  applyI18n();
  $('#authorList').innerHTML = '';
  data.authors.forEach((a) => addAuthorRow(a));
  // ...
});
九、踩坑记录
1)全角标点。 中文输入法打出来的 :「;」「,」跟半角不是一个字符。标签行正则里 [^::] 两种冒号都要收,关键词拆分要把 ;;,, 全部归一化成 ;:
python
for ch in ';;,,':
    text = text.replace(ch, ';')
2)别名匹配前必须手工归一化。 数据库里存的别名大小写不统一,正则 re.IGNORECASE 管不到字典查表这一步,所以统一 label.strip().lower(),别名入库时也统一 lower:
python
return {c.field_name: [a.strip().lower() for a in (c.aliases or '').split(',') if a.strip()]
        for c in configs}
3)「标签行后面没有值」是合法状态。 Abstract: 单独一行,值在下一段------所以匹配成功但值为空时不能当作没匹配,要继续让后续段落往里追加:
python
# 标签行后无值也算匹配(值在后续行)
return field_name, value
4)正则多分支时,取的组号要对。 参考文献序号正则有两个分支:
python
RE_REF_NO = re.compile(r'^\[(\d+)\]\s*(.*)$|^\(?(\d+)\)?[.、]\s*(.*)$')第一个分支的编号和正文是 group(1) / group(2),第二个分支是 group(3) / group(4)。写的时候很自然地会去取 group(1),结果第二种写法下永远拿到 None:
python
no = m.group(1) or m.group(3) or str(len(references) + 1)
body = (m.group(2) or m.group(4) or '').strip()
5)区域边界规则的「例外」要单独写。 前面提过,文献区域不能被 1. Smith J... 这种编号条目打断------这个例外如果不显式写出来,表现为「参考文献只解析出第一条」,而且很难看出原因。
6)空值要一路防御。 从 Word 解析出来的字段可能全是空字符串、也可能是 None。所有取值都过一层:
python
def _v(val):
    """None 安全的 strip"""
    return val.strip() if isinstance(val, str) else ''
比在每个使用点写 if x: 要省心得多。
7)下载文件名要洗一遍。 文章标题里可能有 : / ? 这类在 Windows 上非法的字符:
python
filename = ''.join(c for c in name if c not in '\\/:*?"<>|')[:60] + '.xml'顺手做了 60 字符截断,避免超长文件名。
8)上传要做格式与体积双重校验。 只收 .docx(python-docx 读不了老版 .doc),并在 Flask 配置里限制 32 MB:
python
app.config['MAX_CONTENT_LENGTH'] = 32 * 1024 * 1024 # 上传上限 32MB提示语也要写清楚怎么办------「仅支持 .docx 格式(请先用 Word 另存为 .docx)」,比单纯说「格式错误」有用得多。
9)开发期关掉静态文件缓存。 不然改了 JS 刷新页面没反应,会浪费很多时间去怀疑代码:
python
app.config['SEND_FILE_MAX_AGE_DEFAULT'] = 0 # 开发期禁用静态文件缓存十、重构前后对比
| 维度 | C# WinForms 版 | Flask 版 |
|---|---|---|
| 部署 | 装 .NET + 一堆 DLL,每台机器装一次 | pip install -r requirements.txt + python app.py,浏览器打开 |
| 数据库 | SQL Server 实例 | 单个jats.db 文件,拷走即搬 |
| 界面改动 | 拖设计器,FrmMain.Designer.cs 68 KB |
改 HTML/CSS,即时生效 |
| Word 解析 | WordDocReader_Regex + 多个 ArticleField_* |
word_parser.py 单文件 |
| 字段别名 | 改代码后重新编译 | 界面上在线改,存库即时生效 |
| 跨平台 | 仅 Windows | Windows / Linux / macOS 均可 |
| 数据外发 | --- | 全程本机,不联网 |
代码规模上,核心逻辑从约 132 KB C# 降到约 40 KB Python,前端另加约 48 KB(零依赖)。
十一、小结
几点感受:
1. 重构不是重写,是「翻译 + 减负」。 这次重构的价值不在于换了技术栈,而在于把原版里耦合在 WinForms 事件处理中的业务逻辑拆成了三个职责清晰的模块(解析 / 生成 / 存储)。拆开之后,每个文件都短到能一口气读完,加功能和改 bug 的成本都降下来了。
2. 「可配置」优先于「聪明」。 最初想过做更智能的 Word 结构推断,最后选择了「约定 + 可配置别名」这条路。原因是期刊排版约定本来就是人定的、而且是会变的,把变化点暴露成配置项,比写一堆猜不准的启发式规则更实用。上线后果然------不同刊物的稿件差异基本都是靠加别名解决的。
3. 解析类工具,错误提示和解析能力同样重要。 工具面对的是格式不受控的输入,不可能 100% 命中。能把「为什么没解析出来」讲清楚,用户就能自己修稿件;讲不清楚,工具再准也会被放弃。
4. 选中合适的技术而不是先进的技术。 一个单机单用户、日处理量个位数的小工具,用 Flask + SQLite 是最贴合的答案。这个判断在写第一行代码之前就该做完。
后续可以做的
- 在线校对预览:左侧表单与右侧 XML 双向定位(点 XML 节点跳到对应表单项);
- 批量处理:选一个文件夹,把所有 docx 批量转成 XML 并打包下载;
- 导出模板:把一份配置好的文档存成模板,新稿件只填差异部分;
- 校验:接入 JATS DTD / XSD 做生成后的结构校验,出问题直接顶上红标。
技术栈:Python 3 / Flask 3 / Flask-SQLAlchemy / SQLite / python-docx / 原生 JavaScript
输出标准:JATS Journal Publishing DTD v2.3