前言
在嵌入式对讲、会议终端、可视门铃、安防 IPC、智能工牌、楼宇门禁这类产品开发中,音频链路一直是痛点集中区:环境杂声、喇叭‑麦克风耦合回声、风噪敲击突发噪声、远场拾音差、多设备接口适配复杂。传统方案往往需要 DSP+Codec + 运放多颗器件搭建,算法调试周期长,模拟链路容易引入串扰底噪,数字与模拟设备之间兼容适配成本很高。
AU‑60 是芯慧创科技推出的邮票半孔 SMT 贴片 DSP 语音处理模组,把AI‑ENC 智能降噪、100dB AEC 回声消除、BF 波束成形、ADC/DAC、USB 音频、I2S、SPI 配置接口全部集成在 37.5 mm × 16 mm 狭小模组内,一套硬件兼容模拟麦、PDM 数字麦克风,同时支持 USB、模拟音频、I2S 数字音频输入输出,大幅降低音频硬件设计与算法调试门槛。本文基于规格书从算法能力、硬件接口、工作模式、硬件踩坑要点、适用场景做完整工程梳理,给做语音对讲产品的硬件、固件工程师做参考。
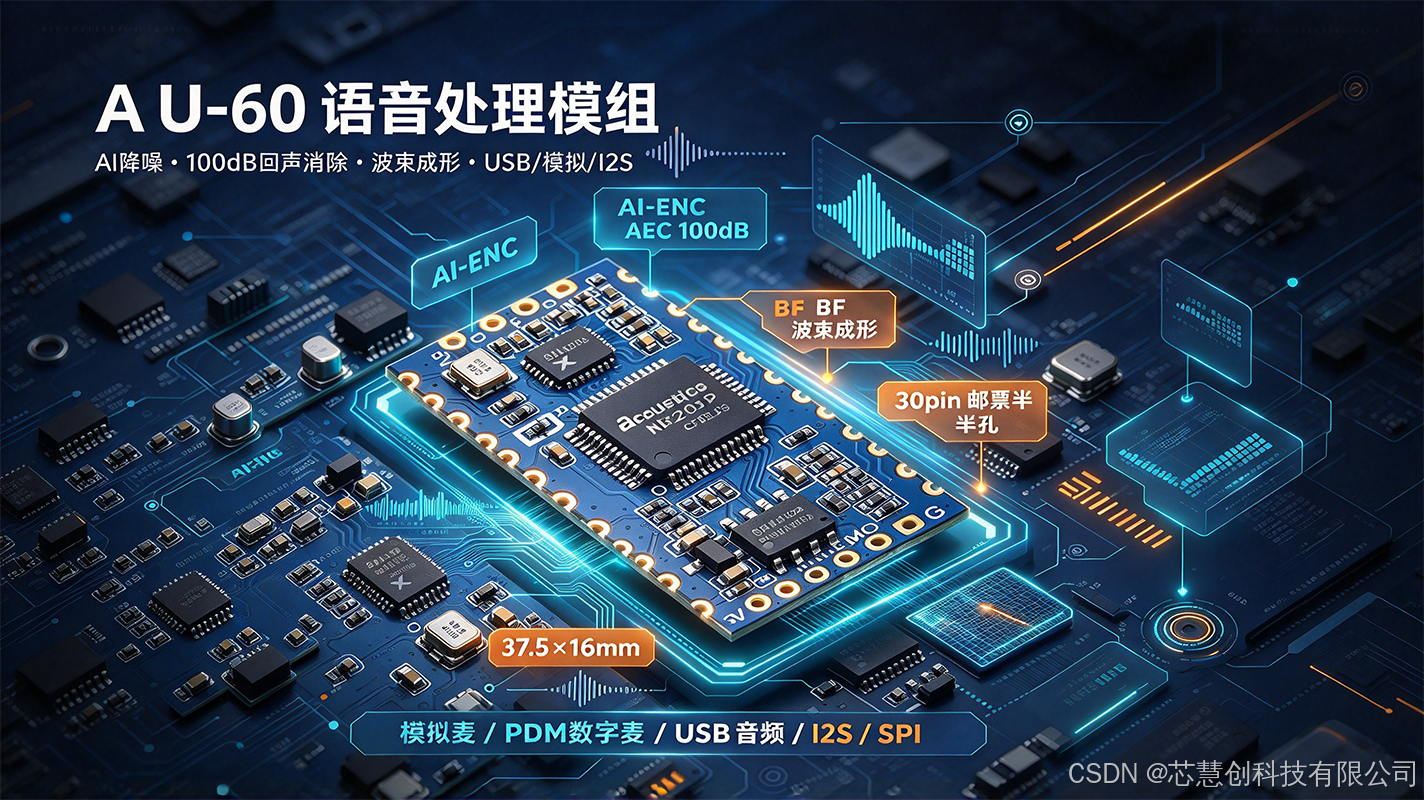
一、核心声学算法与关键电气指标
1.1 AI‑ENC 人工智能环境降噪
区别传统谱减法降噪,AU‑60 的 AI‑ENC 可以压制大量非稳态噪声:风扇、空调、汽车鸣笛、金属撞击、拍打麦克风本体、直吹麦克风的风噪,优先保留人声信号,降噪区间45‑90dB(AI 固件最佳工况)。
重点:不是单纯的 VAD 静音截断,突发噪声不会直接把人声一并切掉,适合工业对讲、监控拾音、户外可视门铃这类噪声复杂的现场。
1.2 AEC 全双工回声消除(100dB 抑制深度)
- 最大回声抑制:100dB
- 最大可容忍回声空间延迟:100ms
- 引脚
AECIN(26脚)为回声参考信号输入端,必须引入喇叭播放的音频参考,AEC 算法才可以正常收敛工作。
工程重点:参考信号有两种取法
- 功放输入端取小信号,可直接直连 AECIN;
- 如果从功放功率输出端取参考,必须串联隔直电容 C1(常用 104/1uF)+R1(1K‑10K)阻容网络,否则大功率信号会损坏模组输入端口。
支持双向同时说话,不会出现 "一方说话另一方被吞音" 的半双工现象,允许喇叭与麦克风物理距离很近,给产品结构设计更大自由度。
1.3 BF 波束成形双数字麦克风定向拾音
当使用 PDM 双数字麦克风固件,支持两种波束模式:
- 双麦单波束单输出:默认中轴 90°,拾音角度范围 60°,单通道输出,用于普通定向拾音对讲;
- 双麦双波束双独立输出:两个波束拥有独立中轴角度,输出两路互不串扰的音频通道,适合双分区对讲、智能工牌、双通道录音翻译设备;
波束中轴角度、拾音覆盖范围均可通过固件或者 SPI 寄存器修改;双麦推荐间距默认 6cm。
1.4 关键电气参数汇总
表格
| 参数 | 规格 |
|---|---|
| 供电 | 5V(4‑5.25V) /3.3V(3‑3.3V);12 脚与 13 脚输入电压必须保持一致 |
| 静态电流 | 65‑80mA |
| 模拟输出 MICOUT / USPKOUT | 输出阻抗 120Ω,SNR 105dB,最大输出 1.07Vrms |
| I2S 默认参数 | 主模式,16KHz,16bit,飞利浦标准;LRCK=16KHz,BCLK=512KHz |
| 工作温度 | ‑20℃~70℃;工业版本可到‑40℃~85℃ |
| 数字麦供电输出(19 脚 3V3) | 最大输出电流30mA,禁止短路,建议优先外部给数字麦供电 |
二、硬件接口总览
AU‑60 为 30pin 邮票半孔封装,核心接口分类:
- 麦克风输入
- 模拟麦:
MIC+(17)、MIC‑(16); - PDM 数字麦:
CLK(15)时钟输出、DAT(14)数据输入;
- 模拟麦:
- 模拟音频
- MICOUT (1):降噪之后模拟音频输出;
- USPKOUT (3):下行播放模拟音频输出;
- AECIN (26):回声消除参考信号输入;
- AGND (2/4/25):模拟音频地,建议和功率地单点接地;
- I2S 数字音频
- LRCK (5) 帧时钟、BCLK (6) 位时钟、D_IN (7) 数字输入(需要拆掉模组板上 R1 电阻才生效)、D_OUT (8) 降噪后数字音频输出;
- USB 音频(27‑30 脚) USB‑D+、USB‑D‑,Windows/Android/Linux 免驱 UAC 音频设备,USB 模式固件分 3 种输出模式,需要和厂商确认固件版本;
- 硬件参数切换引脚 T1 (11) T2 (9)
T1/T2 默认高电平,对地拉低改变拾音距离参数(AEC 固件)
- T1=H,T2=H:中距离 0.5‑2m;
- T1=H,T2=L:近距离 0.1‑0.2m;
- T1=L,T2=H:远距离 0.5‑5m;
- T1=L,T2=L:超远距离 0.5‑8m;
可以预留 0Ω 电阻焊接位,硬件上切换拾音档位;扩音啸叫抑制模式下,该两组引脚切换降噪等级。 6. SPI 控制接口 (21‑24 脚) 模组 SPI 为从机模式,外部 MCU 上电等待约 3 秒后,可以通过 SPI 写入寄存器动态修改降噪、波束、增益参数,适合产品需要软件动态切换声学效果的项目。
重要提醒:模组 19 脚输出 3.3V 给数字麦克风,最大负载 30mA,如果外接多颗数字麦克风,强烈建议外部 LDO 供电,不要使用模组内部输出,防止 LDO 烧毁。
三、十种系统工作模式快速选型
AU‑60 最大优势是一套硬件,适配不同系统架构,根据你主板具备的接口快速选择模式:
表格
| 模式 | 配置 | 适用主板条件 |
|---|---|---|
| 模式一 | 模拟 / 数字麦 + USB 输出 | 主板只有 USB,没有 Codec;可视门铃、USB 对讲设备 |
| 模式二 | 模拟麦 + 模拟输入输出 | 主板只有模拟 LINE‑IN / LINE‑OUT;传统对讲门禁设备 |
| 模式三 | 模拟麦 + I2S 数字输出 | 主板只有 I2S 输入,需要数字音频;IPC 摄像头方案 |
| 模式四 | 模拟麦 + I2S 输入 + 输出(拆 R1) | 主板全部为数字音频,没有模拟 Codec;简化音频 BOM |
| 模式五 | 单数字麦 + 模拟输出 | 想要数字麦抗干扰,后端接模拟 ADC;工业呼叫终端 |
| 模式六 | 单数字麦 + I2S 输出 | 数字拾音,数字输出,降低模拟走线干扰;录音采集设备 |
| 模式七 | 单数字麦 + I2S 双向(拆 R1) | 全数字链路高信噪比设备 |
| 模式八 | 双数字麦波束 + 模拟输出 | 双麦定向拾音,后端模拟输入;会议室对讲 |
| 模式九 | 双数字麦波束 + I2S 输出 | 双麦定向拾音,数字输出;智能门禁、监控拾音 |
| 模式十 | 双数字麦双波束双模拟输出 | 双通道独立波束输出;智能工牌、双分区通话、双通道录音 |
关键点:模式四、七,I2S 的 D_IN 要起作用,必须拆除模组板载 R1 电阻,拆除后 MICOUT 引脚会变为 DAC 下行模拟监听输出。
四、硬件设计避坑指南(工程实践)
- 模拟地 AGND 与功率 GND 要单点汇集 模拟音频地不要和功放大电流地直接大面积共地,否则容易引入电源纹波噪声。邮票孔的 AGND 引脚集中做星型接地处理。
- 模拟输出幅度 1.07Vrms,后端输入幅度过小必须分压 MICOUT、USPKOUT 输出幅度较大,如果后端 ADC 只支持几百毫伏输入,必须增加 RC 分压衰减电路,否则会出现音频削顶爆音。
- 回声参考信号 AECIN 不能悬空 使用 AEC 回声消除功能,必须接入喇叭回放音频参考;悬空状态下 AEC 算法无法工作,回声抑制失效。
- I2S 为主模式 AU‑60 的 I2S 是主模式,时钟由模组输出,后端 CPU/Codec 必须配置为 I2S 从模式接收音频。
- 双数字麦克风硬件注意点 双麦模式需要对应固件,硬件上 PDM 麦克风 SET 引脚接地;麦克风间距影响波束效果,默认推荐 6cm,更改间距需要同步调整固件波束参数。
- 供电:3.3V 供电模式,12 脚和 13 脚必须同时输入 3.3V,不能一个接 5V 一个接 3.3V。
五、典型应用场景
- 安防:IPC 摄像头、可视门铃,监控拾音;
- 对讲:楼宇门禁、别墅对讲、监狱医院呼叫终端;
- 工业:矿井呼叫、停车场自助对讲、智能工牌;
- 会议教育:远程会议、教育通话设备;
- 车载:车载语音通话、车载对讲终端;
- 录音采集:录音笔、采访设备、双通道录音翻译设备。
六、总结
AU‑60 本质是一套完整的声学前端子系统,而不是简单的麦克风放大模块。它把 AI 降噪、AEC 回声消除、波束成形、ADC/DAC、USB 音频全部封装,工程师不用从零调 DSP 算法,通过硬件引脚或者 SPI 即可配置声学参数。
对于产品开发来说,最大价值:
- 兼容模拟 / PDM 数字麦克风;
- USB、模拟、I2S 三驾马车,适配旧设备改造和全新数字硬件;
- T1/T2 硬件档位切换,小批量产品不用改固件就适配不同拾音距离;
- 双波束双通道输出,覆盖普通对讲到双分区拾音这类差异化产品需求。
提示:不同固件对应不同功能,选型前和厂商确认固件版本,双麦双波束、USB 的三种输出模式都需要指定对应固件。