'''
2025082520250825_2025_学年出入所(园)儿童基本情况登记  表一空  01
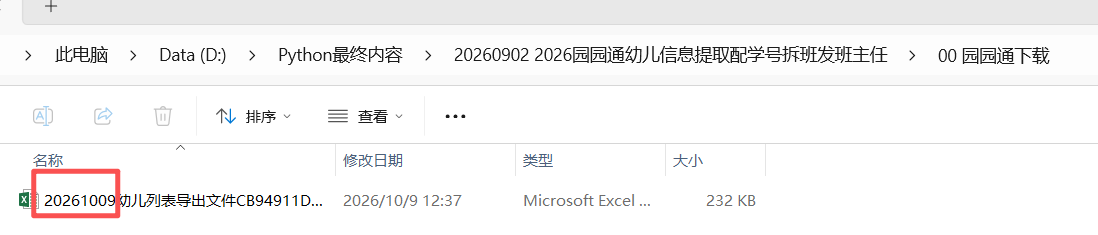
1、下载园园通新生名册.xls,把两个新生名册合并在一起
2、部分插班生信息手动添加
deepseek,阿夏
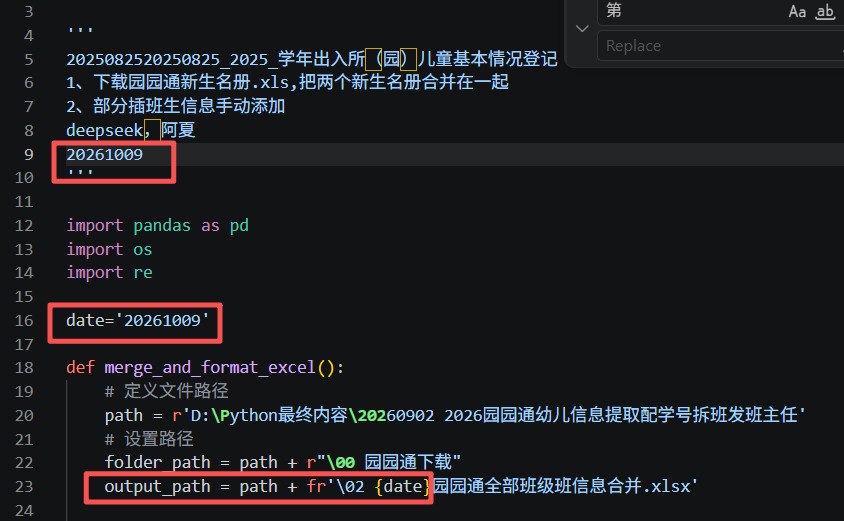
20261009
'''

import pandas as pd
import os
import re

date='20261009'

def merge_and_format_excel():
    # 定义文件路径
    path = r'D:\Python最终内容\20260902 2026园园通幼儿信息提取配学号拆班发班主任'
    # 设置路径
    folder_path = path + r"\00 园园通下载"
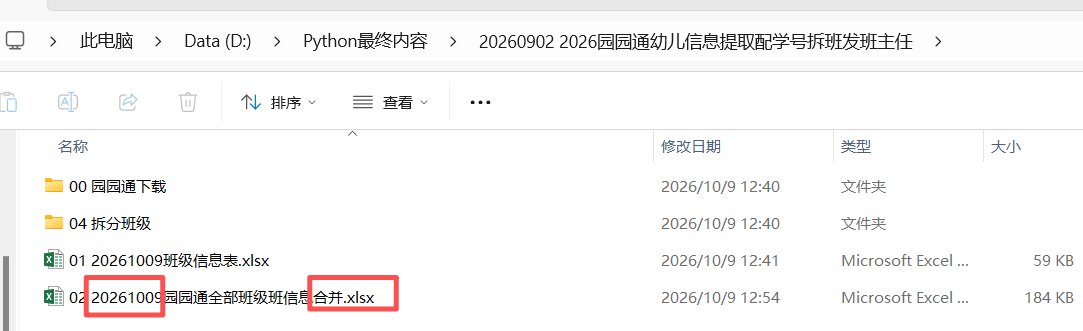
    output_path = path + fr'\02 {date}园园通全部班级班信息合并.xlsx'

    # 获取文件夹中的所有Excel文件
    excel_files = [f for f in os.listdir(folder_path) if f.endswith(('.xlsx', '.xls'))]

    # if len(excel_files) < 2:
    #     print("234文件夹中Excel文件数量不足2个")
    #     return

    # 读取所有Excel文件
    dfs = []
    for file in excel_files[:3]:  # 只处理前两个文件
        file_path = os.path.join(folder_path, file)
        df = pd.read_excel(file_path)
        dfs.append(df)
        print(f"已读取文件: {file}")

    # 合并数据
    merged_df = pd.concat(dfs, ignore_index=True)

    # 将列名"ID"改为"市登记编号"(如果存在)
    if 'ID' in merged_df.columns:
        merged_df.rename(columns={'ID': '市登记编号'}, inplace=True)
        print("已将列名'ID'改为'市登记编号'")
    else:
        print("未找到名为'ID'的列,跳过重命名")

    # 格式化班级列(统一改为"托1班"、"小1班"、"中1班"、"大1班"格式)
    def format_class_name(class_name):
        if pd.isna(class_name):
            return class_name

        class_str = str(class_name)

        # 定义班级类型映射
        class_type_map = {
            '托': '托', '托大': '托',
            '小': '小',
            '中': '中',
            '大': '大'
        }

        # 中文数字到阿拉伯数字的映射
        chinese_to_arabic = {
            '一': '1', '二': '2', '三': '3', '四': '4', '五': '5',
            '六': '6', '七': '7', '八': '8', '九': '9', '十': '10',
            '十一': '11', '十二': '12'
        }

        # 先提取班级类型
        class_type = None
        class_num = None

        # 匹配各种格式
        # 1. 匹配"托大X班"、"小X班"、"中X班"、"大X班"格式
        match = re.search(r'(托大|小|中|大)([一二三四五六七八九十\d]+)班', class_str)
        if match:
            class_type = match.group(1)
            class_num = match.group(2)
        else:
            # 2. 匹配"大一班"、"托一班"格式
            match = re.search(r'(托|小|中|大)([一二三四五六七八九十])班', class_str)
            if match:
                class_type = match.group(1)
                class_num = match.group(2)
            else:
                # 3. 匹配"大班一班"格式
                match = re.search(r'(托大|小|中|大)班([一二三四五六七八九十]+)班', class_str)
                if match:
                    class_type = match.group(1)
                    class_num = match.group(2)
                else:
                    # 4. 匹配"一班大班"格式
                    match = re.search(r'([一二三四五六七八九十]+)班(托大|小|中|大)班', class_str)
                    if match:
                        class_num = match.group(1)
                        class_type = match.group(2)
                    else:
                        # 5. 匹配只有班级类型没有班号的情况
                        match = re.search(r'(托大|小|中|大)班', class_str)
                        if match:
                            class_type = match.group(1)
                            class_num = '1'  # 默认班号为1
                        else:
                            # 6. 匹配只有班级类型没有"班"字的情况
                            match = re.search(r'(托大|小|中|大)', class_str)
                            if match:
                                class_type = match.group(1)
                                class_num = '1'  # 默认班号为1

        if class_type:
            # 标准化班级类型
            if class_type == '托大':
                std_type = '托'
            else:
                std_type = class_type

            # 转换班号
            if class_num:
                if class_num in chinese_to_arabic:
                    num = chinese_to_arabic[class_num]
                else:
                    num = class_num
                return f"{std_type}{num}班"

        # 如果没有匹配到任何模式,尝试直接提取数字
        # 检查是否已经是"托1班"这样的格式
        match = re.match(r'([托小中大])(\d+)班', class_str)
        if match:
            return class_str  # 已经是正确格式

        # 最后尝试:如果字符串中包含"托"、"小"、"中"、"大",且包含数字
        for t in ['托', '小', '中', '大']:
            if t in class_str:
                # 提取所有数字
                nums = re.findall(r'\d+', class_str)
                if nums:
                    return f"{t}{nums[0]}班"

        # 如果还是无法处理,返回原值
        print(f"警告:无法识别的班级格式 - {class_str}")
        return class_str

    # 查找包含班级信息的列
    class_columns = [col for col in merged_df.columns if any(keyword in col for keyword in ['班', 'class', '班级'])]

    if class_columns:
        for class_col in class_columns:
            print(f"检测到班级列: {class_col}")
            merged_df[class_col] = merged_df[class_col].apply(format_class_name)
    else:
        print("未检测到班级列,跳过格式转换")

    # 保存合并后的文件
    merged_df.to_excel(output_path, index=False)
    print(f"文件已保存至: {output_path}")
    print(f"合并完成,共{len(merged_df)}条记录")

    # 显示一些样本数据以供验证
    print("\n前10条数据的班级信息:")
    if class_columns:
        for class_col in class_columns:
            print(f"\n{class_col}列的前10个值:")
            sample_values = merged_df[class_col].head(10).tolist()
            for i, val in enumerate(sample_values, 1):
                print(f"  {i}. {val}")
    else:
        print("未找到班级列")

    # 显示所有列名
    print("\n合并后的所有列名:")
    print(merged_df.columns.tolist())

# 执行函数
if __name__ == "__main__":
    merge_and_format_excel()
'''
20250825_2025_学年出入所(园)儿童基本情况登记  表一空  01
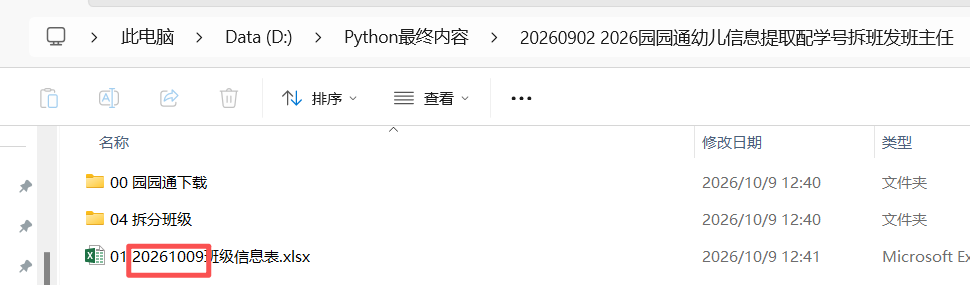
1、用合并xls与班级信息表的学号匹配,按学号排队
2、按班级拆分成一个个班级,最适合列宽一行(非自动换行)
3、按指定的列名顺序重新排列列的位置
20261009
'''

import pandas as pd
import os
from openpyxl.utils import get_column_letter
from openpyxl.styles import Alignment
from openpyxl.styles import numbers

# 设置路径
path = r'D:\Python最终内容\20260902 2026园园通幼儿信息提取配学号拆班发班主任'

date='20261009'

# 定义目标列名顺序
target_columns = [
    '学号', '班级', '姓名', '市登记编号',  '性别','出生地', '证件类型', '证件号码',
    '姓名拼音', '曾用名/英文名', '出生日期', '年级', '班级名称', '入园日期',
    '就读方式', '国籍/地区', '健康状况', '血型', '户口性质', '非农业户口类型',
    '港澳台侨外', '民族', '出生地-省份', '籍贯-省份', '是否人户一致',
    '户口所在地-省份', '户口所在地-城市', '户口所在地-区县', '户口所在地-街道',
    '户口所在地-居委', '户口所在地-详细地址', '现居地-省份', '现居地-城市',
    '现居地-区县', '现居地-街道', '现居地-居委', '现居地邮政编码', '现居地-详细地址',
    '监护人姓名', '监护人证件类型', '监护人证件号', '监护人手机', '与幼儿关系',
    '是否监护人', '是否是第一监护人', '是否是军烈子女', '是否是优抚子女',
    '是否是进城务工人员随迁子女', '是否是部队子女', '是否是孤儿', '是否是残疾幼儿',
    '残疾幼儿类别', '更新时间', '机构所在地区', '机构ID', '机构名称', '办园点ID',
    '办园点编码', '办园点名称', '班级昵称', '出生地-区县', '机构编码', '籍贯-区县',
    '籍贯-城市', '幼儿ID', '创建时间', '班级ID', '版本号', '幼儿特长',
    '户口所在地-居委-其他', '现居地-街道-其他', '户口所在地-街道-其他',
    '现居地-居委-其他', '特异体质', '出生地-城市', '原幼儿编号', '班级排序'
]

def calculate_display_width(text):
    """
    计算字符串在Excel中的显示宽度
    中文字符占2个单位,英文字符和数字占1个单位
    """
    if text is None or pd.isna(text):
        return 0

    text = str(text)
    width = 0
    for char in text:
        # 判断是否为中文字符(包括中文标点)
        if '\u4e00' <= char <= '\u9fff' or char in ',。;:""''!?【】()《》':
            width += 2
        else:
            width += 1
    return width

def reorder_columns(df, target_columns):
    """
    按照目标列名顺序重新排列DataFrame的列
    """
    # 获取DataFrame中实际存在的列
    existing_columns = []
    missing_columns = []

    for col in target_columns:
        if col in df.columns:
            existing_columns.append(col)
        else:
            missing_columns.append(col)

    # 获取目标列中不存在的其他列(放在最后)
    other_columns = [col for col in df.columns if col not in existing_columns]

    if missing_columns:
        print(f"警告:以下目标列在数据中不存在,将被忽略:{missing_columns}")

    if other_columns:
        print(f"注意:以下额外列将放在最后:{other_columns}")

    # 重新排列列顺序
    return df[existing_columns + other_columns]

# 1. 读取园园通信息表,将所有列作为字符串读取,保持原始格式
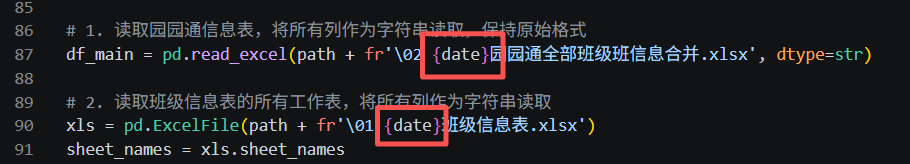
df_main = pd.read_excel(path + fr'\02 {date}园园通全部班级班信息合并.xlsx', dtype=str)

# 2. 读取班级信息表的所有工作表,将所有列作为字符串读取
xls = pd.ExcelFile(path + fr'\01 {date}班级信息表.xlsx')
sheet_names = xls.sheet_names

# 3. 合并所有班级信息表
df_list = []
for sheet in sheet_names:
    df_sheet = pd.read_excel(xls, sheet_name=sheet, dtype=str)  # 所有列作为字符串读取
    df_sheet['班级'] = sheet  # 添加班级列
    df_list.append(df_sheet)

df_info = pd.concat(df_list, ignore_index=True)

# 4. 匹配学号
df_merged = pd.merge(df_main,
                    df_info[['班级', '姓名', '学号']],
                    left_on=['班级名称', '姓名'],
                    right_on=['班级', '姓名'],
                    how='left')

# 5. 移动学号列到最前面(这一步现在会被后面的重新排序列覆盖,但保留以确保学号存在)
cols = df_merged.columns.tolist()
cols = ['学号'] + [col for col in cols if col != '学号']
df_merged = df_merged[cols]

# 6. 对完整匹配结果进行排序并保存
# 学号列转换为数值类型用于排序,但保存时保持原始文本格式
df_merged['学号_排序'] = pd.to_numeric(df_merged['学号'], errors='coerce')

# 先按班级排序(托1班、托2班、小1班、小2班...)
# 创建班级排序的映射关系
class_order = {
    '托1班': 1, '托2班': 2, '托3班': 3, '托4班': 4,
    '小1班': 11, '小2班': 12, '小3班': 13, '小4班': 14, '小5班': 15,
    '中1班': 21, '中2班': 22, '中3班': 23, '中4班': 24,'中5班': 25,'中6班': 26,
    '大1班': 31, '大2班': 32, '大3班': 33, '大4班': 34,'大5班': 35,
}

# 添加临时排序列
df_merged['班级排序'] = df_merged['班级名称'].map(class_order)

# 先按班级排序,再按学号排序
df_merged_sorted = df_merged.sort_values(by=['班级排序', '学号_排序'])

# 删除临时排序列(班级排序保留,因为它在目标列中)
df_merged_sorted = df_merged_sorted.drop(['学号_排序'], axis=1)

# 按照目标列顺序重新排列
df_merged_sorted = reorder_columns(df_merged_sorted, target_columns)

# 保存排序后的完整表格,并调整列宽
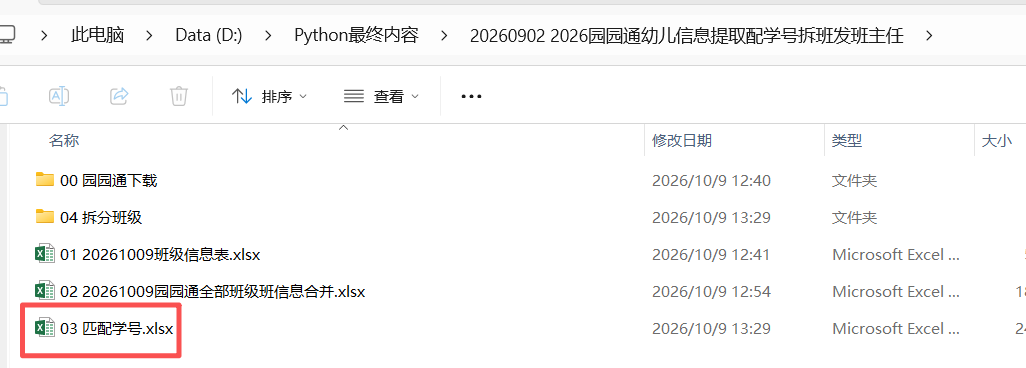
with pd.ExcelWriter(path + r'\03 匹配学号.xlsx', engine='openpyxl') as writer:
    df_merged_sorted.to_excel(writer, sheet_name='匹配结果', index=False)

    # 获取工作表并调整列宽
    worksheet = writer.sheets['匹配结果']

    # 计算每列的最大显示宽度
    for column in worksheet.columns:
        max_width = 0
        column_letter = get_column_letter(column[0].column)

        # 获取列标题和所有单元格的最大显示宽度
        for cell in column:
            try:
                # 计算单元格内容的显示宽度
                cell_width = calculate_display_width(cell.value)
                if cell_width > max_width:
                    max_width = cell_width
            except:
                pass

        # 设置列宽(添加一点额外空间)
        # Excel列宽单位是标准字符宽度,中文字符需要额外空间
        adjusted_width = max_width + 2  # 添加2个字符的边距
        # 限制最小宽度为8,最大宽度为100
        worksheet.column_dimensions[column_letter].width = min(max(adjusted_width, 8), 100)

    # 将所有单元格设置为文本格式
    for row in worksheet.iter_rows():
        for cell in row:
            cell.number_format = '@'  # 设置文本格式

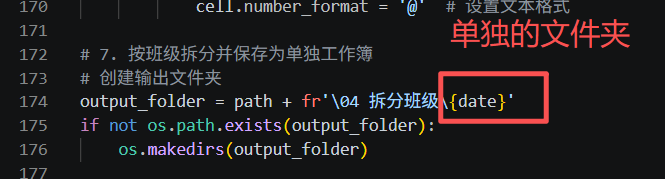
# 7. 按班级拆分并保存为单独工作簿
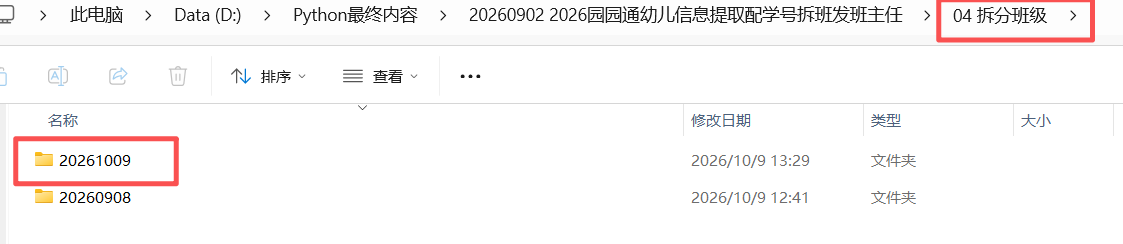
# 创建输出文件夹
output_folder = path + fr'\04 拆分班级\{date}'
if not os.path.exists(output_folder):
    os.makedirs(output_folder)

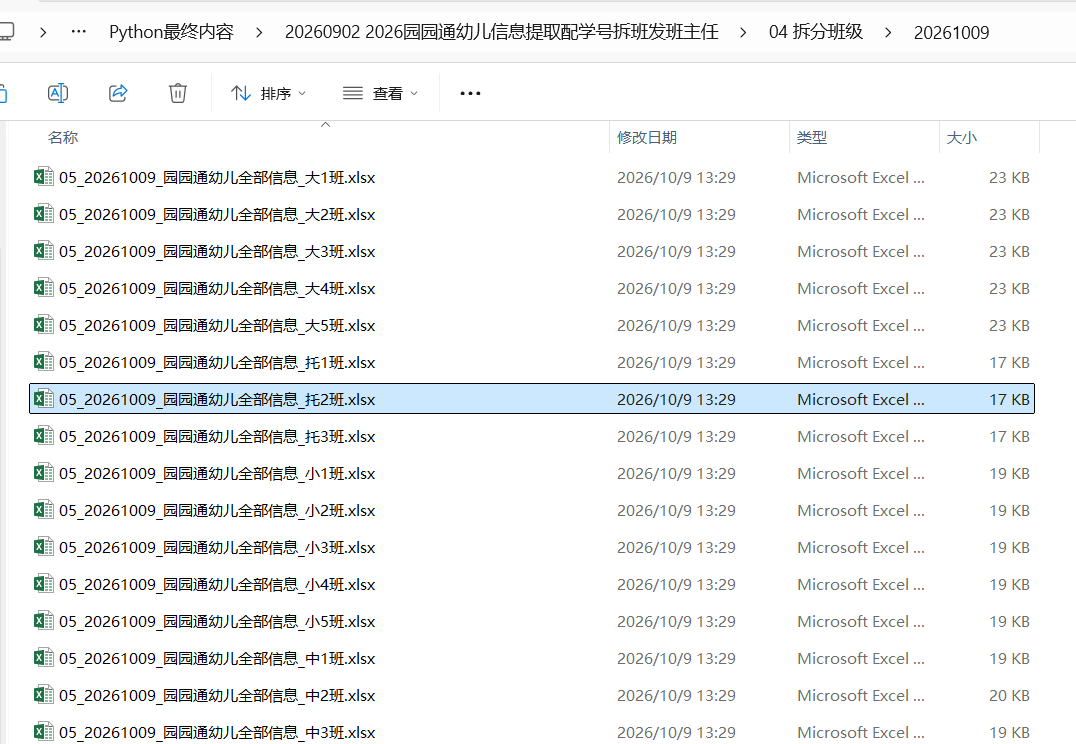
# 按班级拆分
for class_name in df_merged['班级名称'].unique():
    # 筛选当前班级的数据
    class_df = df_merged[df_merged['班级名称'] == class_name]

    # 创建临时排序列用于排序
    class_df = class_df.copy()  # 避免警告
    class_df['学号_排序'] = pd.to_numeric(class_df['学号'], errors='coerce')

    # 对每个班级内的数据按学号排序
    class_df_sorted = class_df.sort_values(by='学号_排序')

    # 删除临时排序列
    class_df_sorted = class_df_sorted.drop('学号_排序', axis=1)

    # 按照目标列顺序重新排列
    class_df_sorted = reorder_columns(class_df_sorted, target_columns)

    # 创建文件名(去除可能存在的非法字符)
    safe_class_name = "".join([c for c in class_name if c not in r'\/:*?"<>|'])
    output_path = os.path.join(output_folder, f'05_{date}_园园通幼儿全部信息_{safe_class_name}.xlsx')

    # 保存为单独的工作簿,并调整列宽
    with pd.ExcelWriter(output_path, engine='openpyxl') as writer:
        sheet_name = f'{class_name}园园通幼儿数据'
        # 工作表名称不能超过31个字符
        if len(sheet_name) > 31:
            sheet_name = sheet_name[:31]

        class_df_sorted.to_excel(writer, sheet_name=sheet_name, index=False)

        # 获取工作表并调整列宽
        worksheet = writer.sheets[sheet_name]

        # 计算每列的最大显示宽度
        for column in worksheet.columns:
            max_width = 0
            column_letter = get_column_letter(column[0].column)

            # 获取列标题和所有单元格的最大显示宽度
            for cell in column:
                try:
                    # 计算单元格内容的显示宽度
                    cell_width = calculate_display_width(cell.value)
                    if cell_width > max_width:
                        max_width = cell_width
                except:
                    pass

            # 设置列宽(根据最长字符的实际显示宽度)
            adjusted_width = max_width + 2  # 添加2个字符的边距
            # 限制最小宽度为8,最大宽度为100
            worksheet.column_dimensions[column_letter].width = min(max(adjusted_width, 8), 100)

        # 设置所有单元格为文本格式
        for row in worksheet.iter_rows():
            for cell in row:
                cell.number_format = '@'  # 设置所有单元格为文本格式

print("处理完成!")
print(f"1. 已生成完整匹配表: 02匹配学号(分园新生).xlsx(已按班级和学号排序,按指定列名顺序排列,所有单元格保持文本格式,根据实际显示宽度计算最适合列宽)")
print(f"2. 已按班级拆分保存到 {output_folder} 文件夹,每个班级内按学号排序,按指定列名顺序排列,所有单元格保持文本格式,根据实际显示宽度计算最适合列宽")
 https://mp.csdn.net/mp_blog/creation/editor/164063926