📌 本文导读|万字长文预警,建议先收藏再细看
"你做了这么多年 Java 后端,现在团队要做 AI Agent,你觉得要补什么?"
这道面试题最近出现频率高得离谱。我面过别人,也被别人面过,发现一个扎心的事实:90% 的人挂在同一个坑------把"转 AI"理解成"学个 Python 调调 API"。
这篇文章,是我这个 13 年 Java 老兵转型 AI Agent 的完整实战复盘。不吹概念,不堆名词,只讲能直接跑的核心代码、面试真正加分的回答,以及生产级 Agent 的落地姿势。
🎯 本文适合谁?
- 3 年以上 Java 后端,想转 AI Agent 方向
- 马上要面试 AI Agent / LLM 应用开发岗位
- 团队要做 AI Agent,但不知道从哪下手
- 不想扔 Java,又想抓住 AI 红利的人
💎 看完你将收获:
- 一张能力迁移地图:哪些 Java 能力能直接带走,哪些必须新学,迁移率一目了然。
- 六块硬骨头:LLM 认知、Prompt 工程、Tool Calling、上下文工程与记忆、RAG、Agent 编排 + MCP。
- Java 生态落地实战:Spring AI 2.0 / LangChain4j 核心代码,零 Python 依赖,无缝集成 Spring Boot。
- 生产级 Agent 架构:可观测、评测、成本治理三板斧,让 Agent 从 Demo 变成能扛流量的系统。
- 16 个技术难点速查表 + 面试加分话术,背下来直接用。
- 30 天快速上手 / 90 天生产级转型路线图。
🧠 核心金句先睹为快:
- 模型负责聪明,框架负责可靠。
- 不是所有需求都要 Agent,能写死流程就别用 Agent。
- Prompt 是门面,上下文是内功。
- 没有 Evals 的 Agent 就是在裸奔。
- LLM 是实习生,Java 工程层是主管。
💬 最后留个问题: 你在做 Agent 落地时,踩过最狠的一个坑是什么?死循环烧钱、记忆串用户,还是模型一本正经编造订单号?评论区聊聊,点赞最高的三个坑,我下篇文章专门写解决方案。
👉 如果觉得有用,点个 "赞" 和 "在看",关注不迷路。后续 RAG 调优实战、多 Agent 编排踩坑记持续更新。
Java 转 AI Agent,到底要补什么?十三年 Java 老兵的转型实战复盘
最近这道面试题出现频率高得离谱:"你做了这么多年 Java 后端,现在团队要做 AI Agent,你觉得要补什么?"
我面过别人,也被别人面过。发现一个扎心的事实:90% 的人挂在同一个坑------把"转 AI"理解成"学个 Python 调调 API"。
这篇文章把我转型路上踩过的坑、面试里真正加分的回答、以及能直接跑的核心代码,完整梳理一遍。适合 3 年以上 Java 后端、想转 AI Agent 方向、或者马上要面试这类岗位的同学。全文有点长,建议先收藏再细看。
一、先破题:不是换语言,是换"脑子"
很多兄弟上来第一句就问:"是不是得把 Java 扔了去学 Python?"
我的答案很干脆:不用扔。Java 转 AI Agent,本质不是转行,是在原有工程底座上叠加一层 AI 能力。
面试开口的前 30 秒决定了这题的生死,我会这样定调:
"过去我写的是确定性系统:输入确定、分支确定、输出确定。Agent 的本质是把一个概率性组件(LLM)嵌进确定性系统里,再用工程手段把它的不确定性关进笼子。所以我要补的不是语言,而是把'确定性流程'改造成'不确定性编排'的那套思维和工具链。"
心里记住一个公式,要补的东西全藏在里面:
text
🤖 Agent = LLM(大脑) + Tools(手脚) + Memory(记忆) + Planning(规划)思维层面的转变,一张表说清楚:
| Java 后端思维 | Agent 思维 |
|---|---|
| 写死流程(if/else) | 让模型理解意图、自主决策 |
| 确定性(编译期定死) | 概率性(必须兜底、容错、重试) |
| CRUD + 接口 | 感知 · 规划 · 行动 · 记忆 · 反思 |
| 输入输出类型安全 | 最不可靠的环节就是"模型输出" |
💡 金句 :Agent 开发本质上还是个软件工程问题,只是"计算单元"从确定性函数换成了不确定性的 LLM 调用------而"给不可靠环节兜底",恰好是 Java 工程师最擅长的。模型负责聪明,框架负责可靠。
二、能力地图:哪些能带走,哪些要新学
先明确一个让人安心的事实:Java 后端的大部分工程能力是可复用的,你的存量能力不是包袱,是护城河。
- 微服务拆分思维 → 多 Agent 拆分
- 中间件经验 → 记忆/向量库选型
- 高并发经验 → 流式 Agent 网关
- 熔断限流重试 → 适配大模型接口的不稳定性
- 链路追踪日志埋点 → 排查 Agent 执行异常
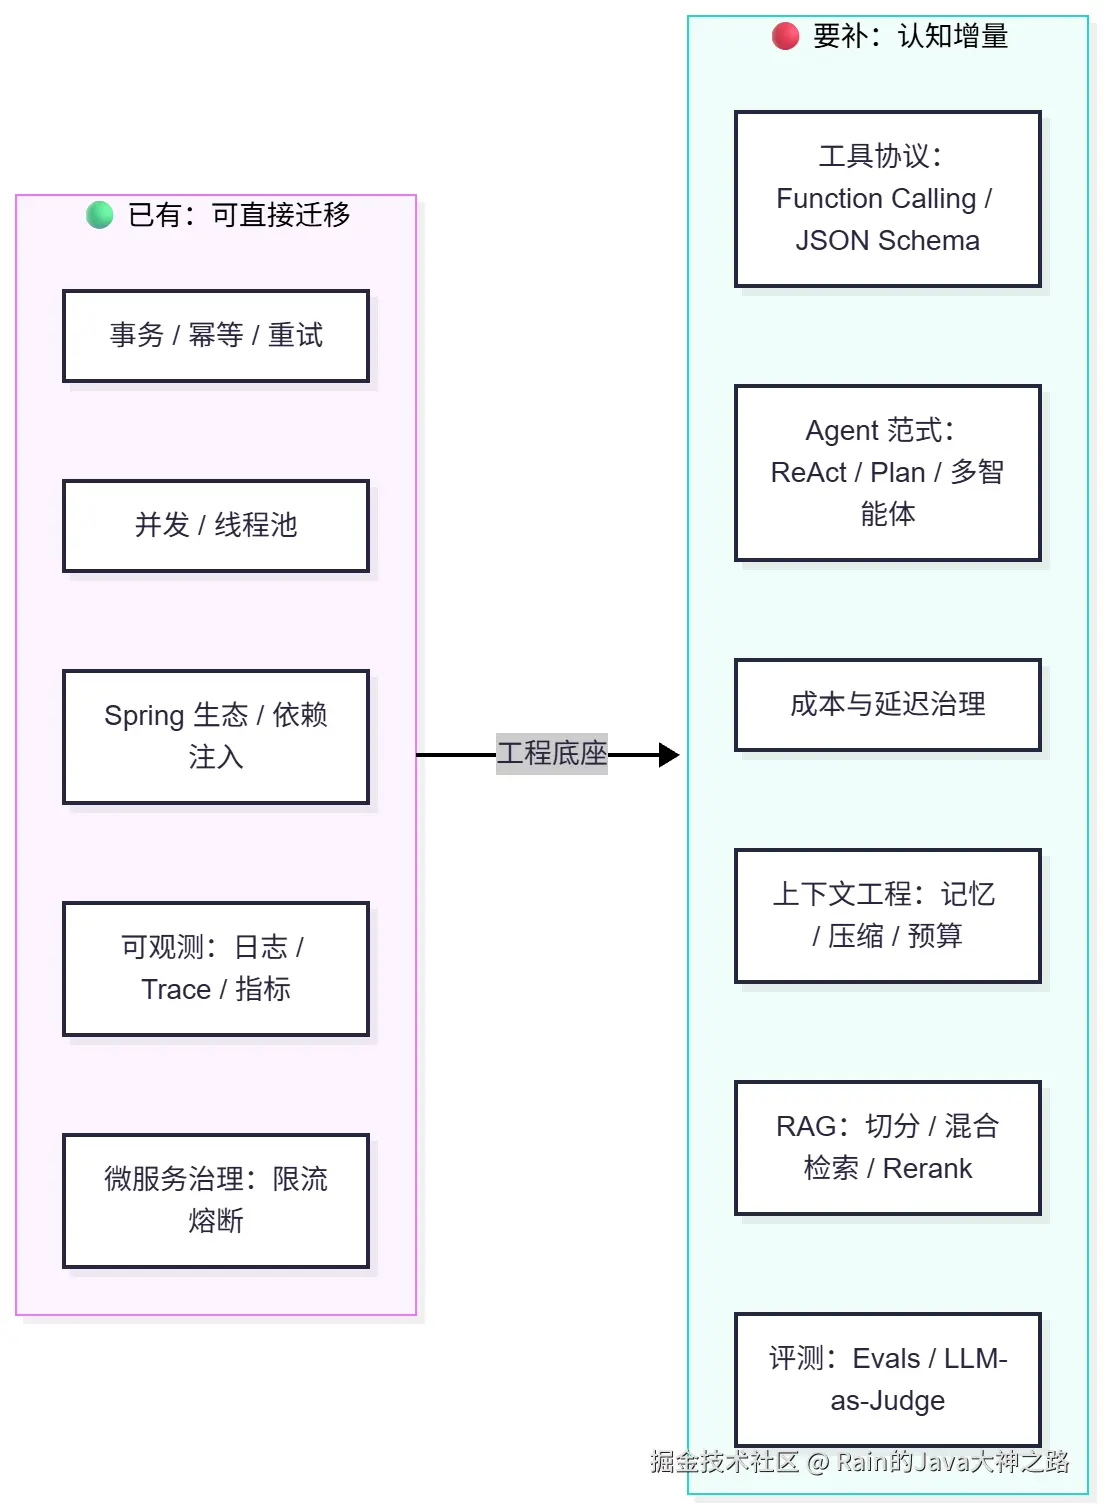
再落到具体维度上,迁移率一目了然:
| 能力维度 | Java 后端现有能力 | AI Agent 需补充能力 | 迁移率 |
|---|---|---|---|
| 核心编程 | Java 基础、Spring 生态、设计模式 | 提示工程、大模型 API、函数调用设计 | 高 |
| 编排逻辑 | if-else / 工作流引擎 |
LLM 动态决策 + 状态机收口 | 60% |
| 外部调用 | Feign / RPC,契约固定 | Tool Call,契约靠 Schema 约束 | 50% |
| 数据存储 | MySQL、Redis、Elasticsearch | 向量数据库、文档分片、嵌入模型 | 30% |
| 状态管理 | DB 事务、Redis | 会话记忆 + Checkpoint 断点续跑 | 70% |
| 异常处理 | 抛异常、重试、降级 | 把错误翻译成模型能自我修复的提示 🆕 | 20% |
| 质量保障 | 单测 + 集成测试 | 评测集 + 回归 CI + LLM-as-Judge 🆕 | 10% |
| 稳定性保障 | QPS / RT / 错误率 | 加上 Token 成本、幻觉率、步数分布 🆕 | 40% |
注意迁移率最低的三块------异常处理、数据层(RAG)、质量保障(评测),这恰恰是"会聊天的 Demo"和"能干活的生产系统"之间的分水岭,也是后面要重点讲的部分。
三、要补的六块硬骨头
我把转型要补的能力拆成六块,每块只讲最关键的点。
3.1 LLM 基础认知:理解"新的运行时"
这一层是 Java 工程师最容易轻敌的。你以前调的是确定性 RPC(入参 → 出参,幂等可重试),现在调的是概率性接口:同样的 Prompt,输出可能不一样。
必须建立的 4 个新心智:
| 传统 Java 心智 | LLM 新心智 |
|---|---|
| 字符串长度可控 | 一切按 Token 计量:计费💰、限流🚦、上下文窗口📦 |
| 输出确定性,单测可断言 | 非确定性输出,断言思维要换成"评测思维" |
| 方法调用即返回 | 调用可能几秒到几十秒,流式 SSE + 异步编排是标配 |
| 入参出参靠接口文档 | 靠 system / user / assistant / tool 消息协议 |
具体要掌握的:Transformer 基本直觉、Token 与上下文窗口、温度系数、嵌入向量、流式输出、结构化输出。不用手写算法,但要懂每个概念对业务的影响。
⚠️ 关键认知:上下文窗口 = Agent 的内存,128K ≠ 无限。会话越长越贵、越慢,还容易出现"迷失中间"(Lost in the Middle)------这是后面"上下文压缩"所有方案的伏笔。
3.2 Prompt 工程:不是聊天,是接口设计
很多 Java 同学一开始把 Prompt 当普通字符串拼,这是新手第一个坑。Prompt 应该像人机接口协议一样设计:角色定义、任务边界、输入约束、输出格式、禁止事项、异常兜底,一样不能少。
实际项目里我推荐三层 Prompt 架构 ,别再 String.format 一把梭了:
java
public class SalesAgentPrompt {

    // 🔒 第一层:系统角色契约(固定不变,锁死边界)
    private static final String SYSTEM_ROLE = """
        你是一个销售数据分析代理,只做以下三件事:
        1. 调用 getSalesData 获取数据;2. 按 metric 聚合;3. 输出 Markdown 表格。
        任何超出范围的问题,回复「暂不支持」。
        """;

    // 🎯 第二层:意图解析(只让它吐结构化参数)
    public static String buildIntent(String rawInput) {
        return """
            用户原始输入: %s
            只提取参数 {startDate, endDate, region, metric},输出纯 JSON。
            """.formatted(rawInput);
    }

    // 📋 第三层:执行规划(给出确定性的执行步骤)
    public static String buildPlan(String params) {
        return """
            根据参数: %s
            Step1: 调用 getSalesData(startDate, endDate, region)
            Step2: 若 metric=sum,对 salesAmount 求和
            Step3: 输出 Markdown 表格,不要加解释
            """.formatted(params);
    }
}
💡 实战心得 :把模型的"自由发挥空间"压到最小,工具调用成功率能从 42% → 91%。别指望模型"理解力强",要指望它"没得选"。对 Java 工程师来说,这就像定义 DTO 和接口契约,是你最熟悉的打法。
3.3 Tool Calling:Agent 的手和脚,也是权限边界
Agent 能不能落地,关键看工具调用。Function Calling 的本质是让模型输出可被程序解析的结构化决策,而不是聊天。
但重点不是"能调",而是"可控地调"。这里有一个必须建立的认知:
java
// 普通方法:
refundService.refund(orderId);

// Agent Tool:
// 权限 + 风控 + 幂等 + 审计 + 规则 + 降级 + refundService.refund()
🔥 一句话讲透:给模型暴露工具,本质上是在暴露业务能力,所以必须像开放 API 一样治理。权限校验、参数校验、幂等控制、超时控制、重试策略、风控确认、审计日志、人工接管,一个都不能省。
在 Java 生态里,把方法暴露给大模型简单到不真实------就是标准 Spring Bean 加个注解:
java
@Service
public class OrderTools {

    @Tool(description = "根据订单号查询订单详情,仅在用户明确询问具体订单时调用")
    public OrderDetail getOrderDetail(
            @ToolParam(description = "订单号,格式如 OW20261010") String orderId) {
        // 调你的 DAO,走事务、走缓存,该有的全有
        return orderDao.findById(orderId);
    }

    @Tool(description = "查询指定城市的实时天气")
    public String getWeather(@ToolParam(description = "城市名,如 北京") String city) {
        return weatherApi.query(city);
    }
}
✨ 技术亮点 :
@Tool/@ToolParam一加,框架自动解析成 JSON Schema 塞给模型;模型返回tool_calls后,框架反射调用你的 Java 方法 再把结果回灌。⚠️ 注意一个高频误区:函数调用是"应用执行",不是模型自己调 API ------所有真实操作都在你的代码里,可控、可审计。这也意味着模型只认 Schema,不认 Java 类型。
想理解框架底层在干什么?其实核心就是"注解扫描 + JSON Schema 生成 + 反射分发",手写一个轻量版也就几十行:
java
@Retention(RetentionPolicy.RUNTIME)
@Target(ElementType.METHOD)
public @interface AgentTool {
    String name();
    String description();
}

public final class ToolSchemaGenerator {

    /** 启动时:把注解方法解析成模型能看懂的 JSON Schema */
    public static ToolDefinition from(Method method) {
        AgentTool anno = method.getAnnotation(AgentTool.class);
        Map<String, Object> props = new LinkedHashMap<>();
        List<String> required = new ArrayList<>();

        for (Parameter p : method.getParameters()) {
            // 简化:实际项目用 Jackson/自定义注解补齐字段描述
            props.put(p.getName(), Map.of("type", mapType(p.getType())));
            required.add(p.getName());
        }
        return new ToolDefinition(anno.name(), anno.description(),
                Map.of("type", "object", "properties", props, "required", required));
    }

    /** 运行时:模型返回 tool_call 后,反射执行真实 Java 业务方法 */
    public static Object invoke(Object bean, String toolName,
                                Map<String, Object> args) throws Exception {
        for (Method m : bean.getClass().getDeclaredMethods()) {
            AgentTool a = m.getAnnotation(AgentTool.class);
            if (a != null && a.name().equals(toolName)) {
                m.setAccessible(true);
                Object[] params = Arrays.stream(m.getParameters())
                        .map(p -> convert(args.get(p.getName()), p.getType()))
                        .toArray();
                return m.invoke(bean, params);
            }
        }
        throw new IllegalArgumentException("未知工具: " + toolName);
    }
}
生产里可以结合 Spring 的 ApplicationContextAware 在启动时扫描所有 @Service 里的 @AgentTool 方法自动注册,业务侧接入只需加一个注解,完全零侵入------你多年积累的业务代码,就是 Agent 的核心资产。
3.4 上下文工程与记忆:最容易挂科的一门
行业里有句话:"Prompt 是门面,上下文是内功。" Prompt 不是写一段话,是在有限 Token 预算内做信息调度。
核心矛盾:上下文越长 → 越贵、越慢、越容易"迷失中间"。解法是分层记忆 + 滚动摘要:
- 短期记忆:滑动窗口(保留近 15~20 轮),快爆窗时"折叠历史"
- 长期记忆:向量库外挂,写入时抽取结构化事实,读取时按需召回
- 工作记忆:当前任务状态、目标置顶,防多轮后漂移
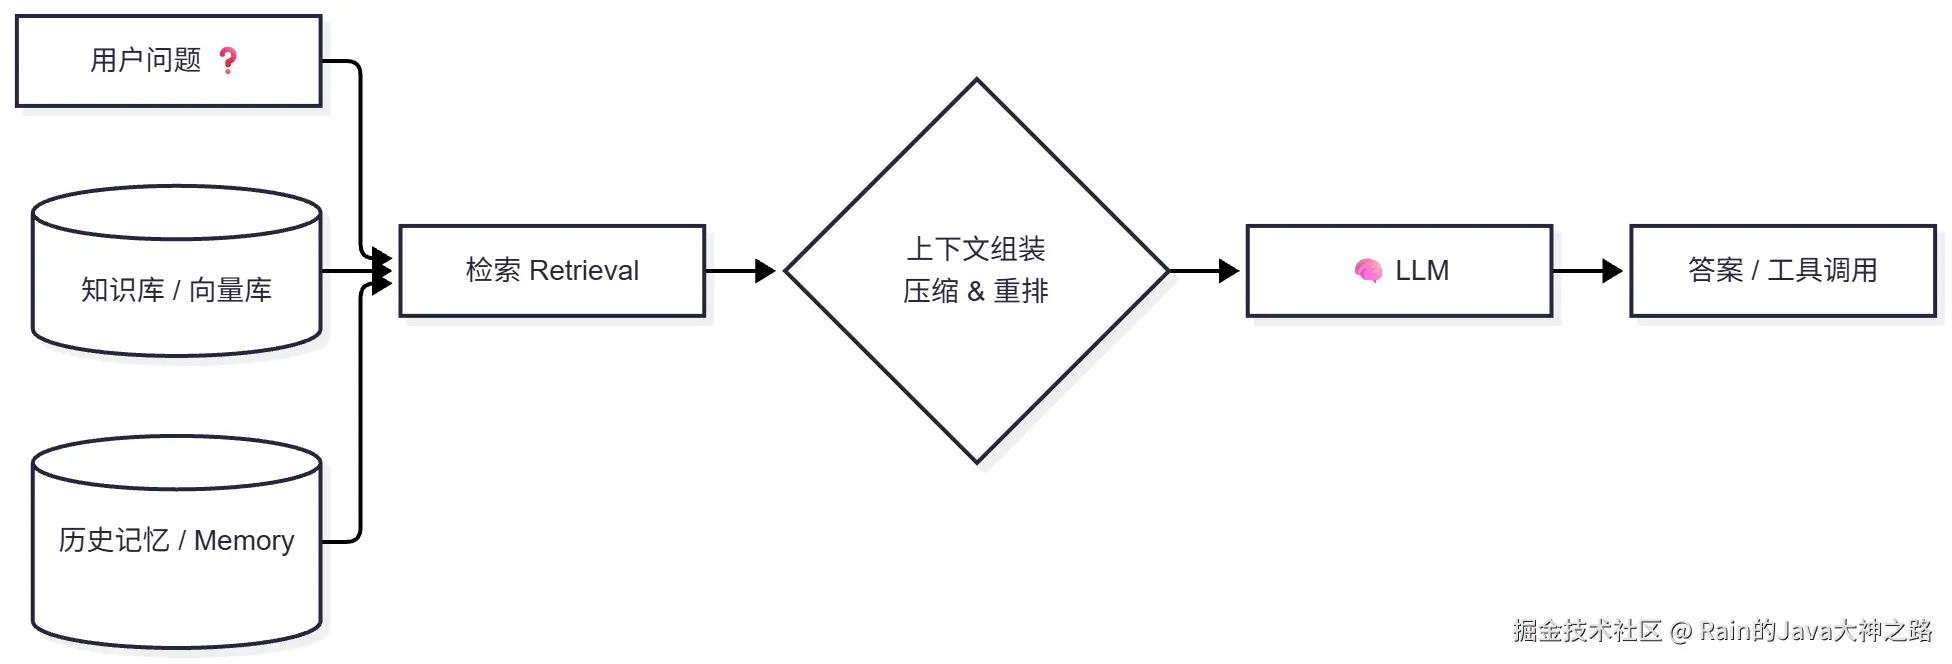
上下文分层渲染的参考实现,直接解决"越聊越笨、越聊越贵":
java
public List<Message> render(AgentState st) {
    return new MessagePack()
        .system(SYSTEM_PROMPT + tools.manifest())   // 常驻层:禁止压缩
        .pinned("当前目标:" + st.goal())             // 🎯 目标置顶,防多轮后漂移
        .summary(st.rollingSummary())                // 🗜️ 旧轨迹滚动摘要
        .recent(st.trajectory().lastK(6))            // 近期 N 步原样保留
        .rag(recall(st.goal(), st.lastStep()))       // 🔍 按需检索,不常驻
        .build()
        .fitBudget(policy.maxInputTokens());         // 📏 超预算从中间层开始裁
}

// 🗜️ 滚动摘要:轨迹超过阈值就压缩,保留"决策"而非"原文"
void compactIfNeeded(AgentState st) {
    if (st.tokenEstimate() > policy.compactThreshold()) {
        String s = model.chat("把以下执行轨迹压缩为<=200字,保留:已完成/失败原因/下一步",
                              st.oldestHalf());
        st.replaceWithSummary(s);   // 摘要替换原文,token 断崖式下降
    }
}
⚠️ 两个我踩过的坑,提前给你排掉:
- 别拿
ThreadLocal存会话! 静态 Map + ThreadLocal 复用直接导致"记忆串用户"。正确姿势是ConcurrentHashMap+ 显式传sessionId/conversationId。- 别把整段闲聊直接向量化当长期记忆 ,噪音会淹没事实。要走双链路:写入时抽取结构化事实存
memory_fact表,读取时混合检索。
3.5 RAG:不是"塞文档",是检索质量工程
用户问"买了 20 天还能退吗?",只靠大模型大概率胡说。RAG 的完整闭环是:改写查询 → 向量召回 → 关键词召回 → 重排 → 上下文裁剪 → 拼进 Prompt → 生成带引用的回答。
RAG 三板斧,必须能手写:
- 切分 Chunking:按语义/标题切,别傻傻按 512 字符硬切 ✂️
- 混合检索:向量相似 + BM25 关键词 + Rerank 重排(效果提升最明显 📈)
- 引用溯源 :答案必须带
source,否则用户不敢信
混合检索 + Rerank 的核心代码,这是 RAG 的质量命门:
java
public List<Chunk> recall(String query, Step step) {
    String q = queryRewriter.rewrite(query, step);       // ✍️ 查询改写/HyDE:口语→检索式
    var vec  = vectorStore.search(embedder.embed(q), 50, filter(step.tenant())); // 语义召回
    var kw   = es.search(q, 50, filter(step.tenant()));                          // 关键词召回
    var fused = RRF.fuse(vec, kw).topN(20);              // 🔀 倒数排名融合,取两家之长
    return reranker.rerank(q, fused).topN(5)             // 🎯 CrossEncoder 精排
                   .filter(c -> c.score() > 0.35)        // 🚫 低分宁缺毋滥,防"硬凑上下文"
                   .peek(c -> st.addCitation(c.docId()));// 📌 强制留引用,答案可溯源
}
📌 面试加分点 :纯向量检索在专业术语、订单号、人名 上很拉胯,混合检索 Hybrid = dense + BM25,用 RRF 融合 是工业界公认的性价比最高的优化。另外两个隐藏坑:召回阶段就要带权限过滤 (不然越权数据先混进上下文了);换 Embedding 模型时向量与模型版本强绑定,要把 embedding 版本号入库,支持灰度双写 + 并行重建,否则全库重建哭都来不及。
还有一句面试时特别好用的话术:"RAG 对我来说不是新东西------它本质是给 LLM 外挂了一个带语义索引的只读数据库,检索、重排、缓存这些优化手段,和我做 Elasticsearch 调优一脉相承。"
3.6 Agent 编排:从"写流程"到"跑循环"
传统 Java 是你编排代码,Agent 是模型编排工具。核心就是 ReAct 循环:思考(Thought)→ 行动(Action)→ 观察(Observation),循环直到得出最终答案。
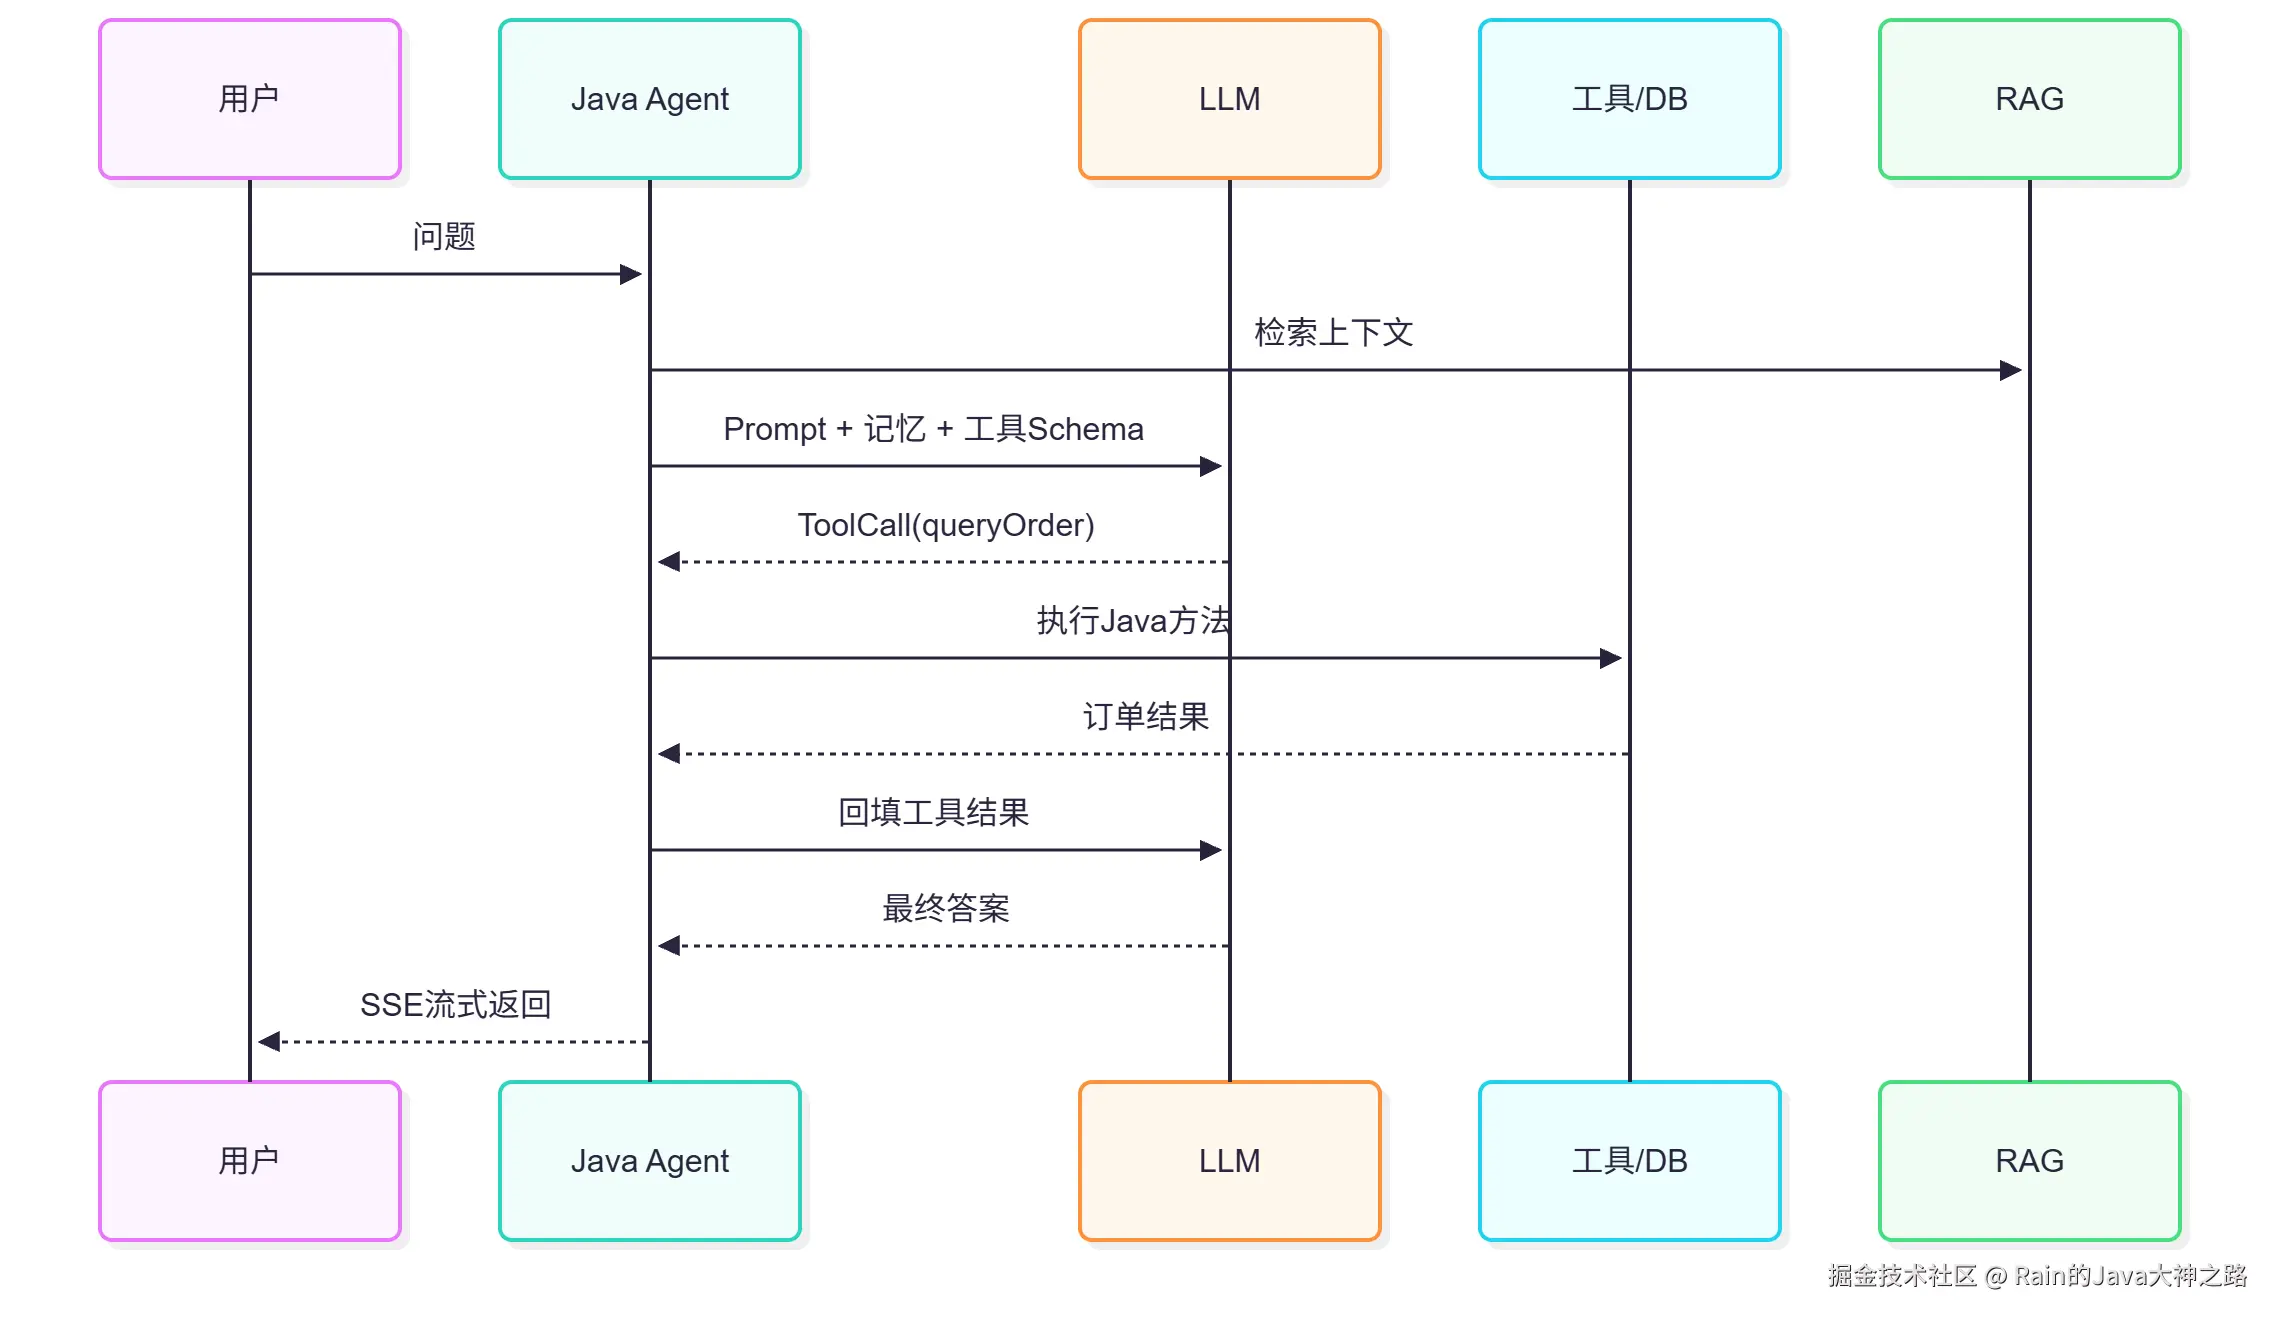
但先记住一个反常识的加分认知:不是所有需求都要 Agent。
| 模式 | 适用场景 | 成本 |
|---|---|---|
| 🔗 Prompt Chaining | 固定流水线(翻译→润色) | 低 |
| 🚦 Routing | 分类分发(意图路由) | 低 |
| 🔁 ReAct(思考→行动→观察) | 开放探索、需要调工具 | 中 |
| 🗓️ Plan-and-Execute | 长任务、多步骤、可并行 | 高 |
| 👥 Supervisor 多智能体 | 复杂域(研究/编码) | 很高 |
能写死流程就别用 Agent。 Workflow 确定、便宜、好测;Agent 灵活、贵、难测。实践中 80% 场景用 Workflow + 局部 Agent 才是正解。判断标准就一条:路径可枚举 → 用 DAG;路径不可枚举 → 才上 Agent,并且给它"围栏"(工具白名单 + 步数上限 + 预算)。
最小可用的 ReAct 循环(面试手撕版):
java
public String agentLoop(String userInput) {
    List<Message> messages = new ArrayList<>(List.of(new UserMessage(userInput)));
    for (int step = 0; step < MAX_ITERATIONS; step++) {        // ① 防死循环熔断
        ChatResponse resp = chatModel.call(new Prompt(messages));
        AssistantMessage output = resp.getResult().getOutput();
        if (!output.hasToolCalls()) {
            return output.getText();                            // ② 无工具调用 = 最终答案
        }
        messages.add(output);                                   // ③ 记住"我要动手"
        for (ToolCall call : output.getToolCalls()) {
            String result = toolExecutor.execute(call);         // ④ 真正执行工具
            messages.add(new ToolResponseMessage(call.id(), result)); // ⑤ 观察结果喂回
        }
    }
    throw new AgentLoopOverflowException("循环超限,触发熔断 🚨");
}
Agent 和 ChatBot 的本质区别,就是这层循环。 而生产级的内核,要再加上五样东西:
java
public final class AgentKernel {
    private final ChatModel      model;   // 模型(可多路由)
    private final ToolRegistry   tools;   // 工具注册表
    private final ContextManager ctx;     // 上下文工程
    private final Checkpointer   store;   // 状态持久化
    private final AgentPolicy    policy;  // 预算/熔断策略

    public AgentResult run(String task, String sessionId) {
        // ✅ 亮点1:状态外置,进程挂了可断点续跑
        AgentState st = store.load(sessionId)
                             .orElseGet(() -> AgentState.newRun(task));

        while (!st.isDone()) {
            policy.guard(st);                    // ✅ 亮点2:步数/Token/时间三重熔断
            ChatRequest req = ChatRequest.builder()
                    .messages(ctx.render(st))    // ✅ 亮点3:分层上下文 + 预算裁剪
                    .tools(tools.specs())        // Function Calling Schema
                    .responseFormat(JsonSchema.of(NextStep.class)) // ✅ 亮点4:结构化解码
                    .build();

            NextStep step = model.chat(req).as(NextStep.class);
            if (step.isFinal()) { st.finish(step.answer()); break; }

            // ✅ 亮点5:工具执行带幂等键 + 超时 + 结果截断(防上下文爆炸)
            ToolResult r = tools.invoke(step.call(), st.runId());
            st.append(step, r.truncate(policy.maxToolOutChars()));
            store.save(st);                      // 每步落盘,可重放
        }
        return AgentResult.of(st);
    }
}
再补两个性能与稳定性的小杀手锏:
java
// 多个独立 tool_call 用 CompletableFuture 并发,IO 密集场景延迟直接砍半 ⚡
List<CompletableFuture<ToolResult>> futures = resp.toolCalls().stream()
.map(tc -> CompletableFuture.supplyAsync(
() -> tools.invoke(tc.name(), tc.args())))
.toList();
// 防死循环:同一 (tool, argsHash) 连续出现 → 判定绕圈,强制收敛或转人工
if (st.recentCalls(3).stream()
.map(c -> c.tool() + ":" + DigestUtils.md5Hex(c.args()))
.distinct().count() == 1) {
st.forceFinish("检测到重复调用,已停止。当前进展:" + st.rollingSummary());
st.escalateToHuman(); // 🧑⚕️ 高危/卡死 → 人在回路(HITL)
}💡 技术亮点小结 :预算双闸门(轮次 + Token)防止 Agent 死循环烧钱;工具并行降延迟;每步状态落盘可断点续跑、可回放。生产环境 Agent 必须是"有限步数、有限预算、有限工具、有限权限、可中断、可人工接管、可回滚"的------LLM 是实习生,Java 工程层是主管。实习生可以提方案,但主管要审核、限权、控预算。
3.7 补一句 2026 年绕不开的:MCP
MCP(Model Context Protocol,模型上下文协议) 是当下 Agent 生态的通用协议。没有它,AI 只会聊天;有了它,AI 能查订单、读文件、调接口、连数据库。
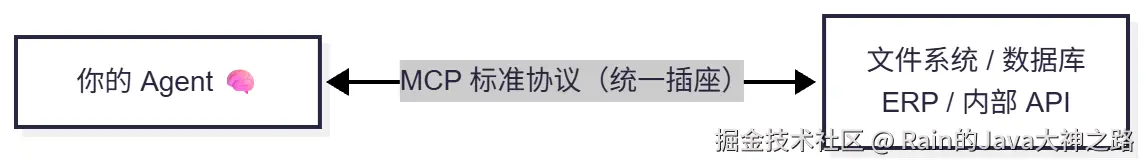
如果说 RAG + Tool Calling + Memory 是 Agent 的"三件套",Prompt 是粘合剂,那 MCP 就是对外扩展能力的"标准插座"------自己造的大脑,直接"长出"别人的能力。
四、Java 生态落地:用熟悉的武器打新仗
完全不用转 Python!Java 生态有完整的 Agent 开发栈。
4.1 框架选型速览(2026 年)
| 框架 | 定位 | 适合场景 | 一句话 |
|---|---|---|---|
| Spring AI 2.0 | Spring 官方,统一抽象层 | 已用 Spring Boot 的企业项目 | "Java 界的 LangChain",接入成本最低 |
| LangChain4j | 社区出身,框架无关 | 想跨 Quarkus / 纯 Java 跑 | "瑞士军刀",模型/向量库支持最广 |
| Spring AI Alibaba | 基于 Spring AI 增强 | 国内 + 阿里云生态、多智能体编排 | "Java 界的 LangGraph",Graph 工作流 |
| AgentScope-Java | 通义实验室,Agentic 优先 | 复杂自主规划 ReAct | 版本迭代最快,"换心脏"型选手 |
💡 一句话选型 :Spring AI 解决"怎么接入 AI",Spring AI Alibaba 解决"怎么让多个 AI 协同"。 新项目建议从 Spring AI 2.x 直接起步(基于 Spring Boot 4.x / Java 17+),别学 1.x 旧 API;存量老项目可先用 1.1.x 过渡。向量库侧,Milvus Java SDK、PGVector、Spring Data Redis Vector、ES 向量检索都有成熟方案;国内大模型(智谱、通义、豆包)也都有官方 Java SDK。
4.2 Spring AI:装配大脑 + 记忆 + 工具
xml
<dependencyManagement>
  <dependencies>
    <dependency>
      <groupId>org.springframework.ai</groupId>
      <artifactId>spring-ai-bom</artifactId>
      <version>2.0.0</version>
      <type>pom</type>
      <scope>import</scope>
    </dependency>
  </dependencies>
</dependencyManagement>
java
@Configuration
public class AgentConfig {

    @Bean
    ChatClient chatClient(ChatClient.Builder builder, OrderTools orderTools) {
        return builder
            .defaultSystem("""
                你是企业客服助理,严格遵守:
                1. 所有事实必须通过调用工具获取,禁止编造;
                2. 工具失败返回标准错误码 TOOL_NOT_FOUND;
                3. 输出纯 Markdown,不含多余解释。
                """)
            .defaultTools(orderTools)                                   // 挂载工具
            .defaultAdvisors(new MessageChatMemoryAdvisor(              // 挂载记忆
                    MessageWindowChatMemory.builder().maxMessages(20).build()))
            .build();
    }
}
再给 Agent 上"保险丝"------防死循环 + 重试 + 强类型输出:
java
// Spring AI 2.0.1 起支持可配置的工具调用次数阈值,超出即抛异常终止
@Bean
ToolCallingAdvisor toolCallingAdvisor() {
    return ToolCallingAdvisor.builder()
            .maxToolCalls(6)                    // 单请求最多 6 次工具调用
            .build();
}

// 业务侧 + Spring Retry:模型抖动、接口超时要能兜底
@Retryable(maxAttempts = 3, backoff = @Backoff(delay = 500, multiplier = 2))
public String safeReason(String prompt) {
    return chatClient.prompt().user(prompt).call().content();
}

// 结构化输出:模型爱自由?用 entity() 逼它遵守 Java 类型
SalesReport report = chatClient.prompt()
        .user(prompt)
        .call()
        .entity(SalesReport.class);          // 直接映射成 Java 实体,类型安全
✨ 技术亮点 :
entity(Class)让模型输出直接落成 Java 对象,编解码层做 JSON Schema 校验 + 容错解析 + 重试,把"概率文本"关进"类型安全"的笼子。
4.3 LangChain4j:声明式 Agent,像写 Service 一样写 Agent
xml
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-spring-boot-starter</artifactId>
    <version>0.32.0</version>
</dependency>
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-open-ai</artifactId>
    <version>0.32.0</version>
</dependency>
java
// 1. 业务工具类:仅需加 @Tool 注解,框架自动解析并注册给大模型
@Component
public class OrderBusinessTools {

    @Tool("根据用户ID查询订单状态,入参为用户ID,返回订单状态描述")
    public String queryOrderStatus(String userId) {
        return "用户" + userId + "的订单状态:已发货,预计明日送达";
    }

    @Tool("计算商品折扣后价格,入参为原价和折扣率(0-1),返回最终价格")
    public double calculateDiscount(double originalPrice, double discountRate) {
        return originalPrice * discountRate;
    }
}

// 2. Agent 接口:声明式定义,无需手写 Prompt 拼接
public interface CustomerServiceAgent extends AiService {

    @SystemMessage("""
            你是电商客服助手,严格遵守规则:
            1. 查询订单必须调用queryOrderStatus工具
            2. 计算价格必须调用calculateDiscount工具
            3. 不知道的问题如实告知,禁止编造
            """)
    String chat(@MemoryId String userId, @UserMessage String userMessage);
}

// 3. 配置类:模型 + 工具 + 记忆,一把装配
@Configuration
public class AgentConfig {

    @Bean
    public CustomerServiceAgent customerServiceAgent(OrderBusinessTools tools,
                                                     ChatMemoryProvider memoryProvider) {
        return AiServices.builder(CustomerServiceAgent.class)
                .chatLanguageModel(OpenAiChatModel.builder()
                        .apiKey("your-api-key")
                        .modelName("gpt-3.5-turbo")
                        .temperature(0.3)
                        .build())
                .tools(tools)                       // 注入业务工具集
                .chatMemoryProvider(memoryProvider) // 对话记忆
                .build();
    }
}

// 4. 一个 REST 接口就是一个 Agent 入口
@RestController
public class ChatController {
    @Autowired
    private CustomerServiceAgent agent;

    @PostMapping("/chat")
    public String chat(@RequestParam String userId, @RequestParam String msg) {
        return agent.chat(userId, msg);
    }
}
✅ 这段代码的精髓 :零 Python 依赖,纯 Java 栈,与现有 Spring Boot 项目无缝集成;注解式工具定义,业务代码零侵入;
AiServices自动管理 ReAct 循环,你不需要手写任何推理流程;@MemoryId天然解决了多用户会话隔离。
4.4 结构化输出的兜底清洗(生产中打磨出来的)
大模型返回的 JSON 经常不规范(带 markdown 代码块、多余文字),直接反序列化必崩。这个工具类解决的就是这个痛点:泛型约束 + 输出清洗 + 异常兜底,一行调用搞定结构化提取:
java
public <T> T chatStructured(String systemPrompt, String userPrompt, Class<T> clazz) {
    // 1. 拼接强制 JSON 输出的系统提示词
    String finalSystemPrompt = String.format(
        "%s\n请严格以JSON格式返回,禁止输出额外文字,参考结构:%s",
        systemPrompt, generateSampleJson(clazz));

    ChatRequest request = new ChatRequest("gpt-4o-mini", List.of(
        new ChatMessage("system", finalSystemPrompt),
        new ChatMessage("user", userPrompt)
    ), 0.2, true);

    // 2. 调用大模型接口
    String content = restClient.post()
        .uri("/v1/chat/completions")
        .header("Authorization", "Bearer " + apiKey)
        .body(request)
        .retrieve()
        .body(ChatResponse.class)
        .getChoices().get(0).getMessage().getContent();

    // 3. 清洗 markdown 代码块,兼容大模型不规范输出(这步非常关键!)
    String cleanJson = content.replaceAll("```json|```", "").trim();
    try {
        return objectMapper.readValue(cleanJson, clazz);
    } catch (JsonProcessingException e) {
        log.error("大模型输出格式异常, content: {}", content, e);
        throw new BizException("大模型输出格式校验失败");
    }
}
用起来就是一行代码完成"自然语言 → 结构化对象":
java
OrderInfo info = llmService.chatStructured(
    "提取用户消息中的订单信息",
    "我上周买的订单 12345 怎么还没到?",
    OrderInfo.class
);
五、整体架构:一个可上线的 Java Agent 系统长这样
把上面的模块串起来,用一个真实场景收口------电商售后退款 Agent。
用户说"我昨天买的鞋不想要了,帮我退款"。传统 CRUD 思路是"点按钮 → 校验订单 → 调退款接口";Agent 思路是"理解意图 → 查询订单 → 判断售后政策 → 调用退款工具 → 生成回复 → 安全审计"。区别在哪?用户入口从固定按钮变成了自然语言,系统需要具备理解、规划、调用工具、兜底的能力。
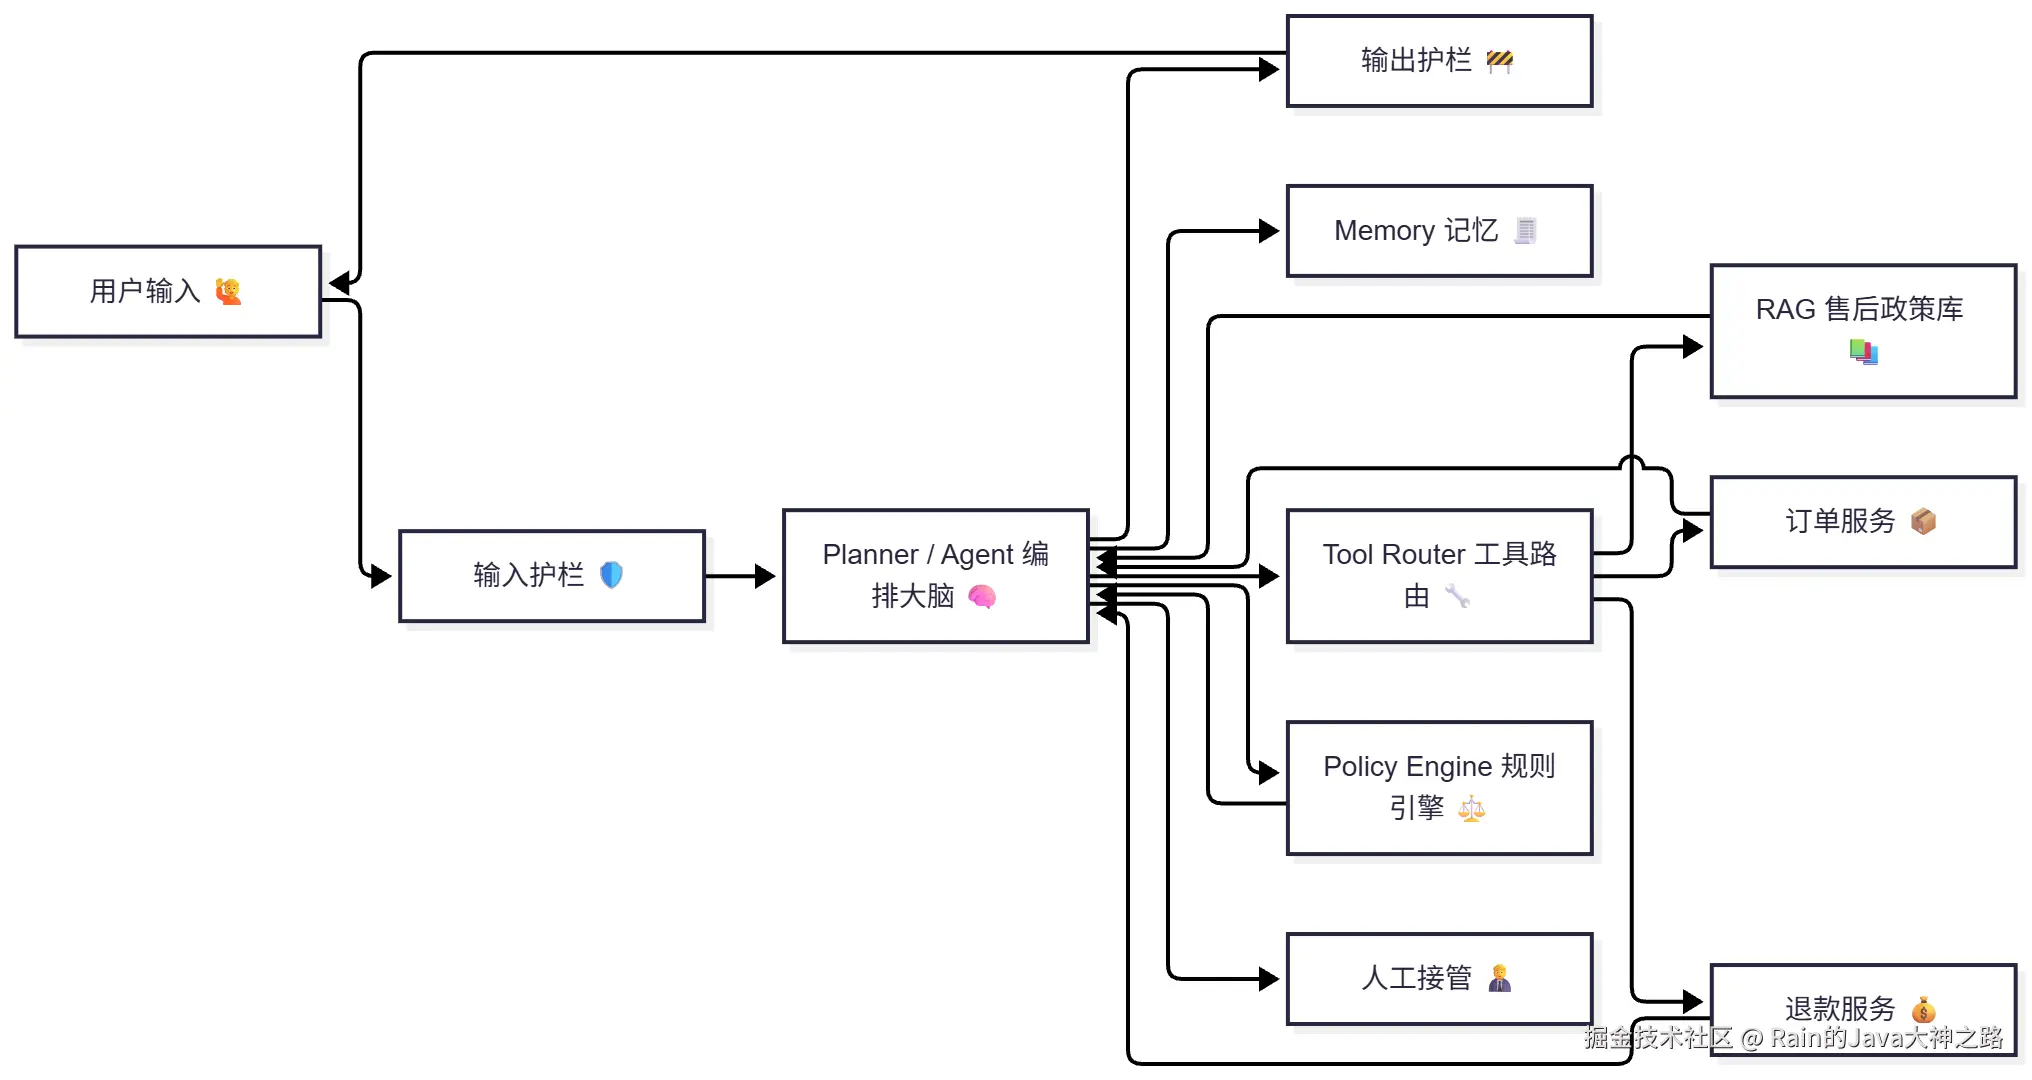
关键点一句话:LLM 只负责"理解和规划",真正危险的业务动作必须由 Java 工程层控制。 图里的订单服务、退款服务依然是你最擅长的高并发 Java 模块,Agent 只是给它们加了一个"会思考的网关"。
售后工具的定义里,工程味全在细节中:
java
@Component
public class AfterSaleTools {

    @Tool(description = "根据订单号查询订单状态、支付时间、是否可退款")
    public OrderInfo queryOrder(
        @P("订单号,必须来自系统,不允许编造") String orderId
    ) {
        return orderService.getByOrderId(orderId);
    }

    @Tool(description = "发起售后退款,只允许用户本人、已支付、30天内且非虚拟商品订单")
    public RefundResult refund(
        @P("订单号") String orderId,
        @P("退款原因") String reason
    ) {
        // 1. 规则引擎先拦截
        refundPolicy.check(orderId, reason);
        // 2. 幂等控制,防止模型重复触发
        String idempotentKey = "refund:" + orderId;
        // 3. 真正调用退款服务
        return refundService.refund(orderId, reason, idempotentKey);
    }
}再看工具执行器------这是我认为面试里最加分的一段代码,面试官听到这个,基本就知道你不是只会 Demo:
java
@Component
public class SafeToolExecutor {

    private final ToolRegistry registry;
    private final AuthChecker authz;
    private final RiskEngine risk;
    private final CircuitBreaker breaker;
    private final AuditLogger audit;

    public ToolResult execute(ToolCall call, String userId) {
        // 1. 权限校验:不是所有用户都能调退款
        if (!authz.can(userId, call.name())) {
            return ToolResult.deny("当前用户无权执行该操作");
        }
        // 2. 风控确认:大额退款、敏感操作需要二次确认
        if (risk.needConfirm(call)) {
            return ToolResult.needConfirm(call);
        }
        // 3. 幂等键 + 熔断 + 超时 + 重试 + 降级 + 审计
        String key = "tool:" + call.runId() + ":" + call.id();
        return idemCache.get(key).orElseGet(() -> {
            try {
                var out = breaker.execute(() ->
                    CompletableFuture.supplyAsync(() -> registry.invoke(call), pool)
                                     .get(call.timeoutMs(), MILLISECONDS));
                audit.log(userId, call, out);
                return idemCache.put(key, ToolResult.ok(out));
            } catch (TimeoutException e) {
                // ✅ 灵魂一笔:错误不抛给上层,转成"模型能自我修复"的提示
                return ToolResult.err("TOOL_TIMEOUT",
                        "工具执行超时,请缩小查询范围(如缩短时间区间)后重试,不要重复相同参数。");
            } catch (BizException e) {
                return ToolResult.err(e.code(), e.getUserFriendlyMsg());
            }
        });
    }
}
🔥 这段是面试官最爱追的点 :Agent 的错误处理不是
throw,而是给模型一条能自救的路。权限控制、风控确认、熔断降级、超时重试、幂等键、审计日志------这就是"把不确定的 LLM 包在确定的工程系统里"。
主循环也不能是 while(true) 裸奔,生产级写法长这样:
java
public AgentResponse run(String userInput, Session session) {
    AgentState state = stateBuilder.build(session, userInput);

    for (int step = 0; step < MAX_STEP; step++) {
        // 1. 让 LLM 决策下一步
        AgentDecision decision = planner.plan(state);

        // 2. 模型认为可以结束 → 输出护栏过滤后返回
        if (decision.finished()) {
            String safeAnswer = outputGuard.check(decision.finalAnswer(), state);
            return AgentResponse.success(safeAnswer);
        }

        // 3. 安全执行工具(走上面的 SafeToolExecutor)
        ToolResult result = safeExecutor.execute(decision.toolCall(), session.userId());

        // 4. 观察结果写回上下文
        state.addObservation(decision.toolCall(), result);

        // 5. 控制 Token,不让上下文爆炸
        state.compressIfTooLong();
    }
    // 6. 超过最大步数,转人工------不能硬答,必须可兜底
    return AgentResponse.escalateToHuman("Agent 推理步数超限,转人工客服");
}
六、生产化三板斧:可观测、评测、成本
大厂最看重、培训班最不教的部分,恰恰是你的主场。
6.1 可观测:Agent 的"失控"比空指针更难排查
传统 Java 排查靠日志 + 链路追踪,但 Agent 的链路是非确定性的------同一个输入可能走出完全不同的调用路径。必须做到:
- Token 消耗统计 :每次调用花了多少钱,暴露
ChatResponseMetadata(限流/耗时/配额) - Prompt 与输出全链路日志:模型到底说了什么
- 工具调用链路追踪:模型为什么选了这个工具
- 全链路 Trace:LLM / Tool / Retrieval 各成一个 Span,TraceId 可反查
推荐方案:接入 Langfuse / LangSmith / OpenTelemetry,开箱即用。
6.2 评测:没有 Evals 的 Agent 就是在裸奔
传统单测断言不了概率输出,要换成"评测思维"。没有 Eval 的 Agent = 没有单测的代码,改一版 Prompt 就全线崩。
java
record Case(String query, String expect, List<String> mustCallTools) {}
EvalReport evaluate(List<Case> cases) {
return cases.parallelStream().map(c -> {
Trajectory t = agent.run(c.query()); // 跑轨迹
return new EvalReport(
judge.score(c.expect, t.answer()), // 🧑⚖️ LLM-as-Judge 打分
toolAccuracy(c.mustCallTools, t.calls()), // 🔧 工具调用准确率
t.steps(), // 📏 步数(成本代理指标)
t.totalTokens(), // 💰 Token 成本
hasCitation(t.answer()) && allCitationsExist(t) // 🕵️ 幻觉检测:引用是否真实存在
);
}).reduce(EvalReport::merge);
}
// 接入 CI:评测分下降 >5% 或成本上升 >20% → 卡住发布 🚦评测三层体系:离线 Eval (准确率/工具调用正确率,自建 ≥100 条含边界 case 的黄金集)→ 在线 A/B (任务完成率、解决率、转人工率、用户重试率)→ 成本与延迟(P95 延迟、单次任务 Token 成本)。三者不达标不上线。
6.3 成本治理:Token 就是钱
把每次会话的 Token 成本当成和 RT 一样的一级指标来监控:
java
// 🌟 Token 预算管理 Advisor ------ 上下文快爆了自动压缩历史
public class TokenBudgetAdvisor implements CallAdvisor {
    @Override
    public ChatClientRequest adviseCall(ChatClientRequest req, CallAdvisorChain chain) {
        int used = tokenCounter.count(req.prompt());
        if (used > BUDGET * 0.8) {                          // 80% 水位告警 💧
            String summary = llm.summarize(olderMessages(req)); // 旧对话 → 摘要
            req = replaceOldWithSummary(req, summary);      // 折叠历史,保留近期
        }
        return chain.nextCall(req);
    }
}

// 🌟 模型分级路由 ------ 成本砍半的关键
public ChatModel route(UserRequest req) {
    if (req.isSimpleIntent())  return cheapModel;  // "你好" → 小模型 💰
    if (req.needDeepReason())  return deepModel;   // 争议退款 → 大模型 🧠
    return defaultModel;
}
再配上语义缓存(相似问题直接返回,不重复调模型)、上下文窗口动态裁剪、按部门/用户设置调用配额,成本基本就管住了。
七、技术难点 & 解决方案速查表(面试必背)
这部分是所有素材里"踩分点"最密集的地方,合并成一张大表,背下来直接用:
| # | 难点 | 典型症状 | 解决方案 |
|---|---|---|---|
| 1 | 幻觉 / 乱调工具 | 编造订单号、参数编错、一本正经胡说八道 | RAG 事实锚定 + 强制工具核对 + JSON Schema 约束解码 + 参数二次校验 + 答案强制引用 + 低分拒答 + 事实性校验器 |
| 2 | 上下文爆炸 / 迷失中间 | 长会话变笨、Token 超限、成本飙升 | 分层上下文(常驻/摘要/近期/检索)+ 滑动窗口 + 滚动摘要 + 工具结果截断 + Token 预算裁剪 |
| 3 | 记忆串用户 | A 用户看到 B 用户的对话 | ConcurrentHashMap + 显式传 sessionId,禁用 ThreadLocal 存会话 |
| 4 | 长期记忆检索不到 | 记住了但想不起来 | 写入时抽取结构化事实存表,读取时混合检索,别把整段闲聊向量化 |
| 5 | 死循环 / 成本失控 | 同一工具反复调用烧钱 | 步数上限 + Token 预算 + 超时熔断 + 重复动作检测 + ToolCallingAdvisor.maxToolCalls + 小模型前置路由 |
| 6 | 输出格式翻车 | 有时返回 JSON 有时自然语言 | entity() 强类型约束 + JSON Schema 校验 + 容错解析 + 重试 + 低温度 |
| 7 | RAG 召回不准 | 答非所问、专有名词失灵 | 语义切分(按标题/父子块)+ 混合检索 dense + BM25 + RRF + Rerank + 元数据/权限过滤 + 查询改写 |
| 8 | 换 Embedding 要全库重建 | 向量与模型版本强绑定 | embedding 版本号入库,灰度双写 + 并行重建 |
| 9 | 长任务不可靠 | 跑了 20 步进程重启全丢 | Checkpoint 事件溯源 + 幂等工具 + 可重放;必要时转异步任务 + HITL |
| 10 | 并发拖垮服务 / 首字慢 | SSE 卡顿、首字 8 秒用户流失 | WebFlux 异步 + SSE 流式先出字 + JDK21 虚拟线程 + 背压 + 并行工具调用 + 语义缓存 |
| 11 | 不可观测、难复现 | 线上出错说不清原因 | 全链路 Trace(Langfuse/OpenTelemetry)+ 输入输出全量落库 + TraceId 反查 |
| 12 | 效果无法量化 | 改了 Prompt 不知变好变坏 | 黄金评测集 + 回归 CI + LLM-as-Judge + A/B + 人工抽检 |
| 13 | Prompt 注入 / 越权 | 网页内容劫持 Agent 删库、诱导调用未授权工具 | 工具白名单 + 最小权限 + 内外网隔离 + 权限在召回/调用阶段前置(不靠 Prompt 自我约束)+ 高危操作人工审批 + 输入输出过滤 + 输出 DLP 脱敏 |
| 14 | 多工具冲突 | 模型选错工具 | Tool Description 优化 + 意图分类 + 工具路由 + 规则兜底 |
| 15 | 事务一致性 | Agent 重复调用退款 | 幂等键 + 状态机 + 业务事务边界 + 审计日志 |
| 16 | 多智能体协调 | 子 Agent 互相打架 | Supervisor 模式 + 共享黑板(Blackboard)+ 单一写入者原则 |
还有三个面试中一定要讲透的关键点,属于"懂和不懂一眼就能看出来"的区别:
- LLM 不是数据库,不能直接信任。 事实类问题必须走工具或 RAG,不能靠模型记忆。用户问订单状态 → LLM 识别意图 → 调订单工具 → 基于真实数据回答。
- Tool 不是普通方法,是权限边界。 模型乱调退款接口怎么办?工具层不信任模型参数:退款前必须查订单、查用户、查风控;高金额必须二次确认;所有调用写审计;超出规则直接转人工。
- Agent 必须有兜底。 答不出来就继续编是不可接受的。转人工、转固定表单、转工单、返回可操作选项------AI Agent 不是要替代所有流程,而是让 80% 常见请求自动化,20% 复杂请求优雅兜底。
八、面试官最爱听的三个加分话术
说出来就和背八股的候选人拉开差距:
① 反共识:"Agent 不是万能的。Anthropic 自己也说------能用 Workflow 解决的别用 Agent。我的判断标准是:路径可枚举 → 用 DAG;路径不可枚举 → 才上 Agent,并且要给它围栏。"
② Java 的不可替代性:"模型层的实验用 Python 没问题,但把 Agent 变成能扛生产流量的系统------并发编排、事务一致性、权限体系、灰度、监控------这些是 JVM 生态最擅长的。我不会去和算法同学比训模型,我要做的是把不确定的模型输出,变成确定可交付的业务结果。"
③ 成本意识:"我会把每次会话的 Token 成本当成和 RT 一样的一级指标来监控,做模型分层路由:简单意图走小模型,复杂推理走大模型,命中语义缓存直接返回。"
如果面试官追问"怎么评估一个 Agent 能不能上线",就答四层:离线 看黄金问答集、工具调用准确率、最终答案合格率;在线 看解决率、转人工率、用户满意度、平均处理时长;安全 看注入拦截率、越权调用率、敏感操作误触发率;成本看单次会话 Token 成本、模型调用次数、工具失败率。
九、学习路线图:先跑通,再叠加
很多人问我该按什么顺序学。核心方法论一句话:别从框架文档第一章读到最后一章! 挑一个你工作里真实烦人的场景(对账校验、日志分析、报文生成)逼自己用 Agent 解决,两周做的"糙玩意",胜过看一个月文档。
30 天快速上手版(适合急需面试或转岗的):
| 阶段 | 学什么 | 产出 |
|---|---|---|
| 第 1 周 | LLM API、Prompt、结构化输出 | 能做一个问答接口 |
| 第 2 周 | Function Calling、Tool Schema | 能调用订单/天气/数据库工具 |
| 第 3 周 | RAG、Embedding、向量库 | 能做企业知识问答 |
| 第 4 周 | Agent 循环、评测、护栏 | 能做完整售后/运维 Agent |
90 天生产级版(适合扎实转型):
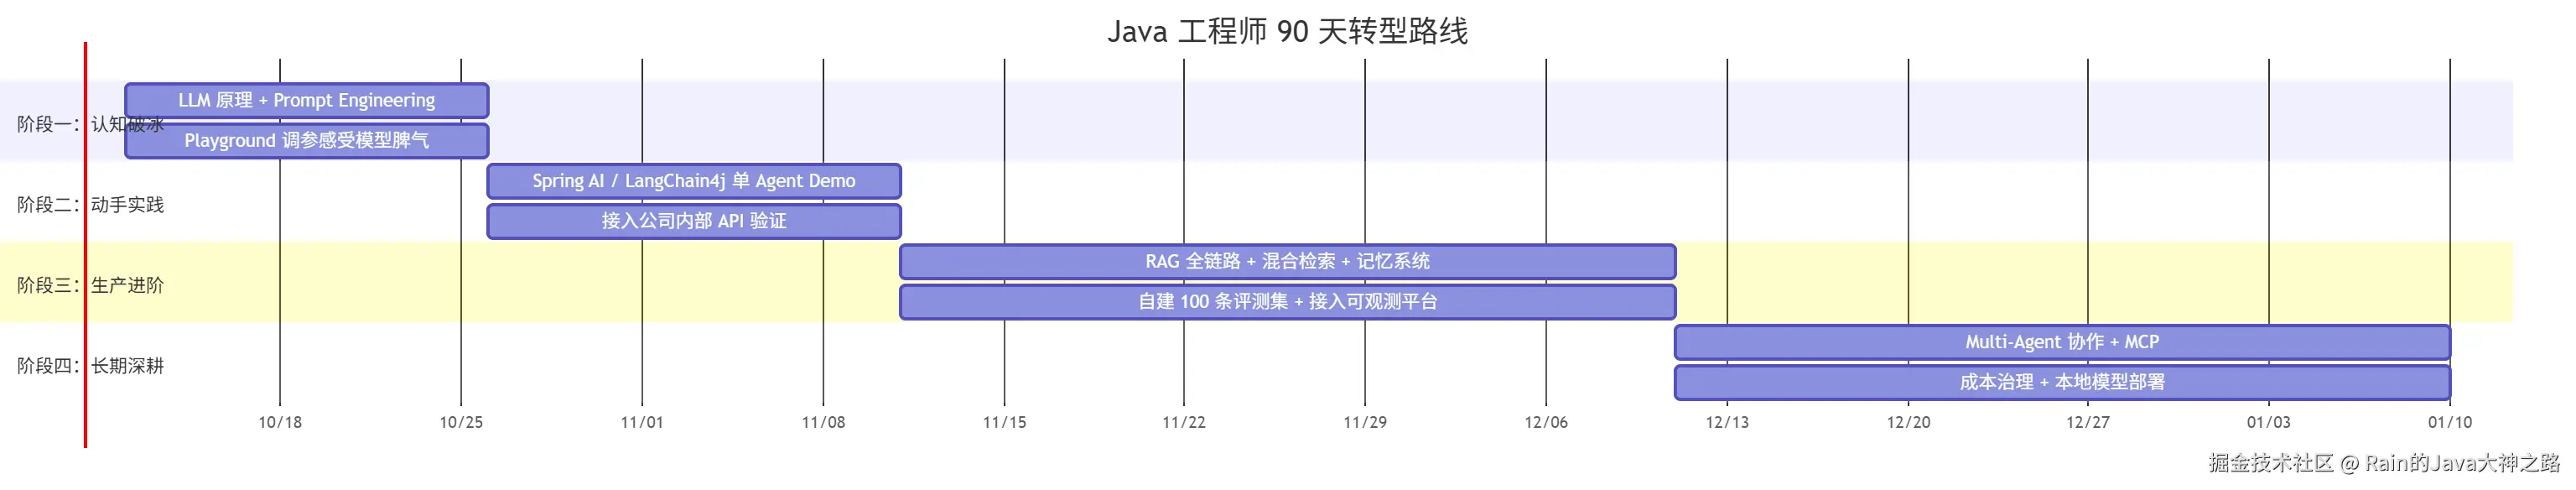
- 第 1-30 天:模型 API / Function Calling / Prompt 工程 / Spring AI 或 LangChain4j → 交付一个能查库、能调接口的 ReAct 小助手
- 第 31-60 天:RAG 全链路(切分 → Embedding → 混合检索 → Rerank → 引用)→ 交付企业知识库问答 + 自建 100 条评测集
- 第 61-90 天:上下文工程 / Checkpoint / 多智能体 / 可观测 / 成本治理 → 交付带 Trace、带熔断、带回归 CI 的生产级 Agent
最快的上手方式就是今天下班前,基于现有业务用 LangChain4j 做一个带工具调用的客服助手 Demo------跑通"单 Agent + 工具 + RAG"这个最小闭环,再谈多 Agent。
写在最后
说了这么多,收个尾。Java 转 AI Agent,补的是上下文工程 + Agent 编排 + 评测可观测 三块短板,守住的是高并发、稳定性、工程化这块长板。
最难的从来不是模型,而是------如何在一个会犯错、会绕圈、会胡说八道的组件外面,用你本来就擅长的工程能力,建一套让它"可控、可观测、可回归、可降级"的壳。
市场上真正稀缺的不是会调模型的人,而是能把模型、工具、数据、权限、风控、审计、评测整合成稳定业务系统的人。把这层补齐,你就是非常稀缺的 Java AI 研发专家。Prompt 谁都会写,能把 Agent 做得又稳、又快、又省钱的,才是大厂要的人。
后续这个系列还会继续更新 RAG 调优实战、多 Agent 编排踩坑记,点个关注不迷路。
最后留个问题给大家:你在做 Agent 落地时,踩过最狠的一个坑是什么?是死循环烧钱、记忆串用户,还是模型一本正经地编造订单号?评论区聊聊,点赞最高的三个坑,我下篇文章专门写解决方案。