💡 一句话总结:这篇论文造了一个「描述保真度」基准(文档好不好,看 AI 能不能只凭它重建代码并跑过原测试),把文档提示词自动优化到 100% 保真,然后诚实地报告:这些高质量文档只在 agent 读不到代码时是救命稻草(测试通过率 8%→71%),在 agent 能读代码的正常场景下毫无提升甚至帮倒忙。做 agent 上下文工程的人值得花 10 分钟读完。
导语:你的 agent 上下文里,是不是也塞了一堆「仓库文档」?
先问一个可能戳到你的问题:你给 coding agent(Claude Code、Cursor 这类 AI 编程助手)配置项目的时候,是不是也往上下文里塞过各种「仓库说明文档」?架构概述、模块说明、API 摘要------反正「多给点背景总没坏处」,对吧?
最近的 agent 生态里这类工具正火:给整个仓库自动生成文档,让 agent「更好地理解代码」。听起来很合理------人都需要读文档,AI 凭什么不用?
但「听起来合理」和「真的有用」之间,隔着一整个实验的距离。今天这篇 arXiv 论文(2609.31587,Hawaii AI 团队)就是来补这个距离的,而且它的结论可能让你省下一大笔上下文预算:当你的 agent 能直接读到代码时,那些文档不仅没用,还可能让它把好好的补丁改成一拍脑门的大重写。
更有意思的是这篇论文的诚实程度:作者本来是造文档工具的,结果大规模实验把自己的假设干碎了------然后他们没藏着掖着,直接把负结果写进了标题("Why It Does Not Transfer")。这种「造出来了,但假设死了」的论文,比十篇「我们又涨了 2 个点」的论文值得读。
想自己动手试?
- 📄 论文:arXiv 2609.31587
- 💻 代码:GitHub · haw-ai-i/roundtrip
这篇论文到底想解决什么问题?
问题分两层,第二层才是要害。
第一层:怎么客观度量一段代码文档的质量? 传统的代码摘要评测靠 BLEU 分数(比对生成文本和参考文本的 n-gram 重合度)或人工打分,这些方法回答不了真正重要的问题------「拿着这份文档,能干活吗?」
第二层:高质量的文档,真的能提升 agent 解决真实问题的能力吗? 这是所有文档生成工具的立身假设,但几乎没人严格验证过。文档基准跑分再漂亮,也不等于 agent 用了它就能多修几个 bug。
作者的拆解很妙:先把第一层做成一个硬核基准,把第二层做成一组大规模实验,然后看第一层的分数能不能「迁移」到第二层------标题里那句 "Does Not Transfer" 说的就是这个。
那第一层的基准怎么造?他们管它叫 roundtrip 基准 (往返基准):把一段代码描述当成「持久化的软件源」,质量 = 另一个 AI 只看这份描述把代码重新写出来之后,能不能通过原仓库的测试。能过测试,说明描述携带了重建这个模块所需的全部信息;过不了,文档写得再天花乱坠也是废纸。
它的思路是什么?
roundtrip 基准的流程是一条闭环,看图:
图说:源代码交给描述生成器写成文档,另一个 AI 只凭文档把代码「盲写」出来,再用原仓库的测试打分------过测试才算文档合格。
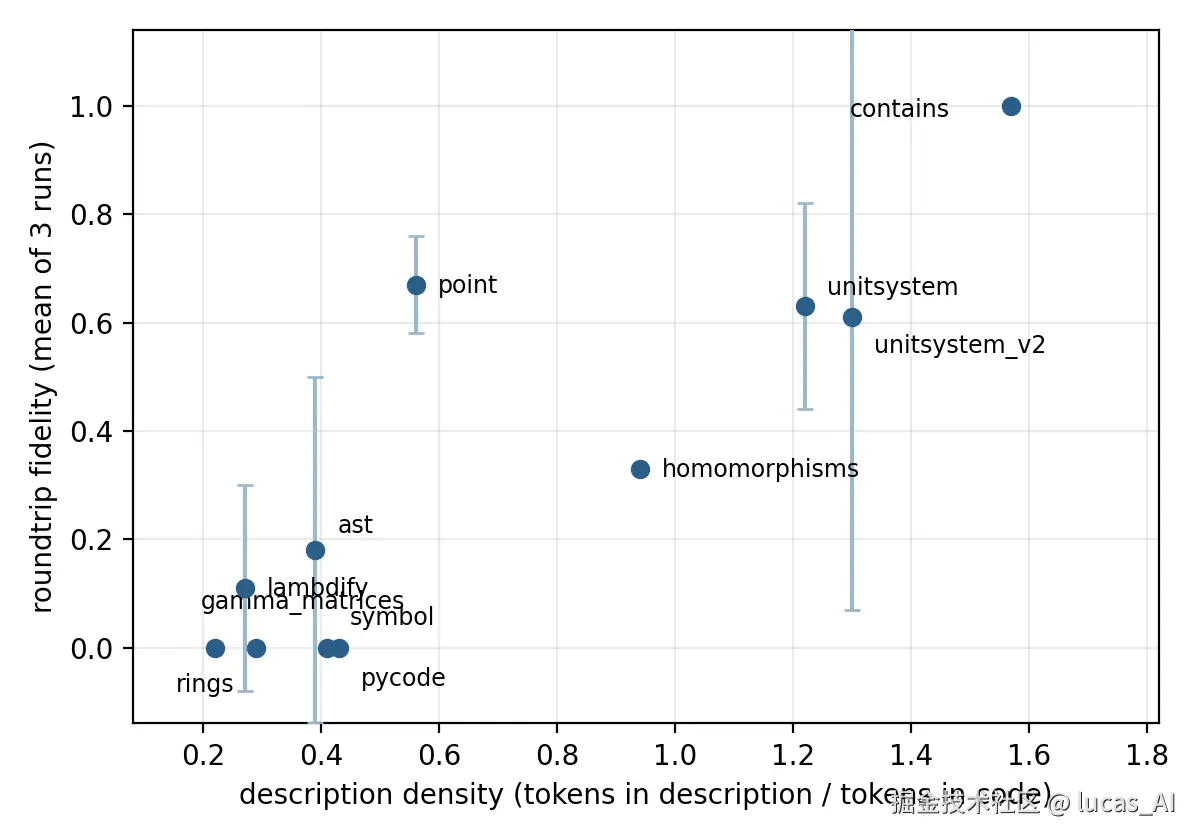
在 11 个 SWE-bench Verified(一个真实 GitHub issue 修复基准里的高质量子集)单文件任务加 3 个手搭代码库上,他们先用一个手写的描述提示词测了基线。结果挺有意思:有的文件能被文档完整重建(保真度 1.0),有的接近全灭(rings 是 0.00)。这 11 个 fixture 里只有 3 个满分。
为什么差距这么大?失败的文件暴露出一组高度一致的「信息漏点」:
- 📦 import 清单:漏写或拼错依赖,再生代码直接跑不起来
- 🔢 常量字面值:模块级常量的精确数值缺失,「大概是个阈值」重建不出来
- ✍️ 签名与默认值:函数参数、默认值有偏差
- ⚠️ 异常路径:什么条件下抛什么异常,文档里没写
也就是说,完整性,而不是长度,决定文档的保真度。那能不能让这个「完整性」自动改进?作者搭了一个优化循环:一个提议器不断修改描述提示词 → 基准打分 → 分数涨了就保留。
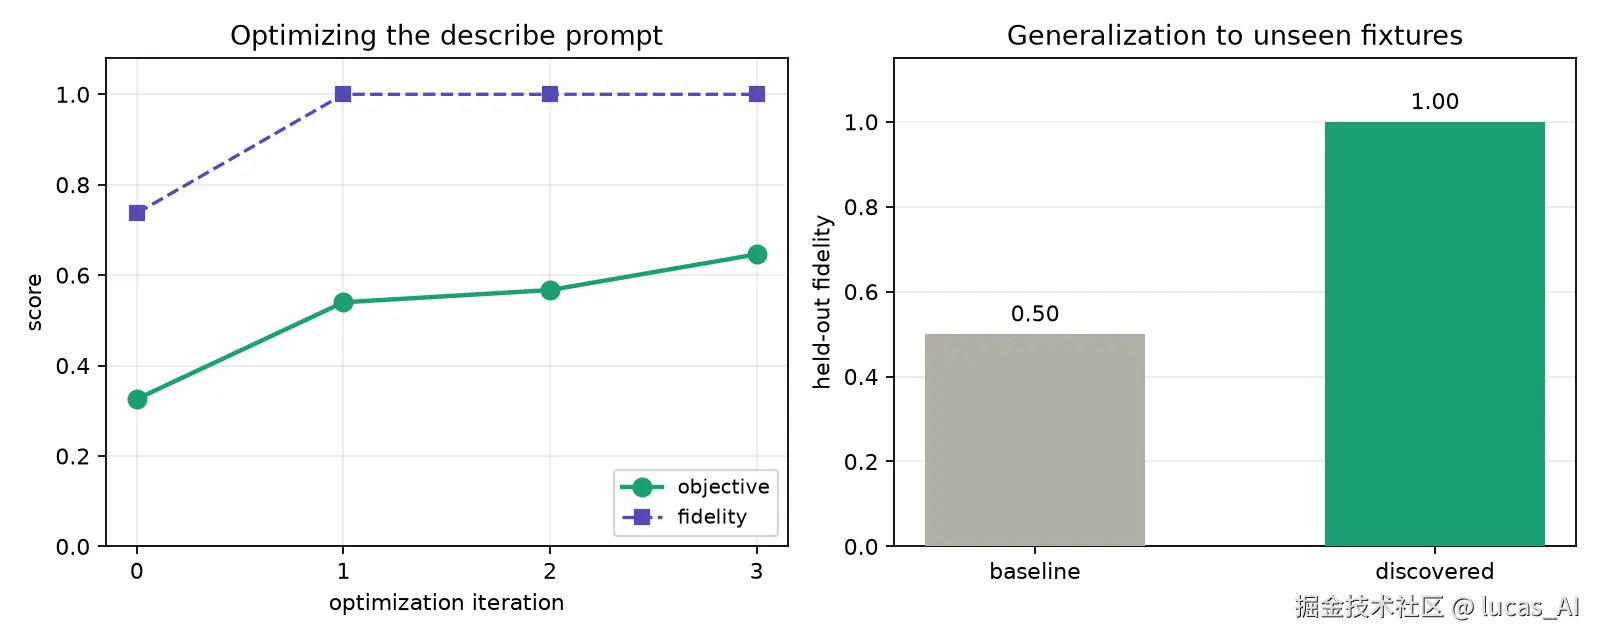
图说:左图是优化过程------保真度先爬到 1.0,然后长度开始下降;右图是在从未参与优化的文件上,保真度从 0.5 提到 1.0。
这里有个漂亮的设计:目标函数是「保真度减去长度惩罚」。它天然形成两阶段动力学------描述不完整时,优化压力全在「补全」;一旦满分,唯一的改进方向只剩「压缩」。先完整,后紧凑,不用人写任何规则。
三个不同温度的独立运行全部收敛到满分,而且优化器自动「重新发现」的修复点和作者手工分析出来的失败模式一一对应------优化器可没看过那份手工分析,这算是基准捕捉到真实信号的强证据。到这一步为止,这是一个非常成功的方法论文。
效果到底怎么样?
好戏从验证开始。作者拿着这些优化出来的文档,去测真正的问题:agent 修真实 bug 时,文档帮不帮忙?
场景一:agent 看不到源码。 11 个任务上,AI 编程助手只拿到 issue 文本,再加(不给文档 / 基线文档 / 优化文档)三种条件之一,要求把整个文件写出来。结果差距大得惊人:只有 issue 时平均测试通过率 0.08 ,加基线文档 0.21 ,加优化文档直接 0.71------11 个任务里 10 个是优化文档最好。而且失败的恰好是 rings 和 lambdify 这两个「保真度黑洞」。
解题能力紧跟着文档保真度走------基准分数在这个场景下是真实能力的预测器。文档在这里就是 agent 的眼睛。
场景二:agent 能读到代码。 也就是 coding agent 的正常工作状态。作者从弱模型到强模型、从自有任务到外部基准 SWE-ContextBench、从小集合到全量,一步一步加码,结论始终没变:
- 弱本地模型(Qwen 3.6)+ 多文件任务:只给 issue 修好 14 个,加全长文档反而只剩 11 个
- 强模型(Gemini 3.1 Pro):只给 issue 修好 9/15,紧凑文档 8,全长文档只有 4------文档越长越差
- 全量基准(58 个任务 × Gemini 3.8 Flash):issue 单干 33 个,检索上下文 30,紧凑文档 29------统计上测不出差异,但排序一致地不利于文档
为什么会这样?论文给出的机制解释很扎心:文档是代码的「复述」,原件已经在上下文里的时候,复述就是干扰项。一个能读到代码的 agent,读了它那份「完整描述」之后,反而更容易放弃最小补丁、动手把整个文件重写一遍------然后引入新 bug。对,就是你想的那个「帮倒忙」。
还剩一个角度:能不能让 agent 靠文档「盲编辑」------根本不加载文件,只按需取几个函数的源码?结果是单文件层面不划算:描述的 token 成本和文件本身差不多,成绩还一样。唯一例外是最大的那个文件。这画出了精确的边界:只有当代码远大于它的描述时,文档才划算------单文件很少见,仓库级是常态。
为什么你要关心?
如果你在做 agent 应用,这篇论文能直接变成你的行动清单:
- 🎯 上下文预算花在 agent 拿不到的信息上:跨文件依赖、历史设计决策、运行时行为、领域约束------这些才是文档的用武之地。别再让工具给 agent 生成「它能读到的代码的复述」,纯烧 token 还添乱。
- 📏 用 roundtrip 思路验收你的文档/摘要产物:不管你生成的是 API 文档还是规格说明,都可以问一句「扔掉原件后,凭这份东西能把活干成吗?」这是比任何人工评分都硬的验收标准。
- 🧪 负结果也有方法论可以抄:这篇论文验证「没用」的方式值得学------先用基准自带的检索上下文做正对照,证明评测仪器灵敏,再宣布「测得出别人声称的效应,却测不出文档的效应」。做评测的朋友可以整套装走。
再往远看一步:作者自己也承认,真正的战场在仓库级------当整个代码库根本装不进上下文窗口,「代码不可读」会从人为设定变成日常现实,那时文档会从冗余复述变成刚需。今天这篇论文帮你划清了边界,明天谁能在边界外侧做出真正有用的仓库级压缩文档,谁就赢。
理性看待
保持冷静的地方也有三处。其一,被测的「文档」形态较窄------只有文件级静态描述和一种检索上下文,架构图、设计文档、API 参考这些形态没覆盖,文件级复述冗余不代表一切文档冗余。其二,SWE-bench 类任务的 issue 本身信息量很足,作者也承认在这类「信息齐全」的任务上文档冗余是「构造出来的」;真实工程里那些模糊 issue 场景,文档仍可能有戏。其三,基准对再生模型敏感------论文里两个开源模型因为幻觉 import 全部得零分,复现时得选够强的模型。代码已开源(haw-ai-i/roundtrip),感兴趣可以自己跑一遍验证。