temperature=0 不能保证消除幻觉,也不能单独保证生产服务的输出完全可复现。 它通常让解码走向贪心选择,但不会替模型核实事实。
先看一个用于说明问题的构造场景:产品说明书只写了工作电压,没有写质保期。用户问「质保是不是三年?」模型给出「是,三年」。即使降到零温后每次都得到这句话,说明书里仍然没有那条依据。
稳定回答和有证据的回答,是两个需要分别验收的结果。
为了看清 temperature 究竟改变了什么,我把本文讨论的问题交给 Qwen2.5-7B,记录了分词、隐藏状态、LM Head 分数、概率和逐步生成轨迹。关键结果直接放在正文里,再沿着机制讨论幻觉、可复现性与生产选值。
本次实测覆盖解码机制及缓存数值对照,没有测业务幻觉率,也没有做生产并发评测。 后面的业务评测是可执行的设计方案,推荐取值是待测试的起点。
1. 先接上链路,temperature 如何参与选定 token
Token 是模型处理和生成的单位,可对应一个词、词片段或字节片段,不一定是一个汉字。Tokenizer 将文字编码成 token ID;embedding 把编号转换成向量,Transformer 再把上下文信息融入表示。
这组表示叫 hidden state(隐藏状态) 。LM Head(语言模型输出头) 将最终表示投影到词表,即模型的 token 集合,给每个候选 token 一个分数;常规下一 token 生成主要使用末位置的最终表示。这些未归一化分数叫 logits,不是已核实的事实置信度。
接下来,解码器从这些分数里选一个 token。采样会先把分数转换成概率,再按概率抽取;贪心则直接选最高分。temperature 和候选过滤参数参与这一步。选出的 token 接回已有内容(前缀),成为下一步的条件,这就是自回归生成。
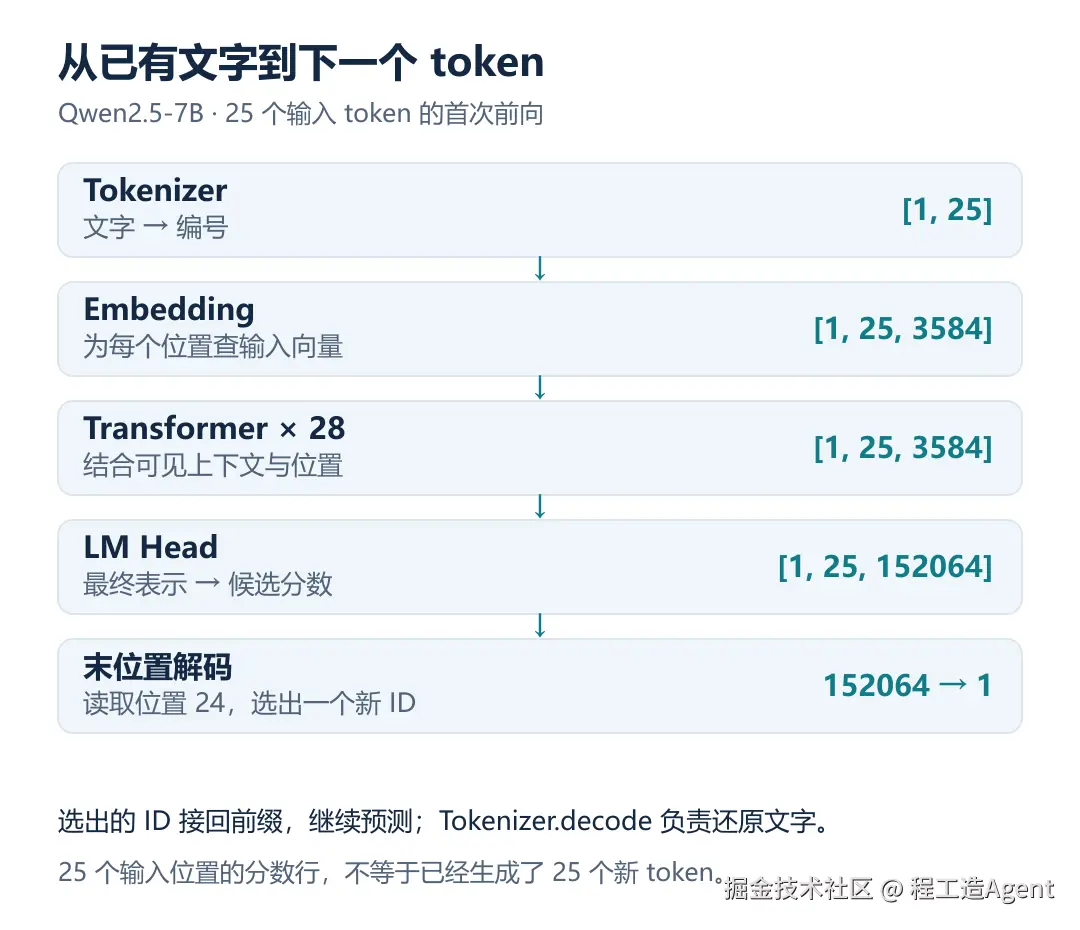
1.1 先看总览,从分数到下一个 token
先跟着本次 Qwen2.5-7B 的真实输入走一遍。读图时只需抓住三个阶段:LM Head 给分数,softmax 算概率,采样决定本轮选谁。 temperature 参与分数处理;选出的 token 接回输入,成为下一轮的上下文。
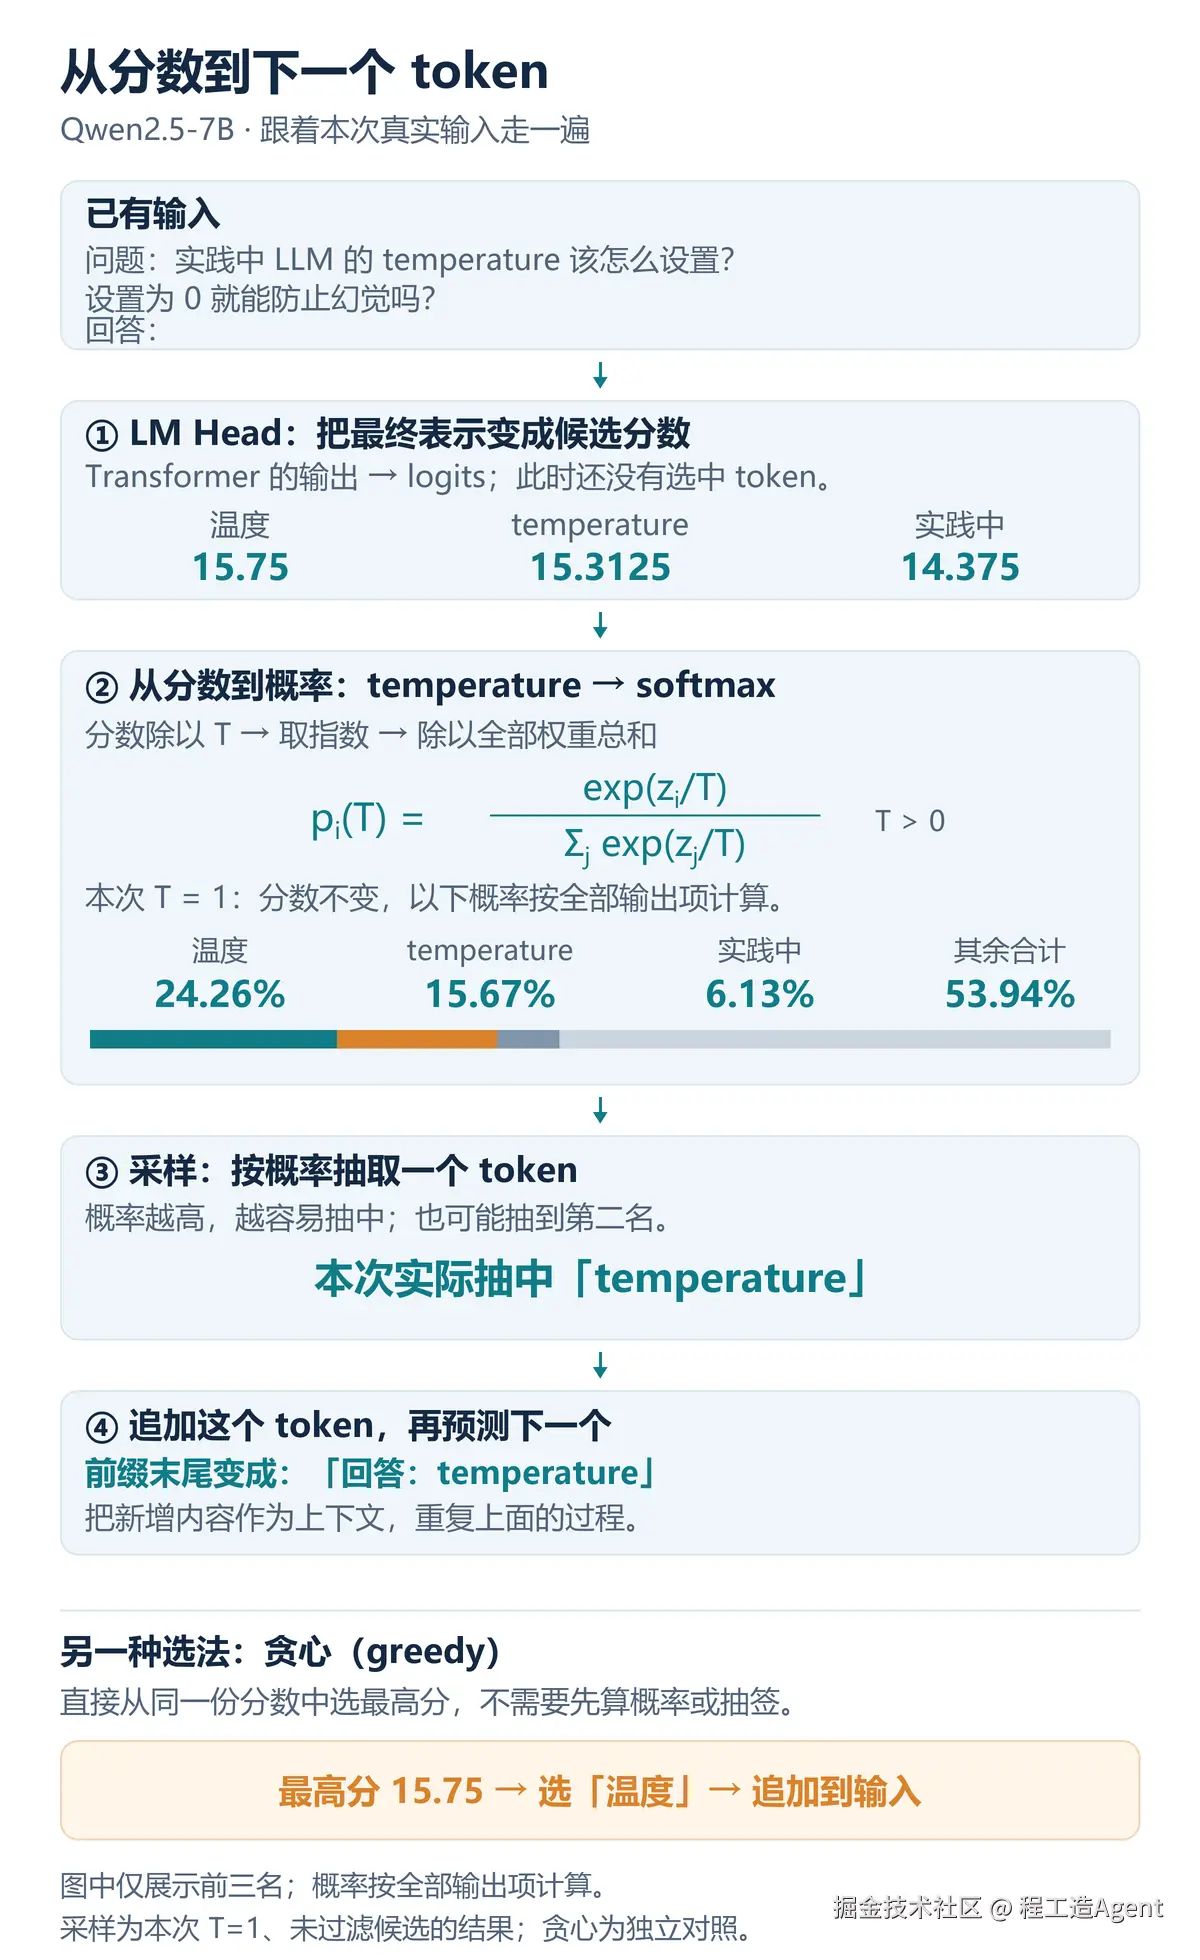
本次采样选中「temperature」,同一份分数的贪心对照选中「温度」。T 表示温度参数,带引号的「temperature」是候选输出的文字。第②步依次展示了温度缩放、softmax 公式与得到的概率; zi 是候选 i 的分数,分母对全部输出项求和。图中的归一化指让概率总和为 1;具体计算、温度对照、零温分支和候选过滤,下面再逐节拆解。
网络内部的 attention 也使用 softmax,但它是在上下文位置之间分配权重;生成端则对词表候选形成概率。常见 API 的 temperature 作用于生成端,通常不会传进每层 attention 改变其缩放。Transformer 原论文、Transformers 生成实现
配套概念篇《跟着 Qwen2.5-7B 走一遍真实推理:理解 Transformer 如何生成下一个 token》逐步展示了这条链路。这里保留必要概念,不要求先读另一篇。
2. temperature 的数学意义,重新分配概率,不重新判断事实
这里用 T 表示 temperature(温度参数) 。忽略其他解码处理,给定固定 logits z,当 T>0 时:
pi(T)=∑jexp(zj/T)exp(zi/T)
式子可以拆成两个动作:先用 exp 把分数变成正权重,再除以全部权重的总和,形成概率。其中,除以总和这一步叫归一化(normalization) ,与训练时施加约束的正则化(regularization) 不同。Transformer 内部的 LayerNorm/RMSNorm 调整的是隐藏表示的数值尺度,也不是这里的输出概率转换。
这说明:低温会让头部更突出,高温会让分布更平。 T=1 表示不对 logits 做 temperature 缩放,不代表输出正确,也不代表预测概率与实际发生频率已经匹配(概率校准)。
2.1 temperature 怎样改变候选被抽中的机会?
总览图第②步用 softmax 将分数转成概率,第③步按这些概率采样。下面的公式描述的就是第②步中,temperature 怎样改变两个候选的概率之比;它由 softmax 公式推得,用于分析概率变化,生成时无需额外执行一次这个对数运算。
logpj(T)pi(T)=Tzi−zj
zi、zj 是两个候选的原始分数, pi(T)、pj(T) 是它们在温度 T 下的概率,log 表示自然对数。 pi(T)/pj(T) 表示候选 i 被抽中的机会是候选 j 的多少倍。固定分数后,T 越小,右边的分数差被放大得越多,领先候选的概率优势就越大。
本次 Qwen 的「温度」得分 15.75,「temperature」得分 15.3125,分数差固定为 0.4375。关闭候选过滤,只调整 T:
| temperature | 「温度」的概率 | 「temperature」的概率 | 前者概率是后者的多少倍 |
|---|---|---|---|
| 1 | 24.26% | 15.67% | 约 1.55 倍 |
| 0.5 | 61.79% | 25.76% | 约 2.40 倍 |
对采样的实际影响是:降温后更容易抽中「温度」,但仍可能抽中「temperature」或其他候选。 表中的概率按全部输出项计算;这个公式只比较其中两项,并不把候选缩减为两项。
只要 T>0,分数差的正负就不会因除以 T 而改变,因此候选排序不变。如果错误续写本来排第一,降温也会强化它的概率优势。temperature 改变了选择倾向,没有增加事实依据,所以不能保证消除幻觉。
2.2 一个真实模型的固定 logits 对照
实测条件:2026 年 10 月 2 日,Qwen2.5-7B 基础模型,RTX 3090,BF16(bfloat16,16 位浮点格式),PyTorch 2.8.0、Transformers 4.57.1,eager attention;未量化、未套聊天模板、未额外添加特殊 token,权重不更新。实际采样在 CPU 上执行。本次选择基础模型,观察原始续写的计算链路。
实际输入是:
text
问题:实践中 LLM 的 temperature 该怎么设置?设置为 0 就能防止幻觉吗?
回答:
这段输入编码成 25 个 token。末位置的 LM Head 输出有 152064 项,前三名为:
| 候选 token | Token ID | 原始 logit |
|---|---|---|
| 温度 | 104273 | 15.75 |
| temperature,无前导空格 | 34558 | 15.3125 |
| 实践中 | 107933 | 14.375 |
固定这份完整 logits,只改变 temperature,关闭候选截断:
| 候选 | T=0.5 | T=1 | T=2 |
|---|---|---|---|
| 「温度」 | 61.79% | 24.26% | 0.89% |
| 「temperature」 | 25.76% | 15.67% | 0.72% |
| 「实践中」 | 3.95% | 6.13% | 0.45% |
| 其余候选合计,约 | 8.50% | 53.94% | 97.94% |
这些是完整 152064 维模型输出上的单步候选概率,不是只对三项归一化,也不是答案的正确率。T 从 1 降到 0.5,「温度」的概率从约 24% 升到约 62%;它本来就排第一,降温没有给它新增事实依据。
把 T=1 的参考概率拆开计算,就能看到 softmax 的分母来自哪里。采用等价的稳定算法,先将全部分数统一减去最大值 15.75,再取 exp:前三项权重约为 [1, 0.645649, 0.252840],其余 152061 项的权重合计约为 2.223076,全部权重总和约为 4.121564 。每项除以这个完整总和,例如「temperature」的概率就是 0.645649 ÷ 4.121564 ≈ 15.67%。统一减去最大值不会改变概率;只拿前三项的权重作分母则会改变计算对象。这里的权重与分母由保存的同一份 BF16 logits 在 FP64 上复算,模型没有重跑。
在 T=0.5、1、2 时,同一份分数的采样熵依次为 1.1286、4.1772、10.3571 nats。熵衡量分布的分散程度,nats 是使用自然对数时的单位;它不衡量模型掌握了多少真实知识。
精度与核验 :FP32、FP64 分别指单精度、双精度浮点计算。概率和熵使用保存的同一份 BF16 logits,在 FP64 上做参考计算,模型没有改用 FP64 重跑。实际采样保留 FP32 路径。原 FP32 的 T=1 概率和约为 1.0000180006,T=2 约为 0.9999979734,两项未通过预设的
2×10⁻⁶求和误差阈值;FP64 参考概率和与 1 的差均小于4×10⁻¹⁴。这一数值差异不影响表中两位百分比的展示。
假如最高分候选通向错误分支,降温也会增加它被选中的机会。这里是条件推论,没有给实测中的三个候选贴上正确/错误标签,更不意味着升温普遍提高正确率。
2.3 temperature=0 怎样落到贪心
z/T 在 T=0 时没有定义。实际系统若支持零温,通常用特殊分支执行贪心选择:
yt=argimaxst,i
argmax 表示取最大分数项。 st 是应用必要的约束、偏置或惩罚后的分数;纯解码情形下可视为 zt。若最大 logits 唯一, T→0+ 的分布集中到该 token;若多个最大值完全相同,数学极限会在并列项间分配概率,工程实现还需要规定如何打破并列。
因此不要把「零温」解释成所有框架都会直接接受 temperature=0。
本次单独执行贪心分支:不做除以 0,直接对原始分数取 argmax,第一步选出「温度」,ID 104273。相同起点的采样设置为 T=1、top_k=0(关闭)、top_p=1、CPU seed=20261002,实际选出第二名「temperature」,ID 34558。
两条路径各继续四步,实际选出的编号为:
| 步骤 | 贪心分支 | T=1 采样分支 |
|---|---|---|
| 1 | 104273:温度 | 34558:temperature |
| 2 | 32665:参数 | 220:空格 |
| 3 | 9909:( | 100751:用于 |
| 4 | 34558:temperature | 100359:控制 |
新增文字分别是:
text
贪心:温度参数(temperature
采样:temperature 用于控制
二者都因 max_new_tokens=4 停止,没有生成 EOS(序列结束标记)。只有第一步共享同一组 logits,随后前缀不同、分数重新计算;这些短片段展示了路径分叉,不能当成完整回答,也不能据此评出幻觉率。
2.4 零温的实现还要看框架
| 框架与版本 | 零温/贪心语义 | 使用时要注意 |
|---|---|---|
| Transformers v4.57.1 | 常规单束贪心使用 do_sample=False, num_beams=1 |
温度分数处理器要求正浮点值;采样时传 0 会报错;关闭采样时 temperature 不参与该采样处理 |
| vLLM v0.22.0 | SamplingParams(temperature=0) 表示贪心 |
该版本在近零温分支会重置候选截断参数;不能当成仍在按原设定随机采样 |
来源:Transformers temperature 处理器、生成循环、vLLM SamplingParams。这是指定版本的实现对照,不是所有兼容 API 的统一契约。
2.5 贪心只看当前一步
逐 token 贪心只优化当前一步,不保证找到模型概率最高的完整序列:起步概率较低的分支,后续可能更集中,整条路径的概率乘积反而更高。即使找到了概率最高的完整序列,也没有自动完成事实校验。局部选择、整段概率与事实正确,是三个不同的判断。
2.6 与 top_p、top_k、seed 的关系
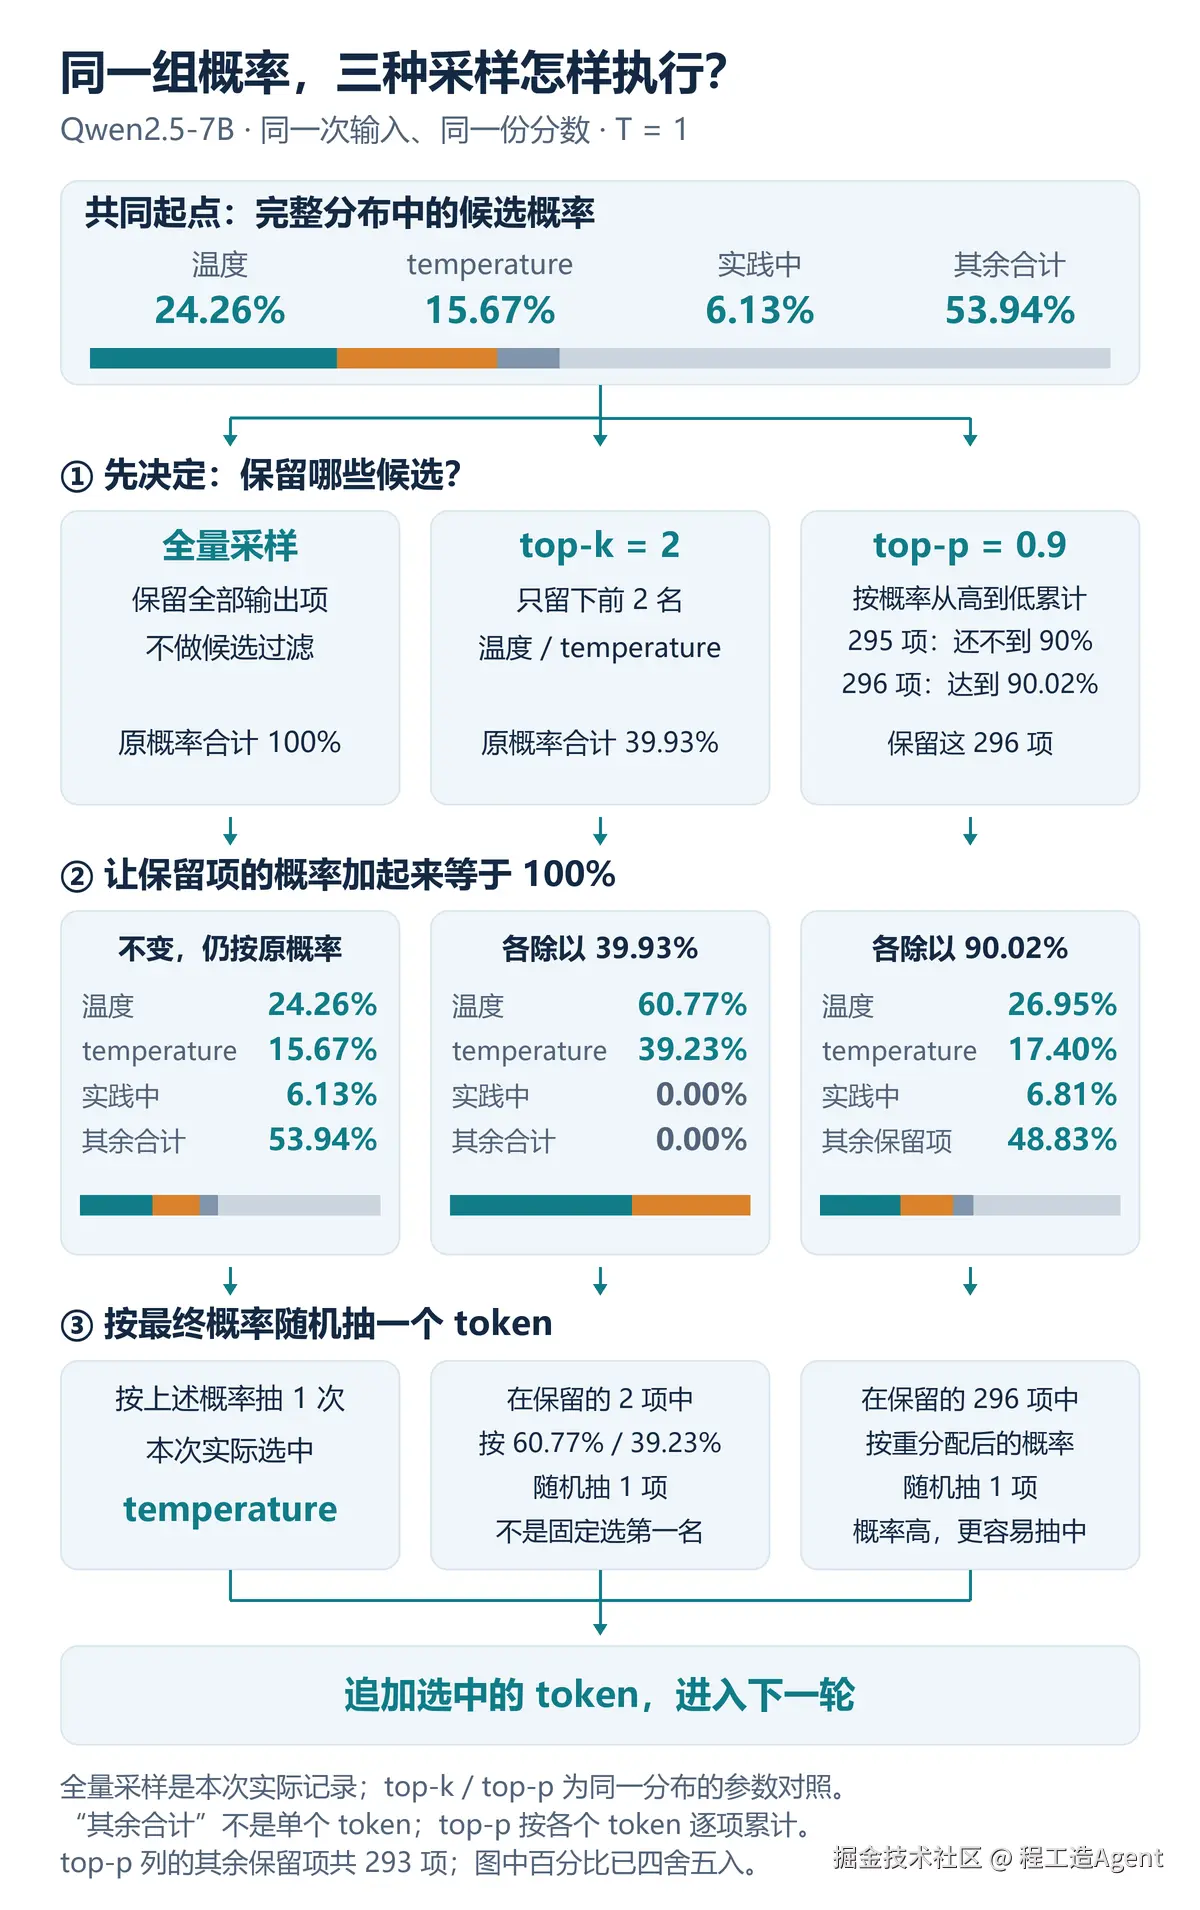
先看同一组真实分数怎样用于三种采样。三列均固定 T=1:左列是本次实际配置(top_k=0、top_p=1);中、右两列分别单独启用 top_k=2 和 top_p=0.9,用于对照。共同过程是:保留候选 → 让剩余概率合计为 100% → 按最终概率随机抽一个 token。概率越高,抽中的机会越大,但不保证每次都选第一名。
| 参数/机制 | 控制什么 | 不提供什么 |
|---|---|---|
| temperature | 正温下改变 token 概率分布的集中程度 | 事实校验 |
| top_k | 保留排名靠前的固定数量候选 | 保证正确候选在集合中 |
| top_p | 按概率累计阈值保留候选集合 | 固定候选个数或事实置信度 |
| seed(随机种子) | 初始化/控制采样随机流,语义依实现 | 自动固定后端数值与服务状态 |
| logit bias/penalty(分数偏置/惩罚) | 修改某些 token 的分数 | 自动修正事实与业务语义 |
| schema(输出结构约定)/语法约束 | 通过解码器执行结构约束时,排除违反格式或语法的续写 | 字段内容真实、业务值合法 |
temperature 和 top_p 会相互影响。对本次同一份真实 logits,先做 temperature 缩放,关闭 top_k,再用 top_p=0.9,实际实现保留的候选数为:
| temperature | FP32 实现保留的候选数 |
|---|---|
| 0.5 | 3 |
| 1.0 | 296 |
| 2.0 | 64571 |
保留集合后还需要重新归一化。本次 T=1、top_k=2 则只保留「温度」与「temperature」,两项原概率合计约为 39.93% ,各自除以这份剩余总概率后,最终概率约为 60.77% 与 39.23% ,与截断前的 24.26% 与 15.67% 不同。所以 top_p=0.9 不等于保留 90% 的词表,也不等于「答案有 90% 的正确率」。另外用 FP64 复核了三个温度下的 top_p 候选集合,保留的编号均与原 FP32 集合完全相同。
从实现上看,Transformers v4.57.1 的 top_k 会把排除项的分数设为负无穷,随后 softmax 同时完成「排除项概率为 0、剩余项重新归一化」。因此,讲解时可以先看原概率、再看过滤后的重新分配,代码不必先后计算两份完整概率。候选过滤实现
Transformers v4.57.1 的相应顺序是 temperature → top_k → top_p;其他引擎要查自己的实现。做参数实验时先固定其他设置,便于判断变化来自哪里;模型有明确的联合配置建议时,另保留完整推荐基线。Transformers 生成源码
同一模型与前缀的理想条件下,temperature 不改变当前步的原始 logits;它若选出不同 token,下一步前缀和后续 logits 就可能改变。因此局部的温度变换仍能影响整条生成路径。
3. 为什么低 temperature 仍会产生幻觉
3.1 先定义我们要防什么
本篇采用两个可操作维度:
-
事实正确性:回答是否符合可核实的现实事实,例如真实作者、日期、产品规格。
-
对证据的忠实性:回答是否得到指定资料支持,是否扭曲或补造了资料未给出的内容。
一段话可能事实上碰巧正确,却没有得到本次资料支持;也可能忠实复述一份过期文档,却与当前事实冲突。RAG(检索增强生成,把检索资料提供给模型后再回答)的评测需要把二者分开。LLM 幻觉综述
3.2 自回归目标不会在解码时自动检查事实
标准语言建模目标让模型学习在上下文条件下预测后续 token。后训练可以改善遵循、拒答与推理行为,但 logits 仍不等于一个外部事实验证器。降温只是对现有分数做变换。
如果模型学到了常见但错误的说法,或者输入把它诱导到某种错误叙述,正确性不会随分布变尖自动提升。
3.3 生产错误要先归因,再调参
| 失败来源 | 示例 | 首要改进方向 |
|---|---|---|
| 知识缺失或过期 | 编造新产品规格 | 接入可核实且及时的资料 |
| 检索遗漏/资料版本错 | 找到上一代说明书 | 改进召回、版本与过滤规则 |
| 虚假前提/冲突上下文 | 用户把不存在的作者当成事实 | 明确检验前提、报告冲突 |
| 无证据仍被迫完整作答 | 资料没有质保期,仍填三年 | 允许缺失字段与拒答,验证来源 |
| 计算与推理失误 | 报价算错、代码不能运行 | 计算器、测试、规则与环境反馈 |
| 采样走向较差分支 | 本可正确却选中另一条续写 | 在控制其他变量后评测 temperature |
这张表是工程归因框架,不是声称每类错误都能用某一措施彻底消除。
3.4 不能把「降低幻觉」写成温度的单调定律
有些任务降温能减少无关扩写,有些任务差异很小,有些推理任务需要路径多样性。temperature 的局部数学性质,不足以推出整个业务的错误率随它单调变化。
Renze 与 Guven 的研究在其多选题设置中,对九个模型与五类提示方法进行了考察,报告 0--1 区间未发现显著性能差异。它支持「不要凭直觉把温度当准确率旋钮」,不支持 「所有任务温度都无影响」,更不能当作开放域幻觉率实验。EMNLP 2024 研究
4. temperature=0 为什么仍可能不完全可复现
理想数学条件下,固定输入、固定分数与固定并列规则,argmax(取最大分数项)是确定的。生产推理服务还要经过硬件计算、批处理和版本路由。
应按三层检查:
-
请求是否真的相同:提示、检索结果、时间、工具返回、历史裁剪、路由模型是否一致?
-
同样请求是否得到相同 logits:硬件、量化、内核、并行归约与批处理条件是否固定?浮点运算顺序变化可能产生微小差异;两个头部候选很接近时,排序可能翻转。
-
同样 logits 是否得到相同选择:是否确实进入贪心?并列如何处理?有采样时随机流是否固定?
本次做了一个更小的数值对照:KV cache 保存此前 attention 的 key/value,让后续计算可以复用。对相同逻辑前缀,分别采用带缓存计算和完整前缀计算,得到:
| 两种路径共享的前缀 | logits 最大绝对差异,约 | 两者的 argmax |
|---|---|---|
| 原输入+「温度」,共 26 个 token | 0.157227 | 都是 32665:「参数」 |
| 原输入+「温度参数」,共 27 个 token | 0.284668 | 都是 9909:「(」 |
两步的 token 选择一致,完整 logits 却均未通过原定 atol=0.125、rtol=0.02 的逐项数值容差;这两个参数分别控制绝对误差和相对误差。这说明「选中 ID 相同」与「分数满足数值一致标准」是两个结果。
这个对照没有测出输出翻转,也不是生产并发实验,不能只凭两步确定所有差异的底层原因。浮点计算不保证批处理与单独计算逐位相同,这一限制也见于 PyTorch 2.8 数值精度说明。
vLLM v0.22.0 官方明确说明默认不保证结果可复现;它提供调度与 batch invariance 等措施,并把相应保证限制在同一硬件与同一版本条件下。不能把某次服务输出变化一概归因于 temperature。vLLM 可复现性文档
batch invariance(使计算结果不依赖批处理条件)是一个有部署前提与性能代价的机制;该版本文档标注为 beta,并列有硬件限制。因此「设一个环境变量就能在任何部署下保证复现」同样是过度承诺。vLLM batch invariance
需要审计时,保存请求、资料快照、原始输出与配置;会修改外部状态的重试还需要幂等键,即标识同一逻辑请求,使重复执行不会重复产生副作用。输出复现不能替代动作幂等。
5. 推理模型的反例,不是所有任务都适合零温
5.1 先看模型自己的使用建议
截至 2026 年 10 月 3 日核对的 DeepSeek-R1 官方使用说明,temperature 建议范围为 0.5--0.7,推荐 0.6 ,理由涉及避免无休止重复或不连贯输出。这是该模型系列的使用建议,不能推广成所有 LLM 的通用最佳值,却足以说明生产配置应从具体模型出发。DeepSeek-R1 使用建议
不同模型可能对参数不开放、只接受固定值,或在不同推理模式下有不同限制。先验证具体模型和接口支持什么,再决定是否显式传 temperature;遗漏参数也可能继承引擎或模型的 generation config(默认生成配置)。
5.2 多次采样可以探索路径,验证负责筛选
self-consistency(采样多条推理路径并聚合答案)在原论文的算术与常识推理基准上改善了表现。这支持有预算时评测多路径策略,而不是说「单次提高温度会让模型更聪明」。Self-Consistency,ICLR 2023
生产中可以探索:生成数个代码候选 → 运行测试 → 选择通过者。数学可用计算器或可执行证明辅助。开放域事实问答则要核验资料,多个模型/多次采样一致仍可能共享同一个错误。
务必区分:
-
pass@1:一次生成的表现。
-
pass@k:k 个候选里是否存在成功结果;报告时写清采样与估计方法。
-
实际选中成功率:系统的选择器最终交给用户的结果是否成功。
找到了一个好候选,和生产系统能选中它,不是一回事。比较多采样方案时要报告总成本与延迟,也应有相同预算的对照。
6. 生产中怎么设,参数配置与证据验证一起设计
6.1 按模型、任务与阶段确定配置
以下是待评测的起始实验点,不是已经证实的最佳值。仅适用于参数被支持的模型;有明确模型建议时,先保留官方完整基线。
| 场景 | 起始对照 | 真正的选择指标 | 必须配合的措施 |
|---|---|---|---|
| 分类、字段抽取 | 贪心/0 与 0.2 | 准确率、缺失识别、格式有效率 | schema、枚举与字段校验 |
| 基于资料的事实问答 | 0、0.2、0.4 | 事实正确、证据支持、正确拒答 | 资料版本、引用核验、缺证据分支 |
| 普通指令模型的代码生成 | 0、0.2、0.6 | 实际测试通过率、回归与成本 | 测试与环境验证 |
| 推理模型 | 官方基线及支持范围内邻近值;R1 可对照 0.5/0.6/0.7 | 端到端成功率、重复退化、预算 | 模型推荐提示、验证器 |
| 查询改写、候选规划 | 官方基线与适量多样性候选 | 检索召回与最终任务完成率 | 再检索、去重与候选评估 |
| 创意文案 | 0.6、0.8、1.0 | 人工质量、多样性、约束遵守 | 涉及事实的内容另行核验 |
| LLM 评审 | 低温基线与重复判定 | 对人工标签一致性、偏差、稳定性 | 明确 rubric(评判标准)、盲评与人审抽检 |
Agent(模型结合工具在多轮中执行任务的系统)的不同阶段,应分别确定配置。 同一个系统可以给候选生成保留多样性,给字段抽取用低温,给事实报告添加证据约束。若服务不支持在一次调用内部按阶段切换,就通过分开的调用与配置实现;不要假设存在通用的内部「推理温度」开关。
选值的顺序可以落实成四步:确认模型与接口支持范围 → 保留模型推荐基线 → 固定资料与其他配置做对照 → 依据业务指标选择并记录版本。指标不达标时,先按失败类型改进资料、提示与验证,再重跑。
配置需要记录:模型标识与可取得的版本、接口、模板版本、temperature 是否显式传入、top_p/top_k/penalty、生成预算、工具与 schema、资料版本,以及请求参数是否被服务接收。能获取的实际生效配置一并保存;拿不到的后端信息明确标成未知。
模型升级、量化变化、模板变更、资料源变更后,都可能需要重跑评测。同样的 0.2 在不同模型上不代表相同的熵或相同的质量。
6.2 防幻觉闭环,回到那份没有质保期的说明书
回到开头的构造场景:说明书里没有质保期。
一个可评测的系统改进可以是:
-
检索正确产品与版本的说明书,保存资料标识。
-
要求回答中的可核实断言对应资料片段;没有支持时输出「资料中未找到质保信息」。
-
若抽取结构化字段,允许
warranty_years=null;服务校验字段类型与来源标识。 -
检查引用是否存在、是否与该断言对应。schema 通过之后仍需检查语义。
-
允许从指定来源补查;找不到时保留未知,必要时升级给人工。
这套设计直接约束的是「是否有证据」。temperature 可作为减少无关扩写的辅助手段,但不能让缺失的质保期凭空出现在文档里。
对 Agent 工具调用也是一样:温度低不保证工具名正确、参数符合业务、对象存在或调用获得授权。可靠性需要工具 schema、运行前校验、权限与执行结果反馈;失败重试时先读取结果,避免盲目重复有副作用的动作。
审查与验证也可能漏错。这些措施的目标是降低风险、使错误可检测,不能把接入 RAG、结构化输出或第二个 LLM 描述成彻底消除幻觉。
7. 把选值变成实验,两个问题,两套对照
7.1 实验 A,temperature 会怎样影响本业务质量?
建议起步方案,尚未执行:先选一个明确支持 temperature 的模型与接口,构建约 100--200 条业务样例。这是发现问题的探索规模,不是罕见错误率的上线证明。
样例至少涵盖:资料充分、资料缺失、资料冲突/过期、用户前提错误、多步推理、字段抽取与工具参数。保留独立测试集,避免在同一批题上调参又宣布最终效果。
控制条件:
-
模型、提示、资料快照、生成预算、penalty、schema 与其他采样参数固定。
-
对允许不截断的常规模型,可先用 top_p=1、关闭 top_k 来隔离 temperature;模型推荐联合配置时另保留推荐基线,不擅自拆散。
-
常规模型探索 0/0.2/0.6/1.0;推理模型按推荐范围设计。
-
各正温设置每题重复数次,使用记录好的不同 seed(若支持),避免只比较一条随机结果;若服务也对零温表现出变化,零温同样重复测试。
-
调度交错各配置,减少时间漂移;盲评时隐藏参数标签。
记录的指标:
| 指标 | 口径 |
|---|---|
| 事实错误率 | 核验错误断言/可核验断言;另报包含错误的回答比例 |
| 无证据断言率 | 无指定证据支持的断言/需要资料支持的断言 |
| 正确拒答率 | 证据不足样例中正确保留未知的比例 |
| 可回答题覆盖率 | 证据充足题中有效回答的比例,防止全拒答刷低错误率 |
| 字段/工具正确率 | 格式与业务语义分别打分,不混为一个成功指标 |
| 端到端成功率 | 按事先定义的业务验收判定 |
| 成本与延迟 | 总 token、调用次数、费用、端到端延迟与必要的尾延迟 |
| 重复与截断 | 重复退化、超预算与不完整回答比例 |
统计时以题目作为配对单位:比较同一道题在各配置下的表现;同题多次采样不能简单当作完全独立样本。报告各项比例、差值、置信区间与失败类型,并写清区间的计算方法。少量测试中零次错误,也不能证明真实错误率为零。
7.2 实验 B,temperature=0 在本部署上是否可复现?
质量实验要冻结输入;复现性实验则专门改变运行条件:
-
固定输入与版本,零温连续运行,比较 token 序列是否完全相同。
-
在可控部署上改变请求并发/batch size(同批处理的请求数),继续比较输出,并记录首次出现差异的位置。
-
若能取得 logits,比较同一前缀下头部候选及间距;前缀已经不同的后续 logits 不适合直接归因。
-
在引擎支持且硬件满足条件时,对照默认模式与确定性/batch invariance 模式,记录性能代价。
托管 API 没有公开的 batch 控制时,可以改变并发观察输出,但不能声称已精确操控内部 batch,也不能仅凭输出差异确定底层原因。
「输出完全相同比例」「结构化字段一致性」「业务答案一致性」应分别报告。措辞变了不一定业务答案变了,输出没变也不代表事实正确。
7.3 最后怎么选
优先满足事实、证据、业务成功与预算约束,再在合格配置之间比较稳定性与多样性。差异没有可靠证据时,保留更简单的配置或模型推荐基线。
发现编造时先看失败原因:资料缺失、版本错、推理错还是采样分支差。不要把「再降一点温度」当成唯一修复动作。
8. 上线前,把四种保证分开
| 常见说法 | 更准确的口径 |
|---|---|
| temperature=0 = 没有幻觉 | 常见实现走贪心,仍可能生成错误或无依据内容 |
| temperature=0 = 生产结果完全一致 | 还依赖输入、数值计算、服务版本与并列规则 |
| temperature 越低 = 模型越聪明 | 采样熵变化不等于知识、推理能力或正确率单调改善 |
| 多次回答一致 = 高事实置信度 | 共同偏差可以导致一致错误,需要外部验证 |
上线清单:
-
确认具体模型/接口支持的 temperature 语义,记录省略参数时的行为。
-
保存完整基线;按模型与阶段区分配置。
-
同时评测错误、无证据断言、正确拒答与可回答题覆盖率。
-
用固定资料评估生成质量,用独立实验评估复现性。
-
schema 与业务语义均有校验,事实断言有可追溯证据。
-
多候选策略有实际选择器,报告实际选中成功率与总预算。
-
记录模型、提示、资料与参数版本;升级后做回归。
-
对有副作用的调用做幂等处理,保存执行结果。
生产系统需要在资料充足时给出可验证的回答,在资料缺失时保留未知,在动作出错时提供反馈与恢复。temperature 是其中一项解码配置;它的合适取值要由具体模型与任务的评测决定,可靠性则需要证据、约束、验证与运行条件共同支撑。
我是程工造Agent,做 Agent 系统与 RAG 的工程师,记录有数据、有验证过程的工程实践。
配套概念篇:跟着 Qwen2.5-7B 走一遍真实推理:理解 Transformer 如何生成下一个 token。
本文部分内容包含 AI 辅助创作