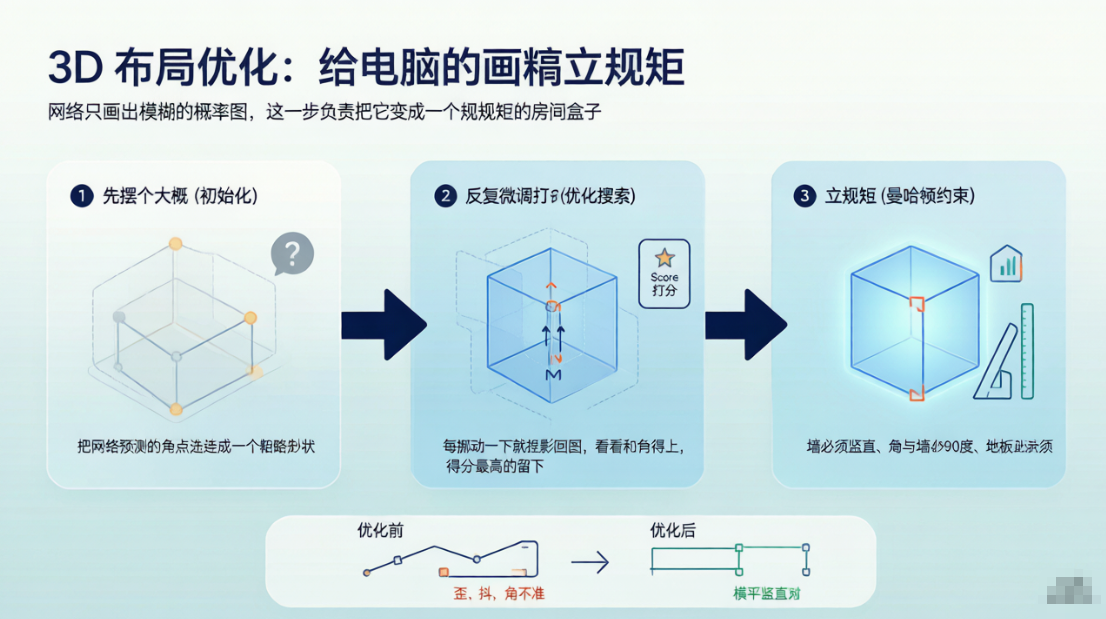
一句话概括:网络画的线是抖的、角是歪的,这一步就是掏出尺子和三角板,把它描成一个规规矩矩的房间盒子。
第 0 课:为什么非得有这一步?
先看看网络交出来的东西长什么样。
LayoutNet 的网络最终输出两张概率图:
- 边界图 mE:每个格子一个 0~1 的数,"这里有多像墙缝"
- 角点图 mC:每个格子一个 0~1 的数,"这里有多像转角"
问题来了------这是"概率图",不是"线条"。它有三个毛病:
| 毛病 | 具体表现 |
|---|---|
| 模糊 | 线有好几个像素宽,没有清晰的"中心线" |
| 抖动 | 该是一条直线的地方,歪歪扭扭 |
| 不守规矩 | 角点未必是 90°,墙未必竖直,地板未必水平 |
而且最关键的是:网络给的是 2D 的概率图,我们要的是 3D 的房间盒子。这两者之间还隔着一层。
所以必须有这一步:从模糊的 2D 概率图,反推出一个干净、规整、符合几何常识的 3D 房间。
打个比方:网络画的是一张铅笔草稿 (抖、糊、有点歪),这一步就是拿尺子和三角板描一遍正式图。
第 1 课:房间的"六个数字"
要描述一个长方体的房间,需要几个数?答案是 6 个。
论文是这么参数化的(假设地面已经对齐到 x--z 平面):
| 参数 | 含义 | 生活说法 |
|---|---|---|
| sw | width | 房间多宽 |
| sl | length | 房间多长 |
| sh | height | 房间多高 |
| tx, tz | translation | 相机在房间的哪个位置 |
| rθ | rotation | 房间相对相机转了多少度 |
写成一行就是:d = {s_w, s_l, s_h, t_x, t_z, r_θ}
这 6 个数字一旦确定,整个房间盒子就完全确定了------可以算出它的每一面墙在哪、天花板多高,也能重新投影回图像上,看看画出来的线落在哪儿。
最后这一点特别重要,是整个优化的核心:能投影回图上,才能和网络画的图做比对。
第 2 课:第一步------先摆个大概(初始化)
优化不能从"零"开始瞎猜,得先有个差不多的起点,不然搜索空间太大。
怎么摆?在俯视图里摆
想象你从天花板往下看 (俯视图),房间就是一个封闭的多边形,相机站在中间某处。
论文把俯视图的轮廓写成一串顶点:
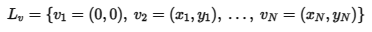
其中 v₁ 被固定在原点 (0,0)。
为什么固定 v₁? 论文原话是 "v₁ resolves the translation ambiguity"------解决平移歧义。
通俗说:如果不固定,整个房间可以整体往左挪 10 厘米、往右挪 10 厘米,看起来全都一样,优化根本不知道该选哪个。把第一个角钉死,这个问题就消失了。
初始化要优化什么?(Eq.2)
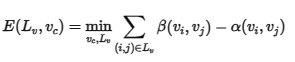
别被公式吓到,它说的其实是一件很朴素的事。先认识两个角色:
| 符号 | 是什么 | 大白话 |
|---|---|---|
| βij | 从相机 vc 看,相邻两个角 vi、vj 之间的夹角 | 这两个角在我视野里张开了多大 |
| αij | 全景图上,vi 和 vj 之间的水平像素距离(除以图宽归一化) | 这两个角在照片上隔了多远 |
而全景图有个绝妙的性质:图像上的水平距离,直接就等于角度。360° 对应整张图的宽度------所以图上一半宽,就是 180°。
所以这个式子的意思是:
调整房间的形状和相机的位置,让"从相机看过去的角度 β "尽量等于"图上量出来的角度 α"。
两者越接近 → 说明我摆的这个房间形状,和网络看到的画面越吻合。
最小化这个差异,就得到一个还不错的初始形状。注意它同时优化 Lv(房间轮廓)和 vc(相机位置)------因为这两者是耦合的。
求解工具是 L-BFGS-B ,一种经典的数值优化算法("B"代表它能处理变量的上下界约束),快且稳。
第 3 课:第二步------给候选盒子打分(Eq.3)
有了初始形状,接下来要反复调整、反复打分、挑最好的。
打分怎么打?(这是整个模块的心脏)
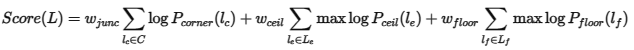
翻译成人话:
把一个候选的 3D 盒子投影回图像上,看它压中了网络画的多少"星星"和"线"。压中得越多、越准,分数越高。
拆成三项看:
① 角点分:压中星星了吗?
把候选盒子的每个角投影回图上,去角点图 mC 上查:"这个位置的概率是多少?"
全部加起来(取对数)。角都压在高概率的星星上 → 得分高。
② 天花板分:沿线扫描取最高点
把候选盒子的天花板边界线 投影回图上,沿着这条线,在边界图的天花板通道上扫一遍,取沿线最高的那个概率值。
③ 地板分:同理
对地板边界做同样的事。
为什么要取 max 而不是"沿线加总"?
这是公式里最精妙的一个细节,值得单独讲。
因为墙角经常被家具挡住。
想象房间角落放着一个大衣柜:地板与墙的交界线在柜子那一块完全看不见,网络在那段的预测概率很低。
- 如果沿线加总:被柜子挡住的那一段会拉低总分 → 一个明明正确的盒子被冤枉扣分
- 如果取 max :只要这条线上有任意一段 压中了高概率区,就算它过关 → 对遮挡免疫
一句话记住:"取最高分"是一种对遮挡的宽容------我不要求你整条线都对,只要有一段对上了,我就认你。
三个权重是怎么定的?
论文用网格搜索试出来:
| 项 | 权重 |
|---|---|
| 角点 wjunc | 1.0 |
| 天花板 wceil | 0.5 |
| 地板 wfloor | 1.0 |
天花板的权重只有一半 ,论文的解释是:这符合一个观察------墙与地板的交角经常被家具遮挡 ,所以需要地板边界来帮忙补位;相对地,天花板上常有吊灯、吊柜等干扰,可靠性低一些,权重就给小一点。
这个 0.5 不是拍脑袋定的,是试出来的。也说明作者很清楚:不同线索的可信度是不一样的,不能一视同仁。
第 4 课:第三步------怎么搜索?(Algorithm 1)
有了打分函数,接下来就是"怎么找最高分"。论文用的是采样 + 局部搜索,非常朴素但很有效:
1. 从初始化得到的形状 L₀ 出发
2. 计算它的分数,作为当前最好成绩
3. 对每一面墙 i:
      把这面墙在"距离相机中心 ±10%"的范围内来回挪动
      → 产生一批候选形状
      对每个候选,再用同样的方式微调天花板和地板的高度
      → 又产生一批候选
      用 Eq.3 给每个候选打分
      留下分数最高的
4. 全部试完,输出分数最高的那个布局
几个关键数字:
| 细节 | 数值 |
|---|---|
| 单面墙挪动范围 | 距相机中心距离的 **±10%** |
| 总共采样候选数 | 约 1000 个 |
| 求解器 | L-BFGS-B |
为什么是"挪一面墙"而不是"全部一起调"?
因为 4 面墙(或 6 面)一起调,组合会爆炸。论文用的是坐标下降 的思路:一次只动一个变量,其他固定------逐个击破,反复几轮,收敛得又快又稳。
就像调一张椅子的四条腿:你不会同时拧四个螺丝,而是一次调一条腿,轮着来几圈。
那"曼哈顿约束"体现在哪?
注意这一步的精妙之处:候选布局本身就只在"合法"的范围内生成。
也就是说,搜索的时候,墙只能沿着规定的方向平移 、高度只能上下调整------它永远不会产生"斜着的墙"或"非直角的角"。
**约束是内建的,不是事后纠正的。** 这比"先随便生成、再强行掰正"要优雅得多。
结果就是:搜索空间被大幅缩小(只在合法解里找),而且输出天生就是横平竖直的。
第 5 课:遇到 L 形房间怎么办?
前面默认房间是长方体(4 面墙) 。但真实世界有 L 形房间。
判断逻辑(非常朴素)
论文的做法:
检查角点图上**"第六强"的那一列** 墙-墙边界,如果它的平均概率 ≥ 0.05 ,就认为存在额外的墙,生成 6 面墙 ;否则生成 4 面墙。
几个要点解释一下:
为什么看"第六强"而不是"第五强"?
留余量。因为全景图是环形闭合的,第 4 面墙的两端会各产生边界响应,统计上会有冗余列。看第六强可以避开这些"影子",降低把噪声误判成真墙的概率。
为什么阈值这么低(0.05)?
因为被遮挡的墙本来信号就弱。宁可宽松一点让 L 形房间进来,也不要一刀切把真墙漏掉。
为什么是 6 面而不是 5 面?
在曼哈顿世界里,L 形房间在俯视图上就是"矩形缺一个角",把缺口补回来正好是 6 个顶点 / 6 面墙。这是这类布局的标准表示。
还有一个细节 :训练非长方体布局时,不使用 3D 参数回归器------因为那个回归器只能输出长方体的 6 个参数,表达不了 L 形。
这部分实验的诚实交代
论文对非长方体只给了定性结果 (几张效果图),没有大规模量化表格。原因是数据太少------作者自己用 Ricoh Theta-S 相机拍了少量样本。
这是论文的一处已知局限,作者没有回避。
第 6 课:这一步到底有多重要?值不值?
收益:消融实验
| 配置 | PanoContext 3D IoU | Stanford 2D-3D 3D IoU |
|---|---|---|
| 完整方法 | **74.48%** | **75.39%** |
| 去掉布局优化 | 73.25%(−1.23) | 74.47%(−0.92) |
| 去掉长方体约束 | 72.56%(−1.92) | 74.13%(−1.26) |
能涨约 1 个点。 而且"去掉长方体约束"掉得更多(−1.92),说明几何约束本身的价值比优化搜索还大。
代价:时间大头
看 Table 2 的 CPU 耗时,这一步贵得惊人:
| 配置 | 平均耗时 |
|---|---|
| 完整方法 | 44.73 s |
| 去掉布局优化 | 14.23 s |
| 去掉长方体约束 | 13.75 s |
优化这一步吃掉了 30 秒,占整个流程的三分之二!
对比一下:
- 神经网络前向推理只要 39 毫秒(快得离谱)
- 但这个 Matlab 实现的几何优化要 30 秒
这是 LayoutNet 一个很真实的工程痛点:神经网络极快,反而是后处理成了瓶颈。
论文实现里这一步是放在 Matlab (
panoOptimization.m)里跑的。
即便如此,相比此前 SOTA 方法 PanoContext 的 300 秒以上,44.73 秒依然是压倒性的快。
第 7 课:这步在透视图上被砍掉了
和"全景图对齐"一样,用在普通照片上时,这步被去掉了。
原因很实在:单张透视照片视野太窄(一般 60°--90°),画面里的几何信息严重不足,强行做 3D 优化反而不稳。所以透视图版本是直接输出角点和边界 ,外加一个房间类型分类分支(11 类)来帮忙判断该检测哪些角。
第 8 课:一张表记住全部
| 环节 | 干什么 | 关键设计 | 数值 |
|---|---|---|---|
| 参数化 | 用 6 个数描述房间 | 长/宽/高/平移/旋转 | --- |
| ① 初始化 | 在俯视图摆个大概 | 固定 v₁ 消歧义;让视野角 β ≈ 图上角 α | L-BFGS-B |
| ② 打分 | 投影回图,看压中多少线角 | **边界取 max(对遮挡免疫)** | 权重 1.0 / 0.5 / 1.0 |
| ③ 搜索 | 逐面墙调整,挑最高分 | 一次只动一面墙;约束内建 | ±10%,约 1000 候选 |
| L 形处理 | 决定 4 面还是 6 面墙 | 第六强边界列平均概率 | 阈值 0.05 |
| 收益 | 3D IoU 提升 | --- | +1.23(PanoContext) |
| 代价 | 耗时 | --- | 约 30 秒 |
最后:这一步想告诉我们什么?
3D 布局优化这个模块,是 LayoutNet 方法论的集中体现。它揭示了三件事:
① 网络不擅长的事,别硬让它做。
网络擅长"模糊的、带不确定性的感知"(概率图),不擅长"精确的、带硬约束的几何求解"。后者用几十年前就成熟的数值优化工具(L-BFGS-B)反而又快又准。
② "约束"是免费的午餐。
曼哈顿假设看起来是个限制,实际上它把搜索空间缩小到原来的极小一部分------只在合法解里找,效率和准确度双双提升。消融实验里"去掉长方体约束"掉 1.92 个点,就是这份午餐的价格。
③ 好的工程是"感知 + 推理"的分工。
网络负责"我看到什么"(感知),几何优化负责"这个世界应该是什么样"(推理)。这个组合在 2018 年显得有点"逆潮流"------当时大家正热衷于万物皆可端到端------但 LayoutNet 用数字证明了它是对的。
这个思路一直延续到今天。近年的 PolyLayout(2025)依然在用同样的配方:神经网络学打分函数,几何优化显式求解。变的只是特征提取器换成了 DINOv2,不变的是那个核心信念------
让学习做感知,让几何做推理,两者配合才是最好的。
注:来自论文 LayoutNet: Reconstructing the 3D Room Layout from a Single RGB Image