做AI应用的团队,对"缓存"这个词应该不陌生。传统的API缓存很简单,同样的请求,存下结果,下次直接返回。但AI调用不一样,用户的问题千变万化,字面完全一样的重复请求很少见。
于是有人问:AI网关能做语义缓存吗?答案是肯定的。但语义缓存不是简单的"省点钱",它对延迟、成本、用户体验都有直接影响。这篇文章从技术原理和实战角度,把这件事讲清楚。
一、语义缓存的技术原理
先从传统缓存说起。传统的API缓存是精确匹配,请求的URL和参数完全一样,才算命中。这种方式对结构化的API请求很有效,因为参数是固定的,同一个接口的调用参数往往是一样的。
但大模型的调用不是这样。用户用自然语言提问,表达方式千差万别。"怎么退款"和"退款流程是什么"和"我想退钱怎么操作",三个问题字面不一样,但意思完全相同。如果用精确匹配的缓存,这三次请求都得走模型,花三份钱。
语义缓存解决的就是这个问题。它不看字面,看意思。两个问题,只要表达的是同一个意思,就算命中缓存,直接返回之前的答案,不用再调用模型。
实现语义缓存的核心是向量相似度计算。把用户的问题转换成向量,也就是一串数字,然后跟缓存里的向量做比较。相似度超过阈值,就认为是同一个意思,返回缓存结果。相似度的阈值可以调,调得高,命中少但准;调得低,命中多但可能出错。
这个技术原理其实不是什么新东西。搜索引擎早就用向量相似度来做语义匹配了。但把它用在AI网关的缓存层,有几个工程上的难点要解决。第一是向量化用什么模型,不同的embedding模型效果不一样。第二是缓存的更新策略,什么时候该清缓存。第三是误命中的处理,意思相近但答案不同的情况怎么避免。这些问题的处理水平,决定了语义缓存的实战效果。
二、实际效果:两到四成的拦截率
理论讲完,说点实际的。MAI Gateway的语义缓存,在真实业务场景中,平均能拦截两到四成的无效请求。
"两到四成"这个范围,看起来跨度不小,其实是因为不同场景的差异很大。影响命中率的因素主要有三个。
**第一个因素是业务场景。**客服和FAQ类的场景命中率最高。因为用户问的问题相对集中,来来去去就是那些常见问题。这种场景下,四成甚至更高的命中率都是正常的。开放式对话和创意生成类的场景命中率低一些,因为每次请求的内容差异大,重复度低。
**第二个因素是使用时长。**缓存是越用越准的。刚上线的时候,缓存库里是空的,命中率很低。运行一段时间后,常见问题逐步被缓存下来,命中率逐渐上升,最后稳定在一个水平。这个过程通常需要一到两周,具体取决于调用量和问题的分散程度。
**第三个因素是阈值设置。**相似度阈值设得低,命中率高,但可能出现"意思相近但答案不一样"的误命中。阈值设得高,命中率低,但更安全。MAI Gateway的默认阈值是一个比较保守的设置,保证准确率优先,实际使用中可以根据业务场景调整。
综合下来,一个中等规模的客服场景,语义缓存上线稳定后,通常能做到三成左右的命中率。三成是什么概念呢?就是每十次调用,有三次不用花钱,而且响应速度更快。
三、语义缓存带来的三重收益
很多人以为语义缓存就是省钱,其实它带来的收益有三重。
**第一重,直接降低成本。**这是最直观的。命中率多少,就省多少比例的模型调用费。三成命中率,就省三成的钱。如果企业每月AI调用费用是十万,语义缓存一个月就能省三万。一年下来,就是三十六万。
**第二重,显著降低延迟。**模型调用的延迟,少说也有几百毫秒,复杂的请求甚至要几秒。缓存命中的响应,延迟通常在几十毫秒以内。用户感受到的区别是很明显的。一个问题,是秒回还是等两秒,体验完全不一样。对于客服这种交互频繁的场景,延迟的降低直接影响用户满意度。
**第三重,提升系统稳定性。**调用量少了,对模型供应商的依赖就降低了。高峰期的压力小了,不容易触发供应商的速率限制。供应商接口出问题的时候,缓存里的内容还能继续服务,相当于多了一层缓冲。
这三重收益里,成本是算得出来的,延迟和稳定性是算不出来但感受得到的。很多团队上线语义缓存之后,最先感受到的不是成本降了,而是用户反馈"响应变快了"。
四、哪些场景适合用语义缓存
语义缓存不是万能的,有的场景效果好,有的场景效果一般。选型的时候要结合自己的业务类型来判断。
**效果最好的场景:客服与FAQ。**用户的问题相对固定,答案也相对固定。同一个问题,不同用户问法不一样,但意思一样。这种场景是语义缓存的最佳用武之地,命中率通常能到三成以上。
**效果不错的场景:知识库问答。**企业内部的知识库问答,员工问的问题往往也有一定的重复性。特别是操作指引类的问题,比如"怎么开权限""怎么申请设备""报销流程是什么",这些问题重复度高,适合用语义缓存。
**效果一般的场景:通用对话。**开放式的聊天对话,话题分散,每次说的都不一样,重复度低,命中率自然也低。但即使是这种场景,也不是完全没用。问候语、常见的寒暄、固定的引导语,这些还是能命中的,只是整体命中率没那么高。
**不建议使用的场景:创意生成。**写文案、做方案、生成代码这类创意性的请求,每次都是新的,语义缓存几乎派不上用场。而且创意类场景对答案的准确性要求很高,缓存命中如果出错,影响比客服场景大。这类场景可以不开语义缓存,或者把阈值设得非常高。
五、配置与优化:怎么调到最好效果
语义缓存的配置本身不复杂,但要达到最好的效果,需要根据业务情况做一些调整。
**相似度阈值的设置。**这是最关键的参数。阈值太高,命中率低;阈值太低,误命中多。建议的做法是,先用默认阈值上线运行一周,然后看缓存命中的记录,检查有没有误命中的情况。如果误命中很少,可以适当降低阈值来提高命中率。如果误命中比较多,就调高阈值。这个过程是逐步优化的,不用追求一步到位。
**缓存范围的选择。**不是所有模型调用都适合开缓存。创意生成类的模型调用,可以单独关闭缓存。客服和知识库的调用,开缓存。MAI Gateway支持按模型、按令牌配置缓存策略,不同的业务线可以用不同的设置。
**缓存的更新与清理。**业务知识更新了,缓存里的旧答案怎么办?MAI Gateway提供缓存管理功能,可以手动清理指定的缓存条目,也可以设置缓存的过期时间。对于知识变化频繁的场景,可以把过期时间设短一些,保证答案不过时。对于知识相对稳定的场景,过期时间可以设长一些,提高命中率。
**与智能路由的配合。**语义缓存和智能路由是可以配合的。一个请求进来,先查缓存,没命中再走智能路由分配模型。缓存命中了,连路由那一步都省了。两者配合,成本优化的效果是叠加的。
六、语义缓存和其他功能的协同
语义缓存不是孤立的功能,它跟AI网关的其他能力是协同工作的。理解这种协同,才能理解为什么语义缓存要放在AI网关里做,而不是单独做一个缓存服务。
举一个真实的客服场景例子。用户发来了一个问题。请求先经过输入防护,确认没有提示词注入和违规内容。然后查语义缓存,如果命中了,直接返回答案,整个过程几十毫秒。如果没命中,智能路由判断这是一个简单问题,分配给轻量模型,成本只有旗舰模型的二十分之一。模型返回的结果经过输出过滤,确认合规再回给用户。这次调用的费用,自动记到客服部门的账上。如果客服部门当月的配额用到了80%,系统自动发提醒。
在这个流程里,语义缓存是第一道成本优化关卡,能拦住的直接拦住。拦不住的,智能路由做第二道优化,用最合适成本的模型来回答。两道优化叠加,再加上配额管控做兜底,成本治理的完整体系就跑起来了。
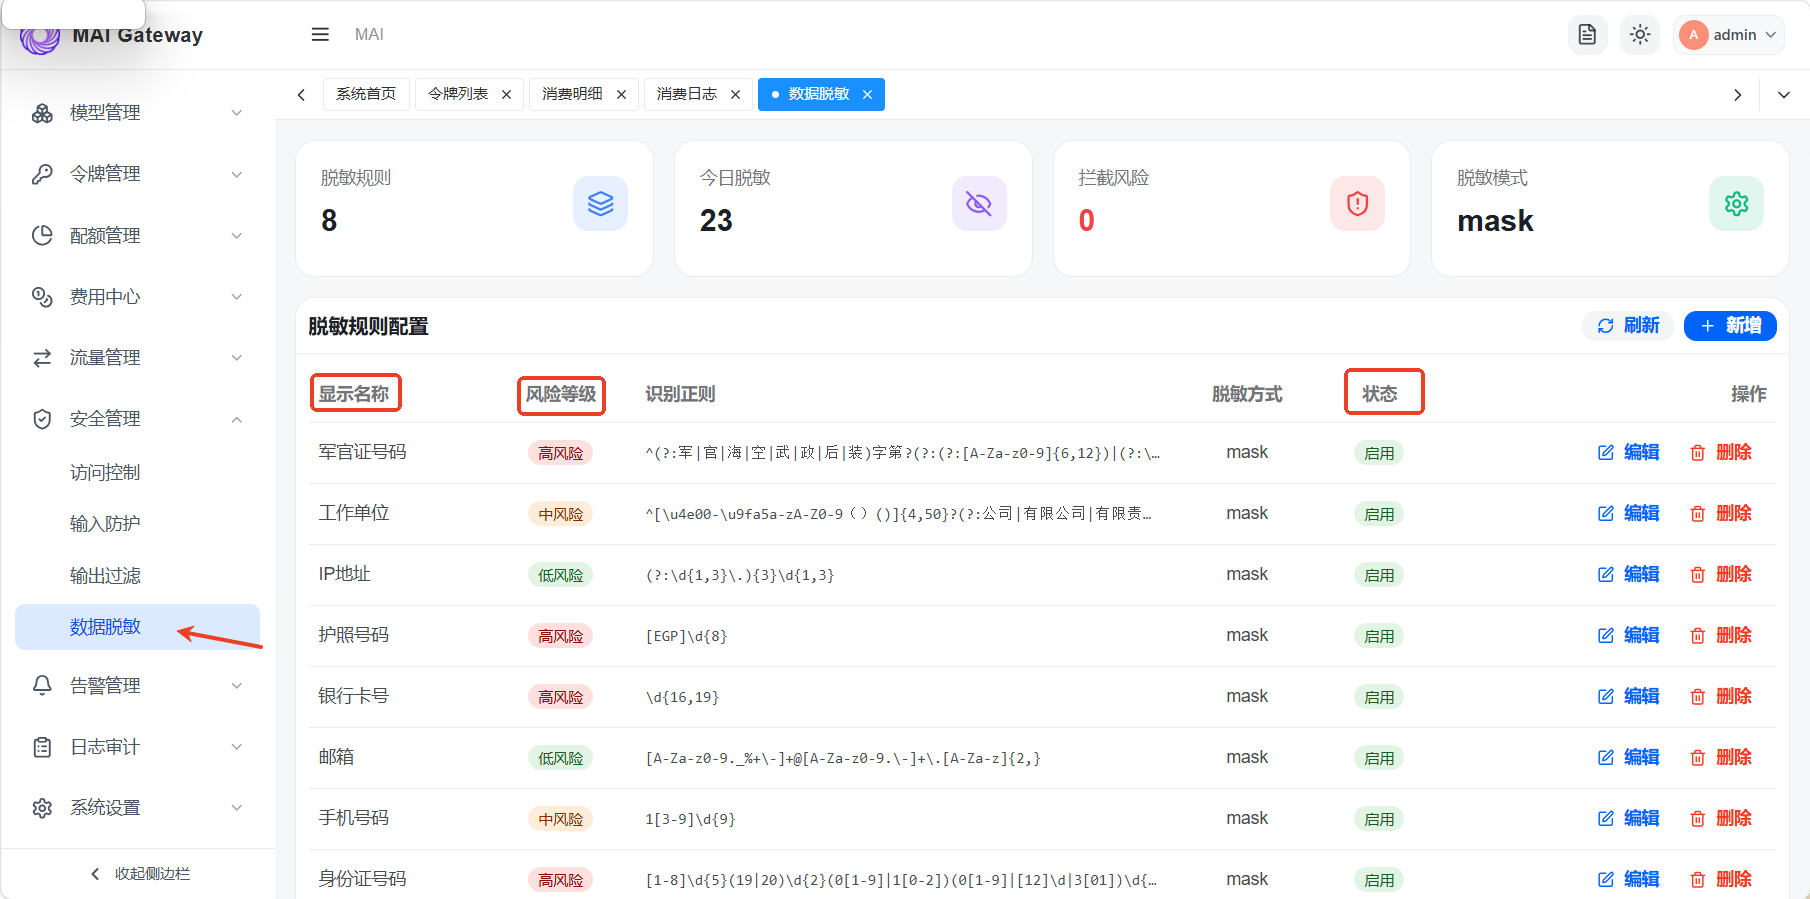
再看安全层面。缓存里的内容也是经过输出过滤的,不会把不合规的内容缓存下来返回给用户。数据脱敏也是在缓存之前做的,缓存里存的是脱敏后的问题和答案,不会有敏感信息泄露的风险。这些安全措施如果不在网关层统一做,而是分散在各个业务系统里,就很难保证一致性和完整性。
七、常见疑问
问:语义缓存会不会把不同意思的问题当成一样的?
有可能,但概率可以通过阈值控制。阈值设得越高,误命中的概率越低。默认阈值是偏保守的设置,优先保证准确率。实际使用中,可以根据业务对准确性的要求来调整。对准确性要求极高的场景,可以把阈值调高,牺牲一些命中率来保证安全。
问:缓存里的答案过时了怎么办?
MAI Gateway提供缓存管理功能,可以手动清理指定条目,也可以设置缓存的过期时间。知识变化频繁的场景,过期时间设短一些。知识稳定的场景,过期时间设长一些。另外,也可以在业务知识更新的时候,手动清理相关的缓存。
问:语义缓存增加了系统复杂度,会不会影响性能?
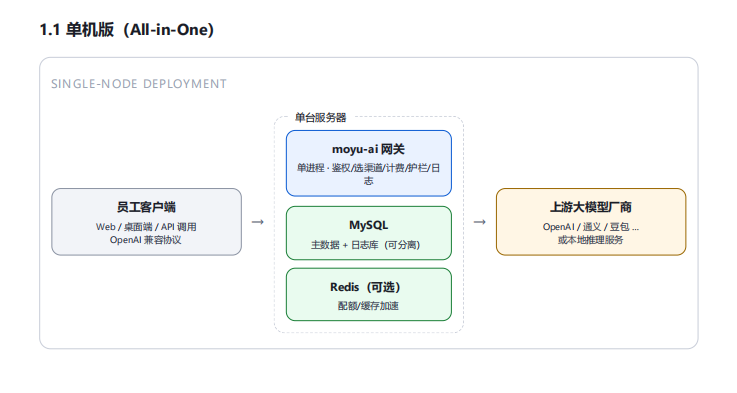
语义缓存的向量计算是在网关侧完成的,计算量不大,对性能的影响很小。实测数据显示,在约450并发的在途请求下,单机版网关的稳态吞吐达到848 req/s,五轮压测错误率为零。语义缓存开启后,因为减少了模型调用,整体系统的响应反而更快。
问:私有化部署的模型能不能用语义缓存?
可以。MAI Gateway的语义缓存不依赖具体的模型供应商,不管是公有云API还是私有化部署的模型,都可以用。缓存的逻辑在网关层,跟后端模型无关。
总结
语义缓存是AI网关成本优化体系中的重要一环。它的技术原理不复杂,向量相似度计算是搜索引擎时代就有的技术。但把它用在AI网关的缓存层,需要解决向量化模型选择、缓存更新策略、误命中处理这些工程问题。
MAI Gateway的语义缓存,在客服、知识库等高频重复场景下,平均能拦截两到四成的无效请求,同时带来成本降低、延迟减少、稳定性提升三重收益。它不是万能的,有适合的场景,也有不适合的场景。选型和配置的时候,结合自己的业务类型来判断,逐步优化阈值和策略,才能达到最好的效果。