一、安装Docker DeskTop
生产环境推荐Docker安装
1.1 下载安装包
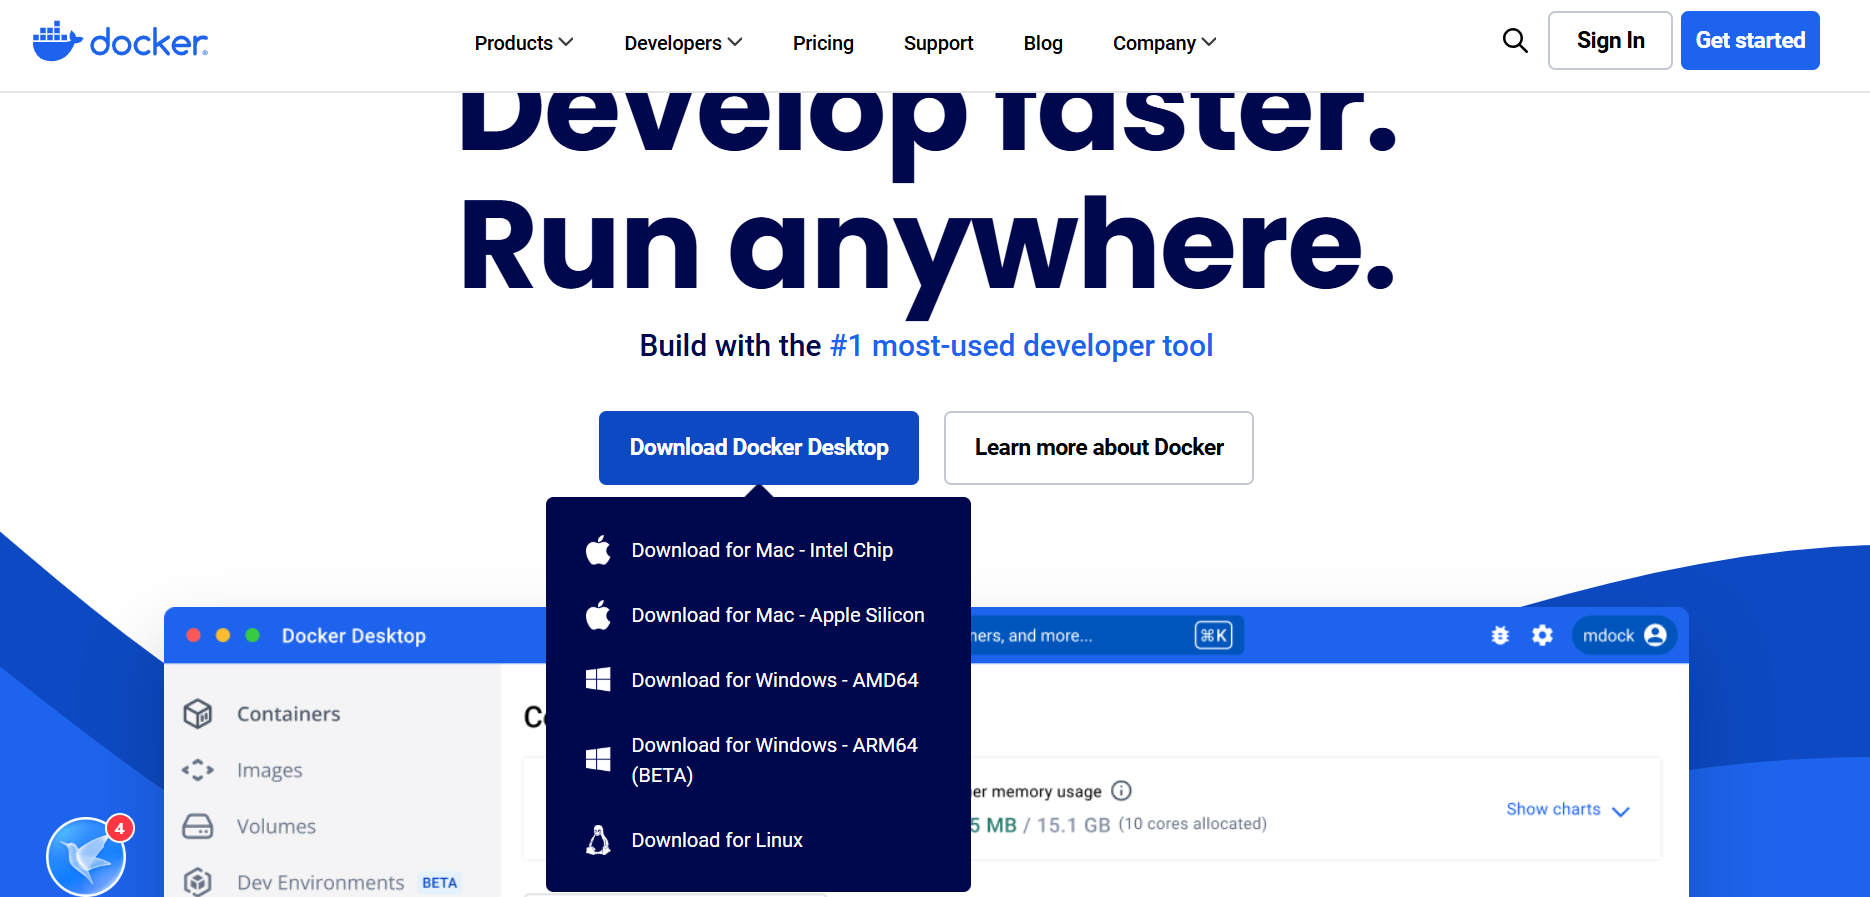
方式1:选择版本下载:
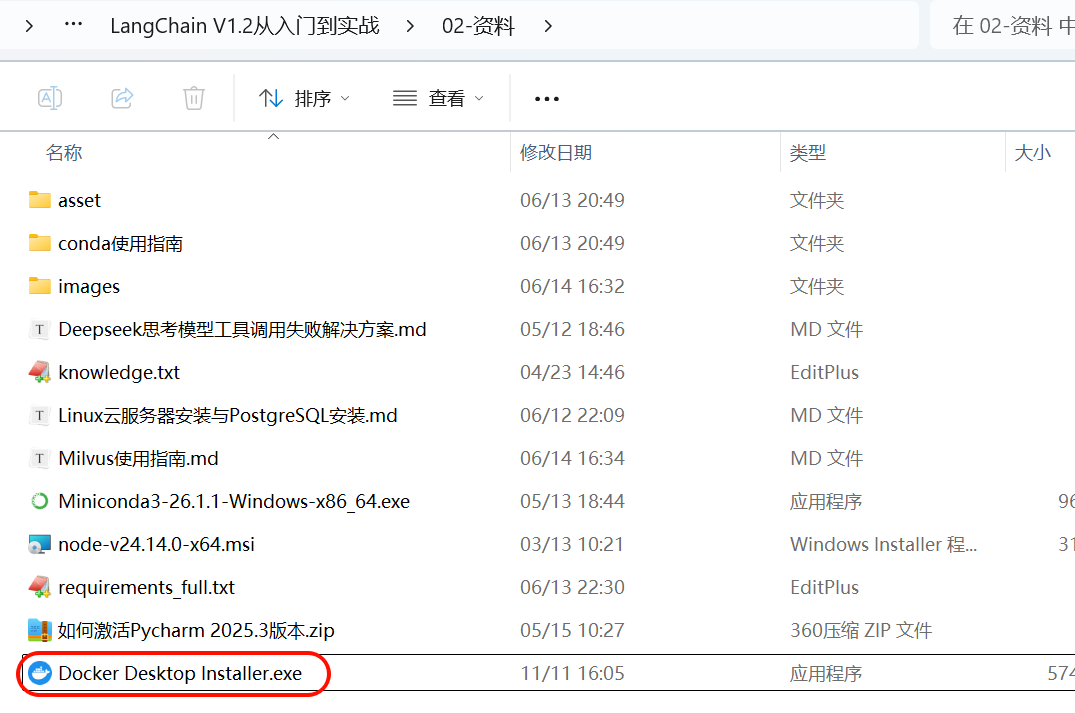
方式2:从视频资料里获取
1.2 安装
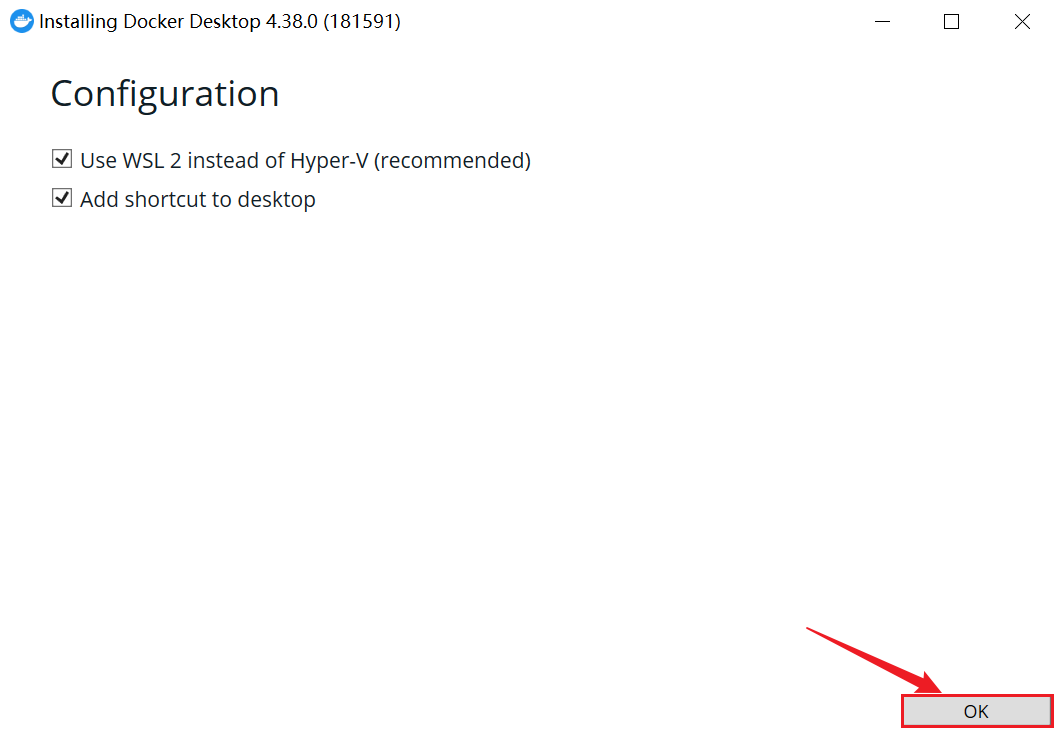
步骤1:点击OK即可
步骤2:等待安装完成
步骤3:重启电脑或稍后自行重启
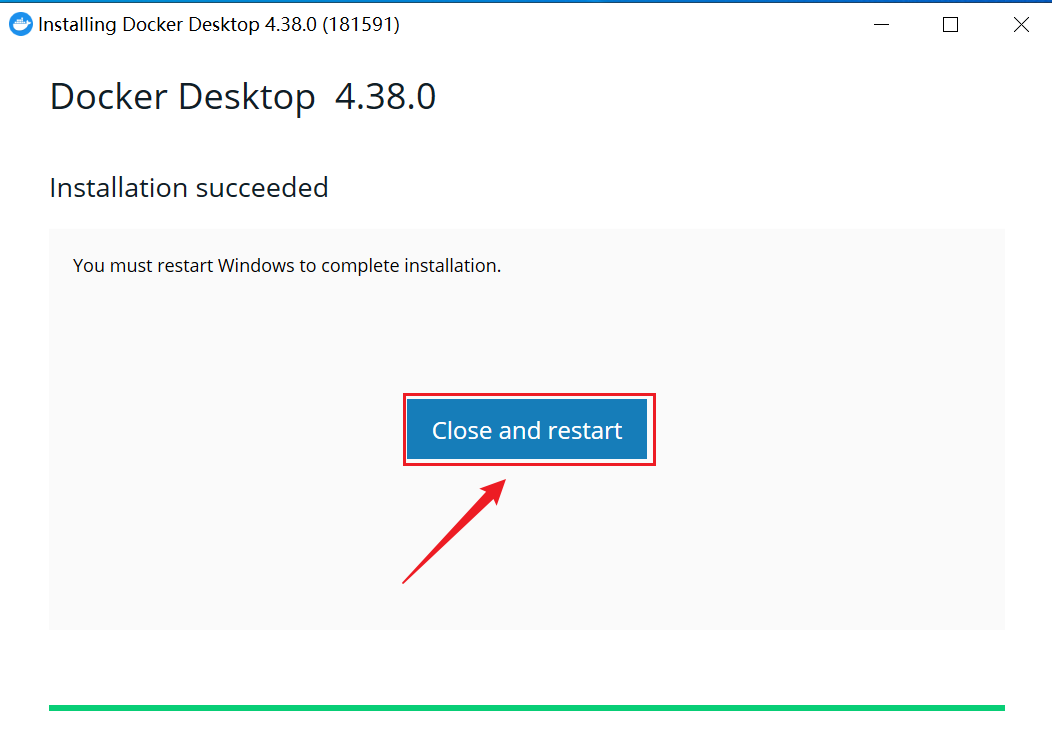
也可以关闭窗口,稍后自行重启。
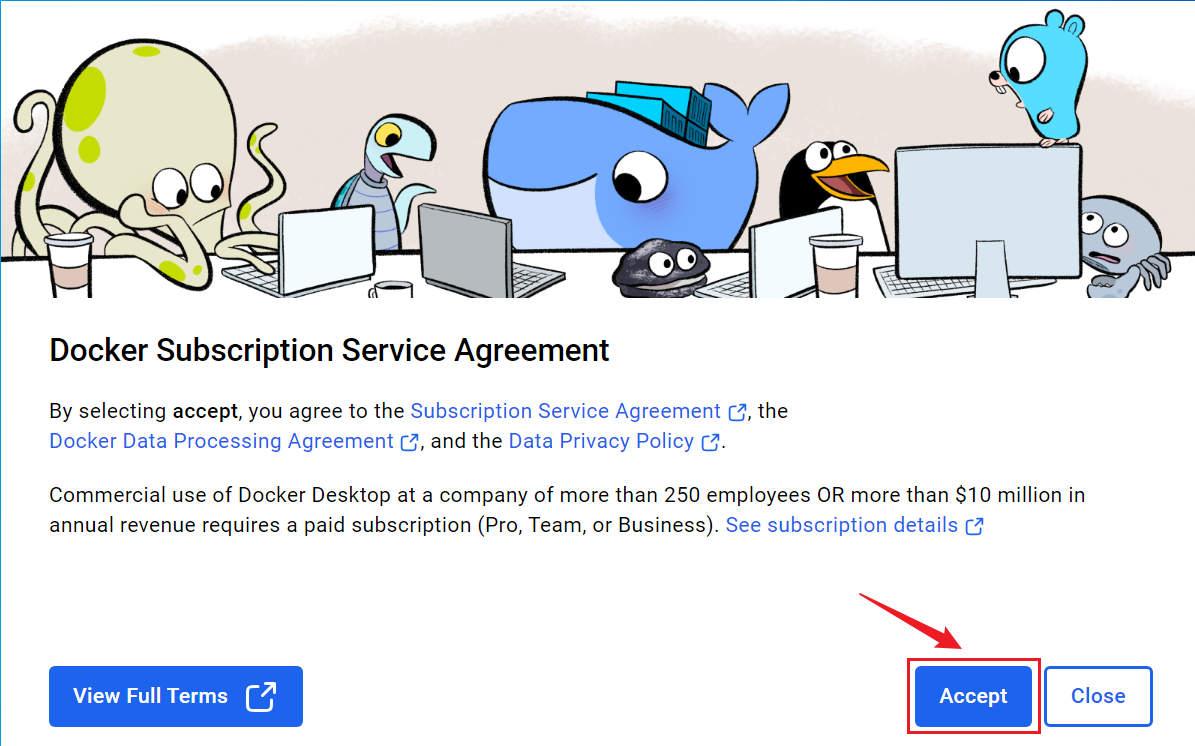
步骤4:接受服务协议
点击启动图标:
弹窗如下窗口:
选择跳过:
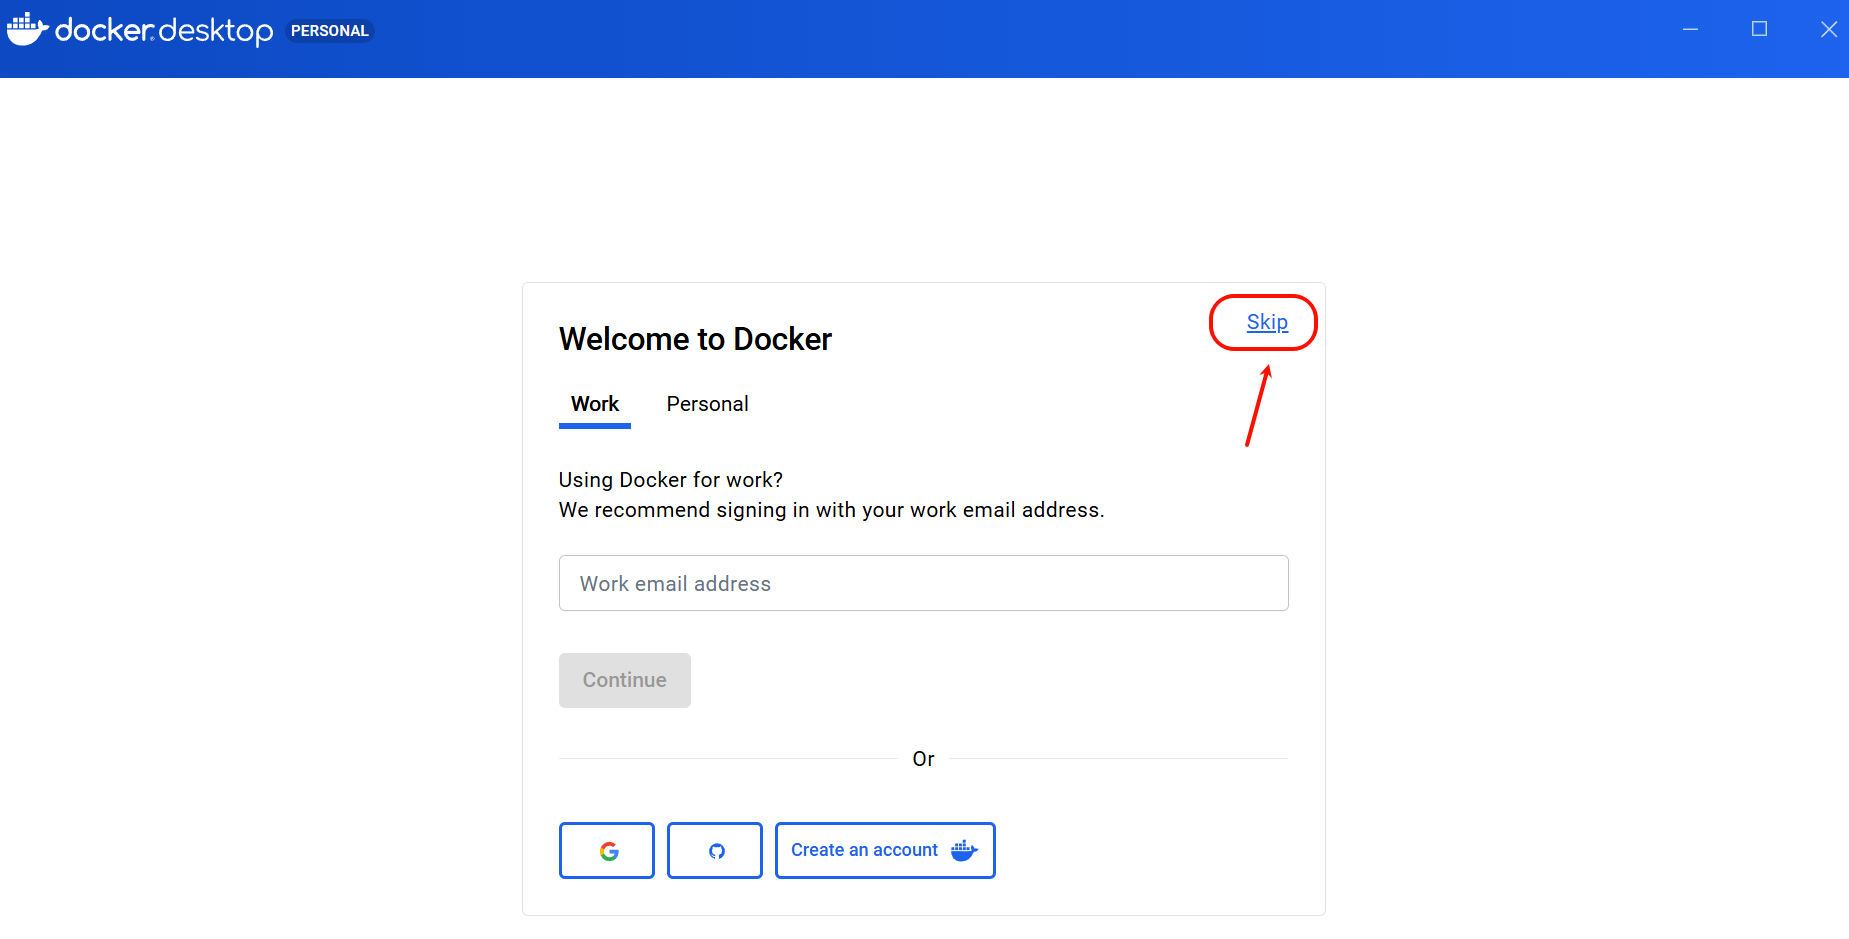
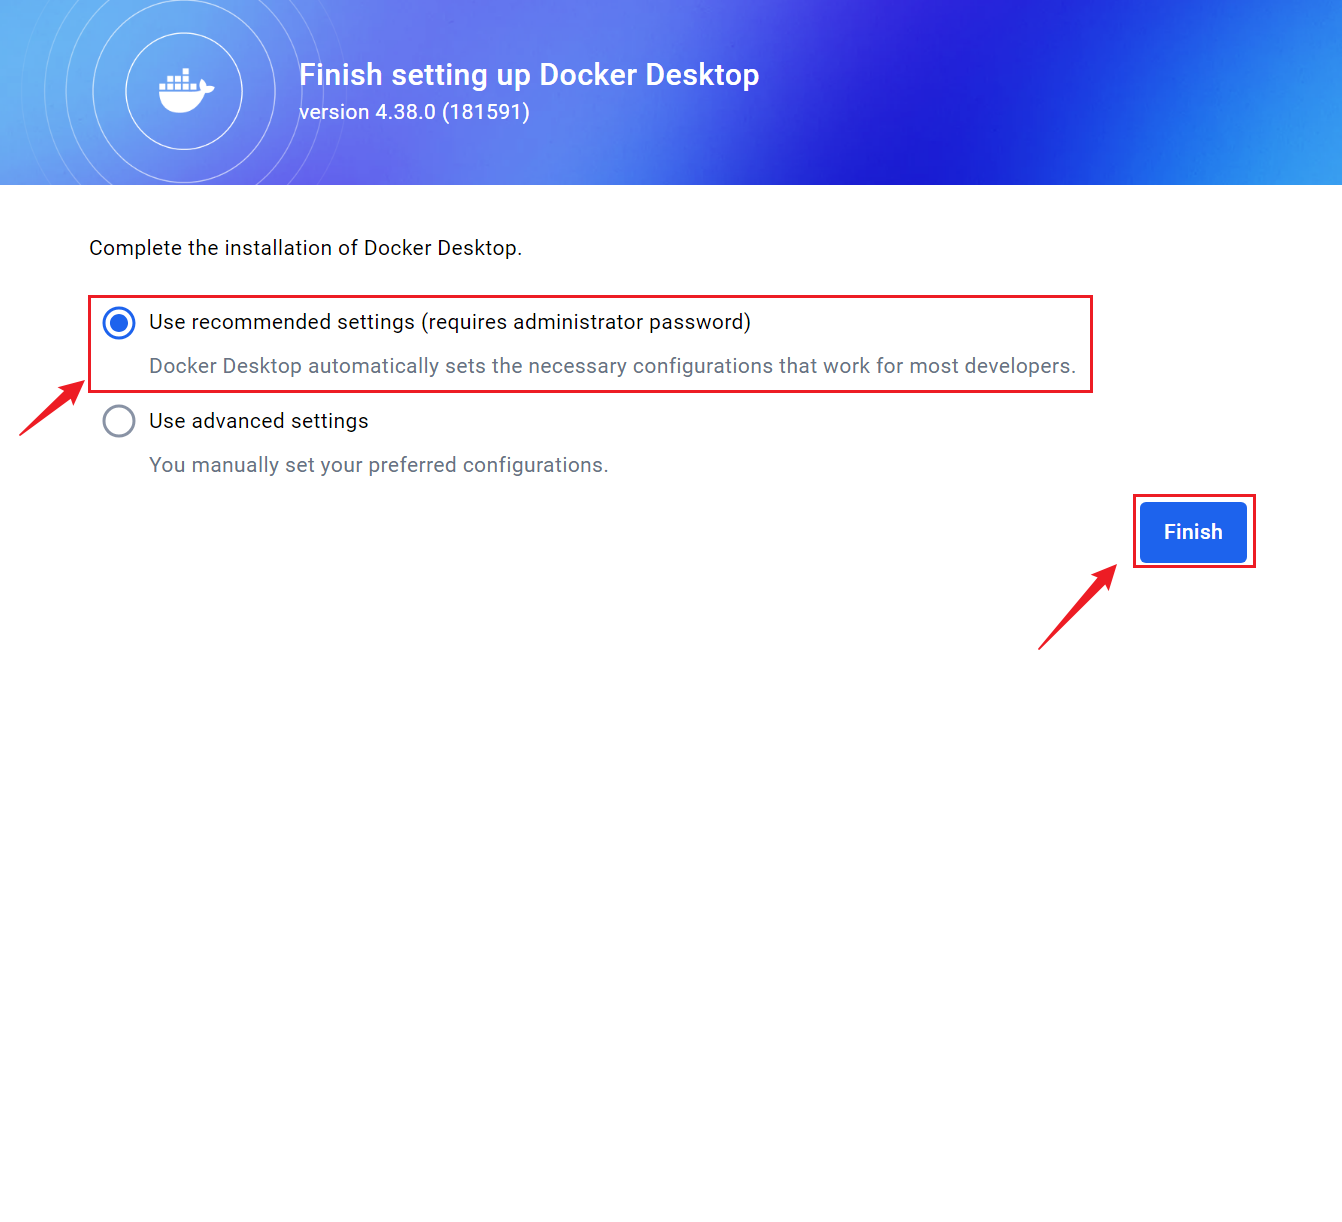
步骤5:完成安装
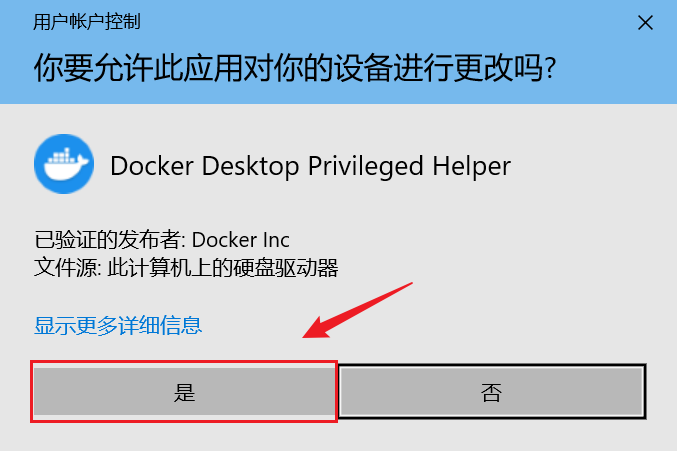
步骤6:选择允许控制
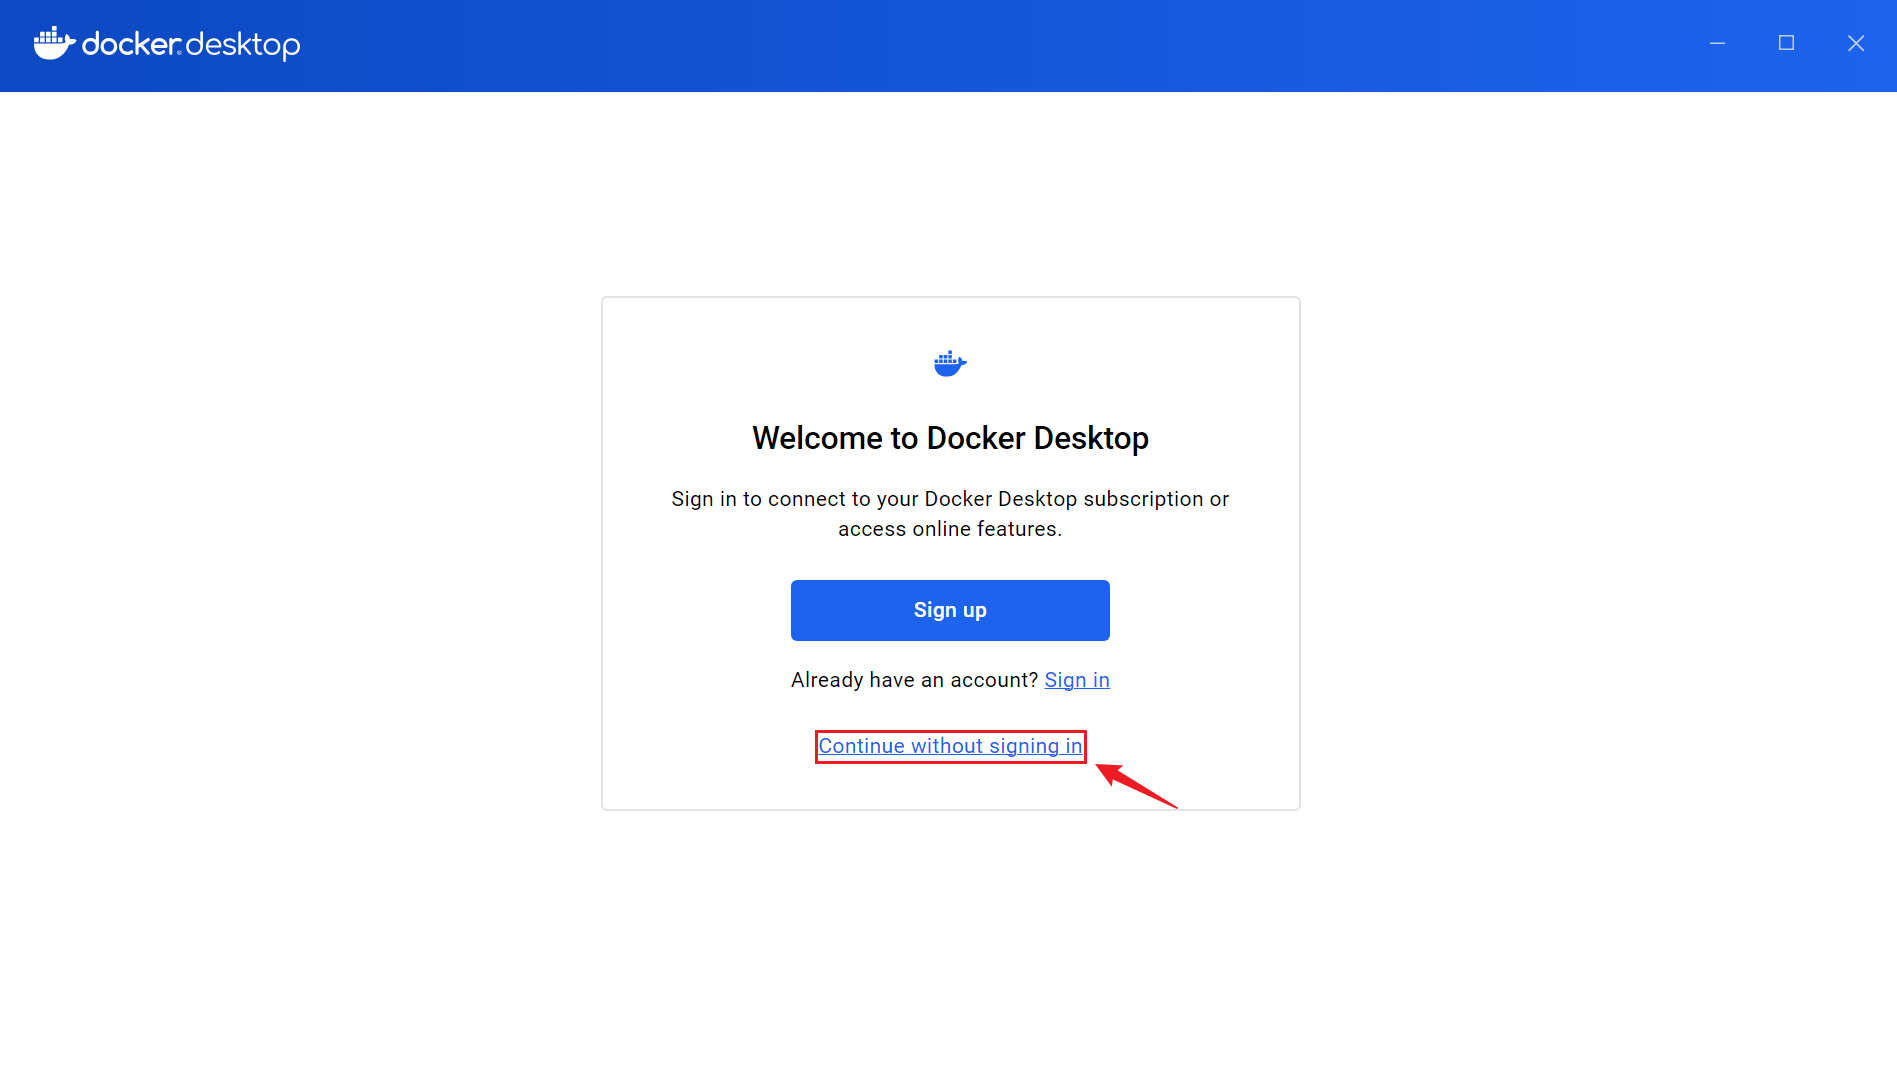
步骤7:不登录使用
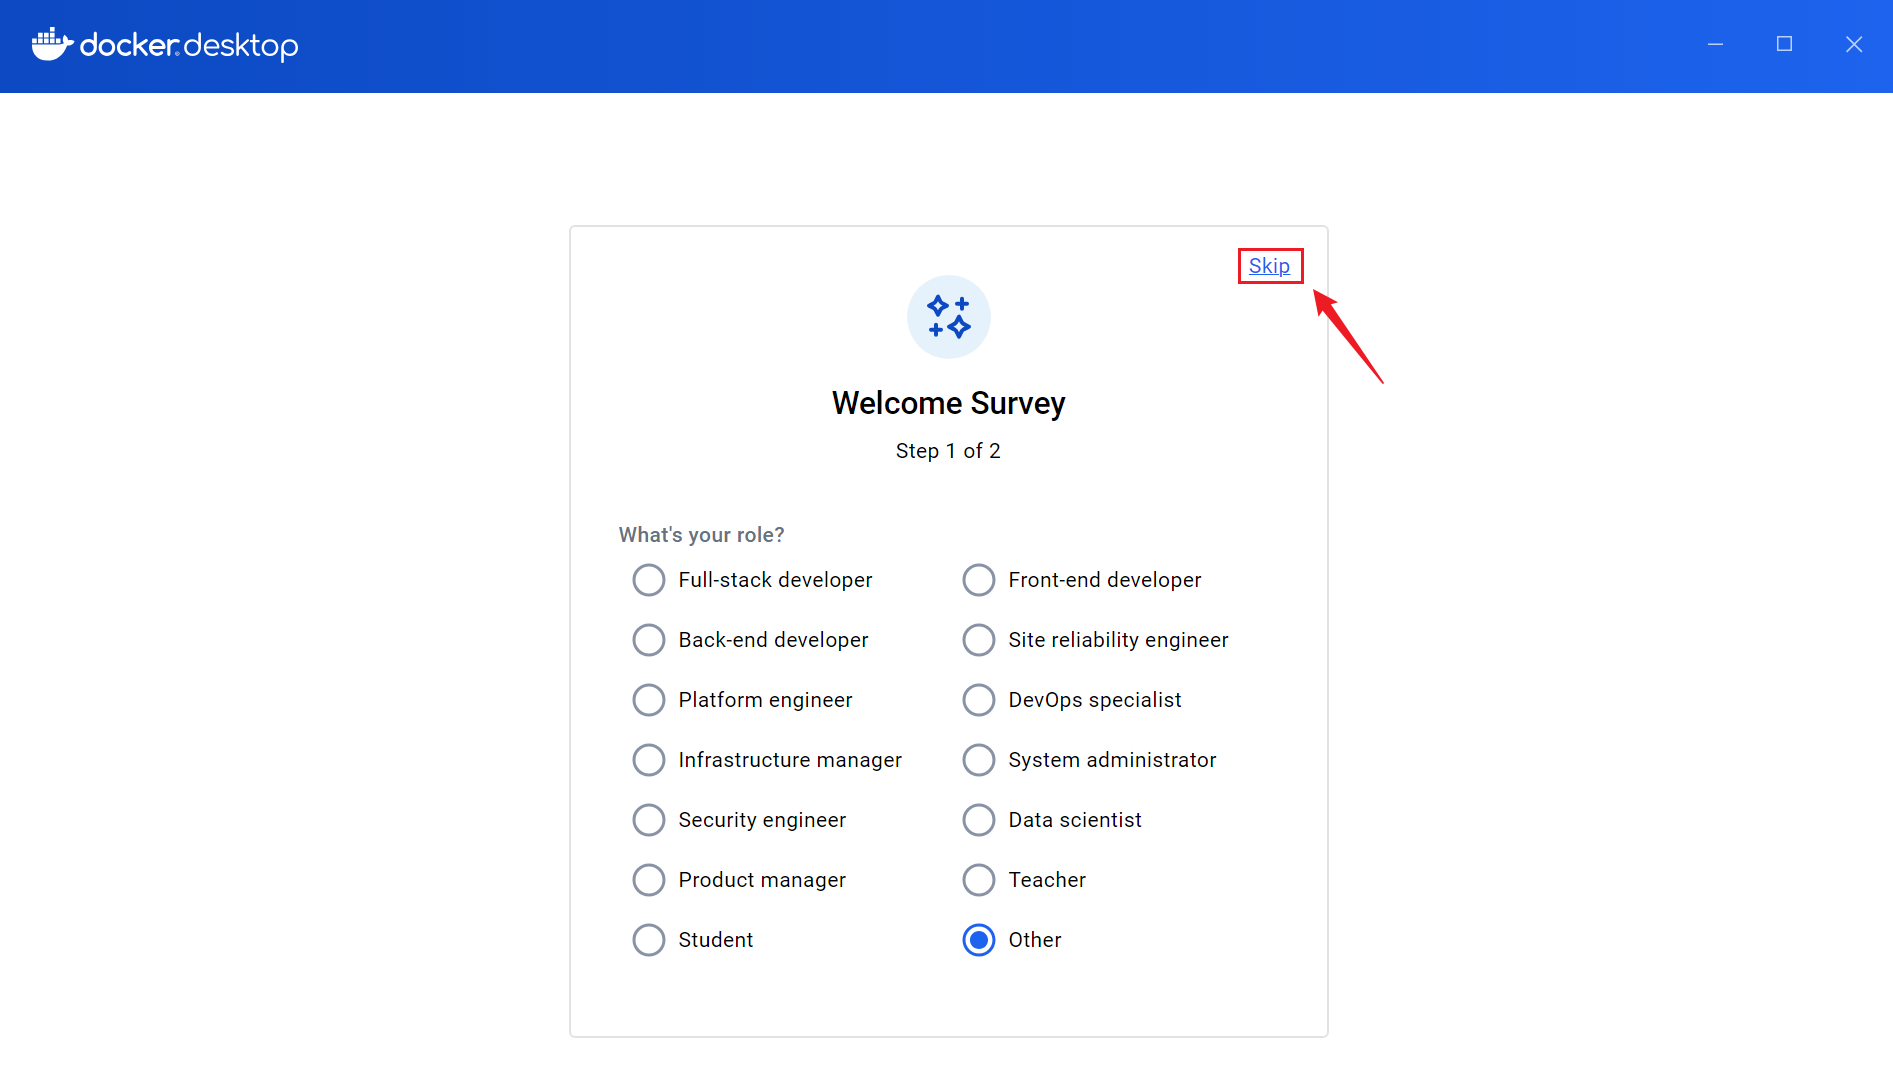
步骤8:跳过
个别首次安装的小伙伴会被windows系统提示需要安装适用于Linux的Windows子系统。这里选
择确认安装。稍等片刻后会完成安装。
步骤9:安装成功验证
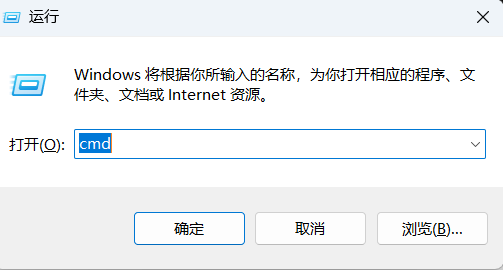
通过win+r调取运行:输入cmd
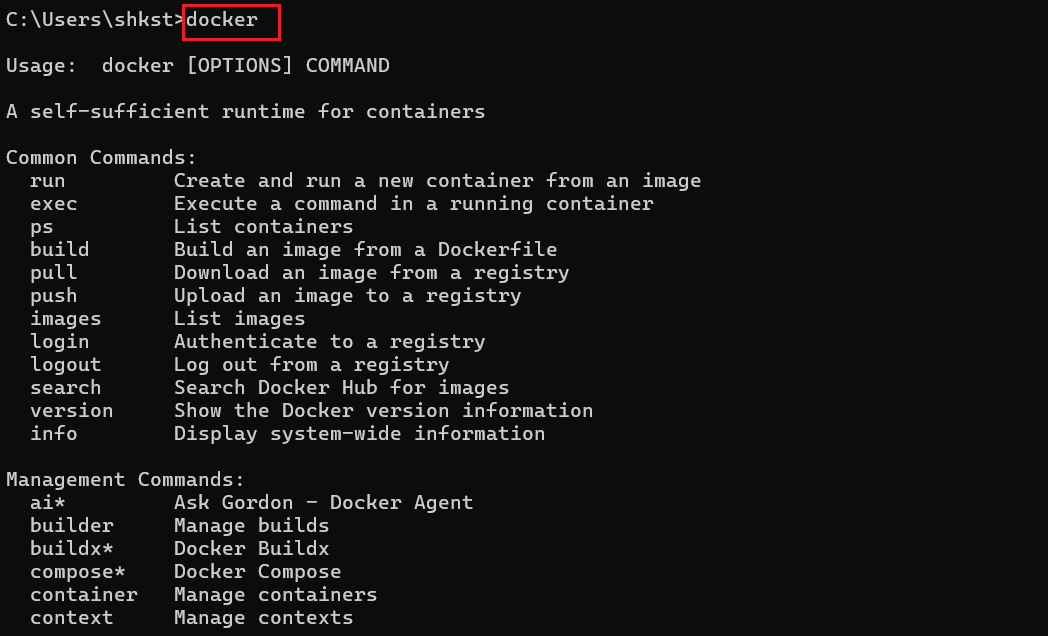
输入:docker。能显示如下内容即可成功
1.3 设置Proxy
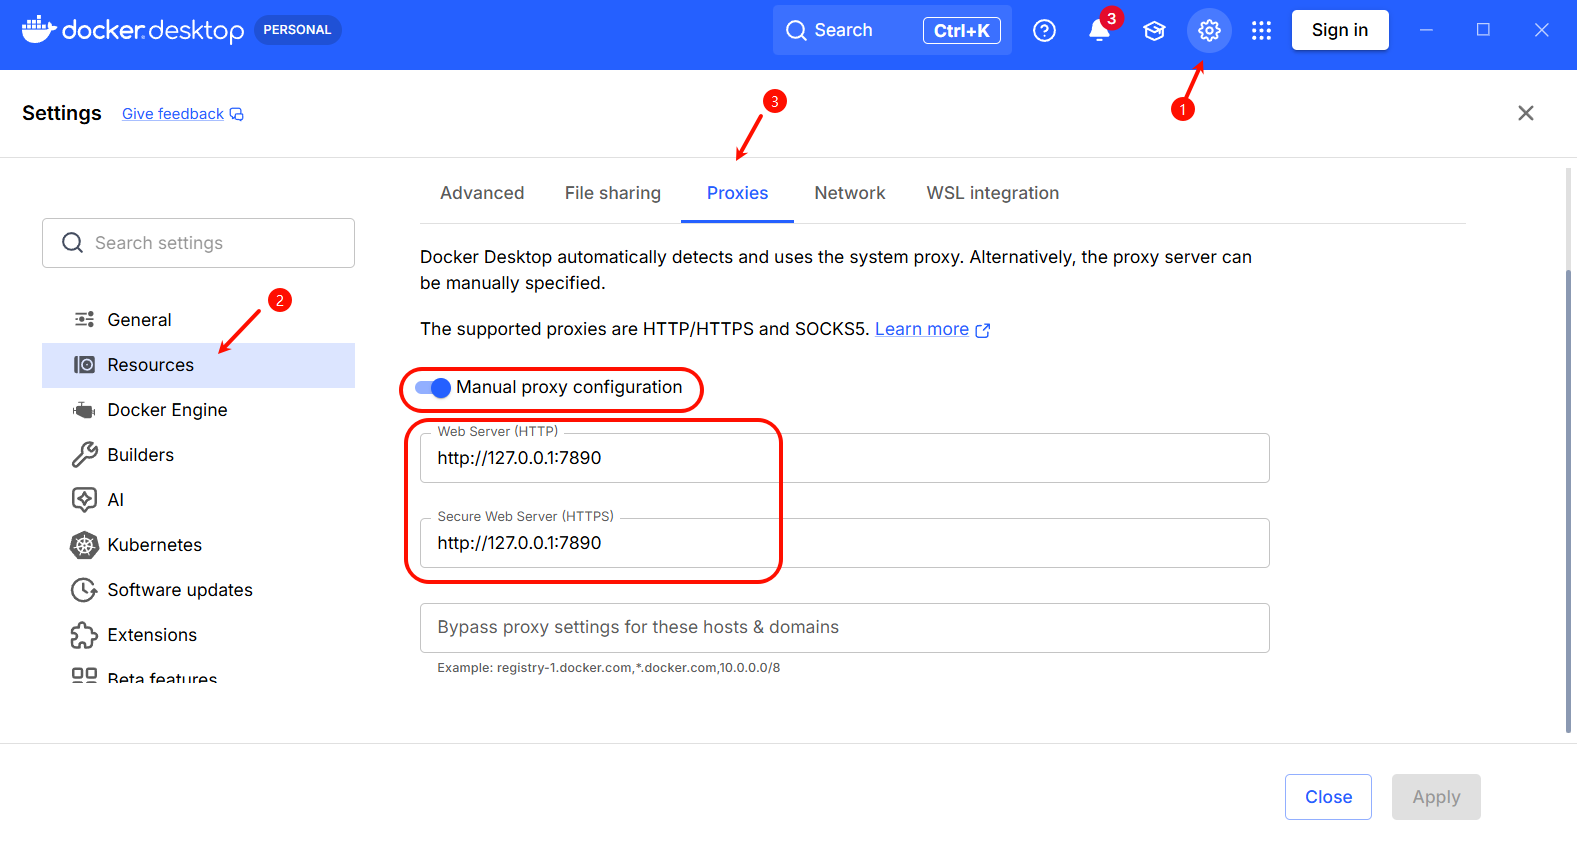
我们后续下载的Milvus是最新版,在国内可能没有对应镜像,所以建议"xx上网"
1.4 配置加速器(备选)
因为 Milvus 镜像文件比较大(好几百 MB 甚至上 GB),加上 Docker Hub 的官方镜像源在国内访问经
常受到网络限制或干扰,所以会出现下载速度极慢、甚至卡死报错的情况。所以,我们可以加速器。
-
阿里云的个人专属加速器(免费且稳定)。
- 登录 https://cr.console.aliyun.com/cn-hangzhou/instances/mirrors,在左侧导航栏选择
镜像工具 -> 镜像加速器,在页面中你会看到一个属于你的 加速器地址。
- 登录 https://cr.console.aliyun.com/cn-hangzhou/instances/mirrors,在左侧导航栏选择
在Docker Desktop中-右上角的 齿轮图标-左侧配置Docker Engine :
text
{
  "builder": {
    "gc": {
      "defaultKeepStorage": "20GB",
      "enabled": true
    }
  },
  "experimental": false,
  "registry-mirrors": [
    "https://rlmws9iw.mirror.aliyuncs.com",
    "https://docker.dockerimages.jobcher.com"
  ]
}
二、安装Milvus
-
以管理员身份打开Docker Desktop,确保Docker Engine状态正常后进行下一步
-
打开powershell,后续操作都在powershell命令行完成
-
切换文件目录
text(base) PS C:\WINDOWS\system32> d: (base) PS D:\> cd D:\developTools\Milvus (base) PS D:\developTools\Milvus>
注意:developTools\Milvus是你期望保存Milvus数据库的目录,执行前需要确保此文件目录
存在。不存在,提前创建好。
-
下载启动脚本
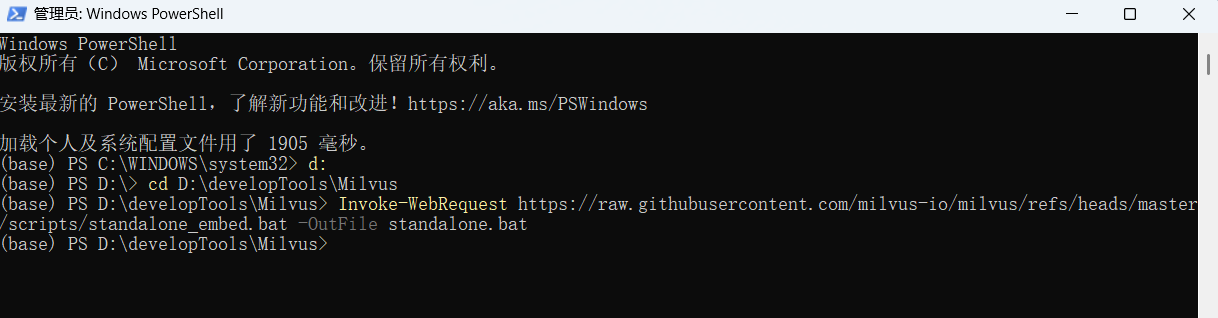
text(base) PS D:\developTools\Milvus> Invoke-WebRequest https://raw.githubusercontent.com/milvus-io/milvus/refs/heads/master/scripts/standalone_embed.bat -OutFile standalone.bat
说明:
1、执行完以后,会在当前路径下生成standalone.bat文件。
2、如果下载不畅,可以打开ikun。
-
执行命令
text(base) PS D:\developTools\Milvus> .\standalone.bat start
第三步我们将启动脚本安装在当前目录下,通过bat文件传递启动命令。
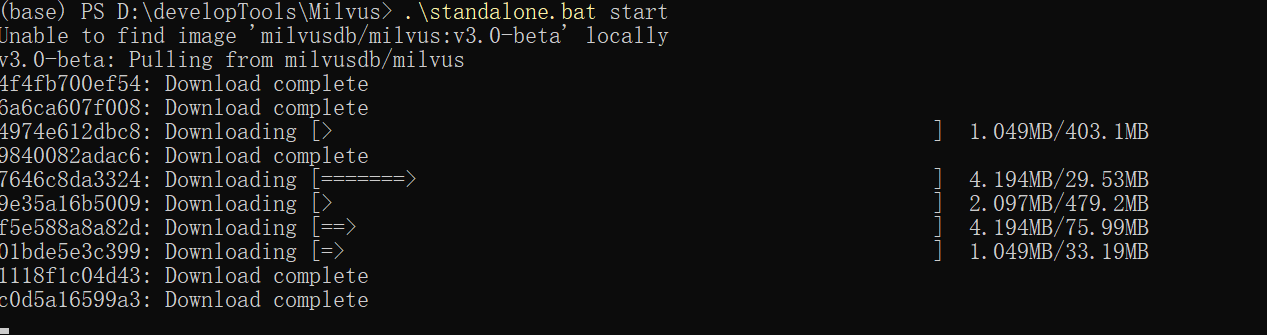
如果更换了启动脚本的下载位置,更改命令指向该文件即可。
- 查看状态
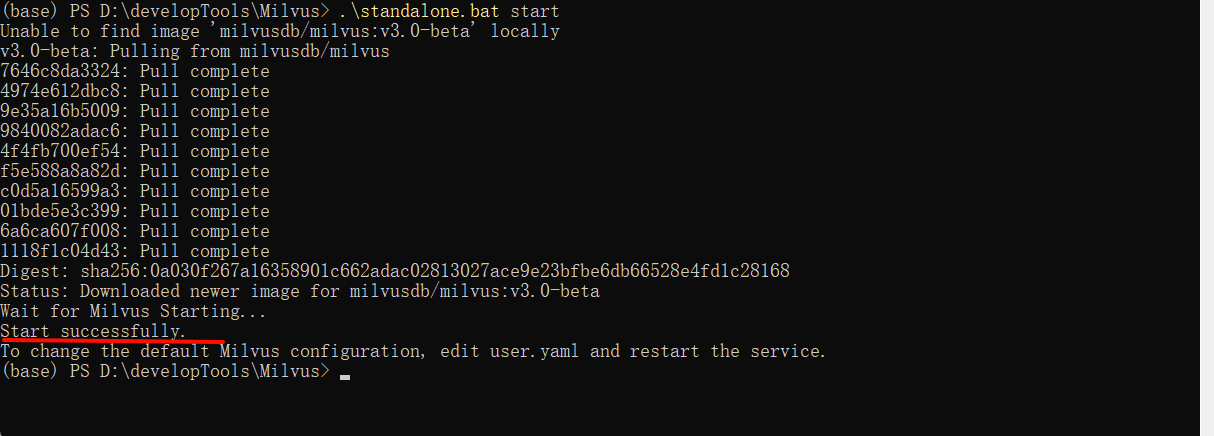
本地缺少Milvus镜像会自动从云端拉取,看到上图所示Start successfully 则启动成功。
-
停止容器
text(base) PS D:\developToo1s\Milvus> .\standalone.bat stop
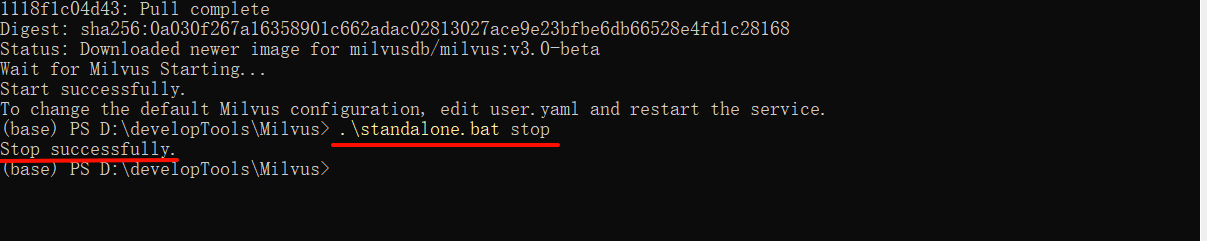
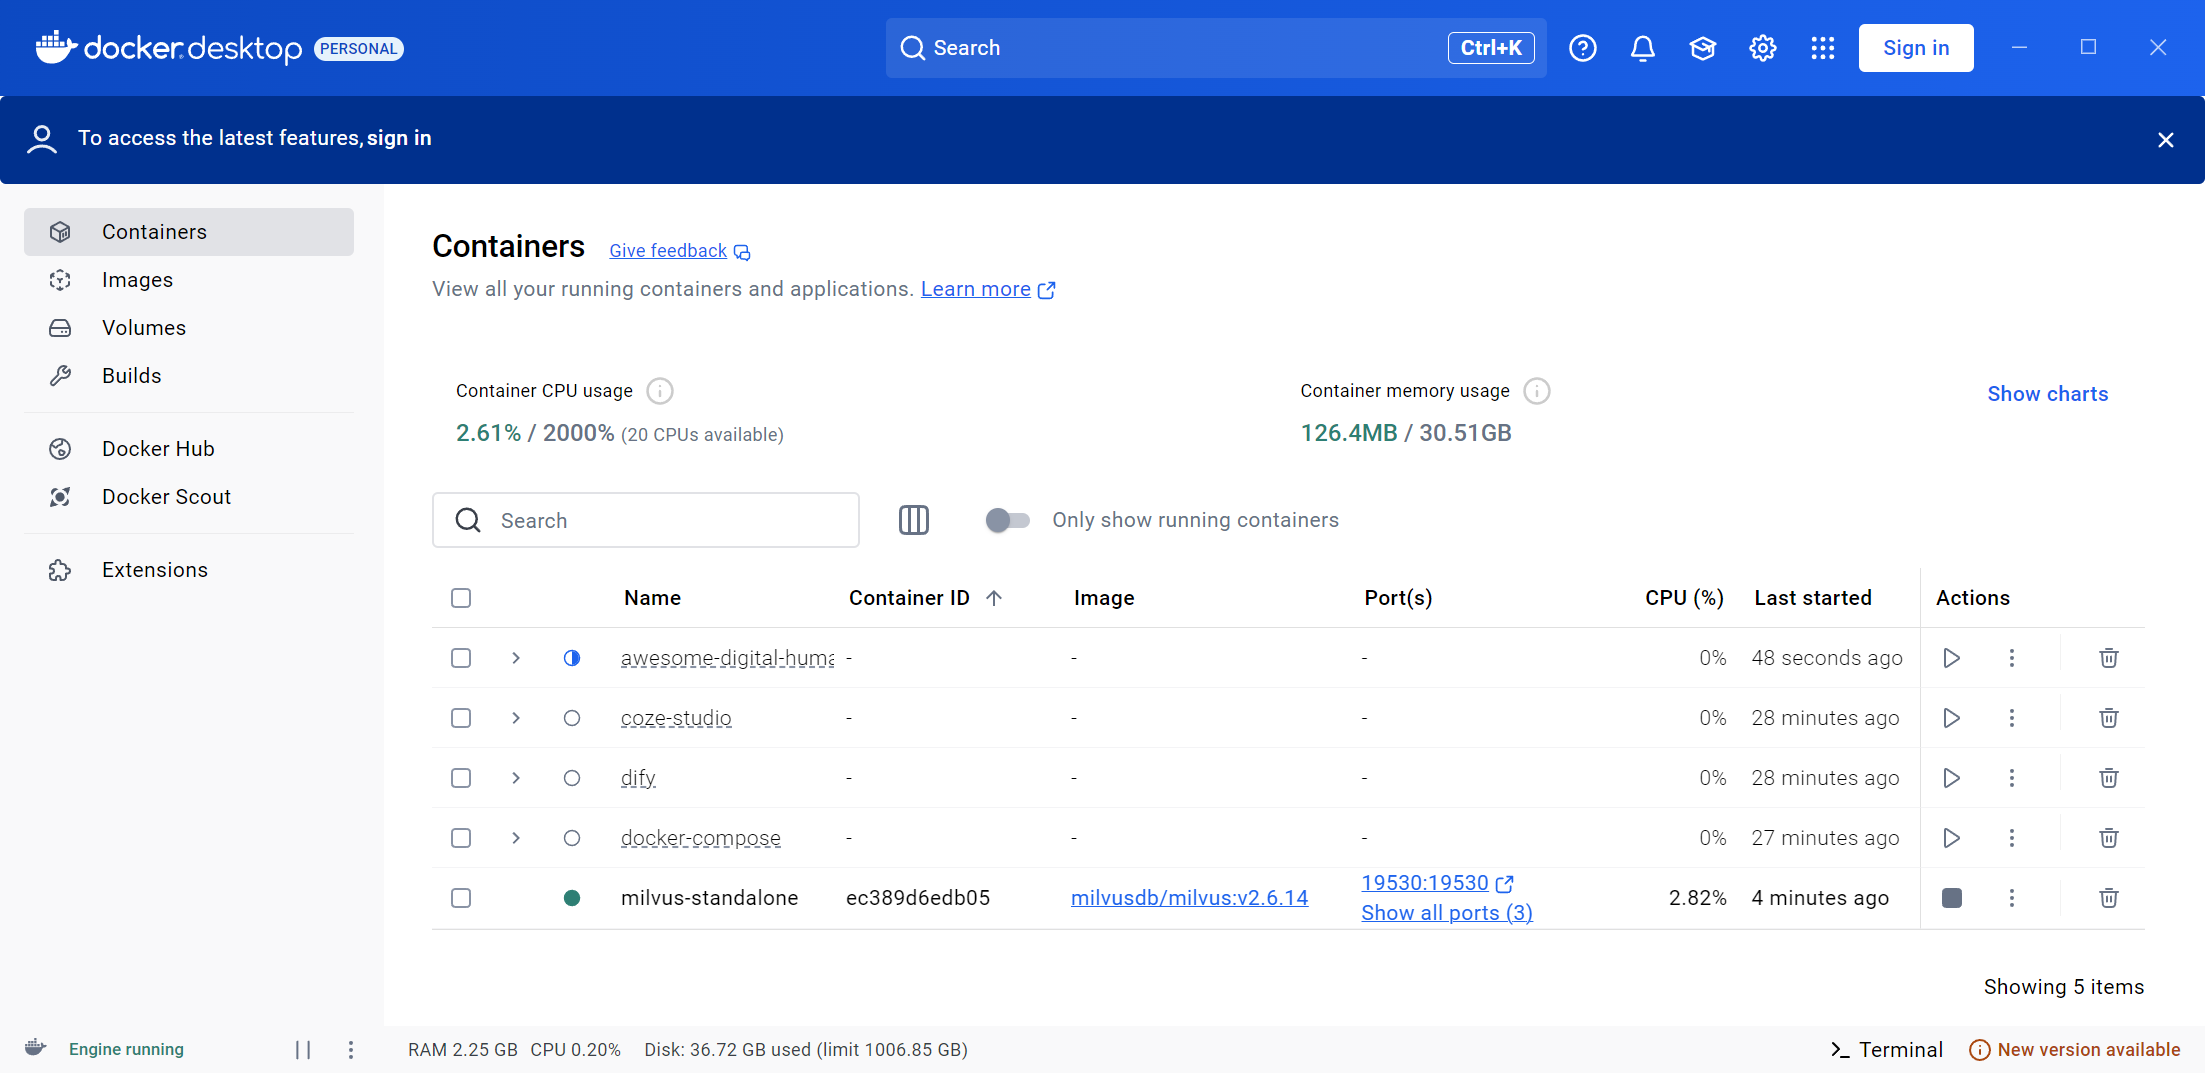
此外,在Docker容器中可见:
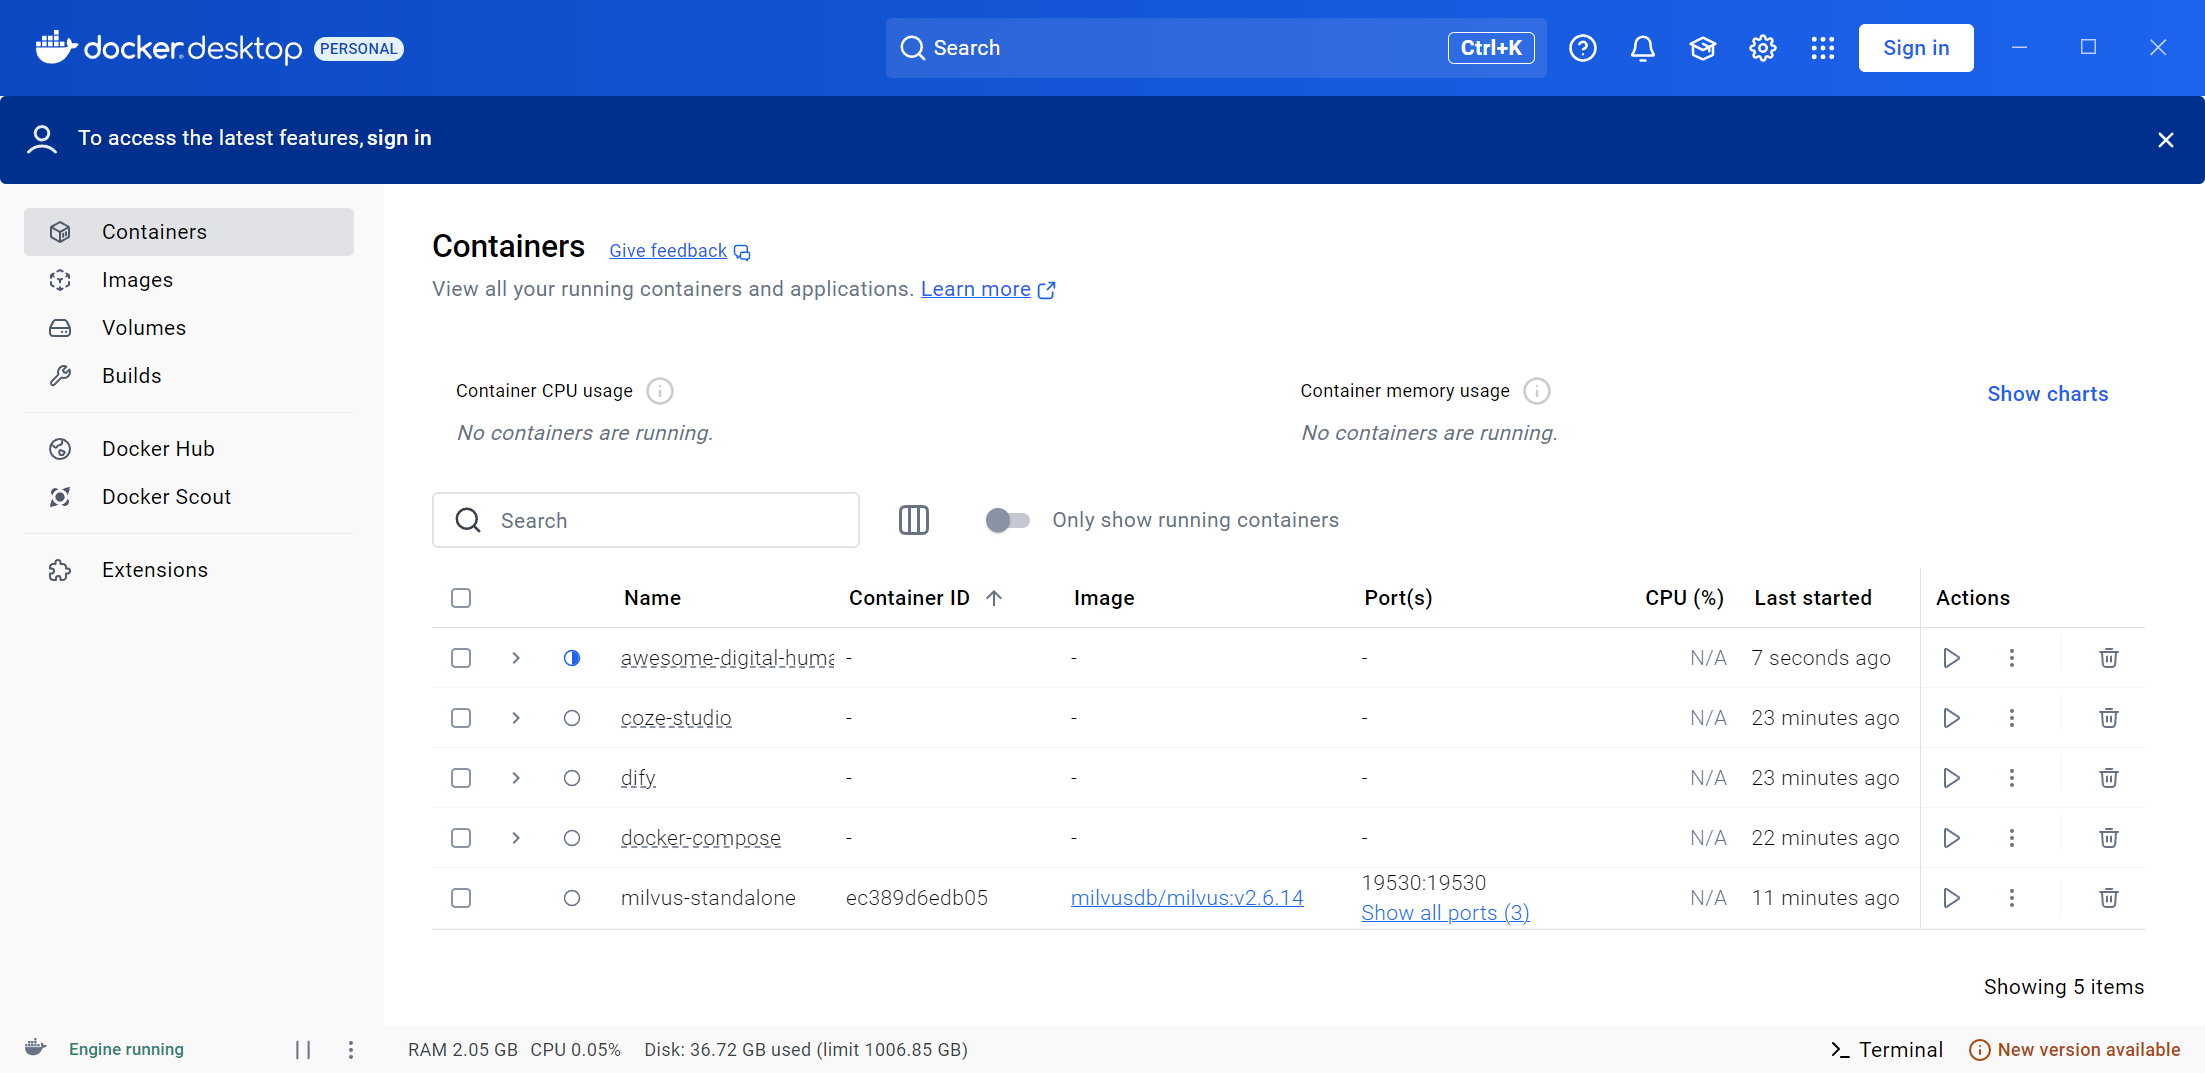
三、测试前准备工作
3.1 确保Milvus已启动
text
(base) PS D:\developToo1s\Milvus> .\standalone.bat start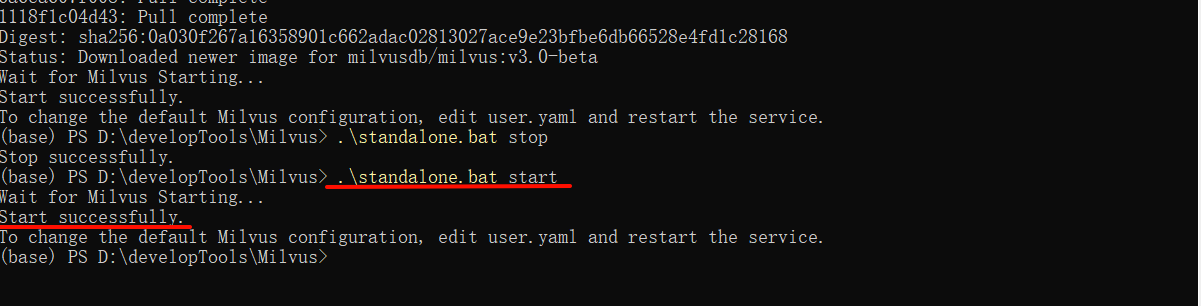
3.2 安装Milvus Python SDK
text
pip install pymilvus # 已在requirements_full.txt文件中安装Milvus Lite已包含在Milvus的Python SDK中,此处不用Milvus Lite,直接访问在docker desktop安装
的、Standalone模式的Milvus服务。
3.3 Milvus数据模型
3.3.1 整体结构
从业务角度,Milvus数据模型层级如下
text
Database -> Collection -> Partition -> EntityDatabase:Milvus 的数据库,用来隔离不同业务数据。
Collection:最核心的逻辑容器,类似于关系型数据库里的 table。
Partition:分区,是 collection 的子集,不是必须手动创建;一个 collection 至少会有默认
partition。
Entity:可以理解为 collection 中的一条记录。类似于关系型数据库的一行数据。
3.3.2 具体说明
在传统数据库中,如果你想存储用户信息,你会建一张表叫 user_table ;想存储商品,会建一张表叫
product_table 。
在向量数据库中,我们要存储的是成千上万个"特征向量"以及它们对应的文本。为了把不同用途的向量
分门别类地存放,我们就要创建不同的 Collection。 比如,COLLECTION_NAME = "docs" 就是给这
张"表"取名叫 docs ,专门用来存放你切分好的文档片段向量。
四、基本用法
4.1 DDL操作
4.1.1 Database
4.1.1.1 查看数据库
- 创建客户端
text
from pymilvus import MilvusClient

client = MilvusClient("http://localhost:19530")- 列出所有数据库
text
existing_dbs = client.list_databases()

print("== Databases ==")
for db in existing_dbs:
    print(db)
输出如下
text
== Databases ==
default
4.1.1.2 创建数据库
text
db_name = "rag_tutorial"

if db_name not in existing_dbs:
    client.create_database(db_name=db_name)
4.1.1.3 删除数据库
text
client.drop_database(db_name=db_name)如果数据库下有Collection则无法删除,需要先删除它的所有Collection才能删除Database
4.1.2 Collection
4.1.2.1 切换数据库
text
client.use_database(db_name=db_name)上述命令的作用等价于关系型数据库中的 use <database>
4.1.2.2 查看数据库下的collections
text
collections = client.list_collections()

print("== Collections ==")
for collection in collections:
    print(collection)
输出如下
text
== Collections ==4.1.2.3 创建collection
text
collection_name = "docs"

client.create_collection(
    collection_name=collection_name,
    dimension=1024,
    metric_type="COSINE"
)
dimension :嵌入向量维度,应和嵌入模型的向量维度保持一致,见下文。
metric_type 表示向量相似度的计算方式,COSINE 表示余弦相似度。
-
当用户提问时,系统会把提问也变成向量,然后去数据库里找"最相似"的本地文本向量。但怎么定
义"相似"呢? 向量数据库需要知道计算规则。COSINE (余弦相似度)关注的是两个向量在方向上
的夹角:
-
如果两个向量方向完全一致(代表文本意思极度接近),余弦值接近 1 。
-
如果方向正交(毫无关系),值接近 0 。
-
结论:在 RAG 检索时,Milvus 会帮你计算用户问题与数据库中所有文本的余弦相似度,并把
得分(Score)从大到小排序,把得分最高(最相似)的前 K 个片段还给你。 (注:除了
COSINE 之外,常见的还有 L2 欧氏距离、IP 内积等。)
-
4.1.2.4 删除collection
text
if client.has_collection(collection_name=collection_name):
    client.drop_collection(collection_name=collection_name)
4.2 DML操作
确保已删除名为docs 的collection,下文会重新创建
4.2.1 准备嵌入模型
选择bge-m3 作为嵌入模型,可以通过硅基流动调用,该模型可以免费调用,如果追求更低的延迟、更
稳定的服务,也可以充值后选择带有pro 前缀的模型,如下所示
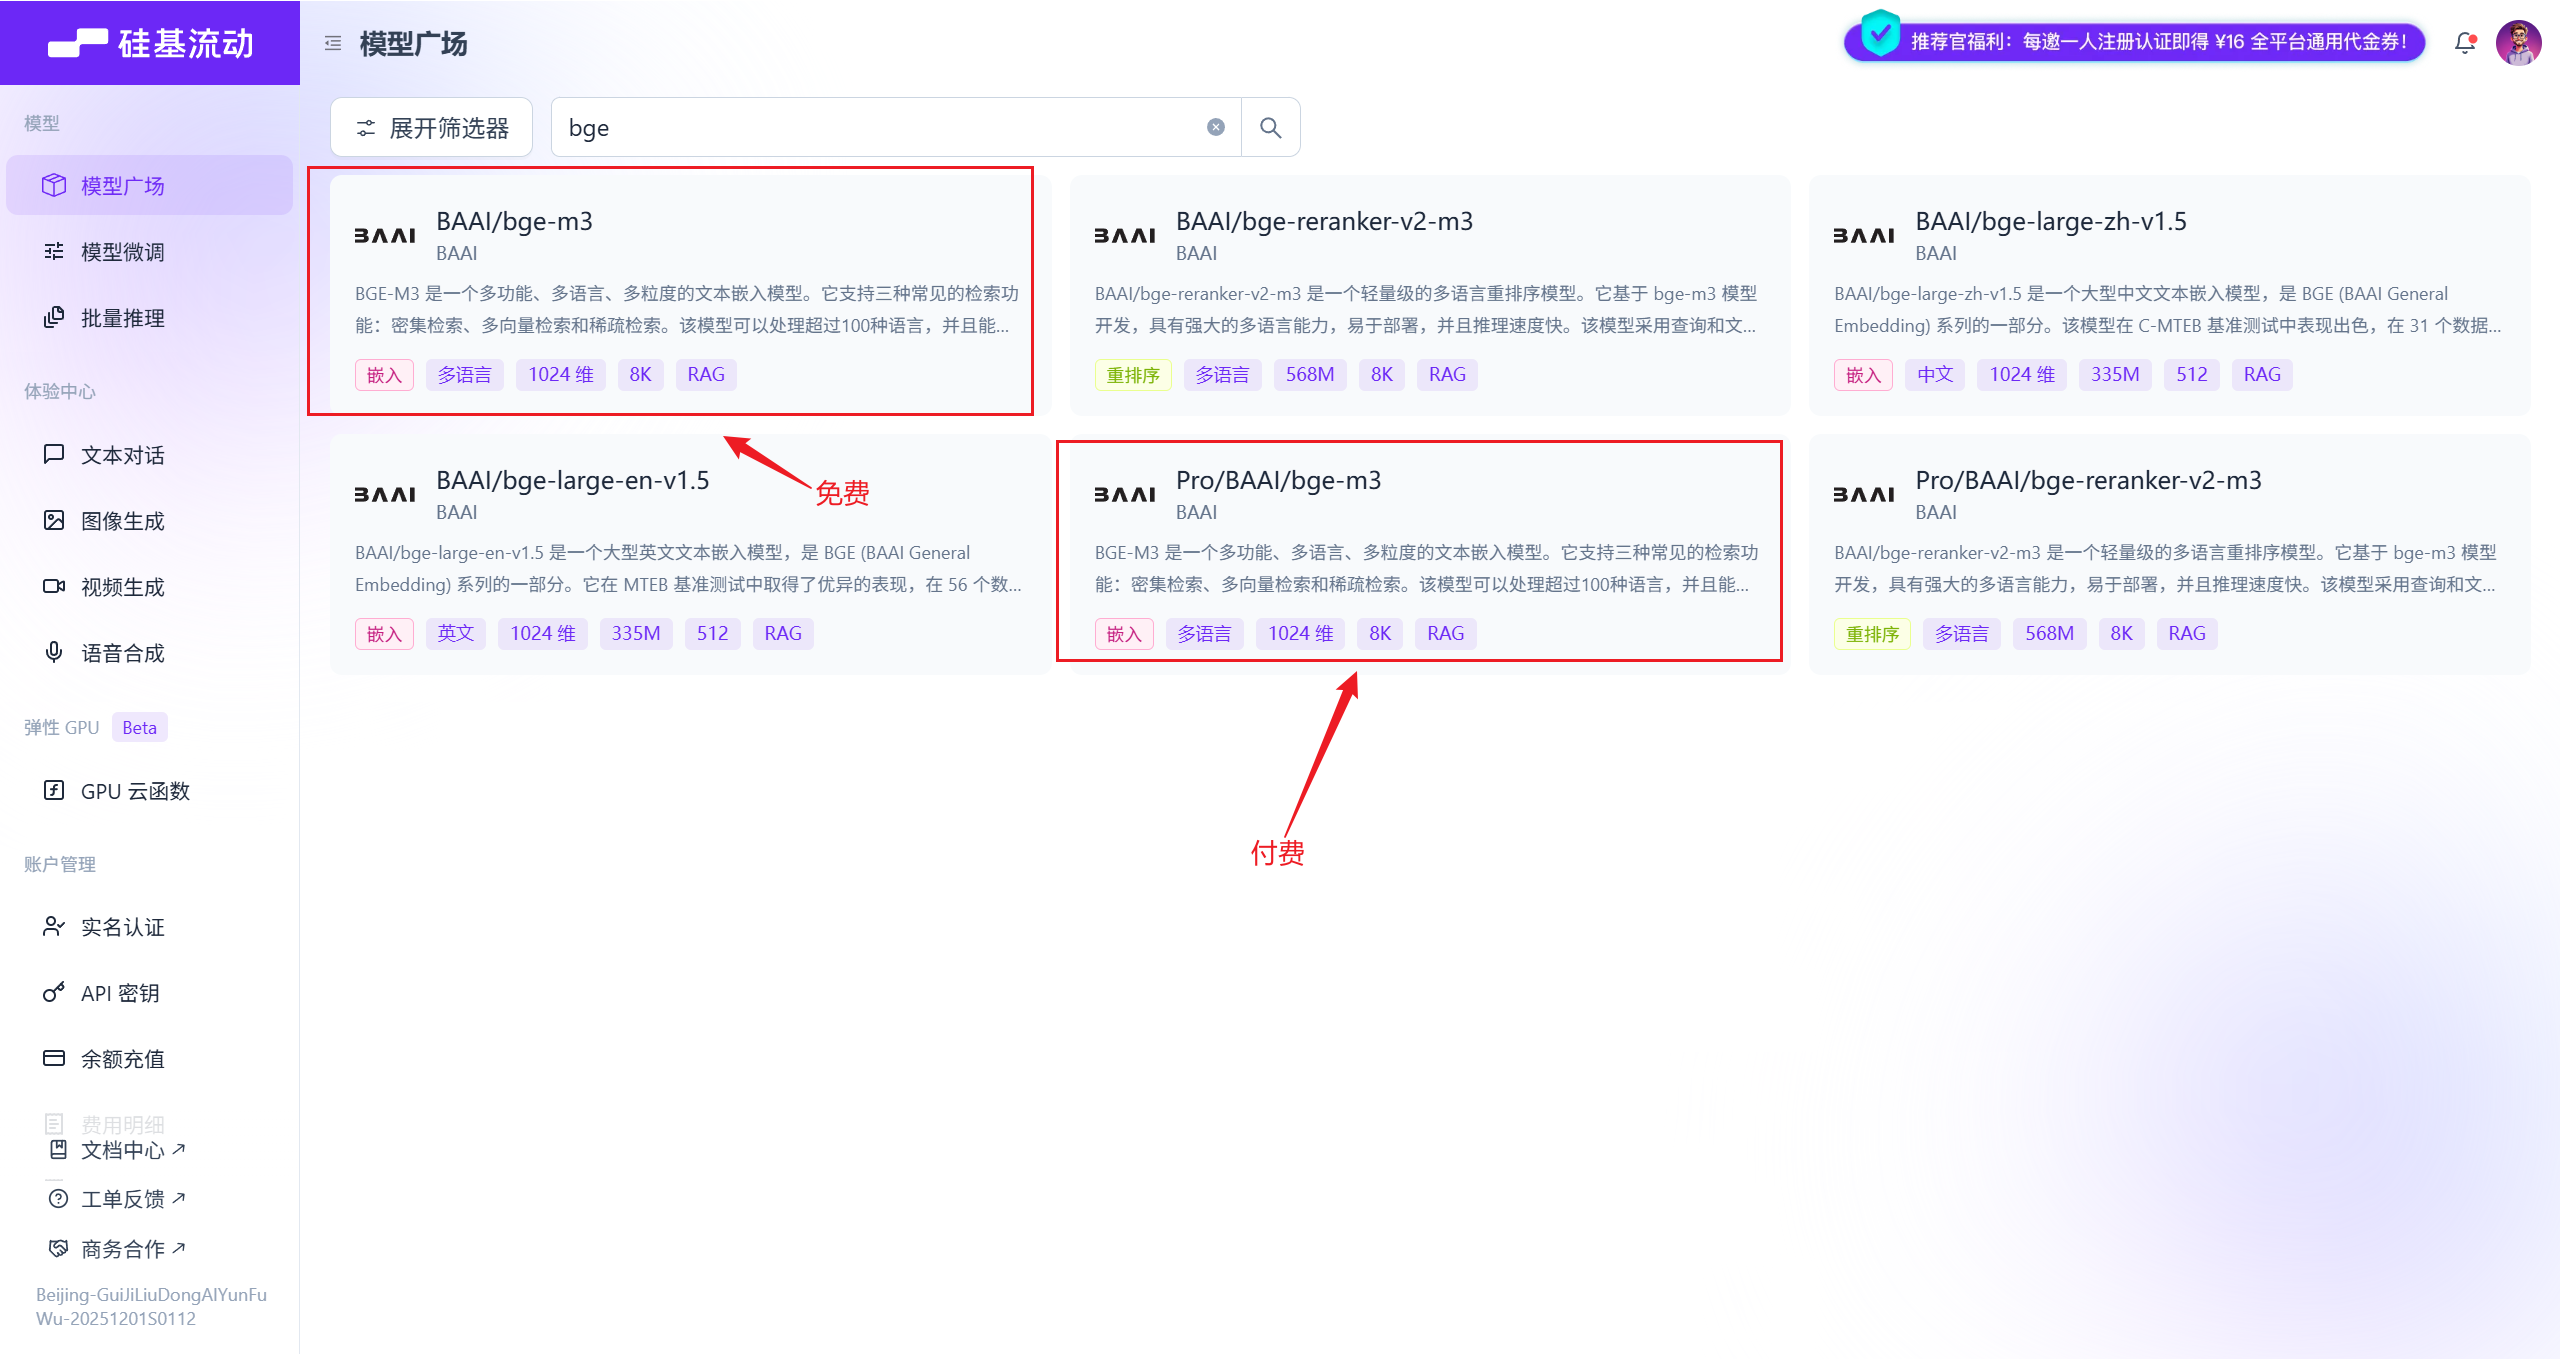
这两款产品的模型是一样的,区别只在于资费和服务保障。
注册后获取硅基流动的API_KEY,写入.env文件
text
SILICONFLOW_BASE_URL=https://api.siliconflow.cn/v1
SILICONFLOW_API_KEY=<YOUR_API_KEY>
准备嵌入模型,代码如下
text
from langchain.embeddings import init_embeddings
import os
from dotenv import load_dotenv

load_dotenv(override=True)

# 初始化嵌入模型
embed_model = init_embeddings(
    model="openai:Pro/BAAI/bge-m3",
    api_key=os.getenv("SILICONFLOW_API_KEY"),
    base_url=os.getenv("SILICONFLOW_BASE_URL"),
)
或者:
text
from langchain_openai import OpenAIEmbeddings
import os
from dotenv import load_dotenv

load_dotenv(override=True)
# 初始化嵌入模型
embed_model = OpenAIEmbeddings(
    model="Pro/BAAI/bge-m3", # 免费模型 ID: BAAI/bge-m3
    base_url=os.getenv("SILICONFLOW_BASE_URL"),
    api_key=os.getenv("SILICONFLOW_API_KEY"),
)
4.2.2 准备collection
4.2.2.1 创建collection
text
client.create_collection(
    collection_name=collection_name,
    dimension=1024,
    metric_type="COSINE"
)
根据模型维度,创建匹配的collection。
4.2.2.2 查看collection元数据
text
from rich import print as rprint

# 查看 collection 元数据
metadata = client.describe_collection(
    collection_name=collection_name,
)

rprint(metadata)
输出如下
text
{
 'collection_name': 'docs',
 'auto_id': False,
 'num_shards': 1,
 'description': '',
 'fields': [
     {
         'field_id': 100,
         'name': 'id',
         'description': '',
         'type': <DataType.INT64: 5>,
         'params': {},
         'is_primary': True
     },
     {
         'field_id': 101,
         'name': 'vector',
         'description': '',
         'type': <DataType.FLOAT_VECTOR: 101>,
         'params': {'dim': 1024}
     }
 ],
 'functions': [],
 'aliases': [],
 'collection_id': 467030880814894392,
 'consistency_level': 2,
 'properties': {'timezone': 'UTC'},
 'num_partitions': 1,
 'enable_dynamic_field': True,
 'enable_namespace': False,
 'created_timestamp': 467030999785013266,
 'update_timestamp': 467030999785013266
}
我们在创建collection时没有指定schema,后者可以理解为表结构,此时Milvus会将collection定义为默
认结构。字段信息如下
-
id :数据ID,作为主键唯一标识数据
-
vector :数据的嵌入向量
此外,enable_dynamic_field 为True ,这表示 collection 支持动态字段。也就是说,除了预定义的
id 和 vector 字段之外,在插入数据时还可以携带其他未提前声明的字段,这些字段会被自动写入
并统一存储在动态字段中。这样做的好处是能够在不修改 schema 的情况下,灵活保存额外的业务属
性,例如文本内容、标签、时间戳或来源信息等,适合字段结构不固定的场景。
4.2.3 准备数据
4.2.3.1 准备原始数据
text
# 准备测试数据
texts = [
    "LangChain 是一个用于构建 LLM 应用的开发框架。",
    "Milvus 是一个适合 AI 应用的向量数据库。",
    "RAG 的核心是先检索相关知识,再让大模型生成答案。",
    "Docker Desktop 可以方便地在本地运行 Milvus Standalone。"
]
4.2.3.2 生成嵌入向量
text
vectors = embed_model.embed_documents(texts)4.2.3.3 查看生成的嵌入向量
text
print(len(vectors))
print(len(vectors[0]))
print(vectors[0][:5])
输出如下
text
4
1024
[-0.027955636382102966, 0.052097633481025696, 0.042480628937482834, 0.0016073246952146292, 0.030923642218112946]
4.2.3.4 封装为可以插入的数据格式
由上可知,collection需要id字段作为主键唯一标识数据,需要vector字段存储嵌入向量,其余字段
可以按需添加。
text
data = [
    {"id": i, "vector": vectors[i], "text": texts[i], "source": "demo"}
    for i in range(len(texts))
]
4.2.4 写入数据
4.2.4.1 插入数据
text
# 插入数据
insert_res = client.upsert(
    collection_name=collection_name,
    data=data
)
print("insert result:", insert_res)
upsert可以保证幂等写入,即主键相同时覆盖
输出如下
text
insert result: {'upsert_count': 4, 'ids': [0, 1, 2, 3]}4.2.4.2 手动flush
text
# 手动 flush
client.flush(collection_name=collection_name)
Milvus不会第一时间将数据落盘,要看到写入效果,我们手动flush,将数据刷写到磁盘
4.2.4.3 查看collection统计信息
text
# 查看 collection 统计
stats = client.get_collection_stats(collection_name=collection_name)
print("collection stats:", stats)
输出如下
text
collection stats: {'row_count': 4}4.3 DQL操作
4.3.1 扫描数据
通过query_iterator 扫描collection下的所有数据
text
it = client.query_iterator(
    collection_name=collection_name,
    batch_size=100,
    filter="",                     # 不加过滤 = 扫全部
    output_fields=["*"]            # 你的显式 schema 字段
)

i = 0
while True:
    rows = it.next()
    if not rows:
        break
    for row in rows:
        print("=" * 30, f'-> 第{i + 1}条 <-', "=" * 30)
        print(row)
        print("=" * 30, f'-> 第{i + 1}条 <-', "=" * 30)
        i += 1

it.close()
输出如下
text
============================== -> 第1条 <- ==============================
{'id': 0, 'vector': [0.06801506131887436, 0.06247688829898834, ......], 'text': 'LangChain 是一个用于构建 LLM 应用的开发框架。', 'source': 'demo'}
============================== -> 第1条 <- ==============================
============================== -> 第2条 <- ==============================
{'id': 1, 'vector': [0.03384151682257652, 0.057637207210063934, ......], 'text': 'Milvus 是一个适合 AI 应用的向量数据库。', 'source': 'demo'}
============================== -> 第2条 <- ==============================
============================== -> 第3条 <- ==============================
{'id': 2, 'vector': [-0.009978039190173149, 0.09607630968093872, ......], 'text': 'RAG 的核心是先检索相关知识,再让大模型生成答案。', 'source': 'demo'}
============================== -> 第3条 <- ==============================
============================== -> 第4条 <- ==============================
{'id': 3, 'vector': [0.027756735682487488, 0.11396646499633789, ......], 'text': 'Docker Desktop 可以方便地在本地运行 Milvus Standalone。', 'source': 'demo'}
============================== -> 第4条 <- ==============================
4.3.2 通过主键查询数据
text
# 查询
res = client.get(
    collection_name=collection_name,
    ids=[0, 1, 2, 3],
)

print(len(res))

for i in range(len(res)):
    print("=" * 30, f'-> 第{i + 1}条 <-', "=" * 30)
    print(res[i])
    print("=" * 30, f'-> 第{i + 1}条 <-', "=" * 30)
输出如下
text
4
============================== -> 第1条 <- ==============================
{'id': 0, 'vector': [0.06801506131887436, 0.06247688829898834, 0.1035236120223999, -0.030978884547948837, 0.004772709216922522, ......], 'text': 'LangChain 是一个用于构建 LLM 应用的开发框架。', 'source': 'demo'}
============================== -> 第1条 <- ==============================
============================== -> 第2条 <- ==============================
{'id': 1, 'vector': [0.03384151682257652, 0.057637207210063934, 0.07520284503698349, 0.0011678006267175078, 0.013201077468693256, ......], 'text': 'Milvus 是一个适合 AI 应用的向量数据库。', 'source': 'demo'}
============================== -> 第2条 <- ==============================
============================== -> 第3条 <- ==============================
{'id': 2, 'vector': [-0.009978039190173149, 0.09607630968093872, 0.029030004516243935, 0.005278652533888817, 0.022045450285077095, ......], 'text': 'RAG 的核心是先检索相关知识,再让大模型生成答案。', 'source': 'demo'}
============================== -> 第3条 <- ==============================
============================== -> 第4条 <- ==============================
{'id': 3, 'vector': [0.027756735682487488, 0.11396646499633789, 0.04289725795388222, -0.043288204818964005, -0.029911866411566734, ......], 'text': 'Docker Desktop 可以方便地在本地运行 Milvus Standalone。', 'source': 'demo'}
============================== -> 第4条 <- ==============================
4.3.3 相似度检索
4.3.3.1 准备查询嵌入
text
# 相似度检索
query = "什么是向量数据库?"
query_vector = embed_model.embed_query(query)
4.3.3.2 检索
text
results = client.search(
    collection_name=collection_name,
    data=[query_vector],   # Milvus search 这里仍然要传二维列表
    limit=3,
    output_fields=["text", "source"]
)

print("=== search results ===")
for hit in results[0]:
    print(hit)
limit 表示检索结果最多保留几条数据
output_fields 表示输出的实体中展示哪些字段。
结果如下
text
=== search results ===
{'id': 0, 'distance': 0.5897263884544373, 'entity': {'text': 'LangChain 是一个用于构建 LLM 应用的开发框架。', 'source': 'demo'}}
{'id': 1, 'distance': 0.5572514533996582, 'entity': {'text': 'Milvus 是一个适合 AI 应用的向量数据库。', 'source': 'demo'}}
{'id': 2, 'distance': 0.50614333152771, 'entity': {'text': 'RAG 的核心是先检索相关知识,再让大模型生成答案。', 'source': 'demo'}}