全球权威 AI 基准测评组织 MLCommons 在9月正式发布 MLPerf Storage v3.0 结果。泛联分布式全闪存存储 UbiPower 18000 完成了 Checkpointing、Training、KV Cache 三大类共 10 个场景的全部测试。按每 U 归一化性能统计,在 10 个场景中斩获 8 项第一,26 项测试指标中拿下 15 项第一。在重点考验系统读写吞吐能力的 Checkpoint 场景下,UbiPower 18000 在 Llama3-450B、Llama3-1250B 两项大模型测试中,读写带宽双双登顶。
 Checkpoint:守护大模型训练成果,AI 存储性能的试金石
GPU大模型训练是以周、月为单位的长跑。训练过程中一旦硬件掉电、网络抖动或软件故障,从头重启训练的代价极高。Checkpoint(检查点)正是这套容错机制的核心:训练会周期性地将模型参数、优化器状态和训练进度生成完整快 照写入存储;任务一旦中断,即可从最近的检查点恢复,无需归零重启 。
模型越大,这份"快照"的数据体量就越大,存储将承受巨大的写入与恢复压力。参考本次 MLPerf Storage 测试覆盖的模型规模:
-
405B 参数级,单次 Checkpoint 约 5.29TB
-
1250B 参数级,单次 Checkpoint 高达约 18TB
这意味着,每次保存或恢复都要处理数 TB 级的高并发读写。如果存储带宽不足、延迟过高,成百上千张 GPU 会被迫暂停计算,等待数据落盘或重载;GPU 空转的每一秒,都在消耗高昂的算力成本。因此,Checkpoint 场景对存储性能的核心诉求就是持续高带宽------快照写得越快、任务恢复读得越快,GPU 空闲等待存储的时间就越短,算力利用率也就越高。
读写带宽双登顶:在千亿、万亿级负载上拿下第一
MLPerf Storage 由国际非营利组织 MLCommons 联合全球头部存储厂商与科研机构共同制定,具备开源、规则统一、结果可复现的特点。所有厂商基于同一套测试脚本、同一类 I/O 负载开展评测;全部提交结果必须遵守 MLPerf 规则,公开硬件配置与实现细节,接受社区公开审计。
Checkpoint 测试场景专门模拟大模型训练过程中检查点保存与恢复业务负载,重点考察读写高带宽能力。泛联在该场景下取得每 U 归一化读写带宽参评第一的成绩。
- Llama3-450B 测试:每 U 写入带宽 48.96 GiB/s、每 U 读取带宽 76.6 GiB/s
- Llama3-1250B 测试:每 U 写入带宽 48.93 GiB/s、每 U 读取带宽 76.99 GiB/s
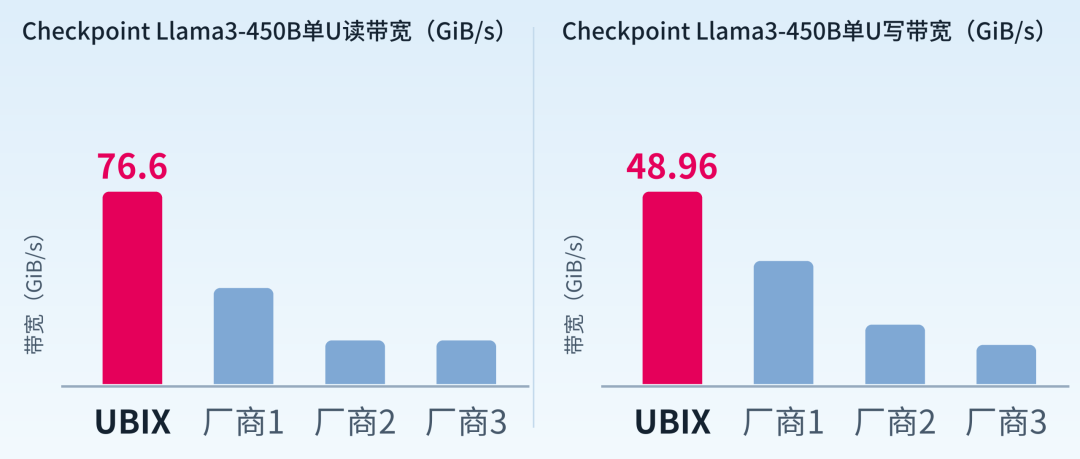
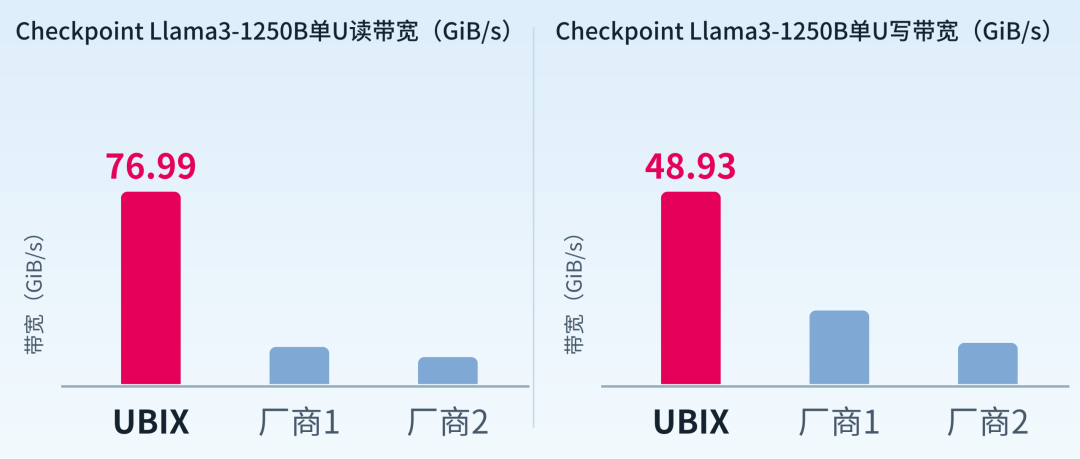
值得注意的是:参数规模越大,Checkpoint 的数据体量、并发写入压力也随之攀升,对存储系统是双重考验。而泛联正是在 450B、1250B 这类超大参数模型下取得该成绩------这印证了 UbiPower 18000 的实战能力并不止步于中小规模训练,在超大规模、高压负载场景下同样经得住考验。
登顶背后的关键技术
优异测试成绩,来源于 UbiPower 18000 软件栈到资源调度两处底层设计,核心目标是让数据以最短路径、最少开销直达存储介质。
其一,全用户态 + RDMA 直通。传统存储数据通路要经过内核块层、文件系统、页缓存和系统调用,每一层都会引入额外开销与延迟。UbiPower 18000 将完整存储协议栈运行在用户态,配合 RDMA 网络直通实现零拷贝,数据无需在用户态、内核态反复搬运,绝大部分带宽因此能直接用于业务读写,同时也大幅降低了 CPU 在数据搬运上的开销。
其二,专核专用,关键路径免锁。存储节点按任务类型对 CPU 核心做隔离,协议解析、IO 调度、元数据处理、数据落盘各自绑定专属核心,互不抢占资源;关键 IO 路径采用无锁设计,避免多线程频繁竞争锁、反复切换上下文所带来的损耗。这样一来,CPU 算力不再耗在任务排队和资源协调上,而是全部转化为稳定、持续的带宽输出。
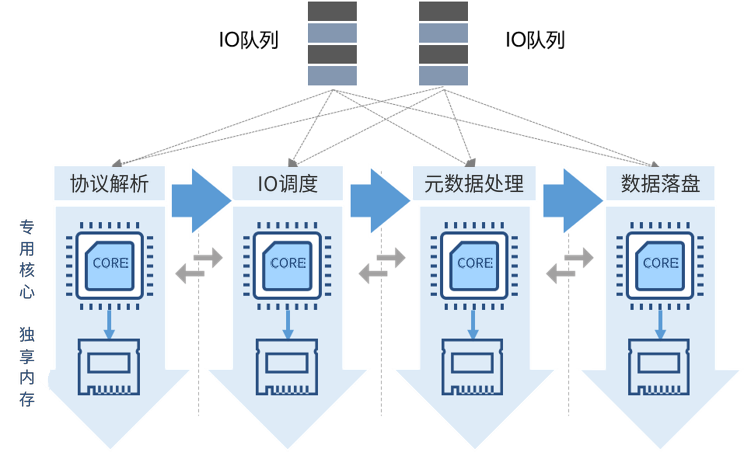
一个做减法、一个做隔离,叠加起来的效果就是:实测带宽可以逼近物理链路极限,而非被软件开销消耗。更重要的是,传统架构中的锁竞争、上下文切换、内核态数据拷贝等开销,通常随并发压力升高呈非线性增长;而 UbiPower 18000 从架构层面消除了这些瓶颈,带宽表现不会随负载上升而明显衰减。这也解释了为什么在模型参数规模与并发压力越高的场景下,其性能优势越明显。
高性能 Checkpoint 的价值
存储性能并非孤立指标,它直接决定算力的"含金量"。
Checkpoint 期间,整个集群的 GPU 都在等待存储。存储越快,这个窗口越短,GPU 的有效训练时间越长。举一个直观的例子:执行 Checkpoint 时,整个集群的 GPU 都会等待存储完成 IO。存储带宽越高,快照读写耗时就越短,GPU 的有效训练时间就越长。我们可以做一笔简单测算:
- 测算示例:以千卡规模 AI 集群、同步式 Checkpoint(即写入期间训练暂停、GPU 处于等待状态)为例,每 4 小时执行一次 Checkpoint。若单次写入耗时从 30 分钟缩短至 10 分钟,单卡 GPU 每日可夺回约 2 小时有效训练时间;整个集群每日相当于额外获得约 2000 GPU 小时的有效算力。
读取带宽的提升同样具备巨大价值:故障发生后模型恢复速度更快,训练中断带来的损失被进一步降低。GPU 利用率提升后,同等算力投入可以产出更多 Token,单位模型训练成本随之下降。
在算力供给紧张、训练成本居高不下的当下,GPU 利用率已经是比 GPU 卡数量更关键的核心竞争力。Checkpoint 场景的优异测试成绩,印证了一个容易被忽视的事实:存储系统,同样是决定 AI 训练效率的关键变量。
UbiPower 18000 在 MLPerf Storage v3.0 Checkpoint 场景中,于 Llama3-450B、Llama3-1250B 大参数模型下实现每 U 读写带宽双第一。
这一成绩得益于用户态 + RDMA 直通、专核专用等底层设计,使带宽接近物理链路极限,并在负载升高时保持稳定。对千卡、万卡集群而言,这意味着更短的 Checkpoint 等待时间、更高的 GPU 利用率和更低的训练成本。此公开可复现的测试成绩可作为相关场景的选型参考。