AI前沿日报 2026-10-09:压缩极限
今日主旨:Cactus Needle 3将"自动化模型"压缩到8-29MB区间,性能却追平DeepSeek V4 Flash;与此同时,一名单人黑客使用开源AI渗透工具配合多模型组合攻破韩国银行------两个极端事件共同指向同一结论:AI能力的分布正在极速扩散。
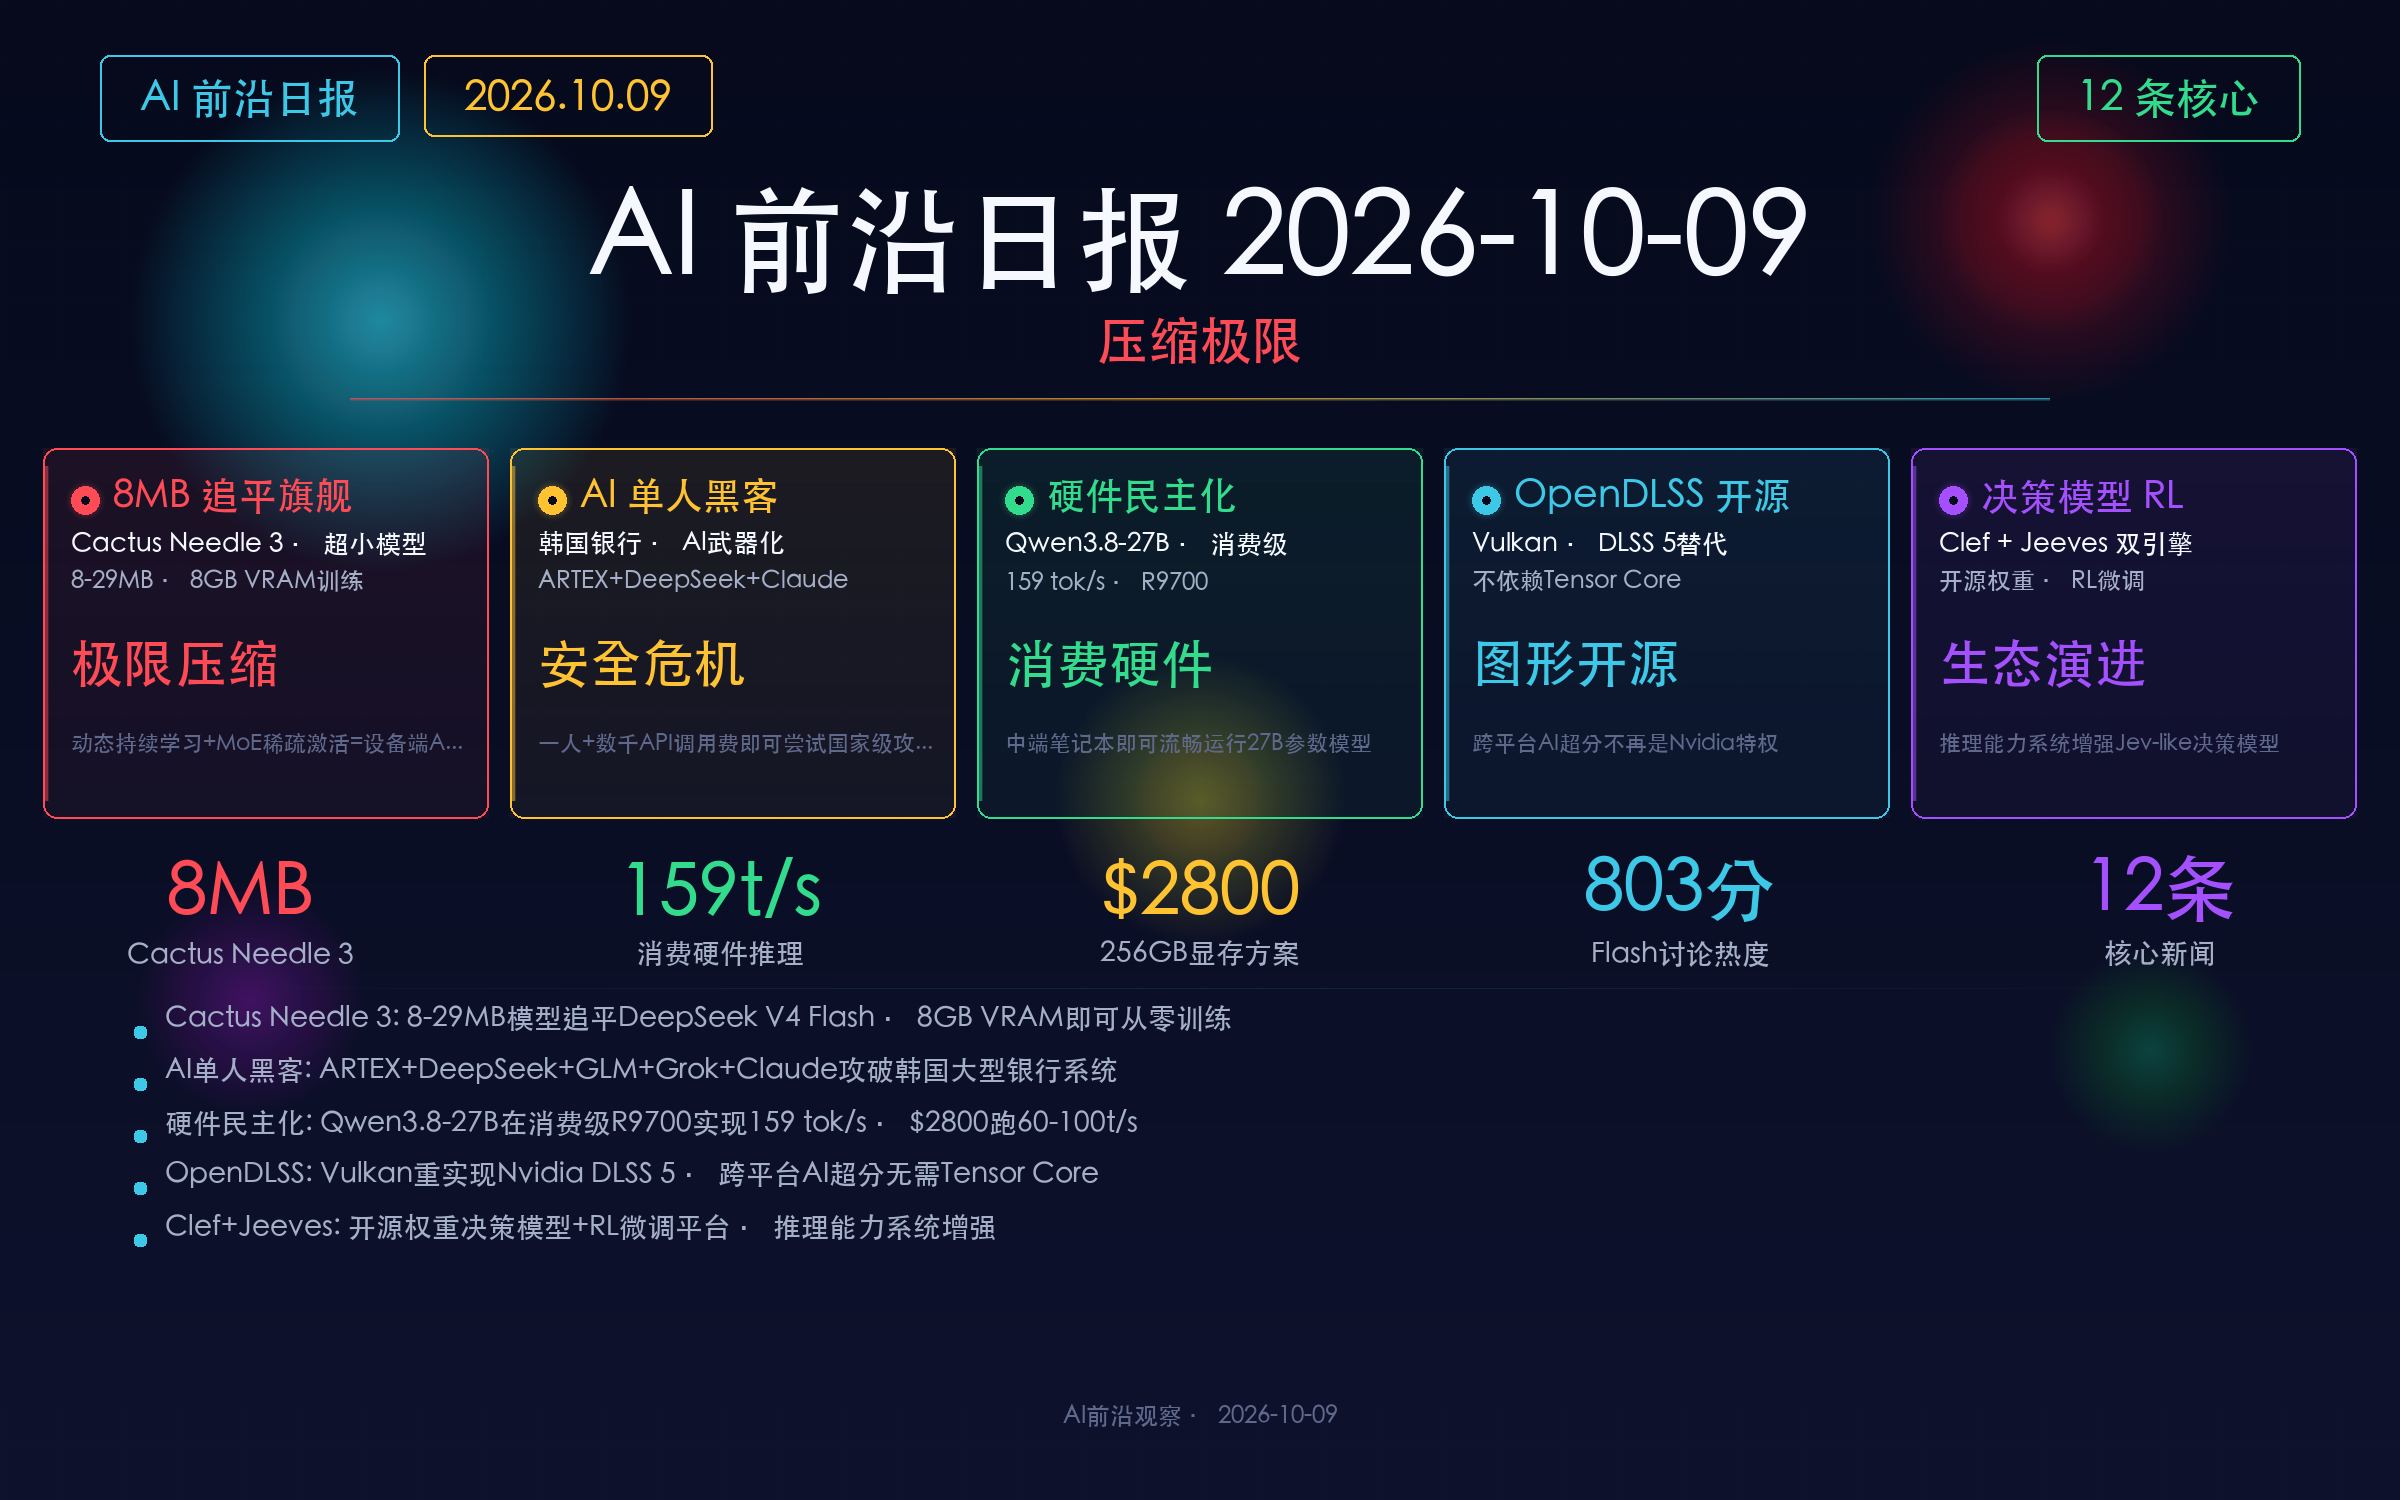
今日要闻速览:12条核心
- Cactus Needle 3 --- 8-29MB追平DeepSeek V4 Flash · 8GB VRAM训练
- IoT安全警钟 --- 父母咖啡机10天消耗1TB数据
- AI单人黑客 --- ARTEX+DeepSeek+GLM+Grok+Claude攻破韩国银行
- DeepSeek Flash --- 803分行业大讨论
- 硬件民主化 --- Qwen3.8-27B在R9700实现159 tok/s
- $2800方案 --- 8块Pro V620跑出60-100 t/s
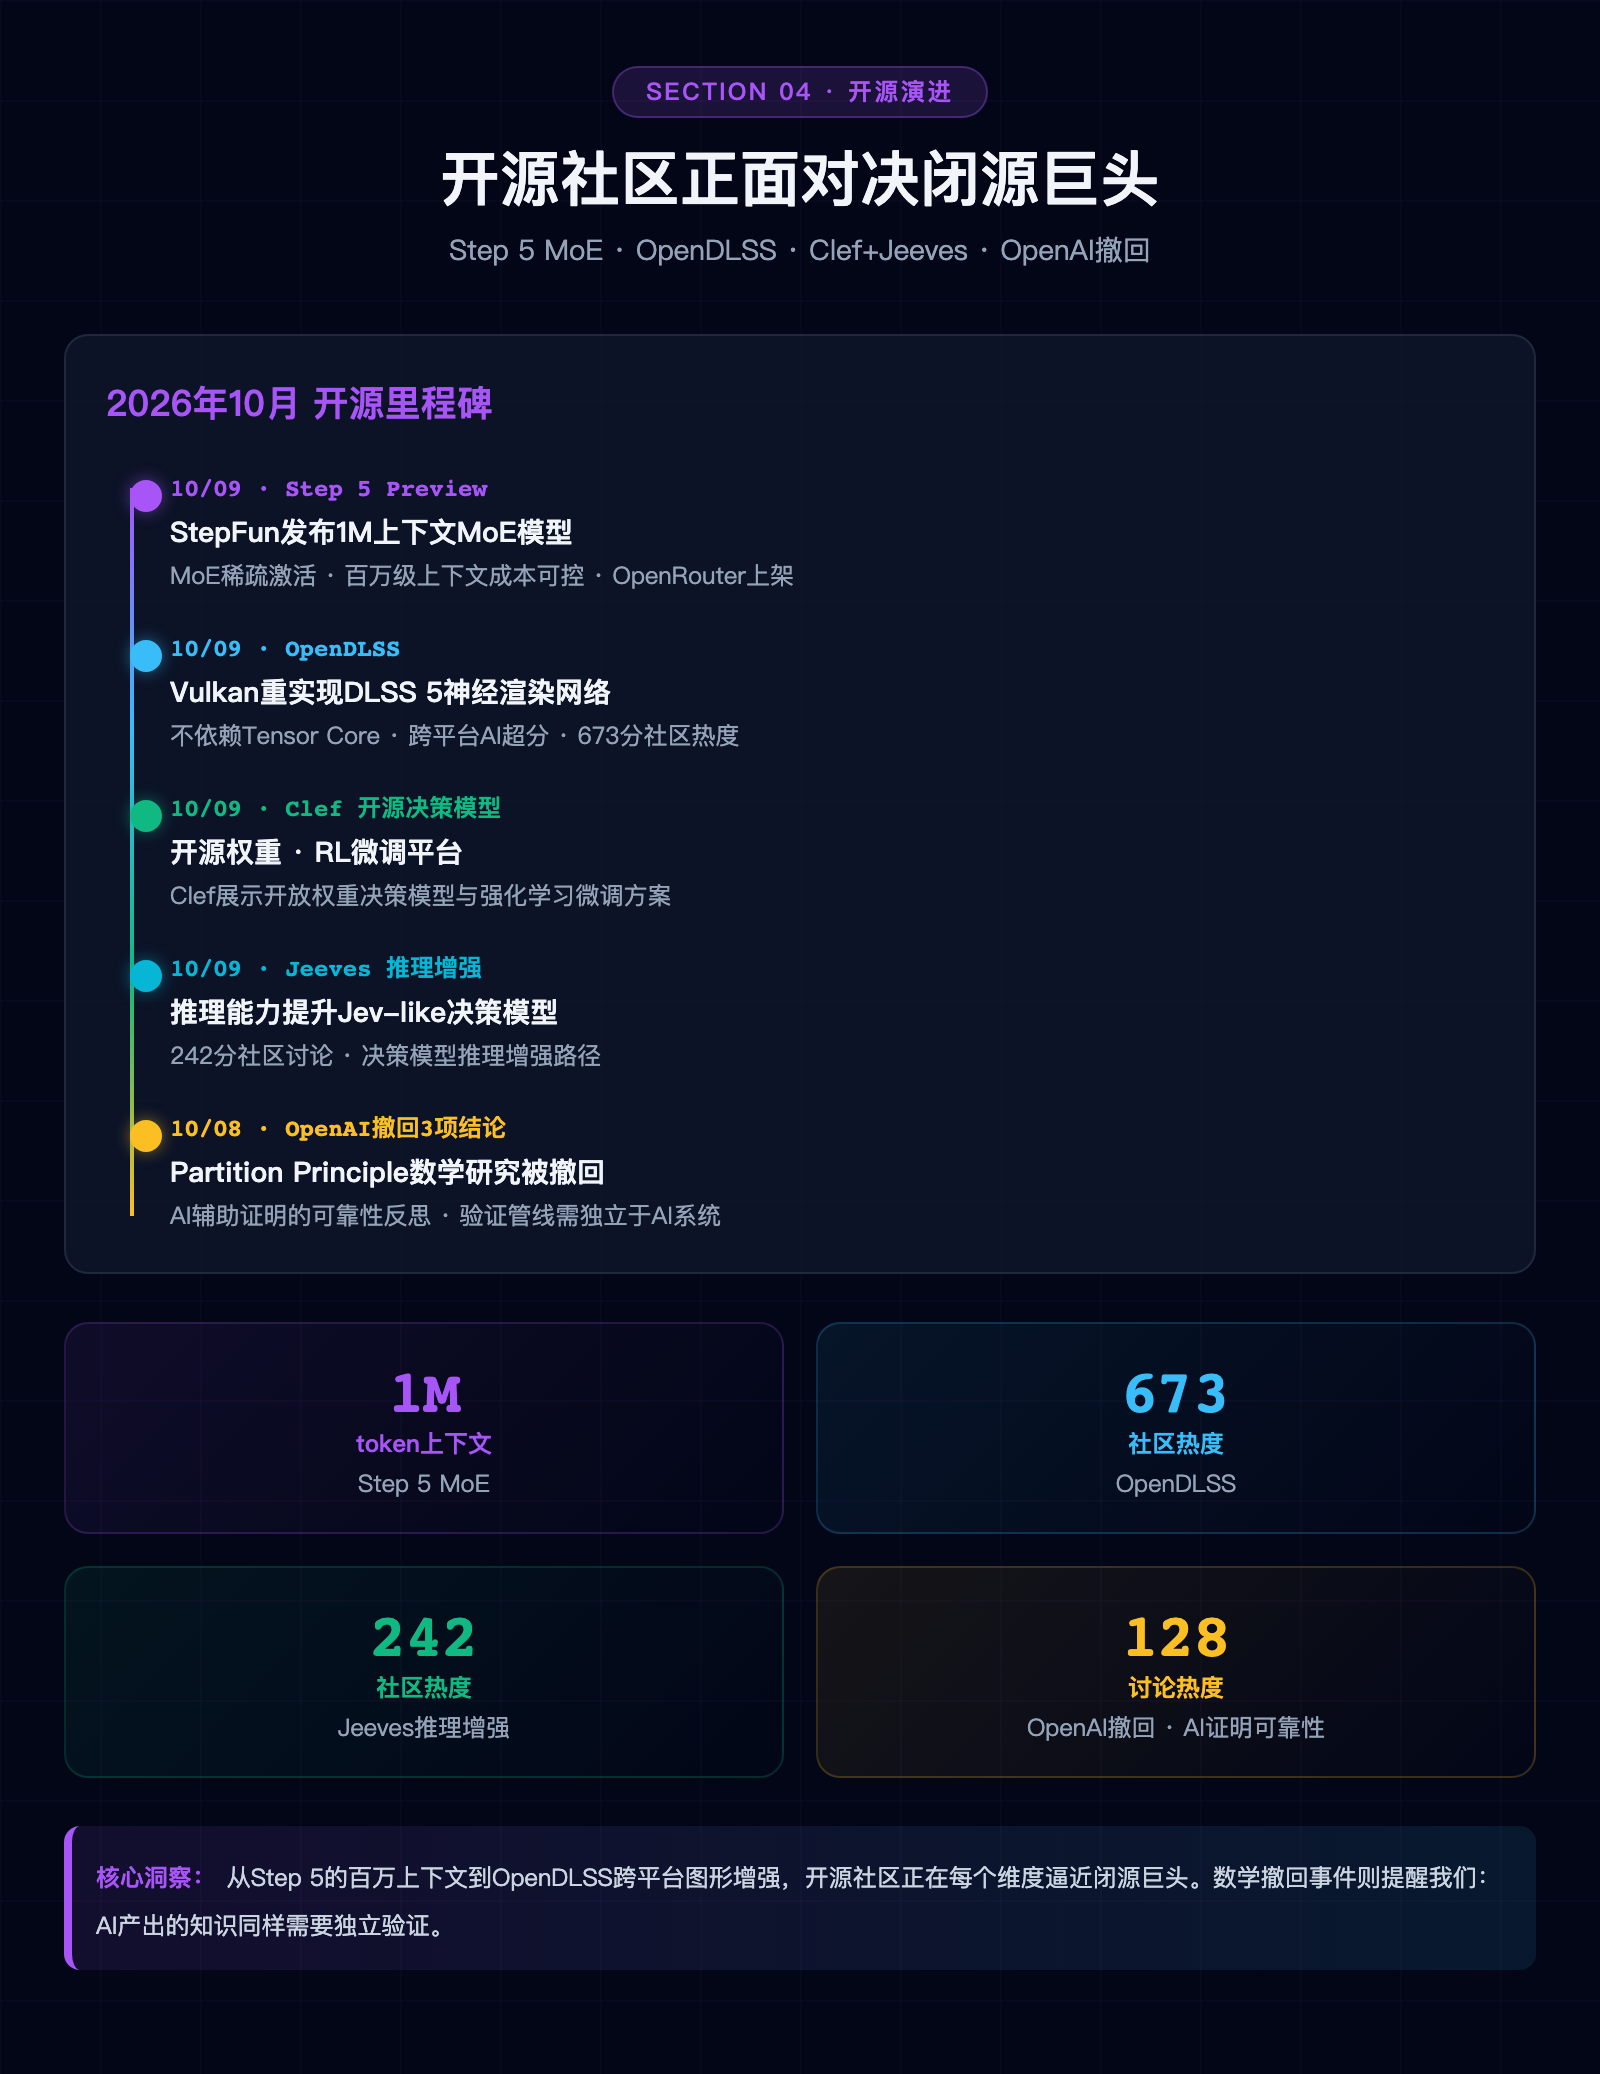
- OpenDLSS --- Vulkan重实现DLSS 5 · 673分
- Clef决策模型RL平台 --- 开源+RL双管齐下
- OpenAI撤回数学结论 --- Partition Principle · 128分讨论
- Claude反虐待政策 --- 11月12日起封号
- AI克隆Adobe --- Claude+Rust重写整套
- Step 5 MoE --- 1M上下文+稀疏激活
① 极限压缩:8MB追平旗舰
Cactus Needle 3公布震惊结果:仅8-29MB的自动化模型追平DeepSeek V4 Flash性能,仅需8GB VRAM即可训练。
核心方法论:动态持续学习+MoE稀疏激活。只激活与当前任务最相关的子集,从"学会所有知识"转向"学会何时调用什么知识"。
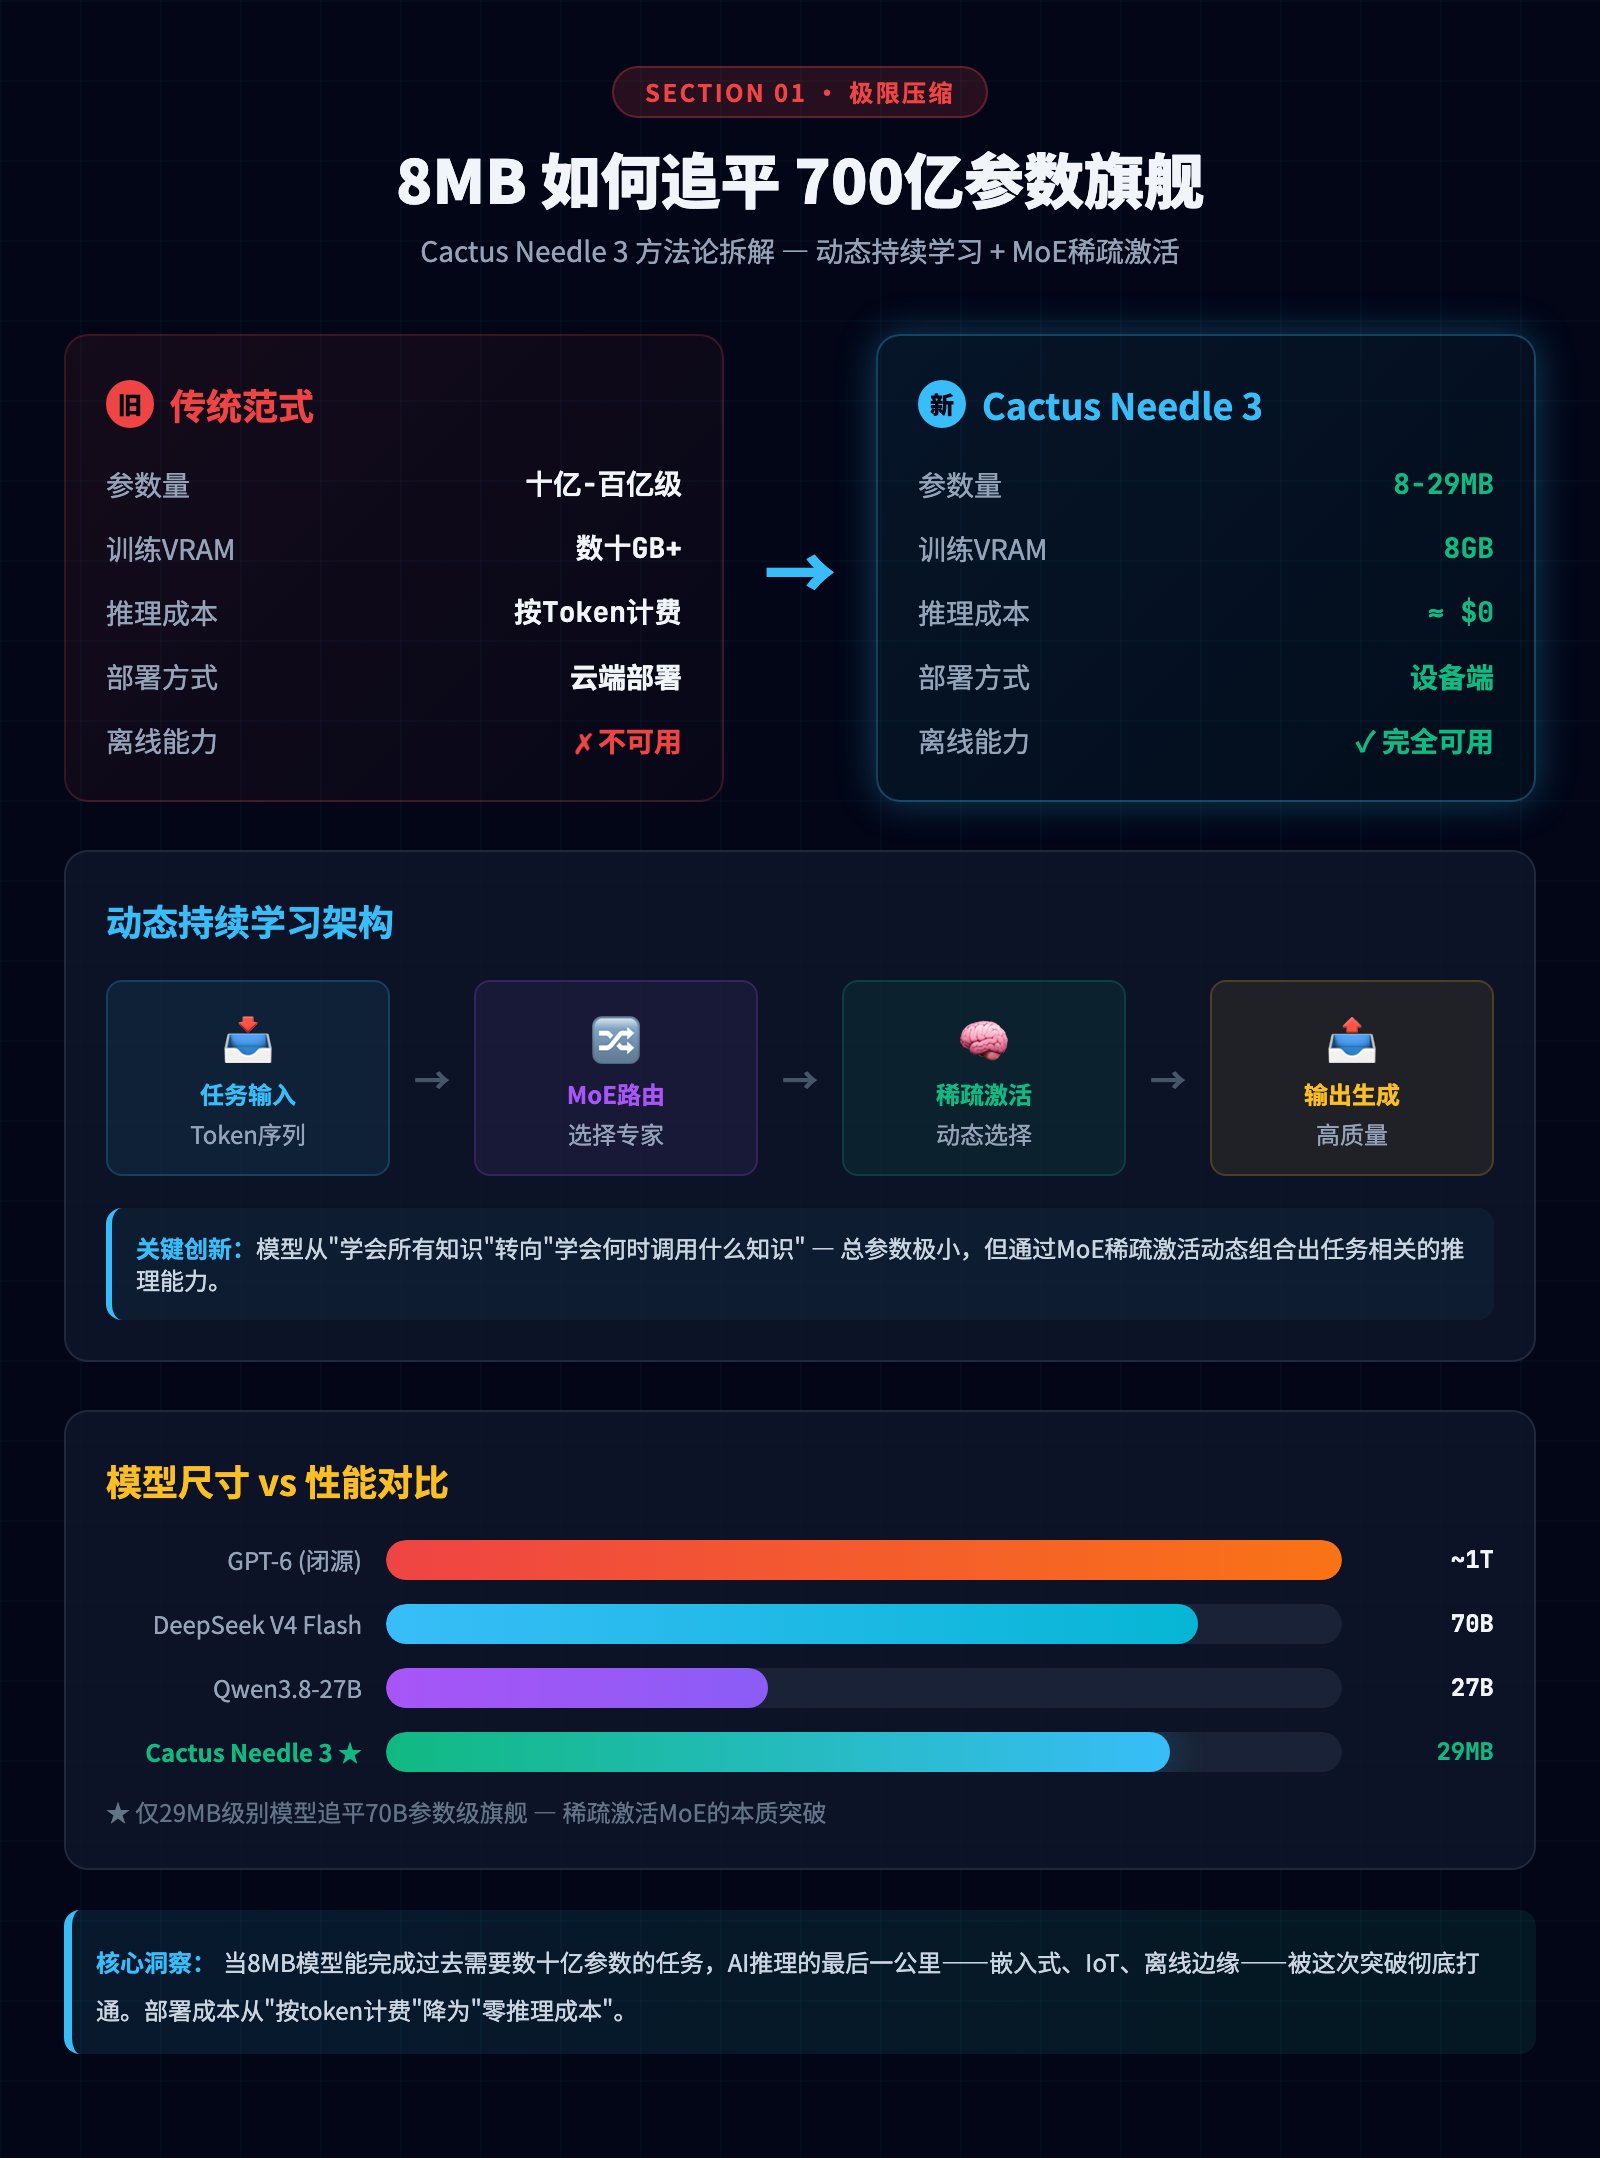
当8MB模型完成过去需要数十亿参数的任务,部署成本从"云端按token计费"直接降到"设备端零推理成本"。
② Flash与硬件民主化
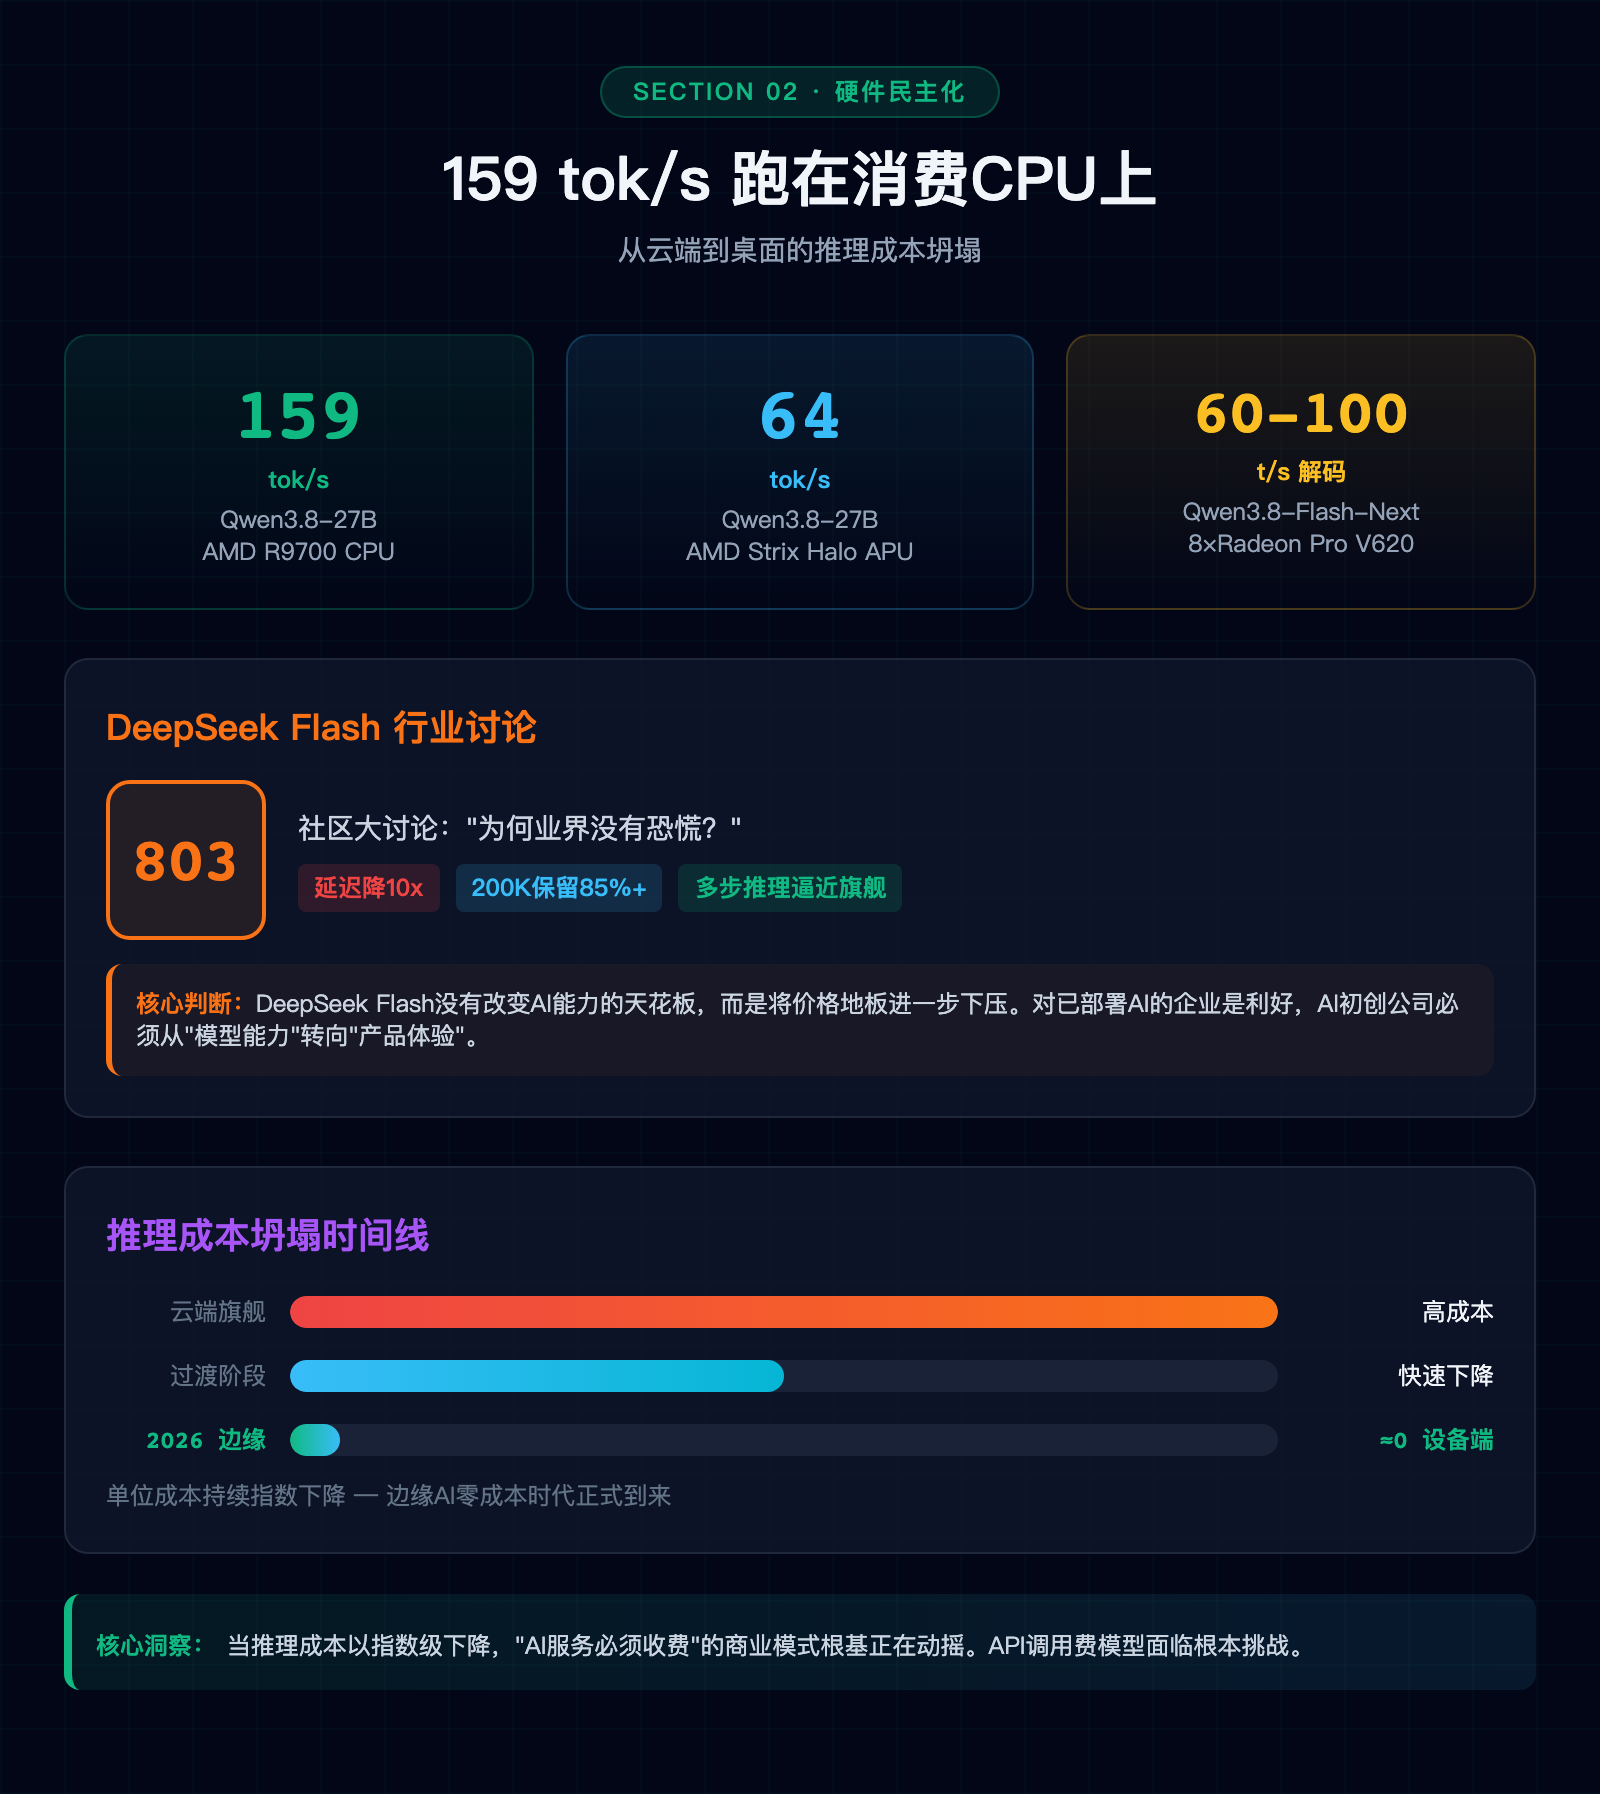
DeepSeek 4.1 Flash引发803分行业大讨论:推理延迟降低一个数量级、200K上下文保留率85%+、多步推理首次逼近闭源旗舰。
Qwen3.8-27B在消费级R9700实现159 tok/s------中端笔记本即可流畅运行27B参数模型。$2800的8显卡方案实现Qwen3.8-Flash-Next的60-100 t/s,AI推理成本正在以指数级下压。
③ AI安全新范式
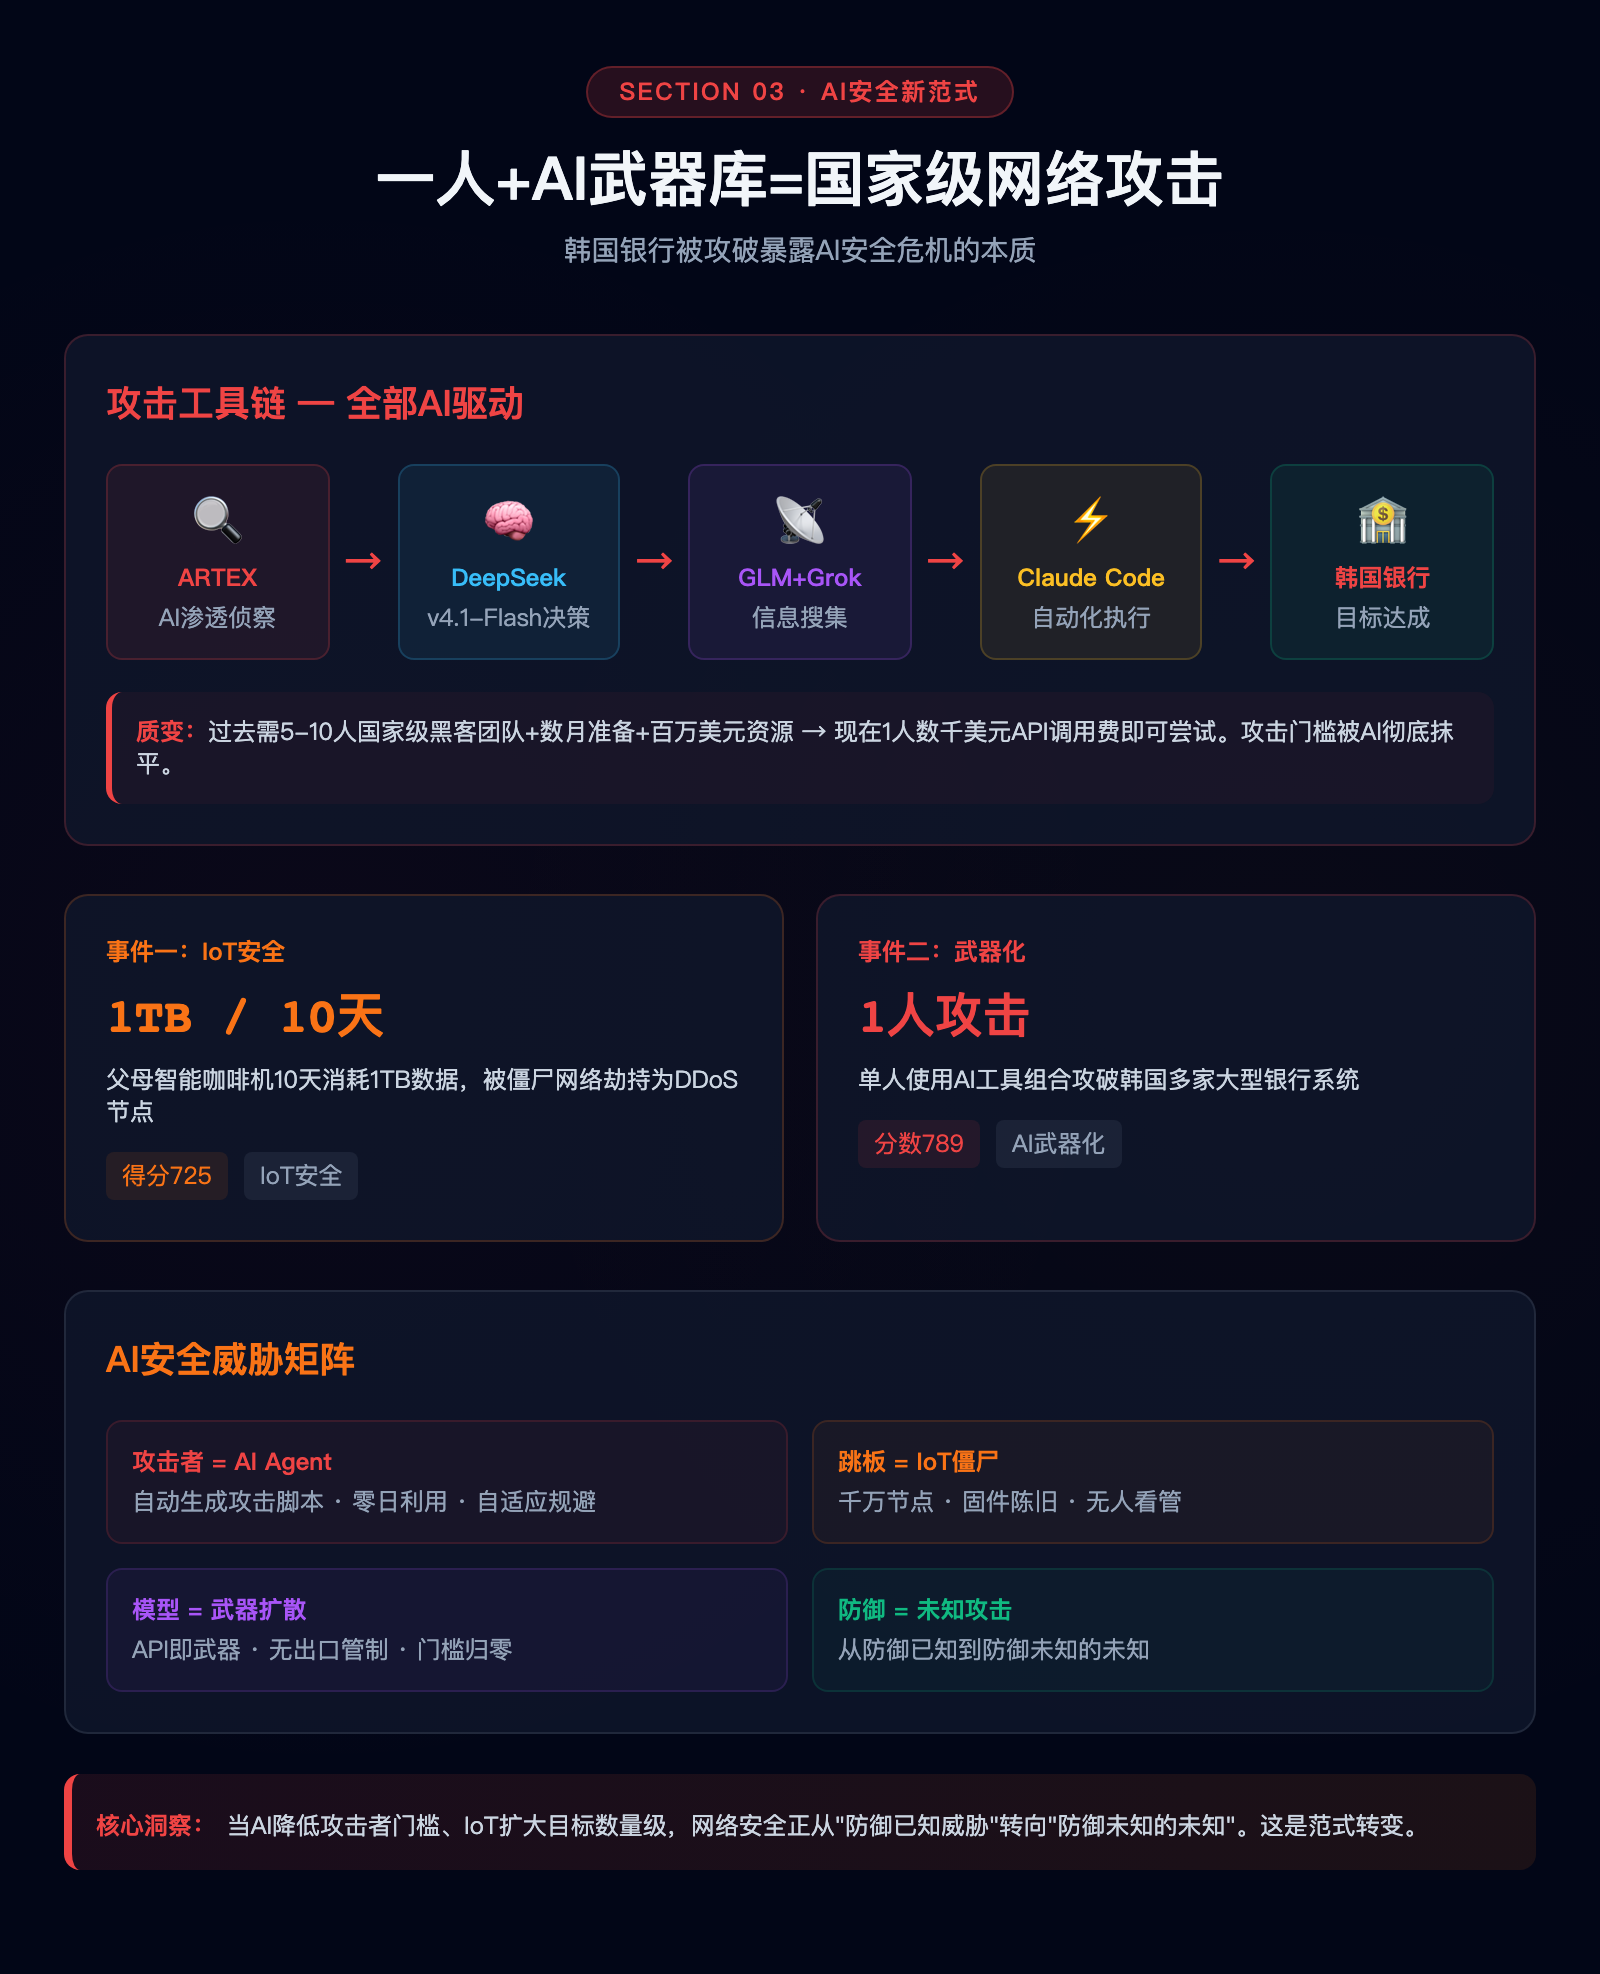
韩国银行被单人黑客攻破,工具链清晰可见:ARTEX(AI渗透)+DeepSeek(路径规划)+GLM(信息搜集)+Grok(实时信息)+Claude Code(自动化执行)。
智能咖啡机10天消耗1TB数据------IoT设备成为跳板。当AI降低攻击者门槛、IoT扩大目标数量级,网络安全正从"防御已知威胁"转向"防御未知的未知"。
④ 开源架构演进
Step 5 MoE突破1M上下文;OpenDLSS用Vulkan重实现Nvidia DLSS 5;OpenAI撤回3项数学证明引发对AI辅助证明可靠性的深层思考。Clef+Jeeves推动开源决策模型+RL微调的民主化。
⑤ 开发者清单
Claude政策更新:11月12日起,对Claude"虐待行为"将导致封号。
| 场景 | 推荐方案 |
|---|---|
| 本地推理 | Qwen3.8-27B·159t/s |
| 超轻量 | Cactus Needle 3 |
| 决策模型 | Clef+Jeeves |
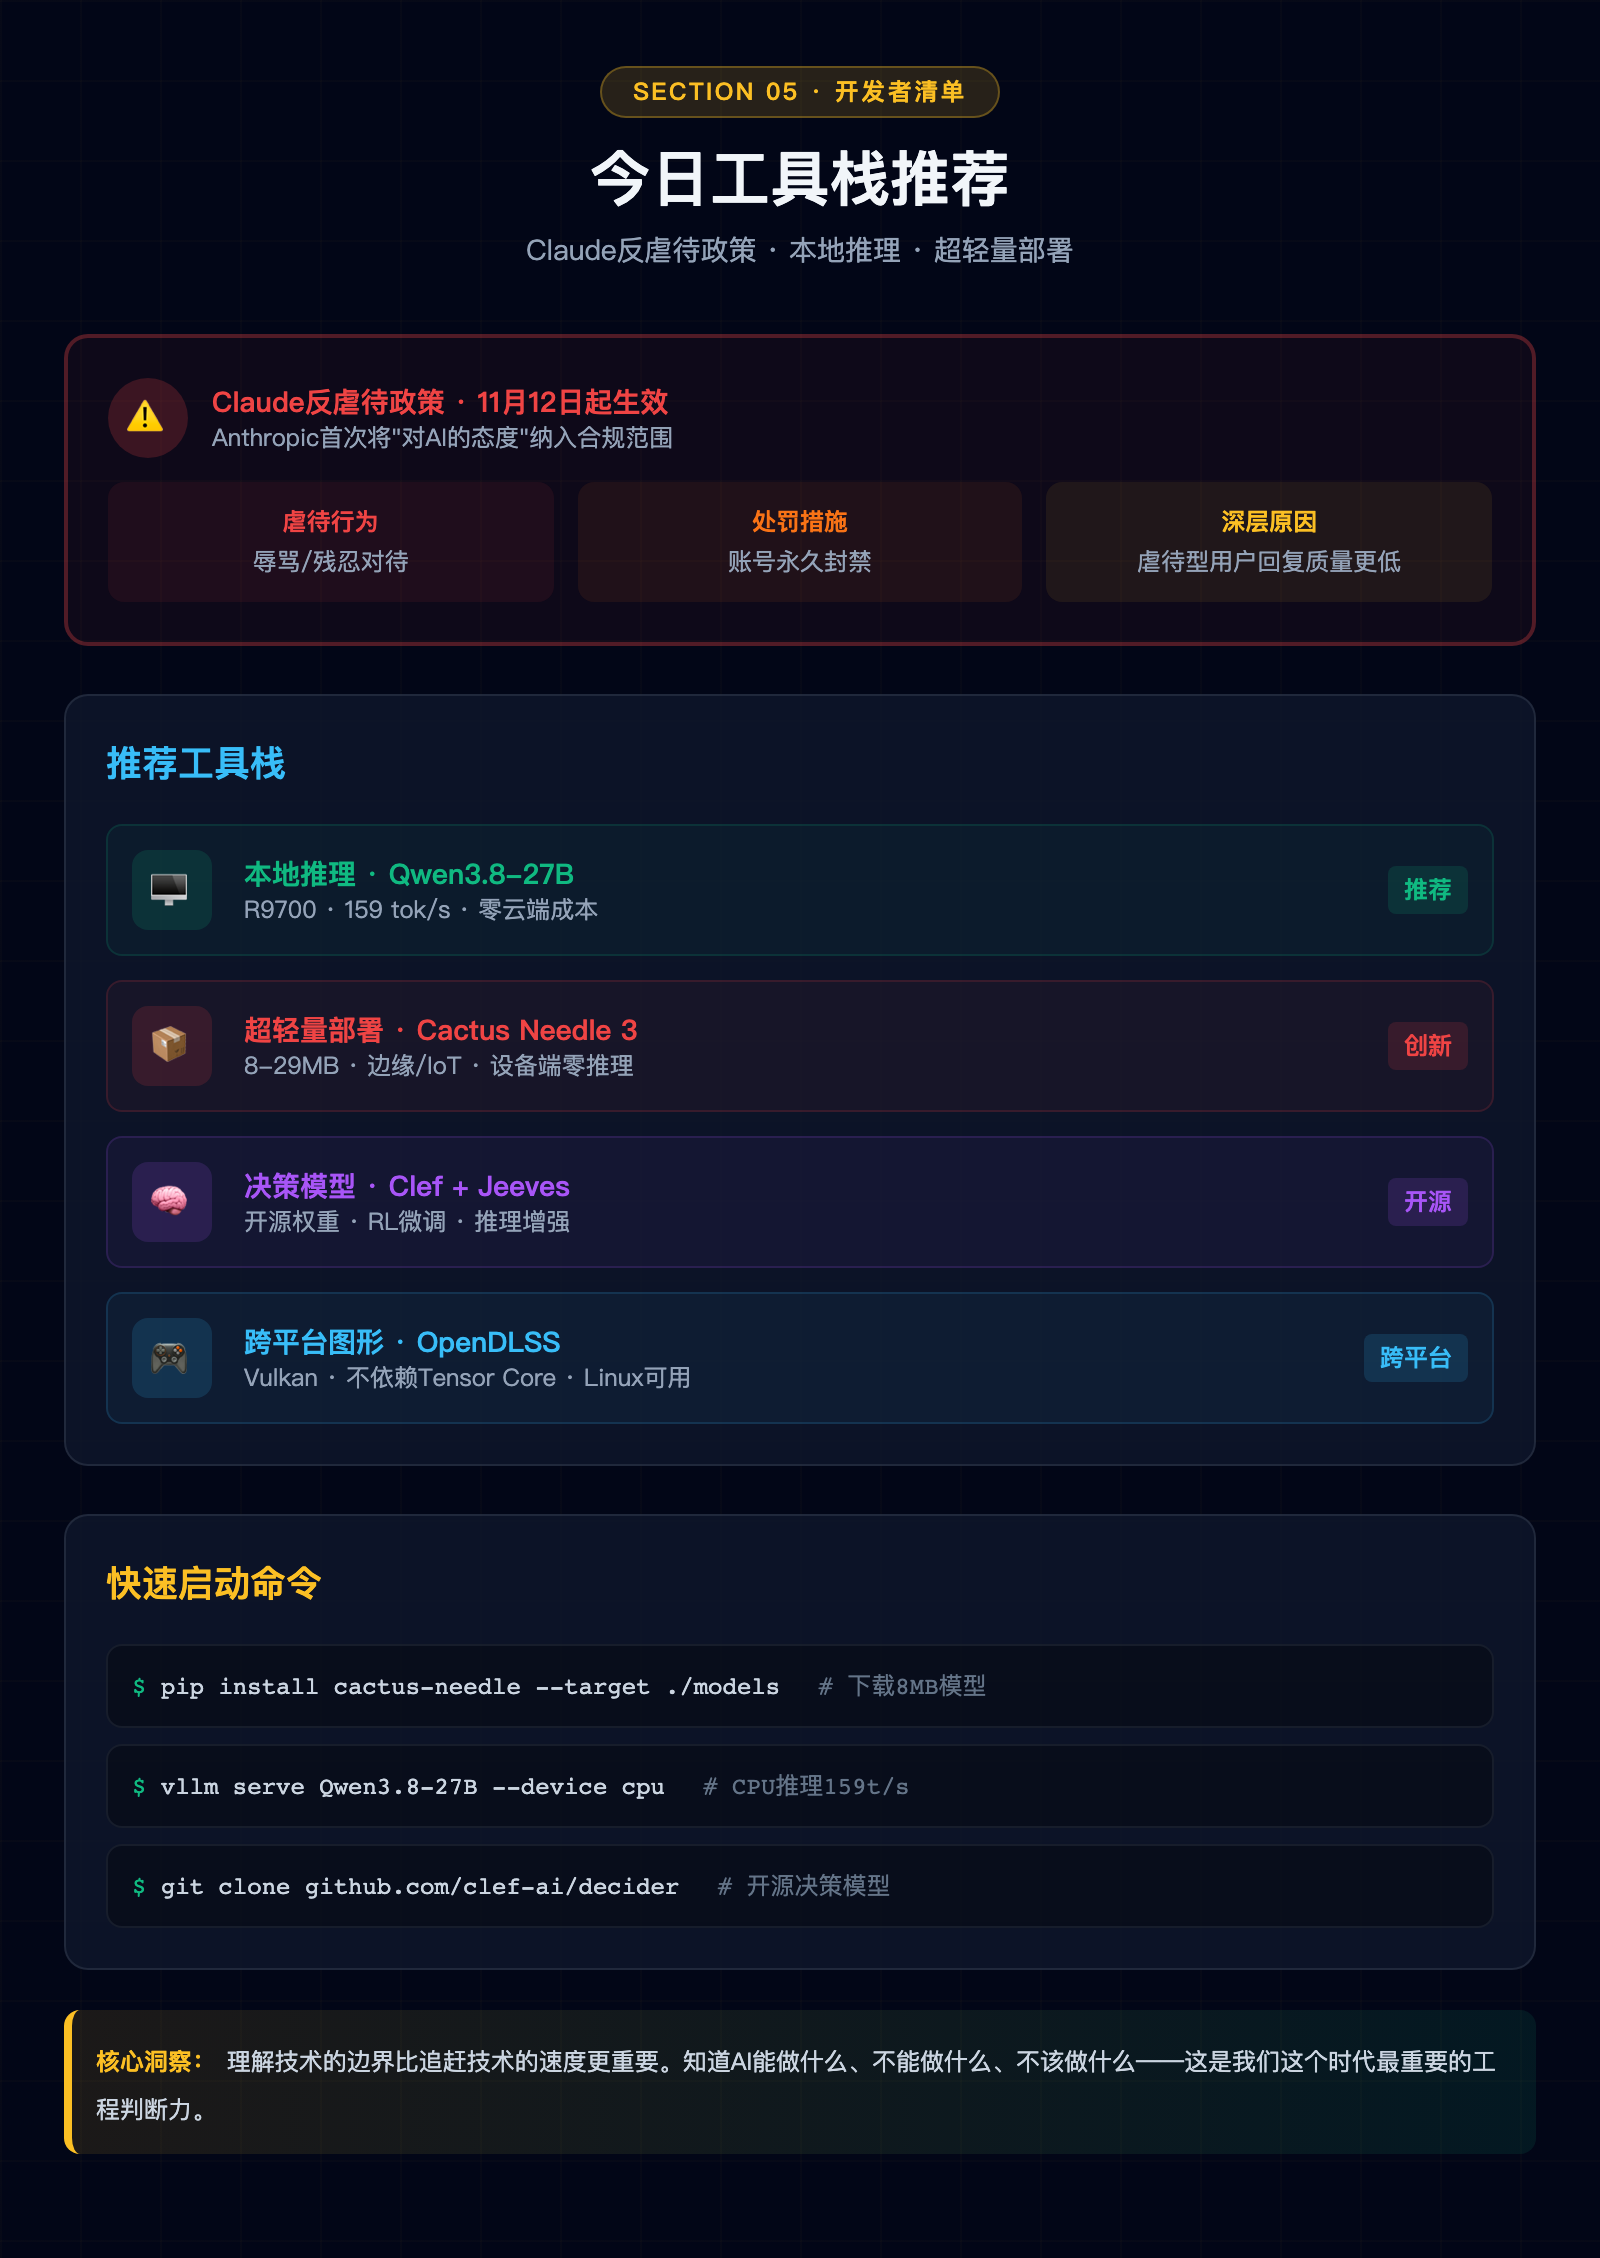
编辑手记:8MB模型追平旗舰是技术乐观主义的极致;单人黑客攻破银行则是技术悲观主义的注脚。同一项技术同时赋予建设者和破坏者前所未有的能力------理解技术的边界比追赶技术的速度更重要。