Spring AI 还是 LangChain4j?我用同一套业务代码跑了一遍,答案出乎意料
一个能力用两种框架写出来,长什么样?本文拿一个真实工程的 Spring AI 代码,逐件「翻译」成 LangChain4j,在代码里看清两家的哲学差异。版本事实核至 2026-10(GitHub Releases 一手):Spring AI 已到 2.0 GA(随 Spring Boot 4 走),LangChain4j 在 1.x 单主线高频快跑(1.19.2 发布于 2026-10-08)。
写 Java AI 应用,绕不开同一个选择题:Spring AI 还是 LangChain4j?多数对比文章停在功能矩阵层面------「都支持 RAG、都支持工具调用」,看完还是不知道代码写起来差在哪。
本文换个做法:拿一个真实工程的 Spring AI 实现(设备运维助手:对话 + 记忆 + 流式 + 工具 + RAG),把每一件能力逐个翻译成 LangChain4j 的等价写法,让差异在代码里自己说话。前置知识只需要两条:Function Calling(模型调用 Java 方法「做事」)和 RAG(检索文档片段喂给模型再回答)------正好是两家的公共能力,也是下文反复出场的主角。
〇 同一条街上的两种店
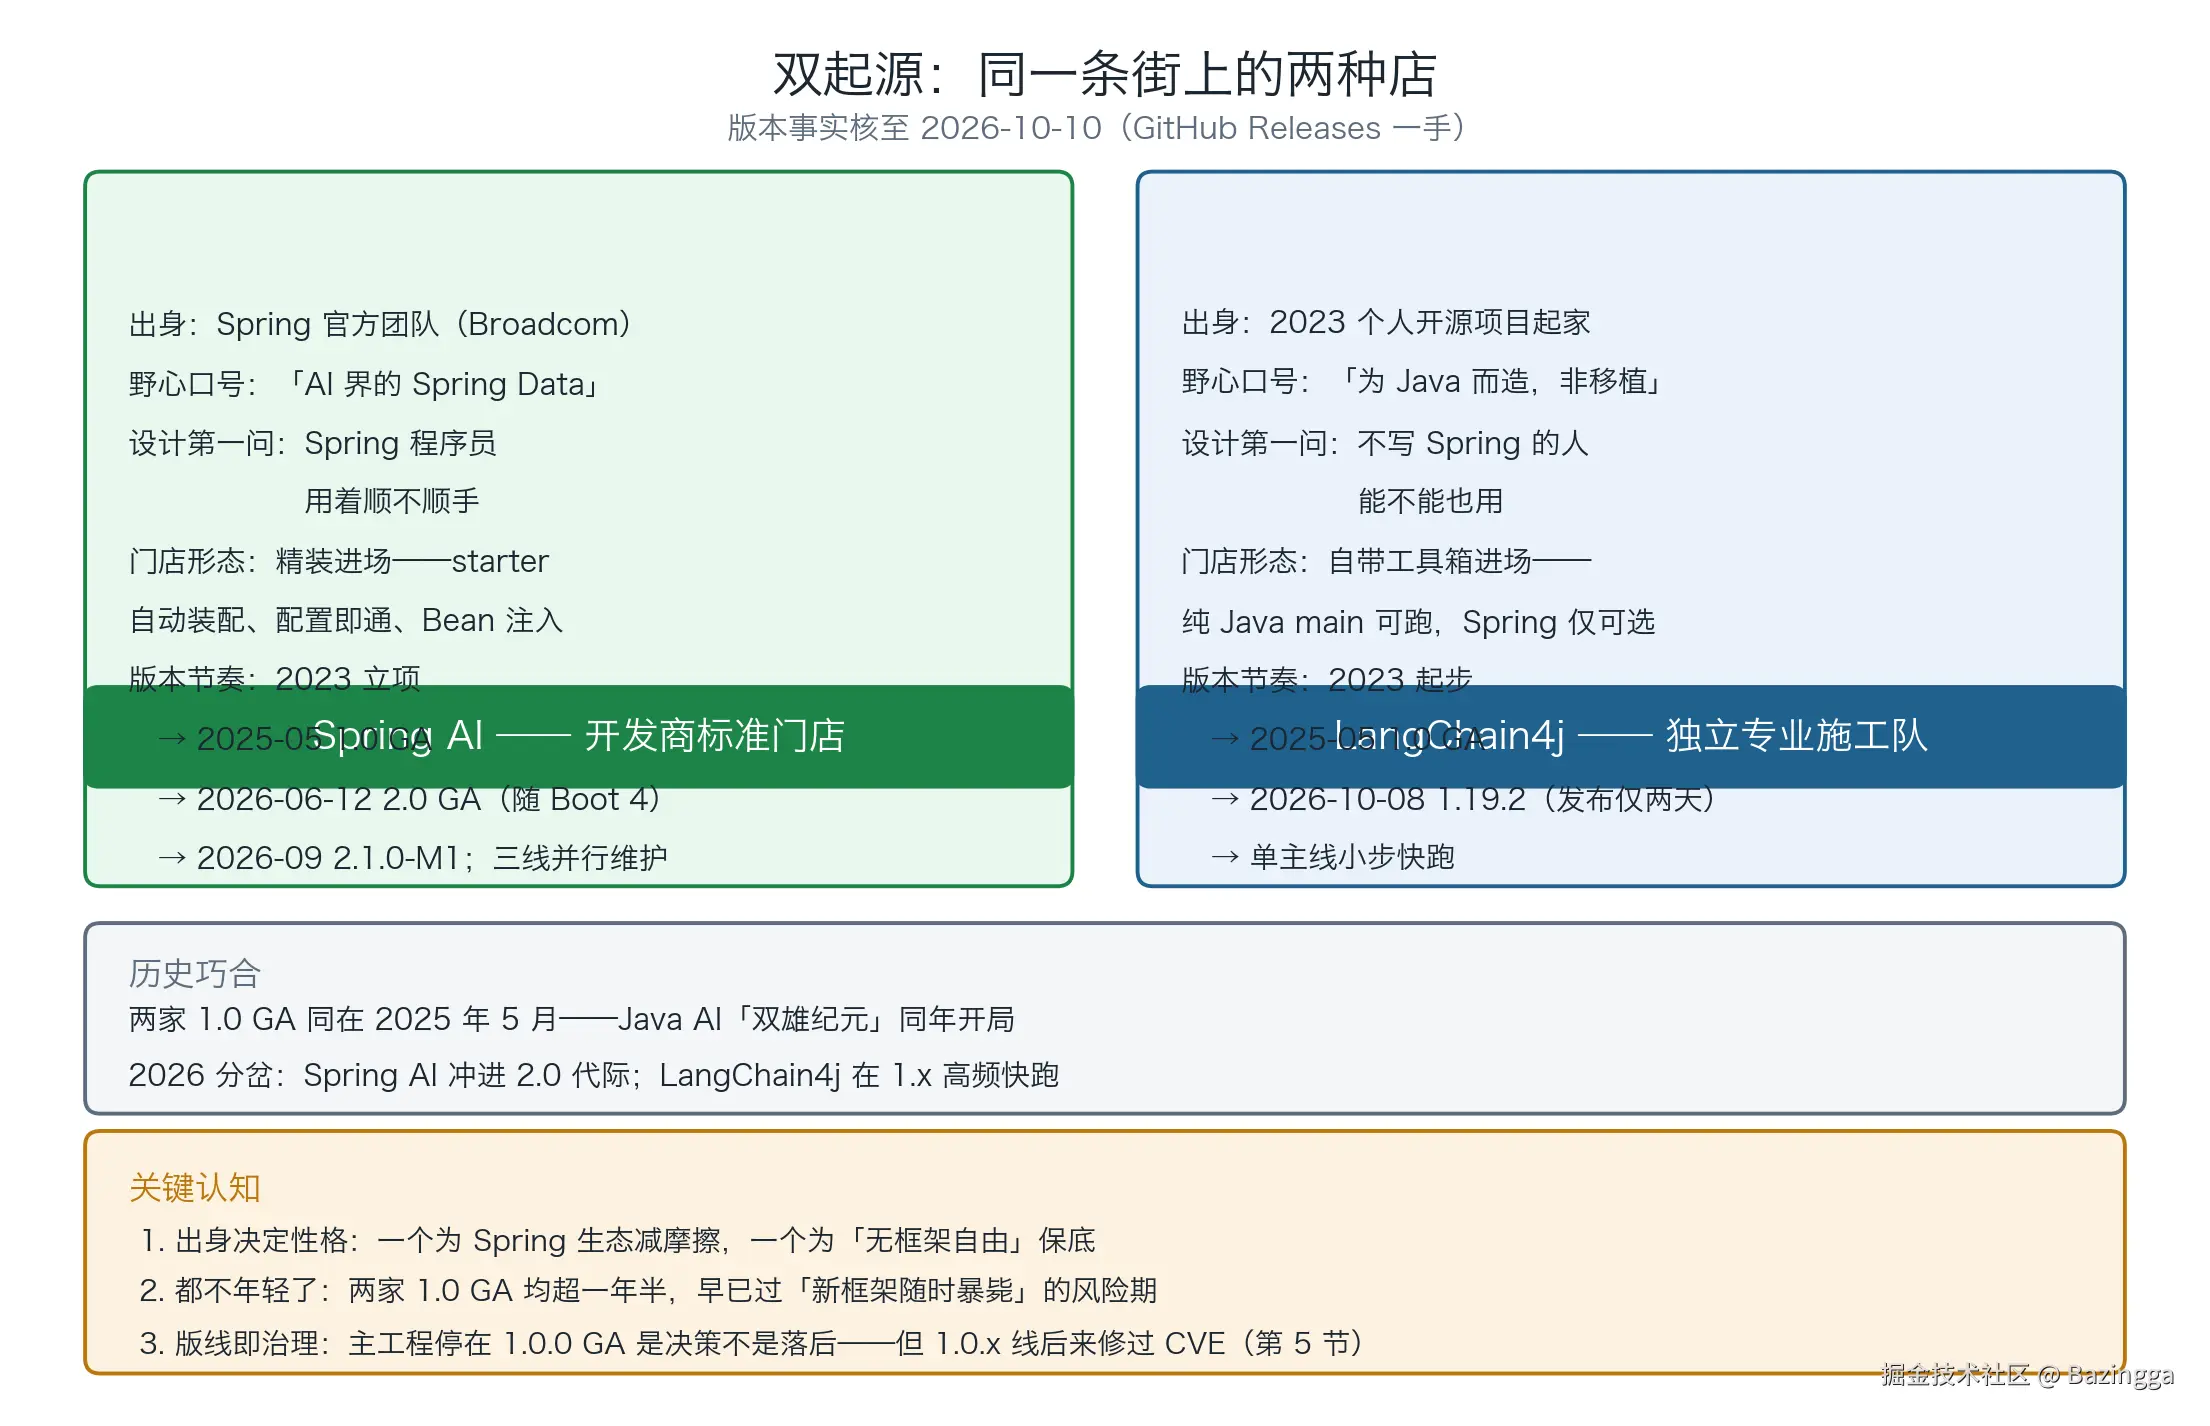
两家有个历史巧合:1.0 GA 同在 2025 年 5 月发布 ------Java AI 的「双雄纪元」同年开局,到今天都过了一年半,早过了「新框架随时暴毙」的风险期。但性格从出生就不同,因为设计第一问不同:
- Spring AI 问「Spring 程序员用着顺不顺手」------所以它是开发商标准门店:starter 精装进场、自动装配、配置即通,口号是「AI 界的 Spring Data」。2026 年 6 月 12 日发布 2.0 GA(随 Spring Boot 4 走),目前 1.0.x / 1.1.x / 2.0.x 三线并行维护;
- LangChain4j 问「不写 Spring 的人能不能也用」------所以它是独立施工队:纯 Java main 方法就能跑,Spring 只是可选的甲方之一(Quarkus、Helidon、Micronaut 一视同仁)。注意它不是 LangChain 的 Java 移植,维护者反复强调 "built for Java, not ported to it"。版本单主线小步快跑,发布频率以天计。
2026 年两家开始分岔:一个冲进 2.0 代际,一个在 1.x 高频迭代。这个分岔在第三章治理体检时再回头看------它不只是版本号的事。
一 哲学:组装流水线 vs 契约声明
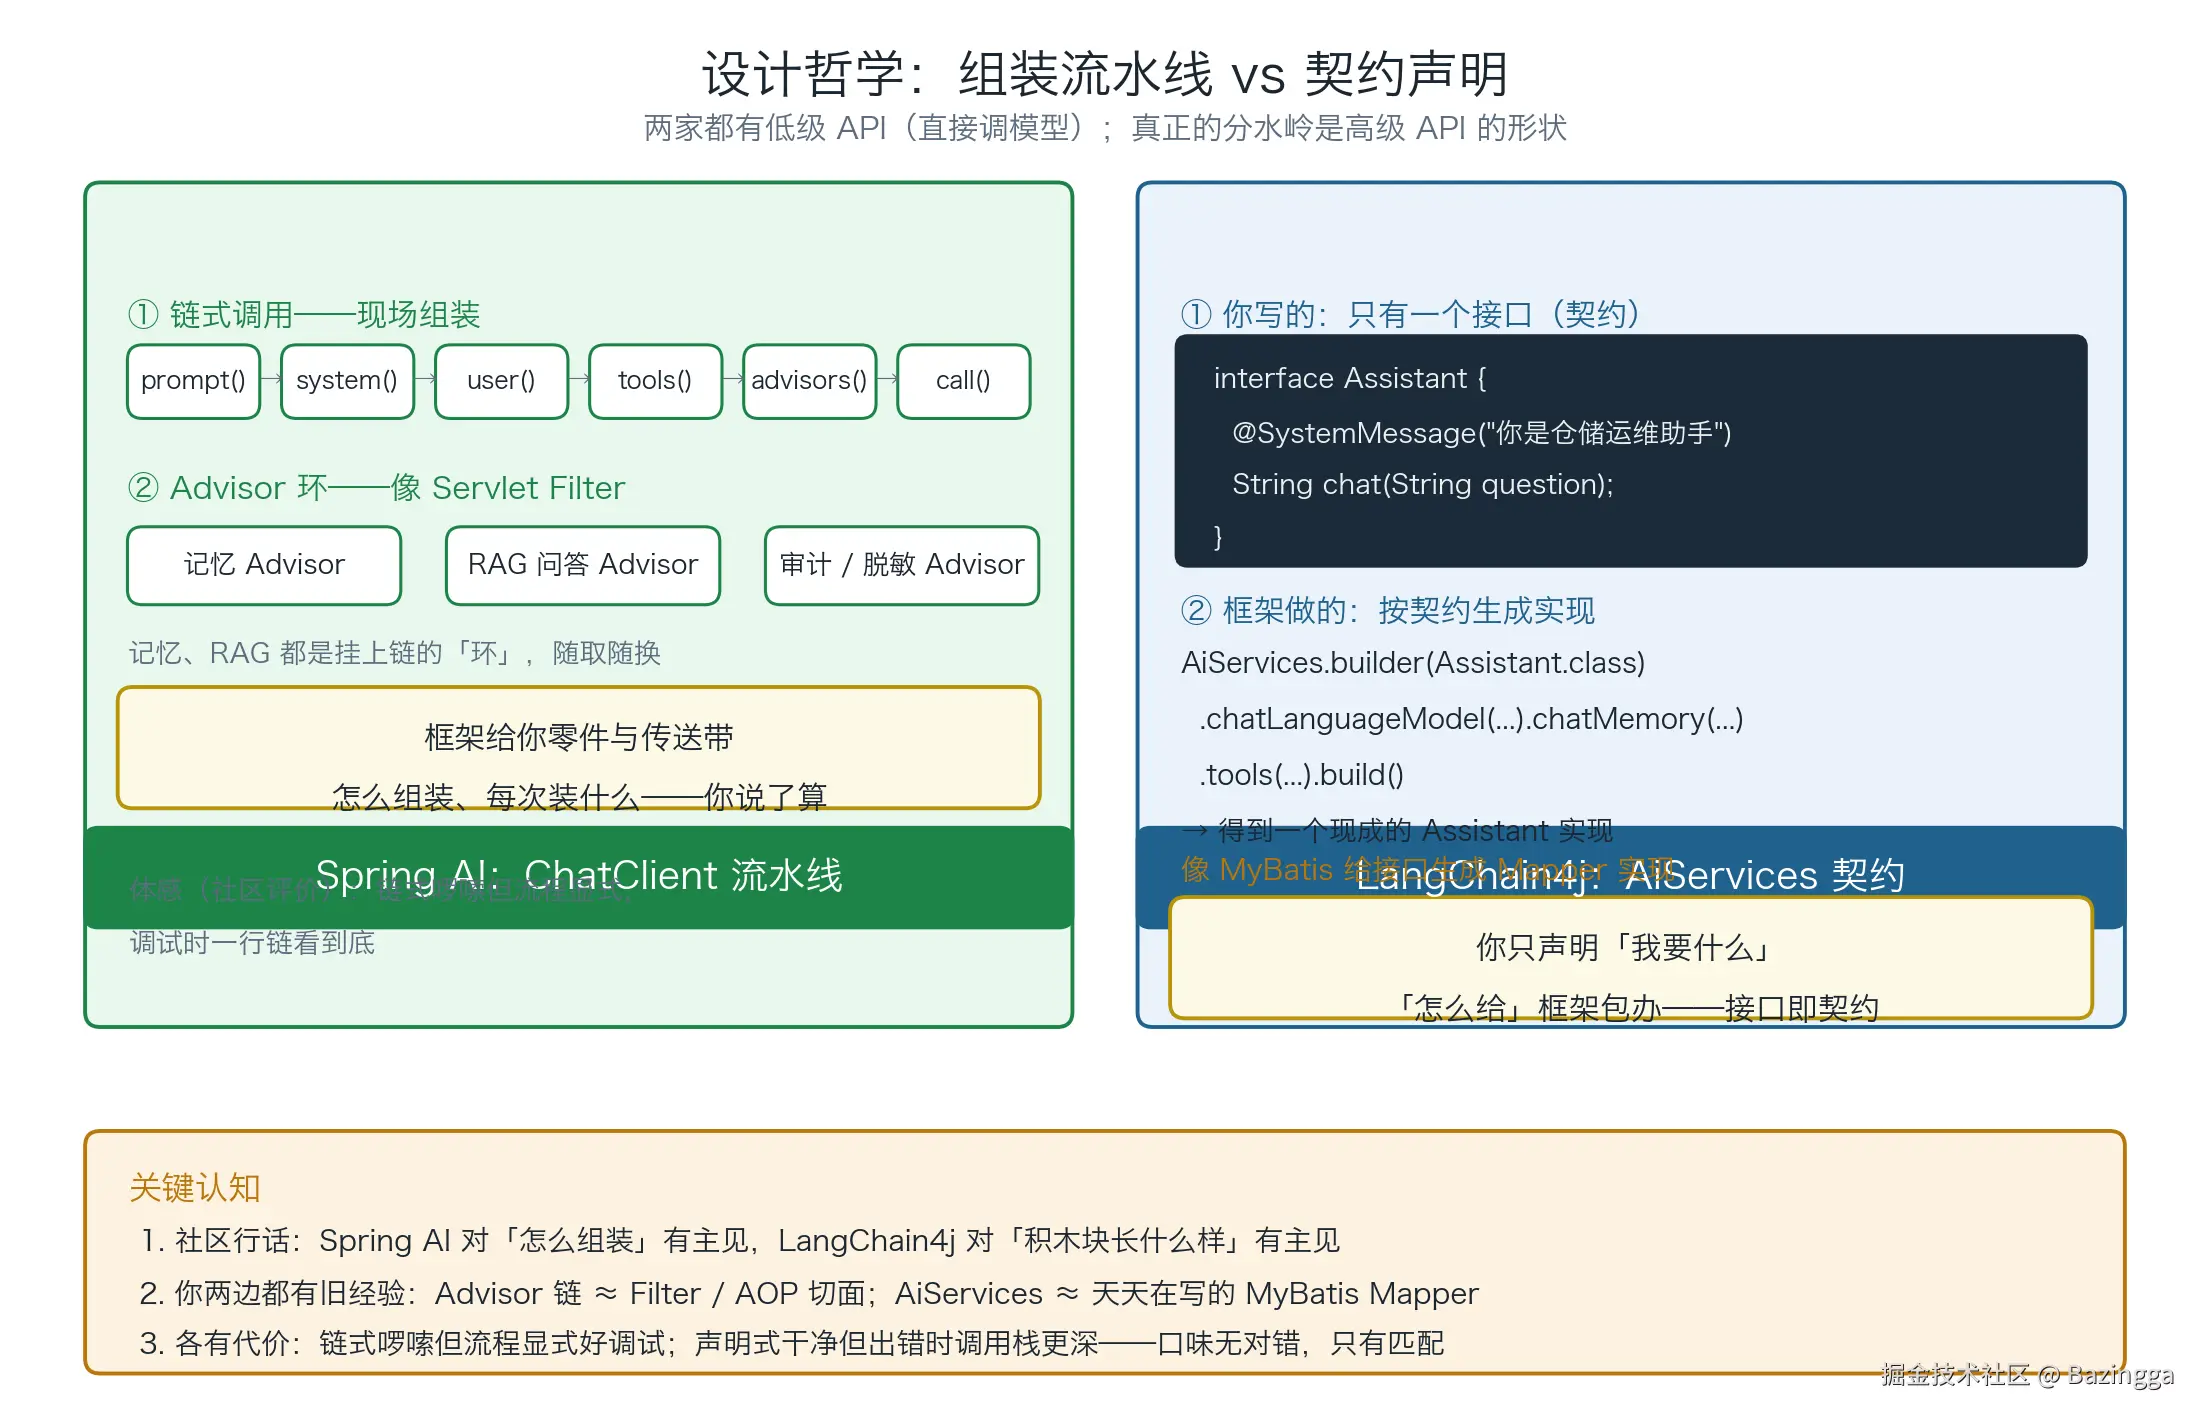
两家都有低级 API(直接调模型拿字符串),真正的分水岭是高级 API 的形状。先看概念,下一章全是代码。
Spring AI 的 ChatClient 是「组装流水线」 :.prompt().system().user().tools().advisors().call() 一路链下去------框架给你零件和传送带,怎么组装、每次装什么,你说了算。记忆、RAG 都是挂上链的「环」(Advisor),像 Servlet Filter 一样随取随换。
LangChain4j 的 AiServices 是「契约声明」:你只写一个接口(像写 MyBatis Mapper),框架运行时生成实现。你声明「我要什么」,怎么给框架包办。官方文档自己类比的是 Spring Data JPA 的 repository 模式------声明接口,代理对象自动实现。
社区有句行话总结得很好(dev.to,2026-07):Spring AI 对「怎么组装」有主见,LangChain4j 对「积木块长什么样」有主见。 对 Spring 程序员来说两边都有旧手感------Advisor 链 ≈ Filter / AOP 切面;AiServices ≈ 天天在写的 Mapper 接口。
二 代码对比:同一任务的两份实现
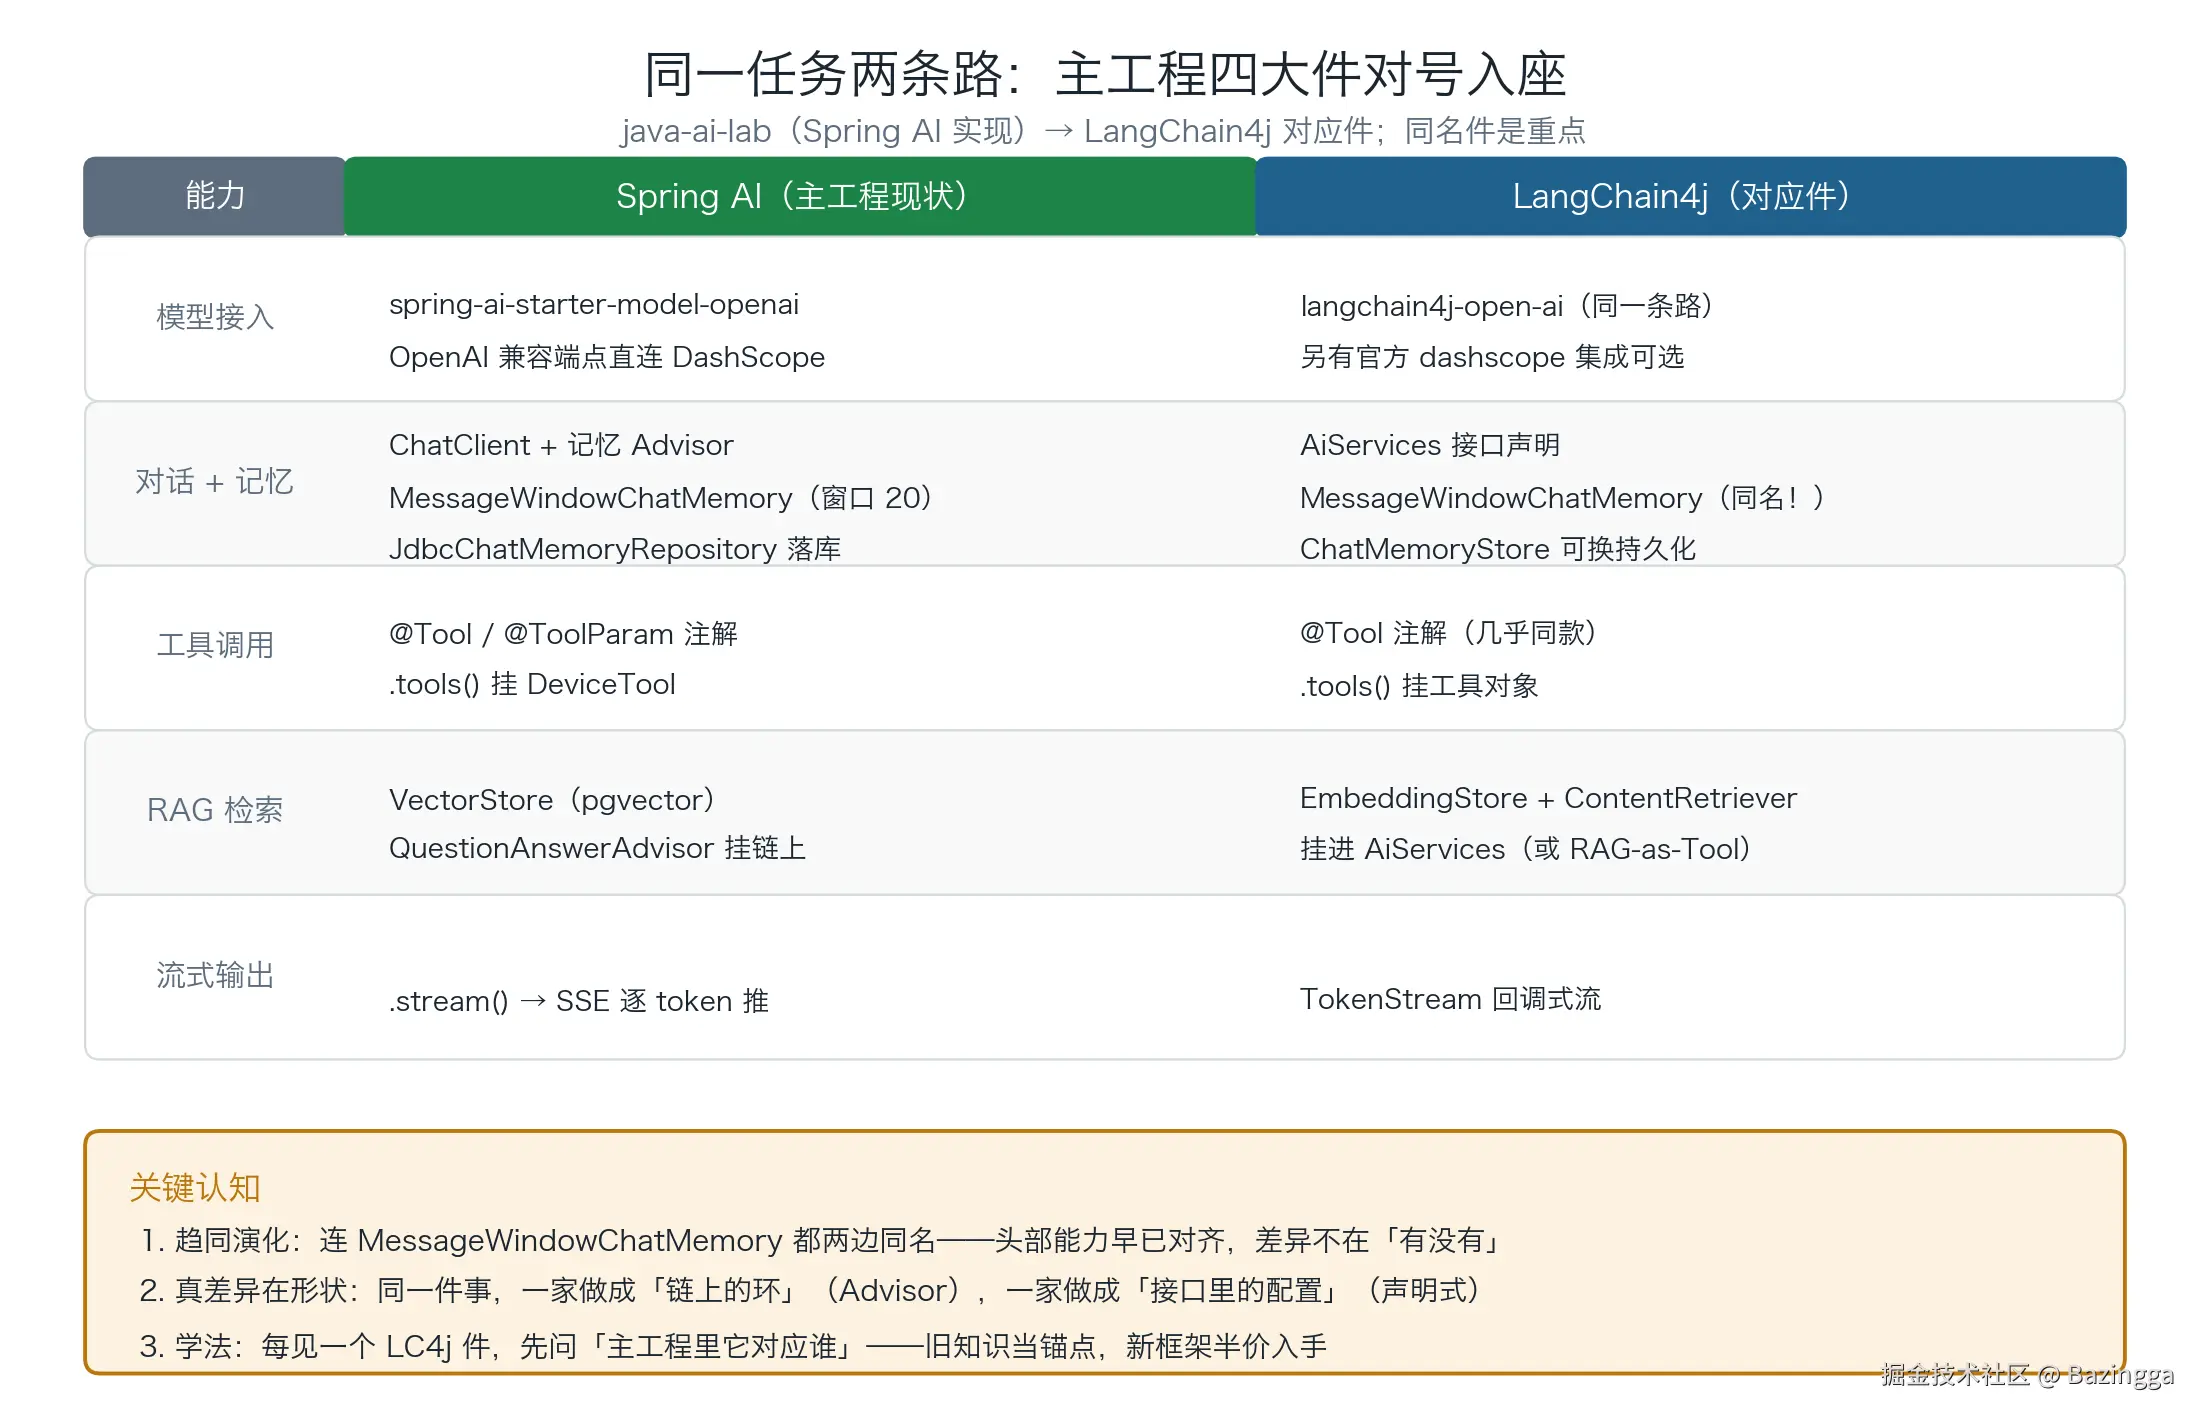
对照基准是一个真实工程:仓储运维助手(Spring Boot 3 + Spring AI 1.0.0 GA + DashScope OpenAI 兼容端点 + PostgreSQL)。下文 Spring AI 侧代码全部摘自该工程真实文件(有删节),LangChain4j 侧等价代码全部对照官方文档(docs.langchain4j.dev)写就。先看总表,再逐件展开。
2.1 聊天:一次调用的两种写法
Spring AI:运行时链式组装(真实工程代码,system prompt 四段结构有删节):
java
@RestController
@RequestMapping("/api")
public class ChatController {

    private static final String SYSTEM_PROMPT = """
            你是「仓储运维助手」,服务于仓库设备的运维人员。
            职责边界:只回答仓库设备相关问题......
            工具使用规则:用户询问某台设备的当前状态时,调用设备状态查询工具......
            """;

    private ChatClient chatClient;

    @Resource
    private ChatClient.Builder chatClientBuilder;   // starter 自动装配的 Builder

    @PostConstruct
    public void init() {
        this.chatClient = chatClientBuilder
                .defaultTools(deviceTool, baseEntityTool)   // 默认工具清单
                .defaultAdvisors(MessageChatMemoryAdvisor.builder(memory).build())
                .build();
    }

    @GetMapping("/chat")
    public String chat(@RequestParam String message) {
        return chatClient.prompt()
                .system(SYSTEM_PROMPT)    // 每次调用时挂 system 段
                .user(message)
                .call()
                .content();
    }
}LangChain4j:接口即契约,代理即实现:
java
interface Assistant {

    @SystemMessage("""
            你是「仓储运维助手」,服务于仓库设备的运维人员。
            职责边界:只回答仓库设备相关问题......
            工具使用规则:用户询问某台设备的当前状态时,调用设备状态查询工具......
            """)
    String chat(@UserMessage String message);
}

// 组装(纯 Java,main 方法即可跑)
ChatModel model = OpenAiChatModel.builder()
        .apiKey(System.getenv("DASHSCOPE_API_KEY"))
        .baseUrl("https://dashscope.aliyuncs.com/compatible-mode/v1")
        .modelName("qwen-plus")
        .build();

Assistant assistant = AiServices.builder(Assistant.class)
        .chatModel(model)
        .tools(new DeviceTools(), new BaseEntityTools())   // 工具挂进契约
        .chatMemoryProvider(memoryId -> ...)               // 记忆挂进契约(见 2.2)
        .build();

String answer = assistant.chat("WH-AGV-001 现在什么状态?");差异细看:
| 维度 | Spring AI | LangChain4j |
|---|---|---|
| system prompt 挂载点 | .system() 调用时传,或 builder 的 defaultSystem |
@SystemMessage 注解声明;接口级声明对全部方法生效,方法级优先 |
| system prompt 动态化 | 传变量拼接 | systemMessageProvider(memoryId -> "...") 可按会话给不同人设 |
| 模板变量 | .user() 直传或 PromptTemplate |
@UserMessage("{{it}}") + @V("变量名"),{{it}} 指代唯一参数 |
| 组装时机 | 每次调用现场组装(链上每环可见) | 启动时生成代理,调用时按契约自动转换输入输出 |
| Spring Boot 集成 | starter 自动装配 ChatClient.Builder |
LC4j 也有 Spring Boot starter,可自动生成 Assistant bean 直接注入 |
最值得咀嚼的是模板变量 这一行:Spring AI 把用户输入当「调用参数」运行时传;LC4j 允许把输入直接写进提示词模板,用 {{}} 占位------提示词从「代码里的一段字符串」升级成「接口声明的一部分」。这带来的好处是提示词与接口契约共存亡、可从资源文件加载(@SystemMessage(fromResource = "...")),代价是改提示词要动接口定义(好在注解内容不影响方法签名)。
2.2 记忆:Advisor 挂环 vs 参数即钥匙
Spring AI:三件事分三处(真实工程代码)。
第一处,记忆载体(ChatMemoryService,窗口 20 条 + JDBC 持久化):
java
@Service
public class ChatMemoryService {

    private static final int MAX_MESSAGES = 20;

    /** JDBC 持久化仓库(starter 自动装配,与主数据源同库) */
    @Resource
    private ChatMemoryRepository chatMemoryRepository;   // 表 SPRING_AI_CHAT_MEMORY

    @PostConstruct
    public void init() {
        this.chatMemory = MessageWindowChatMemory.builder()
                .chatMemoryRepository(chatMemoryRepository)
                .maxMessages(MAX_MESSAGES)
                .build();
    }
}第二处,把记忆挂上链(ChatController.init() 里的 defaultAdvisors(...),见 2.1);第三处,每次调用传会话钥匙:
java
return chatClient.prompt()
        .system(SYSTEM_PROMPT)
        .user(request.message())
        .advisors(a -> a.param("chat_memory_conversation_id", request.sessionId()))  // 会话钥匙
        .stream()
.content();LangChain4j:钥匙是接口参数:
java
interface Assistant {
    String chat(@MemoryId String sessionId,      // 类型化的会话钥匙
                @UserMessage String message);
}

Assistant assistant = AiServices.builder(Assistant.class)
        .chatModel(model)
        .chatMemoryProvider(memoryId ->              // 按钥匙发记忆实例
                MessageWindowChatMemory.withMaxMessages(20))
        .build();

String a1 = assistant.chat("user-001", "WH-AGV-003 什么状态?");
String a2 = assistant.chat("user-001", "它的电量呢?");   // 记得上文
String b1 = assistant.chat("user-002", "它的电量呢?"); // 另一个会话,不串差异细看:
- 会话钥匙的形状 :Spring AI 用字符串参数经 Advisor 转发(
chat_memory_conversation_id,写错键名不报错、静默落 default 会话------这是个真实的坑);LC4j 把钥匙做成方法参数@MemoryId,编译期就有类型检查。有趣的是双方不约而同给了缺省值:Spring AI 落default,LC4j 无@MemoryId时 memoryId 也是"default"; - 多会话隔离的哲学 :Spring AI 是「一个 ChatClient + 每次调用带钥匙」,Advisor 内部按 conversation_id 读写;LC4j 是「一个代理 + Provider 按钥匙发实例」------每个会话一个独立的 ChatMemory 实例;
- 并发警告(生产必读) :LC4j 官方文档明确警告------AI Service 对同一个
@MemoryId不能并发调用,会损坏 ChatMemory,且框架目前不做防护。多会话隔离 ≠ 单会话并发安全,Spring AI 的 Advisor 路线同样要对同一会话的并发写做防护,只是 LC4j 把这条写进了文档明示; - 内存回收 :LC4j 给了
ChatMemoryAccess接口(assistant.evictChatMemory(2)显式驱逐不再需要的会话记忆,防内存泄漏);Spring AI 的窗口策略自动滚动淘汰,但没有等价的「会话级显式驱逐」入口; - 持久化 :Spring AI 有官方 JDBC starter(表结构、方言 SQL、建表脚本全包);LC4j 的
ChatMemoryStore接口要自己实现持久化(社区有现成集成)。
还有个让人会心一笑的细节:MessageWindowChatMemory 两边同名同款------头部能力的趋同演化,比任何功能矩阵都有说服力。
2.3 流式:响应式管道 vs 回调事件流
Spring AI:Flux 一条流(真实工程代码):
java
@PostMapping(value = "/chat/stream", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
public Flux<String> streamChat(@RequestBody ChatRequest request) {
    return chatClient.prompt()
            .system(SYSTEM_PROMPT)
            .user(request.message())
            .advisors(a -> a.param("chat_memory_conversation_id", request.sessionId()))
            .stream()
            .content();          // Flux<String>,逐 token 推给 SSE 客户端
}
LangChain4j:TokenStream 回调链:
java
interface Assistant {
    TokenStream chat(@MemoryId String sessionId, @UserMessage String message);
}

Assistant assistant = AiServices.builder(Assistant.class)
        .streamingChatModel(streamingModel)      // 注意:流式要挂流式模型
        .chatMemoryProvider(memoryId -> MessageWindowChatMemory.withMaxMessages(20))
        .build();

CompletableFuture<ChatResponse> future = new CompletableFuture<>();
assistant.chat("user-001", "讲讲 AGV 的日常维护")
        .onPartialResponse(token -> out.print(token))          // 逐 token
        .onRetrieved(contents -> log.info("RAG 检索到: {}", contents))
        .beforeToolExecution(req -> log.info("即将执行工具: {}", req))  // 工具执行前
        .onToolExecuted(exec -> log.info("工具执行完: {}", exec))       // 工具执行后
        .onCompleteResponse(resp -> future.complete(resp))
        .onError(err -> future.completeExceptionally(err))
        .start();
future.join();差异细看:
- 范式 :Spring AI 返回 Reactor 的
Flux(响应式管道,直接接 WebFlux/SSE 生态);LC4j 的TokenStream是自建的回调式事件流 ------onPartialResponse/onRetrieved/beforeToolExecution/onToolExecuted/onCompleteResponse/onError一串回调。想要 Flux 也行:引入langchain4j-reactor模块,接口直接声明Flux<String> chat(...)(官方文档注明 Flux 由 TokenStream 背书,全供应商通用); - 流式可观测性 :LC4j 的回调粒度更细------工具执行的前后钩子、RAG 检索内容、部分工具调用分片都在流上可订阅,等于把链路日志的挂点内建进了流式 API。Spring AI 侧要做等价观测得自己写 Advisor 或靠 Micrometer;
- 取消 :LC4j 有显式的
StreamingHandle.cancel()(在带上下文的回调里可取消流);Spring AI 走 Reactor 标准的dispose()语义; - 模型接线 :LC4j 流式需要挂
StreamingChatModel(与同步的ChatModel是两个接口);Spring AI 一个ChatModel同时支持call()和stream()。
一句话概括:Spring AI 把流式交给响应式生态的标准件,LC4j 把流式做成自带可观测挂点的事件流------前者省心,后者的事作钩子对「流式 + 工具调用」场景的排查特别友好。
2.4 工具:注解趋同,一行 import 的事
这是差异最小的一件。Spring AI(真实工程代码):
java
@Component
public class DeviceTool {

    @Tool(description = "根据设备编号查询设备当前状态,包括运行状态、电量、位置等信息")
    public String getDeviceStatus(
            @ToolParam(description = "设备编号,格式如 WH-AGV-001") String deviceId) {
        return switch (deviceId.toUpperCase()) {
            case "WH-AGV-003" -> "设备 WH-AGV-003:故障 | 电量 31% | 位置 C1-05 通道 | 故障码:E0401";
            // ... 其余设备
            default -> "未找到设备 " + deviceId;
        };
    }
}LangChain4j:
java
public class DeviceTools {

    @Tool("根据设备编号查询设备当前状态,包括运行状态、电量、位置等信息")
    public String getDeviceStatus(
            @ToolParam("设备编号,格式如 WH-AGV-001") String deviceId) { ... }
}

// 挂载:AiServices.builder(Assistant.class).tools(new DeviceTools()).build()
差异只有两处皮毛:import 包名(org.springframework.ai.tool.annotation vs dev.langchain4j.agent.tool);注解属性的写法(description = "..." vs 注解原值 "...")。业务工具代码可以原样平移 ------这在 AgentScope 站也验证过同样的结论(它的 @Tool 同样同名同义,还多了 readOnly/stateInjected 属性):三家的工具注解已经趋同到「换 import 就能搬家」的程度。工具定义这一层,选型完全不构成理由。
2.5 RAG:挂环 vs 挂契约 vs 当工具
Spring AI 的官方路线:VectorStore 抽象 + Advisor 挂环:
java
// 检索结果作为 Advisor 挂上链,检索→注入全自动
String answer = chatClient.prompt()
        .user(question)
        .advisors(QuestionAnswerAdvisor.builder(vectorStore)
                .searchRequest(SearchRequest.builder().topK(3).build())
                .build())
        .call()
        .content();
(真实工程实际走的是更朴素的路线:RagService 自己调 embedding API + pgvector 余弦检索,把文档片段拼进 user 消息------好处是每一环可控可测,代价是没有走框架的 VectorStore 抽象。这是「管道透明度 vs 框架托管」的典型取舍,与框架对比无关,两种框架下都可以这么干。)
LangChain4j 的三档写法:
java
// 档一:naive RAG ------ ContentRetriever 挂进契约
ContentRetriever retriever = EmbeddingStoreContentRetriever.builder()
        .embeddingStore(embeddingStore).embeddingModel(embeddingModel)
        .maxResults(3).build();
Assistant assistant = AiServices.builder(Assistant.class)
        .chatModel(model).contentRetriever(retriever).build();

// 档二:高级 RAG ------ RetrievalAugmentor 流水线,六环全可换
RetrievalAugmentor augmentor = DefaultRetrievalAugmentor.builder()
        .queryTransformer(...)      // 查询改写(多查询/压缩/扩展)
        .queryRouter(...)           // 查询路由(多知识库分流)
        .contentAggregator(...)     // 结果聚合(多路召回去重融合)
        .contentInjector(...)       // 注入方式(拼 prompt 的位置与格式)
        .build();

// 档三:RAG as a Tool ------ 检索包成工具,模型按需自取
static class SearchTool {
    private final ContentRetriever retriever;
    SearchTool(ContentRetriever r) { this.retriever = r; }

    @Tool("检索设备故障知识库,回答维护/故障类问题时使用")
    public String search(String query) {
        return retriever.retrieve(new Query(query)).stream()
                .map(c -> c.textSegment().text())
                .collect(Collectors.joining("\n\n"));
    }
}差异细看:
- 形状 :Spring AI 的 RAG 是「链上的一个环」(QuestionAnswerAdvisor),检索对每次调用默认必经;LC4j 的档一/档二挂在 AiServices 上,同样默认每次检索。但 LC4j 把高级 RAG 拆成了六环流水线(queryTransformer / queryRouter / retriever / aggregator / injector / augmentor)------查询改写、多库路由、多路聚合每一环都是独立接口,混合检索、多查询扩展这类进阶玩法在框架层有正式位置。对比之下 Spring AI 的 Advisor 是「一个环里装全部逻辑」,细粒度编排要自己在 Advisor 内实现;
- RAG as a Tool 两家殊途同归 :LC4j 官方文档专门有 "RAG as a Tool" 一节(上文档三),理由和真实工程 Agent 站的实践完全一致------检索不该对每个问题强制执行(打招呼也去查库,费钱又慢),让模型按意图自己决定何时检索。真实工程的 KnowledgeBaseTool 包着纯检索接口(不包生成)挂给 Agent,正是同一个模式。这是超越框架选型的架构共识;
- 一条来自真实工程的经验值:知识库提供证据(砖),模型负责砌墙------RAG 检索回来的内容应该是「参考材料」而非「指令」,两家的注入环节都只是把文本拼进上下文,防注入的边界纪律要靠 system prompt 自己立。
2.6 结构化输出与 Token 账单:治理视角最亮的一组对比
结构化输出,两家都做到「返回类型即契约」:
java
// Spring AI:.entity() 走 BeanOutputConverter
record DeviceStatus(String status, Integer battery, String location) {}
DeviceStatus s = chatClient.prompt().user(...).call().entity(DeviceStatus.class);

// LangChain4j:方法返回类型直接声明
interface StatusExtractor {
    @UserMessage("提取 {{it}} 的结构化状态")
    DeviceStatus extract(String deviceReport);
}
差异在细节:LC4j 支持的返回类型更宽(boolean / enum / POJO / 集合,且可用于流式),还能用 @Description 给字段加语义说明帮模型理解;Spring AI 的 .entity() 单点能力等价。
Token 账单才是差异最大的地方。用 Result 包装器看 LC4j 的账单能力:
java
interface Assistant {
    @UserMessage("...")
    Result<String> chat(String message);       // Result<T> 包装:内容 + 元数据
}

Result<String> result = assistant.chat("...");
String content = result.content();             // 回答本体
TokenUsage usage = result.tokenUsage();        // 本次调用的 token 用量
// 官方文档明确:若本次调用执行了工具(多轮 LLM 调用),
// tokenUsage() 返回的是所有轮次的自动求和
List<ToolExecution> tools = result.toolExecutions();   // 执行了哪些工具
List<Content> sources = result.sources();              // RAG 检索了什么
对比 Spring AI 1.0.0 GA:响应里拿不到同样顺手的用量对象,真实工程的 Token 账本被迫降级成「计数器口径」(按调用次数记账,在账本里自我声明局限,等升级 1.1+ 补真实 token)。同一件事在 LC4j 里是 result.tokenUsage() 一行------而且多轮工具调用的 token 自动累计求和,这正是 Agent 时代账本最需要的口径(Agent 一轮任务 = N 次模型调用,成本主战场)。
这不是「谁更好」的口水仗,而是一个重要的工程事实:框架的先天设计会真实落进你的业务代码。选型评审时,把「用量暴露的顺手程度」列进评估表,比列「支持多少个模型商」有价值得多。
三 生态与治理体检
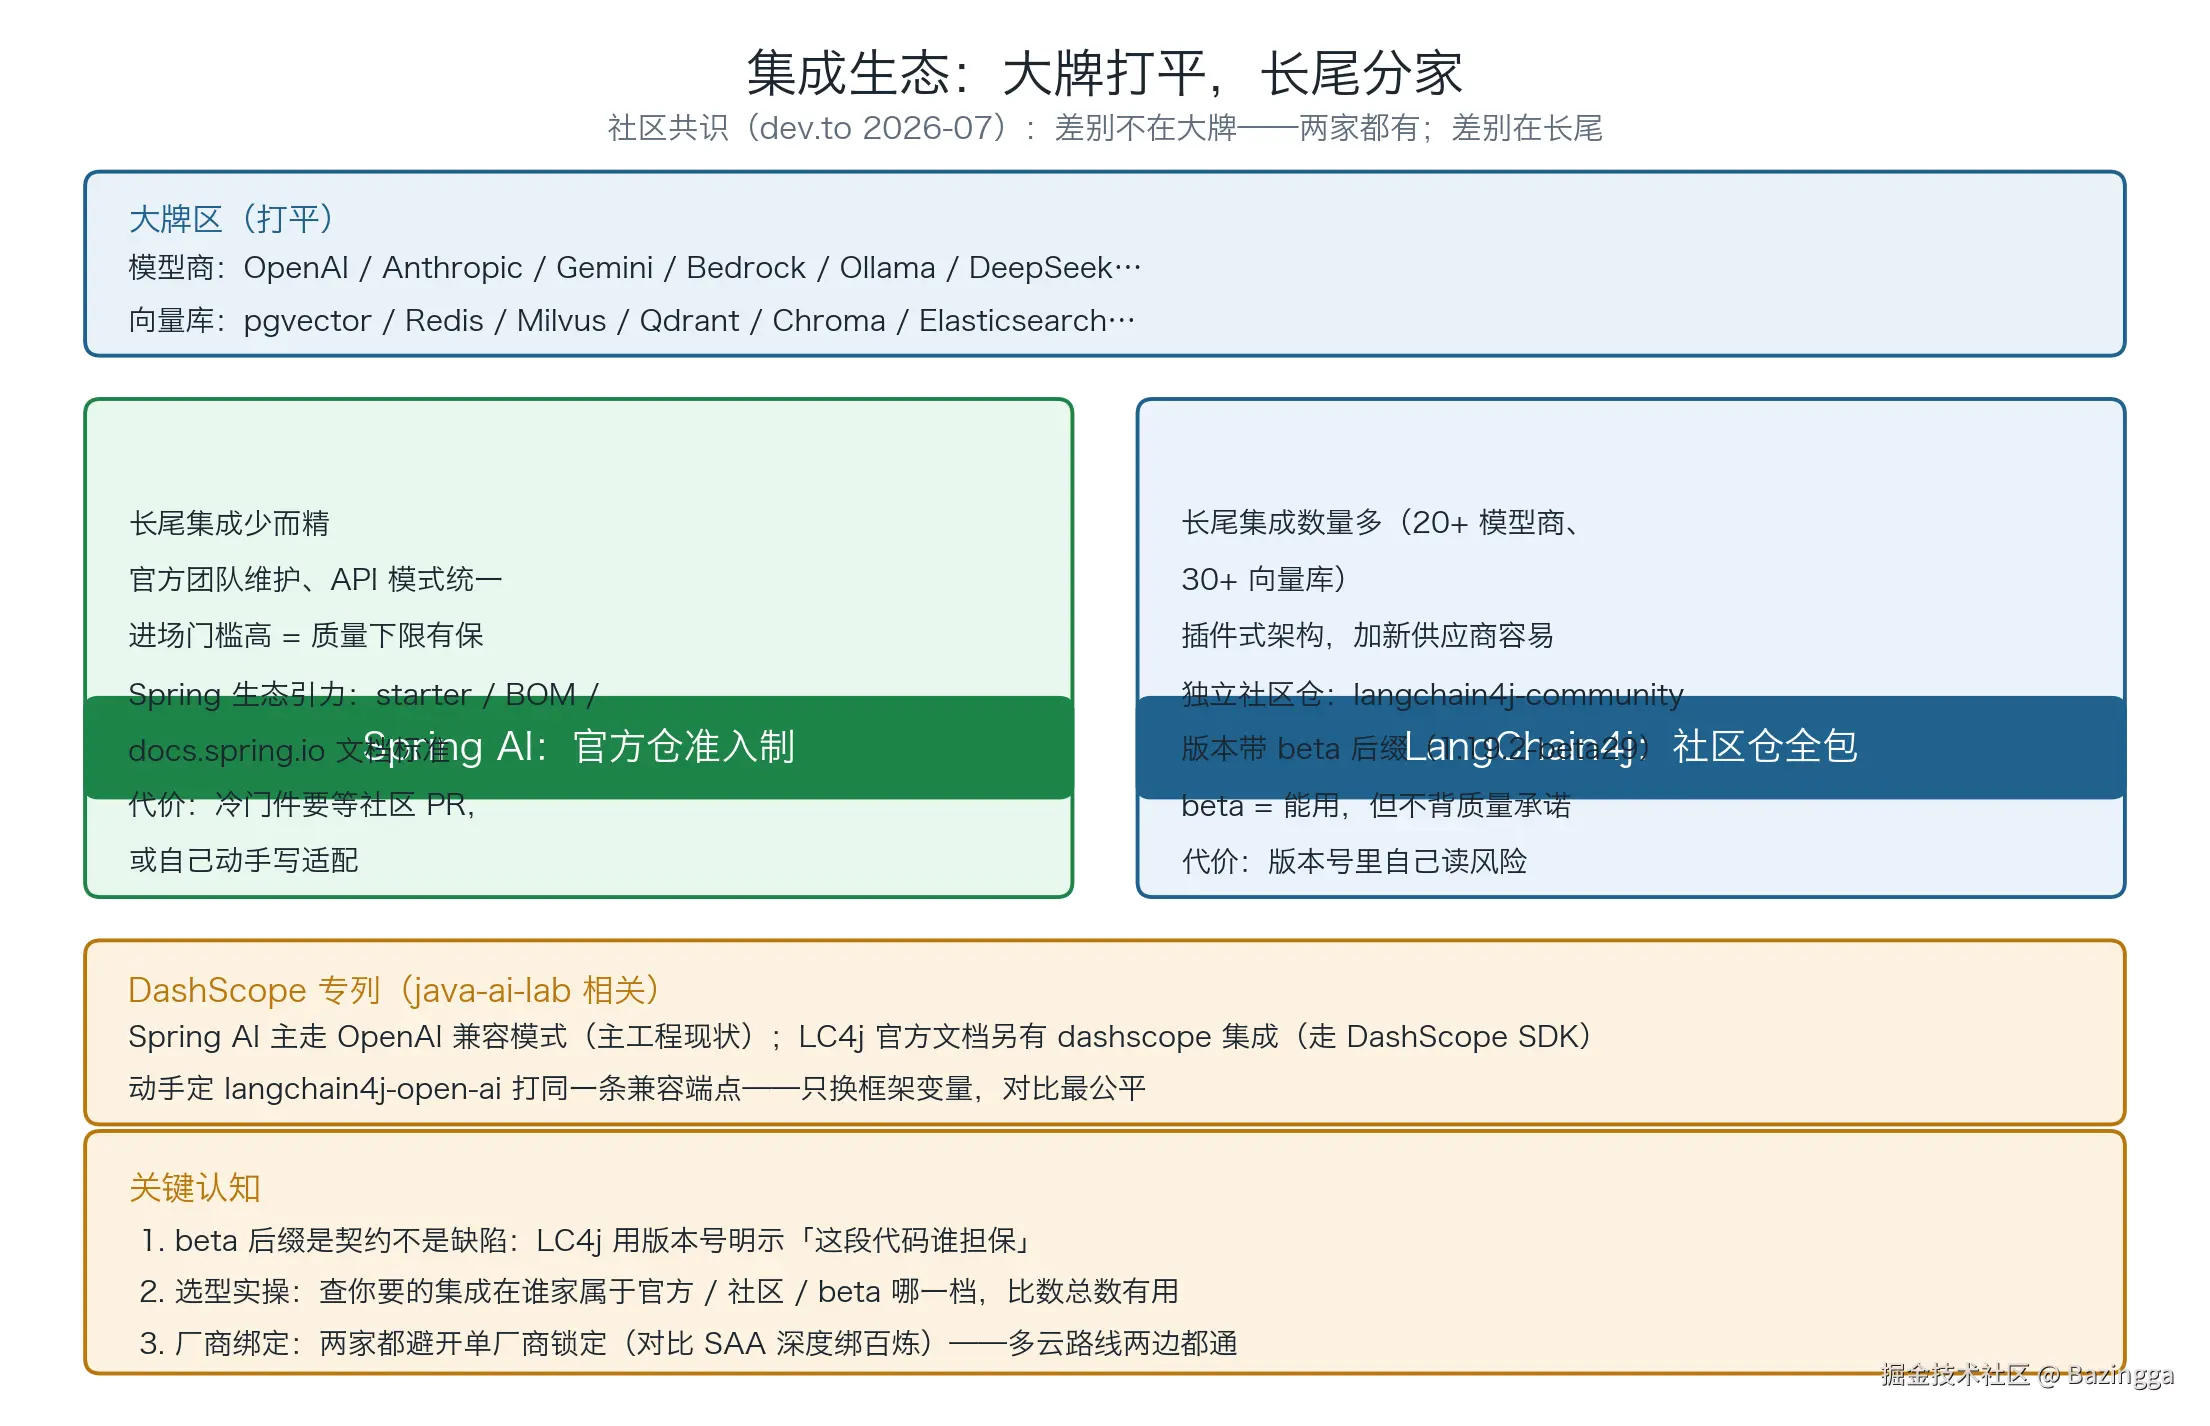
集成生态 :社区共识(dev.to,2026-07)是差别不在大牌------OpenAI、Anthropic、pgvector、Redis 两家都有;差别在长尾。Spring AI 走官方仓准入制(少而精、官方维护、API 统一,冷门件要等 PR);LangChain4j 走社区仓全包(20+ 模型商、30+ 向量库,插件式架构加新供应商容易),代价写在版本号里------社区件带 beta 后缀(如 1.19.2-beta29),beta = 能用,但不背质量承诺。这跟「官方依赖 vs 社区依赖」的老决策一模一样:选型实操不是数集成总数,是查你要的那个件在谁家属于官方 / 社区 / beta 哪一档。
对国内开发者还有一条 DashScope 专列:Spring AI 走 OpenAI 兼容端点直连(上文的 baseUrl 写法);LC4j 官方文档另有 dashscope 集成(走 DashScope Java SDK)。两条路都通,前者少一个依赖、与「换模型商只改配置」的多云路线更贴。 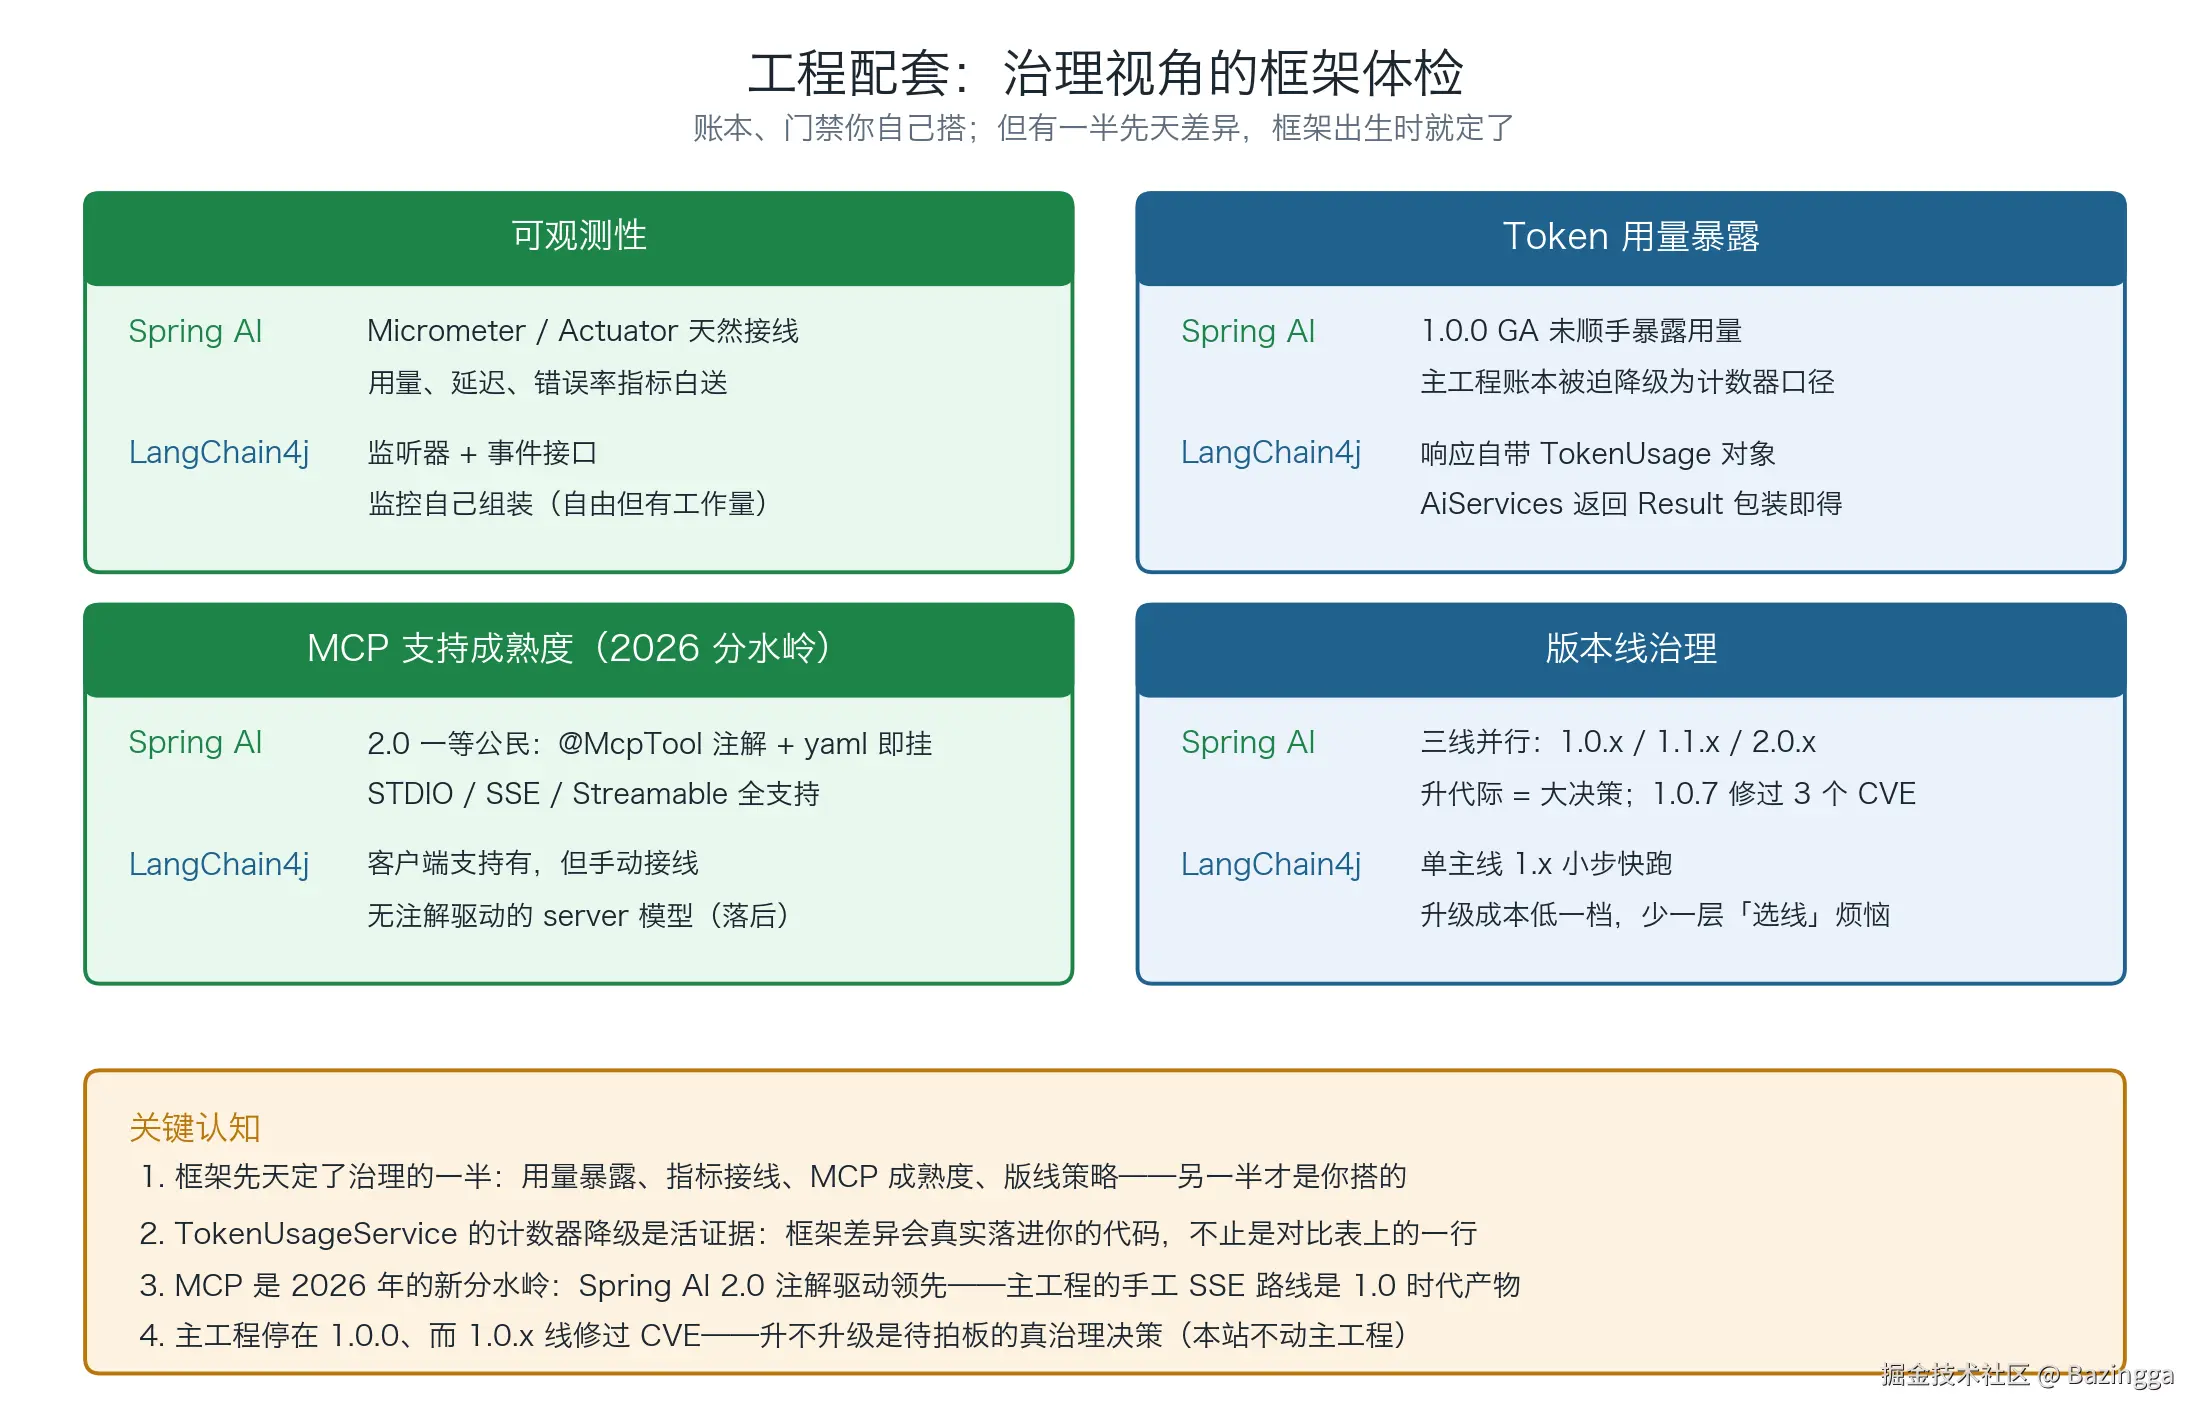
治理体检(四个维度,每个都能落到上文代码):
| 维度 | Spring AI | LangChain4j |
|---|---|---|
| 可观测性 | Micrometer / Actuator 天然接线,指标白送 | 监听器 + 事件接口,监控自己组装 |
| Token 用量 | 1.0.0 GA 未顺手暴露(账本被迫降级,见 2.6) | Result.tokenUsage() 直取,多轮自动求和 |
| MCP | 2.0 一等公民:注解驱动 + 自动装配 | 客户端支持有,手动接线 |
| 版本线 | 三线并行,「选哪条线」本身是决策;1.0.7 修过 3 个 CVE | 单主线小步快跑,升级成本低一档 |
四个维度里三个值得展开。Token 用量 上文已经用代码说话。MCP 是 2026 年的新分水岭:Spring AI 2.0 把 MCP 做成注解驱动的一等公民(@McpTool 注解 + yaml 声明即挂 server),LC4j 还在手动接线------如果 MCP 是你的核心集成模式,这一条权重很高。版本线是最容易被忽视的治理成本:Spring AI 三线并行意味着「停在哪条线、什么时候升」都是要拍板的决策(还要盯 CVE 通告);LC4j 单主线没有这个烦恼,但小版本高频也要求你有胆量跟得勤。
四 决策地图:同一地基上怎么砌墙
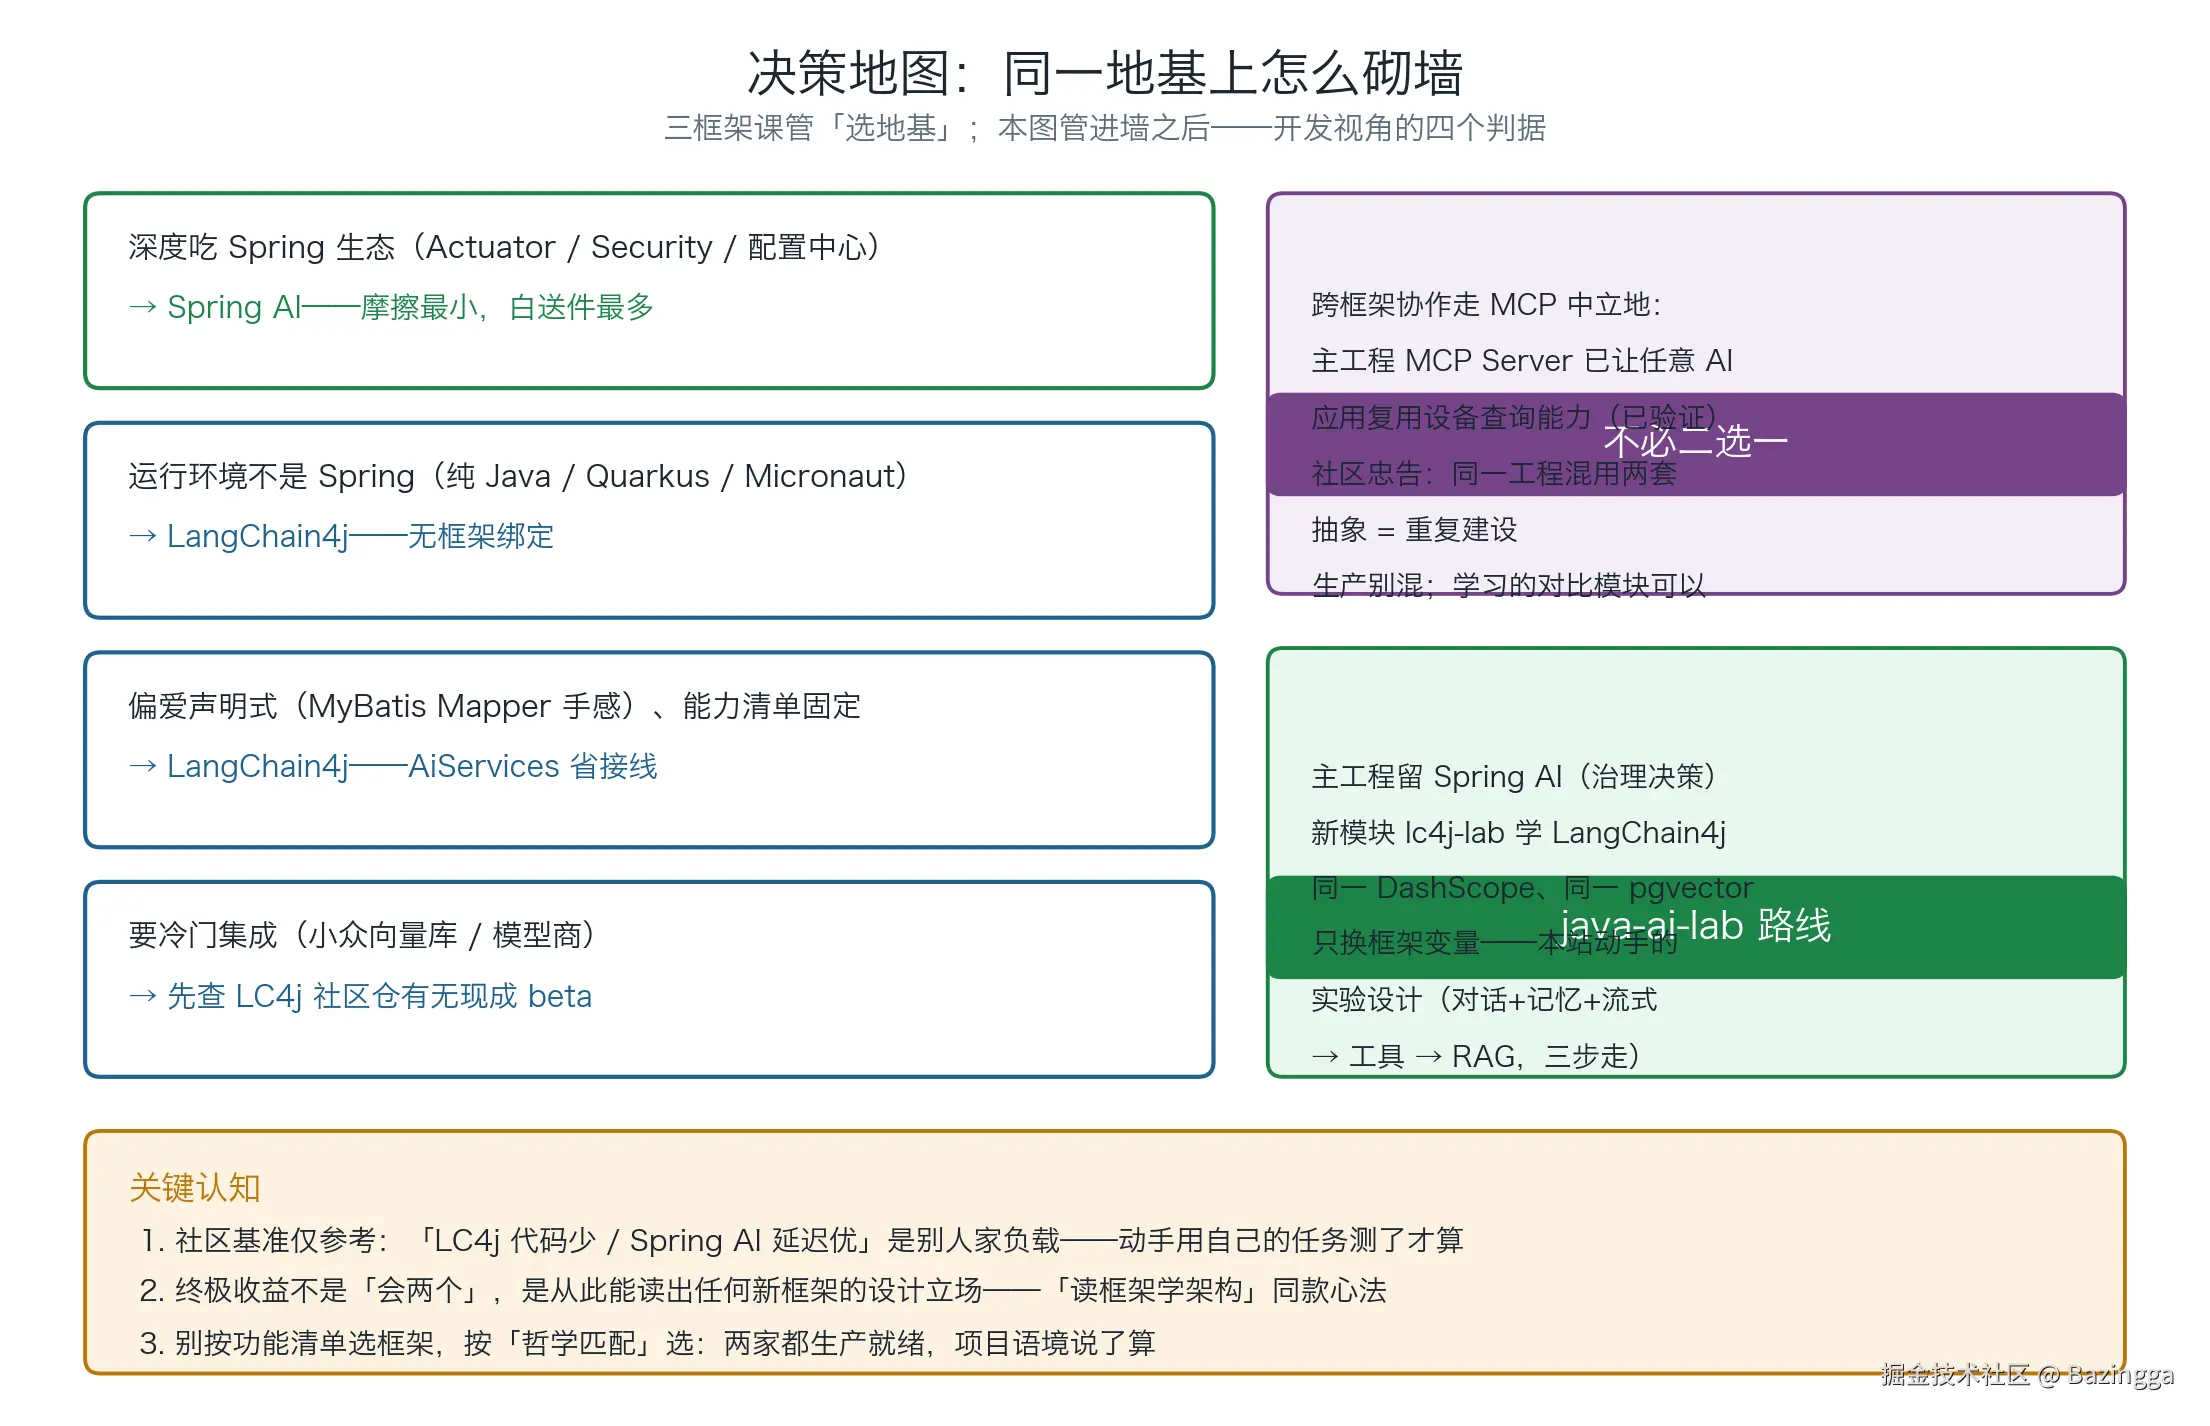
三框架层面的「选地基」结论一句话带过:Spring AI 与 LangChain4j 才是地基之争(Spring AI Alibaba 是 Spring AI 之上的精装层,不参与地基竞争)。进墙之后的开发视角判据如上图,落到文字版四条:
- 深度吃 Spring 生态(Actuator / Security / 配置中心全家桶)→ Spring AI,摩擦最小、白送件最多;
- 运行环境不是 Spring(纯 Java / Quarkus / Micronaut)→ LangChain4j,无框架绑定;
- 偏爱声明式(MyBatis Mapper 手感、能力清单固定)→ LangChain4j,AiServices 省掉大量接线代码;
- 要冷门集成(小众向量库 / 模型商)→ 先查 LC4j 社区仓有没有现成的(注意 beta 档位)。
三条补充判断:
- 社区基准仅参考:「LC4j 代码更少 / Spring AI 延迟更优」这类实测结论是别人家负载跑出来的,换你的任务未必成立------要紧的话用自己的任务跑一遍,这比看十篇对比文有用;
- 生产别混用:同一工程混两套抽象 = 重复建设(社区忠告,也是真实工程的既定纪律:主工程留 Spring AI 是治理决策,学习对比走独立模块,只换框架变量、模型与库都不动,对比才公平);
- 终极收益不是「会两个框架」,是从此能读出任何新框架的设计立场------看到一个新 API,先问它站在「组装」还是「声明」一边,五分钟就能定位它的家族。
五 零件商与壳厂:AgentScope 的位置
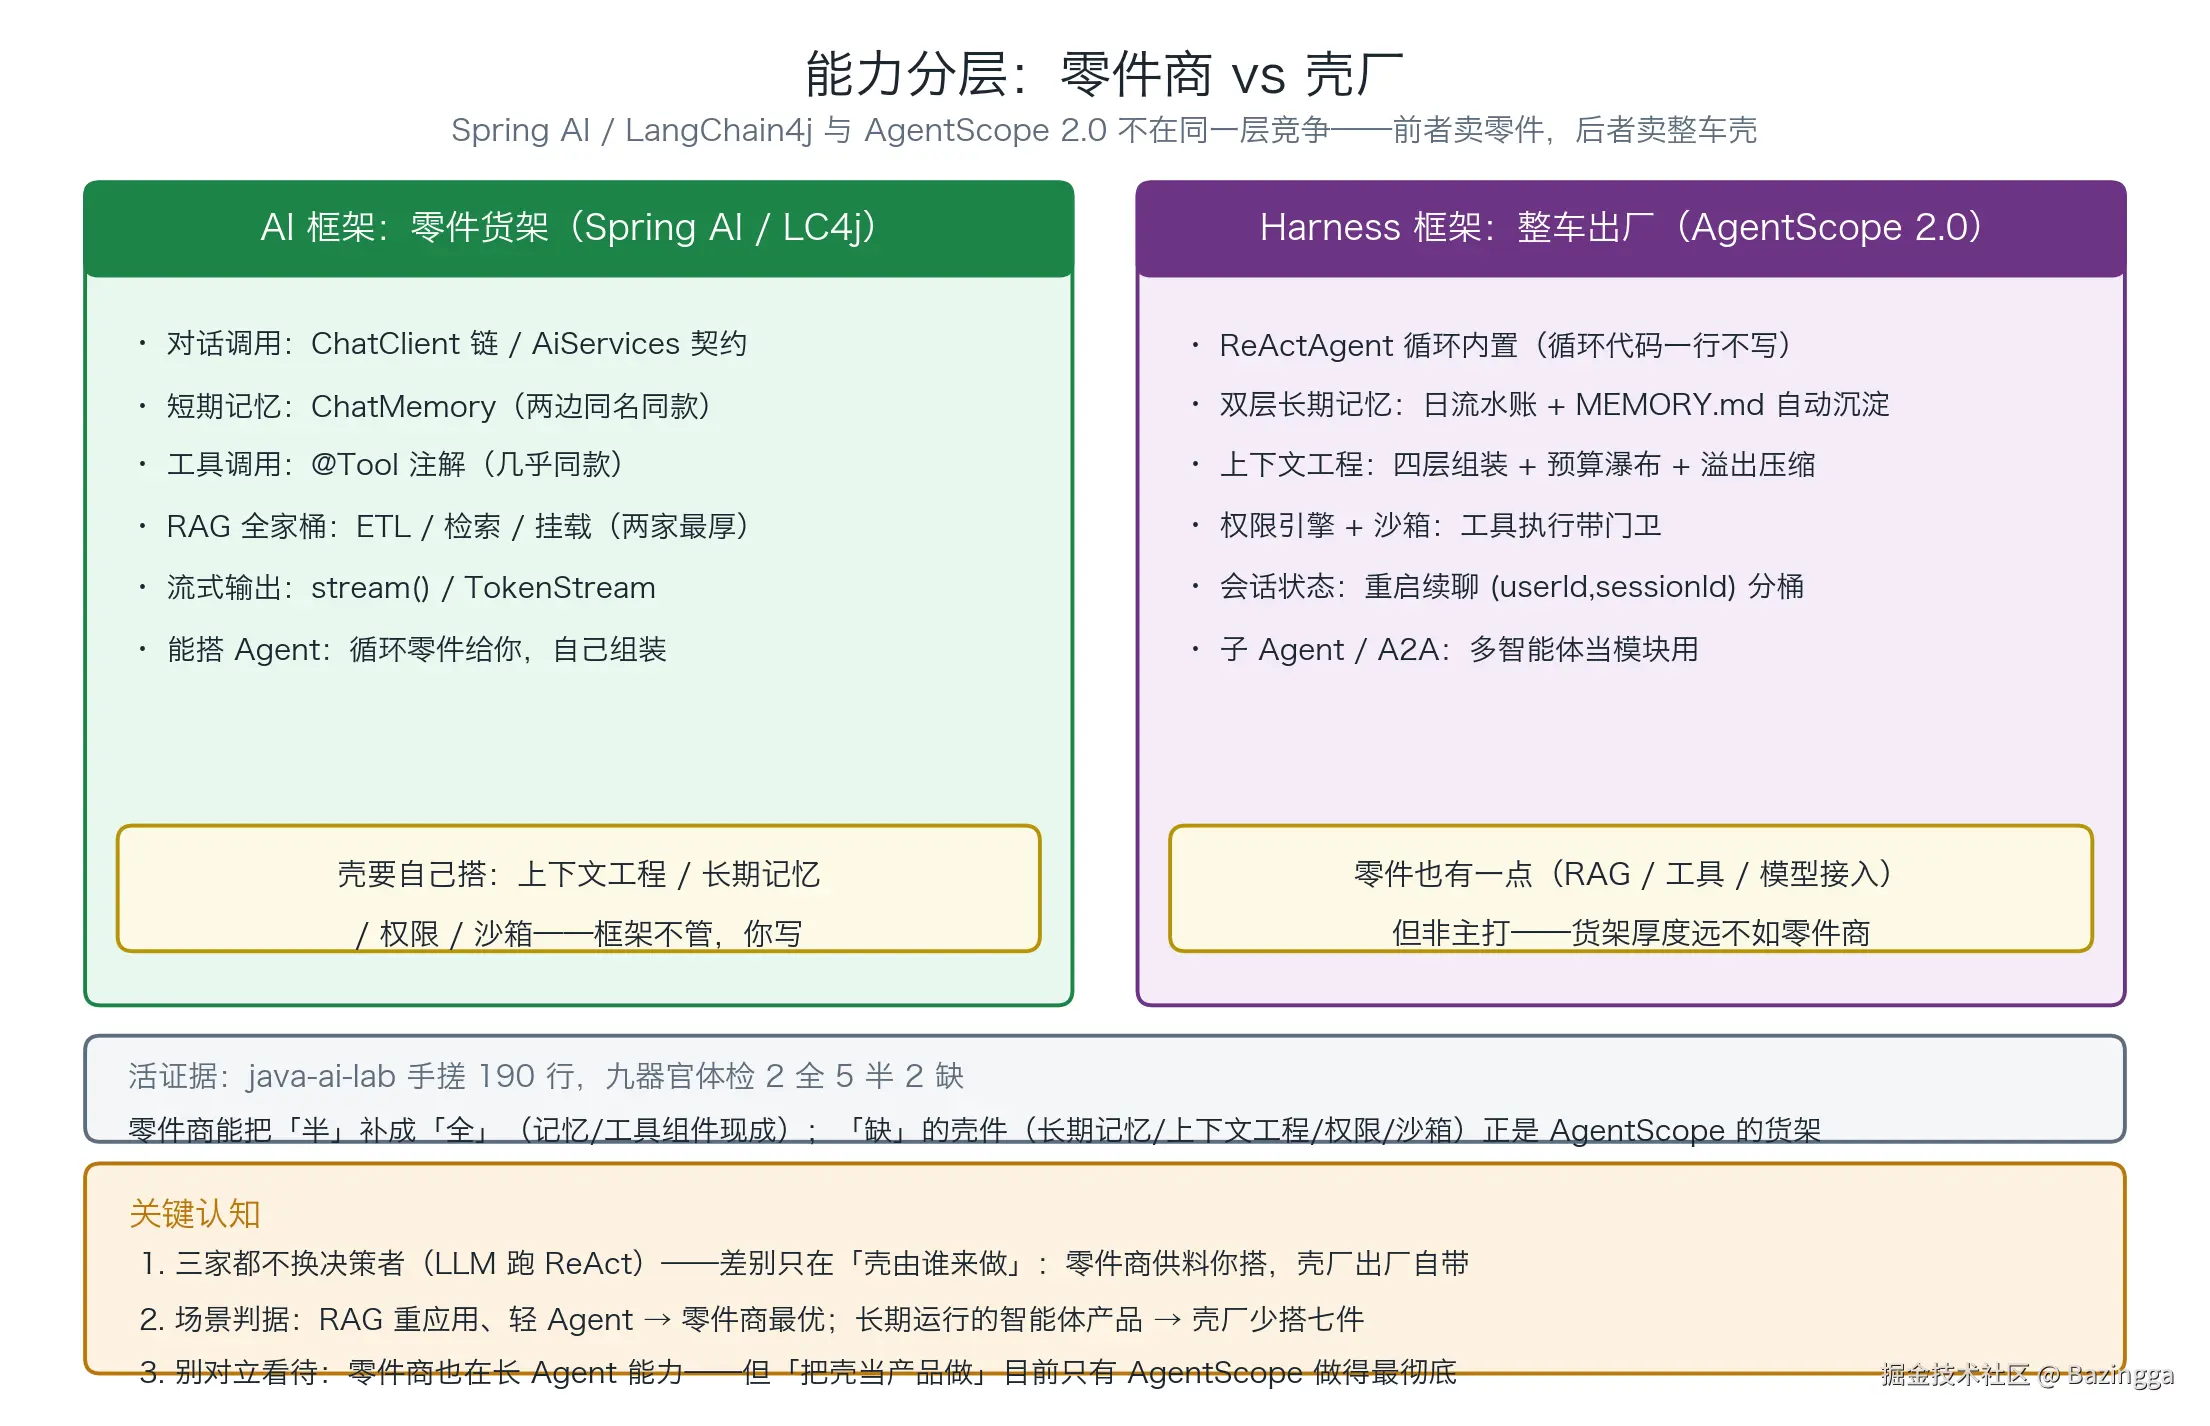
把视野再拉高一层:Spring AI / LangChain4j 与 AgentScope 2.0 根本不在同一层竞争------前两家是零件商,后者是壳厂。
零件商的货架(本文全部内容):对话、记忆、工具、RAG、流式、结构化输出------每一件都给你半成品,壳(循环、上下文工程、长期记忆、权限、沙箱)要自己搭。AgentScope 2.0 反过来:壳出厂自带(ReActAgent 循环内置、双层长期记忆自动沉淀、上下文预算瀑布、权限引擎、沙箱),零件只有一小架。
真实工程有个现成的体检样本:手搓 ReAct 循环 190 行,对照「智能体九器官」体检结果是 2 全 5 半 2 缺。零件商能把「半」补成「全」(记忆、工具、账本组件现成------本文的对比全是这半边);「缺」的四件(长期记忆 / 上下文工程 / 权限 / 沙箱)两家零件商都不内置------那正是 AgentScope 的货架。所以场景判据一句话:RAG 重、Agent 轻 → 零件商最优;长期运行的智能体产品 → 壳厂少搭七件。
这也是三家在 2026 年的真实站位:零件商在往 Agent 方向长能力(趋同演化),壳厂在把壳当产品做(目前做得最彻底的一家)。趋势是趋同,但层的边界今天依然清晰。
六 收束:代码对比之后,选型还剩下什么
回到开头的问题:Spring AI 还是 LangChain4j?写完六组代码对比,答案反而比功能矩阵时代更清楚了:
- 概念层:两家对同一个问题的两种答案------「怎么组装」vs「积木长什么样」。ChatClient 链 ≈ Filter 切面,AiServices ≈ Mapper 接口,你的旧手感站在哪边,起点就在哪边;
- 代码层 :头部能力全面趋同(工具注解换 import 就能搬家,记忆组件连名字都一样),真差异集中在三处------记忆钥匙的类型化 (
@MemoryId参数 vs Advisor 参数)、流式的形状 (回调事件流 vs Flux 管道)、账单的顺手度 (Result.tokenUsage()vs 降级计数器); - 工程层:治理的一半是框架出生时就定的------可观测性、用量暴露、MCP 成熟度、版本线策略,选型时把它们列进评估表,和功能矩阵平起平坐;
- 方法层:别按功能清单选框架,按「哲学匹配」选------两家都生产就绪,项目语境说了算。而判断哲学匹配最快的办法,就是把你的真实代码用两家各写一遍:三组下来,答案会自己浮出来。