最近在做一个需要批量处理人脸的素材整理工作,需求很简单:把一批视频里指定人物的脸换掉,用于内部素材演示,不涉及对外发布。云端换脸工具有隐私和额度上的顾虑,所以想在本机跑。试了几个方案后落到 FaceFusion 上,它算是 Rope 那一系工作流的延续,命令行和 Web UI 都有,Windows 下也有现成的整合包。这篇就把我这段时间实际用下来的配置、模型选择和参数调整过程写出来。
需要先说清楚:FaceFusion 迭代比较快,不同版本之间参数名和界面差异不小。我用的版本是 3.x 系列,具体小版本号我这里不写死,因为官方仓库更新频繁,你按自己下载到的那版为准。下面所有命令和参数名都以我本地实际能跑通的为准,如果你的版本对不上,以你版本的 --help 输出为准。
为什么选整合包而不是 pip 安装
最开始我是想按官方文档 pip 装的,结果卡在依赖上。FaceFusion 依赖 onnxruntime(或 onnxruntime-gpu)、insightface、以及一堆图像处理和视频编解码库,其中 insightface 在 Windows 上编译经常出问题,尤其是没有预编译 wheel 的时候。我折腾过一次,onnxruntime-gpu 的 CUDA 版本和本机驱动对不上,报的是很含糊的 provider 加载失败,排查成本不低。
后来改用社区维护的 Windows 整合包,本质是把 Python 环境、依赖和模型都打包好,解压即用。整合包的好处是省掉环境折腾,坏处是版本可能不是最新,而且你不太清楚里面装了什么版本。我个人的取舍是:先要能跑起来,再去理解内部。如果你有干净的 conda 环境并且熟悉 CUDA 版本匹配,pip 装也行,但要有心理准备。
整合包解压后目录大致是这样(不同打包者命名略有差异):
text
facefusion/
├── facefusion/          # 核心代码
├── models/              # 模型权重,首次运行会下载
├── ffmpeg.exe
├── python.exe
├── run.py               # 或 run.bat / 启动脚本
└── ...
【注意】模型权重不是随包全带的,很多是首次运行某个功能时才去下载。如果网络不通,会卡在下载阶段。我这边是提前确认了 models 目录里 inswapper 相关文件已经存在。
显卡和执行提供者:别默认它一定用 GPU
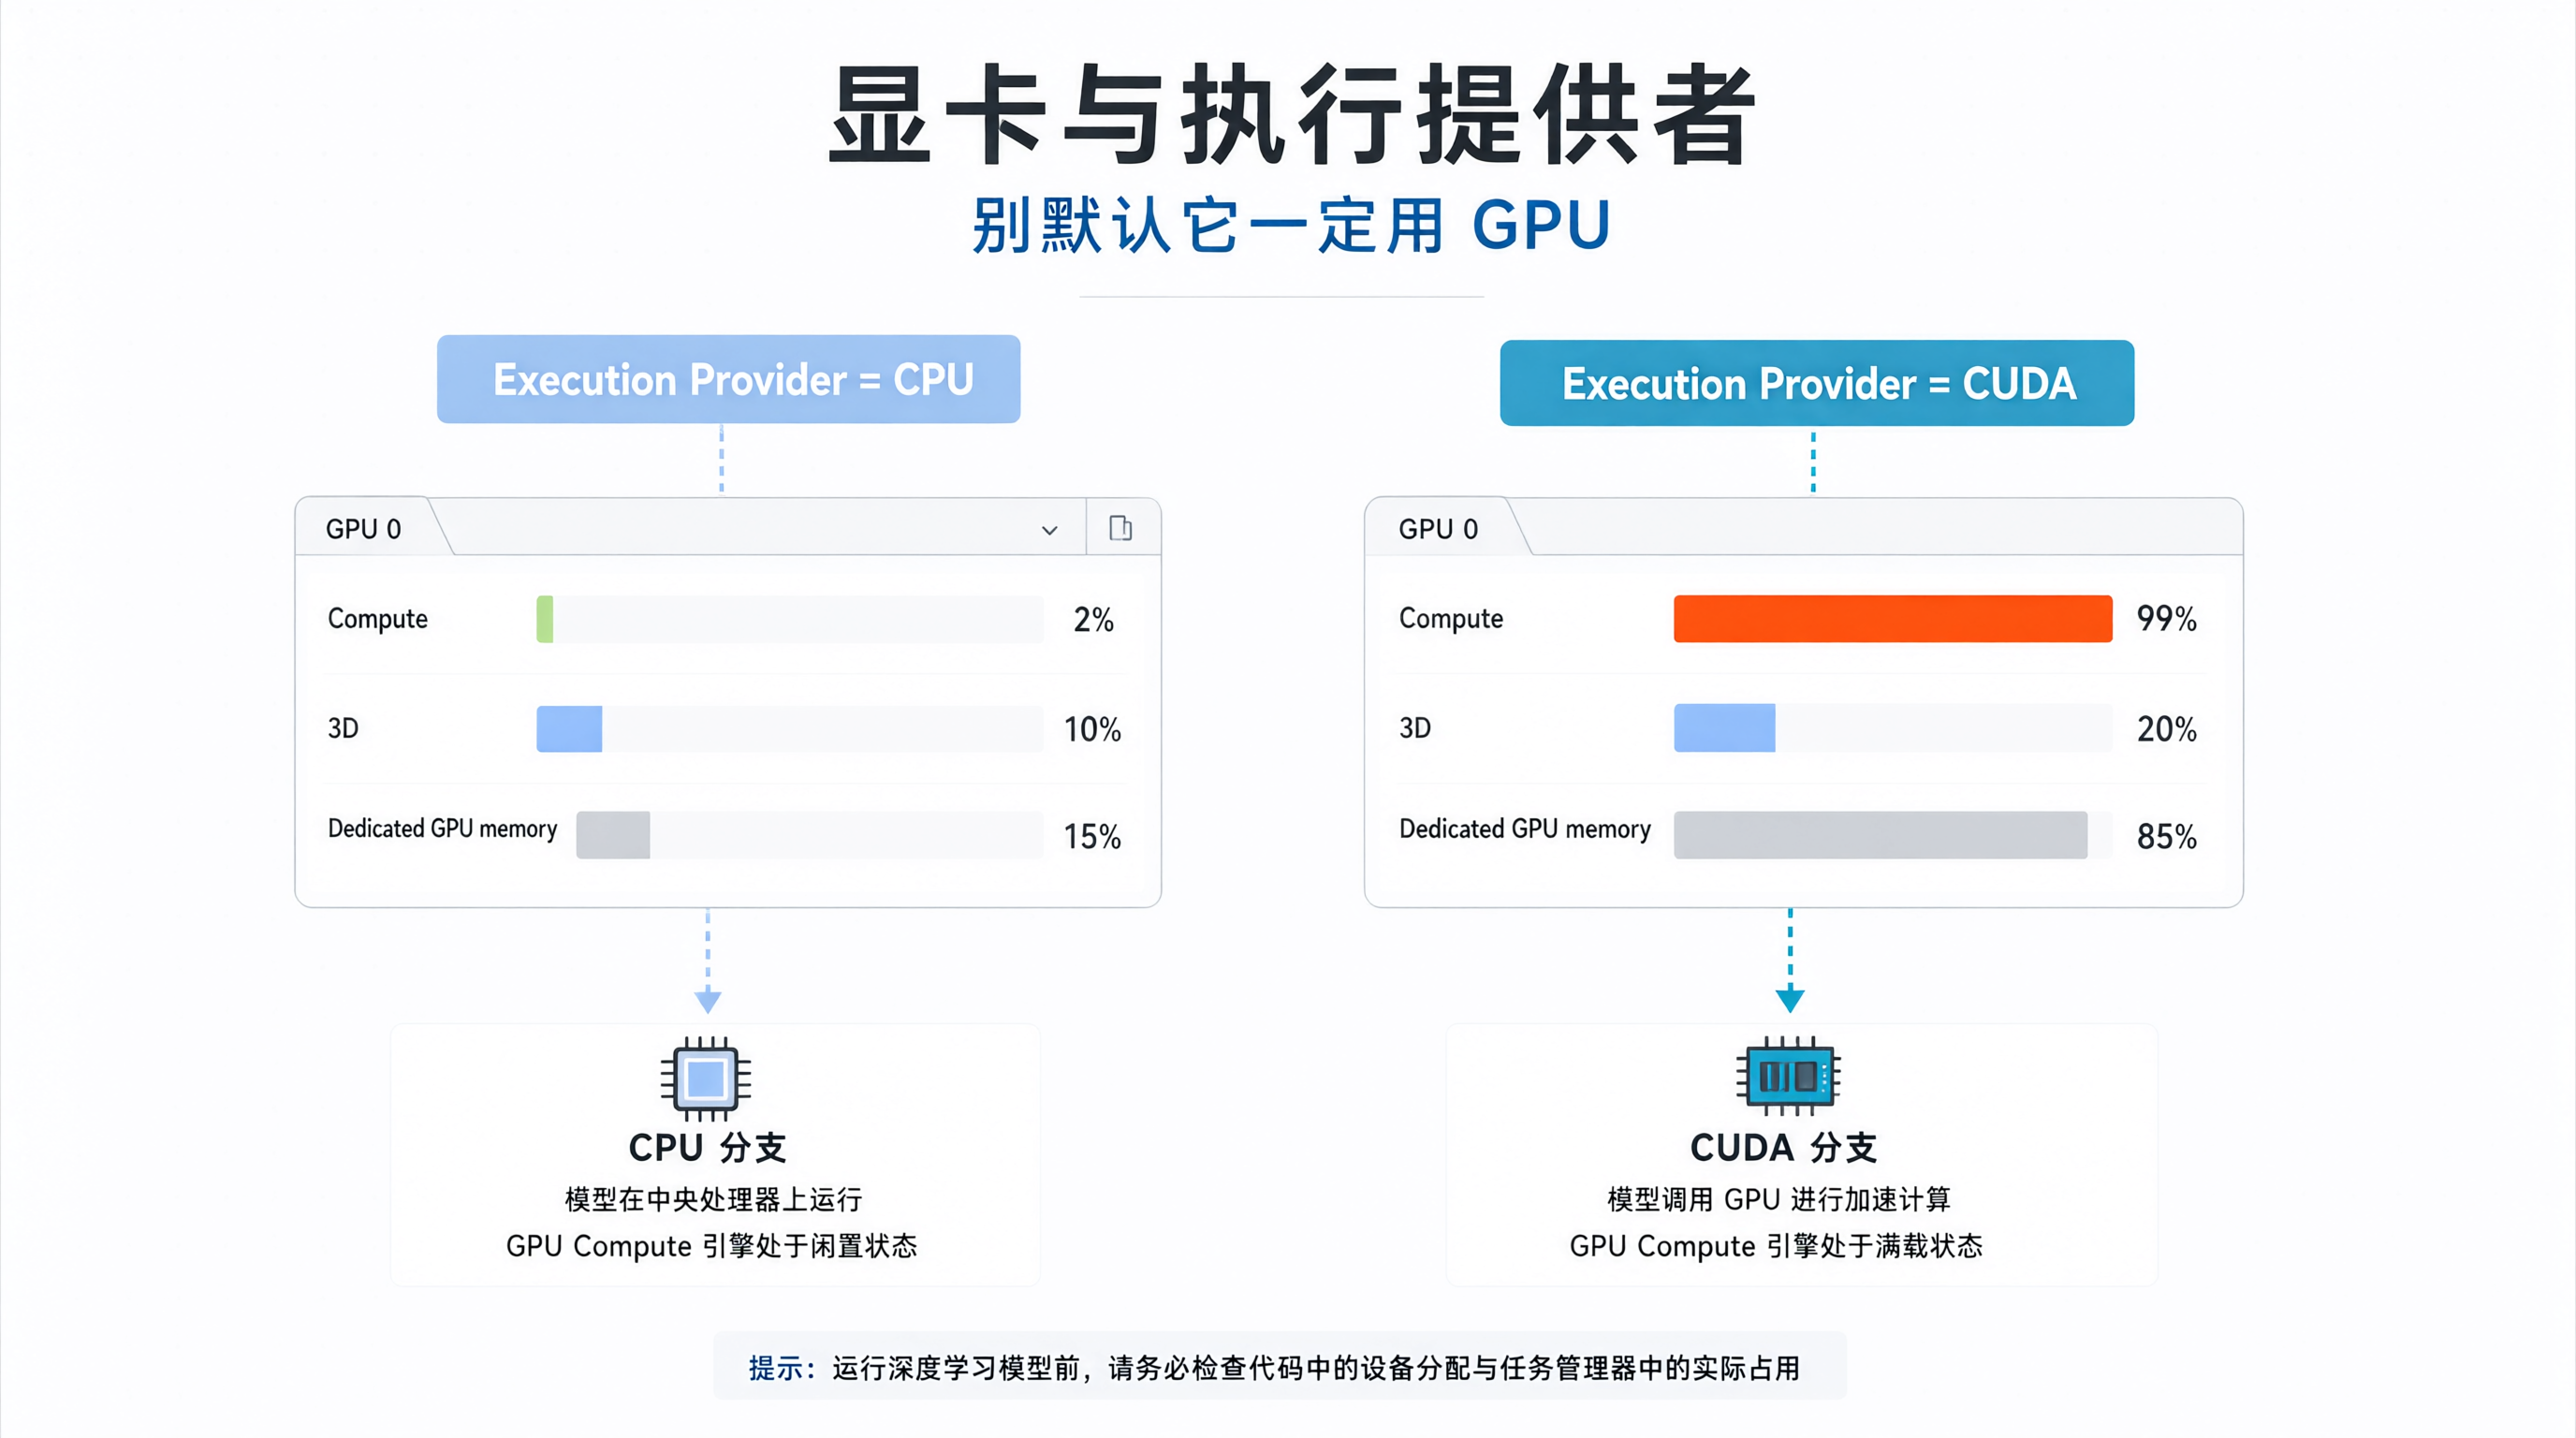
这一步是我第一个真正踩到的地方。整合包跑起来后,我默认以为它会自动用显卡,结果处理一段 10 秒视频花了好几分钟,明显是 CPU 在跑。
FaceFusion 的执行提供者(execution provider)决定了用 CPU 还是 GPU。相关参数在不同版本里名字可能是 --execution-providers 之类,取值类似 cuda、tensorrt、cpu。我这边用的是 CUDA。判断有没有真的用上 GPU,最直接的办法是处理时看任务管理器里 GPU 的 Compute 占用,或者看启动日志里 provider 的加载信息。
bash
python run.py --execution-providers cuda如果你的机器是 NVIDIA 显卡,装整合包时通常已经带了 onnxruntime-gpu,但 CUDA 和 cuDNN 的版本必须和 onnxruntime-gpu 匹配。我遇到过一次报错,大意是找不到某个 cudnn 的 dll,最后发现是 cuDNN 版本比 onnxruntime 期望的高了一档。这种情况要么降 cuDNN,要么换 onnxruntime 版本,没有捷径。
对我来说,GPU 和 CPU 的实际差距是数量级的,尤其是有面部修复模型叠加的时候。所以如果你的处理速度明显不对劲,第一件事就是确认 provider。
模型选择:inswapper 负责换,修复模型负责救
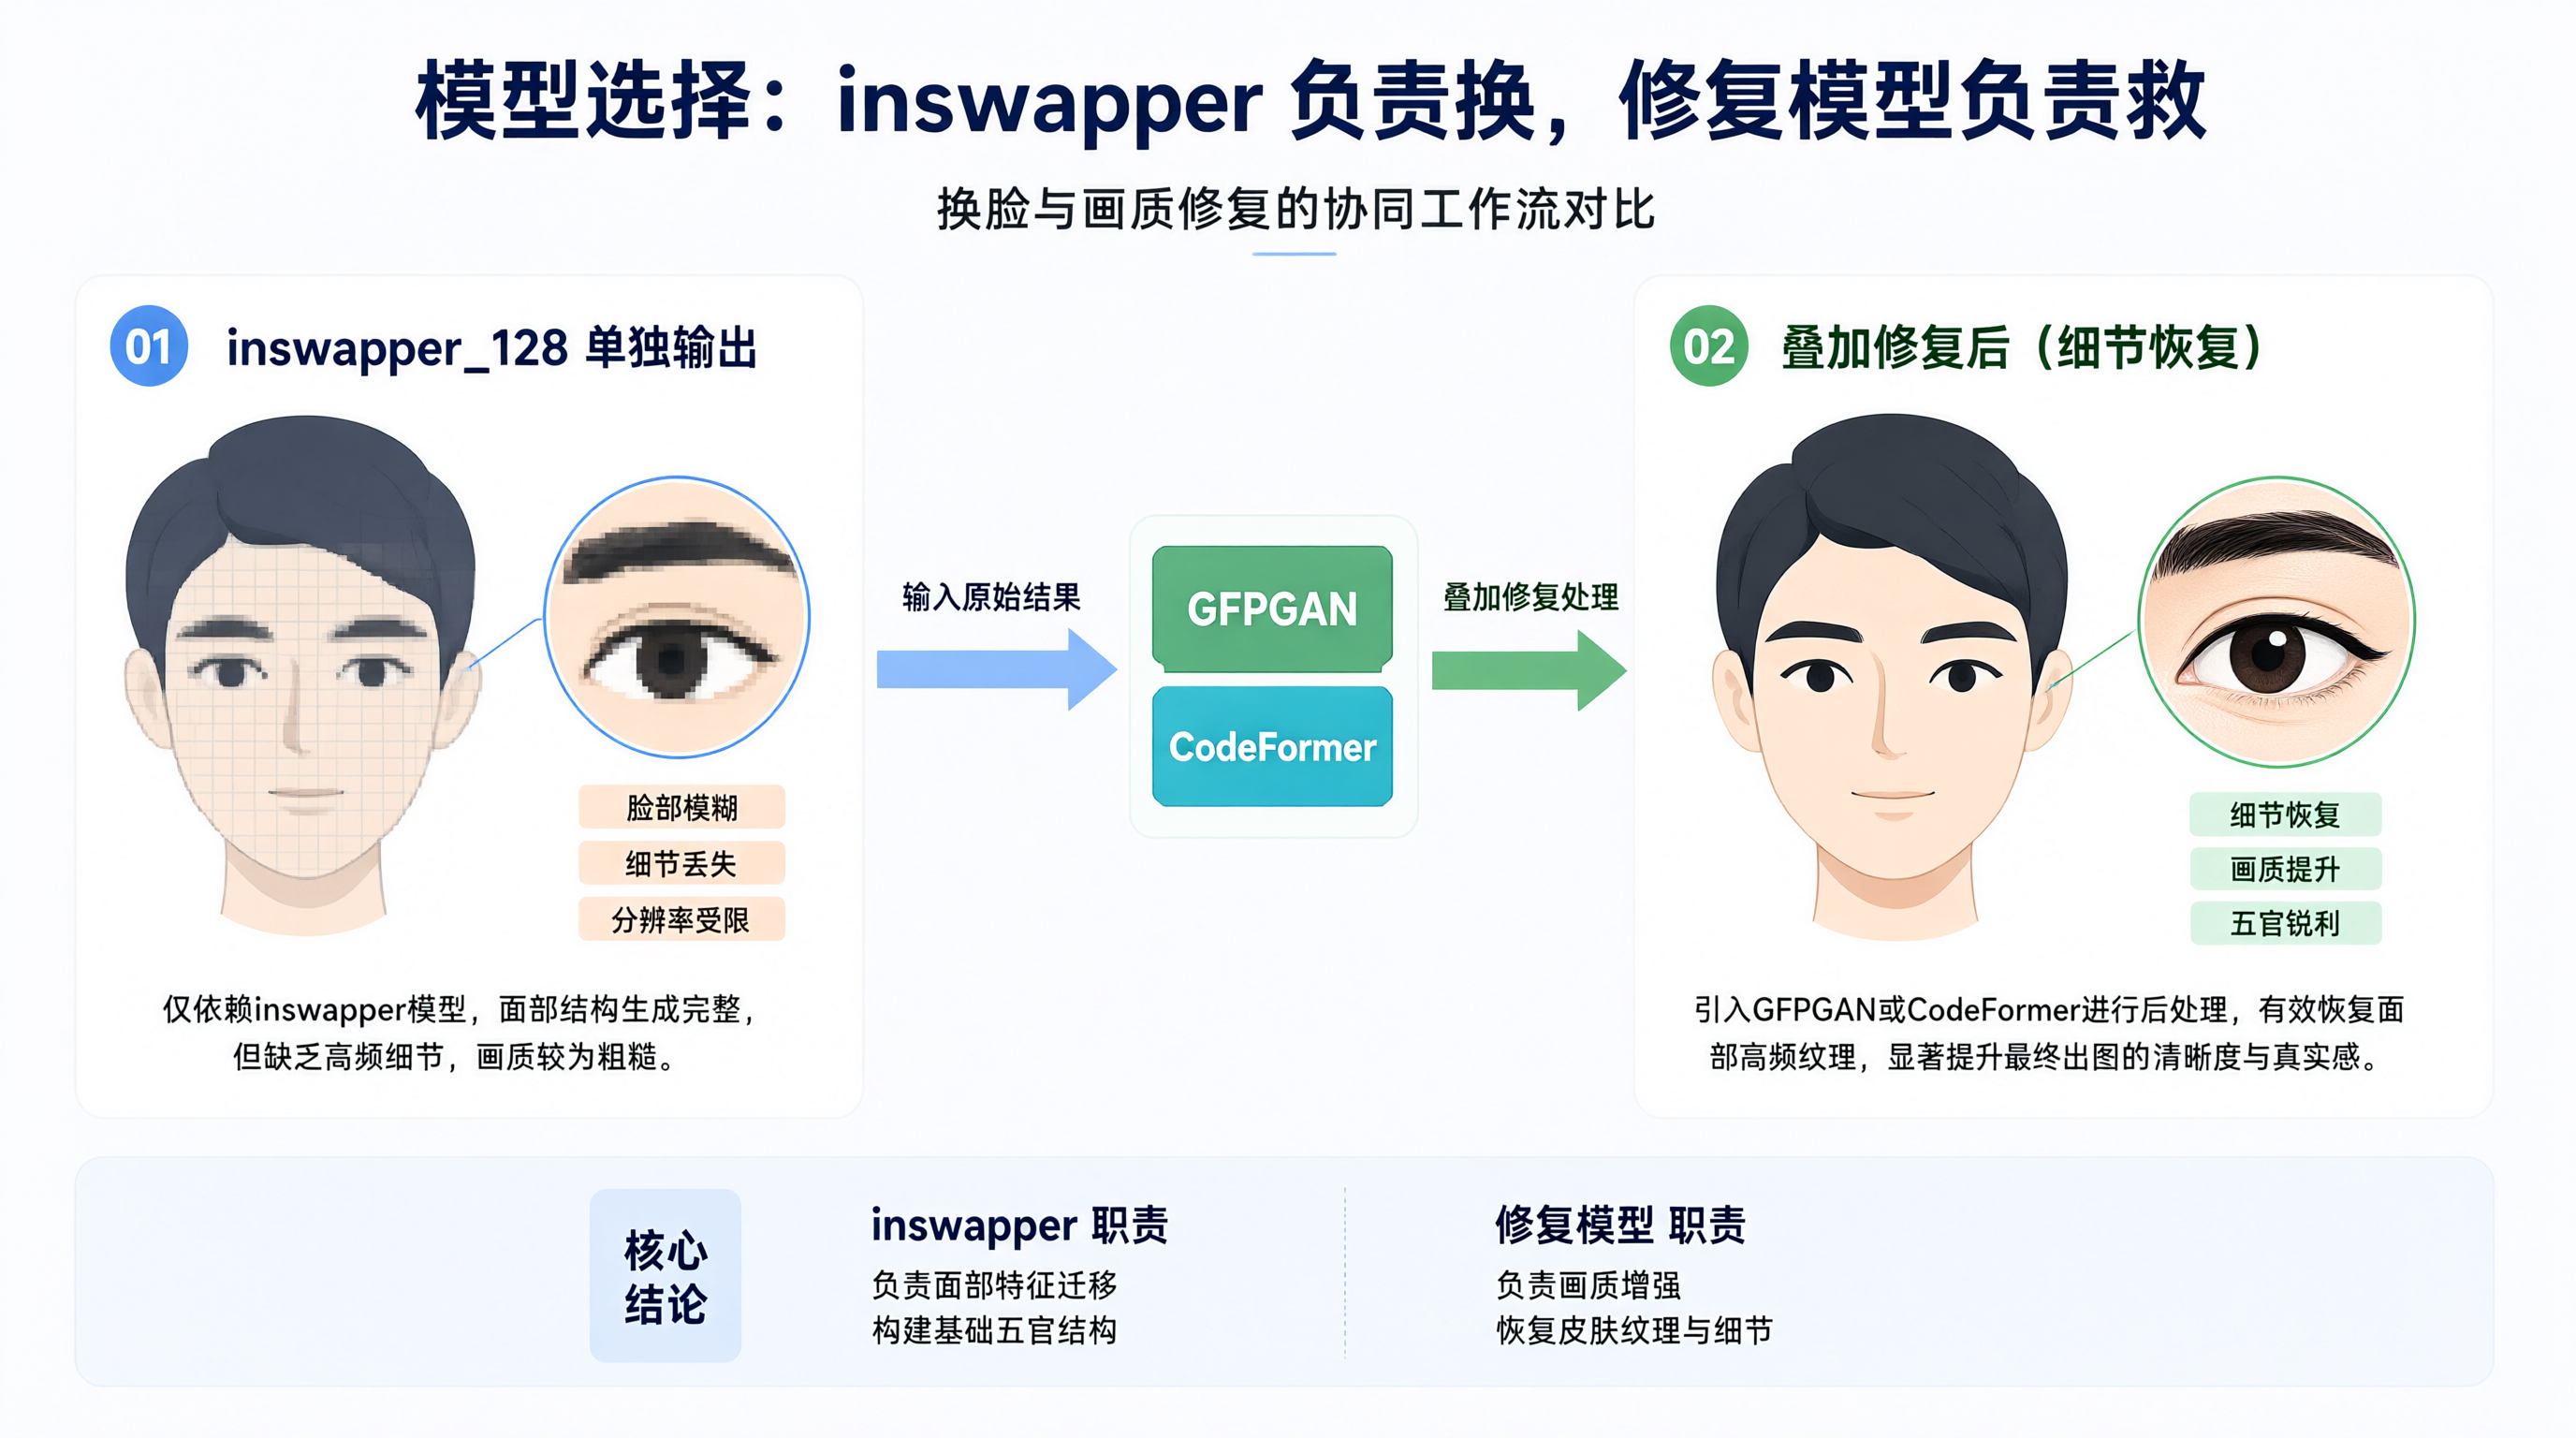
FaceFusion 的换脸核心用的是 inswapper 系列模型,常见的是 inswapper_128。这个 128 指的是输出的换脸区域分辨率大概是 128×128,所以在视频里放大看,脸部会偏糊,这是它的固有特性,不是参数没调好。
为了改善清晰度,一般会叠加一个面部修复(face enhancer)模型。我实际对比过几个:
| 方案/特性 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| inswapper_128 不叠加修复 | 速度快,资源占用低 | 脸部偏糊,细节丢失明显 | 快速预览、远景人物 |
| + GFPGAN | 面部细节恢复较好,速度尚可 | 有时会过度平滑,像磨皮 | 大多数常规视频 |
| + CodeFormer | 可调保真度权重,细节控制更细 | 速度更慢,权重调不好会失真 | 对清晰度和相似度都要求高 |
| + 其他修复模型 | 各有侧重 | 我未逐一验证 | 按需尝试 |
CodeFormer 有个保真度(fidelity)权重参数,一般用 --face-enhancer-fidelity 之类的名字(具体看你版本)。权重越高越贴近原始换脸结果、越不容易"美化过头",但太高就回到糊的状态。我一般从 0.5 附近开始试。
【关键结论】修复模型不是万能的。如果源脸和目标脸的姿态、光照差太多,修复模型会把错误也一起"修"得更明显。这种情况调修复参数没用,得回到换脸本身或者换素材。
模型文件都放在 models 目录下,首次使用某个修复模型时会下载。如果你看到某个模型一直加载失败,先去确认文件是否下全了。
多人识别:怎么让它只换我想换的那张脸
这是我觉得最需要讲清楚的部分。换脸时如果画面里有多个人,默认行为可能会把检测到的脸都换掉,或者换错人。FaceFusion 提供了 face selector 相关的模式,常见的有 reference、one、many 这几类思路:
many:检测到多少脸就处理多少脸,多人场景会全换。one:只处理一张脸,通常是画面里最显著的那张。reference:根据一张参考图去匹配目标脸,只换和参考脸相似的人。
我的需求是"只换某个人",所以用的是 reference 模式,配合一张该人物的参考图。
bash
python run.py \
  --source source_face.jpg \
  --target input_video.mp4 \
  --output output.mp4 \
  --face-selector-mode reference \
  --reference-face-position 0 \
  --execution-providers cuda
这里的 --reference-face-position 指的是参考图里第几张脸作为匹配基准(参考图里也可能有多张脸)。参数名我按本地版本来,你的版本可能叫法不同,务必用 --help 核对。
reference 模式的匹配靠的是人脸特征向量相似度,所以参考图质量很关键。我用一张正脸、光照均匀、分辨率够的图,匹配就稳;换成侧脸或者模糊的图,就会出现有时换对有时换错的情况。这一点我反复验证过,参考图质量几乎决定了多人场景的成败。
【踩坑提醒】如果你的参考图本身是视频截图,压缩噪点大,匹配会不稳定。宁可多花点时间找一张干净的正面照。
遮罩处理:接缝和鬼影基本都出在这
换脸贴回原视频时,如果直接把换好的脸硬贴上去,边缘会有明显的矩形接缝,或者下巴、头发边缘出现鬼影。FaceFusion 用遮罩(mask)来处理这个融合。我接触到的主要有几类遮罩参数:
- box mask(框遮罩):以检测框为基础,控制边界模糊和上下左右扩展。模糊(blur)让边缘过渡自然,扩展(padding)让遮罩稍微超出检测框,避免裁掉下巴或额头。
- occlusion mask(遮挡遮罩):处理手、头发、眼镜等挡住脸的情况。开启后它会尝试识别遮挡区域,不把换脸结果盖到遮挡物上。
- region mask(区域遮罩):更精细地按脸部区域(比如只换嘴部、眼睛)来限定范围。
我的实际做法是:先开 box mask 的模糊和适度扩展,把硬接缝解决掉;如果画面里有手挡脸或者戴眼镜,再开 occlusion mask。
bash
python run.py \
  --source source_face.jpg \
  --target input_video.mp4 \
  --output output.mp4 \
  --face-mask-types box occlusion \
  --face-mask-blur 0.3 \
  --face-mask-padding 5 5 0 0 \
  --execution-providers cuda
--face-mask-padding 的四个值一般对应上、下、左、右的扩展像素或比例。我习惯上、下多给一点,因为下巴和额头最容易露馅。具体数值要按素材分辨率试,没有万能值。
这里我必须诚实说一点:遮挡遮罩不是万能的。当手快速划过脸、或者头发丝很细的时候,遮挡检测会漏,还是会出现鬼影。这种情况我目前没有找到特别好的纯参数解法,只能靠挑选素材或者接受一定瑕疵。如果你对这块有更好的处理方式,欢迎交流。
处理流程与性能
我把日常用的流程整理成几步,方便复用:
- 确认 execution provider 用的是 GPU,跑一小段测试确认速度正常。
- 准备一张干净的参考图,确认参考图里目标脸的位置(对应 reference-face-position)。
- 先用不叠加修复模型的配置快速跑一遍预览,确认换脸对象没选错。
- 确认无误后叠加修复模型和遮罩参数,跑正式输出。
- 输出后检查边缘接缝、遮挡处鬼影、以及多人场景有没有换错人。
性能上,GPU 处理一段 1080p 视频,速度主要受帧数、是否叠加修复模型、以及遮罩复杂度影响。叠加 CodeFormer 会比不叠加慢不少,这个差距在长视频上会很明显。所以预览阶段我一般不叠修复模型。
一些我没验证清楚的地方
写技术文最怕把没验证的东西说成结论,这里明确标出来:
- TensorRT provider 我这边没配成功,具体性能提升多少我没有验证。
- 某些较新的修复模型我没有逐一测过,表格里"其他修复模型"那格是留白的,不做评价。
- 遮挡遮罩在极端场景(快速运动、细发丝)下的失败率,我没有做过系统统计,只是观察到会漏。
- 不同 FaceFusion 版本之间参数名差异,我建议你以自己版本的
--help为准,不要照抄本文命令。
结尾
FaceFusion 在本地换脸这件事上,工程完成度是够的,整合包也降低了上手门槛。真正花时间的不是"跑起来",而是三件事:确认真的用上了 GPU、多人场景把目标选对、以及遮罩参数一点点调到接缝不明显。模型选择反而是相对固定的,inswapper 加一个修复模型基本能覆盖大多数情况。
如果你也在做类似的事,我的建议是先把预览流程跑顺,别一上来就叠满修复和遮罩去跑长视频,那样调参成本太高。至于遮挡和快速运动下的鬼影,目前还是个需要靠素材挑选绕开的问题,这块要是有更成熟的方案,值得再研究。