AgentScope到底是用来做什么的?一篇笔记说清楚
这篇笔记围绕一个曾被问住的问题组织:AgentScope 到底是用来做什么的? 先用一句话钉死答案,再沿着"为什么有它 → 它替你省了什么 → 做出来长什么样 → 什么时候用"层层展开,最后把引擎室、动手实测和两个高频误会一次讲透。
〇、它到底是用来做什么的
如果只允许记住一句话:
AgentScope 是阿里开源的智能体框架:你只写业务------一段提示词加几个 @Tool 工具方法;它包办其余全部------让 LLM 像一名员工一样长期干活所需的基础设施。
对 Java 后端最有感觉的类比------它至于 AI Agent 应用,就像 Spring Boot 之于 Web 应用:
| Web 应用 | AI Agent 应用 | |
|---|---|---|
| 你写什么 | Controller / Service 业务逻辑 | 提示词 + 业务工具方法 |
| 框架包办什么 | 内嵌容器、依赖注入、事务、安全 | 推理循环、记忆、上下文压缩、沙箱、多实例部署 |
| 不用框架会怎样 | 手搓 Socket、手写路由 | 手搓 ReAct 循环、手搓记忆、手搓状态管理 |
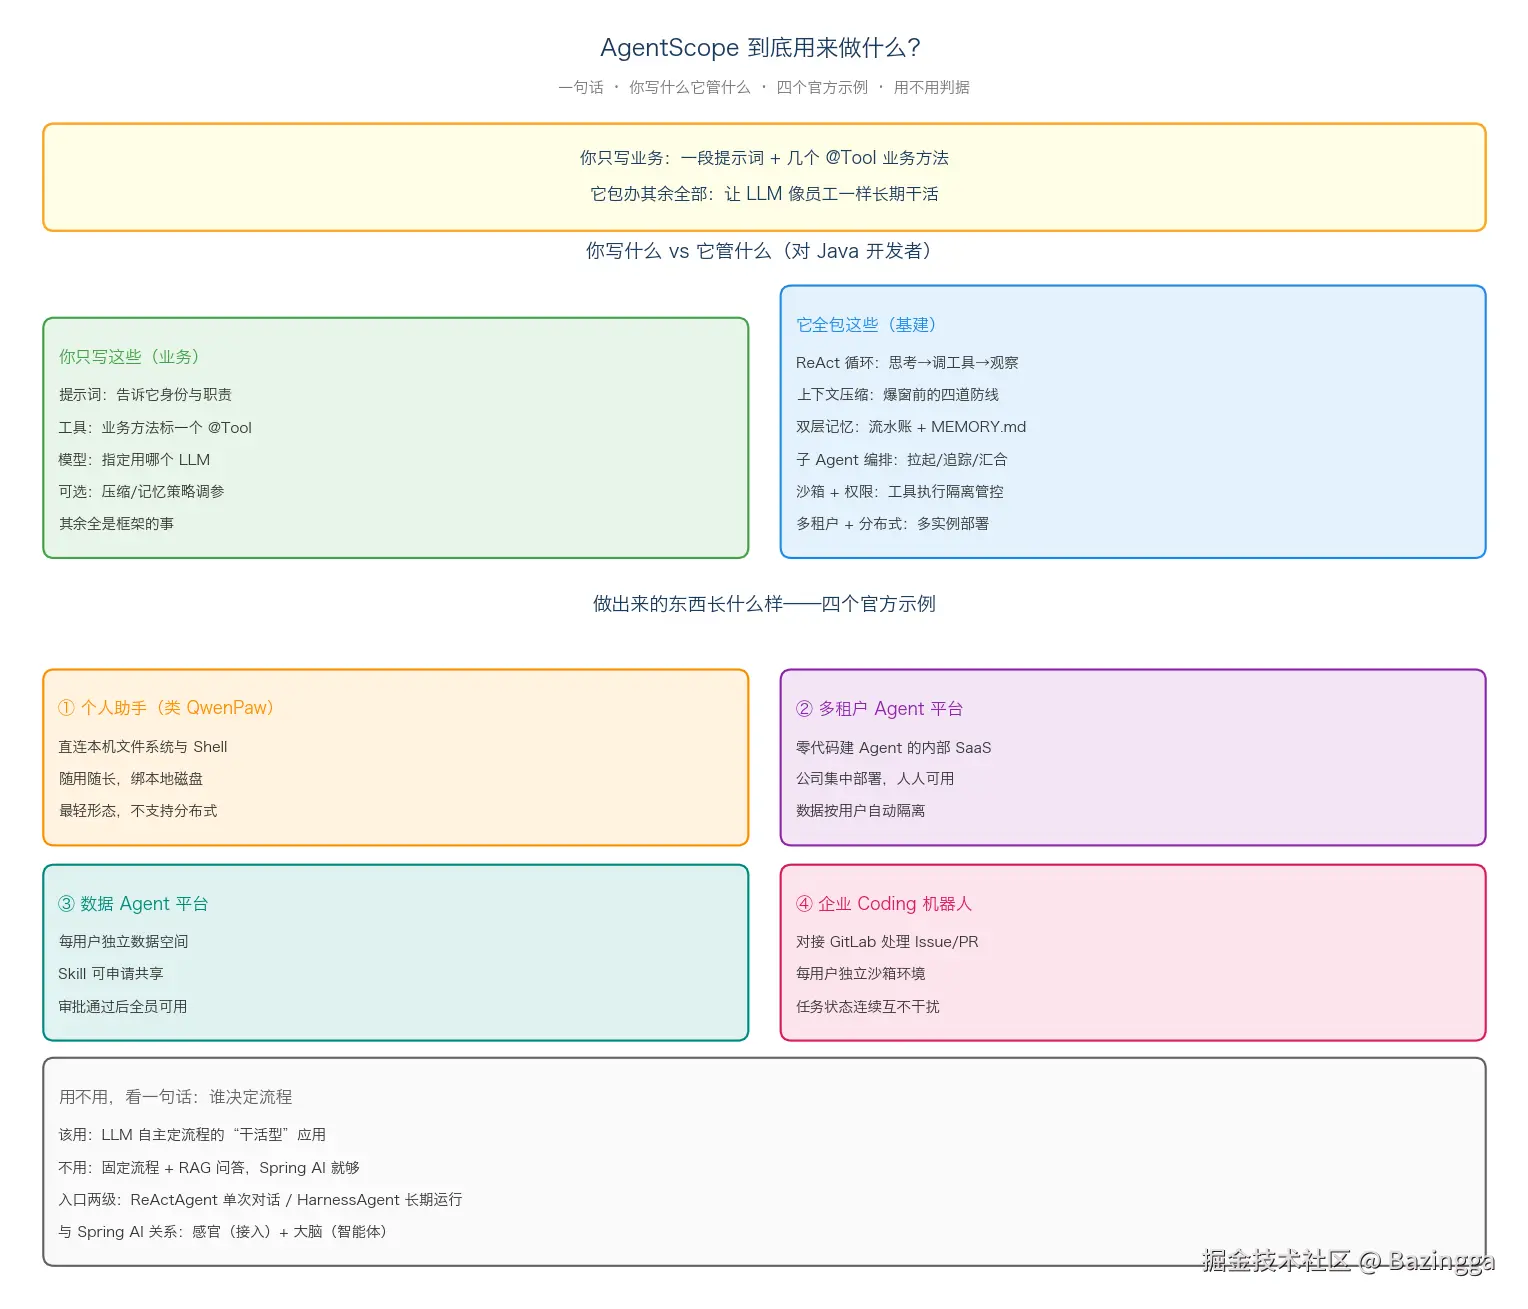
做出来的东西长什么样:四个官方示例
官方仓库里有四个真实示例,比任何定义都直观:
- 个人助手(类 QwenPaw)------直连本机文件系统与 Shell,随用随长,绑本地磁盘,最轻形态,不支持分布式部署;
- 多租户 Agent 平台------公司内部集中部署的"零代码建 Agent"SaaS,人人可建、数据自动按用户隔离,正是 Claude Managed Agents、Qoder Cloud Agents 这类产品的原型;
- 数据 Agent 平台------每个用户独立数据空间,沉淀出的 Skill 走审批流程共享给全员;
- 企业 Coding 机器人------集中部署后对接 GitLab,谁处理 Issue / PR 就给谁拉起一个独立沙箱,任务状态连续、互不干扰。
再加一个事实佐证:阿里内部飞猪、淘宝闪购、淘天交易、1688、千问 APP、高德、蚂蚁国际等 13+ 条业务线在生产上使用,官方口径是"阿里内部使用最广泛的 Agent 框架"(Java 与 Python 合计)。
用不用,看一句话:谁决定流程
- 该用:LLM 自主决定流程的"干活型"应用------下一步干什么、调哪个工具、什么顺序,是模型自己想的;
- 不用:固定流程 + 每步调一下 LLM 的"流水线型"应用------比如 RAG 问答,Spring AI 甚至手搓就够。
拿本系列的仓储项目套这条判据线:设备诊断 Agent 的调查步骤(先查状态、再查知识库、信息不够继续查)是模型自主规划的,所以它早就在"该用"的那一侧------此前手搓的,正是它的内置件。
一、为什么会有它:一个名字,两代框架,三条语言线
Java 开发者想构建 Agent,搜一圈会发现 LangChain、AutoGen、CrewAI 全是 Python------而企业主力栈是 Spring Boot + Maven + JDK 17,金融、政务、电商全是 Java 的地盘。难道为了做个 Agent 要专门养一套 Python 环境? AgentScope Java 版就是回答这个问题的:不是把 Python 框架翻译成 Java,而是从 Java 生态的实际出发重新设计。
时间线上一手可核:
- Python 版:2024 年 2 月开源(本尊首发地);
- Java 1.0:2025 年 12 月发布,"面向 Java 开发者提供企业级 Agentic 应用构建能力";
- Java 2.0 GA:2026 年 7 月 10 日(经 5 个 RC 迭代),此后两月连发 2.0.1、2.0.3,维护活跃度极高;
- 语言版图:Python / Java / TypeScript 三语言实现,Go 版开发中。
2.0 的核心变化用官方原话说:"把 Harness 整套方案内置到了框架里面" ------这也意味着它面向的场景,主要是企业级的分布式智能体。 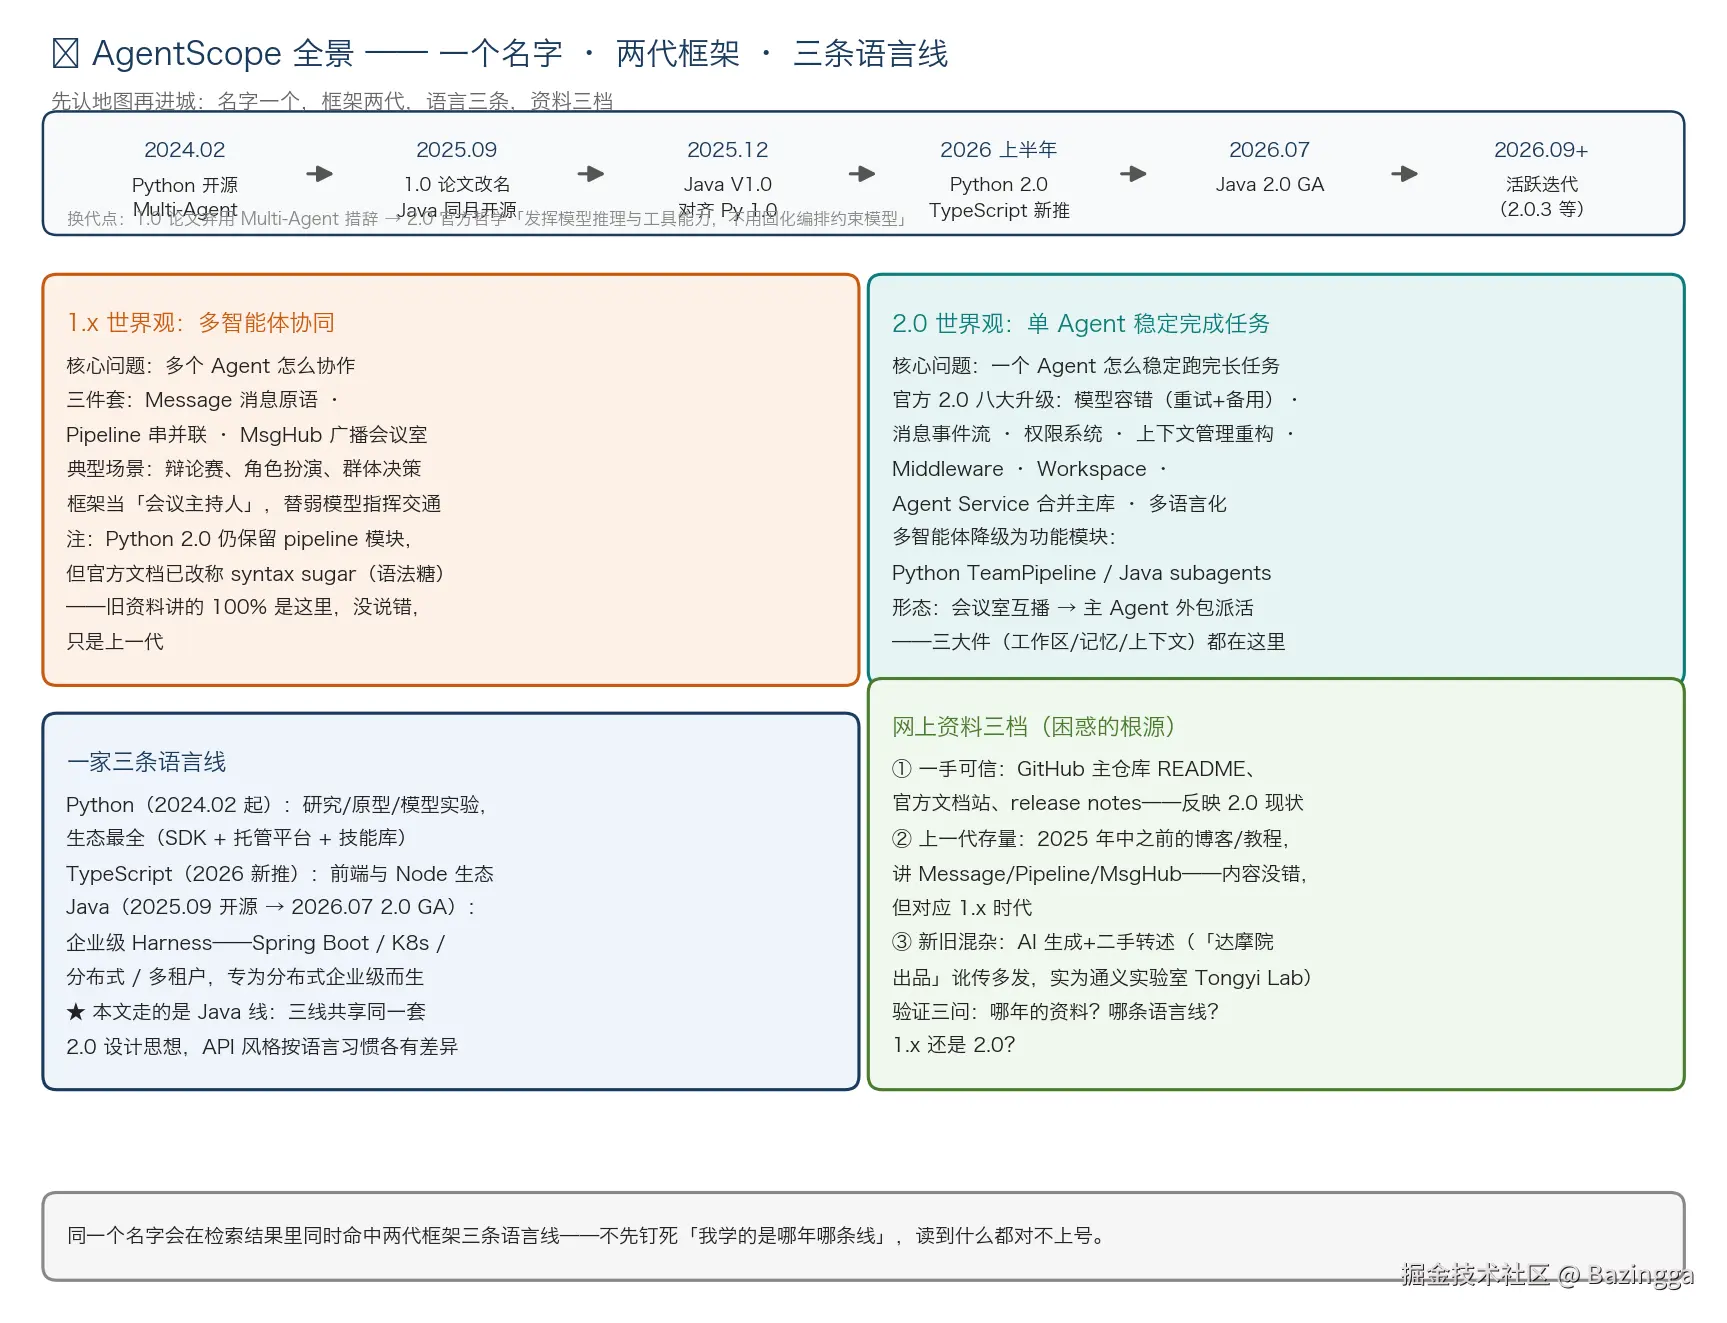
二、先把词汇表钉死:Agent = LLM + Harness
读懂官方定位------"专为分布式、企业级智能体打造的 Harness 框架"------需要先钉死三个词的关系:
- LLM ≈ 发动机:只会生成下一个 token,没有记忆,没有手脚(工具),不知道自己在哪;
- Harness ≈ 底盘 + 车身:包在发动机外面的工程外壳;
- Agent ≈ 整车:能自己跑着干活的智能体。
拿这个公式去做体检:
- 裸调
ChatClient.prompt().call()------ 只有发动机,连壳都没有,是对话机器人,不算 Agent; - 手搓的 AgentLoopService(189 行)------ 发动机 + 手搓的壳,是个迷你 Agent,也是一台车;
- Claude Code / Cursor ------ 强 Agent;圈内说它们是 "coding harness",说的是壳;
- AgentScope 本身不是 Agent------它是造壳的工具箱,你用它加发动机,才拼出一台车。
一个容易混的点:"Claude Code 是 Agent"和"Claude Code 是 Harness"都对------前者是产品视角(它是台能干活的整车),后者是构造视角(Anthropic 造的是壳,发动机是外部模型)。 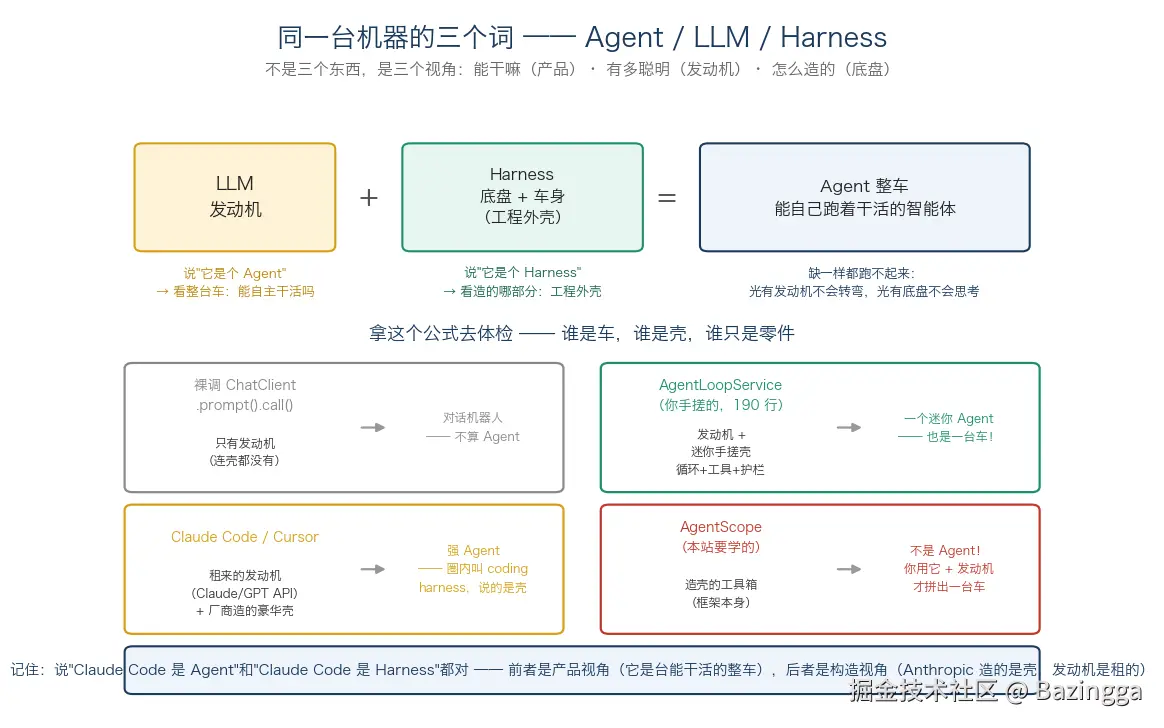
那这个"壳"里都有什么?八件:工作区 / 长期记忆 / 工具箱 / 权限管控 / 沙箱执行 / 子 Agent 编排 / 技能库 / 会话状态 。这八件也正是下文引擎室的主角。 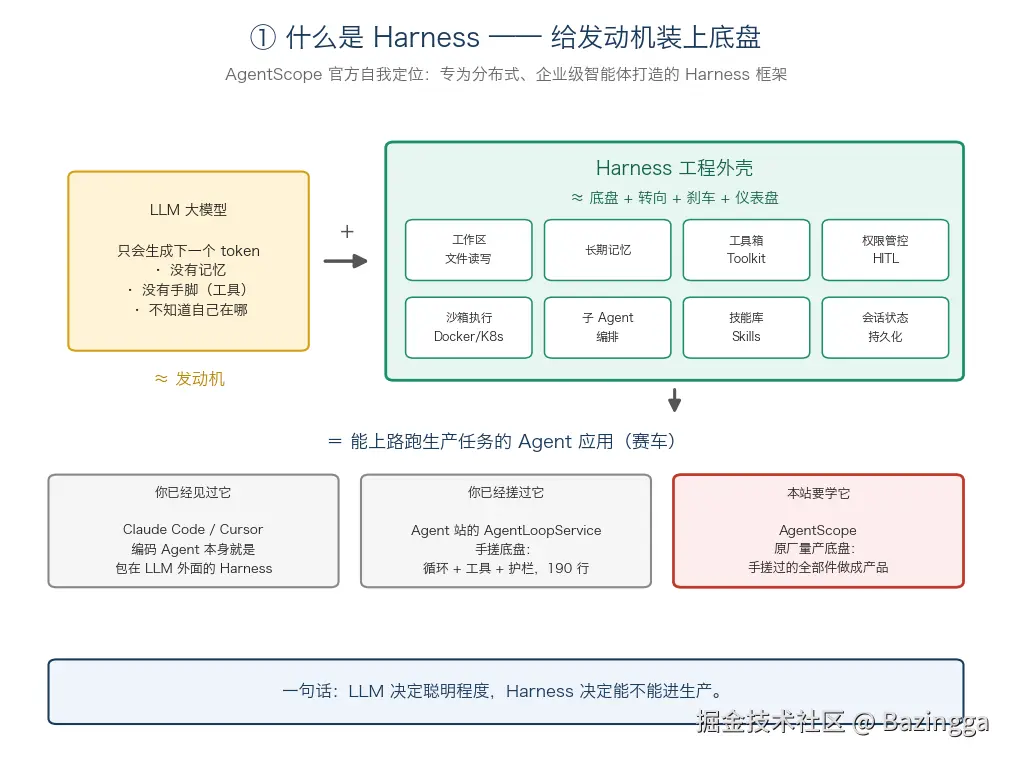
一句话收束这一章:LLM 决定聪明程度,Harness 决定能不能进生产。
三、它替你省了什么:拿手搓项目对账
最有说服力的不是功能清单,是对账。拿手搓仓储项目的四件套:
| 手搓组件 | 行数 | 在 AgentScope 里 |
|---|---|---|
| AgentLoopService(ReAct 循环) | 189 | 内置件,整类删除 |
| ChatMemoryService(对话记忆) | 42 | 内置件(还是双层记忆),整类删除 |
| TokenUsageService(Token 记账) | 94 | 内置 Middleware 挂载点,改几行 |
| DeviceTool(查设备的业务工具) | 43 | 保留------这才是框架要求你写的 |
规律一眼可见:你手搓的全部"通用件",正是它内置的全部;你唯一保留的业务工具,正是它要求你提供的全部。 前者写的是轮子,后者才是价值。而且它管的那一列远不止手搓过的这些------上下文压缩四道防线、MEMORY.md 自动蒸馏、子 Agent 编排、沙箱隔离、权限管控、多租户部署,这些还没来得及踩坑的部分,它也都管了。
其中"记忆"这一格值得单独算一笔深账:手搓的滑动窗口是截断式 ------20 条窗口,超出滚掉最早的,丢掉的信息永久丢失,会话一断全忘;Harness 的双层记忆是沉淀式 ------窗口丢之前先抽精华落盘,截断解决"放不下",沉淀解决"记不住"。 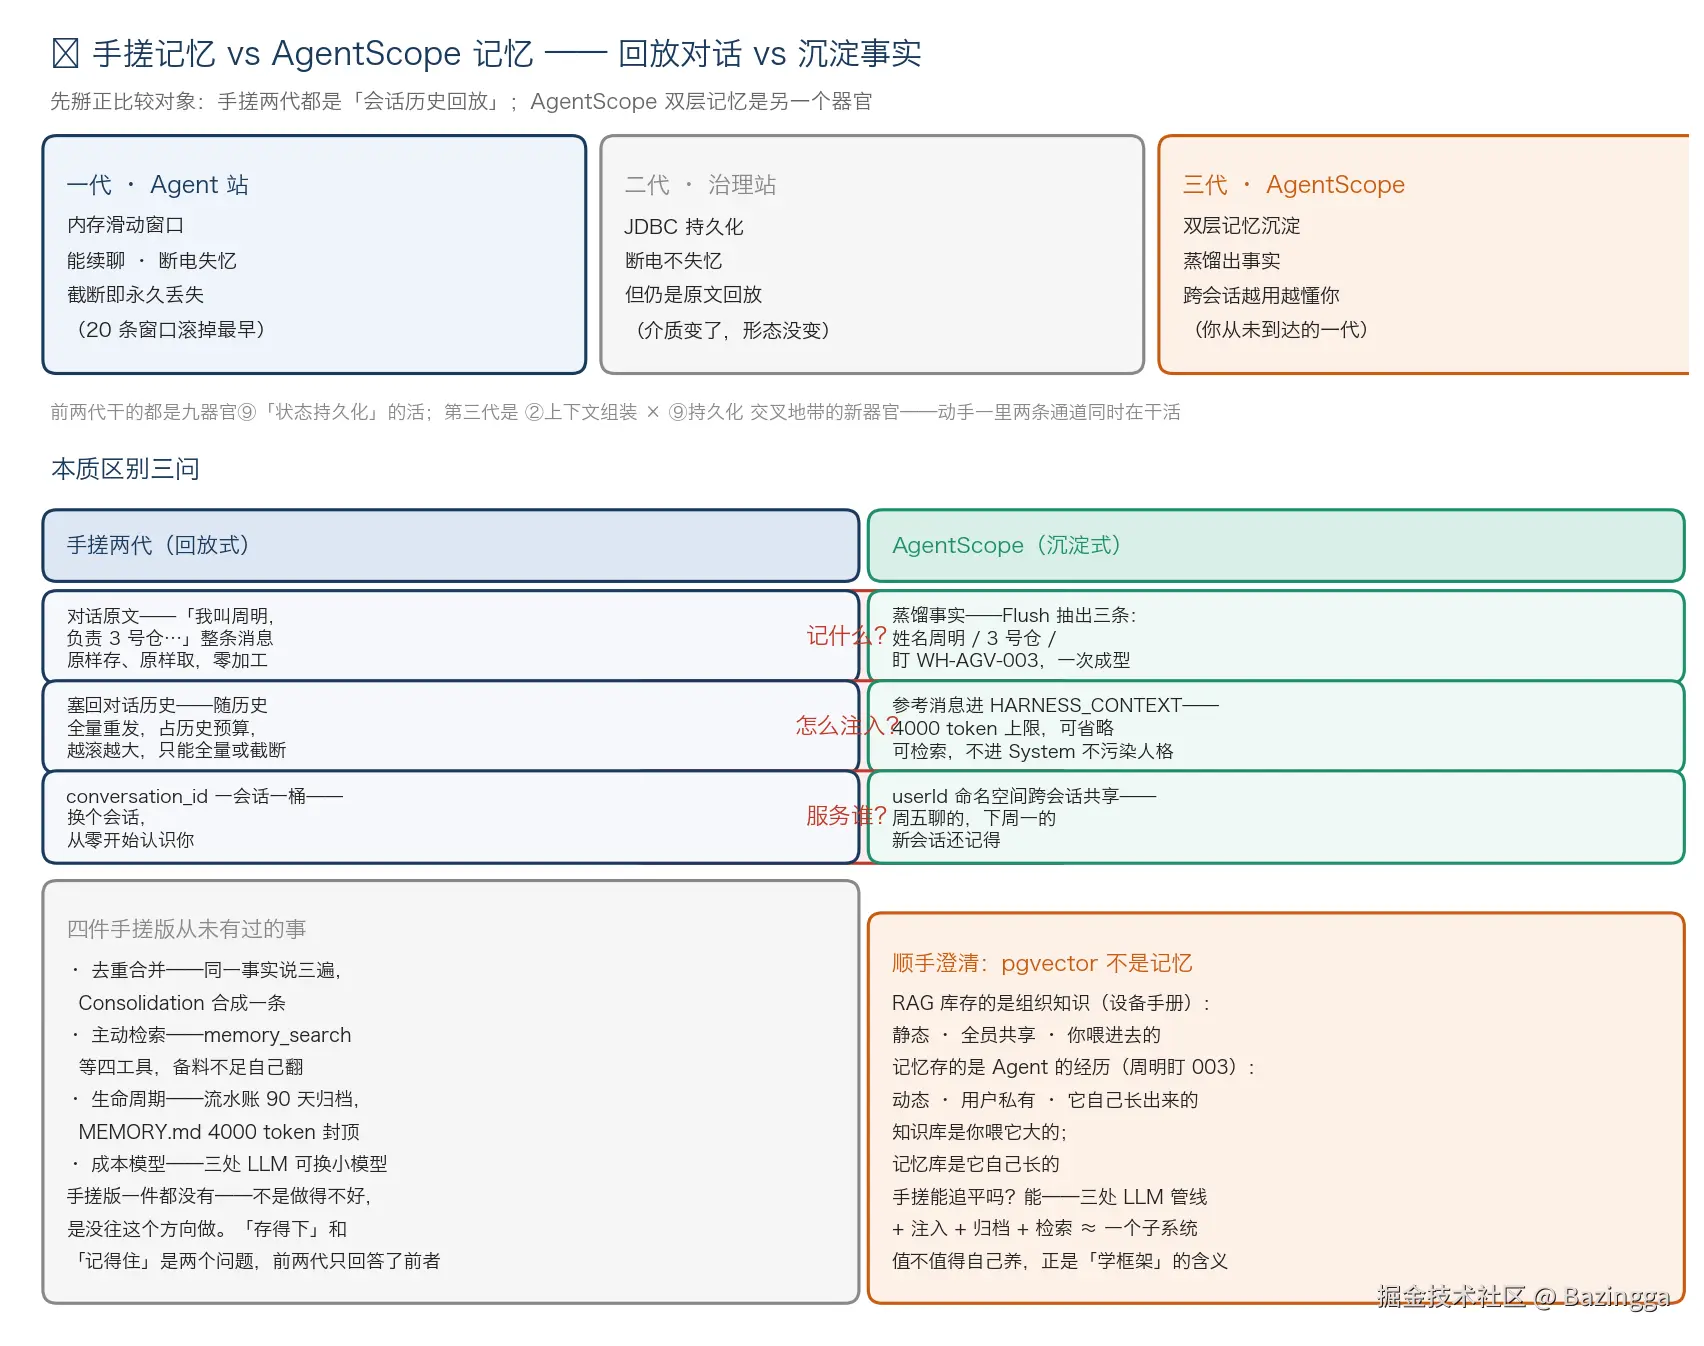
四、什么时候用、什么时候不用:两级入口
判据已经在〇章给过(谁决定流程),这里补齐工程入口。框架提供两级 API:
- ReActAgent------管"这一次对话怎么跑":轻量原型、单次任务、不需要持久化状态时直接用;
- HarnessAgent------管"长期运行怎么稳定":生产级入口,工作区 / 长期记忆 / 会话持久化 / 子 Agent / 沙箱等工程能力全在这一层按需启用。
两者的架构关系是"双层叠加、只叠加不替换":HarnessAgent 通过 Middleware(中间件)+ Toolkit(工具)两个扩展通道 ,把八大件叠在 ReActAgent 之上;ReActAgent 本身完全无状态,会话可变状态经 Reactor Context 透传------一个实例可以安全并发服务多个 (userId, sessionId) 组合 ,这是它能多副本部署的地基。 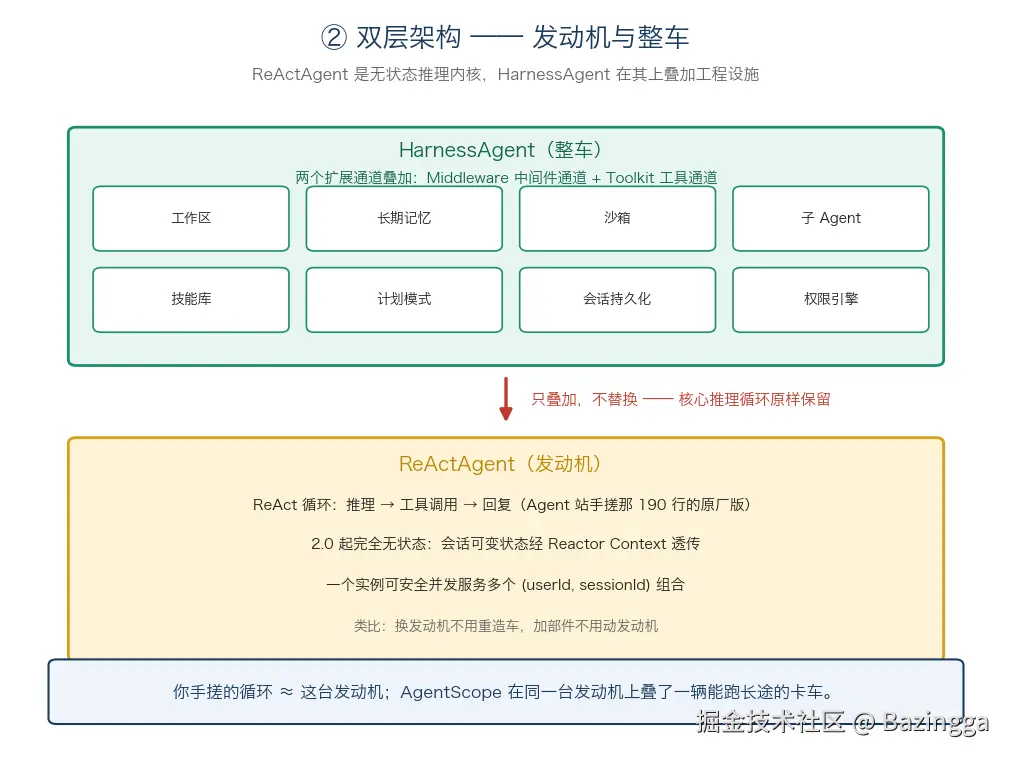
顺带钉死一个工程事实:AgentScope 不是建在 Spring AI 之上 ------它有自己的模型扩展(agentscope-extensions-model-dashscope 等),模型调用不走 Spring AI 的 ChatModel。所谓"配合使用"是同框共存:同一个应用里,Spring AI 管你的 RAG 问答端点,AgentScope 管你的智能体运行时,各干各的活。
五、它在版图里的位置:邻居、同类与换代
楼层判定:与 Spring AI / LangChain4j 管的楼层不同
把 AI 应用想象成一栋楼:Spring AI 和 LangChain4j 在一楼(模型接入层) ------统一各家模型的 API、RAG 检索、工具调用注册、结构化输出;AgentScope 在二楼(智能体 Harness 层)------让智能体长期干活的工作区、记忆、压缩、沙箱、多租户。三者不是三选一的竞品,是楼层分工,可以同框。
一个值得盯住的动态:LangChain4j 1.x 把智能体能力拆成了专门的 langchain4j-agentic 模块(声明式接口 + AgenticScope 共享状态 + guardrails 双向护栏)------它正在从一楼往二楼爬 ,未来交叠会越来越大。 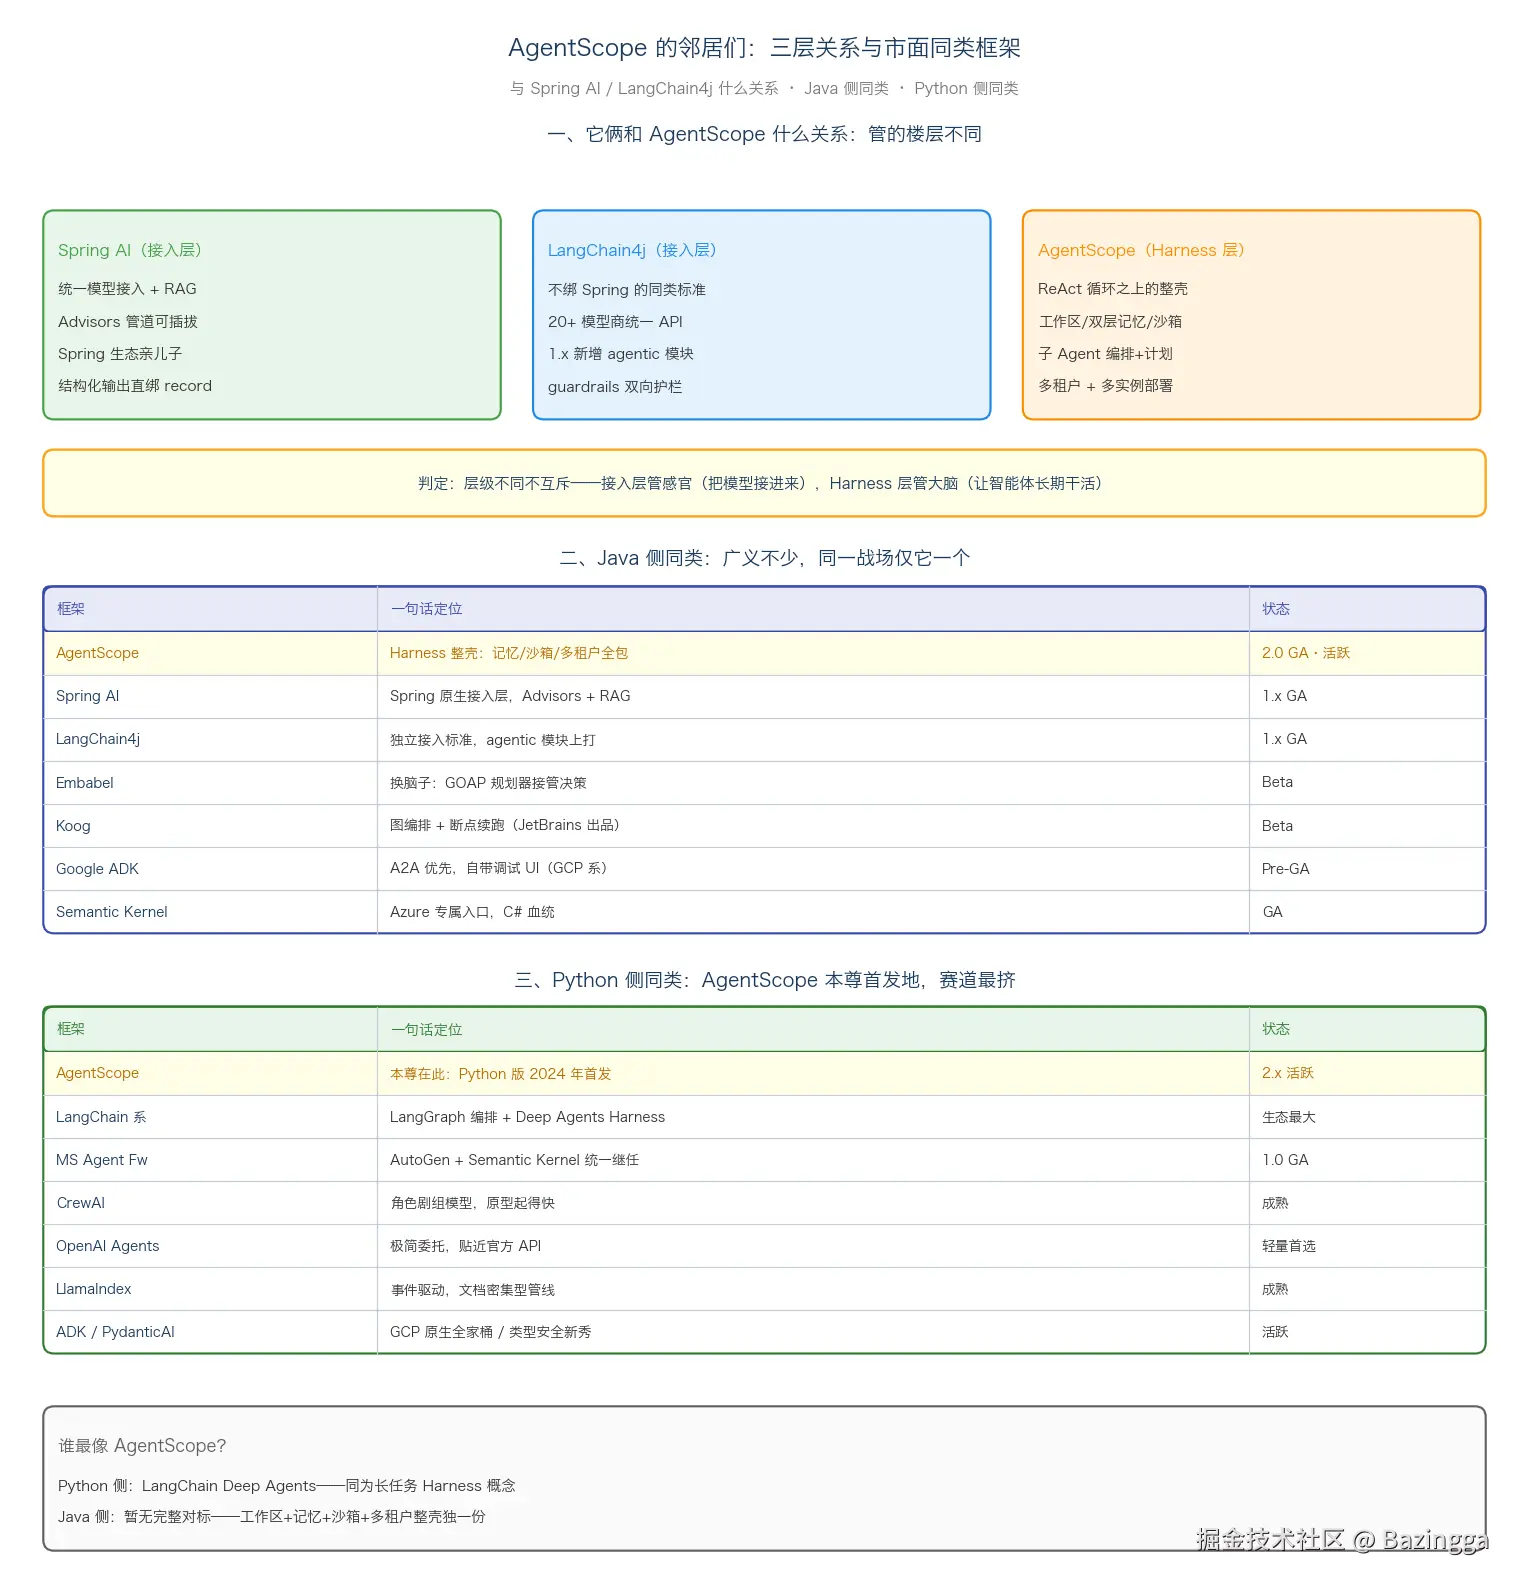
按 2026 年的最新格局盘点:
Java 侧 ------广义的"Java Agent 框架"有七个(AgentScope / Spring AI / LangChain4j / Embabel / Koog / Google ADK / Semantic Kernel),但跟 AgentScope 打同一仗(工作区+双层记忆+沙箱+多租户的完整 Harness 内置)的,目前只有它一个。其余各家姿势都不一样:Embabel 是换脑子路线(GOAP 规划器接管决策);Koog 主打图编排加断点续跑;Google ADK 与 Semantic Kernel 是云厂商专属入口。
Python 侧 ------先说破一件事:AgentScope 本尊就是 Python 首发地,所以"Python 有没有类似框架"的第一答案是它自己。除它之外赛道最挤:LangChain 三件套(LangChain 零件 / LangGraph 编排 / Deep Agents------官方定位"长任务 Agent Harness",概念上与 AgentScope 最像);Microsoft Agent Framework(2026 年 4 月 1.0 GA,AutoGen + Semantic Kernel 的统一继任者,AutoGen 已转维护模式);CrewAI(角色剧组模型);OpenAI Agents SDK(极简委托);LlamaIndex(事件驱动文档管线);Google ADK 与 PydanticAI(GCP 全家桶 / 类型安全新秀)。
两条正交的线:别把 AgentScope 和 Embabel 当竞品
把框架版图压成两个问题:谁做决策 (LLM-ReAct → GOAP 规划)与工程化程度 (手搓 → Harness 产品化)。AgentScope 站在"LLM 决策 + Harness 产品化"的右上角,Embabel 站在"GOAP 决策"的另一条线上------两条线正交,理论上还能组合。 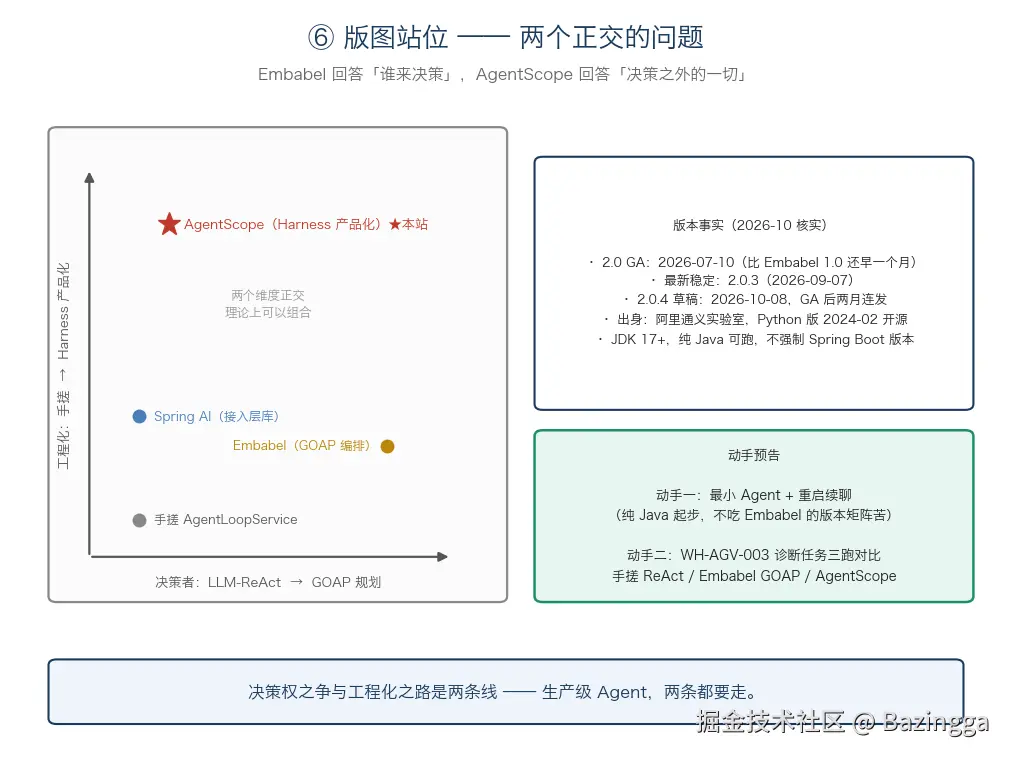
换代:同一个名字的两代框架
1.x(2024--2025)是多智能体平台:一切交互皆消息、Agent 相互独立、MsgHub 广播,组件是 Pipeline 与 MsgHub,典型场景是辩论、角色扮演、群体决策,使命是让"多智能体协作"变简单。
2.0(2026--)是生产级 Harness:组件清单变成 ReAct 循环、Toolkit、Permission、Context、Memory、Workspace、Middleware------"单体作战舰:一个 Agent,全副武装",典型场景是 Coding Agent、诊断助手、长任务。
多智能体死了吗?没有------降级成了功能模块 :Python 侧的 TeamPipeline、Java 侧的 subagents 都在,只是从"框架存在的理由"变成了"一种用法"。 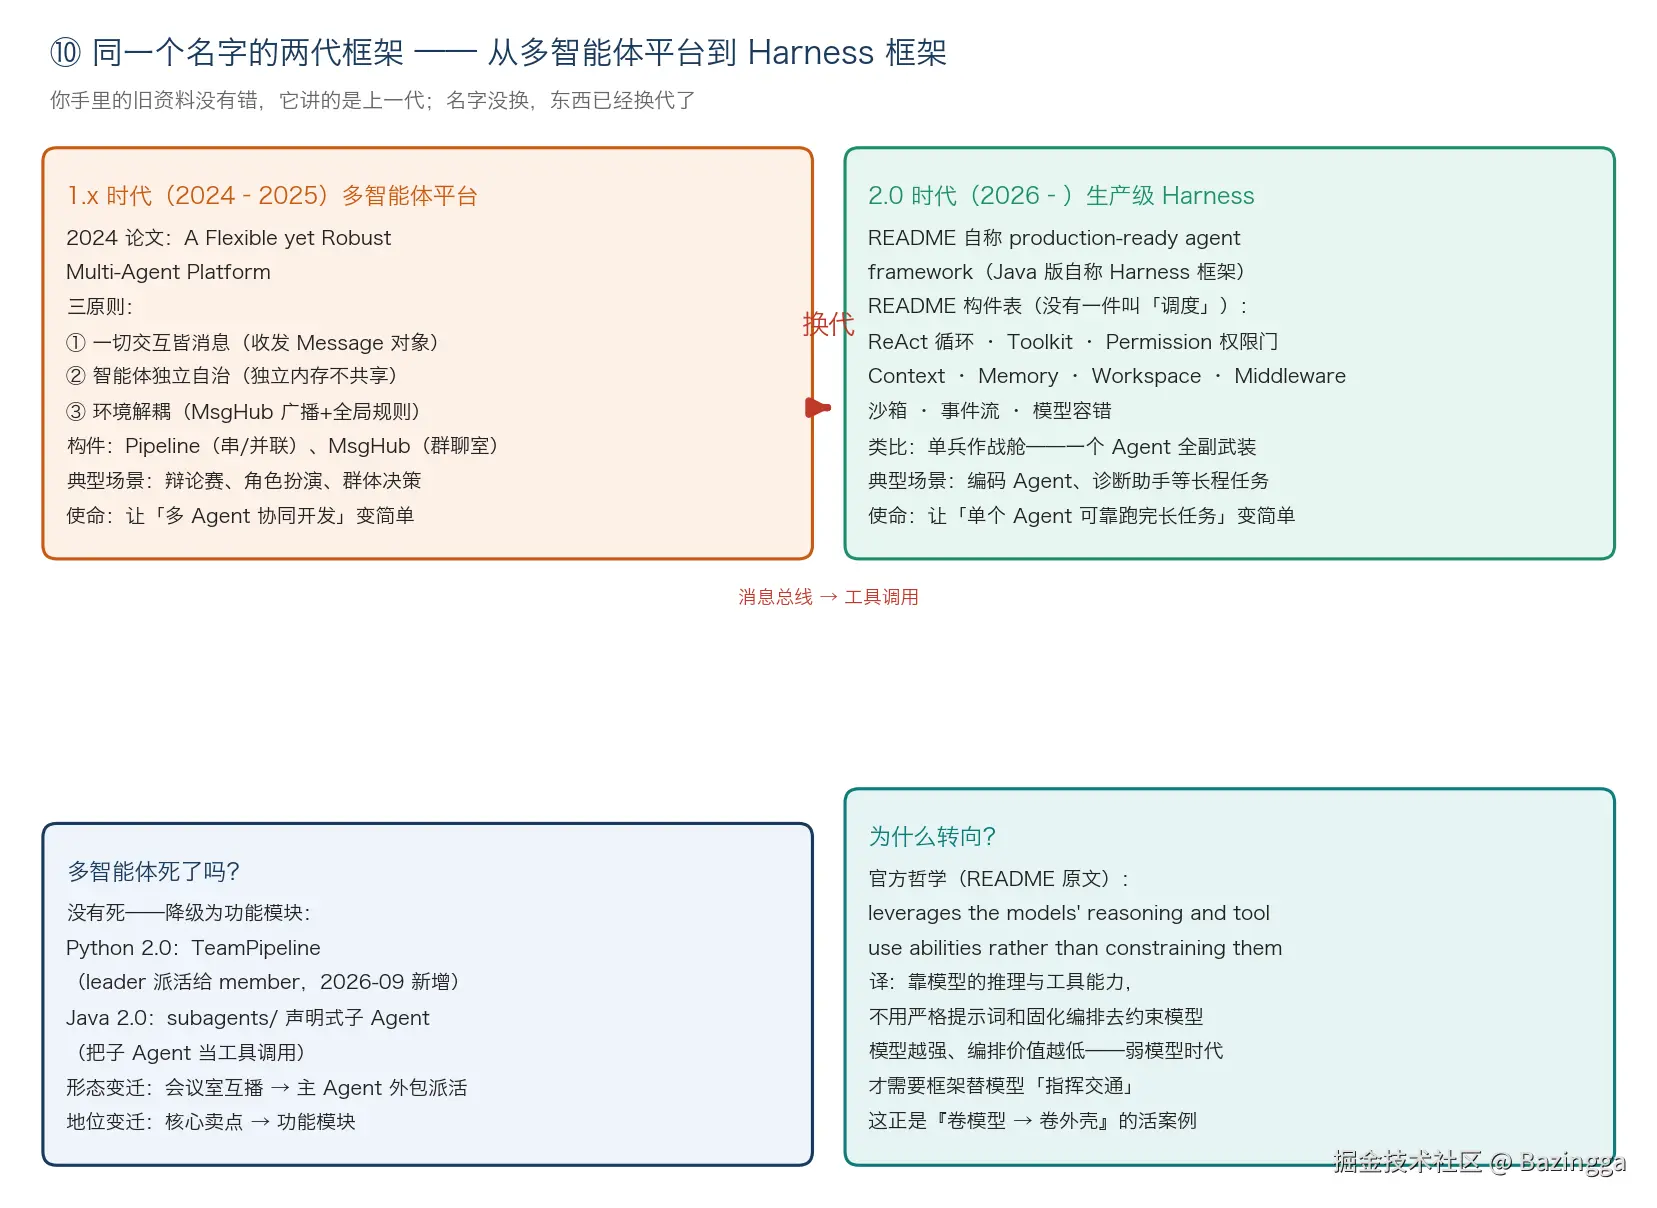
三框架三姿态
同样回答"给你一套能力",姿态分三种:Spring AI 是零件超市 (零件自选,底盘自己拼);Embabel 是决策器套件 (换上 GOAP 规划器这个脑子);AgentScope 是整壳预制 (原厂量产底盘直接装)。从 Maven 依赖到 Builder 到 build() 到 call() 的四级链条里能清楚看到控制反转------循环在框架手里跑,工具是被框架调用的,你只声明"有什么能力"。 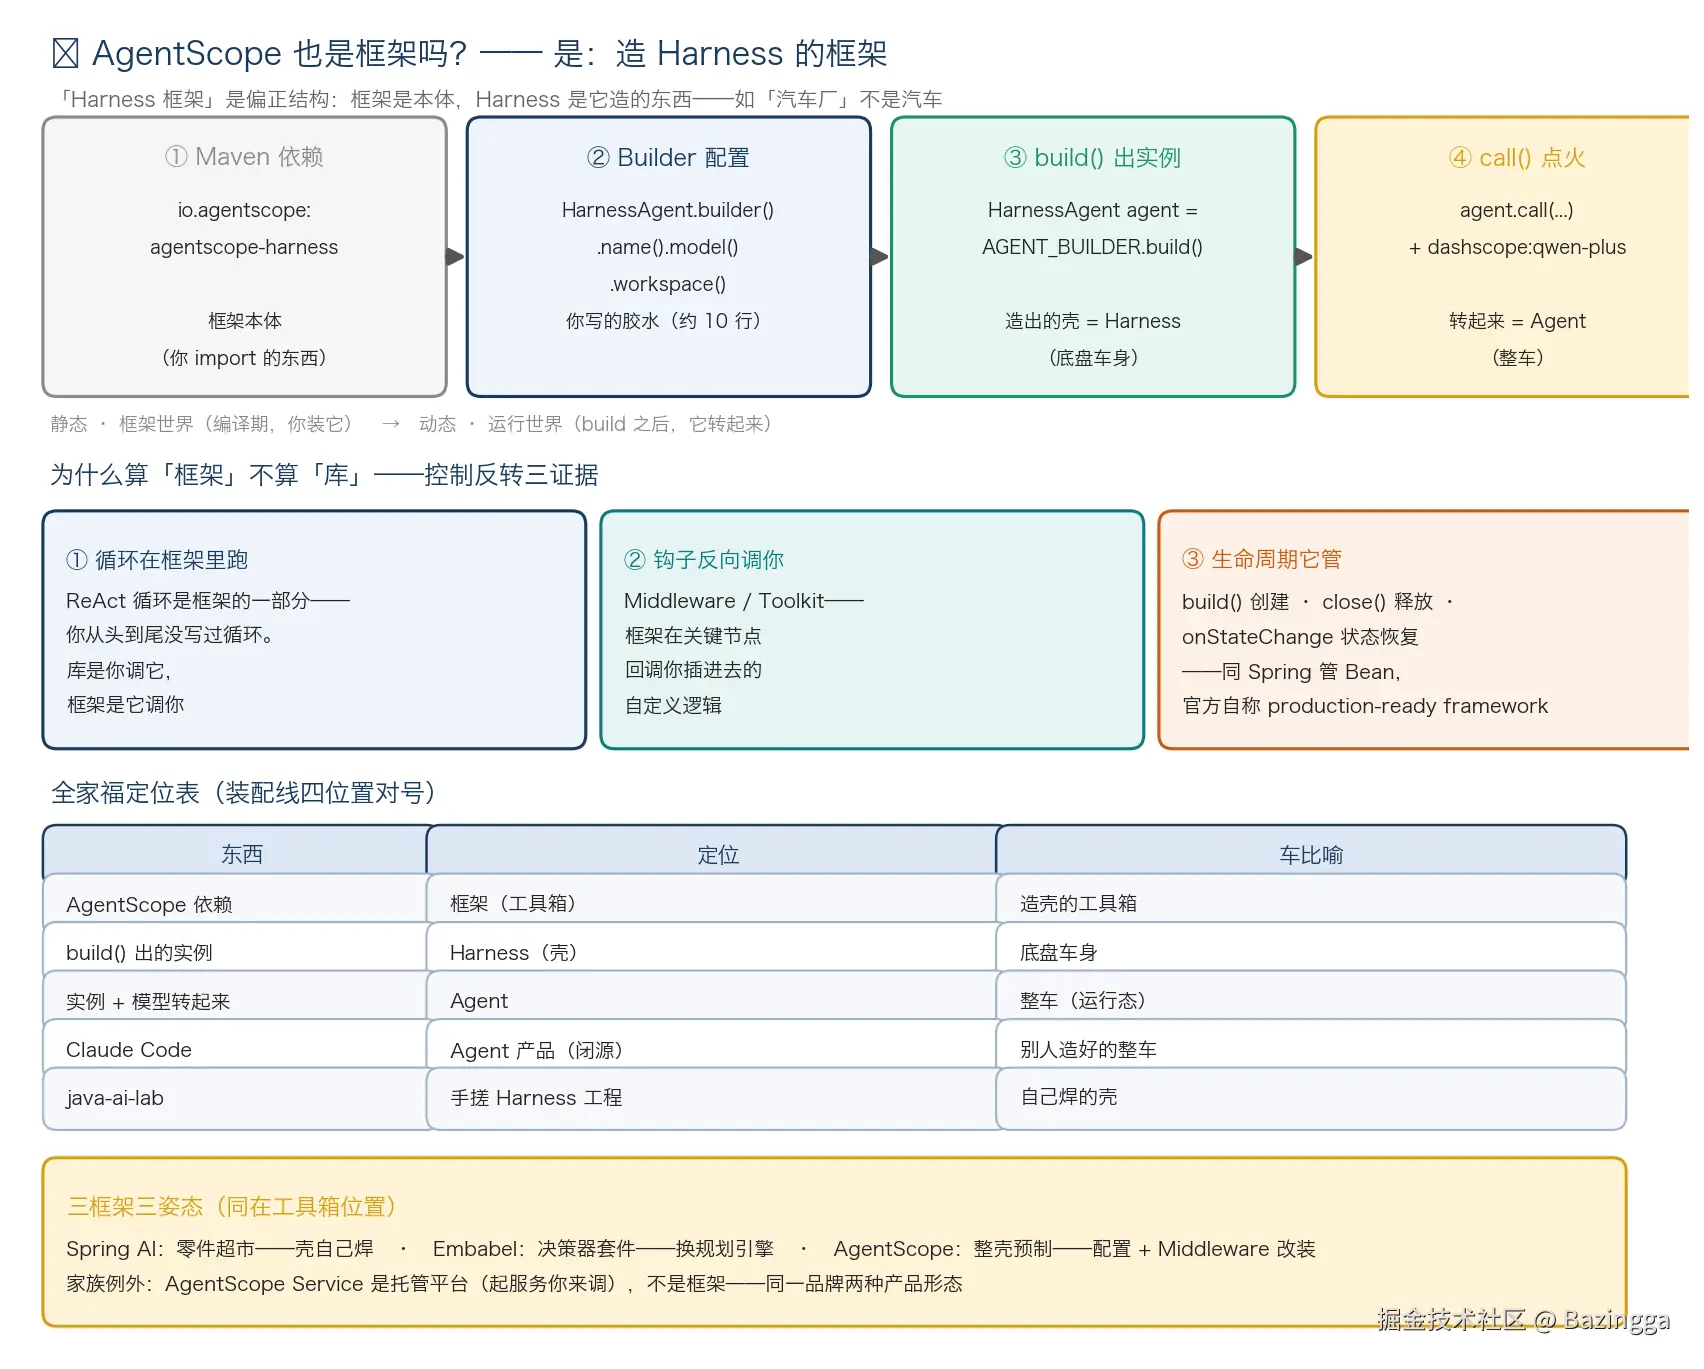
六、引擎室深看:一个目标,八大件
前面回答了"用来做什么",这一章回答"长期干活靠什么"。2.0 的全部设计收敛为一个目标:让一个 Agent 稳定跑完长任务 ------八大件(工作区、记忆、上下文、会话、沙箱、子 Agent、技能、权限)全是对这个目标的对策。 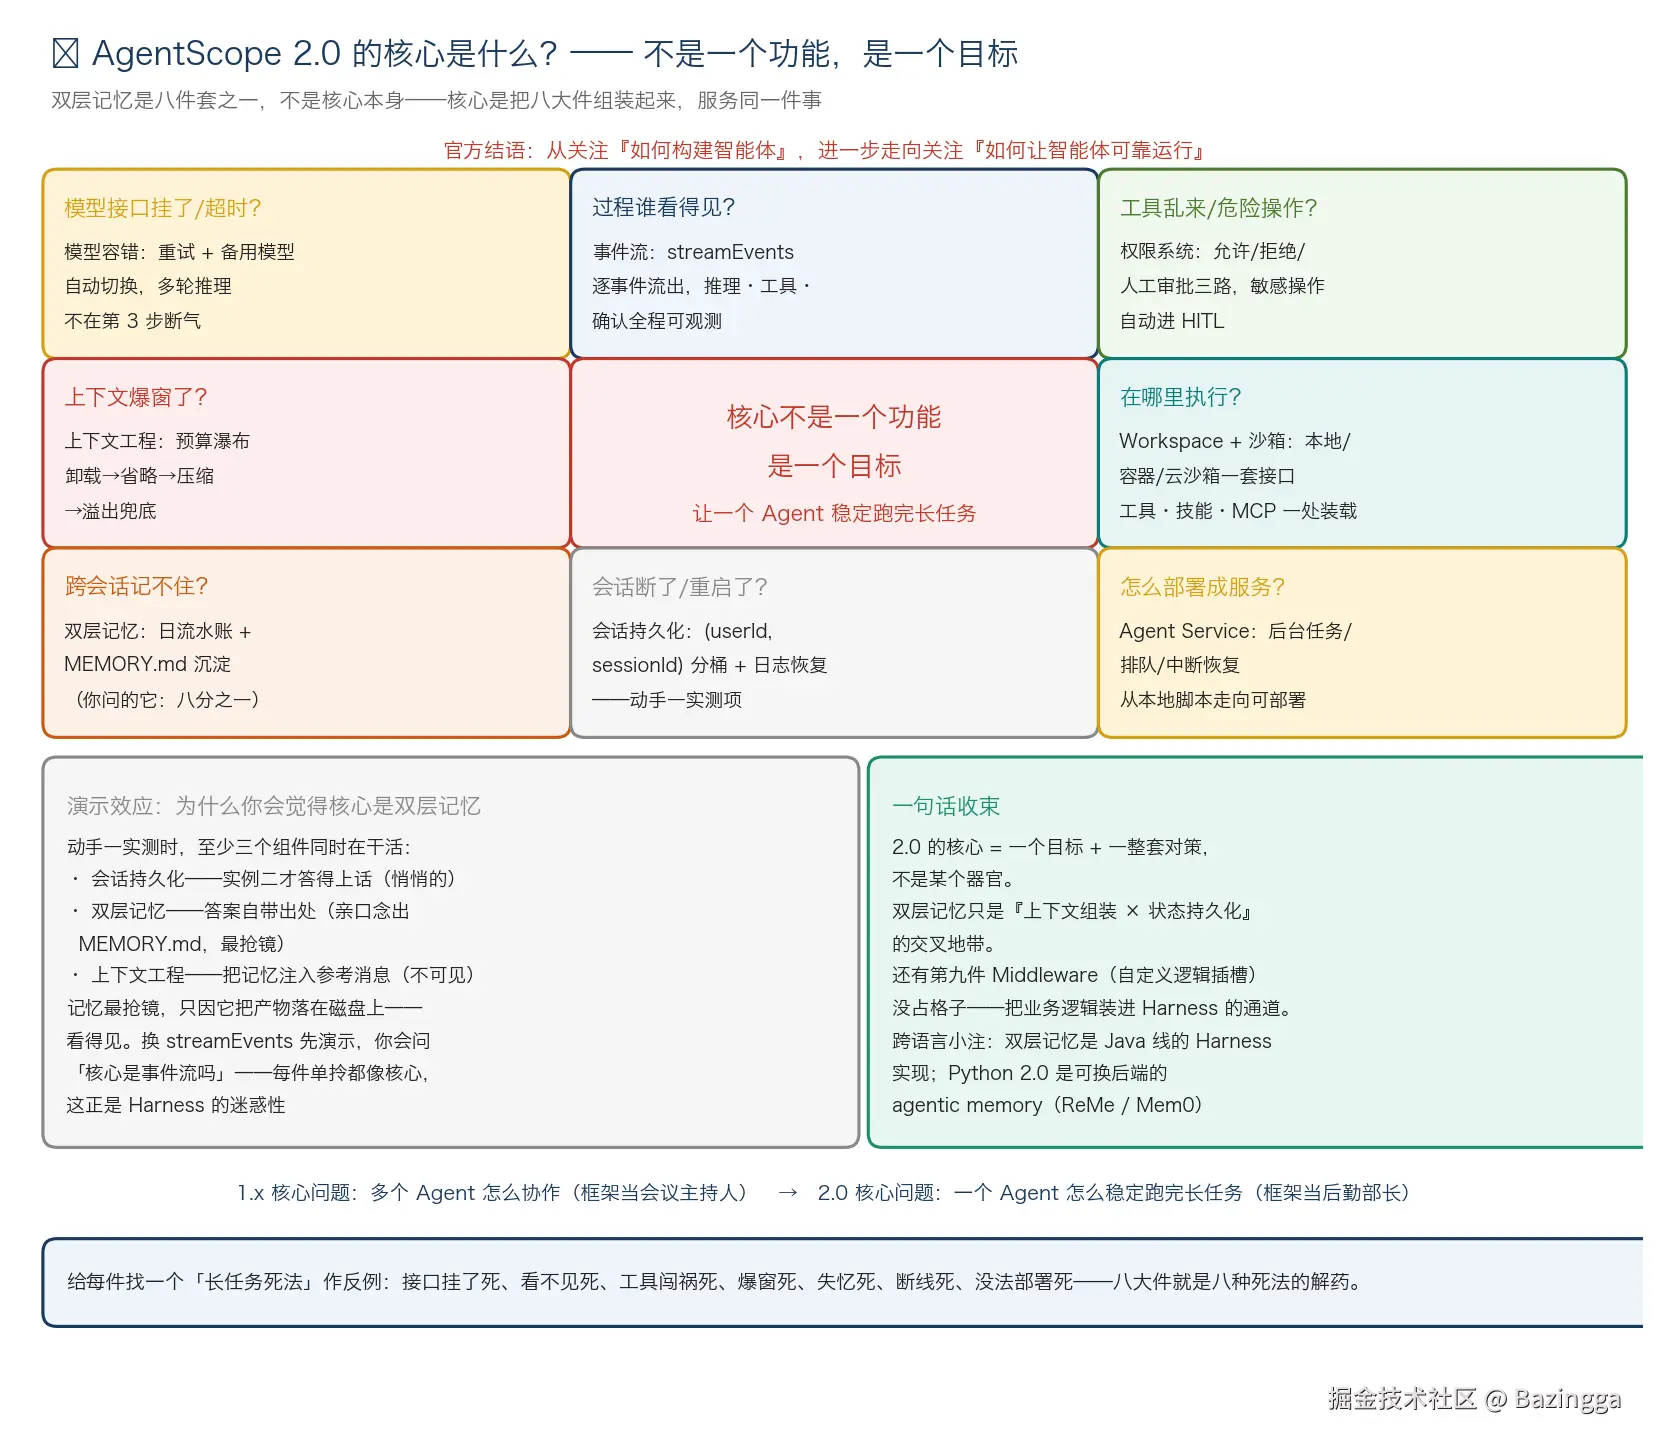
工作区:定义即文件
.agentscope/workspace/ 里,Agent 的全部身家都是文件:AGENTS.md(人格与行为契约)、tools.json(工具白名单)、knowledge/(领域知识)、skills/(技能包)、subagents/(子 Agent 声明)、MEMORY.md(长期记忆)、memory/(日流水账)、plans/(计划)、agents/(userId)/(运行时会话数据)。
谁写谁的东西分得清楚:静态资产人写,长期记忆 Agent 写,运行时数据框架生成。三个设计思想贯穿其中:
- 定义即文件------人格、知识、技能、工具的定义全是 Markdown / JSON,不是代码;
- 进化自动写入------Agent 运行中自己沉淀记忆、起草技能、落盘结果;
- 知识只放索引 ------提示词里只给条目路径,全文要模型自己调
read_file取,相当于 RAG 的文件系统版。
其实你天天在用这套设计:Claude Code / Cursor 的 CLAUDE.md / AGENTS.md 项目规则文件,就是同款思想。 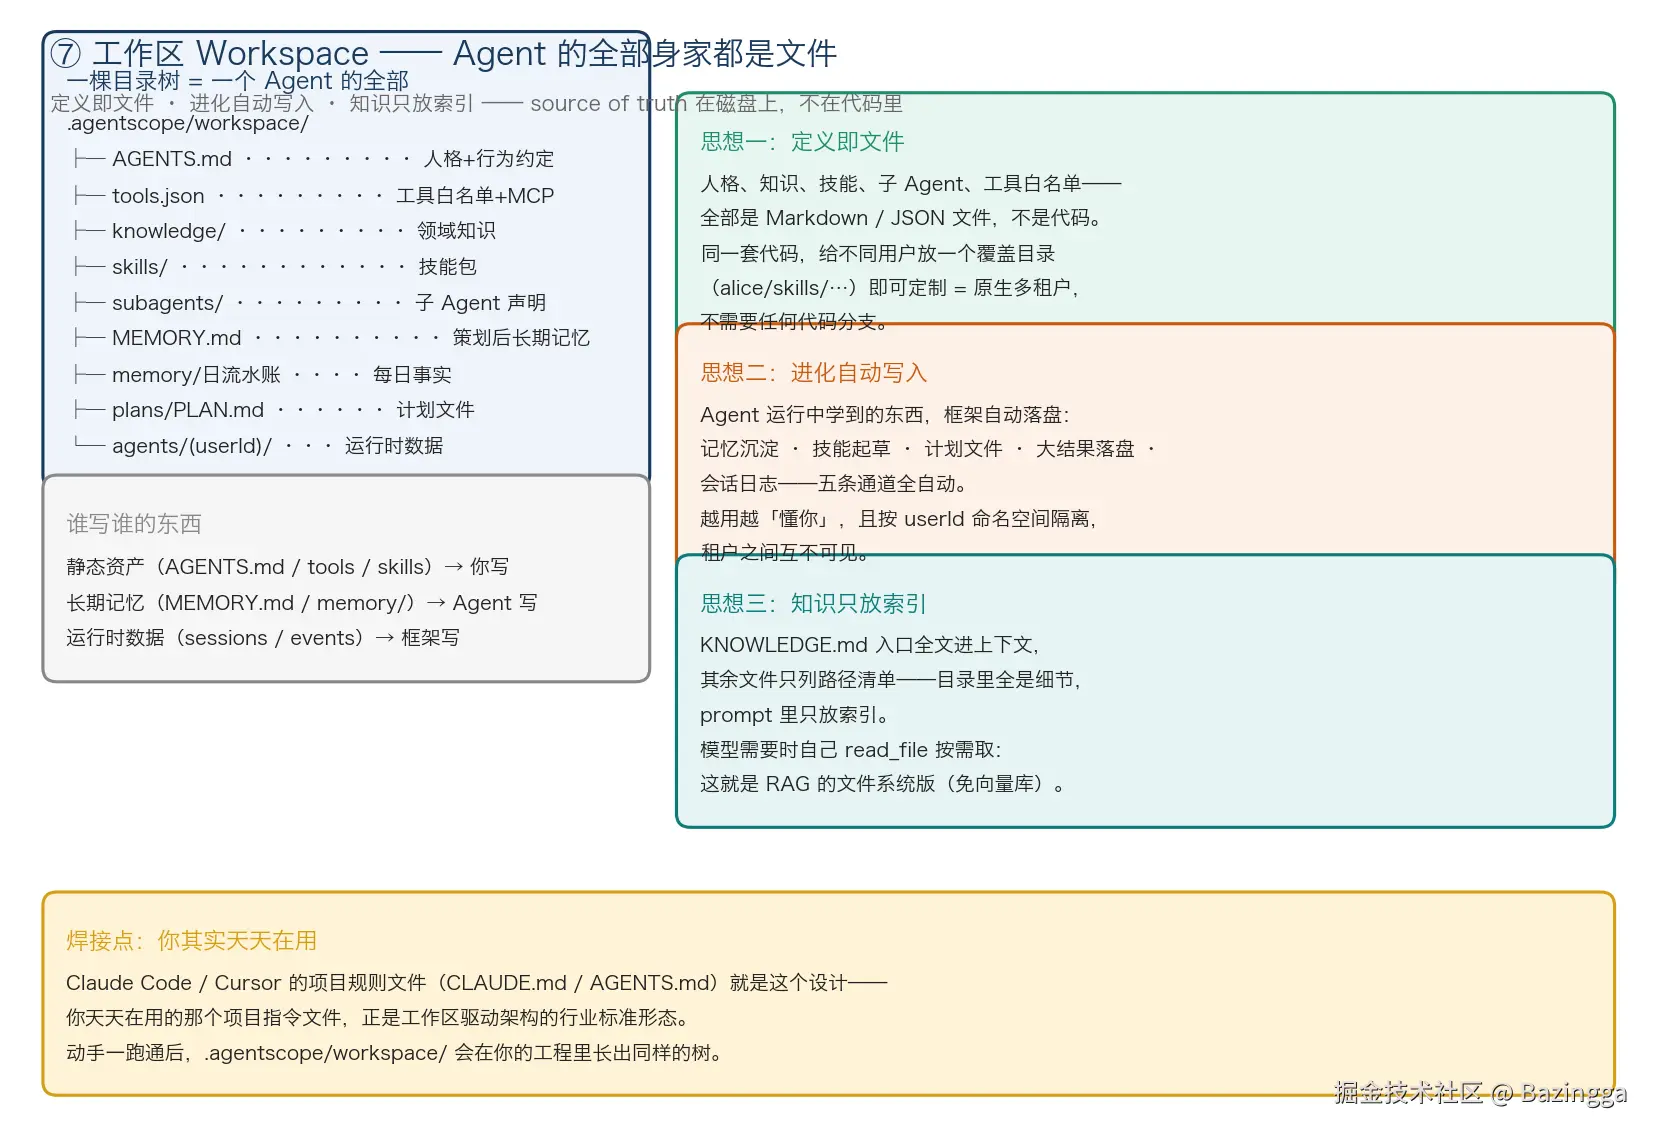
双层记忆:记性是沉淀出来的,不是截断出来的
记忆管线由三处独立 LLM 调用各管一段:① Flush 抽事实 ------对话压缩前先分拣,抽出的写进日流水账(memory/YYYY-MM-DD.md,只追加不去重);② Consolidation 合并去重 ------后台任务定期把流水账蒸馏成全局 MEMORY.md(上限 4000 token);③ Compaction 对话压缩------50 条触发、保留尾部 20 条、前缀蒸馏成一条摘要,专管"对话放不下"。
MEMORY.md 的注入方式有个讲究:下一轮调用时进 HARNESS_CONTEXT,作为 USER 参考消息而不进 System ------记忆是"参考"不是"指令",防止记忆污染人格。成本上配了三板斧:Flush 节流(最多 10 分钟一次)、三处 LLM 换小模型跑、90 天流水账归档。另外 Agent 手里还有备用工具(memory_search / memory_get / memory_save / session_search),MEMORY.md 被截断时模型会自己去翻。 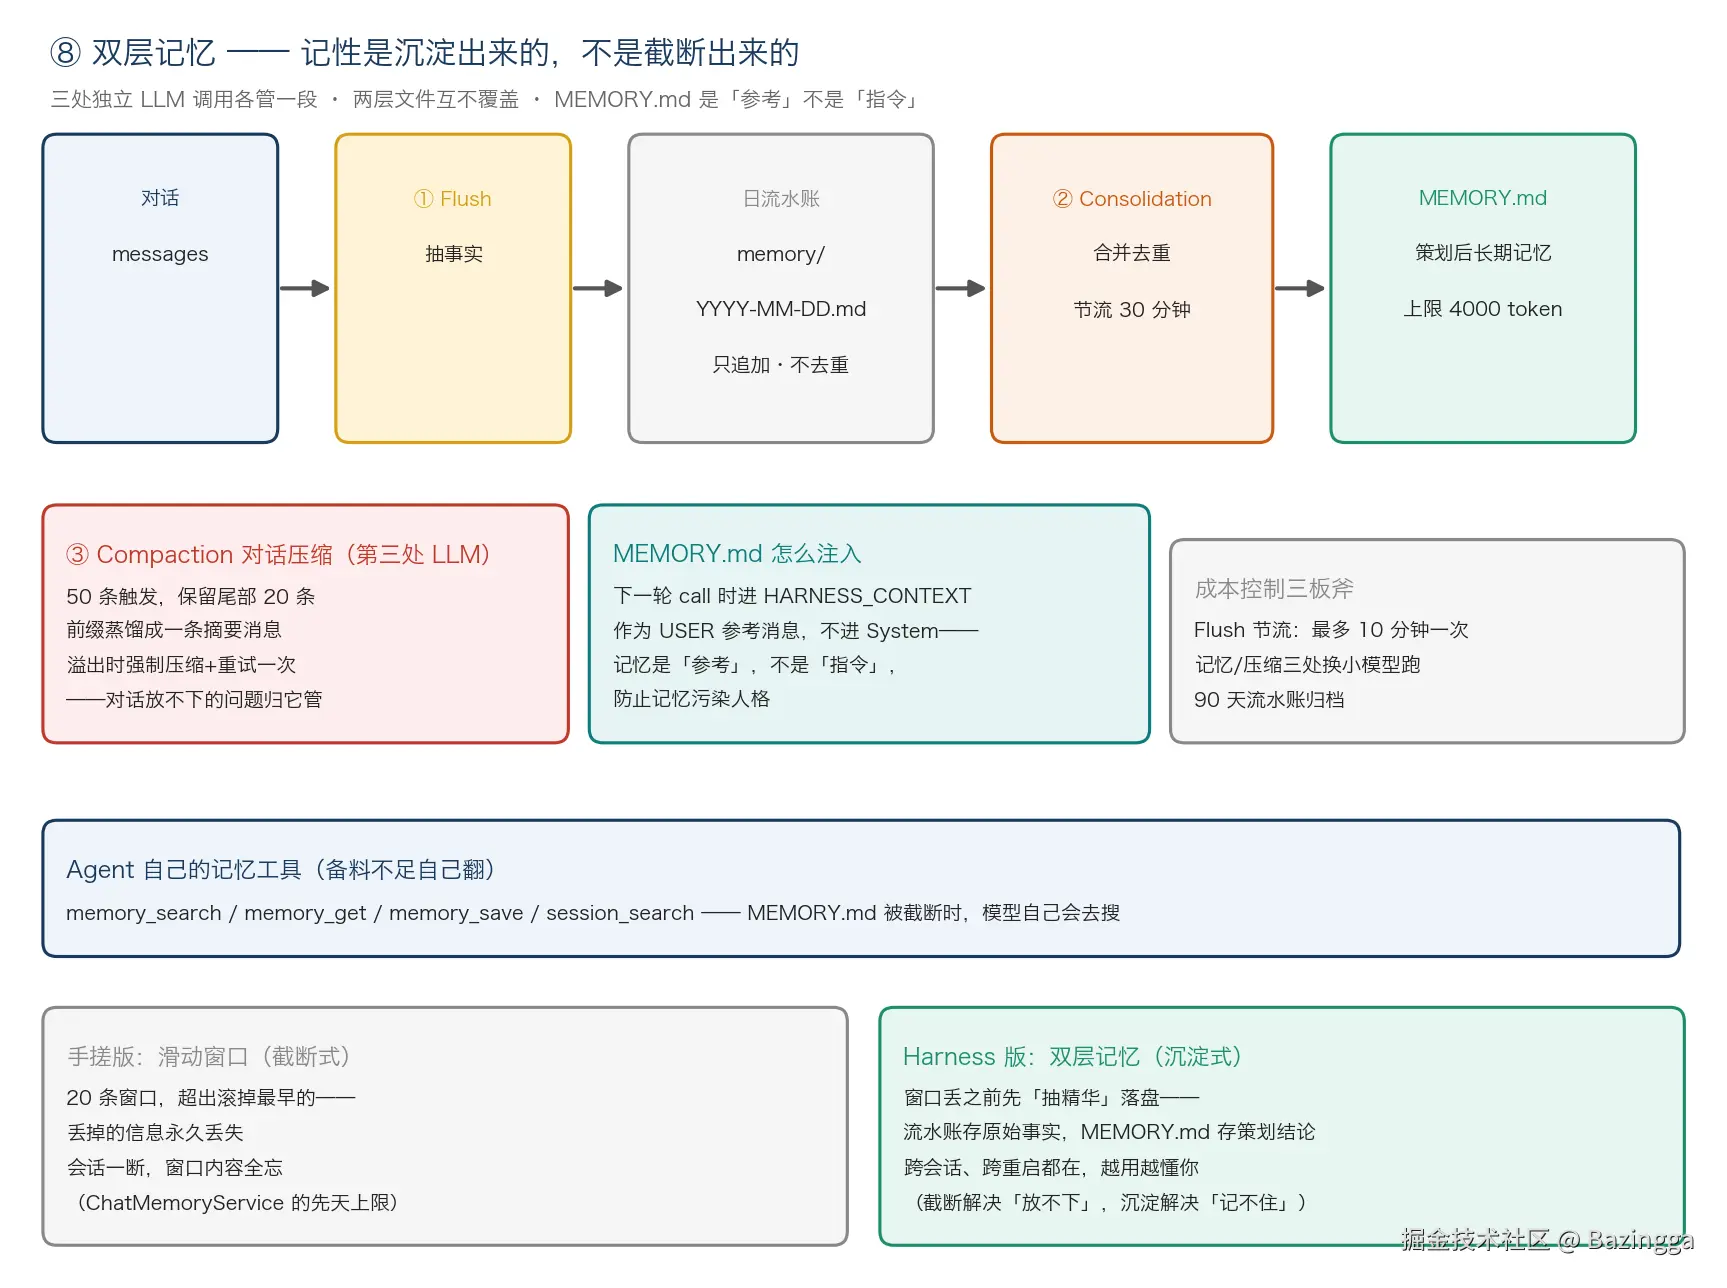
上下文工程:每轮推理前,重新备一次料
手搓循环的草稿本是"每轮全量重发",长任务 token 线性爆炸。Harness 把它精细化成每轮组装 + 预算控制 + 溢出兜底 :每一轮都重新组装本轮输入(System 指令、对话历史、当前状态、参考材料、工具 Schema),过预算就走四层瀑布裁剪------先卸载大工具结果(单条超 80K 字符全文落盘,上下文只留首尾 2K 预览加 read_file 指针),再省略可选材料(MEMORY.md 优先被省,System 指令与 required 块永不省),再压缩历史(轻量裁剪先行,仍超则 LLM 摘要前缀,保留近期消息与工具调用配对),最后溢出兜底(模型真报 context_length_exceeded 就强制压缩并在同一次执行内重试一次)。
配套的 ContextManifest 是排查神器:每轮请求的"备料清单"------哪些材料进来了、哪些被省略、做了什么变换,模型"没看到某信息"时不再靠猜,查清单就知道哪一环丢了。 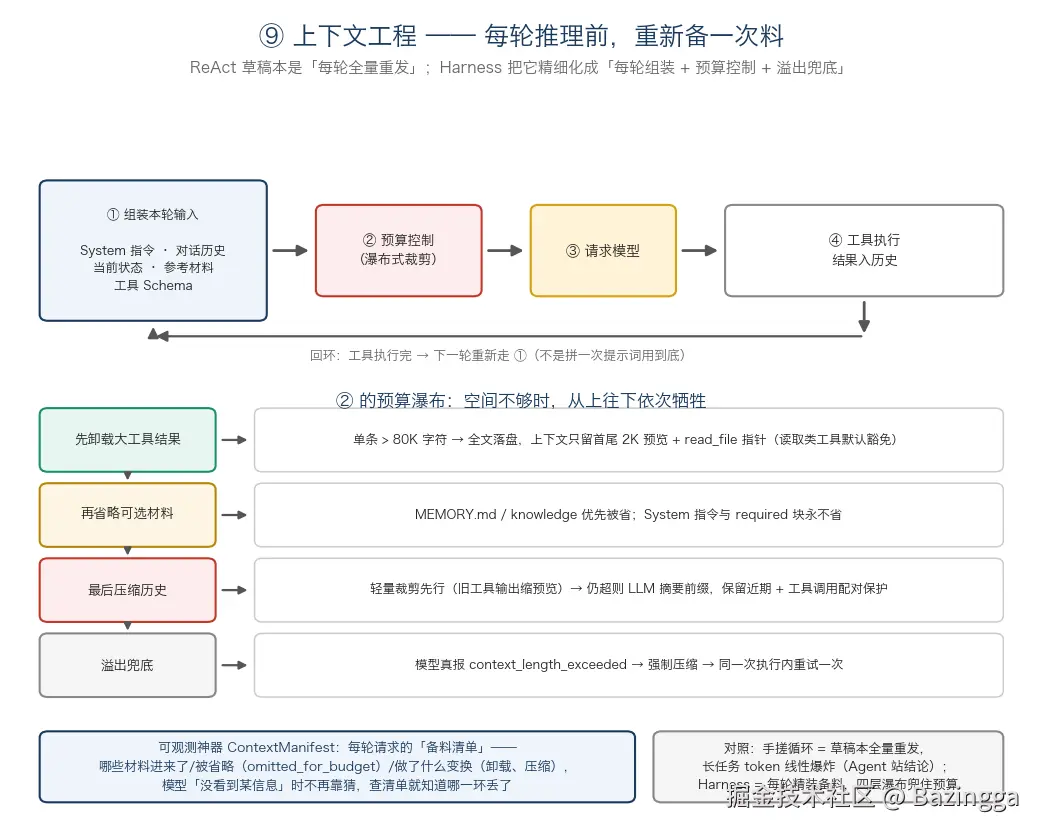
会话身份:身份跟着调用走,不跟着实例走
每次调用都要传 RuntimeContext(userId, sessionId)------会话身份跟着调用走。框架按身份把状态分桶持久化进 AgentStateStore,存储后端任选(InMemory / JSON 文件 / Redis / MySQL / PG / OSS / MongoDB)。这直接换来两大能力:重启续聊 (实例销毁重建,同一身份自动从持久日志恢复上下文)与多副本接续(会话落在任意实例上都能接着干------分布式部署的地基)。还有 AgentSession 后台任务模式:关掉页面任务继续跑、忙时排队、运行中补充要求、中断后继续原任务。
对照手搓版:ChatMemoryService 的内存窗口做不到"实例销毁后续聊"------治理站补了 JdbcChatMemoryRepository 才追平这一格,而这里 Builder 自带、零代码。 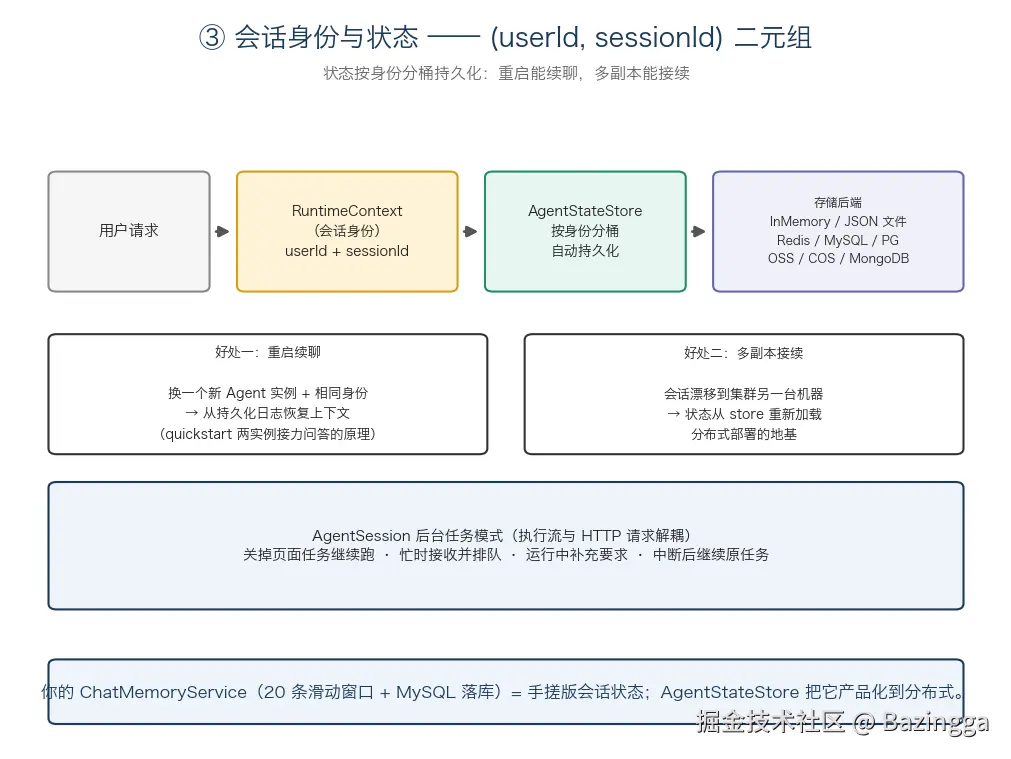
扩展双通道:改行为走中间件,看过程走事件流
改行为用 Middleware:六个挂载阶段(onAgent / onReasoning / onActing / onModelCall / onSystemPrompt / onAgentStateReady)------与 Spring Advisor / 拦截器链是同一门哲学:不动内核,挂在外面。治理站手搓的 token 记账,在这里就是一个 onModelCall Middleware 的标准写法。
看过程 用 streamEvents:28 种类型化事件(文本增量、工具开始调用、工具结果增量、自定义事件......)------前端实时跟随过程、HITL 审批、中断后恢复,都建立在事件流上。手搓版的轨迹双写,在这里是订阅几行的事。 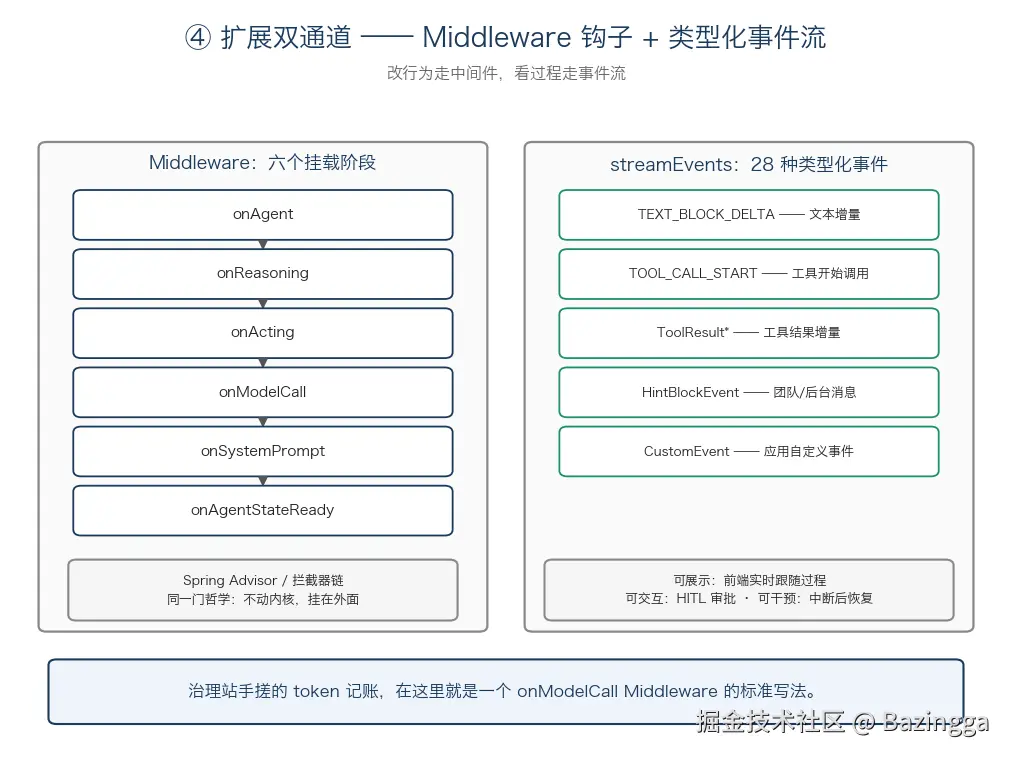
企业级套件:进生产的全部装备
再往抽屉里看一层,八件装备各管一摊:权限引擎 (工具调用三态决策:允许 / 用户审批 / 拒绝,敏感操作自动进 HITL);沙箱抽象 ("做什么"与"在哪执行"分离,本地 / Docker / K8s / E2B 统一同一套接口);子 Agent (声明式规格,agent_spawn / agent_send,事件流实时转发);技能系统 (Classpath / 文件 / Nacos / 市场四层合成,propose → curate → promote);上下文工程 (上文已展开);模型容错 (Credential + ModelRegistry,最大重试 + 备用模型自动切换);协议互通 (A2A 智能体间协作、MCP 工具接入、AG-UI 前端协议);Channel 接入 (钉钉 / 飞书 / 企业微信 / GitHub 机器人------Agent 直接住进 IM)。 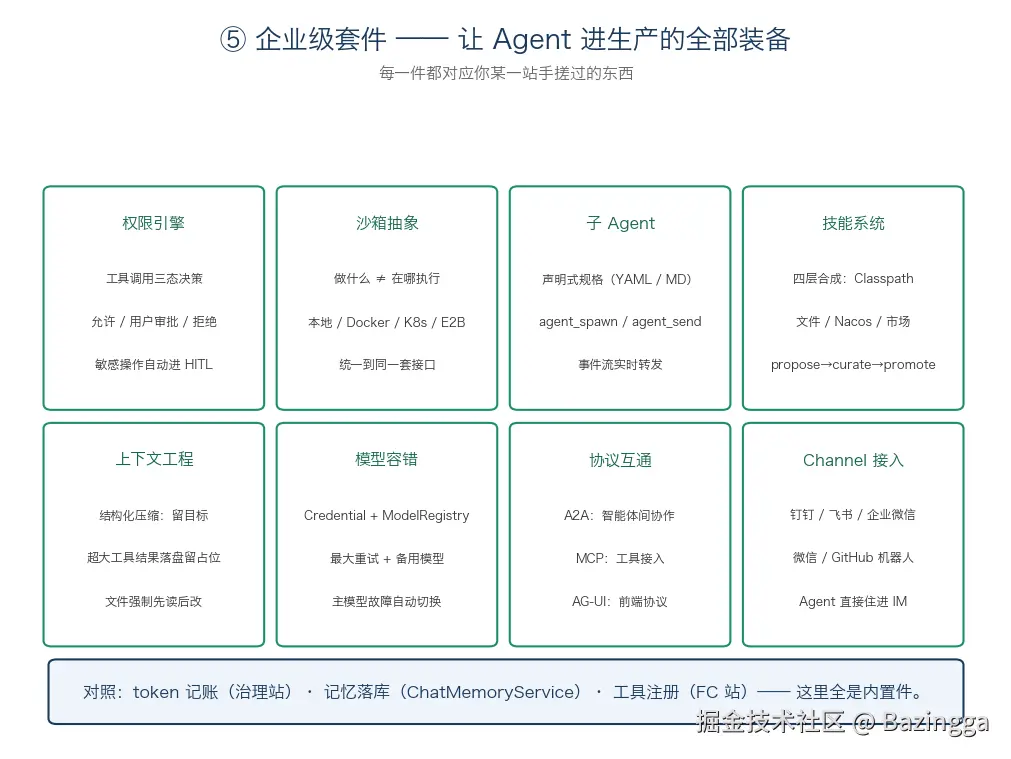
调度权移交:指挥棒从框架交到模型手里
1.x 的调度员是框架(其实是开发者):Pipeline(alice, bob, charlie) 定了谁先谁后,MsgHub(participants=[...]) 定了谁能听见谁------都在翻译期(代码编译时)定死,流程错了要改代码重建;框架扮演"会议主持人",本质是不让模型偏离剧本。
2.0 的调度员是主 Agent(模型):运行时实时决定要不要拆任务、派给哪个 subagent、结果不满意要不要重试;subagent 的本质是工具 (Java 侧 subagents/ 声明式定义),每个 subagent 自带全套 harness(自己的记忆 / 工具 / 权限 / 沙箱);流程错了模型下一步自己调整。框架从"会议主持人"退到"装备部"------给工人配装备,路线工人自己定。计划模式(PlanEnter / PlanExit 一整套配套工具)与 Codex、Claude Code 的 Plan 模式同款。 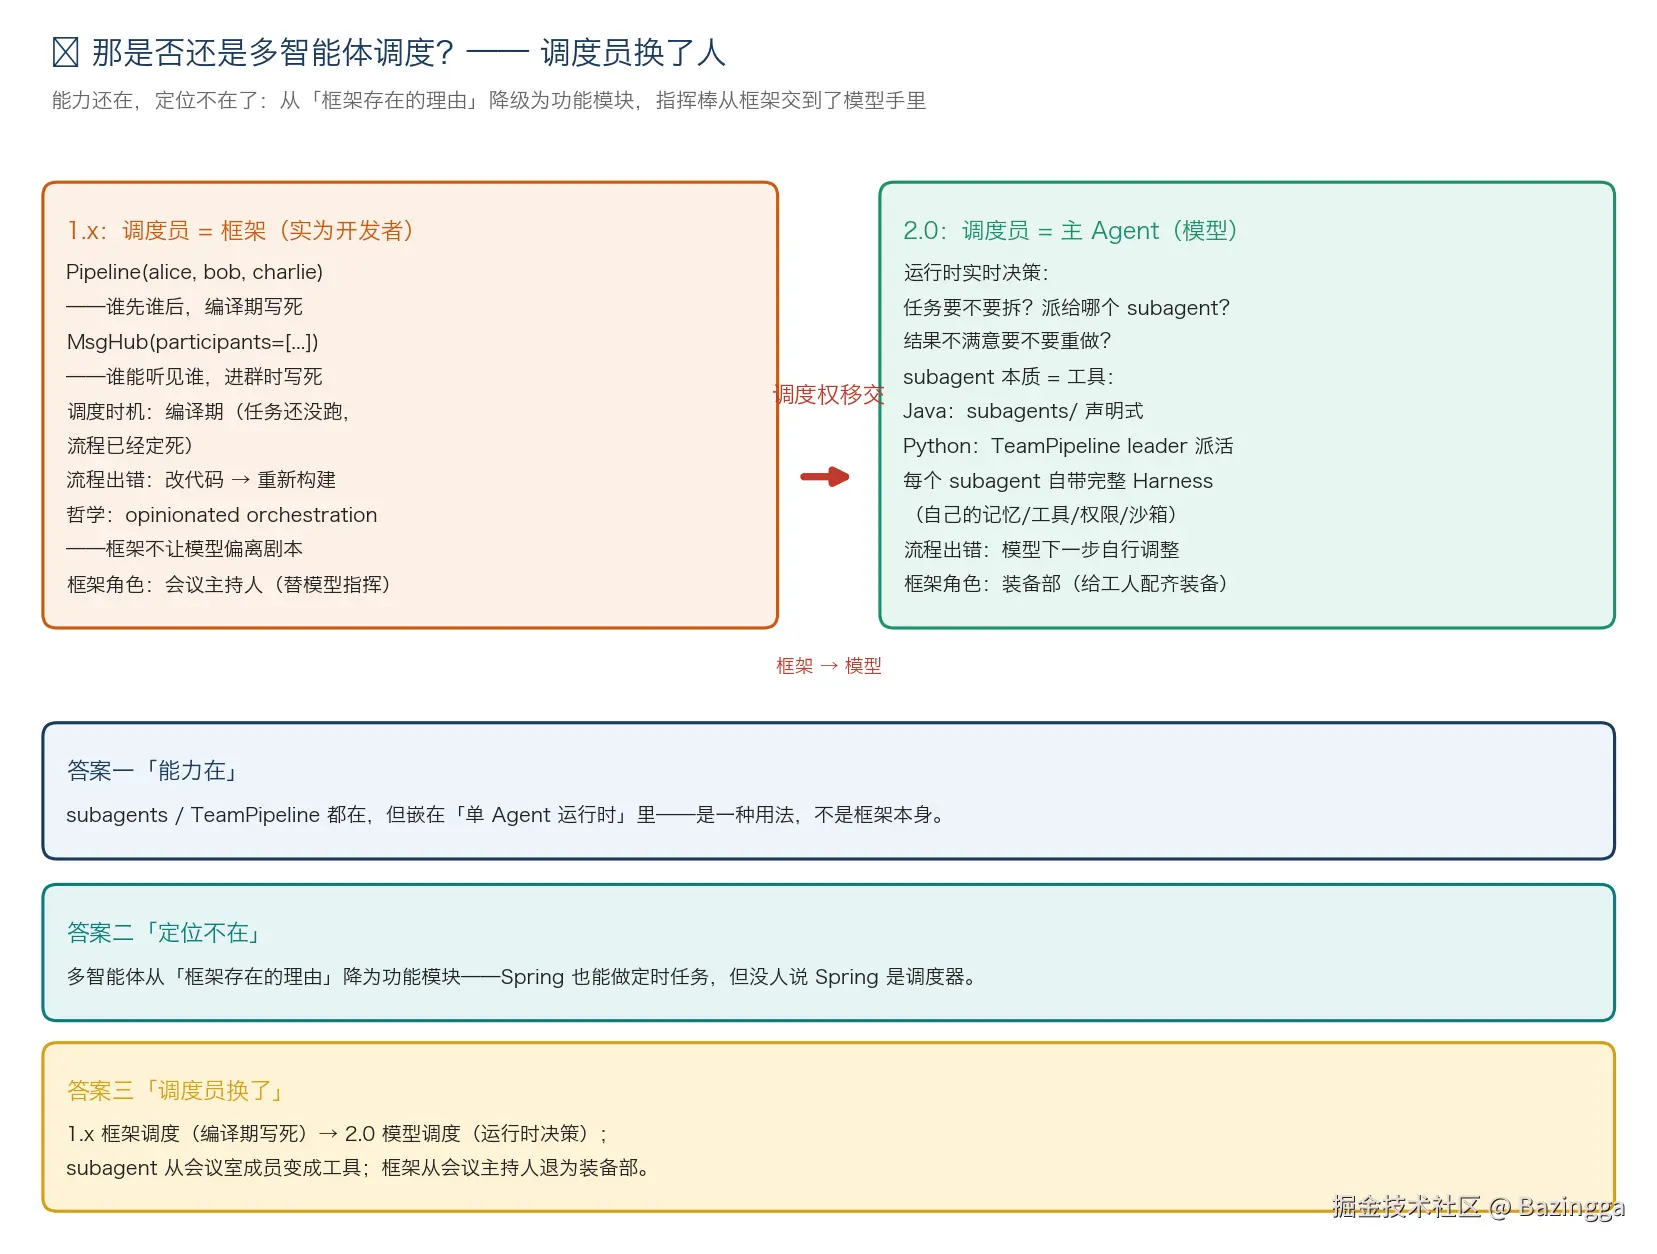
七、动手实测:48 行跑起来,替换映射对账
环境要求:JDK 17+、Maven 3.9+。依赖两个坐标起步:io.agentscope:agentscope-harness(含 core)加模型扩展 io.agentscope:agentscope-extensions-model-dashscope。纯 Java 的 main 方法就能跑,不强制 Spring Boot 版本。
动手一:最小 Agent + 两实例接力
验证目标是会话身份那格能力:Agent 实例可以随手创建随手关闭,会话不随实例消亡。
java
private static final HarnessAgent.Builder AGENT_BUILDER = HarnessAgent.builder()
        .name("warehouse-assistant")
        .agentId("warehouse-assistant")
        .sysPrompt("你是仓储运维助手,帮助仓库管理员管理设备。")
        .model("dashscope:qwen-plus")
        .workspace(Path.of(".agentscope/workspace"));

public static void main(String[] args) {
    // ---- 实例一:告知事实,然后关闭 Agent ----
    try (HarnessAgent agent = AGENT_BUILDER.build()) {
        RuntimeContext ctx = RuntimeContext.builder()
                .userId("zhou-ming").sessionId("first-demo").build();
        agent.call(new UserMessage("我叫周明,负责 3 号仓,重点盯一台编号 WH-AGV-003 的 AGV 小车。"), ctx).block();
    }

    // ---- 实例二:全新实例 + 同一身份,上下文应从持久日志恢复 ----
    try (HarnessAgent agent = AGENT_BUILDER.build()) {
        RuntimeContext ctx = RuntimeContext.builder()
                .userId("zhou-ming").sessionId("first-demo").build();
        Msg reply = agent.call(new UserMessage("我叫什么名字?我重点盯哪台设备?"), ctx).block();
        System.out.println("== 实例二回复:" + reply.getTextContent());
    }
}
注意共享 Builder 上只有通用配置(名字 / 提示词 / 模型 / 工作区),会话身份不在这,在每次调用的 RuntimeContext 里 。实测结果:实例二准确答出"周明"与"WH-AGV-003"------上下文确实从 .agentscope-runtime/ 的持久日志恢复了,全程零行持久化代码。这一格手搓版靠 ChatMemoryService 做不到,治理站补了 JdbcChatMemoryRepository 才追平。
动手二:同款诊断任务的替换对照
拿 AgentLoopService 手搓过的同款任务(WH-AGV-003 报障诊断)换 AgentScope 跑:sysPrompt 复刻手搓版的"岗位说明书"原文一字不动;工具类 WarehouseTools 与原 DeviceTool 同源------@Tool / @ToolParam 注解同名同义,只换 import 包名;轨迹不再双写,订阅事件流即是:
java
agent.streamEvents(new UserMessage(task), ctx)
        .doOnNext(event -> {
            if (event.getType() == AgentEventType.TOOL_CALL_START) {
                System.out.println("\n[Action] " + ((ToolCallStartEvent) event).getToolCallName());
            } else if (event.getType() == AgentEventType.TEXT_BLOCK_DELTA) {
                System.out.print(((TextBlockDeltaEvent) event).getDelta());
            }
        })
        .blockLast();
实测轨迹与手搓版同构:模型先调 get_device_status 拿到"故障 | 故障码 E0401",再调 search_fault_knowledge 拿到原因分析,最后输出"现状 / 原因分析 / 处理建议"三段结构化结论。差别在维护成本------手搓 189 行要自己维护六件事:ReAct while 循环、迭代上限护栏、工具名匹配执行、异常转观察、轨迹双写、草稿本追加;替换后约 50 行,六件事全在框架里。
替换映射总表
| 手搓组件 | 去向 |
|---|---|
| AgentLoopService(189 行) | 整类删除------ReAct 循环内置 |
| ChatMemoryService(42 行) | 整类删除------双层记忆 + 会话身份更强 |
| TokenUsageService(94 行) | 改写为 onModelCall Middleware(几十行) |
| DeviceTool(43 行) | 保留------仅换 import 包名 |
| pgvector 检索、rag-eval 评测、业务数据源 | 全部保留------检索可以包成 @Tool 挂进工具箱 |
一句话总结对账结果:约 50 行业务(提示词 + 工具方法)换掉约 325 行基建(189 + 42 + 94),换来的还更多。
八、两个高频误会:多智能体与分布式
误会一:多智能体对话,要搭多台服务器吗?
不需要。1.x 的 MsgHub 里 alice / bob / charlie 的对话是真的 ------各自有独立的 prompt、记忆和 LLM 调用,不是同一个模型自导自演;但它们互相 reply / observe 是同进程的普通方法调用,语义级开销,不走网络。"真的有多智能体在对话"与"需要多台服务器"是两个独立问题。
什么时候才真的拆机器?三条判据:规模 (Agent 到千级万级,单进程事件循环和内存先撑不住)、隔离 (某 Agent 要跑危险工具,必须关进沙箱容器别连累主进程)、边界(不同团队各管一摊 Agent 独立发布扩缩容)------就是后端熟悉的微服务拆分三件套:流量、隔离、团队。反过来,三个 Agent 开个辩论会?一个进程绰绰有余,就像三个 Bean 互相调用不需要拆三个微服务。
这条分布式能力线在 2.0 没死,升级成了别的形态:1.x 的 gRPC 私有通道(只能连自家的 Agent),升级为 A2A 标准协议 (跨框架对话)加 AgentScope Service 控制面 ------演进逻辑与 Spring 的 EJB 远程调用 → HTTP REST 完全同款。 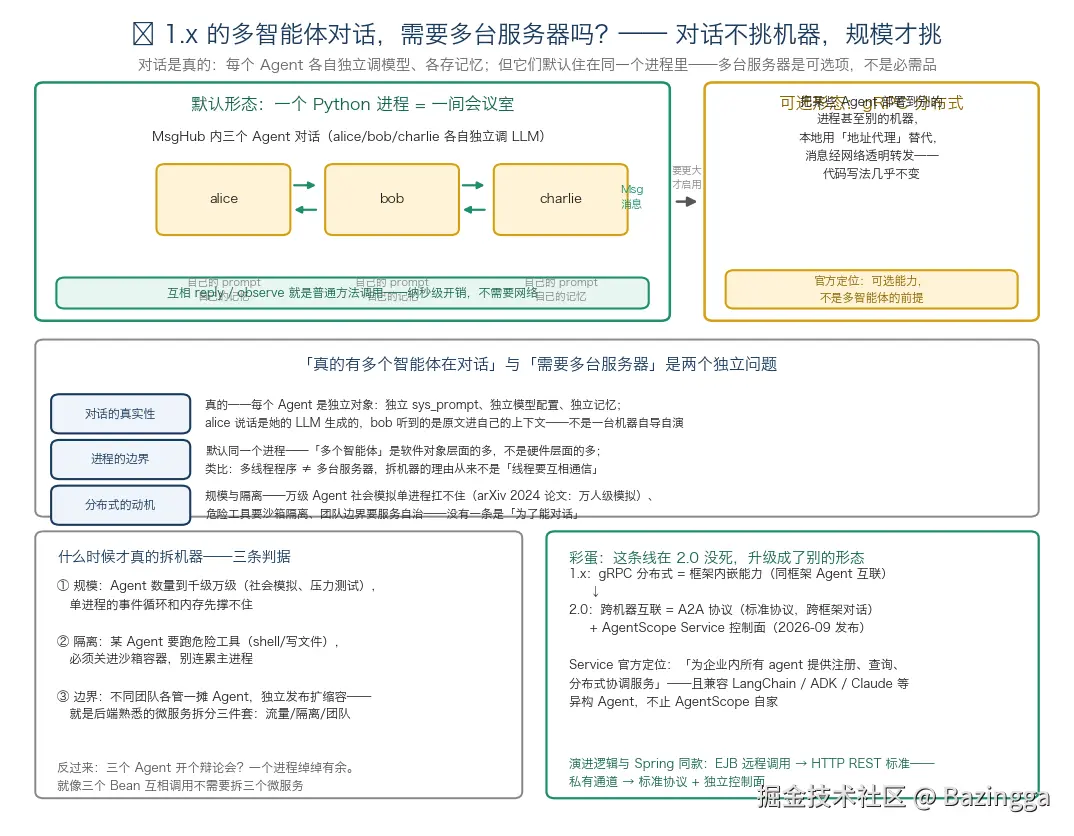
误会二:官方定位里的"分布式"指什么?
"分布式"三个字就写在 Java 版官方定位原文里("专为分布式、企业级智能体打造的 Harness 框架"),但它指的不是"多台服务器开会对",是三层意思:
- 部署视角(2.0 主战场) :你的 Agent 应用能像普通后端服务一样多副本部署 。三件地基全是 2.0 已有件------无状态 ReActAgent + 外置 AgentStateStore + Workspace 池化。对照 Java 后端的同款套路:无状态 Service、外置 session、网关轮询、外置缓存------你天天在做的分布式,就是它要的;
- 联网视角:跨机器的智能体互联。1.x 用 gRPC 地址代理(私有通道),2.0 换 A2A 开放标准(LangChain、ADK、Claude 的 Agent 都能通);
- 控制面:AgentScope Service(2026 年 9 月发布)------为企业内所有 Agent 提供注册、查询、分布式协调,类比 Nacos / Eureka 之于微服务,且兼容异构框架的 Agent。
两问两答收束:你的 Agent 应用能不能分布式部署?能,而且这是设计目标 。AgentScope 管不管智能体间的分布式调度?那是 1.x 的重点,2.0 交给了 A2A 协议加 Service 控制面。 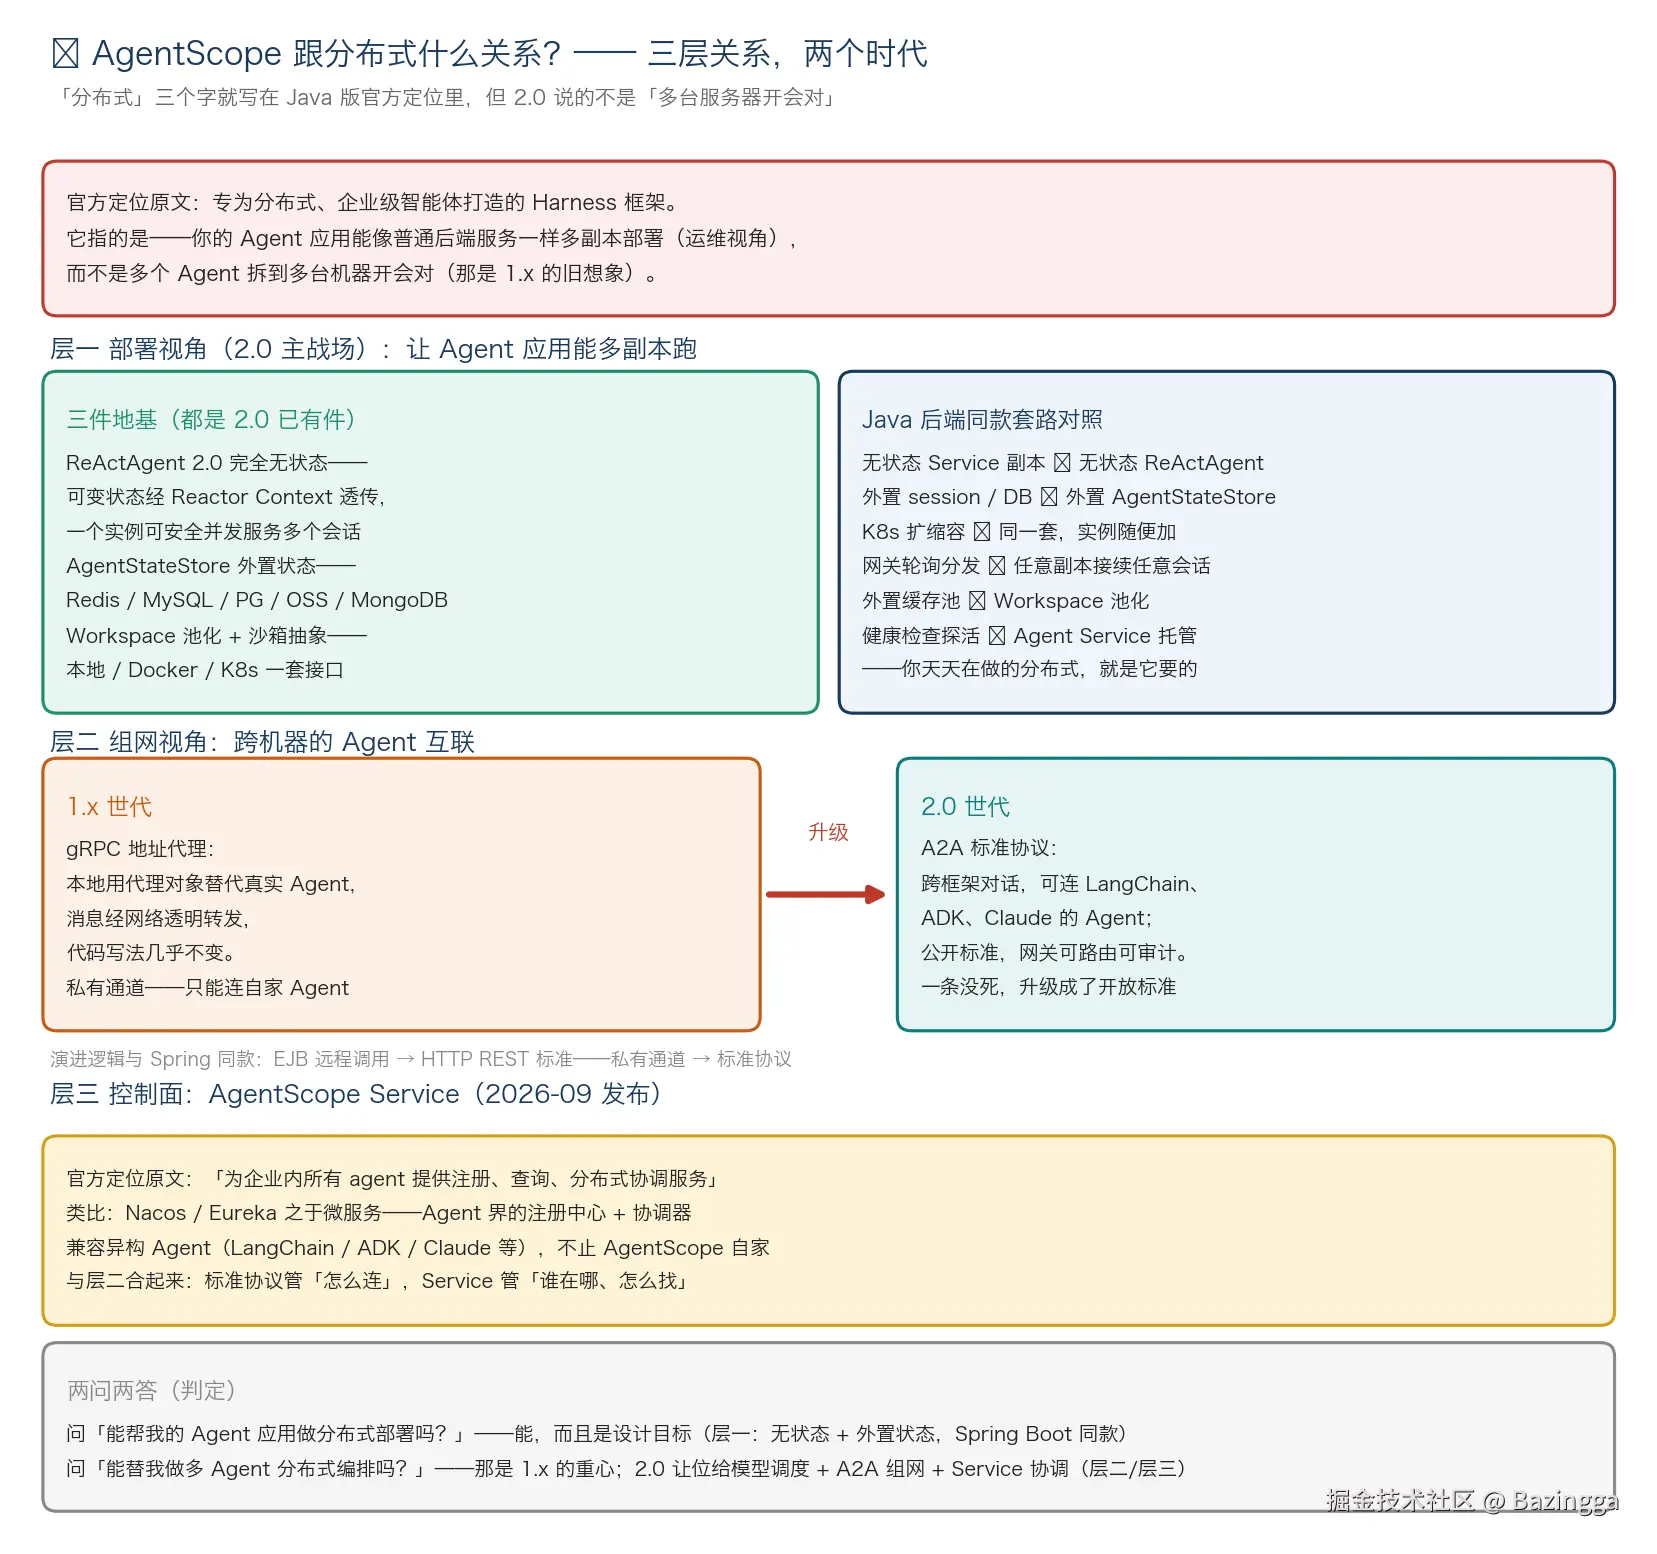
九、收束
四层带走:
- 概念层:Agent = LLM + Harness;AgentScope 是造壳的工具箱,本身不是 Agent------你用它加发动机,才拼出一台车;
- 判断层:谁决定流程定用不用------LLM 自主定流程的"干活型"应用用它,固定流程的"流水线型"用 Spring AI 就够;它与 Spring AI / LangChain4j 是楼层分工不是竞品,可以同框共存;
- 工程层:手搓的全部通用件正是它的内置件,你唯一要写的业务(提示词 + 工具方法)正是它要求的全部------对完账,49 行业务换 325 行基建白送,换来的还更多;
- 方法层:学一个框架先问"它替我省了什么"------拿手上的项目逐件对账,比读十遍功能清单都清楚。