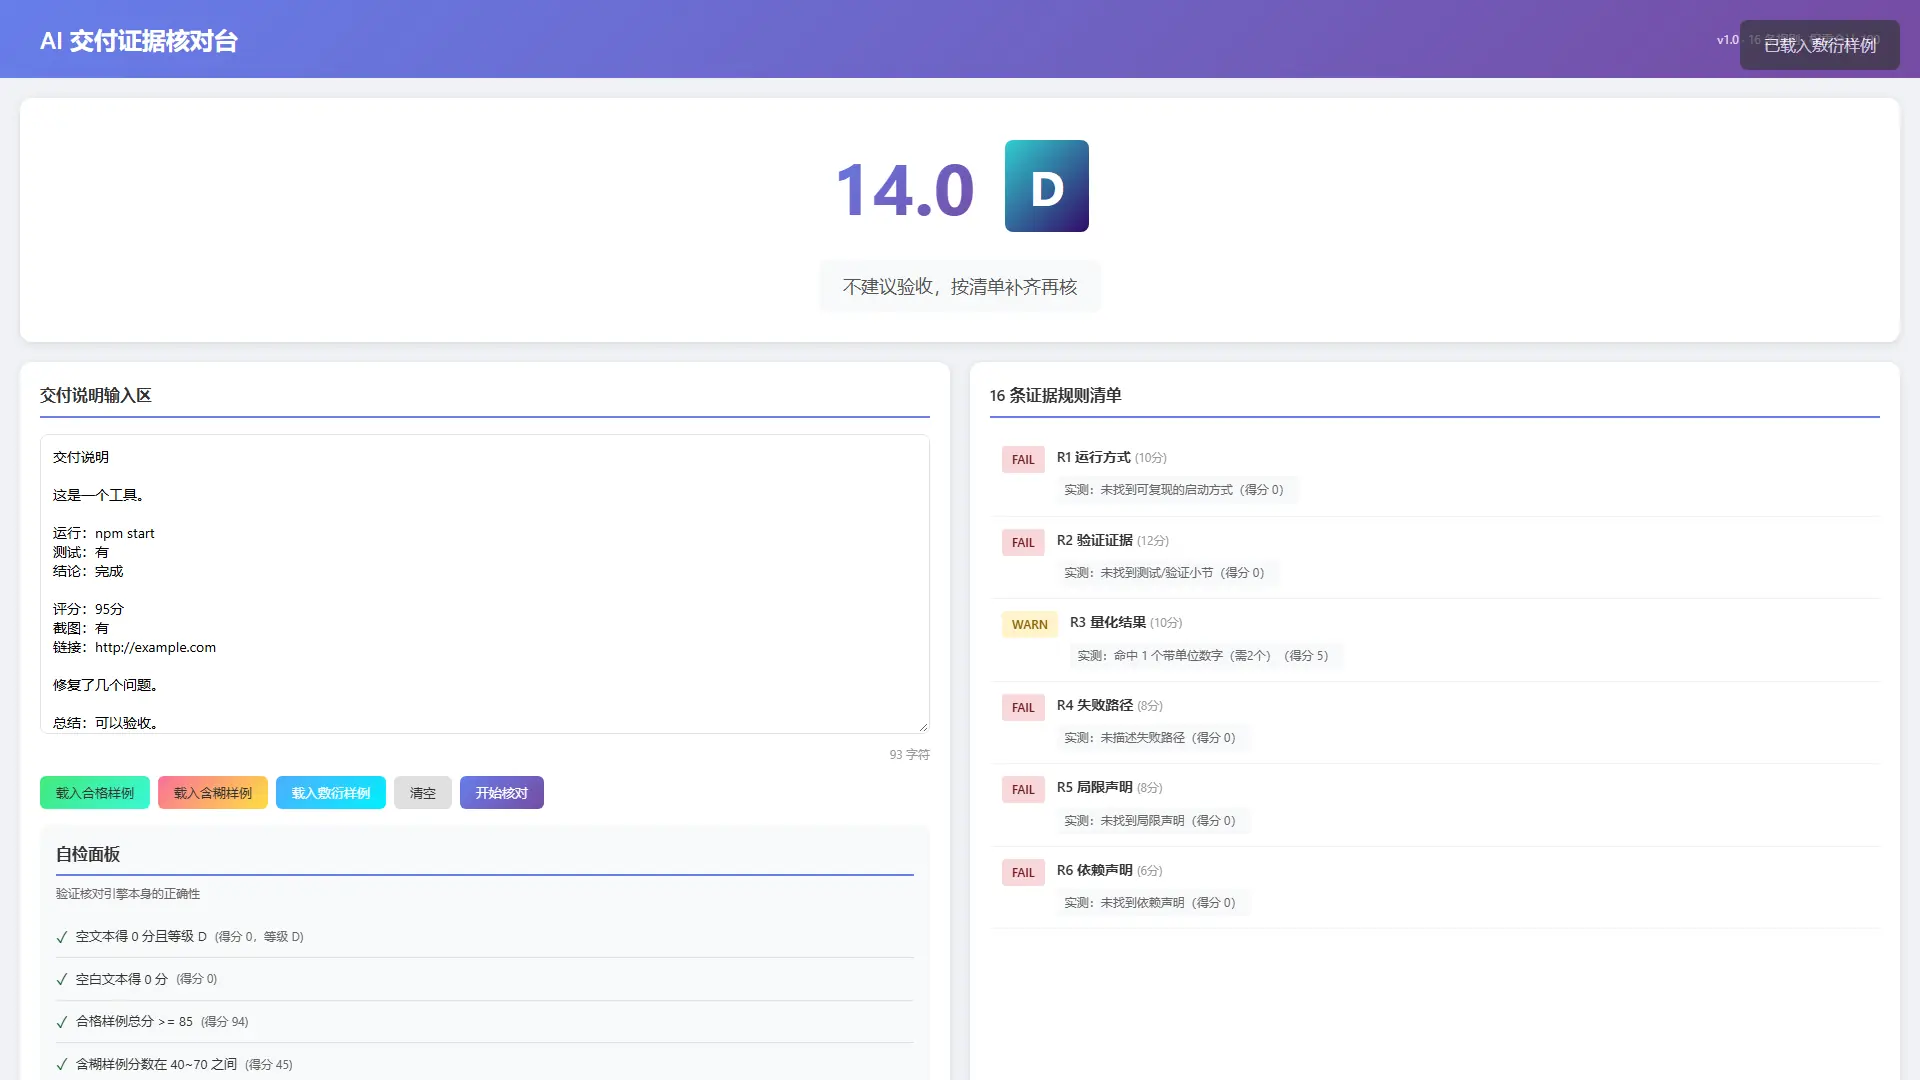
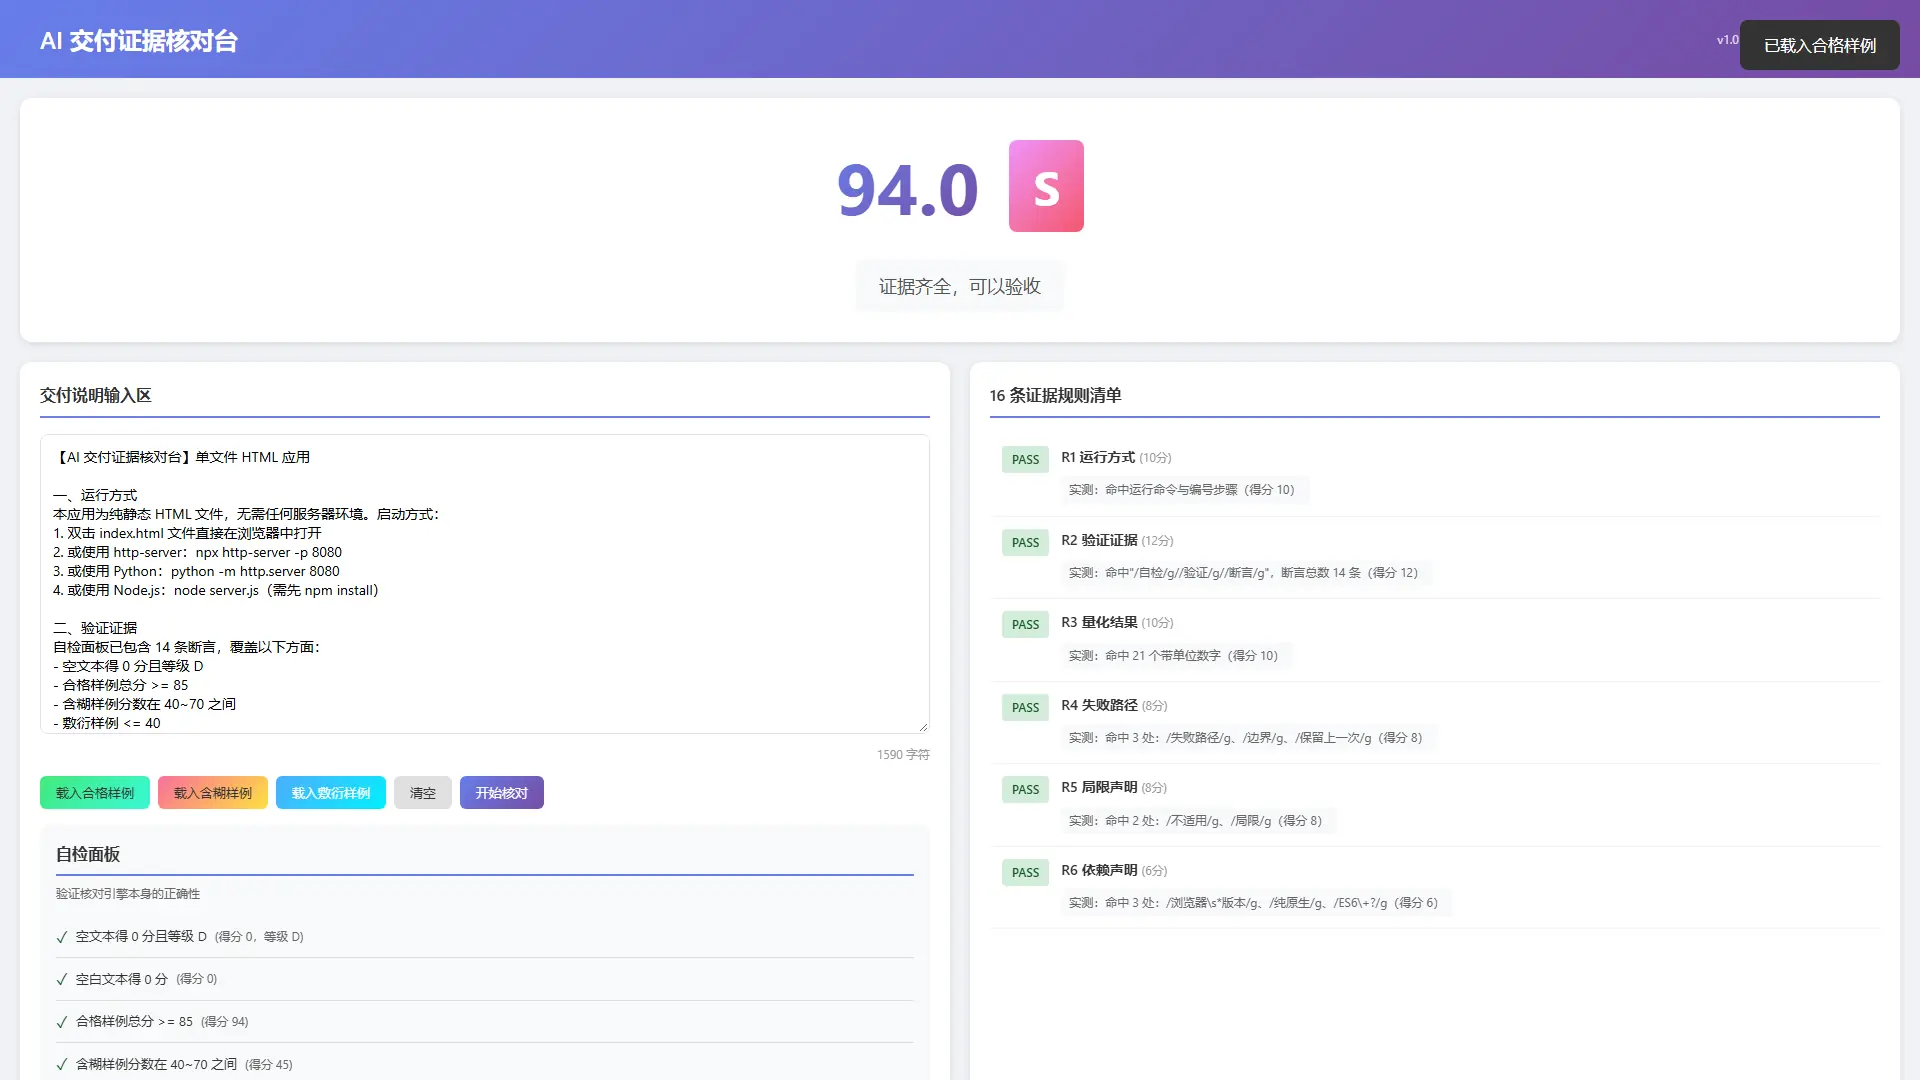
「改完了、测试通过、可以验收」------这句话本身不含任何可核对的信息。我把「一份交付说明该拿什么证明自己」拆成 16 条带权重的规则,做成一个单文件核对页:粘贴说明文本,分数、等级、逐条结论、待补清单一次给全。三份真材料的实测结果:合格样例 1590 字符拿 94.0 分(S 级,15 PASS / 1 FAIL)、含糊样例 299 字符拿 45.0 分(D 级,4 PASS / 4 WARN / 8 FAIL)、敷衍样例 93 字符拿 14.0 分(D 级,2 PASS / 2 WARN / 12 FAIL)。
算法不藏着:16 条规则的权重加起来正好 100,PASS 拿满权重、WARN 拿一半、FAIL 拿 0,上面三组分数都能手算复现(第五节有复算过程)。成品只有一个 index.html(约 28 KB),双击就能跑,不联网、不上传文本、不引第三方库。
先把边界说清楚:它核对的是「交付说明里有没有证据」,不判断技术方案本身对不对。规则靠关键词和正则字面匹配,读不懂语义,所以一定会误判------这也是第四节要花一整节讲的事。
一、先看结果:三份说明、三个分数、16 条规则
三份输入在同一台机器、同一个页面上连续跑出来的结果:
| 输入材料 | 字符数 | 分数 | 等级 | PASS / WARN / FAIL | 手算复检 |
|---|---|---|---|---|---|
| 合格样例(带自检小节、量化结果、复现步骤的交付说明) | 1590 | 94.0 | S | 15 / 0 / 1 | 100 − 6(R8 访问入口)= 94 ✔ |
| 含糊样例(每项都提了一句,但全是「比较完善」「做了一些测试」) | 299 | 45.0 | D | 4 / 4 / 8 | 32(PASS 权重)+ 13(WARN 一半)= 45 ✔ |
| 敷衍样例(「运行:npm start / 测试:有 / 结论:完成」) | 93 | 14.0 | D | 2 / 2 / 12 | 6 + 8 = 14 ✔ |
等级线是 S ≥ 90、A ≥ 80、B ≥ 70、C ≥ 60,再低是 D。所以「94 分」不是加权平均出来的感觉分,就是少了一条访问入口的价钱------合格样例故意只写了 http://localhost:8080/,而 R8 要的是 http(s) 链接,这条 FAIL 是它真实存在的短板,不是误判。
16 条规则按管的事分五组:
| 分组 | 规则编号 | 条数 | 管什么 |
|---|---|---|---|
| 能不能跑起来 | R1、R10 | 2 | 有没有可复现的启动方式、有没有 3 条以上编号步骤 |
| 能不能被验证 | R2、R3、R11、R16 | 4 | 有没有自检/测试小节、有没有 2 个以上带单位的数字、有没有验收阈值、数字带不带口径 |
| 出问题怎么办 | R4、R5 | 2 | 有没有写失败路径、有没有写局限声明 |
| 东西是什么 | R6、R7、R8、R9 | 4 | 依赖与版本、截图数量、访问入口、可调参数范围 |
| 交付态度 | R12、R13、R14、R15 | 4 | 有没有复盘问题数量、有没有结论段、正文够不够 1500 字符、有没有夸大词 |
权重不是平均分的:R2 验证证据 12 分最重,R1 运行方式 10 分,R3 量化结果 10 分------「能证明它在工作」比「它说它完成了」值钱得多。R15 只有 2 分,但它是唯一一条「命中即 0 分」的规则:一旦出现「一键搞定」「百分之百」「完美解决」这类词,不管别的写得多么齐全,这条直接 FAIL。
二、为什么值得看:AI 交付缺的不是能力,是证据
这段时间刷技术社区,Agent 编程、AI 交付是绕不开的两个词。讨论大多停在「它能不能写对」,但真正让人卡住的是一件更具体的事:AI 说它写完了,你凭什么相信。
代码写错,编译器会拦你;测试挂掉,CI 会标红;而一条「已完成」的消息既不是编译错误也不是测试失败,它就是一个字符串。你只能自己去看、自己去试、自己去想「它是不是漏了什么」。于是「AI 说完成了但其实没完成」成了社区里反复出现的吐槽,而每次翻车的原因往往都很小:没写怎么启动、没写测了什么、没写哪里是边界、没说哪里没做。
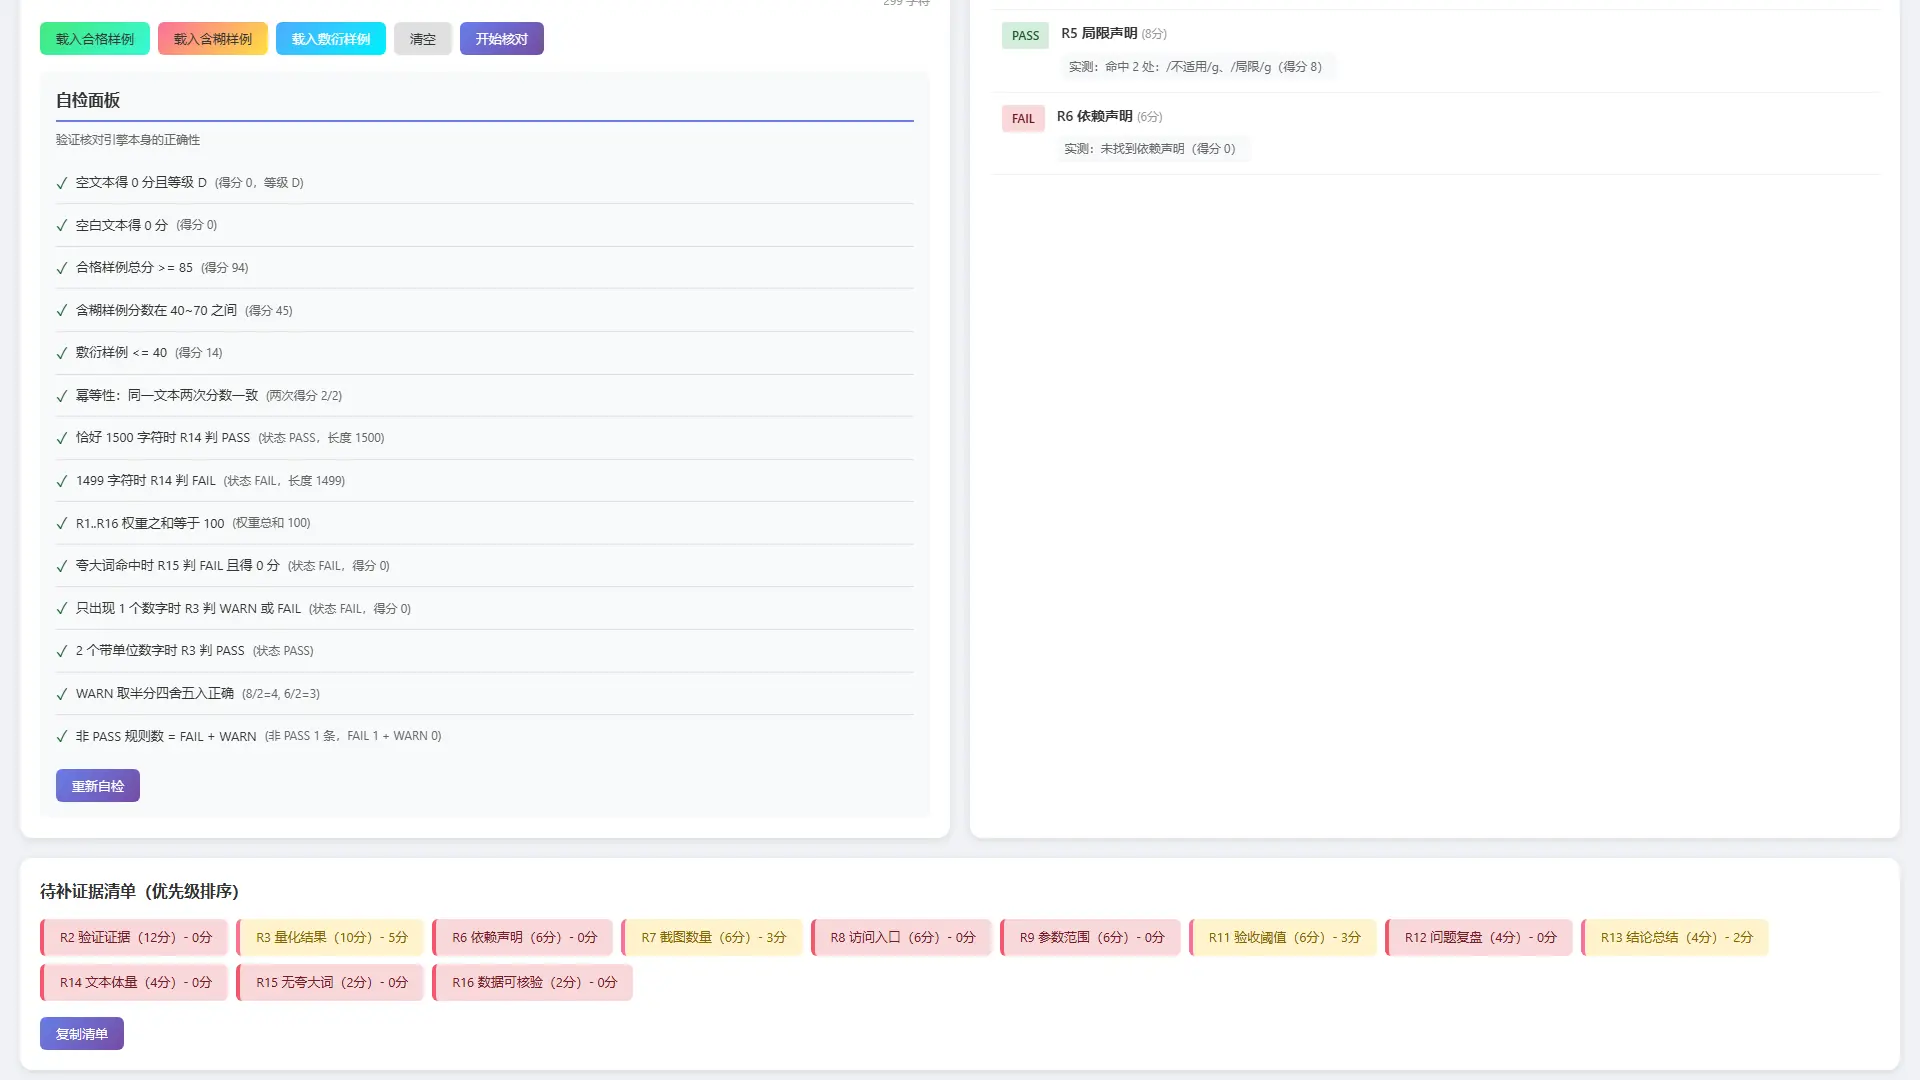
这类内容有个共同点:都是可判定的。既然可判定,就不该靠人肉记忆去查。我把它们从「经验」翻译成「带权重的断言」,好处有三个:分数可以对比(敷衍样例 14、含糊样例 45、合格样例 94)、问题可以定位(FAIL 到具体哪一条、扣几分)、补齐有清单(待补证据按扣分从多到少排序)。它解决的不是「AI 更可信」,而是「它不可信的时候你能立刻指出来」。
三、准备环境:进入码道 Web,把验收标准写进需求
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。本文用的是 WebUI 版。浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source...,登录后就能在对话窗口输入需求,不需要装软件。
需求是这么写的(节选):做一个单文件 index.html 的「AI 交付证据核对台」,中文界面、零外部依赖、不联网。16 条规则逐条实现并给出权重,权重合计必须等于 100:R1 运行方式 10 分......R15 无夸大词 2 分,命中夸大词即 FAIL 且 0 分。每条规则必须显示实测依据,不能只给 PASS 或 FAIL;页面要有自检面板,至少 14 条断言并显示实测值;失败路径要写清空输入、空白字符、超长文本的处理,任何情况下不能白屏;所有文案用中文,不出现英文占位符和 TODO。完成后打开预览。
这段需求里有三句话最值钱,后来都变成了文章里的证据:
- 「权重合计必须等于 100」。把总分算法先锁死,事后才能手算复检;不锁,分数就是一个不知怎么来的数。
- 「每条规则要给出实测依据」。只写 PASS/FAIL,事后你没法核对自己算的对不对;写上「仅 0 个带单位数字」,一眼就能反推。
- 「页面里要有自检面板」。让页面自己证明自己,而不是让我去猜它有没有跑对。
四、验证与踩坑:交付的页面我先在本机逐条核对,修掉 8 处真缺陷
交付的页面能打开,不等于它对。我把页面拉回本机逐条核对,一共修了 8 处真缺陷------没有一处是美化,全都是「不修就出错误结论」:
| # | 现象 | 根因 | 改法 |
|---|---|---|---|
| 1 | 有一条断言永远显示绿色,等于没测 | 断言把「未通过项条数」写成 FAIL + WARN,再拿它跟 FAIL + WARN 比,是句同义反复 | 改成「非 PASS 规则数 = FAIL + WARN」 |
| 2 | 「合格样例」自己只拿 90 分,被自己的 R14 扣了 8 分 | 样例本身只有 1482 字符,不到 R14 要求的 1500 | 给样例补了一节「局限说明」,补到 1590 字符,分数回到 94 |
| 3 | 样例里明明写着「文中包含 5 张截图」,R7 却判 FAIL | 数字正则 /\d+\s*张/g 没有捕获组,取 m[1] 恒为 undefined |
改成 /(\d+)\s*张/g,把数量抓出来 |
| 4 | 只给了一个带单位的数字,R3 却按两个算 | 单位列表里「个」被重复列了两次 | 删掉重复项 |
| 5 | 日期 2024-01-15 被当成参数范围 |
范围正则 /\d+\s*-\s*\d+/g 从日期里匹配到了 2024-01 |
前后加边界((?<![\d\-.])),并给「范围」拆出四条并列分支 |
| 6 | 两个分支返回完全相同的结果,白写一个条件 | R10 里 >= 5 与 >= 3 走的是同一段返回 |
合并成一个分支 |
| 7 | 样例自己写「13 条断言」,页面上实际是 14 条 | 文案没跟实现同步 | 3 处文案统一改成 14 |
| 8 | 修第 5 处时矫枉过正:1500-20000 被读成 500-20000、22.5-90 被读成 5-90 |
第一版把数字位数写死成 \d{1,3},长数字被截断;小数点也没被后顾挡住 |
改成允许小数与单位后缀,前后边界统一用 `(?<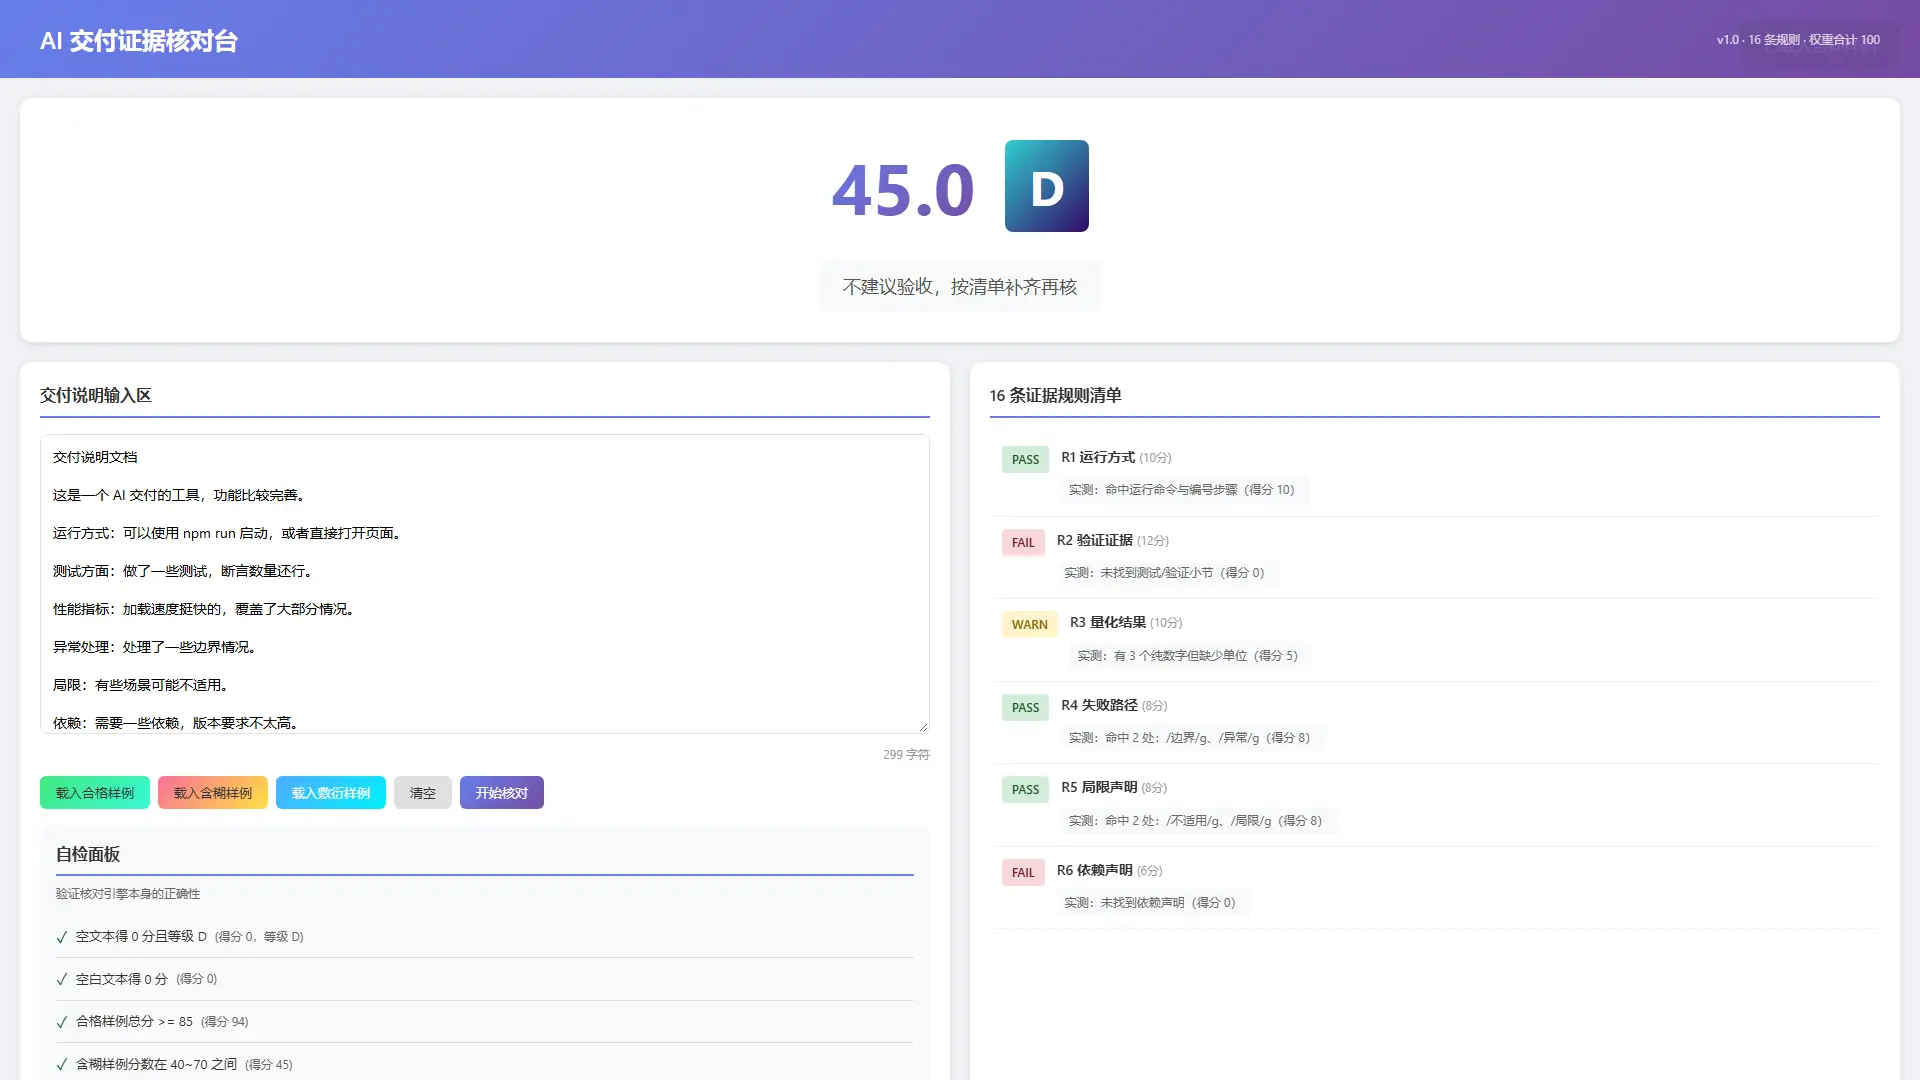
五、本地复现:三条命令核对全部数字
成品是单文件,复现不需要装任何东西:
bash
python -m http.server 8000
# 浏览器打开 http://localhost:8000/index.html
# 依次点「载入合格样例」「载入含糊样例」「载入敷衍样例」,对照上表的字符数与分数
复算过程就是一条加法。合格样例:15 条 PASS(满分 100 里少了 R8 的 6 分)→ 94;含糊样例:4 条 PASS 拿 32 分(10 + 8 + 8 + 6),4 条 WARN 拿到一半共 13 分(5 + 3 + 3 + 2)→ 45;敷衍样例:2 条 PASS 拿 6 分(4 + 2),2 条 WARN 拿 8 分(5 + 3)→ 14。三组数字和页面上的 PASS/WARN/FAIL 计数一一对应,没有第四种算法参与。
页面自带的自检面板是另一重核对手段:14 条断言全绿,专门盯那些「容易写错但不容易发现」的地方------空文本得 0 分且等级 D、恰好 1500 字符时 R14 判 PASS 而 1499 字符判 FAIL、同一份文本连跑两次分数完全一致(幂等)、16 条规则权重之和等于 100、夸大词命中时 R15 判 FAIL 且得 0 分、「非 PASS 规则数 = FAIL + WARN」。这些断言的好处是它不看主观判断,只看结构事实。
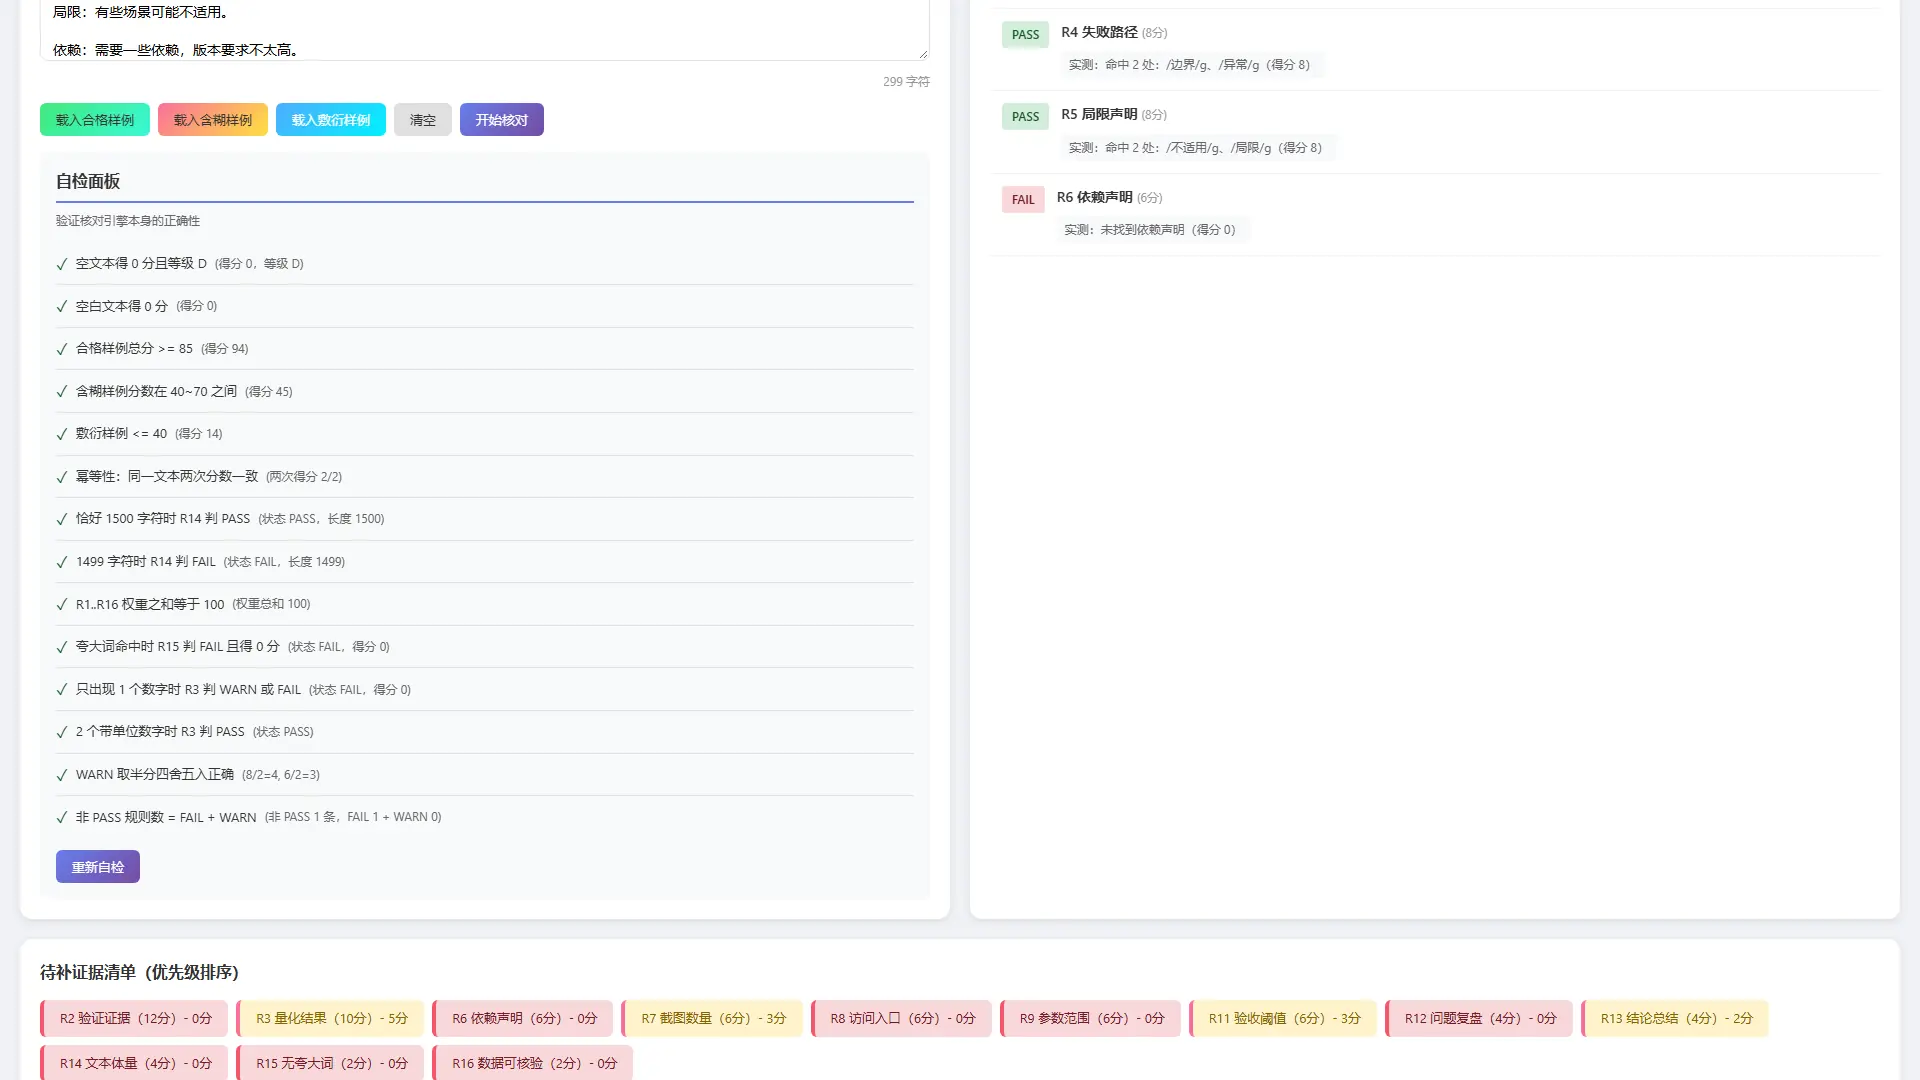
失败路径实测:输入为空提示「请输入交付说明」,全是空白字符提示「内容为空白字符,请输入有效内容」,超过 20 万字符提示「文本超出长度限制(20 万字符)」------三种情况都保留上一次的结果、不白屏,清空按钮有二次确认弹窗。这里有一个诚实记录:超长输入被拦下来时,右侧的字符计数仍然显示 200001 字符,计数没有跟着封顶。它不影响判定结果,我把它留在页面上当已知问题。
性能也顺带量了一下:199999 个字符跑完整轮核对用了 4.9ms,200000 个字符只用了 0.8ms------后者更快不是优化,是因为它在长度校验那一步就被拦下了,根本没跑规则。这也说明一件事:先卡边界再算规则,比让规则自己处理极端输入便宜得多。
六、使用码道体会:把「可验证」写进需求
这一轮下来,有 6 条经验值得留下:
- 先定评分口径,再定规则条数。「16 条权重加起来等于 100」这句话写进需求,等于给结果装了一把尺子;否则页面上那个 87 分你没法解释它怎么来的。
- 要求每条规则输出实测依据。这一条直接决定了文章能不能写------「R2 未找到测试/验证小节」可以核,「R2 不合格」只能信。
- 把自检写进需求。要求页面自带断言面板,等于让它自己给自己出证明题;14 条断言比任何一句「已完成」都可信。
- 边界当成验收项写。空输入、全空白、超长输入各写一行要求,比事后自己补缺陷便宜得多。
- 交付后逐条对照需求核,而不是「能打开就行」。这轮 8 处缺陷里有 6 处属于「页面能打开、逻辑是错的」,只看截图一个都发现不了。
- 规则明确的小工具特别适合这种协作方式。需求里把 16 条规则和权重列清楚,一遍就能交付到接近可用的程度;反过来,规则含糊时,改起来就是反复来回。
七、结论与下一步
16 条规则、三组可复算的分数、8 处真缺陷、14 条断言,构成了这份交付证据核对台的全部底账。它不能替你判断一份技术方案好不好,但能在「AI 说它写完了」的时候,替你回答那个更实际的问题:证据在哪一条、差几分、该补什么。
公开仓库:atomgit.com/deli007/dem...;本案例目录:atomgit.com/deli007/dem...。下一步想把 16 条规则做成可自定义的规则包(不同团队对「证据」的要求不一样),以及把待补清单直接导成一份待办,让「补齐证据」这件事能被分派出去。