完整面试题内容下载链接:https://pan.quark.cn/s/bb15fae7b82a
Agent / Coding Agent 面试八股文详细版:新人学习 + 面试背诵稿
适用场景:Agent、Coding Agent、AI Native 工程岗位面试。
目标:不是只给"标准答案",而是把每个答案背后的知识点讲清楚,让你可以一边背面试稿,一边反向学习 Agent 系统设计。
使用方式:先看下面的面试题清单,再看"猫猫项目是什么",然后按题号跳到对应章节。每个问题建议按"30 秒版 → 2 分钟版 → 追问防守"逐层准备。
面试题清单
详细机制都在后面。先对上题目,再跳到对应节。
- Agent 是什么?它和聊天机器人有什么区别?见第 1 节。
- Harness、Tool Call、MCP、A2A 分别是什么?MCP 和 A2A 怎么区分?见第 2 节。
- 记忆权威是什么?低权威记忆怎样才能变成架构决策?重复出现算不算?见第 3 节。
- 记忆冲突怎么合并?新指令能不能压过安全策略和已确认的 ADR?见第 4 节。
- Memory 和 RAG 有什么区别?向量能不能判断权威?见第 5 节。
- Session 和记忆怎么隔离?用户说「参考之前那个项目」怎么办?见第 6 节。
- 单只 Agent 的上下文怎么排?为什么高约束放开头、当前目标放末尾?见第 7 节。
- 多只 Agent 互相能看见什么?沉默很久的角色被叫起来,怎么恢复上下文?见第 8 节。
- 长任务只在结束时做摘要,过程中会不会失忆?压缩丢了细节怎么办?见第 9 节。
- 怎么保证目标不漂移?没有强状态机时,任务流转靠什么卡住?见第 10 节。
- 什么时候拉一只新的 Agent?为什么不一律用一个强模型做完?见第 11 节。
- 多 Agent 协作有哪些坑?两只 Agent 聊起来停不下来怎么办?见第 12 节。
- 子 Agent 产生幻觉怎么办?它说「测试通过了」能不能信?见第 13 节。
- 主子结构、Agent 团队、共享状态、A2A 是不是一层东西?见第 14 节。
- 为什么不直接调裸 API,而用 Claude Code 这类执行器?这算不算套壳?见第 15 节。
- 工具调用不准,尤其是较弱模型,怎么从 harness 侧修?见第 16 节。
- git worktree 和云端沙箱怎么隔离?一人一个常驻环境成本太高怎么办?见第 17 节。
- 对接飞书、GitHub 时,凭证为什么不能给模型看?见第 18 节。
- Agent 如何自进化?Skill 怎么写?怎样把 10 步收成 5 步?见第 19 节。
- Eval 和不同模型的 ROI 怎么评?思考档位要不要交给用户选?见第 20 节。
- 企业级、多租户、记忆不上云,分别要补什么?见第 21 节。
- 用这套系统做一次开发,存量项目怎么接入?怎么防止旧功能被改坏?见第 22 节。
- 换国产或较弱模型时,harness 要改什么?和 Claude Code、OpenClaw、开放运行时怎么区分?见第 23 节。
- 一个会话里从原神聊到崩铁,上下文怎么接?生成图片或视频很慢,怎么减少等待?见第 24 节。
0. 猫猫项目是什么
后文里的「猫」不是比喻,是这个项目里的叫法。一只猫 = 一个有角色、有权限、有边界的 Agent。 猫猫是你自己做的多 Agent 工作系统,用来回答面试里的「你的项目怎么落地」。
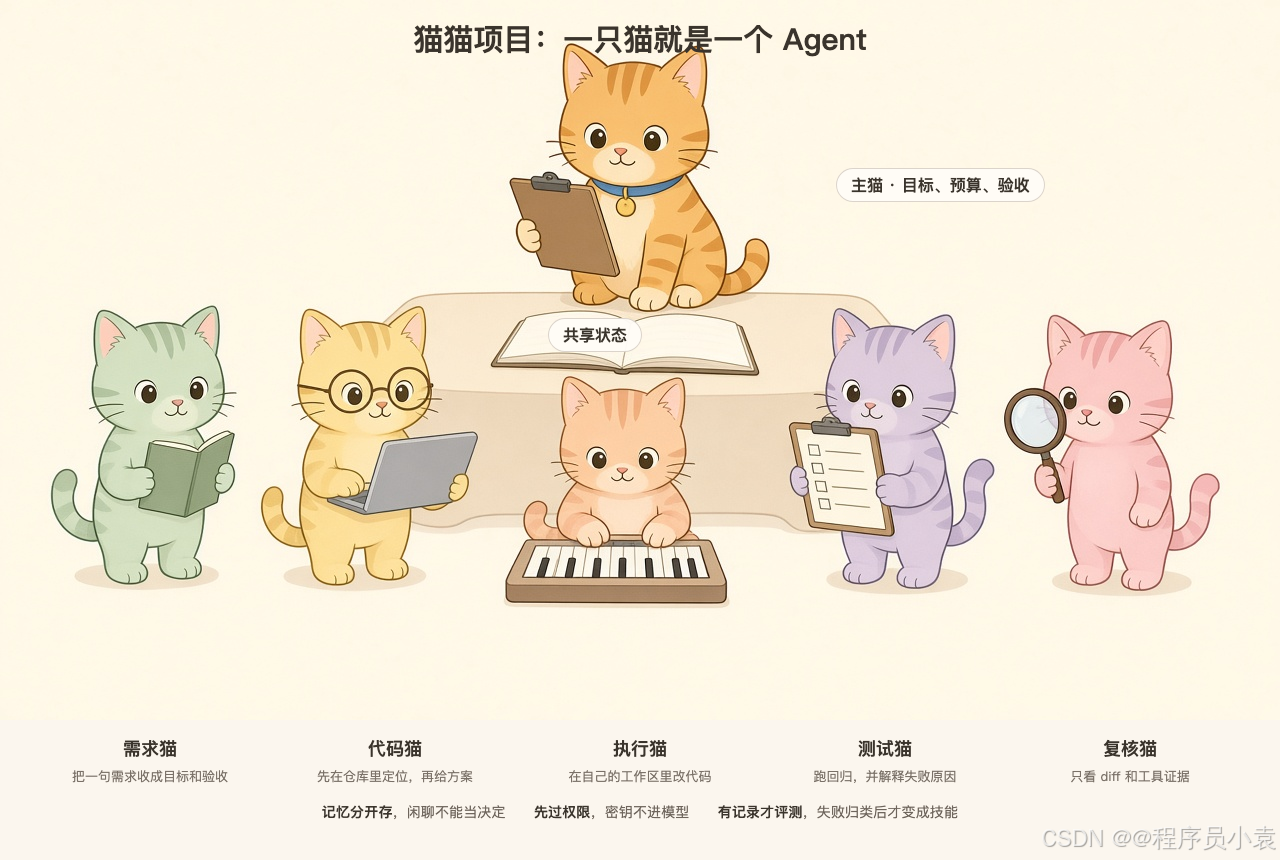
它不是一个聊天窗口,也不是把用户的话原样转给 Claude Code 或 Codex。底层可以接这些现成的编码执行器,上面自己做一层 harness:长任务怎么拆、谁来做、做到哪了、能不能做、做错了怎么停、经验怎么留下。
四块设计,面试时按这个顺序讲:
| 块 | 在猫猫里是什么 | 后文对应 |
|---|---|---|
| 多只猫协作 | 主猫拿着目标和验收标准,按需要拉需求猫、代码猫、执行猫、测试猫、复核猫。交接是任务包,不是群聊 | 第 8、11、12、13 节 |
| 记忆和上下文 | 这一轮看得见的内容、这次任务的计划、项目事实、已确认的决策、安全规则分开存,避免闲聊变成架构决定 | 第 3 到 9 节 |
| 工具和权限 | 每次调用先过权限、预算和风险;改代码在独立 worktree 里,密钥不进模型 | 第 16 到 18 节 |
| 记录、评测、技能 | 每次运行留下 trace;失败归类后写成 skill 或规则;固定任务集通过才灰度 | 第 19、20 节 |
角色就这几个,看到名字对上号即可:
- 主猫:调度者。持有目标、预算和停止权,决定拉不拉新猫,验收后才把结论写进共享状态。
- 需求猫:把一句需求收成目标、非目标、验收标准。
- 代码猫:先在仓库里定位,再给方案,不负责直接改主分支。
- 执行猫:在自己的 worktree 里改代码。
- 测试猫:看影响面、补测试、解释失败是不是这次 diff 造成的。
- 复核猫:只读。看 diff 和证据,不听另一只猫的自信表述。
共享状态是这些猫共用的任务账本:谁在改哪个文件、决定了什么、产物在哪、测试跑过没有。一只猫默认看不到另一只猫的完整对话。
后文反复用的例子,就是猫猫接了一个小需求:登录失败不要只显示「出错了」,按错误码展示具体文案。 需求猫先划定「不改后端错误码、不重构登录页」,代码猫定位 Login.tsx 和文案文件,执行猫在独立工作区改映射,测试猫跑回归,主猫核对运行时记下的测试结果,通过才算完成。
三十秒可以这样开场:
猫猫是我做的多 Agent 工作系统,解决长程研发任务里的上下文、记忆、协作和权限。一只猫是一个有角色的 Agent。主猫拿验收标准,子猫只拿任务包,产物要有工具证据才写入共享状态。底层可以接现成的编码执行器,我做的是上面的编排、记忆治理和评测。
0. 怎么用这份文档
这份文档不是普通的知识总结,而是按照真实面试问法组织的"八股文 + 学习路线"。你可以这样用:
- 先背 30 秒版:面试时先给结论,避免一上来散讲。
- 再理解知识点:知道什么是 memory、harness、A2A、MCP、sandbox、trace、eval、skills。
- 准备项目例子:所有答案都要能落回你的"猫猫项目":你怎么设计、怎么落地、遇到什么坑、怎么改。
- 准备证据:架构图、trace 截图、benchmark 表、PR/commit、失败案例、cost 变化、用户反馈。
- 不要硬装大佬:新人可以说"我的理解是......我在项目中这样实现过......如果企业级落地我会补这些"。这比把概念堆满更可信。
0. 答题时怎么讲
系统设计题可以按这条线讲,面试官容易跟上:
text
结论:这个问题本质是什么。
分层:拆成哪几层。
机制:每一层怎么工作,有什么约束。
例子:用一个具体任务走一遍。
取舍:为什么不选更简单的做法。
边界:个人项目做到哪,企业级还要补什么。
新人最容易被追问穿的,不是名词,而是把名词说成了另一样东西:
- Agent 不是一段更长的 prompt。它是模型加上工具、状态、权限和反馈循环。
- 记忆不是向量库。向量只负责"找得像",不负责"能不能信"。
- 多 Agent 不是几个模型互相聊天。没有角色、预算和停止条件,就会死循环。
- 自进化不是权重自己更新。它是执行记录、失败分类、候选改动、评测、灰度。
下面多数例子用同一个任务串起来:把登录失败从"出错了"改成按错误码展示具体文案。这样记忆、交接、工作区和回归可以讲成一件事。
1. Agent 是什么
1.1 30 秒
Agent 不是一次问答。用户给出目标之后,系统会自己循环:理解目标、选工具、看结果、改计划,直到完成、失败,或者必须问人。模型负责决定下一步,工具负责碰到真实世界,状态负责记住做到哪了,权限负责拦住危险动作,执行记录负责事后复盘。
1.2 例子
用户说:"登录失败不要只显示出错了,按错误码给具体提示。"
聊天机器人会直接写一段前端代码,至于项目里错误码在哪、文案文件叫什么、测试怎么跑,它并不真的去做。
Agent 会自己做完这些事:先搜索 Login 和错误码枚举,读到 src/pages/Login.tsx 和 src/i18n/error.ts,发现后端错误码不该改,再改前端映射,跑相关测试,最后给出 diff。中途如果测试失败,它看的是命令输出,而不是再编一段"应该通过了"。
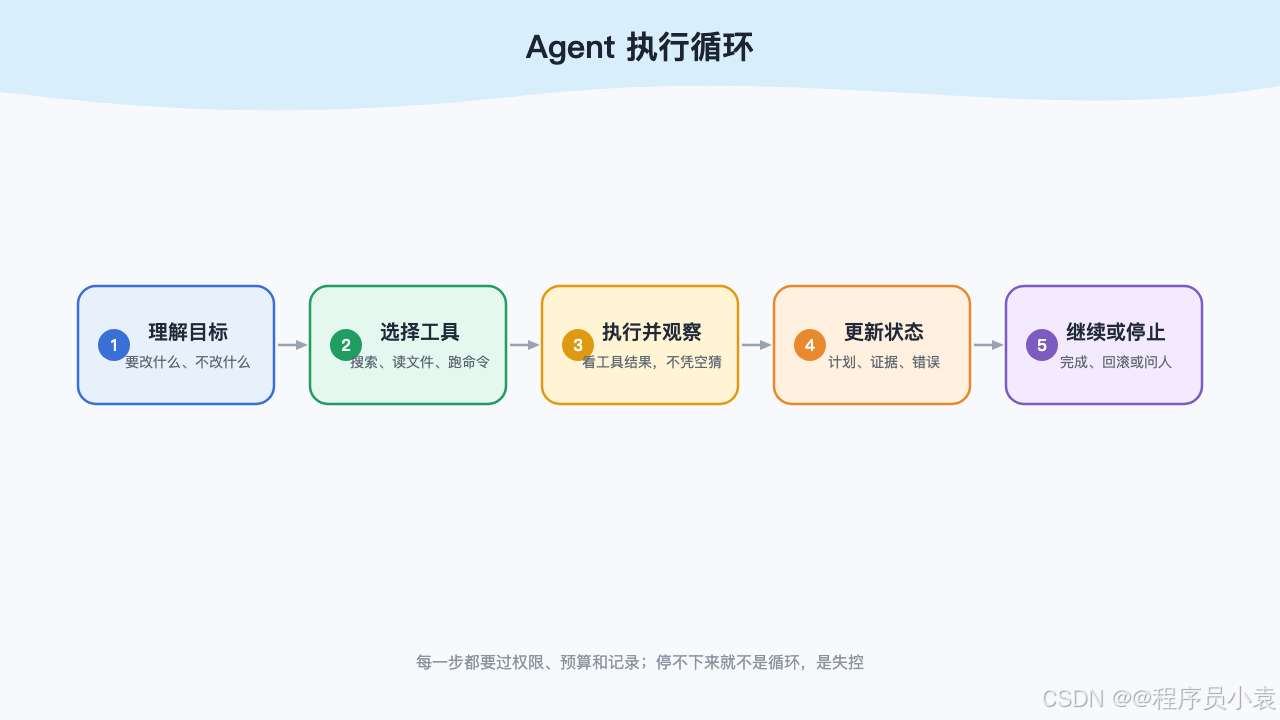
循环必须有步数、token 和时间上限。每一步高风险工具调用前要过权限。每一步要留下记录,否则后面无法排错,也无法做评测。
1.3 和普通聊天机器人的差别
| 维度 | 聊天机器人 | Coding Agent |
|---|---|---|
| 目标 | 把话说对 | 把任务做完 |
| 输错的后果 | 用户不采信 | 改坏仓库、泄露密钥、删错文件 |
| 核心难点 | 回答质量 | 可靠执行:读代码、改代码、跑测试、失败后恢复 |
| 怎么评估 | 人觉得像不像 | 测试是否通过、改动是否越界、花了多少钱、有没有弄坏旧功能 |
可以说:聊天机器人的问题是答得对不对;Coding Agent 的问题是做得稳不稳。所以我更关心循环外面的那层工程壳,而不是只换一个更强的模型。
2. 先把这几个词讲清楚
2.1 Harness
模型只会输出文字,或者输出"我想调用某个工具"。Harness 是把这个意图变成真实动作的外壳:提示词、工具注册、真正执行、权限审批、沙箱、上下文拼接和压缩、重试、执行记录、评测、模型路由。
例子:模型说"运行 rm -rf dist"。没有 harness,这句话只是文本;有 harness,系统要先判断这个命令在不在白名单、当前目录是不是任务工作区、要不要让人确认。模型决定想做什么,harness 决定能不能做、怎么做、失败了怎么回到模型。
2.2 Tool Call
模型给出工具名和参数,系统执行,再把结果塞回模型。不准的时候,先改工具,不要先换模型。
常见改法:
- 两个工具都能"搜代码"时,模型会乱选。留下一个,写清什么时候用、什么时候不用。
- 参数太自由,就把路径、命令类型收成枚举,必填项写死。
- 失败只返回一段自然语言,模型无法改。改成错误码加下一步建议,例如"文件不存在,请先用搜索定位"。
- 工具结果有几千行,要裁成关键片段再送回,否则下一轮上下文被日志撑满。
例子:弱模型面对一个大工具 do_anything(action, path, command),经常把搜索和读文件传混。拆成 grep 和 read_file 之后,选错的次数会明显下降。复杂规划仍交给强模型,分类和抽取可以留给较弱的模型。
工具调用准不准,是模型、参数约束、工具说明、上下文和错误反馈一起决定的。
2.3 MCP 和 A2A
MCP(Model Context Protocol)解决的是:一个 Agent 怎么按统一方式接上外部工具和资料。A2A(Agent2Agent)解决的是:两个彼此看不见内部的 Agent 怎么交接一项任务。
MCP 里记住三个角色、三种能力就够面试讲:
- Host 是用户正在用的应用,例如 IDE。Client 是 Host 里负责连服务器的那一段。Server 对外提供能力。
- Tools 是能执行的动作,例如查库、开 PR。
- Resources 是能读的资料,例如表结构、文档。
- Prompts 是可复用的提示模板。
接上 MCP 不等于安全。身份、权限、审计、超时、工具白名单、提示词注入防护,都要自己补。Server 返回的内容也可能是攻击文本,不能因为"来自工具"就当成可信指令。
A2A 里记住这几样:Agent Card 是能力名片;Task 是一项协作任务;Message 是来回的消息;Part 是消息里的文本、文件或图片;Artifact 是任务产物。它默认双方是不透明的,不共享你的内部记忆和权限系统。
内部几只猫协作,我更需要共享任务账本、细粒度权限和预算,所以早期用自己的结构化交接,而不是先上 A2A。以后要和外部 Agent 互通,再把内部任务映射成 Agent Card、Task 和 Artifact。这不是否定 A2A,而是内外两层。
2.4 RAG、向量和 Hybrid Search
RAG 是:模型不该靠背诵来猜的内容,先从外部资料检索,再带着检索结果回答。
Embedding 把文本变成向量,语义接近的片段距离更近。它能找"意思像"的内容,不能判断真假,不能判断谁更权威,也不能代替权限。
纠正: Hybrid Search 指两路召回一起用,一般是关键词或 BM25,加上向量。两路结果先融合,例如用倒数排名融合。Rerank 是融合之后、送进上下文之前的单独一步,用一个更贵的模型把前几十条再排一次。不要把 Rerank 说成 Hybrid 的定义本身。
Coding 场景尤其不能只靠向量。函数名、错误码、配置项必须精确命中。ERR_PASSWORD 和"密码错误"语义接近,但改代码时必须找到枚举本身。所以先用搜索和语法树保证精确召回,再用向量补"叫法不同但意思相同"的片段,最后按范围过滤,必要时再 Rerank。
2.5 Context、Memory、知识库、共享状态
| 概念 | 是什么 | 活多久 | 登录页例子 |
|---|---|---|---|
| Context | 这一次调用模型能看见的输入 | 一次调用 | 刚读到的 Login.tsx 片段 |
| 短期记忆 | 这次任务的计划和临时结论 | 一个任务 | "后端错误码不动,只改前端文案" |
| 长期记忆 | 跨会话还要记住的事 | 项目或更久 | "这个仓库回答用中文,测试命令是 pnpm test" |
| 知识库 | 外部事实来源 | 被人维护 | 接口文档、README |
| 共享状态 | 多只猫一起干活的账本 | 一个任务 | 谁在改哪个文件,测试有没有跑 |
一句话:Context 是这次看得见的,Memory 是以后还要用的,知识库是外面的资料,共享状态是协作时的账。混在一起,就会把 A 项目的密钥讨论带进 B 项目。
2.6 上下文压缩
窗口装不下时,要压缩的是可恢复的状态,不是随便写一段聊天摘要。至少留下:目标、约束、已做决定、做过的动作、证据在哪、没解决的问题、风险、下一步。
摘要如果不能指回文件路径、行号、命令记录或 commit,它就只是二手事实。后面关键决策不能只信它。
2.7 Sandbox
沙箱让命令和改动发生在受控环境里。个人项目可以用 git worktree 加命令白名单。企业场景还要租户隔离、网络隔离、密钥注入、磁盘回收和审计。容器适合多数任务;需要更硬隔离时再用 microVM。不是每个用户永久占一台机器。
2.8 Trace、Eval、Benchmark
| 概念 | 作用 |
|---|---|
| Trace | 一次运行的全过程:模型输入输出、工具调用、错误、花费、耗时 |
| Eval | 用固定任务看这次改动有没有变好、有没有退步 |
| Benchmark | 更标准化、能横向比较的评测集,例如 SWE-bench 这一类 |
没有执行记录就没有评测,没有评测就不要说自己在进化。指标不能只看最后一句像不像答对,还要看步数、工具是否选对、测试、花费、人工介入、改动范围、旧任务是否被弄坏、有没有越权。
2.9 Skill
Skill 是把反复出现的做法收成一份可复用的能力说明。它不是另一段永远塞进提示词的文字。一份能用的 skill 要写清:什么时候触发、步骤、允许用哪些工具、怎样算做完、失败了怎么恢复、一个例子。
路由时只看它的短描述。命中之后再加载全文。否则 skill 越多,上下文越脏。
3. 记忆权威:低权威内容怎么才能变成决策
3.1 例子
三句话权威完全不同:
- 聊天里说:"我感觉可以用 MongoDB。"这是低权威证据。
- 仓库 README 写:"本项目统一 PostgreSQL。"这是项目事实。
- ADR 写:"用户系统用 PostgreSQL,因为要事务。"这是架构决策。
Agent 如果看见向量距离近,就把第一句当成决策,后面写迁移方案,就走错了。
...