系统崩溃不是设备太多,而是建模太乱
很多开发者将IoT系统失稳归因于'设备数量增长',但真实瓶颈不在硬件资源或网络带宽,而在建模逻辑的缺位。
当200台以上多品牌、多协议设备未经统一抽象就直接接入,协议插件混用、点位命名随意、驱动配置分散,系统便迅速陷入不可维护状态。
典型表现是字段语义严重冲突:同一温度参数,在不同设备中被命名为temp、temperature、T1、当前温度------这种非标命名使后续的数据分析、告警配置、BI看板全部失效。
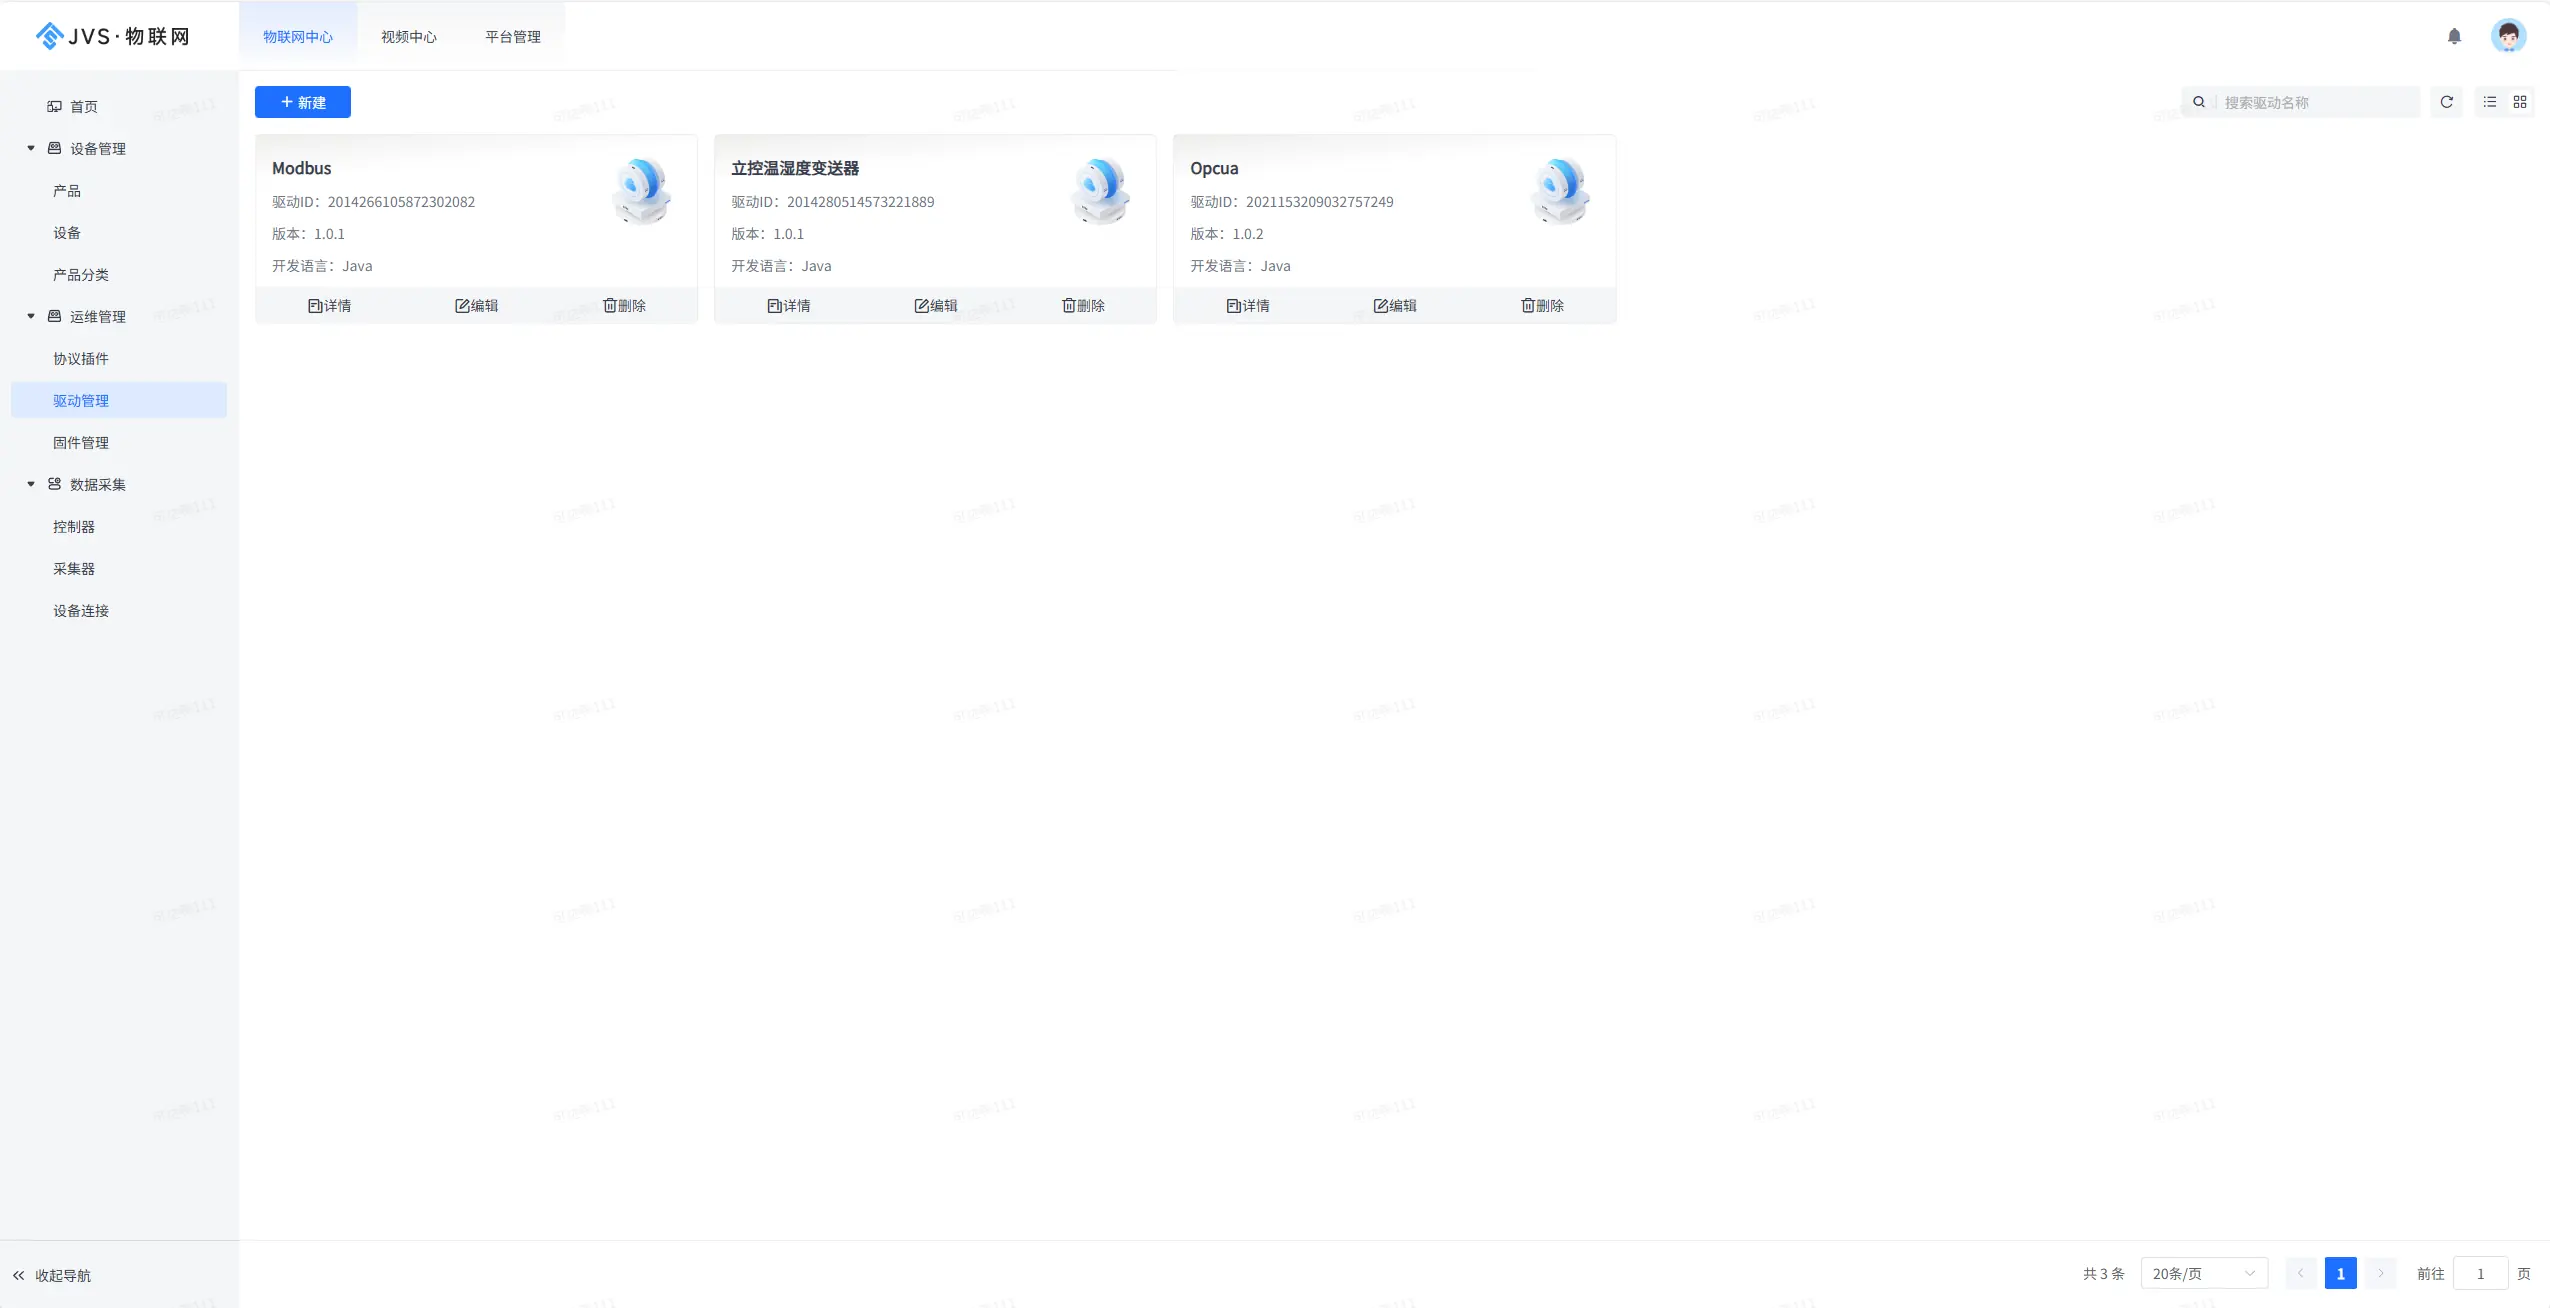
问题本质不是'接不上',而是'接完之后管不住、用不起来'。
制造业客户反馈印证了这一判断:'单台设备调试只要半天,接入第50台时,光对齐点位表就花了三天,第100台上线后,告警规则全要重写。'
这说明设备接入失败率随规模上升,并非技术能力不足,而是缺乏前置建模共识。
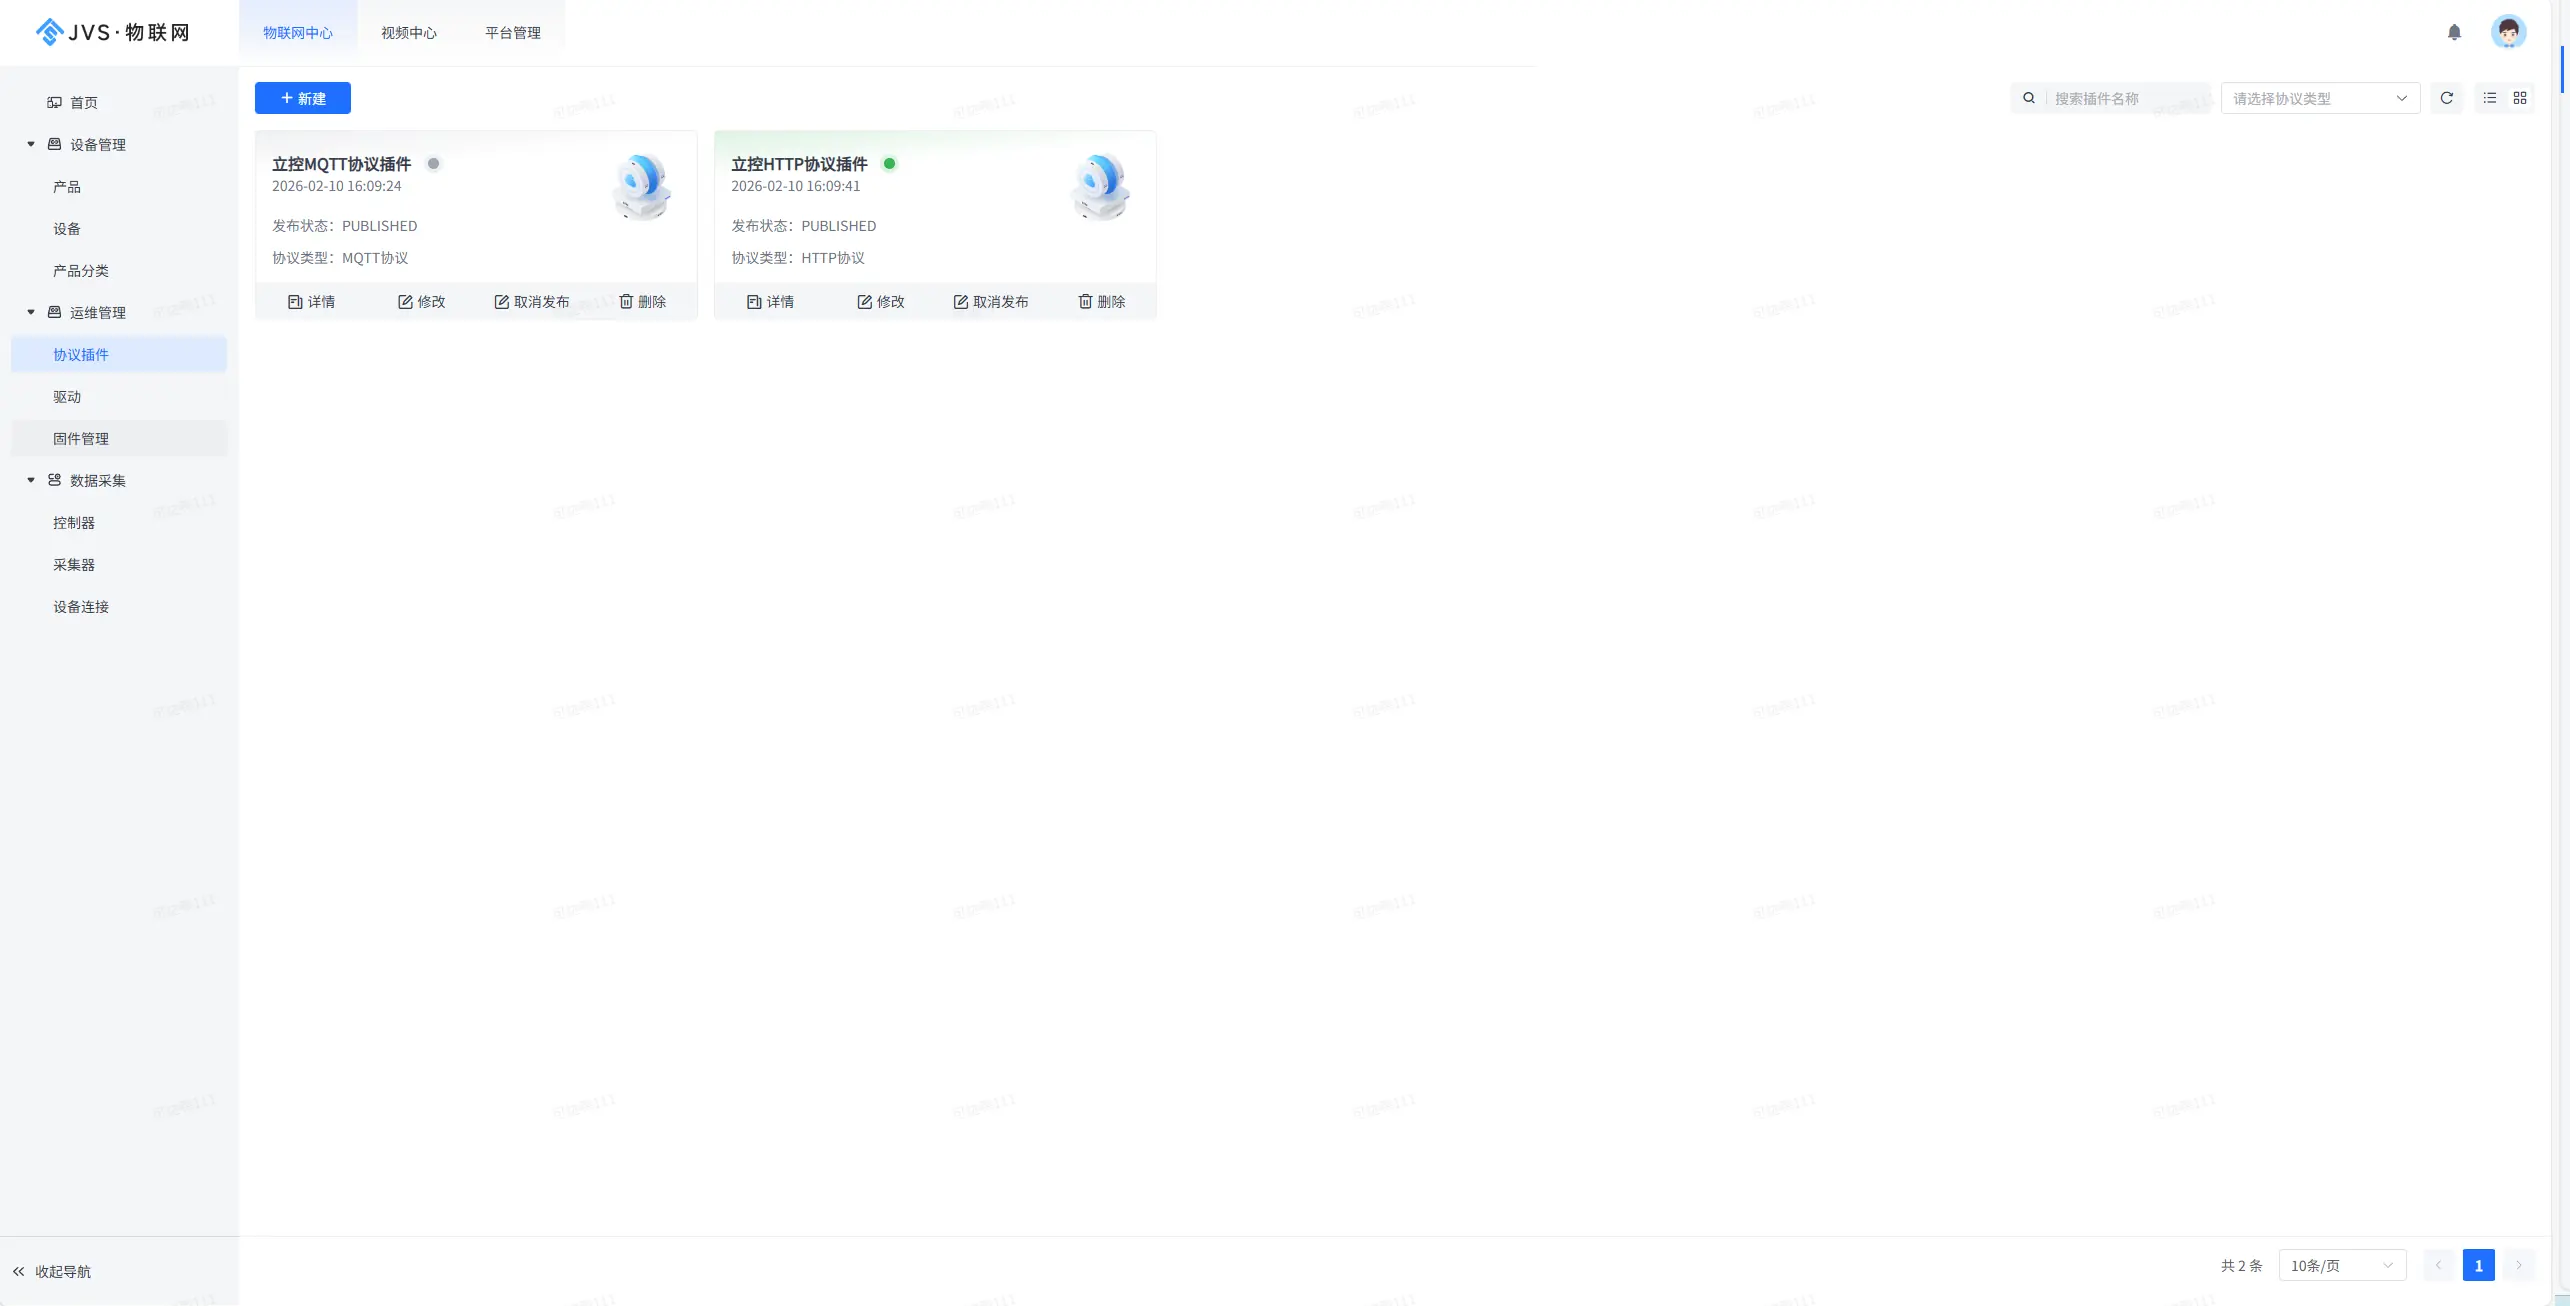
三层抽象失效如何引发运维雪崩
当产品层、设备层、物模型层任意一环缺失,问题会逐层放大,最终演变为系统级失控。
以下三类失效现象在实际项目中高频出现:
- 产品层缺失:同类温湿度变送器需为每台单独配置协议、驱动和采集频率,无法复用,调试成本线性增长;
- 设备层失控:设备离线时无法快速区分是网络中断、网关故障、采集器异常还是设备本体停机,日志分散、链路断裂,远程排障效率极低;
- 物模型层空转 :属性、功能、事件未标准化,规则引擎无法跨设备复用告警逻辑------例如'电机过热'规则在A品牌PLC中匹配
overheat_flag=1,在B品牌中却需适配motor_temp>85℃,导致每新增一类设备,告警开发就要重来一遍。
结果就是'接入即负债':设备数量每增加50台,日志管理复杂度翻倍、告警误报率上升、权限配置出错概率激增、与MES/ERP集成联调周期延长------运维成本呈指数级攀升。
重建'产品-设备-物模型'三层契约体系
规模化稳定运营的前提,是建立可继承、可验证、可审计的标准化契约关系。
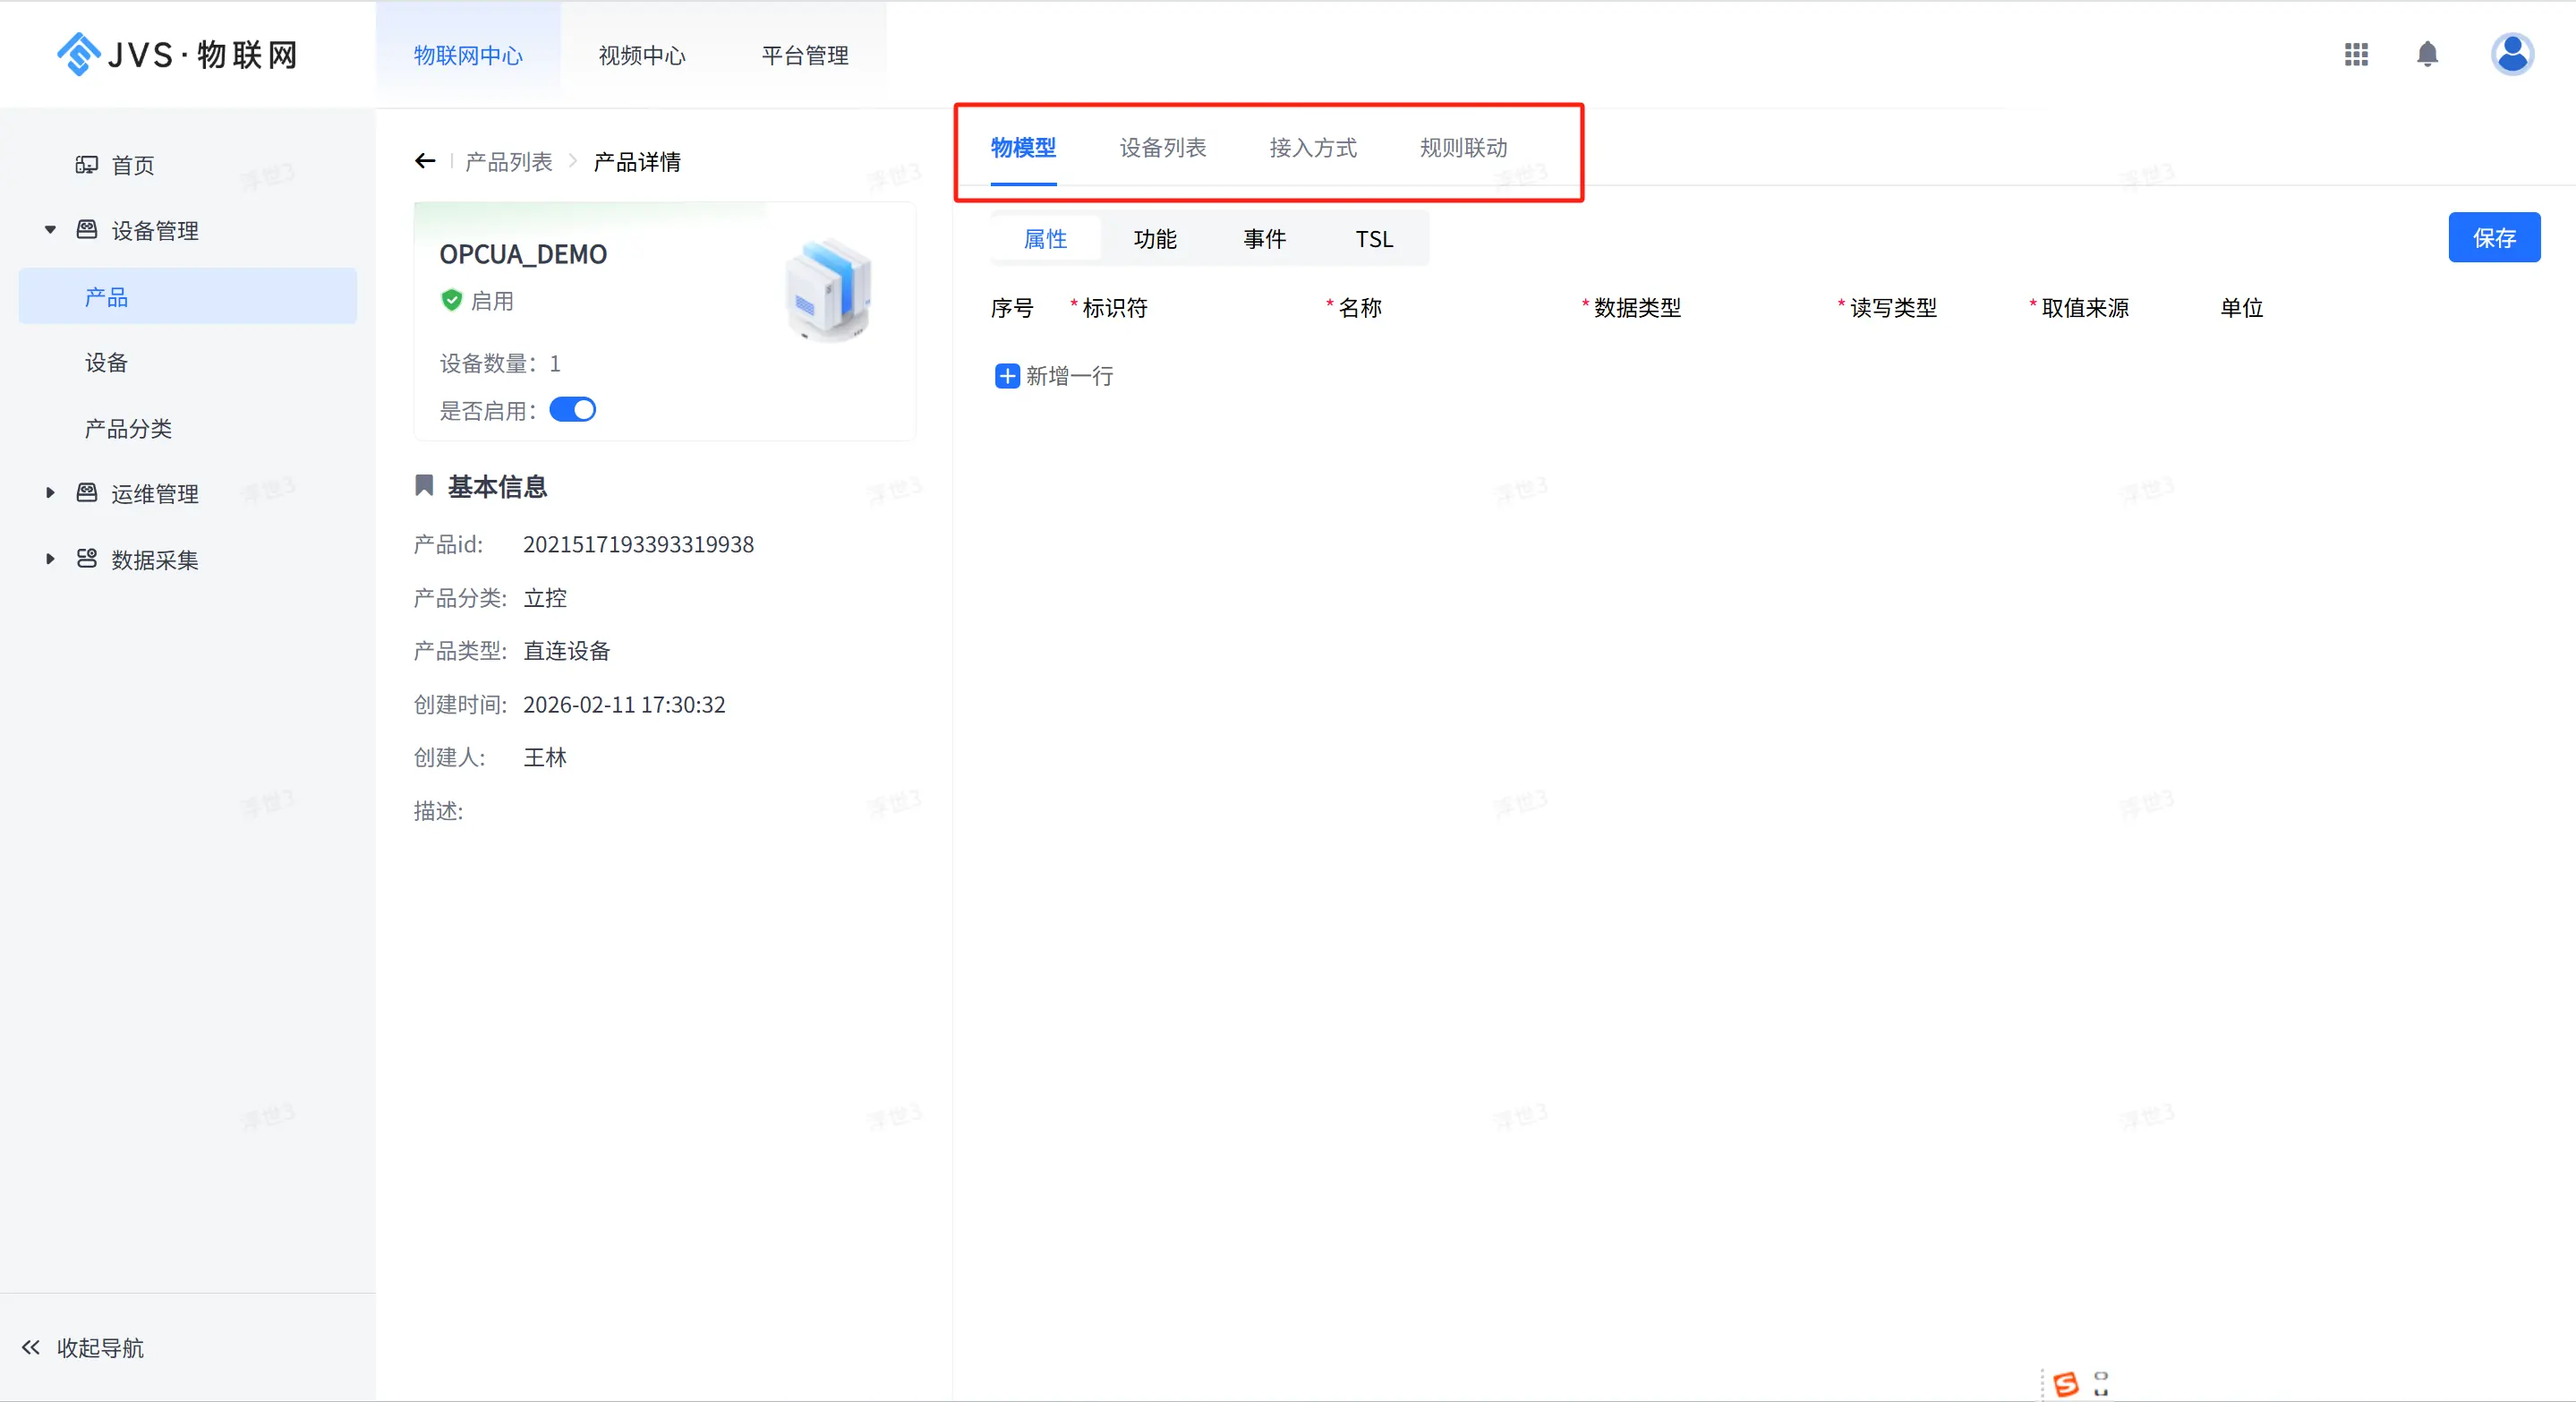
该体系包含三个核心抽象层级:
- 产品即模板:按设备类型(如继电器、温湿度变送器、智能电表)构建产品分类体系,每个产品模板预置协议插件、驱动配置、默认采集策略和安全策略;
- 设备即实例:物理设备注册时强制绑定唯一产品模板,自动继承其全部配置,包括接入参数、权限分组、生命周期规则及设备影子同步机制;
- 物模型即契约 :通过标准TSL(Thing Specification Language)明确定义三类接口:
属性(如temperature、status),支持读写与单位统一;功能(如set_power_on、reset_alarm),封装远程控制指令;事件(如device_fault、low_battery),规范异常上报结构与等级。
该体系下,新增设备仅需选择对应产品模板、录入SN码,即可完成协议适配、点位映射、告警绑定与权限下发,实现真正意义上的零配置上线。
从推倒重做到持续运营的关键行动
对技术负责人和架构师而言,避免项目陷入'建了又拆、接了又改'困局,关键在于把建模动作前置化、标准化、指标化。
启动前必须完成三项基础工作:
- 梳理全量设备协议清单;
- 确认结构化点位表(含名称、单位、数据类型);
- 联合设备与IT部门共同评审核心物模型字段。
坚决拒绝'先接入后建模':应将产品模板评审与TSL签核纳入项目立项前置条件,未通过不得进入实施阶段。
验收时不只看连接数,更要看两个硬性指标:
- 同类设备批量接入耗时 ≤15分钟;
- 新设备上线后,已有告警规则、看板组件、API接口的复用率 ≥80%。
长期价值不在'接了多少台',而在于设备数据能否稳定转化为设备在线率、平均故障间隔(MTBF)、维修响应时长、能耗波动趋势等可衡量、可优化、可汇报的经营指标。