智乃36倍数
数学原理
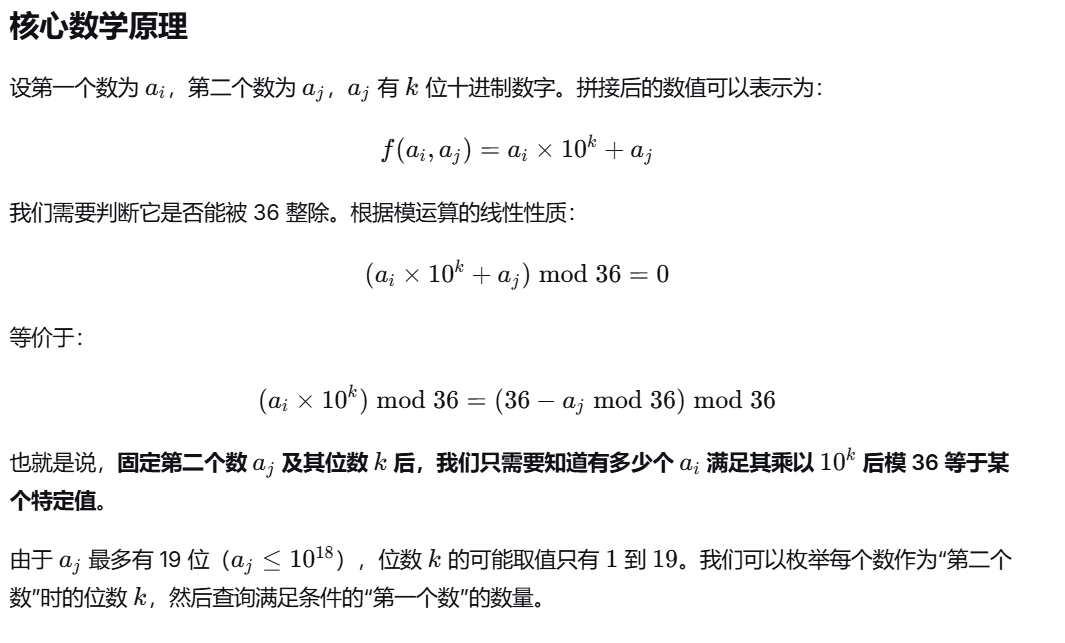
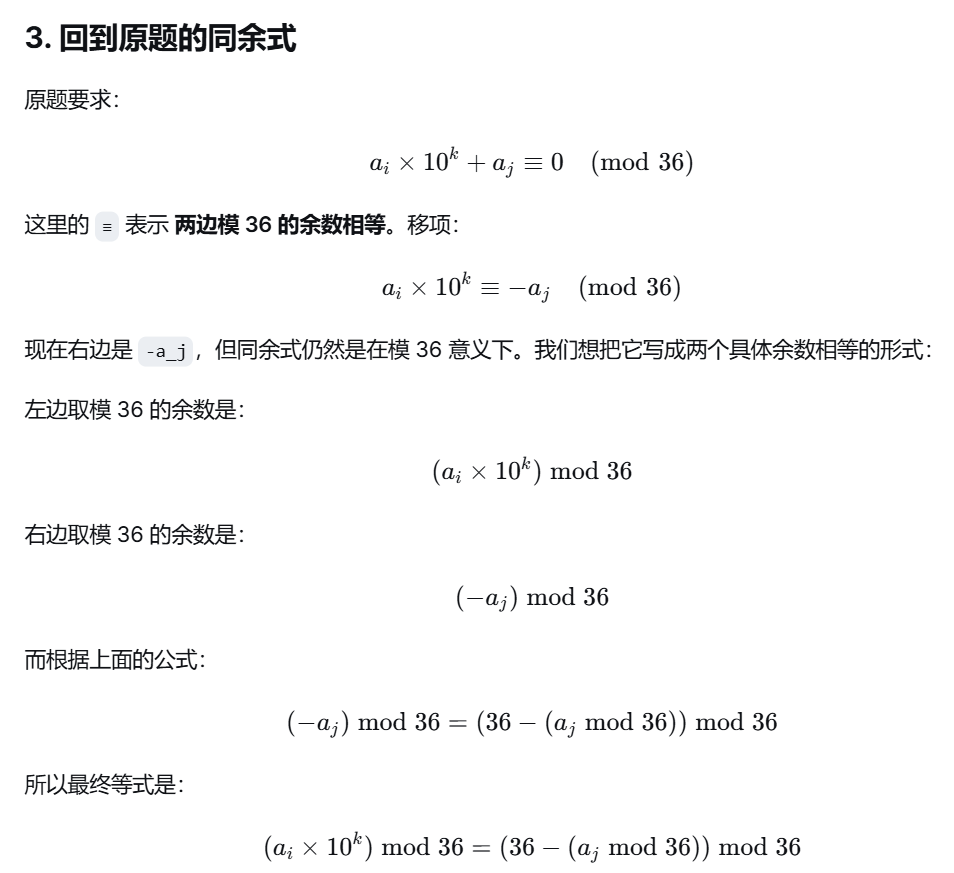
就是说,这里去枚举aj,即拼接数的第二个数,即拼接完后的低位,枚举aj时也能知道k,然后就是去找能符合这个等式的ai
即给定aj后,计算右式可以得到一个值,然后暴力法就是可以逐个算ai,看是否等于这个值,如果可以,那就++
不过这貌似依然是On^2,如何由这个数学原理进一步解题?
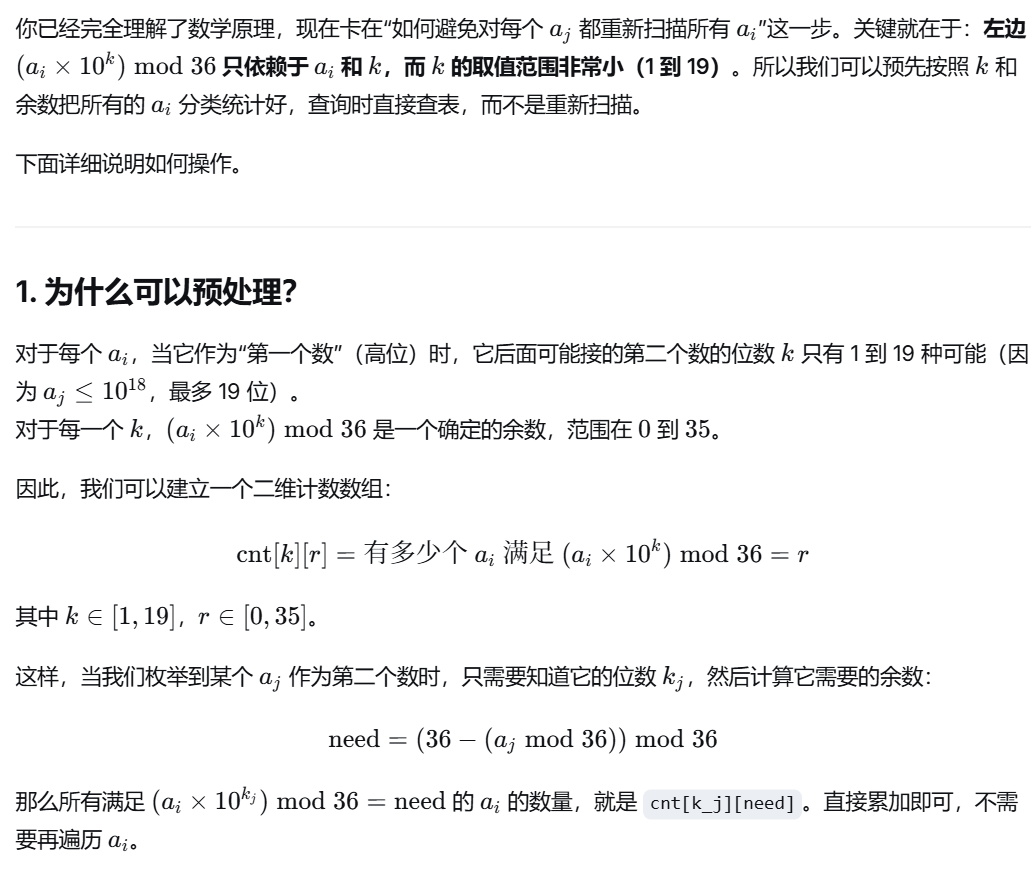
就是说左式的值是处于0-35之间的
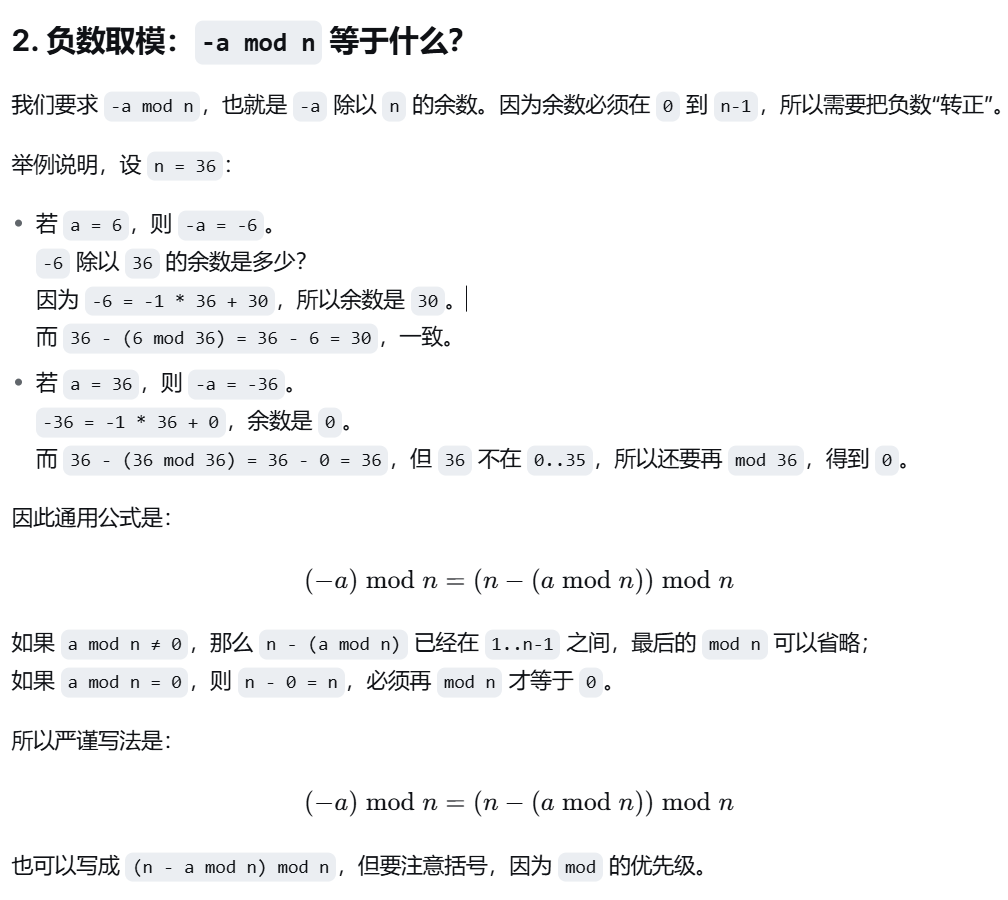
对于-ajmod36,是怎么推导出36-ajmod36的?
通用等式就是-kmodn=n-kmodn吗,是(n-k)modn还是n减去kmodn?然后对于原题,移项时的外壳mod36就一直没动
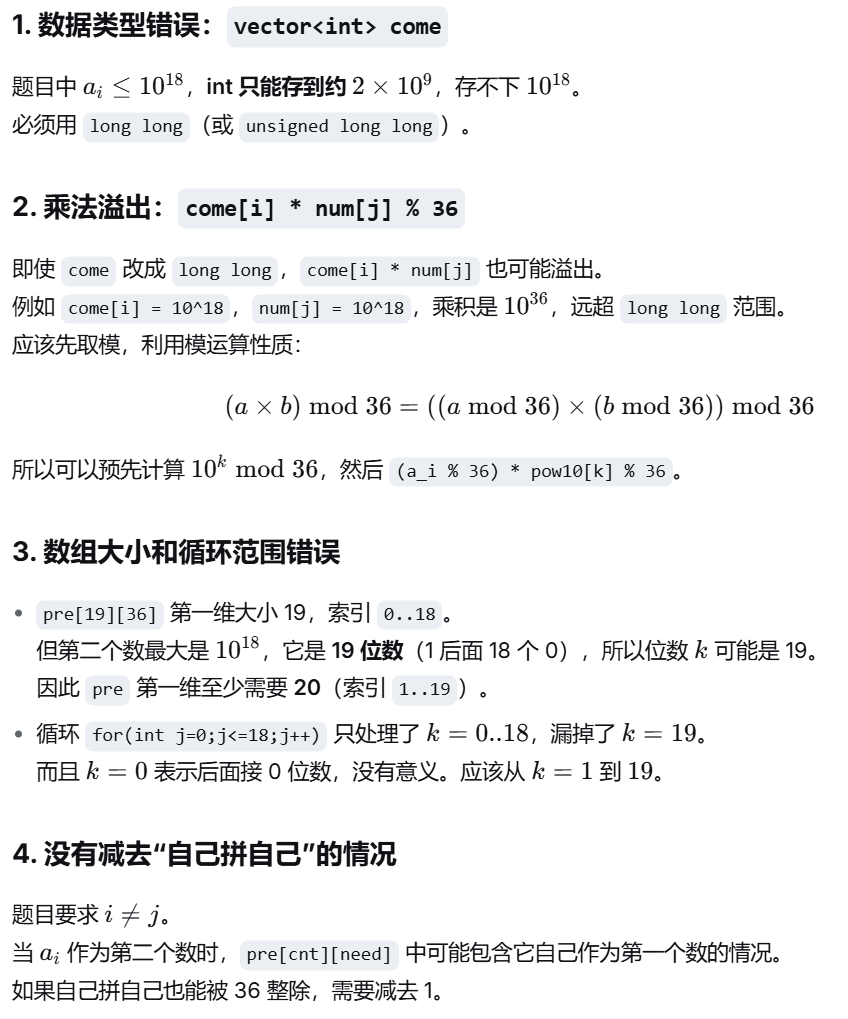
DEBUG
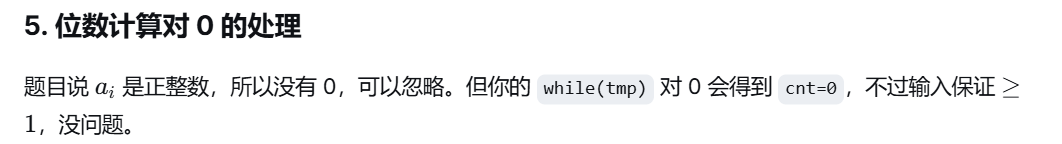
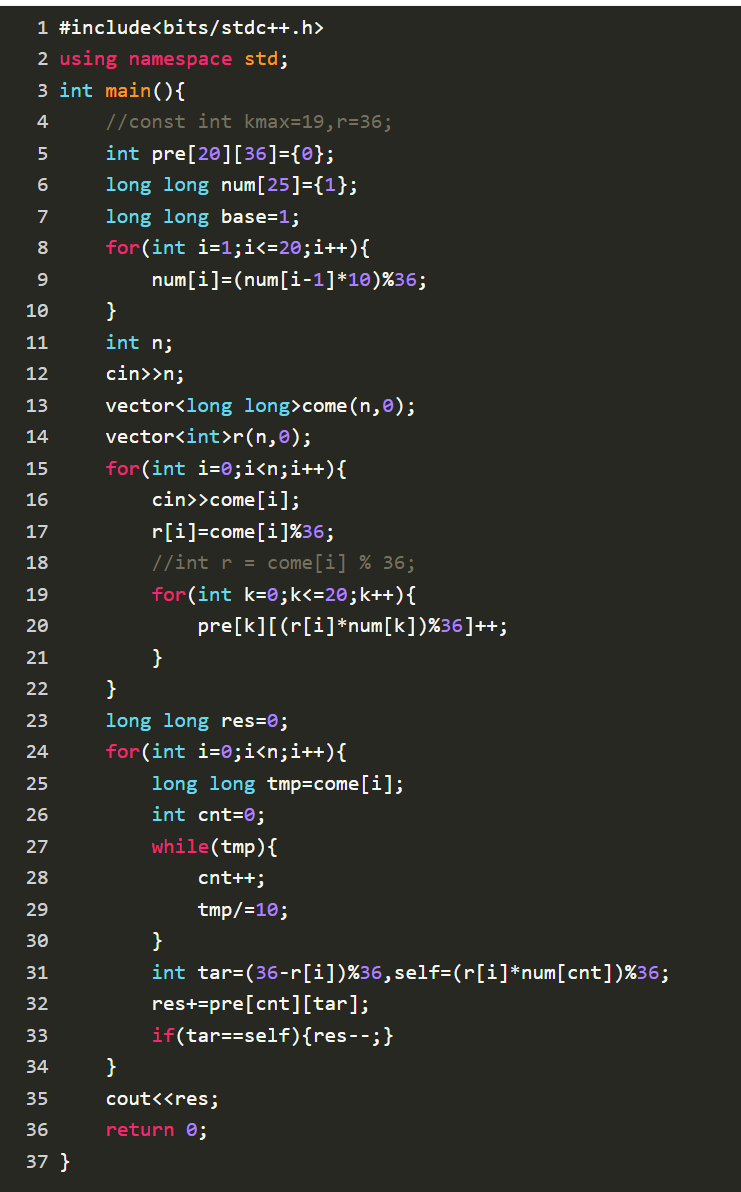
AC
AI题解
#include<bits/stdc++.h>
using namespace std;

int main(){
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n;
    cin >> n;
    vector<long long> a(n);
    for(int i = 0; i < n; i++){
        cin >> a[i];
    }

    // num[k] = 10^k mod 36
    long long num[25] = {0};
    num[0] = 1 % 36;
    for(int k = 1; k <= 20; k++){
        num[k] = (num[k-1] * 10) % 36;
    }

    // pre[k][r]: 作为第一个数,后面接 k 位数时,(a_i * 10^k) % 36 = r 的个数
    // k 的范围 1..19
    long long pre[25][36] = {0};

    for(int i = 0; i < n; i++){
        int r = a[i] % 36;
        for(int k = 1; k <= 19; k++){
            int val = (r * num[k]) % 36;
            pre[k][val]++;
        }
    }

    long long ans = 0;
    for(int i = 0; i < n; i++){
        long long x = a[i];
        int len = 0;
        long long tmp = x;
        while(tmp){
            len++;
            tmp /= 10;
        }
        // 需要的余数:(-x) mod 36
        int need = (36 - (x % 36)) % 36;

        ans += pre[len][need];

        // 减去自己拼自己的情况
        int self_val = ( (x % 36) * num[len] ) % 36;
        if(self_val == need){
            ans--;
        }
    }

    cout << ans << '\n';
    return 0;
}
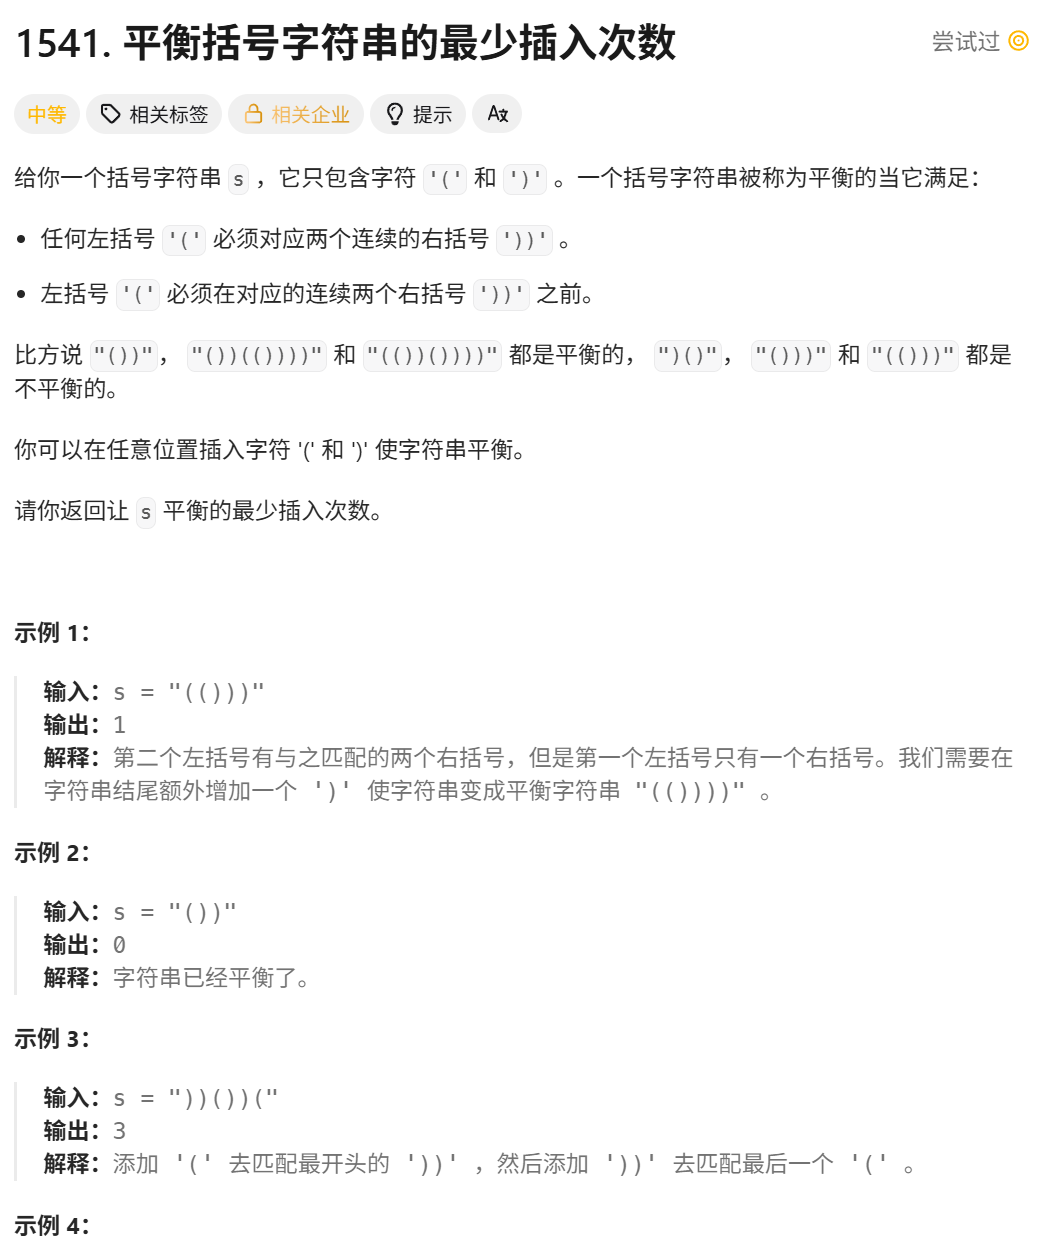
1541
错误自解
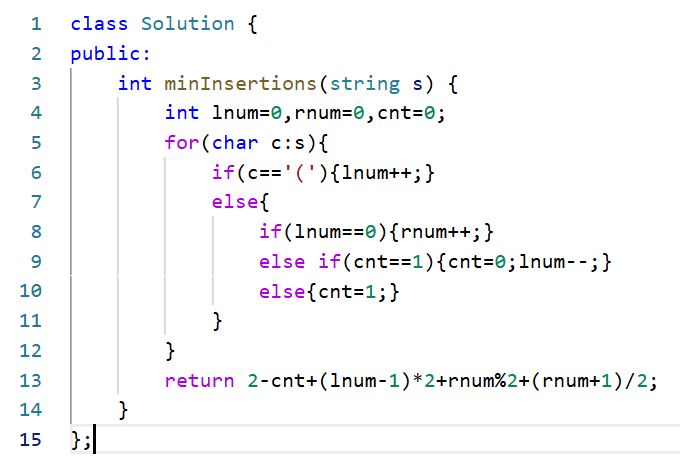
当遇到左括号时,lnum++
遇到右括号时,检测左侧是否有左括号,即lnum是否为0
如果为0,那么cnt1++
如果不为0,则cnt2++
当cnt2为2时,cnt2归0,并让lnum--
最后检测lnum和cnt1,cnt2数量
若存在cnt2,则cnt2必为1,那么对于lnum,也必然有一个不匹配
所以左括号的计算是(lnum-1)*2
然后cnt2是2-cnt2
对于cnt1,若为奇数,则要补1个右括号
若为偶数,则只需补左括号
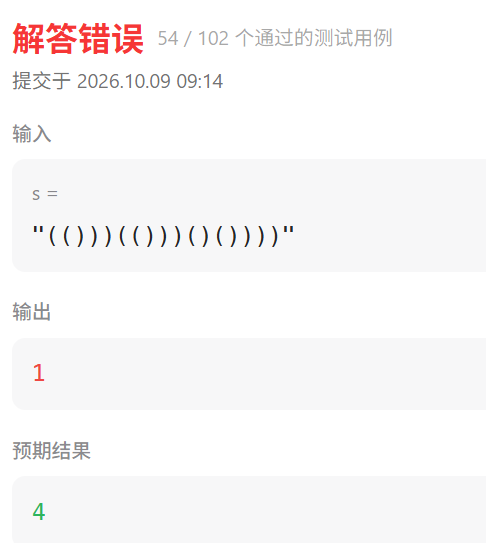
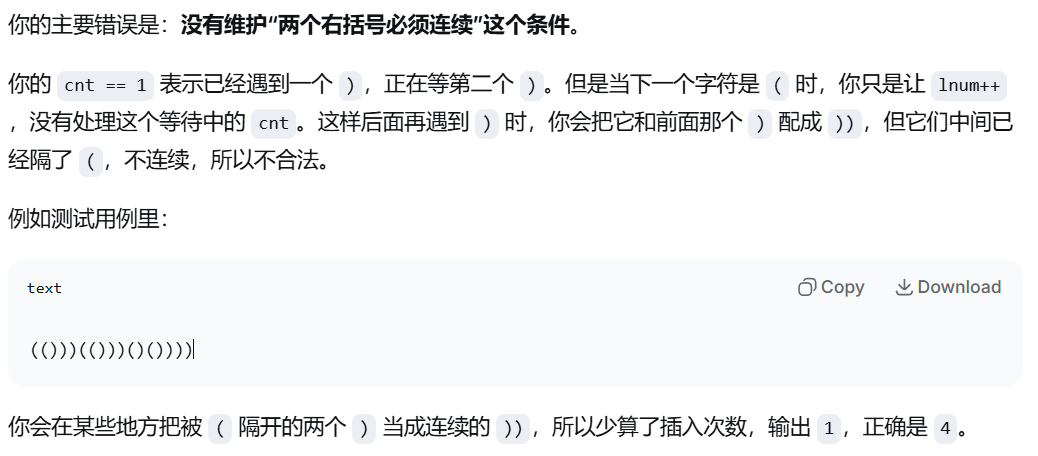
错误原因
错解2.0
如果要考虑两个右括号必须连续,
遇到左括号,依然lnum++,看cnt是否为0,若为0则无事,否则说明前一个是右括号,先使cnt=0,并且res+2
遇到右括号,看cnt是否为0,若为0,则说明自己是开始
若不为0,则看是否有lnum,若有,则使lnum--,否则res++,并且使cnt=0
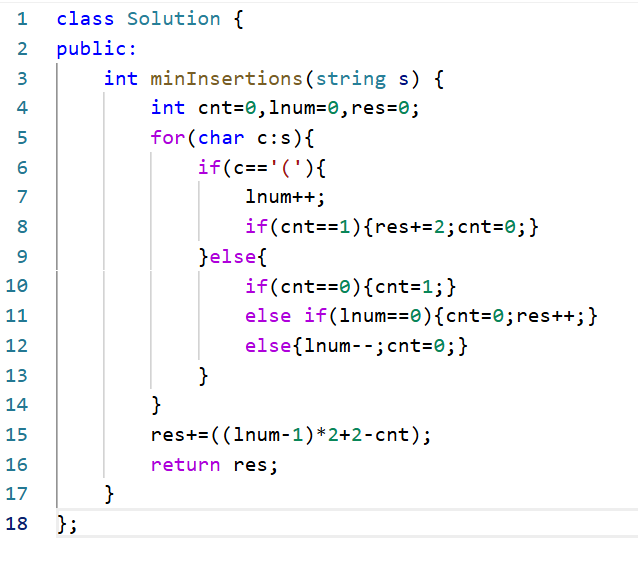
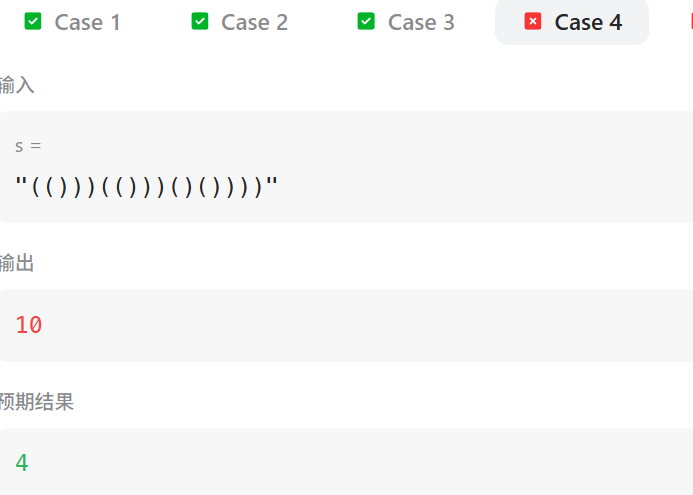
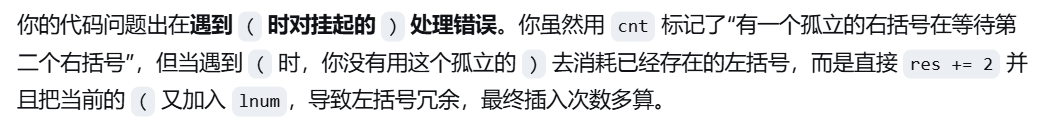
就是说在cnt不为0时,说明前面一定是有一个右括号的
原来的想法是只针对这一个未匹配的右括号去加字符,那就是加一个左和一个右
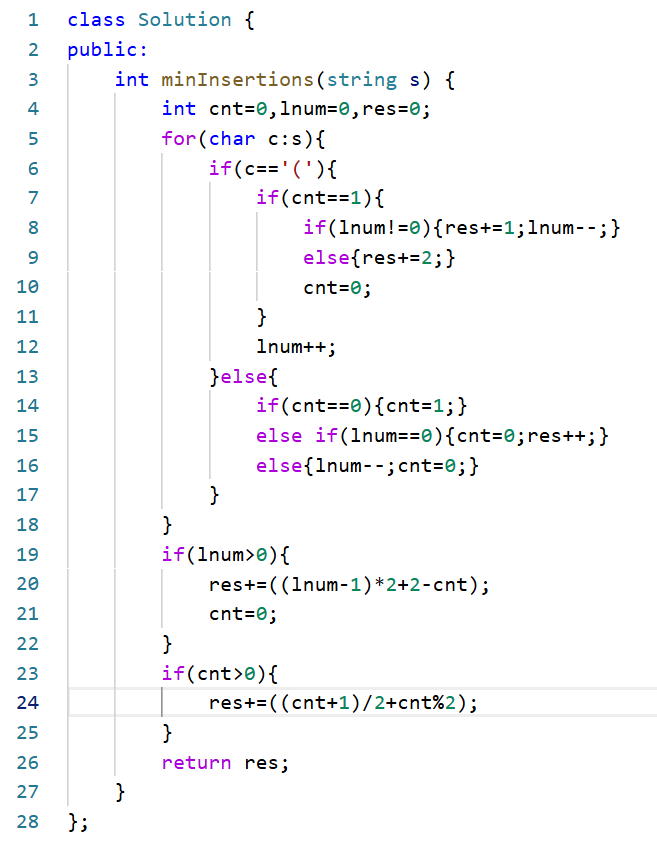
但前面还可能存在一个左括号,而题目问的是最少,所以可以直加一个右括号,同时还能消除一个左括号
改后
AI清晰逻辑
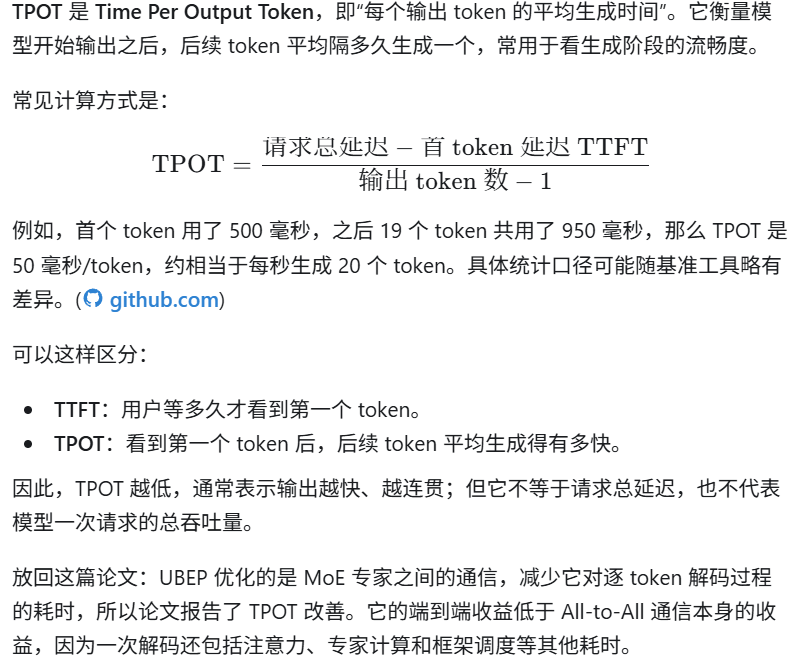
TPOT
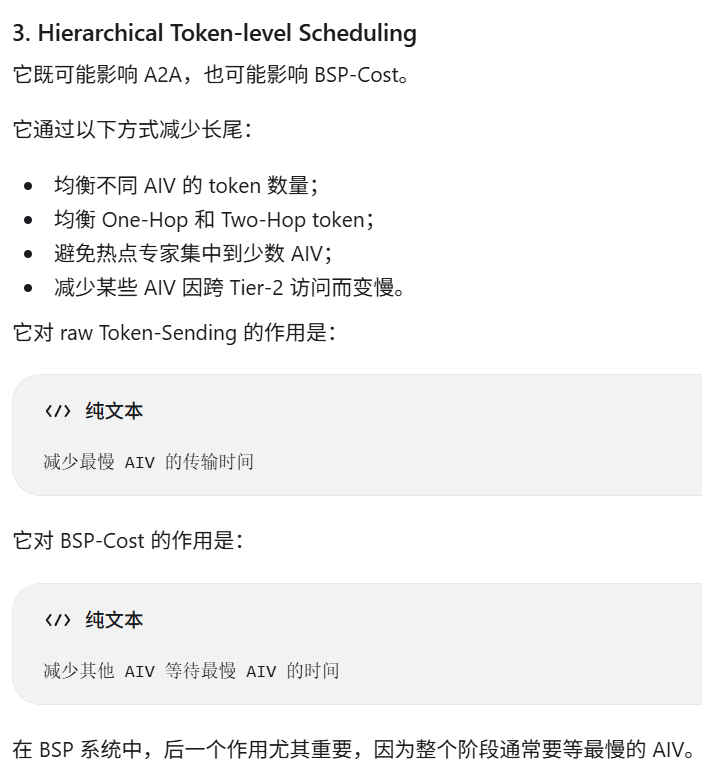
分层token调度
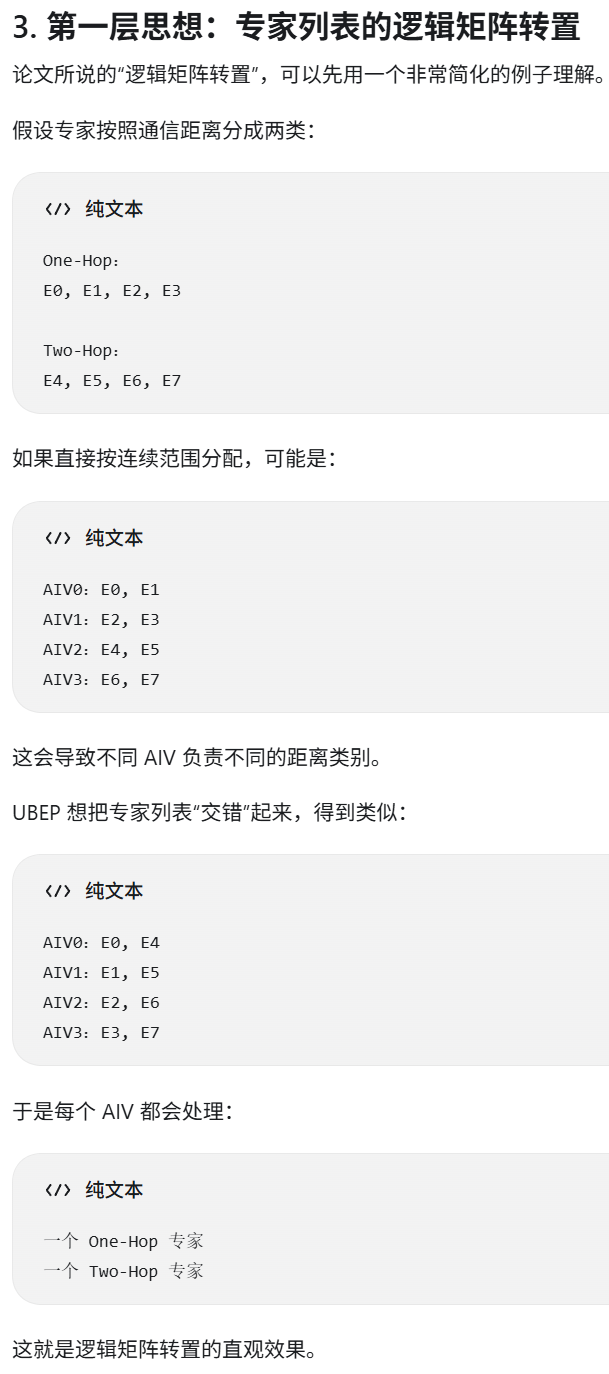
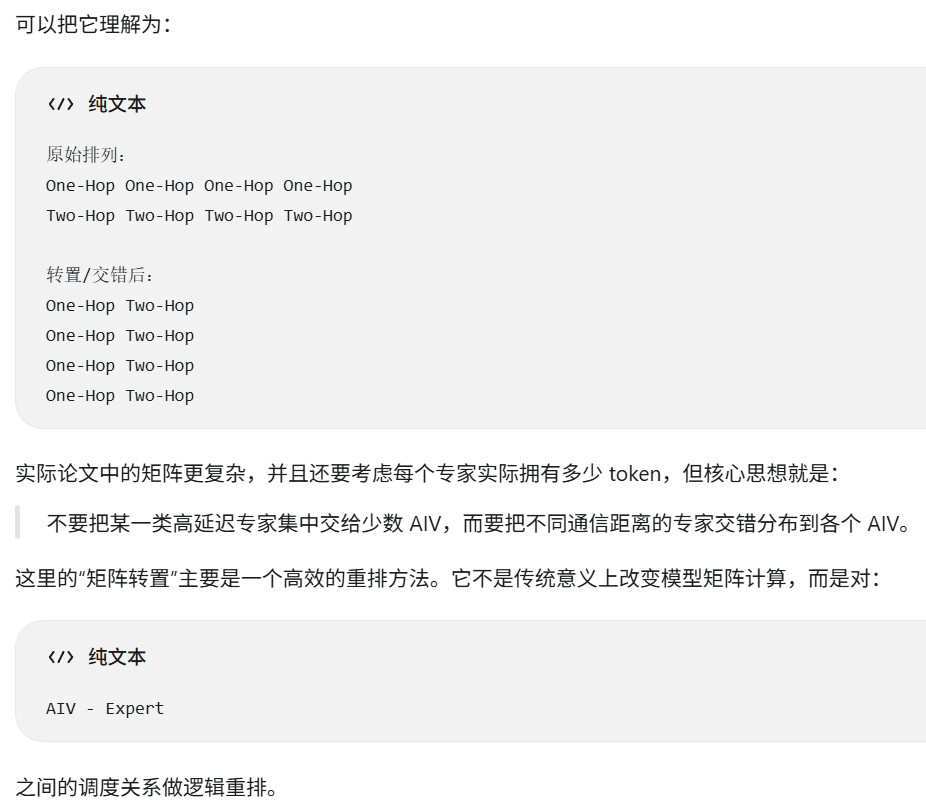
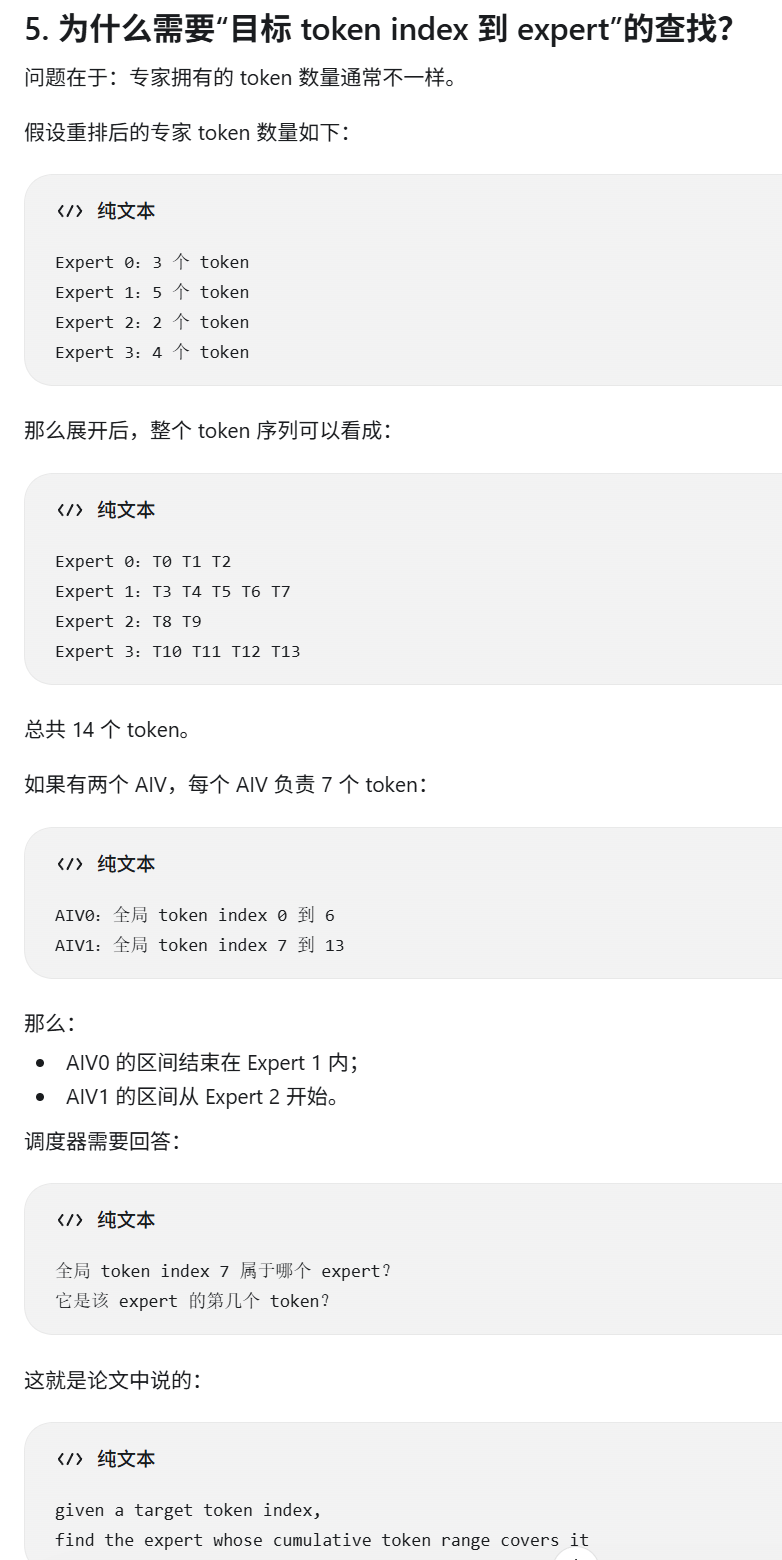
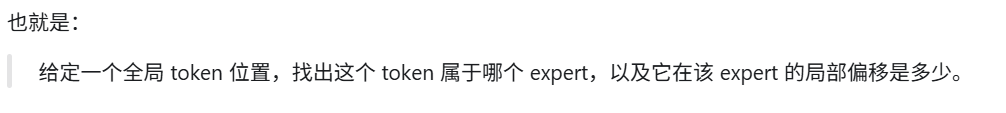
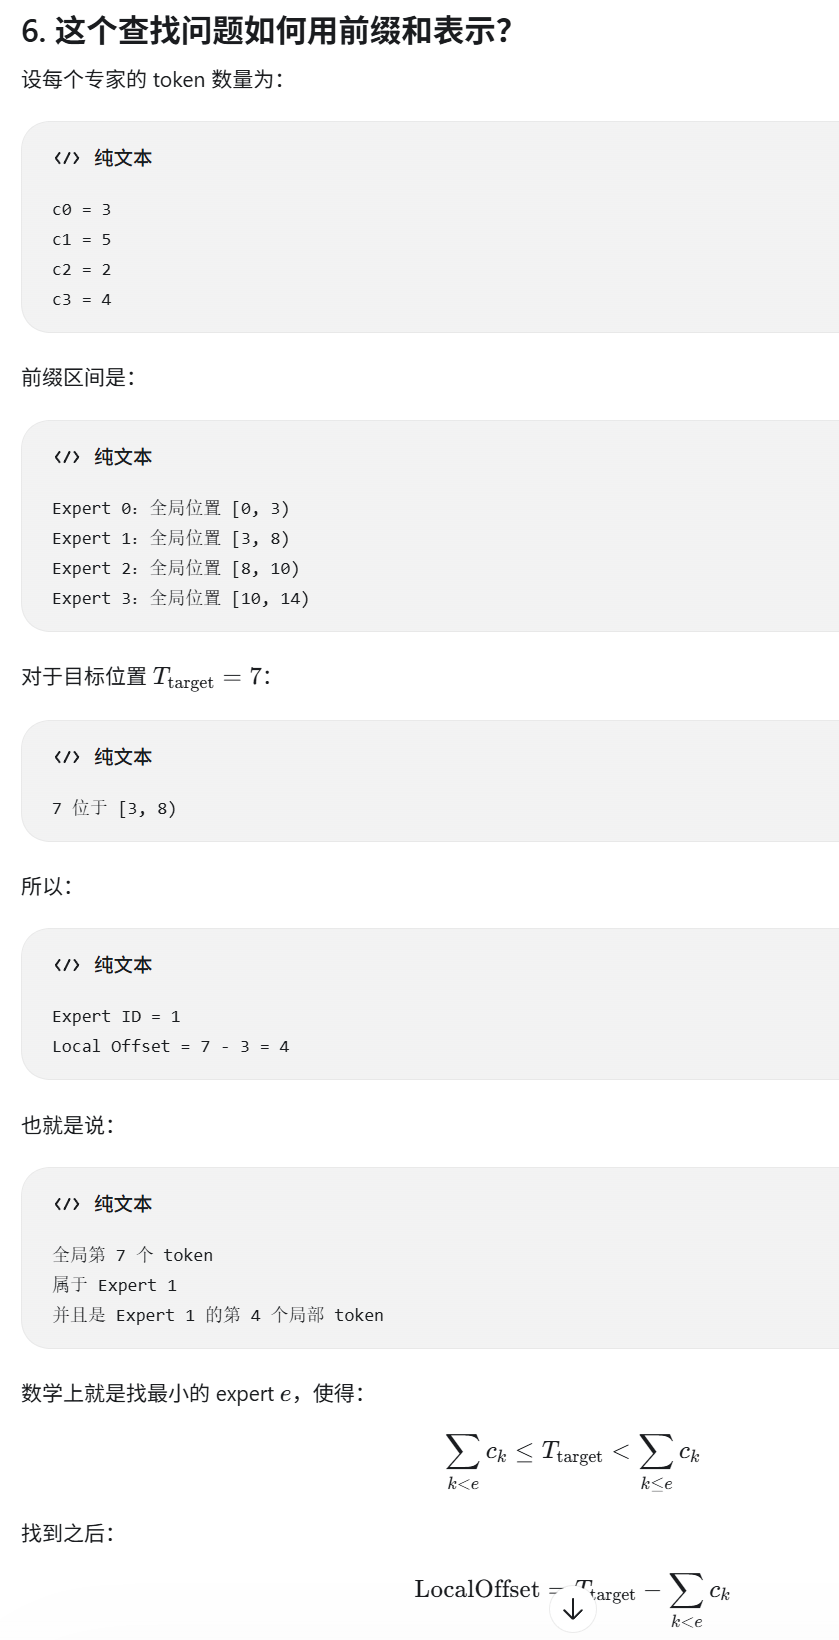
专家和AIV之间的关系是什么?分层Token不是该让AIV发给对应的专家吗?什么叫重排后的专家token数量,重排是什么重排
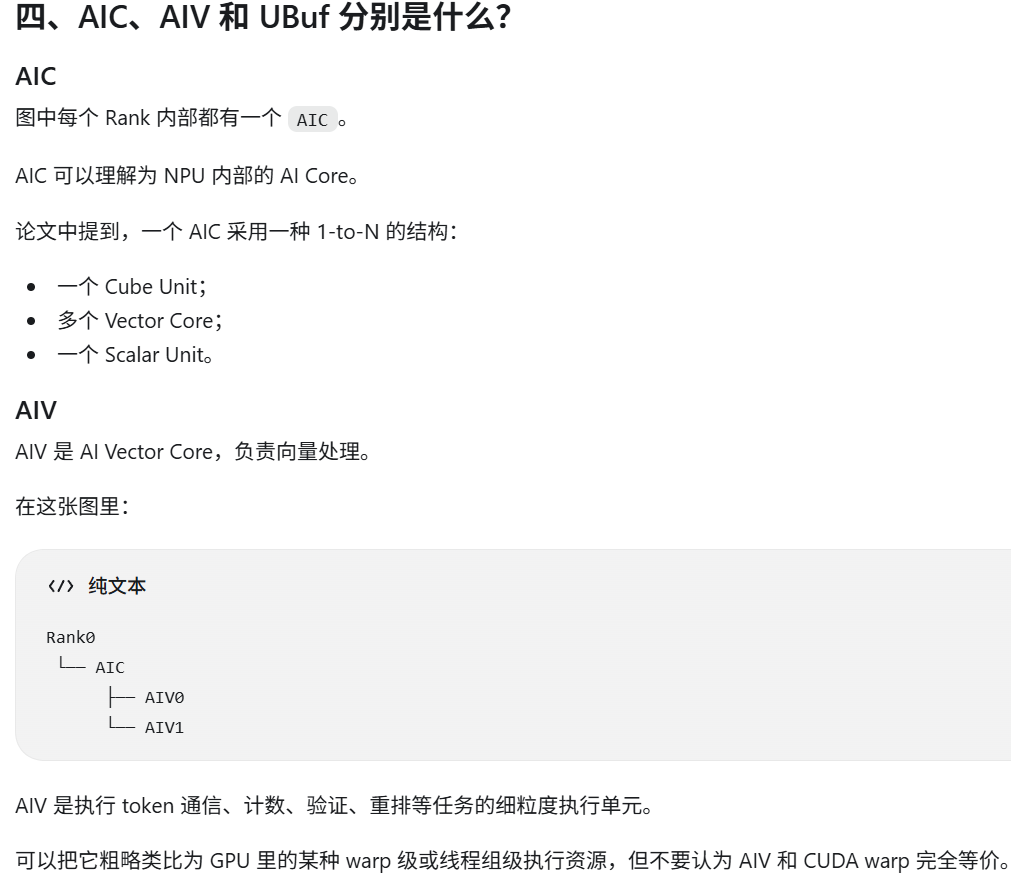
AIC/AIV/UBuf
MOE通信过程
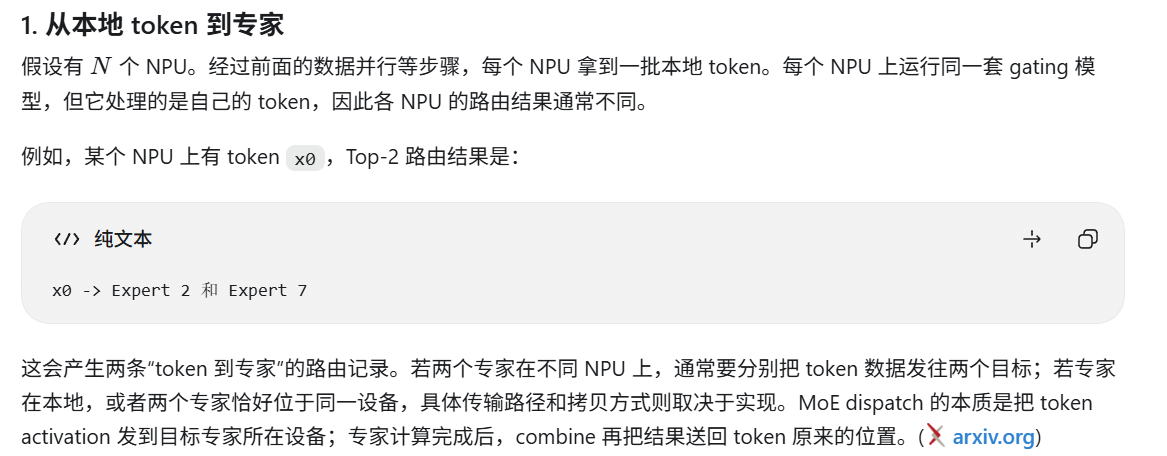
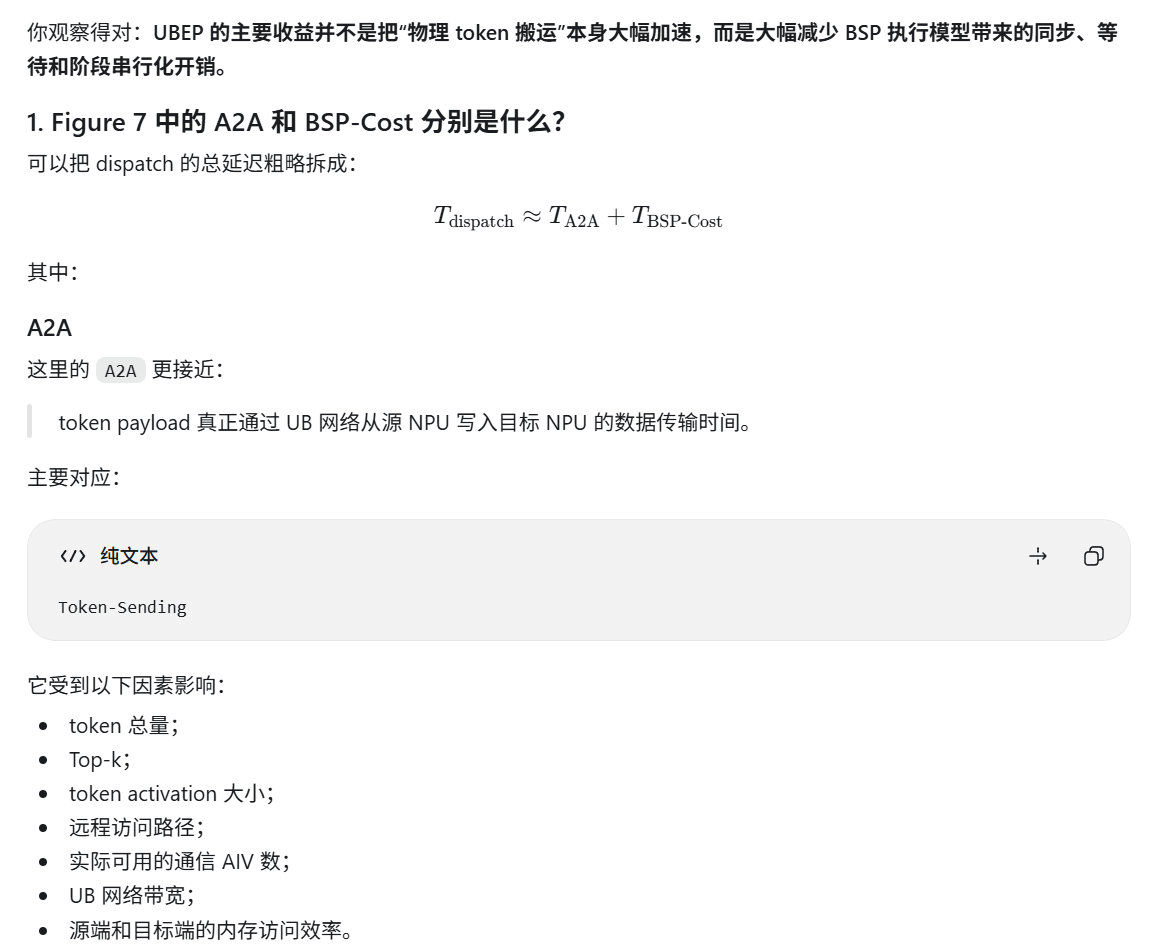
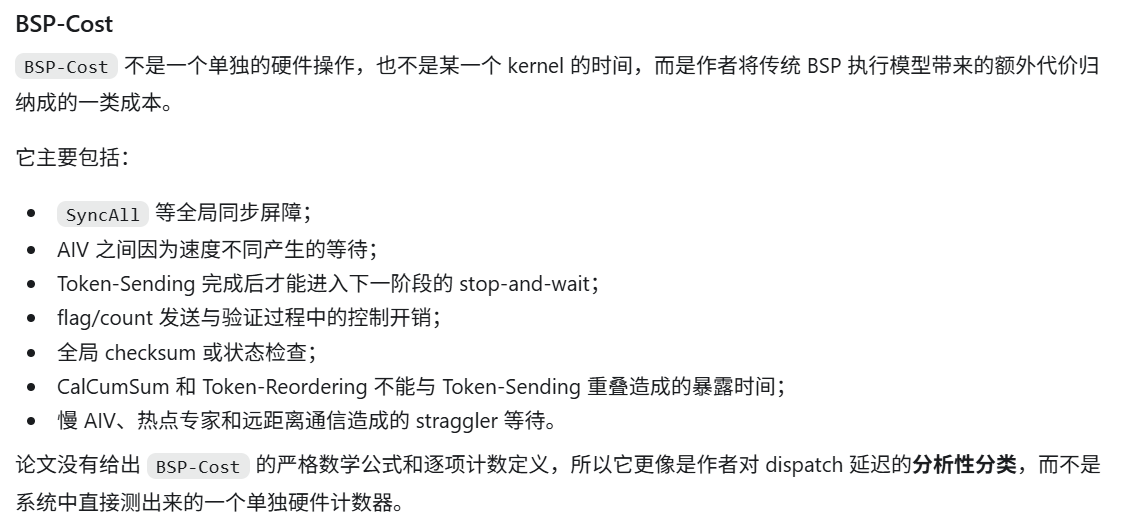
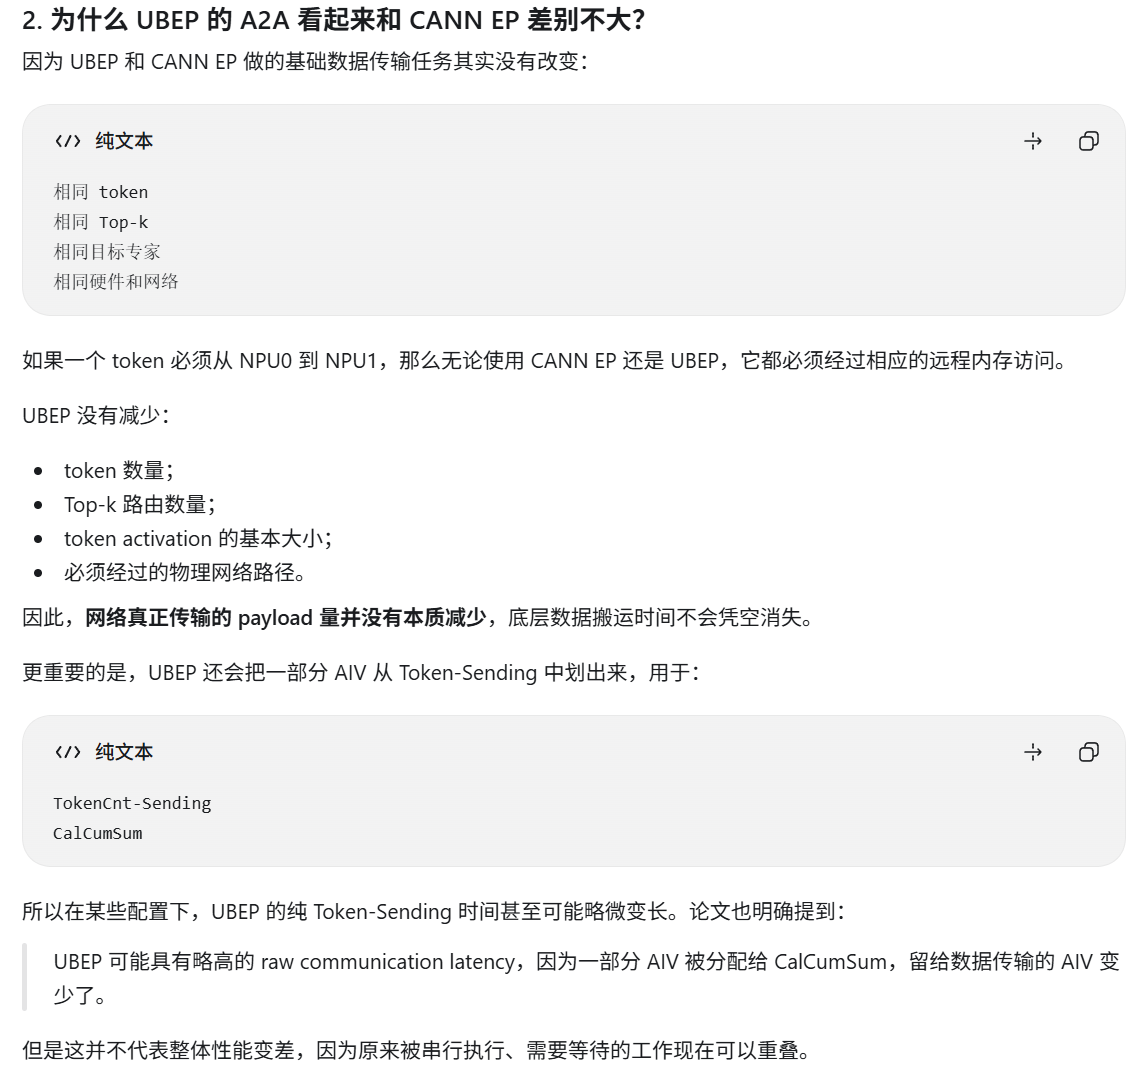
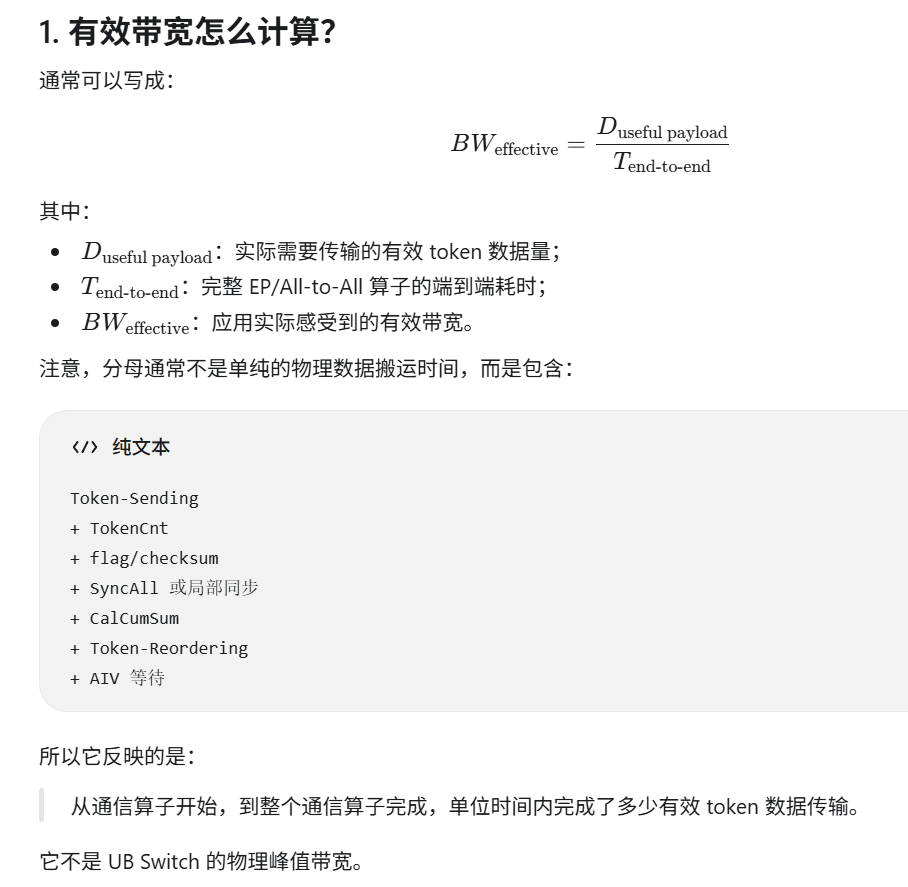
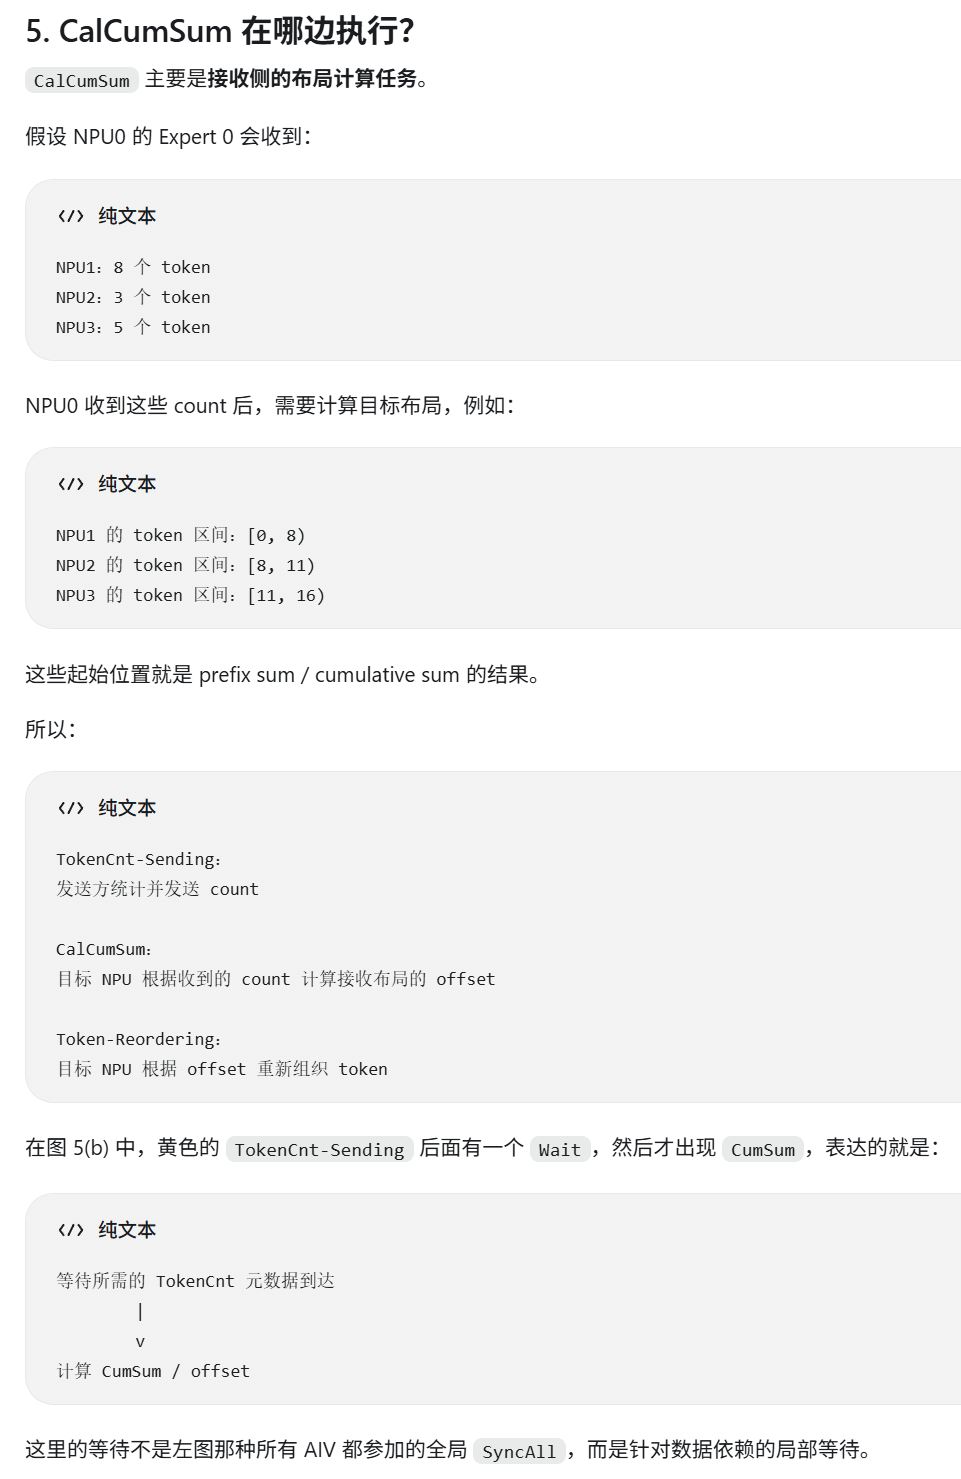
就是说从客户端接收到的M个token,现在通过某些机制将其分配给了N个NPU(假设每个NPU上都有2个专家,以及4个AIV),然后每个NPU上都有相同的一套门控路由机制,然后就并行地处理这些分配给自己的M/N个token,经过路由知道要发给哪个设备上的哪个专家,假设是top2,那就是store两次;Token-Sending在发送方,时间是路由计算和数据发送等,CalCumSum是什么?
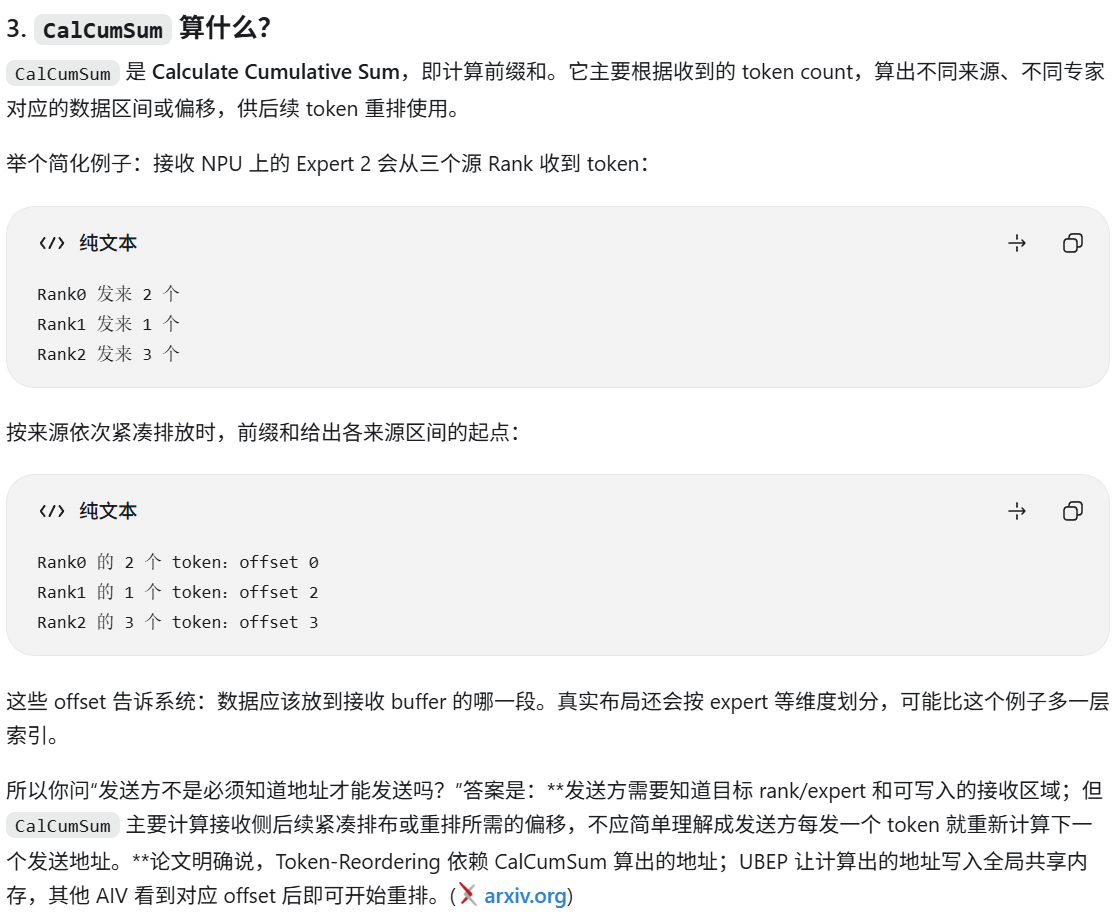
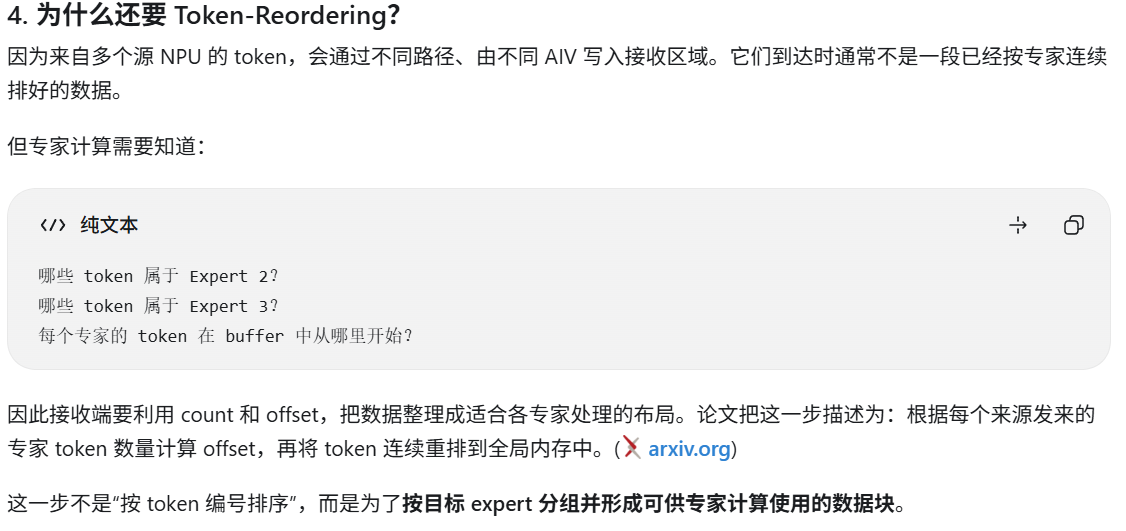
每个设备也要接受N-1个其它设备的,发给自己两个专家的token,这是moe上的all-to-all过程,等接收完后进行token-reordering,不过为什么要?以及排序时,是按全局的顺序排的吗?这个排序是发生在专家上,还是设备上?比如专家2,3在NPU1上,然后专家2收到6,4,2,专家3收到3,7,5,排序是统一排成2,3,4,5,6,7,还是每个专家各自排成2,4,6和3,5,7?
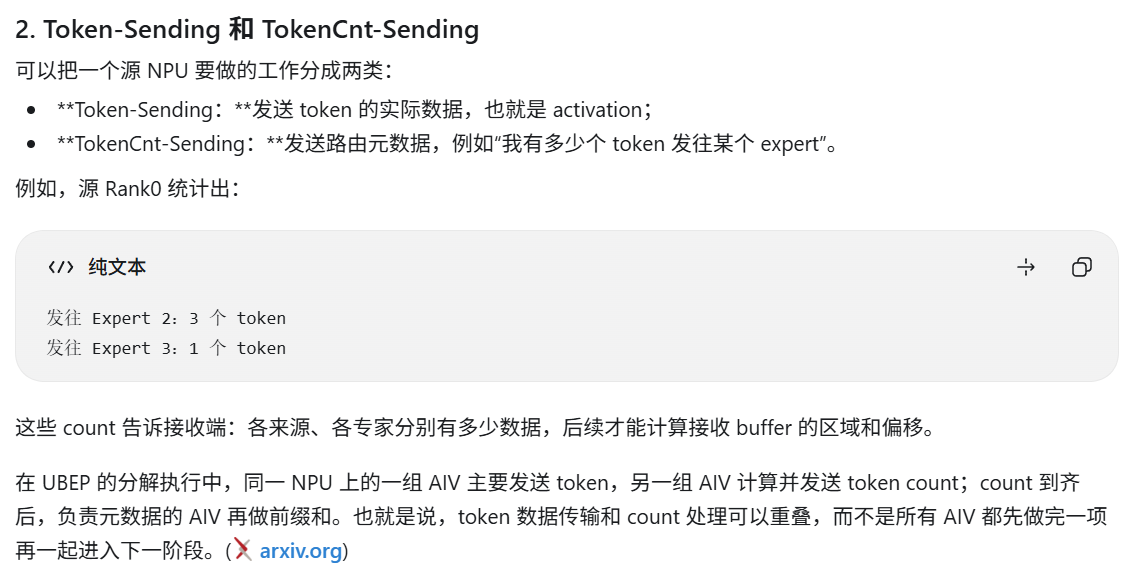
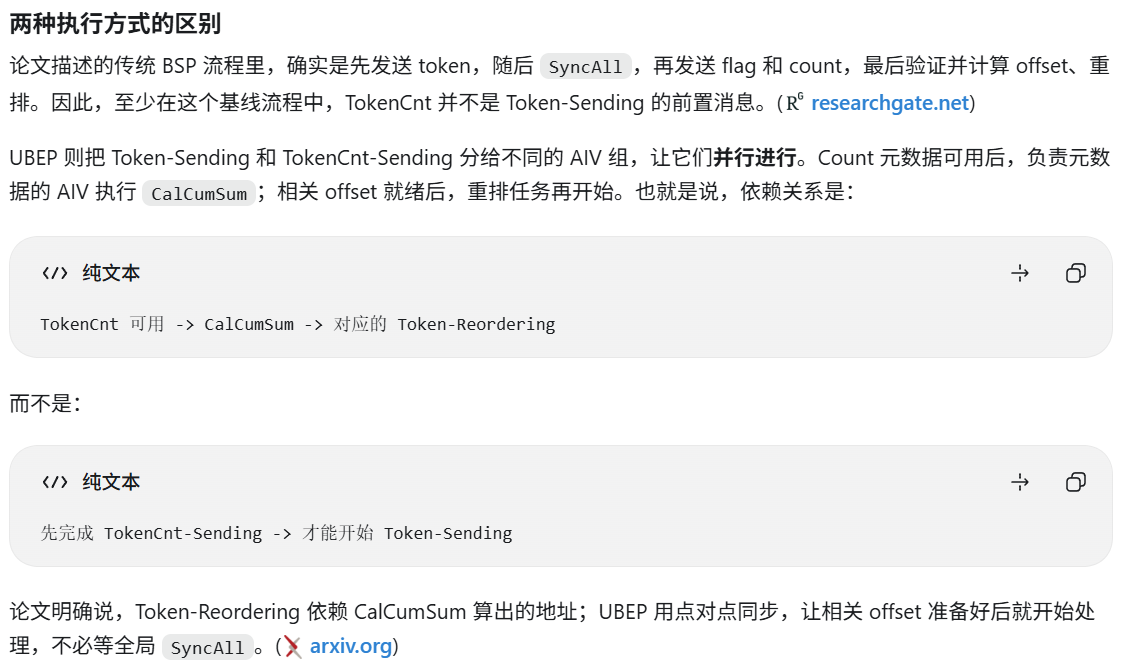
就是说接收方要接收发送的token,必须要等发送方发来tokenCnt-sending吗,或者说,必须发送方先发送TokenCnt-sending,然后才能发送Token-sending吧,否则接收方不知道该如何接收吧
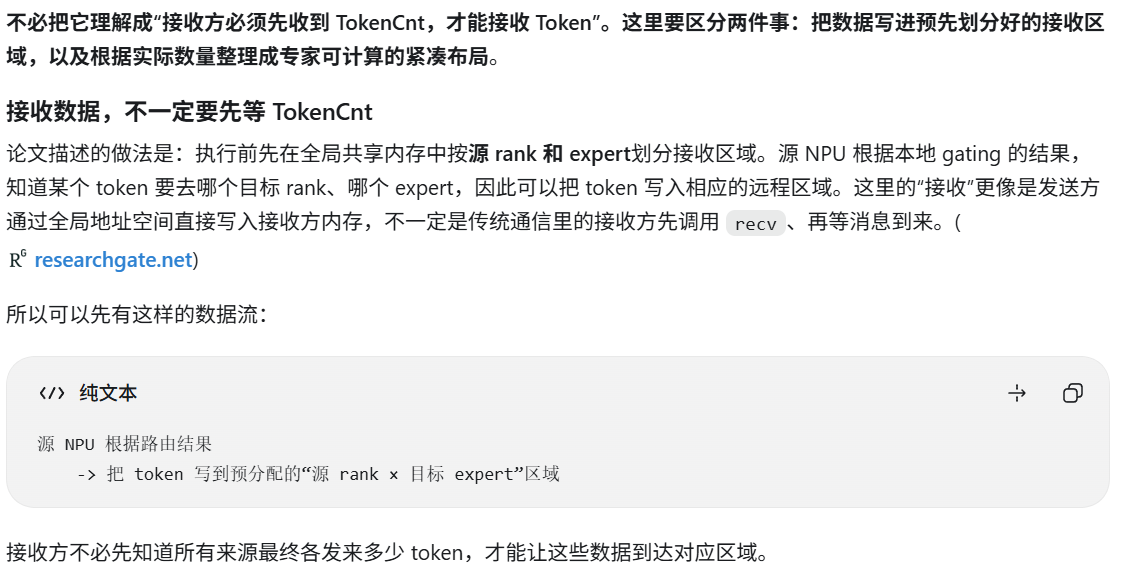
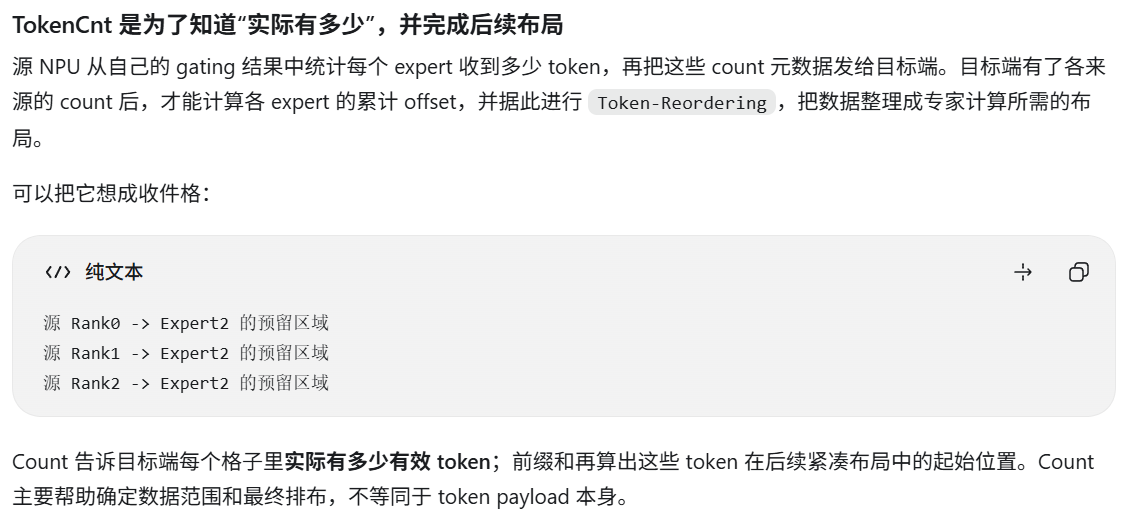
就是说NPU0会为N个NPU分配足量的接收缓存区,就是说是从NPU1来的给专家0,专家1,从NPU2来的给专家0,专家1.....然后在dispatch时,其余NPU就会往其对应的缓存区上写Token,而且要保证写入token的数量不会超过预留缓存区的大小,然后NPU0就检查那些缓存区,轮询检查?然后去确定每个token是否写入了?等到NPUi发来tokenCnt的时候,是说明对应一批(即来自NPUi的发给专家0)的token写完了,然后就可以排序了吗
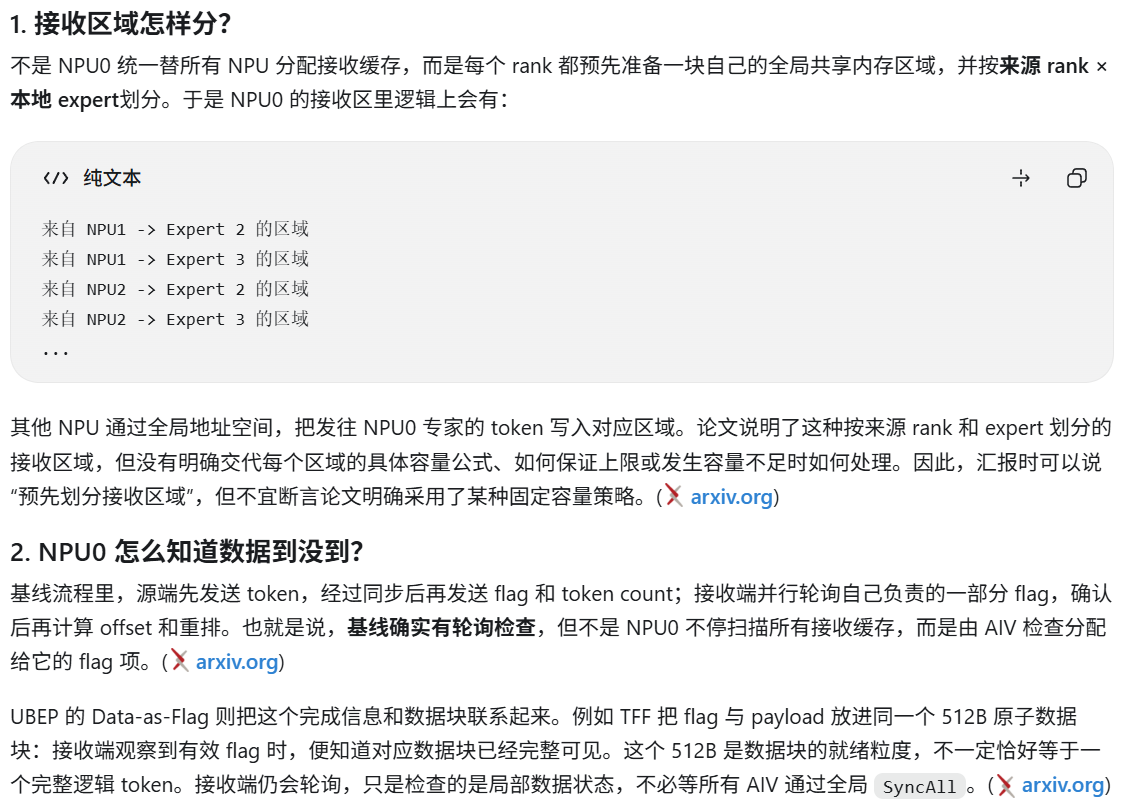
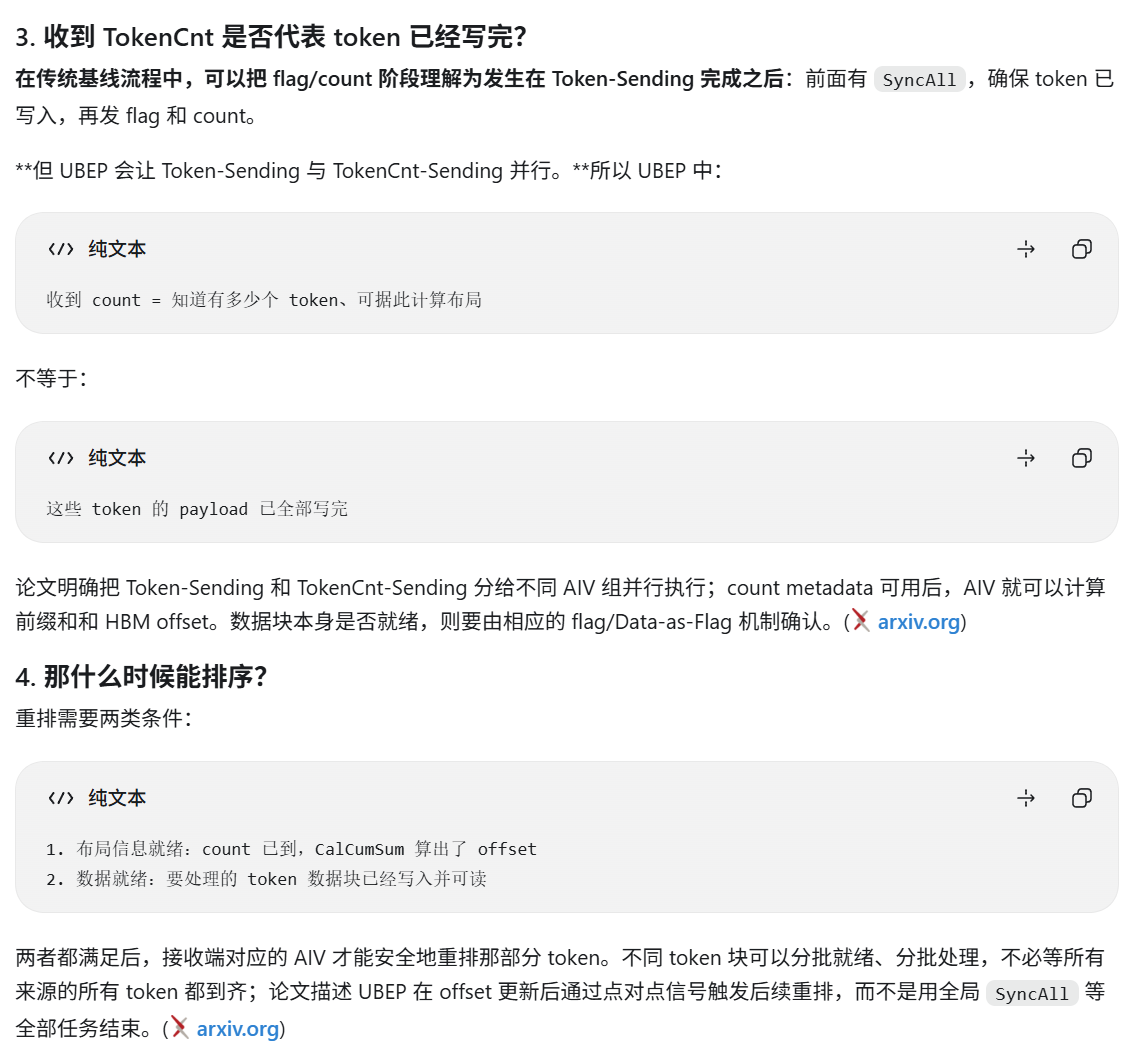
那假设NPU0为来自每个NPU发给自己专家0的缓冲区分配了10个slot,然后NPU1要发8个Token,npu2要发3个token,然后在t0时刻,npu通过不断轮询检查,知道此刻npu1发来了6个token,以及cnt是8,npu2发来了3个token,以及cnt是3,那接下来就是可以对npu2发来的token排序了吗?怎么排?在原缓存区吗还是拷贝到一块新区域?
NPU1 怎么知道 token 写完了?
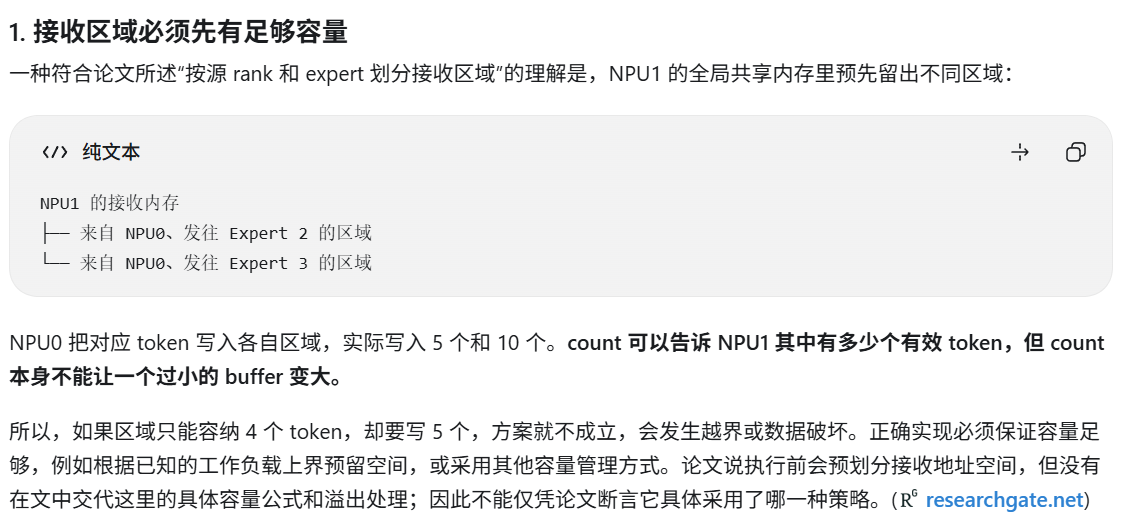
还是没太理解,假设NPU0要向NPU1的专家2上发送5个Token,专家3上要发10个token,NPU1不知道NPU0要发多少个Token,NPU0往NPU1的专家2的预留区域上写5个Token,那预留区域该有多大呢?如果比5小呢?以及NPU1怎么知道NPU0已经成功写入了呢?轮询检查吗?
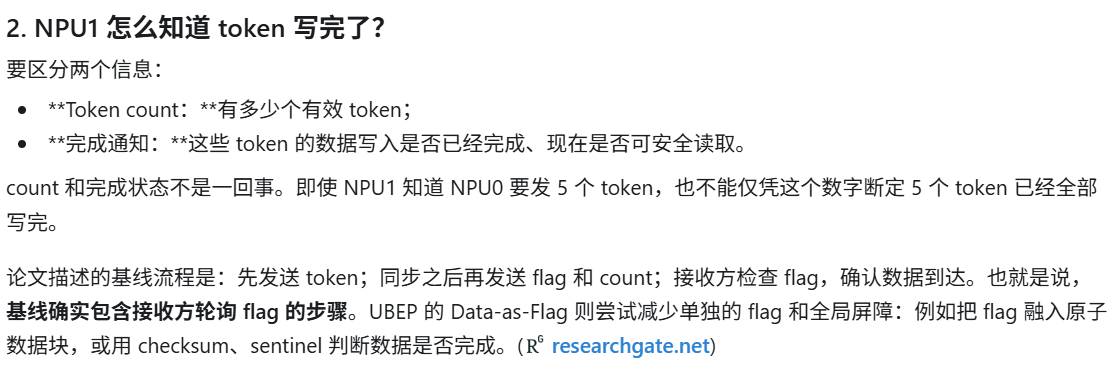
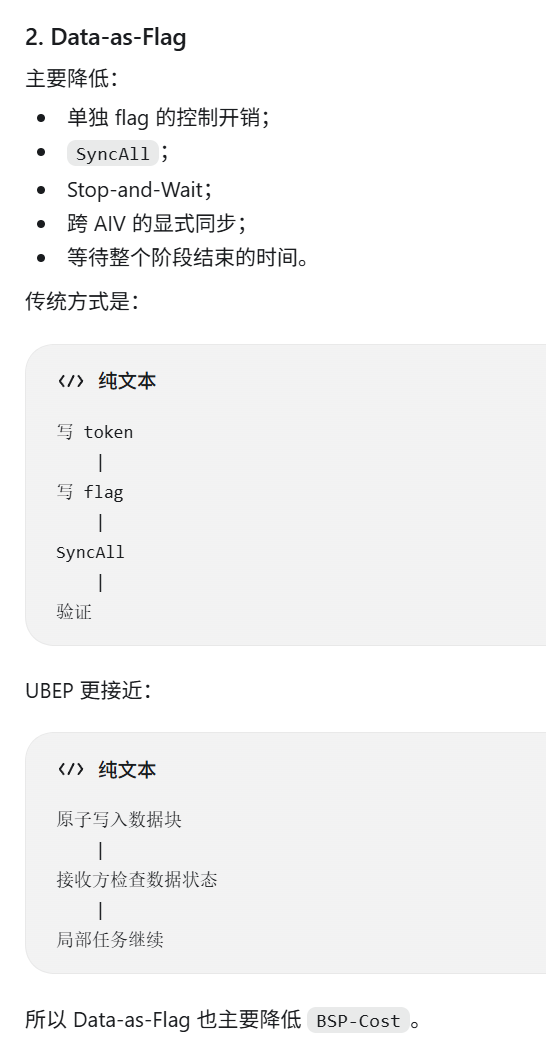
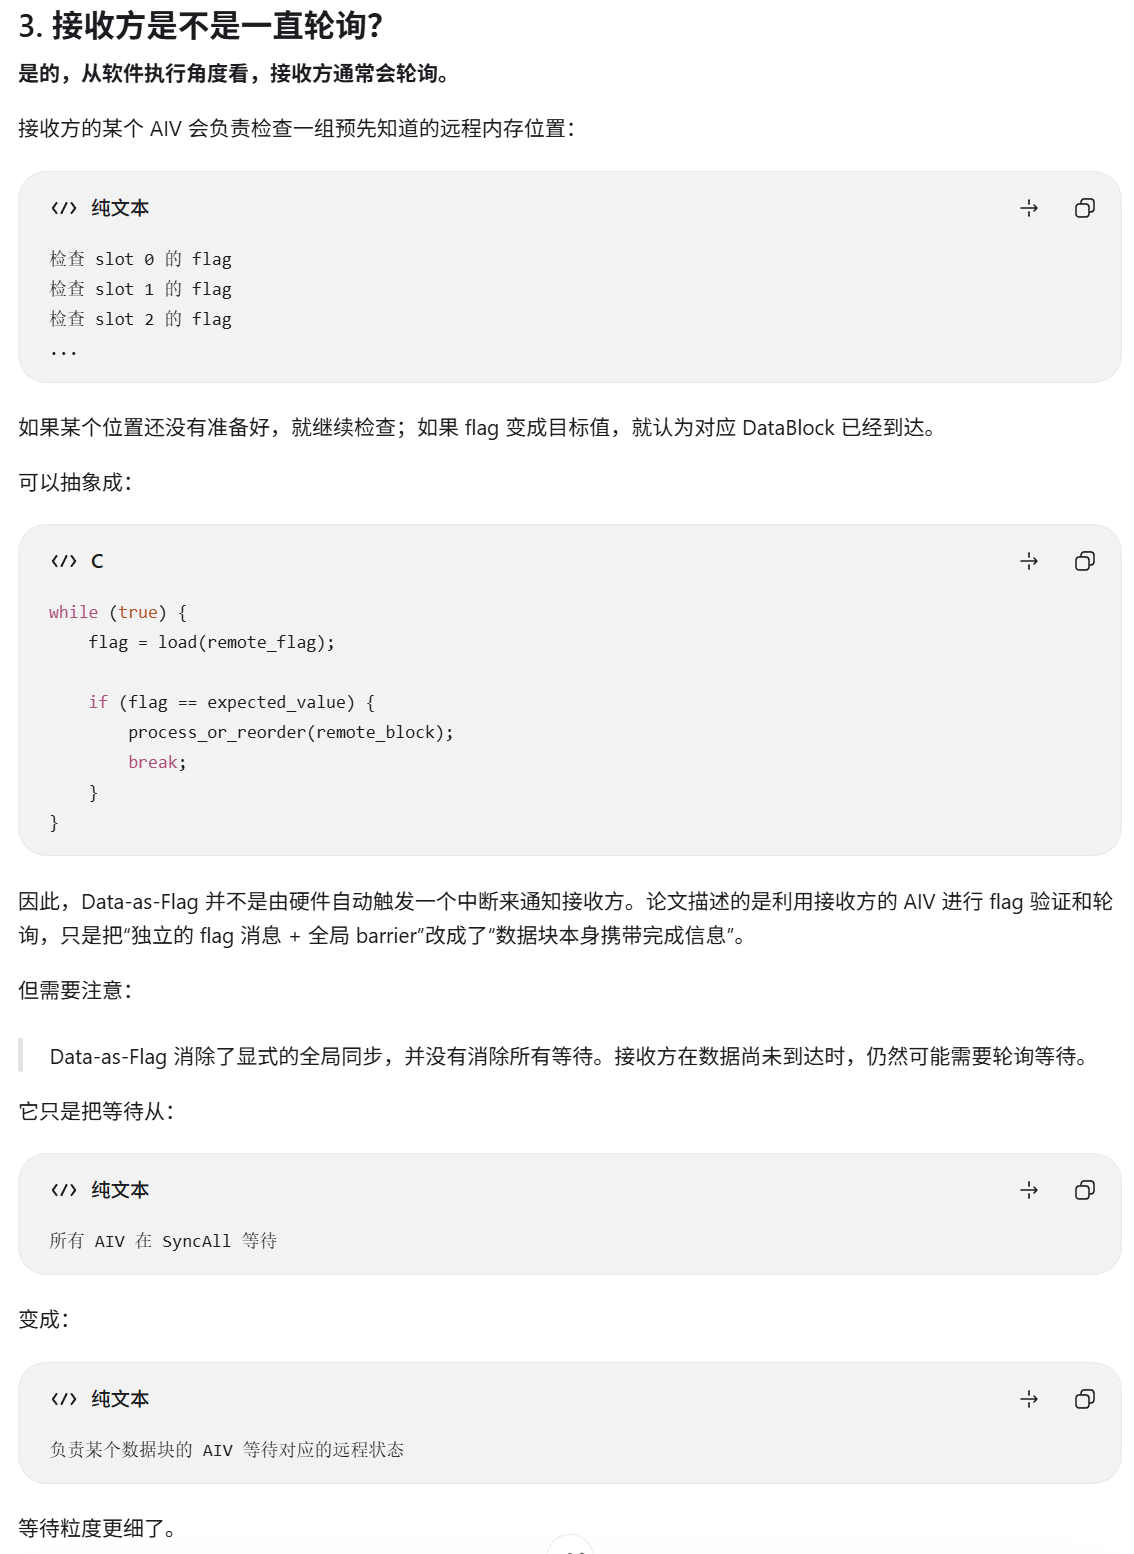
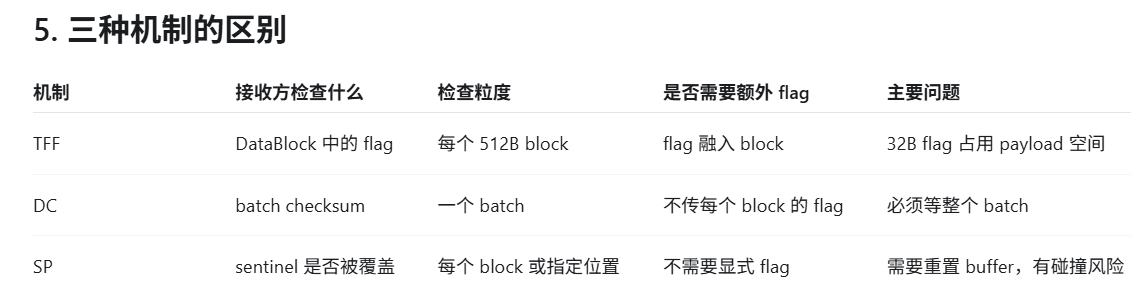
对于UBEP,它的data-as-flag是检查一个token是否传输完毕的,是512B的数据块,那就是一个512B来了之后就直接处理吗?而且是怎么检查的?就是现在发送方在写入,那接收方什么时候检查呢,发送方就只发数据,也不通知接收方何时检查,那接收方就一直轮询检查,直到标记被覆写吗
Token-Reordering
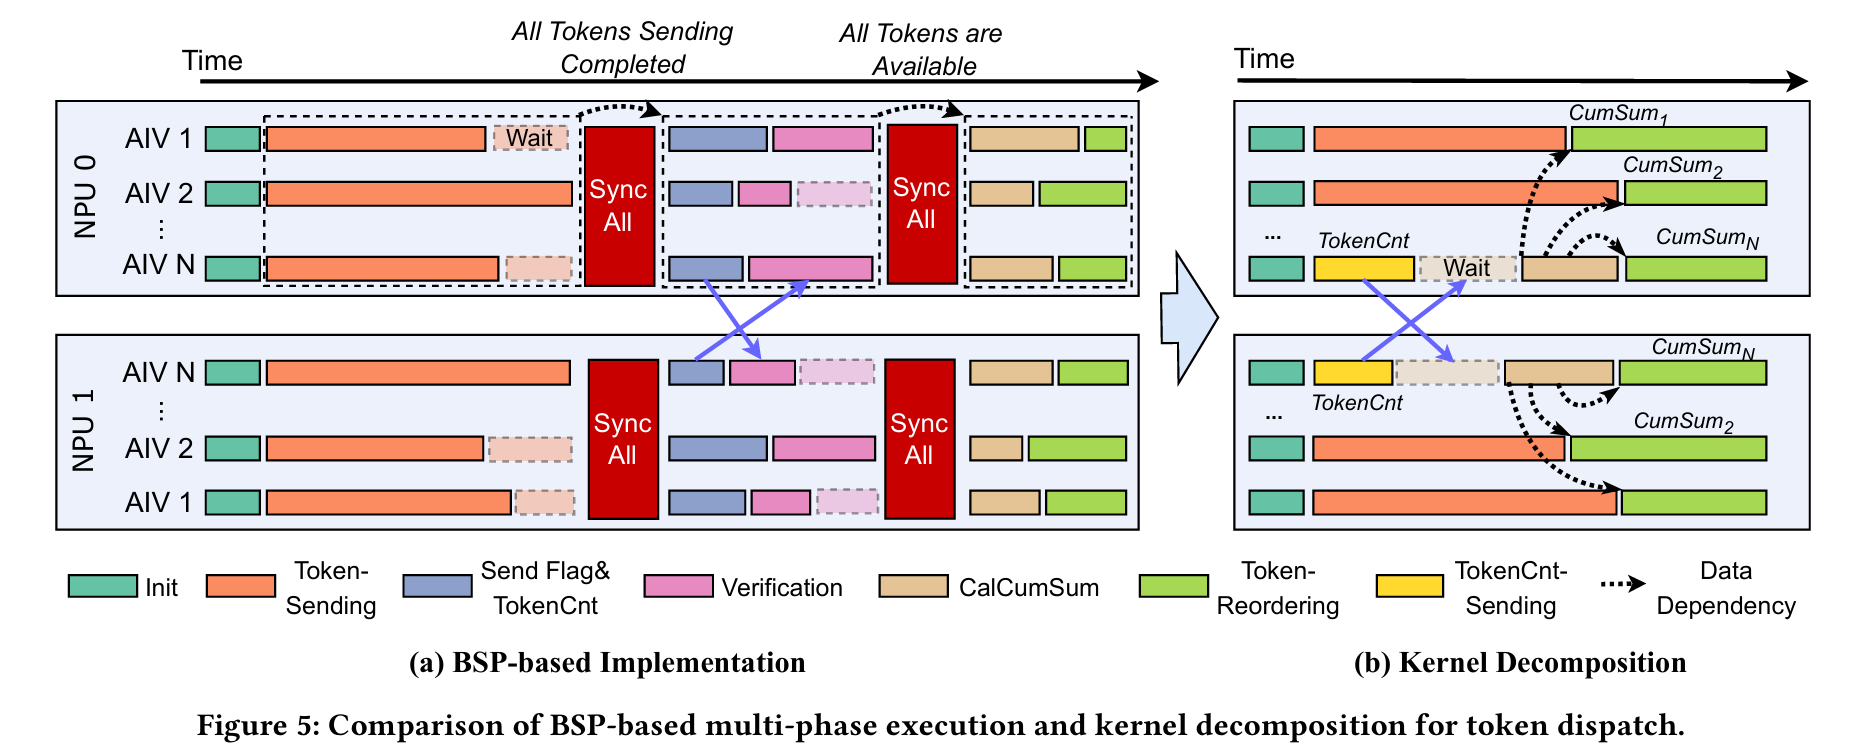
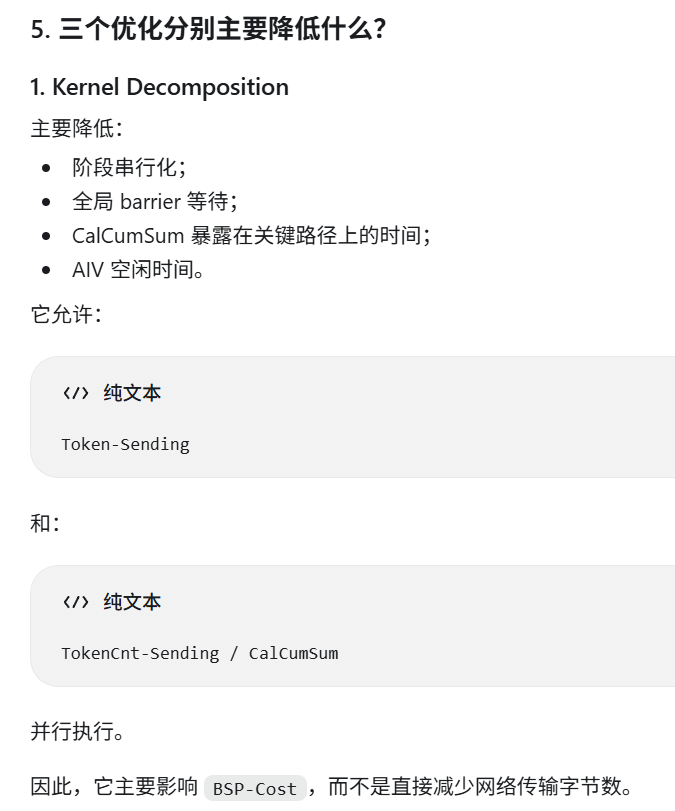
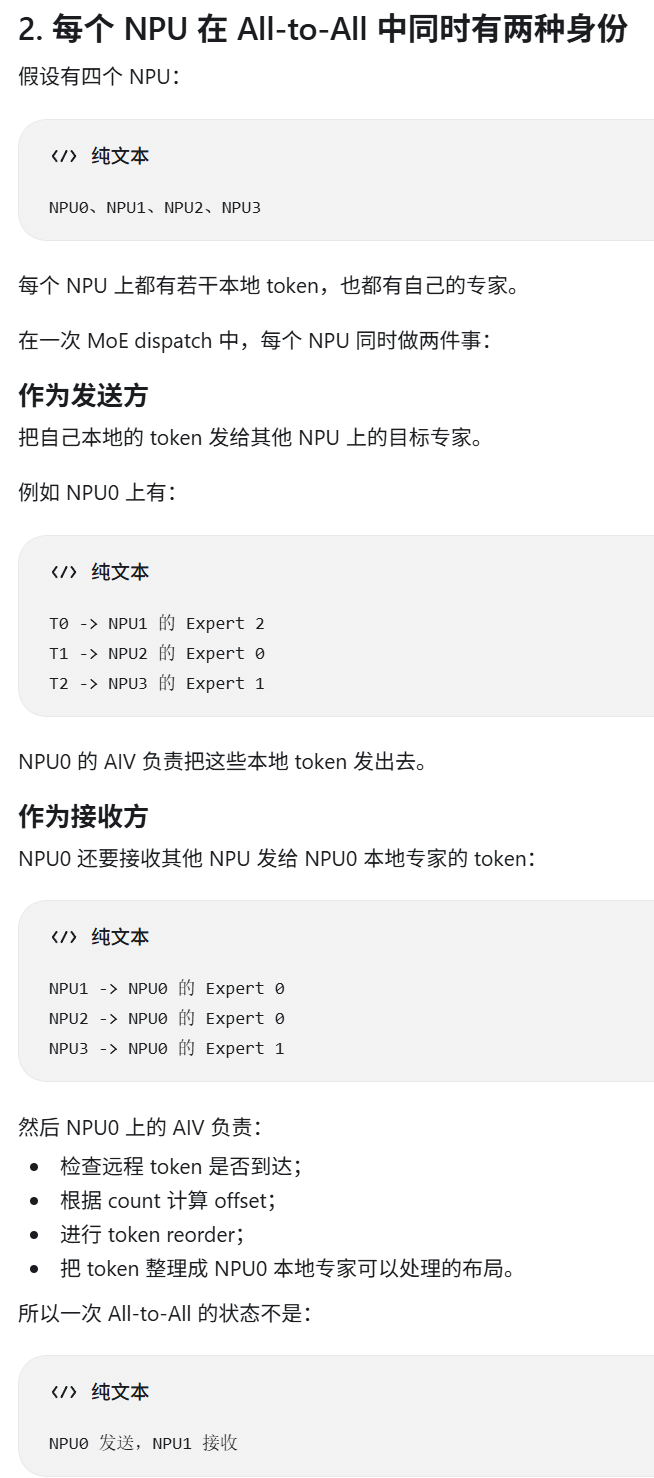
对于这个图,又或者论文的机制,是每个AIV都负责一个NPU发来的token吗,不然怎么能并行地排序?即AIV0可能负责NPU1发给专家0的token,然后专门负责给它排序?以及token-sending不是发生在发送方,token重排发生在接收方吗,这两个任务能让一个AIV来执行吗?还是说每个NPU在all-to-all当中既是发送方又是接收方,然后token-sending和tokencnt是自己作为发送方的任务,然后calCumSum就是等待其它NPU的tokenCnt都发送完毕后,自己接收后做的接收方任务,之后再做重排的接收方任务?
所以这样内核分解,就是说对于dispatch,all-to-all的过程当中,原本的BSP是将每个NPU作为发送方和接收方的任务串行执行,即必须先做完自己作为发送方的任务,等都统一完成后,再统一执行自己作为接收方的任务;然后现在就是说可以同时进行,最后执行作为接收方的最后的一个任务,即token重排
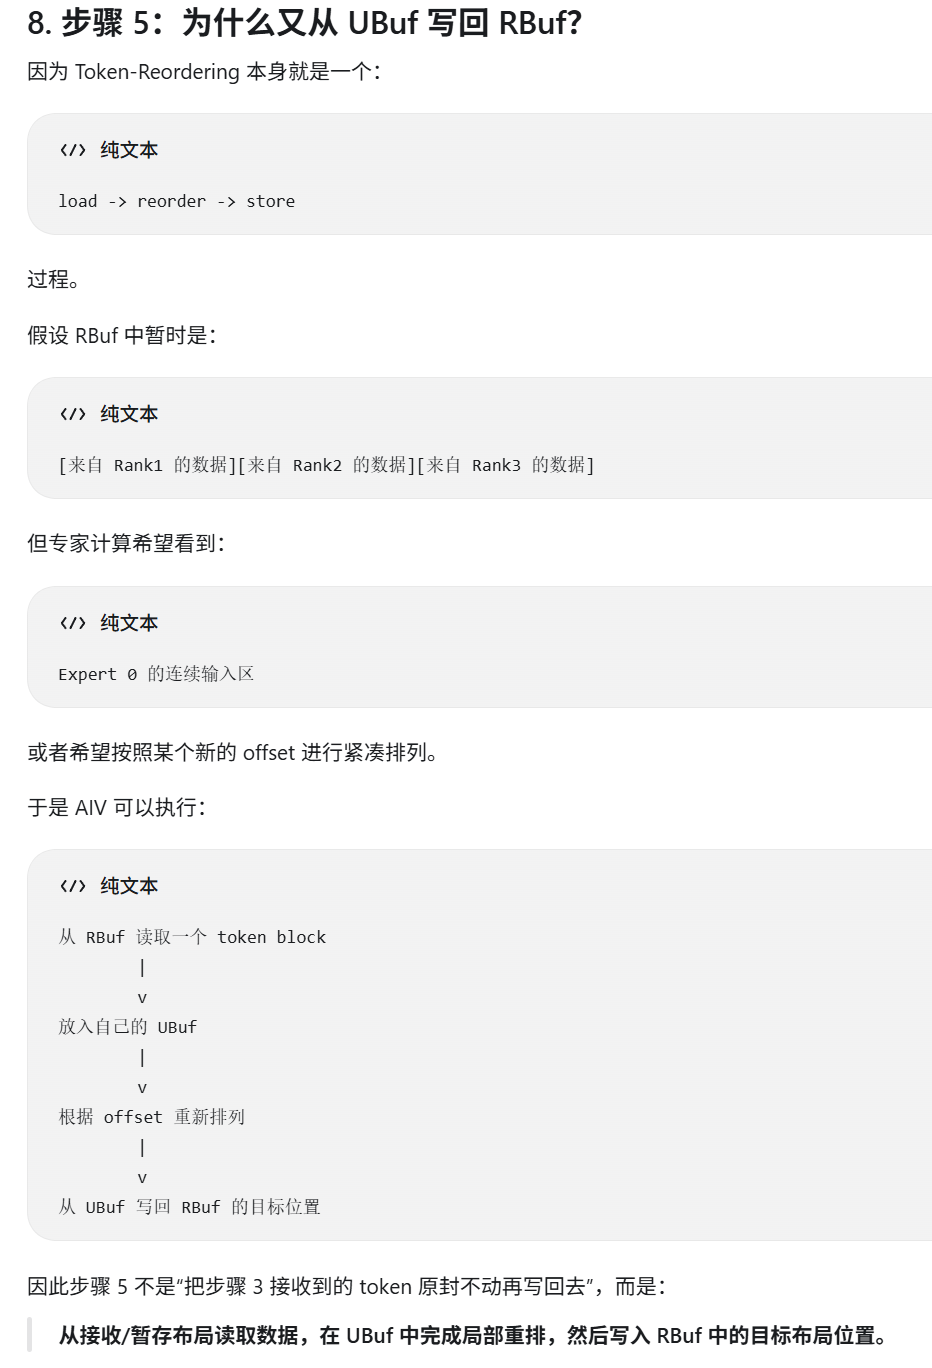
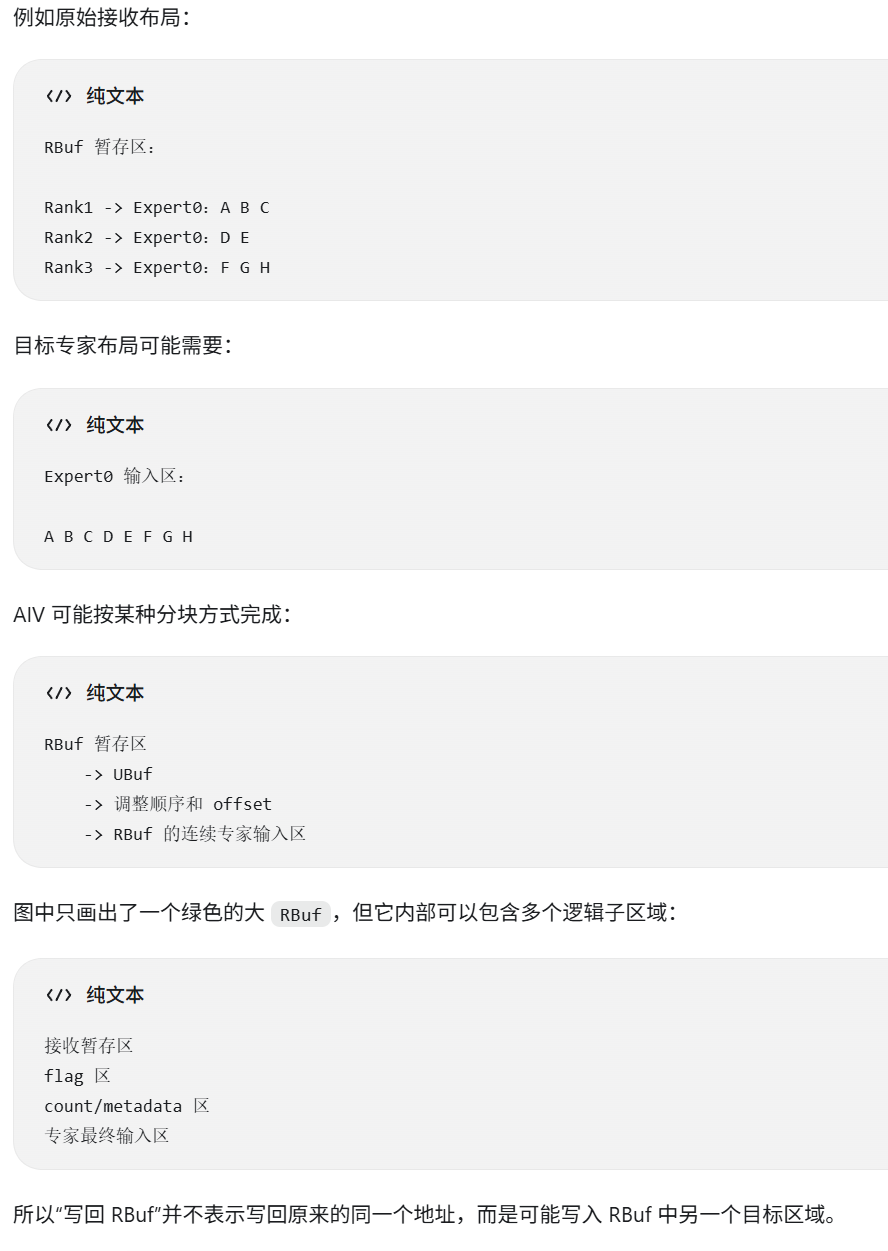
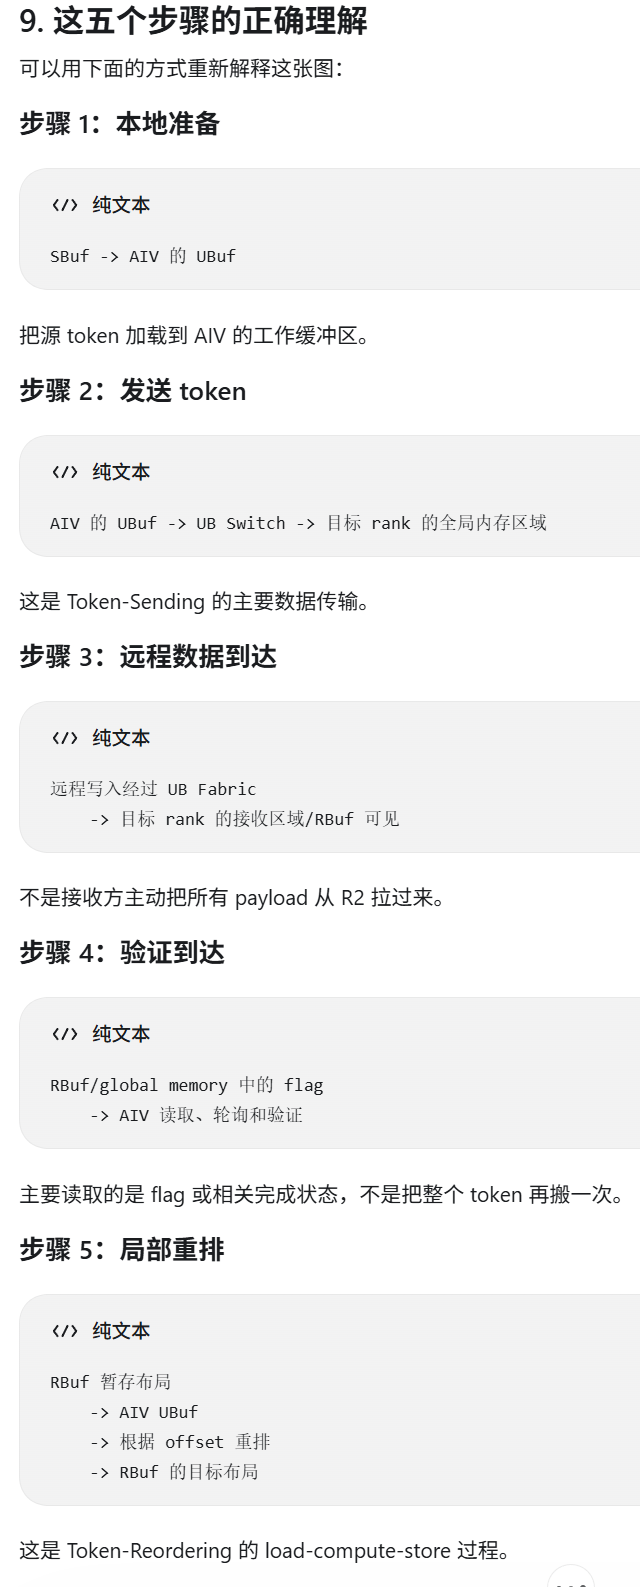
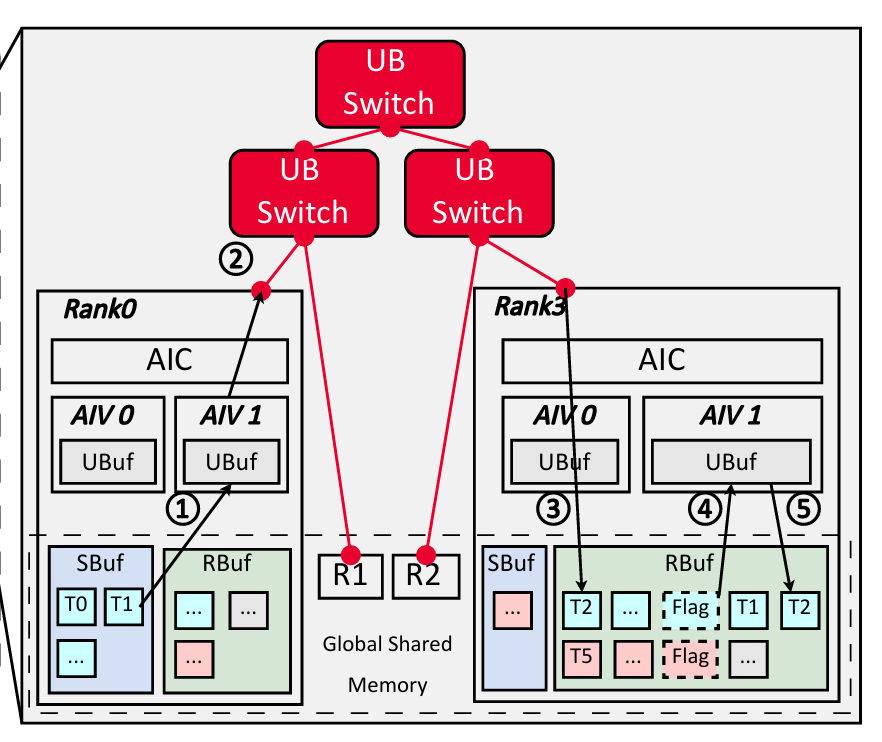 再解释一下这个图,发送的动作是发生在UBuf还是再SBuf上?为什么1的标号是从SBuf指向AIV1的UBuf?2是UBuf把数据写到共享内存区域上,这个共享内存区域可能组织成NPUi发送给NPUj上的数据,然后NPU就不断轮询检查自己对应的区域去得到数据,当Rank3检查到自己对应的区域上有数据后,就从R2写入到RBuf吗?那为什么第4步又把数据从RBuf写入到AIV1的UBuf上了,第5步又从UBuf折回到RBuf?
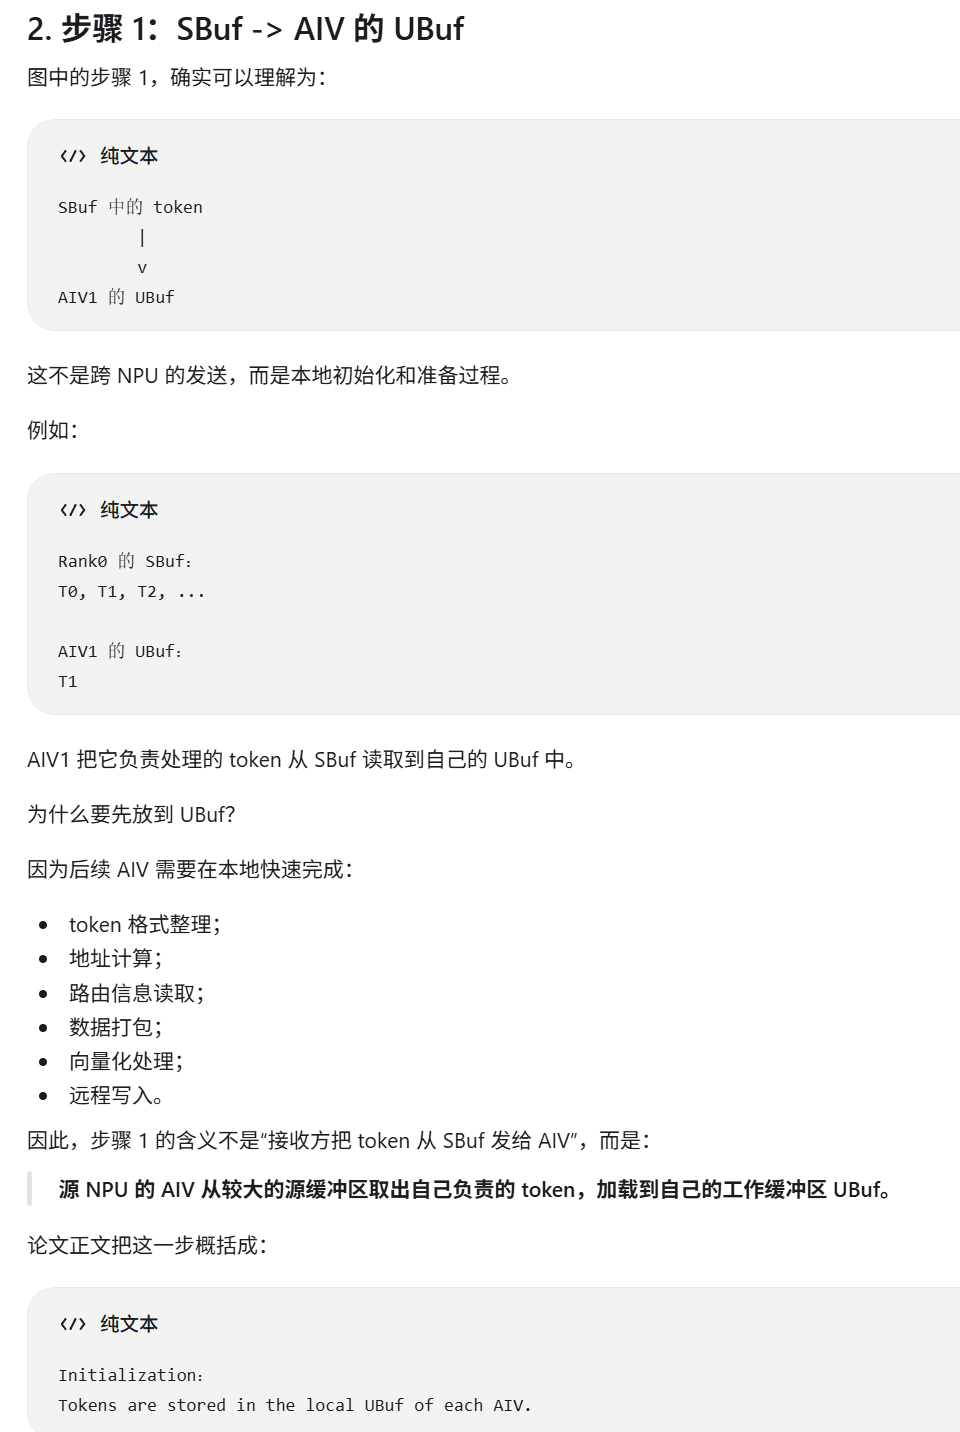
那如果Rank3不轮询,Rank3又怎么知道Rank1已经完成写入了呢?就是Rank1有什么办法能让Rank3知道自己正在写入,以及写入已完成呢?
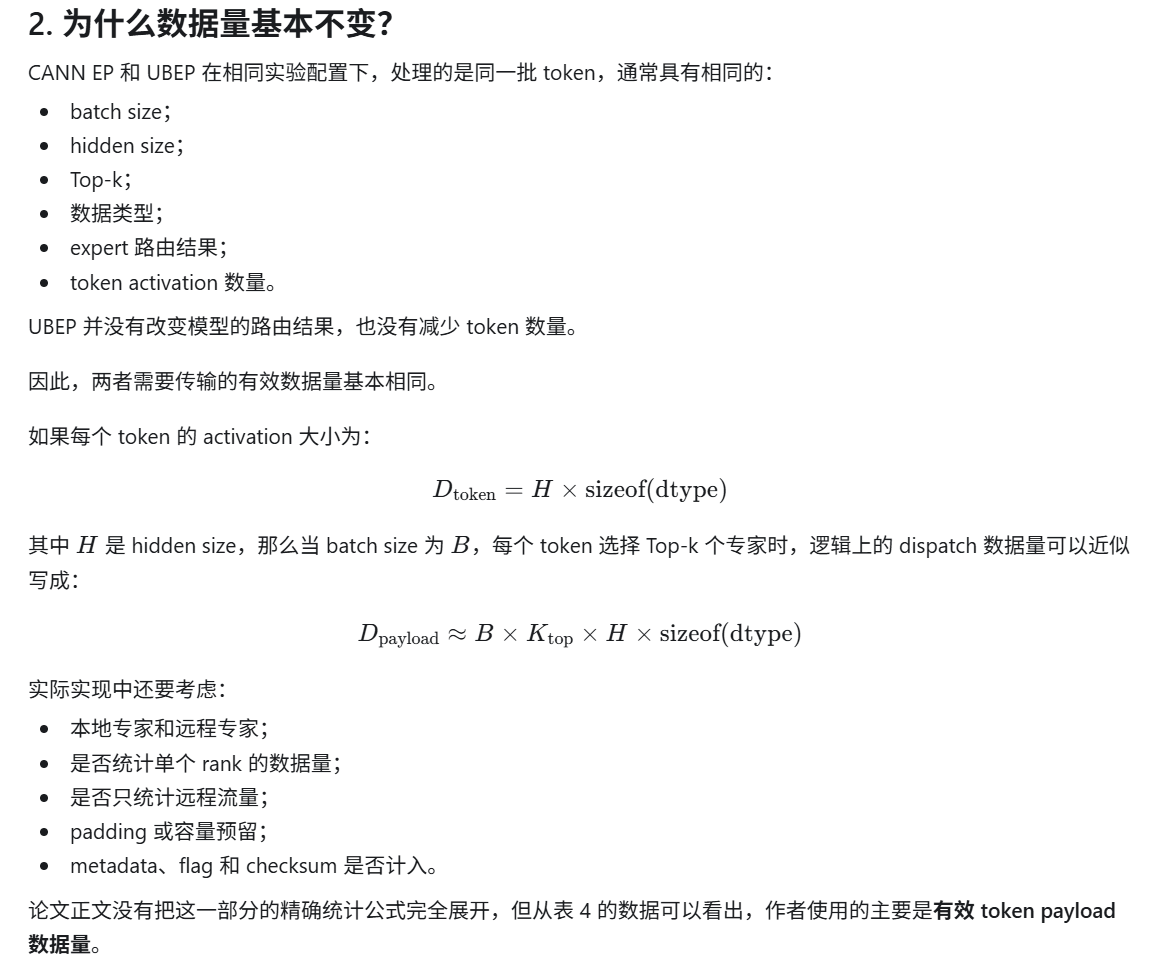
数据分析