NVIDIA Dynamo Snapshot 介绍
1. 它到底做什么
GPU 推理 worker 真正贵的通常不是拉镜像,而是启动后的初始化:权重进显存、拉起 CUDA runtime、warmup。之后每次扩副本、重启、被调度,都要把同样代价再付一遍。
Snapshot 只做一件事,拆成两半:
- Capture :在源 Pod 所在节点,把一台已经初始化完 的 GPU worker 冻住,落到磁盘。CPU 侧 CRIU,GPU 侧
cuda-checkpoint,再加容器可写层差量。 - Restore:在新 Pod 所在节点,把这份状态灌进占位容器,进程从冻结点继续跑。省掉的是模型加载和 warmup,不是 Kubernetes 调度。
落盘整包叫 artifact。它不是容器镜像,也不是 VolumeSnapshot。概括包括:
- CRIU 镜像(CPU 寄存器、内存页、部分资源描述)
- CUDA 状态(先到进程的 host 内存,再进 CRIU;多卡另有
cuda-checkpoint-job) - overlay 差量
rootfs-diff.tar、deleted-files.json manifest.yaml(以及criu.conf、dump.log)
设计是 policy-neutral:何时拍、拍谁、失败怎么办,交给上层。Snapshot 执行请求,进度挂在 Kubernetes 对象上。调用方只跟 apiserver / CR 打交道。
2. 仓库结构
| 路径 | 职责 |
|---|---|
api/ |
CRD(v1alpha1)和 restore 用的 podcontract |
operator/ |
控制面:PodSnapshot / SnapshotJob、artifact 清理、snapshotctl |
agent/ |
节点 DaemonSet:CRIU / cuda-checkpoint、进 namespace、restore |
charts/snapshot/ |
一次装 operator + agent + PVC + RBAC + seccomp |
e2e/ |
对着真 GPU 集群或 vCluster 跑 |
镜像:ghcr.io/ai-dynamo/snapshot/{operator,agent}。agent 只做 linux/amd64。
3. 控制面怎么切
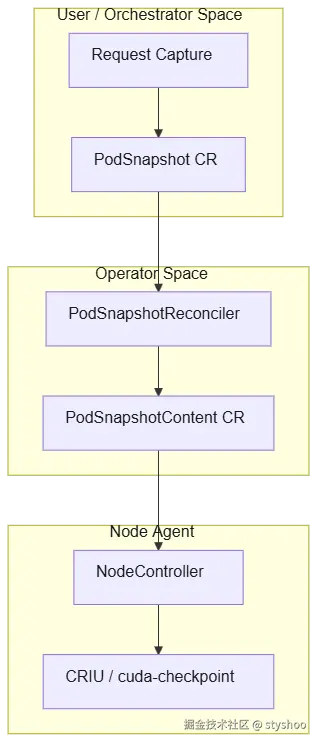
Operator (Deployment):把 namespaced 的 PodSnapshot 转成 cluster-scoped 的 PodSnapshotContent 工单,把 agent 写回的 Ready/Failed 镜像到 Snapshot,删对象时清盘。
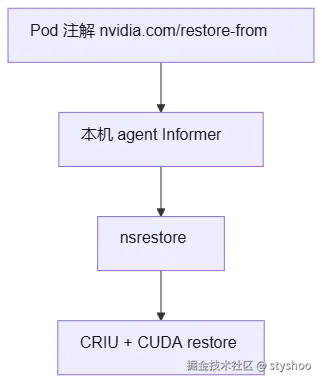
Node Agent (特权 DaemonSet,hostPID / hostIPC / hostNetwork):看着本机 Content 和带 restore 注解的 Pod,真正调 CRIU 与 cuda-checkpoint。
一句话:operator 编排,agent 执行。agent 没有另开给业务调的 HTTP/gRPC。
容易忽略:restore 不经过 operator。 新 Pod 打上注解即可;checkpoint 必须 operator 在,否则没有 Content 工单。
| 操作 | 谁决定节点 |
|---|---|
| Capture | 钉死在源 Pod 所在节点 |
| Restore | kube-scheduler 把 restore Pod 落到哪,哪台机器上的 agent 干活 |
4. 三个 CR,先记名字
拆法类似 PVC / PV。细节(为何不能合成一个、SnapshotJob 为何底层 Job 常显示 Failed)见内部逻辑。
| 对象 | 范围 | 回答的问题 |
|---|---|---|
PodSnapshot |
namespaced | 用户要拍谁、restore 时引用谁 |
PodSnapshotContent |
cluster | 文件在哪套身份下、该哪个节点去拍 |
SnapshotJob |
namespaced | 一句话「起 Pod → 拍成 Snapshot」 |
restore 注解 nvidia.com/restore-from 指向同 namespace 的 PodSnapshot 名,不是 Content。
5. 和 Dynamo 的关系(一句)
仓库在 ai-dynamo 下,但 Snapshot 不认识 Dynamo。何时拍、哪份 worker restore,在 Dynamo operator(DynamoGraphDeployment / DynamoCheckpoint)。机制在 Snapshot。产品路径细节见内部逻辑。
6. 现状
早期开发,不适合生产。已经能跑通绑定、SnapshotJob、节点 dump/restore、restore 合同、Helm 和 e2e。主要限制:一次一个容器、dump 会杀掉源进程、跨节点要共享 RWX 盘和匹配的 GPU/驱动、restore 失败不能在原 Pod 原地重试。
附录:常用术语
| 术语 | 含义 |
|---|---|
| Capture | 按请求把源容器状态落到 artifact 的整条流程 |
| dump | 把活进程序列化成文件的动作 |
| Restore | 在新容器里把状态灌回去 |
| Artifact | dump 落盘后的整包产物 |
| CRIU | 用户态 CPU checkpoint/restore |
| cuda-checkpoint | NVIDIA 冻/恢复 CUDA 状态;agent 里常用 cuda-checkpoint-helper |
| Operator / Node Agent | 控制面 vs 节点上真正 dump/restore |
| placeholder | restore 前先跑着的占位进程(如 sleep infinity) |
| policy-neutral | 只负责机制,不负责何时拍 |
参考
- 仓库:github.com/ai-dynamo/s...
- 同目录按上表编号继续读