数据同步软件技术实践:从异构数据库迁移到实时数据流转,解析电科金仓KFS架构设计
在企业数字化建设过程中,数据库已经成为核心业务系统的重要基础设施。但随着业务发展,很多企业都会遇到一个现实问题:不同业务系统使用不同数据库,数据如何实时、安全、准确地流转? 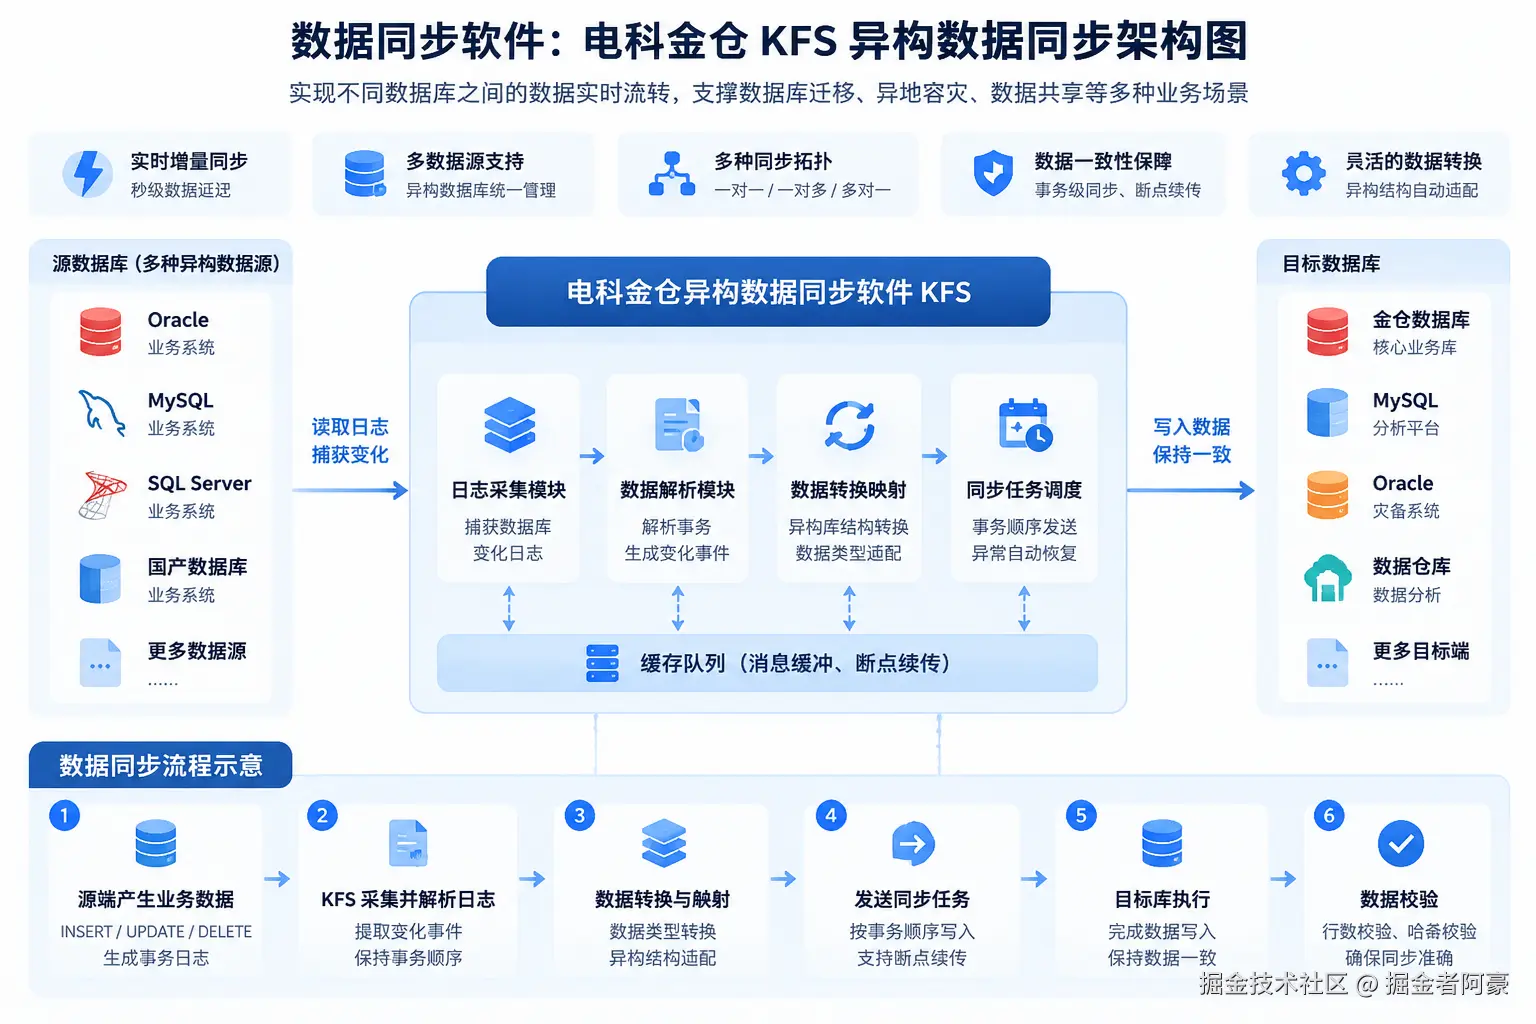
这也是数据同步软件诞生的核心价值。
传统的数据迁移更多关注"一次性搬过去",例如导出 SQL、导入数据、校验结果。但在金融、能源、政务、制造等行业,核心系统往往无法长时间停机,数据每天持续变化,如果只依赖离线迁移,很容易出现"迁过去的数据是昨天的,线上业务已经产生新变化"的问题。
因此,现代数据同步软件需要解决的不只是数据搬运,而是:
- 如何捕获实时变化?
- 如何保证事务一致?
- 如何支持异构数据库之间的数据转换?
- 如何在网络异常情况下保证数据不丢失?
- 如何支撑数据库迁移过程中的业务连续性?
针对这些问题,电科金仓推出的异构数据同步软件 KFS(Kingbase FlySync),提供了一套面向企业级场景的数据同步解决方案,主要应用于数据库平滑迁移、异地容灾、数据集中共享、业务系统数据分发等场景。电科金仓
本文从数据库工程实践角度,分析企业级数据同步系统应该如何设计,以及 KFS 在异构同步场景中的技术特点。
一、为什么企业需要专业的数据同步软件?
很多开发人员第一次接触数据同步,会想到:
定时执行 SQL,把 A 库的数据复制到 B 库。
例如:
sql
INSERT INTO target_order
SELECT *
FROM source_order;
这种方式在数据量较小的时候没有问题。
但是在生产环境中,会快速遇到几个问题。
1. 数据量增长导致同步效率下降
假设订单表每天新增 500 万数据:
sql
select count(*) from order_info;结果:
500000000如果每天凌晨全量同步:
sql
500000000 rows即使每秒同步 1 万条,也需要:
yaml
500000000 / 10000 / 3600 ≈ 13.8小时同步还没有结束,下一天的数据已经产生。
2. 无法感知实时变化
业务数据库一直在执行:
sql
update order_info
set status='PAY_SUCCESS'
where order_id=10001;
传统 ETL 并不知道:
- 哪些数据发生变化
- 哪些数据需要同步
- 修改顺序是什么
最终只能不断扫描:
yaml
数据库
  |
  |
全表查询
  |
  |
比较数据
  |
  |
同步
效率非常低。
3. 异构数据库存在转换问题
真实企业环境通常不是单一数据库。
例如:
yaml
Oracle
   |
   |
 MySQL
   |
   |
 金仓数据库
   |
   |
 数据仓库
不同数据库之间存在:
- 数据类型差异
- SQL语法差异
- 字符编码差异
- 索引结构差异
例如:
Oracle:
sql
NUMBER(10)可能对应:
sql
BIGINT或者:
sql
DECIMAL(10)同步软件需要完成这些转换。
二、企业级数据同步软件核心架构
一个成熟的数据同步系统,一般不是简单的数据复制,而是由多个模块组成。
整体架构如下:
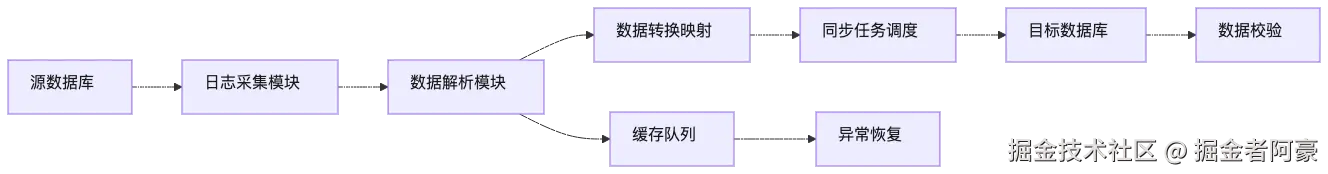
核心流程:
- 捕获源数据库变化
- 解析变化事件
- 转换数据结构
- 按事务顺序发送
- 写入目标数据库
- 校验同步结果
KFS 的核心思路也是围绕异构数据平台实时同步展开,通过增量日志解析技术,实现不同数据源之间的数据实时流转。电科金仓
三、增量同步的核心:日志解析
目前主流企业同步方案不会采用定时扫描数据库,而是采用:
Change Data Capture(CDC)
即变化数据捕获。
数据库执行:
sql
UPDATE customer
SET phone='13800000000'
WHERE id=100;
数据库内部会产生日志:
ini
事务开始

UPDATE customer
id=100
old_phone=13811111111
new_phone=13800000000

事务提交
同步软件读取日志:
css
数据库日志

    |
    ↓

变化事件

{
 table:"customer",
 id:100,
 action:"UPDATE",
 before:{
 phone:"13811111111"
 },
 after:{
 phone:"13800000000"
 }
}

    |
    ↓

目标数据库执行
这样同步延迟可以降低到秒级甚至更低。
四、数据同步完整流程
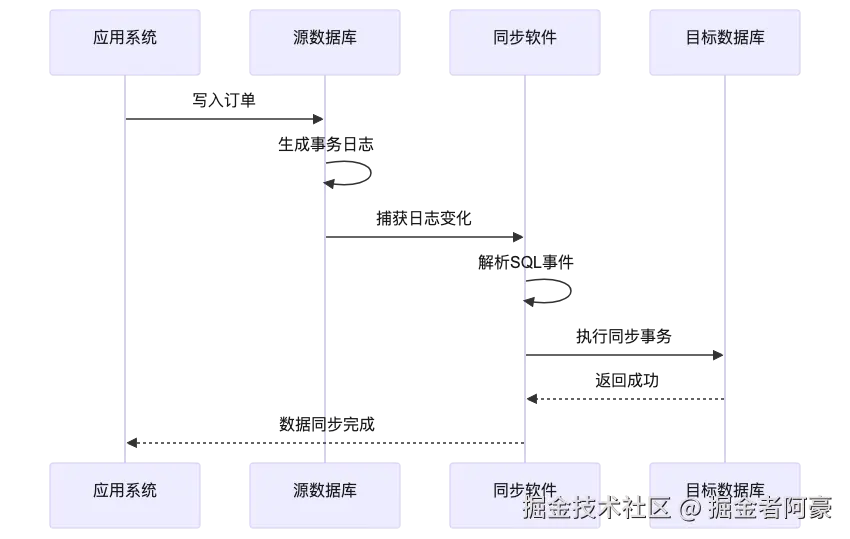
下面模拟一次订单数据同步过程。
源端产生交易
业务系统:
sql
INSERT INTO orders
(
 id,
 user_id,
 amount,
 status
)
VALUES
(
10001,
20001,
99.9,
'PAID'
);
数据库生成事务日志:
sql
TX001

BEGIN

INSERT orders

COMMIT
同步系统读取:
yaml
TX001
 |
 |
解析
 |
 |
转换
 |
 |
发送
最终目标数据库:
sql
select *
from orders
where id=10001;
结果:
10001 | 20001 | 99.9 | PAID流程图:
五、数据库迁移为什么需要数据同步软件?
很多企业进行数据库升级时,会采用:
第一阶段:全量迁移
例如:
markdown
旧数据库

100TB数据

       ↓

新数据库
迁移完成需要几十小时。
但是业务期间:
订单新增
支付变化
用户修改
仍然不断发生。
所以需要:
yaml
旧数据库
   |
   |
全量迁移
   |
   |
新数据库

同时

旧数据库
   |
   |
增量同步
   |
   |
新数据库
这样:
- 老数据迁过去
- 新数据实时跟随
最终切换业务时:
数据差异 ≈ 0这种方式能够大幅降低数据库升级风险。
电科金仓提供的迁移方案中,也采用存量迁移与增量同步结合的方式,实现数据库平滑替换。电科金仓
六、数据一致性是同步系统最大的挑战
同步快并不难。
真正困难的是:
快,并且不能错。
例如:
订单系统:
事务1:
sql
insert order;

update account
set balance=balance-100;
如果同步顺序错误:
目标库:
账户扣钱成功

订单不存在
业务直接异常。
因此同步软件必须保证:
1. 事务顺序
保证:
sql
BEGIN

SQL1

SQL2

COMMIT
整体复制。
2. 断点恢复
网络异常:
ini
同步位置:

LSN=100000
恢复后:
ini
继续:

LSN=100001
而不是重新同步。
3. 数据校验
例如:
源库:
sql
select count(*)
from orders;
结果:
10000000目标:
10000000进一步校验:
sql
select md5(
concat(id,status)
)
from orders;
保证内容一致。
七、KFS在异构同步场景中的技术价值
从数据库工程实践来看,一个企业级同步工具需要具备几个能力:
1. 多数据源支持
企业数据库环境往往复杂:
arduino
Oracle

MySQL

SQL Server

国产数据库

消息系统

数据仓库
同步工具需要提供统一管理能力。
2. 实时增量同步
传统 ETL:
小时级
分钟级
实时同步:
秒级更加适合:
- 交易系统
- 生产系统
- 实时分析平台
3. 多种同步拓扑
实际业务不是简单:
css
A → B更多情况:
markdown
          数据中心

             |
     ----------------

     |       |       |

  分支1   分支2   分析平台
因此需要支持:
- 一对一
- 一对多
- 多对一
- 级联同步
KFS 官方资料显示,其支持多种同步拓扑,并面向灾备、迁移、数据共享等场景设计。电科金仓
八、实际应用案例:数据库国产化迁移
假设某企业:
原系统:
css
业务数据库A计划迁移:
金仓数据库传统方式:
停机

备份

恢复

测试

上线
风险:
- 停机时间长
- 数据丢失风险高
采用同步方案:
yaml
阶段1:

旧数据库
     |
     |
 KFS同步
     |
     |
 金仓数据库


阶段2:

业务继续运行

增量持续同步


阶段3:

切换访问入口


阶段4:

完成迁移
整个过程:
业务不停机。
这也是数据同步软件在企业级数据库升级中的核心价值。
九、总结
数据同步软件并不是简单的数据复制工具,而是连接不同数据库、保障业务连续性的基础设施。
真正可靠的数据同步系统,需要解决:
- 海量数据传输
- 实时增量捕获
- 异构结构转换
- 事务一致性
- 异常恢复
- 数据校验
随着企业数据库架构越来越复杂,单一数据库已经无法满足所有业务需求,异构数据流转能力成为数据库体系的重要组成部分。
电科金仓 KFS 通过日志解析、实时同步、数据校验、多拓扑同步等能力,为企业数据库迁移、灾备建设以及数据共享提供了一种更加稳定的技术路径。电科金仓
对于开发人员而言,理解数据同步背后的技术原理,比简单选择一个同步工具更加重要。因为未来的数据架构,本质上一定是多数据库、多系统、多场景协同的数据流动体系。