如果你正在为本地知识库选 Embedding 模型,先别把向量维度、RRF 融合和生产准确率混在一起。这次我用 LiteRT-LM 的 270M 量化文本模型亲自跑了 32 问,记录了 256d、768d、FTS5 与 RRF 的真实排序,以及失败情况。
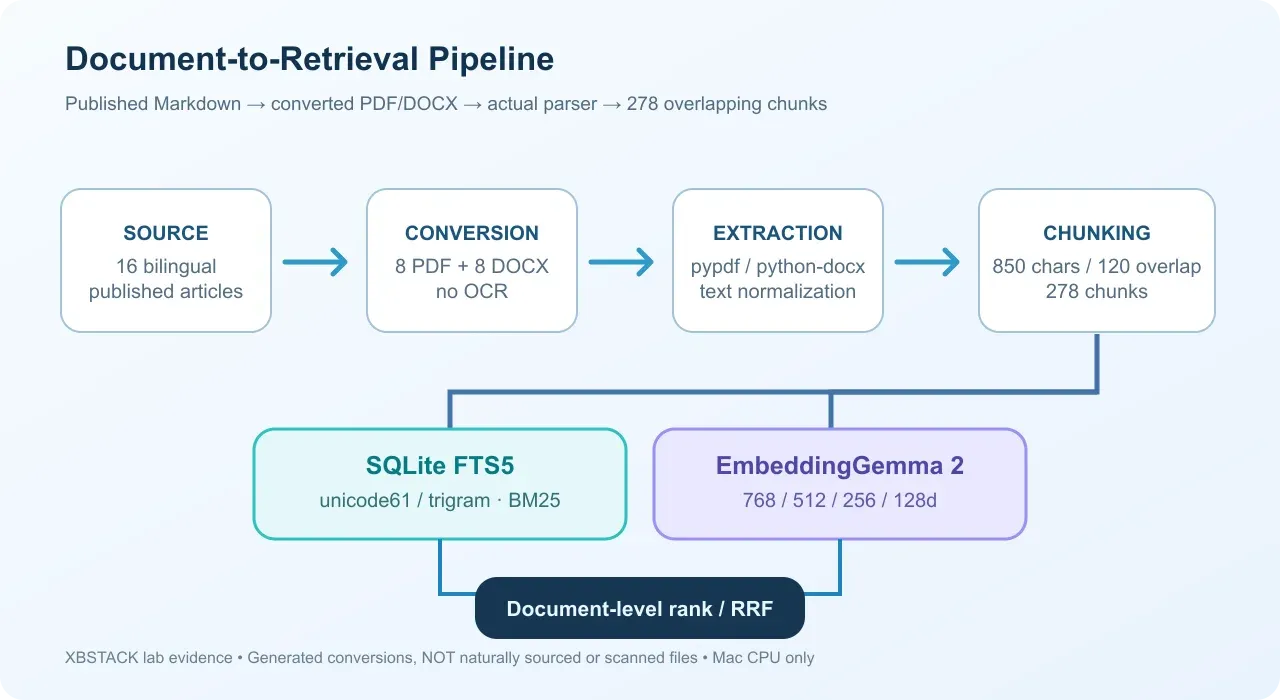
实测范围:Apple Silicon Mac / LiteRT-LM CPU 四线程 / EmbeddingGemma 2 270M 文本量化版 / 16 篇真实已公开文章转换成 8 PDF + 8 DOCX / 278 Chunk / 32 作者标注问题。
重要限制:生成式转换的 PDF/Word 不等于自然采集的扫描件,未测 OCR、复杂表格、Reranker、生产问答或 iPhone 13 真机。
一、真正的问题不是模型能否运行,而是检索是否值得换
做本地知识库,用户关心的是导入文档后能否快速找回包含答案的来源;开发者还要考虑模型加载、向量化速度、索引体积和跨语言查询。如果只贴 Google 模型参数、截图,无法回答"应该给一个小型资料库配置 256 维还是 768 维、纯语义检索还是混合检索"。
Google 在 2026 年 10 月 6 日发布 EmbeddingGemma 2 开发者指南。官方描述的完整系列涵盖文本、图像、视频、音频,但我们运行的 LiteRT-LM 270M 文本专用量化权重 不含视觉和音频编码器。模型卡还说明它支持 Matryoshka Representation Learning(MRL),可以把 768 维文本向量缩到 512、256、128 维,再归一化。官方给出的任务基准与本文本机脚本不是一回事。
本文测试的关键矛盾是:向量维度减到三分之一,能否在可控的本地文档检索中保住排序表现;双路混合检索是不是一定更好?
二、测试环境与三项实际任务
| 测项 | 本次实际配置 |
|---|---|
| 硬件 | Apple Silicon Mac,macOS / Darwin arm64 |
| 运行时 | Python 3.12.13,LiteRT-LM 0.18.0,CPU 四线程 |
| 模型 | embeddinggemma-2-text-270m.litertlm,量化文本版 |
| 权重 SHA256 | 2d079ee2f6f066b1f368e8d7c819f55214eaef1d0513b312321901f30ab286fb |
| 输入源 | XBSTACK 已发布的 8 个主题、16 篇中英文 Markdown 文章 |
| 文件链路 | 从真实正文生成 8 PDF + 8 DOCX,再用 pypdf / python-docx 解析 |
| 文本索引 | 850 字符一块、120 字符重叠,共 278 个 Chunk |
| 问题集 | 作者在运行前编写的 16 基础问 + 16 复杂改写问 |
| 指标 | 文档级 Hit@1、Hit@5、Recall@5、MRR,另计跨语言对应文档 |
| 未测试 | 自然扫描件、OCR、复杂表格、代码块精确检索、Reranker、真机 iPhone、生产 RAG |
三项任务依次是:第一,文档格式转换后能否重新提取完整正文并分块;第二,不同检索策略是否找到正确主题文档;第三,把输出压到 256/128 维后是否影响召回、排序及存储。
样本包括 MCP 大结果分页、n8n 错误工作流、LangGraph 人工审批与 Checkpointer、Google ADK 长期记忆删除、Agent 上下文成本、Responses API 流中断及 Agent 工具授权。各主题都有中文与英文版本,避免仅凭一句翻译句就声称跨语言能力强。完整来源路径和文件哈希保存在本地证据 JSON 中;文章未引用任何私人用户资料。
三、任务一:PDF/Word 解析与 Chunk 检索到底测了什么
本轮不是把 .md 文件改成 .pdf 扩展名。实验脚本先完整读取 16 篇文章,清理 frontmatter、围栏代码和图片标记,使用 ReportLab 真正生成 PDF、python-docx 真正生成 Word;接着分别用 pypdf 与 python-docx 从这些文件中重新提取正文,再标准化空白。
解析后所有文件均有大量有效文本,通过最低字符保留检查。正文长度覆盖约 4,154 到 29,135 字符;转换后统计字符略有增加,是排版和空白差异,不意味着"额外提取出了更多知识"。每段提取文本按 850 字符窗口切分,向后重叠 120 字符。最终 16 份文件产生 278 个 Chunk。
这里有一个很容易误导读者的地方:验证"从数字 PDF 提取文字"不等于验证 OCR。扫描 PDF 是图像;带复杂表格的 Word/PDF 会改变文本的阅读顺序。本文的转换文件更整洁,因此这一步只能确认基础解析链路跑通,不能推导现实文档导入成功率。
四、任务二:FTS5、纯向量和 RRF 的真实成绩
我们对所有策略使用同一组 32 问和同一批 278 个 Chunk,先按 Chunk 排序、再去重为文档级排名。一个问题有两个同主题目标文档(中文、英文),因此"前五个结果至少命中一个"与"前五个结果召回全部相关文档"不是同一个指标。
| 检索方式 | Hit@1 | Hit@5 | Recall@5 | MRR |
|---|---|---|---|---|
| FTS5 unicode61 | 0.6250 | 0.8750 | 0.7812 | 0.7396 |
| FTS5 trigram | 0.6562 | 1.0000 | 0.7812 | 0.7755 |
| Embedding 768d | 0.9375 | 1.0000 | 1.0000 | 0.9688 |
| Embedding 512d | 0.9375 | 1.0000 | 1.0000 | 0.9688 |
| Embedding 256d | 0.9375 | 1.0000 | 1.0000 | 0.9688 |
| Embedding 128d | 0.8750 | 1.0000 | 0.9844 | 0.9323 |
| unicode61 + 768d RRF | 0.9375 | 1.0000 | 0.9844 | 0.9688 |
| trigram + 768d RRF | 0.8750 | 1.0000 | 0.9062 | 0.9375 |
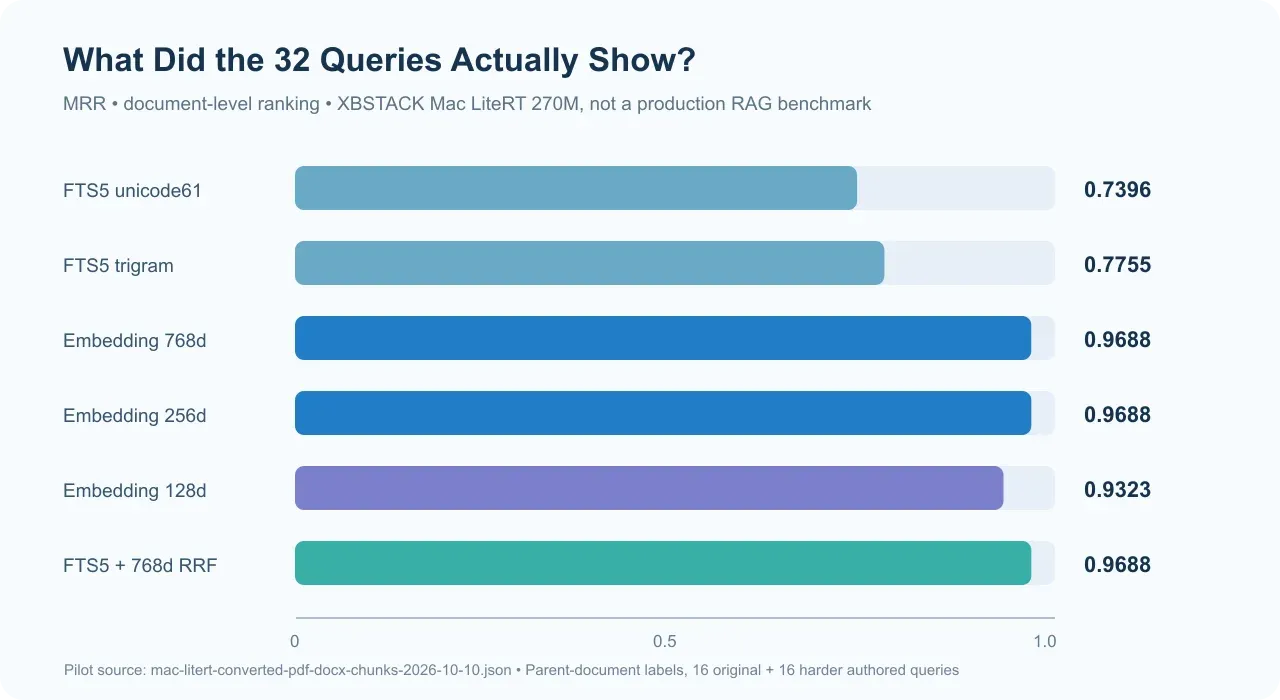
结果并不支持"混合检索一定更准"。 当前 unicode61 + 768d RRF 的 MRR 和纯 768d 相同,但 Recall@5 反而从 1.0000 降到 0.9844;trigram + 768d 的 MRR 也低于纯向量。默认等权 RRF 并未调参,FTS5 的中文切词、过滤和无关高分可能改变融合效果;在其他知识库中 RRF 可能更好,也可能更差。不能删掉这些失败数据,只展示最好的一组。
另一处重要区别:这里测的是是否检索到正确主题文档,而不是是否准确选中包含答案的具体 Chunk,更不是最终 AI 回答正确率。如果同一篇长文涉及十个概念,找到这篇文档并不表示找到了所需段落。
五、任务三:256 维真的可以代替 768 维吗
在这组 278 个 Chunk、32 问里,768、512 和 256 维的文档级 Hit@1 都是 0.9375、MRR 都是 0.9688;128 维的 Hit@1 下降到 0.8750、MRR 到 0.9323。这个观察支持256 维值得作为本地资料库的候选配置继续实测,但不是说各数据集、长文本、自然 PDF、代码搜索中 256 与 768 一样准。
代码没有重新训练模型,只从同一次 768 维编码结果中截取前 256 或 128 维,再分别做 L2 归一化。逻辑如下(已在本地实验脚本执行):
python
# vectors: one batch of 768-dim document embeddings
# qvec: the matching 768-dim query embedding
import numpy as np

dim = 256
index = vectors[:, :dim]
index = index / np.maximum(
    np.linalg.norm(index, axis=1, keepdims=True), 1e-12
)
query = qvec[:dim]
query = query / max(float(np.linalg.norm(query)), 1e-12)
scores = index @ query
278 个 float32 向量的纯数值存储 :768d 是 854,016 字节,256d 是 284,672 字节,128d 是 142,336 字节。256d 相比 768d 正好少三分之二,但这不包括 SQLite、ANN 索引、原文、元数据、模型权重和运行时缓存,也不意味着量化模型包可以随之缩到三分之一或推理速度提升三倍。
当模型、量化版本、维度或归一化策略发生变化时,务必重建或隔离旧向量索引;不能在一个索引中随意混用不同向量定义。
六、Mac CPU 实测耗时,以及为什么不能套到手机上
本轮在 macOS arm64、LiteRT-LM CPU 四线程上,实际记录了以下时间:
| 步骤 | 实测记录 | 口径 |
|---|---|---|
| 模型初始化 | 286.37 ms | 此次进程中的单次初始化 |
| 278 Chunk 文档向量化 | 53.99 s | 一次完整处理累计耗时 |
| 平均每块向量化 | 194.22 ms | 278 块均值 |
| 32 问查询向量化均值 | 79.08 ms | 仅查询编码,非端到端搜索服务 |
| 32 问查询向量化 p95 | 82.47 ms | 此次脚本取样值,非线上 SLA |
模型文件对应 官方 LiteRT 文本 270M 版本,而 Google 的不同手机和硬件加速测试另有专门的设备环境。这里没有跑实体 iPhone 13,也没有测长时间连续导入、内存峰值和发热、电量、后台中止恢复或模型互斥。因此不能根据 79 ms 就保证手机 UI 搜索延迟。
对于本地知识库,这里的工程价值是:FTS 先入库即可让用户搜索,而 Embedding 可以在后台增量进行,避免首次打开或大批量导入时将所有文件同步阻塞在模型推理上。
八、复现步骤、源文件和关键限制
实验不是展示型静态报告:本地确实执行了 LiteRT 270M 权重,模型 SHA、源文章路径和 SHA、每题排名、时间、维度存储估算都记录在原始 JSON。实验代码和依赖保存在 XBSTACK 本地项目目录:
bash
# 在 XBSTACK blog 仓库根目录
uv pip install --python research/embeddinggemma2/.venv-litert/bin/python \
  -r research/embeddinggemma2/requirements-document-pilot.txt

research/embeddinggemma2/.venv-litert/bin/python \
  research/embeddinggemma2/document_format_chunk_pilot.py

research/embeddinggemma2/.venv-litert/bin/python -m unittest \
discover -s research/embeddinggemma2/tests -v- 执行脚本:research/embeddinggemma2/document_format_chunk_pilot.py
- 完整结果:research/embeddinggemma2/evidence/mac-litert-converted-pdf-docx-chunks-2026-10-10.json
- 工程报告:research/embeddinggemma2/document-pilot-report-2026-10-10.md
- 研究单测:20/20 PASS。
- XBSTACK EmbeddingGemma 2 完整公开复现实验 已于 2026-10-10 同步本轮 PDF/Word 脚本、32 问逐题 JSON、20 项研究测试、16 份已公开技术文章源文本与 SHA;查看本次原始提交。量化模型权重需从官方模型源自行下载,不随 GitHub 仓库分发。
不包含:自然形成的 PDF/Word、扫描件 OCR、PPT、复杂表格和图片、原生多模态文档理解、Reranker、证据 Chunk 人工盲标、iPhone 13 真机性能、生产 App 查询流程或最终回答的引用校验。输入来自公开文章,测试问题由作者编写;一组数据只运行了一轮难度分组对照,没有外部独立盲测、置信区间或大规模统计保证。
九、结论:谁值得用,谁应该继续观望
可以继续试的情况:你需要离线文档语义检索、资料以干净文本为主、空间/内存有限,愿意自己管理文件解析、向量缓存、模型版本与索引迁移。对这种场景,EmbeddingGemma 2 270M + 256d 在我们的小规模试验中是有竞争力的候选,值得再用真实私有文档做受控测评。
不适合现在就换掉生产方案的情况:大量扫描 PDF、图表与 OCR 噪声、需要稳定段落级引用、中文专业术语或代码片段精确匹配、现有模型迁移代价高、或端侧机型性能尚不清楚。应保留 FTS 立即可搜,逐步对照 Embedding + Reranker,验证证据选择与回答引用后再迁移。
更大的教训是,一次可复现的好成绩,只能说明在该测试范围内可用。如果后续加入真实扫描资料和长 PDF 后成绩下降,这会是更有价值的产品信息,而不是需要藏起来的失败。
官方和独立资料
- Google 官方发布和开发者指南;模型卡及 MRL 维度说明。
- 270M 文本量化模型仓库;LiteRT-LM Embedding 接口说明。
- strata→signal 独立英文检索对照;Weidows 独立中文 C-MTEB。二者均非本次 XBSTACK Mac LiteRT 270M 同数据集实验,不能拿其分数与本文直接排名。
- Personal AI Agent 架构、Agent Memory 系统 与 Context Engineering 的检索和上下文成本 分别补充本地/云端架构、长期记忆边界及检索成本设计;本篇只负责模型与检索实验。
可验证来源与延伸阅读
完整原始测评(测试环境、结果与边界):EmbeddingGemma 2 270M 实测:278 Chunk、32 个查询与 RRF 反例
公开 GitHub 复现实验(原始查询排名和来源 SHA256):github.com/xbstack/emb...