阿里 Qwen 团队在 2026 年 10 月 9 日放出 Qwen-Image-2.1-Turbo:同一个 7B 架构,去噪步数从 40 步降到 8 步。
直觉上这意味着 5 倍加速。但真当你去跑,会发现加速比远不是 5×------除非你同时把另外两笔账也算上。
这篇文章要做的,就是把这三笔账摊开:步数、每步的前向次数、以及那笔摊不掉的条件编码成本。 少步生成的所有工程技巧,本质上都在这三行里。
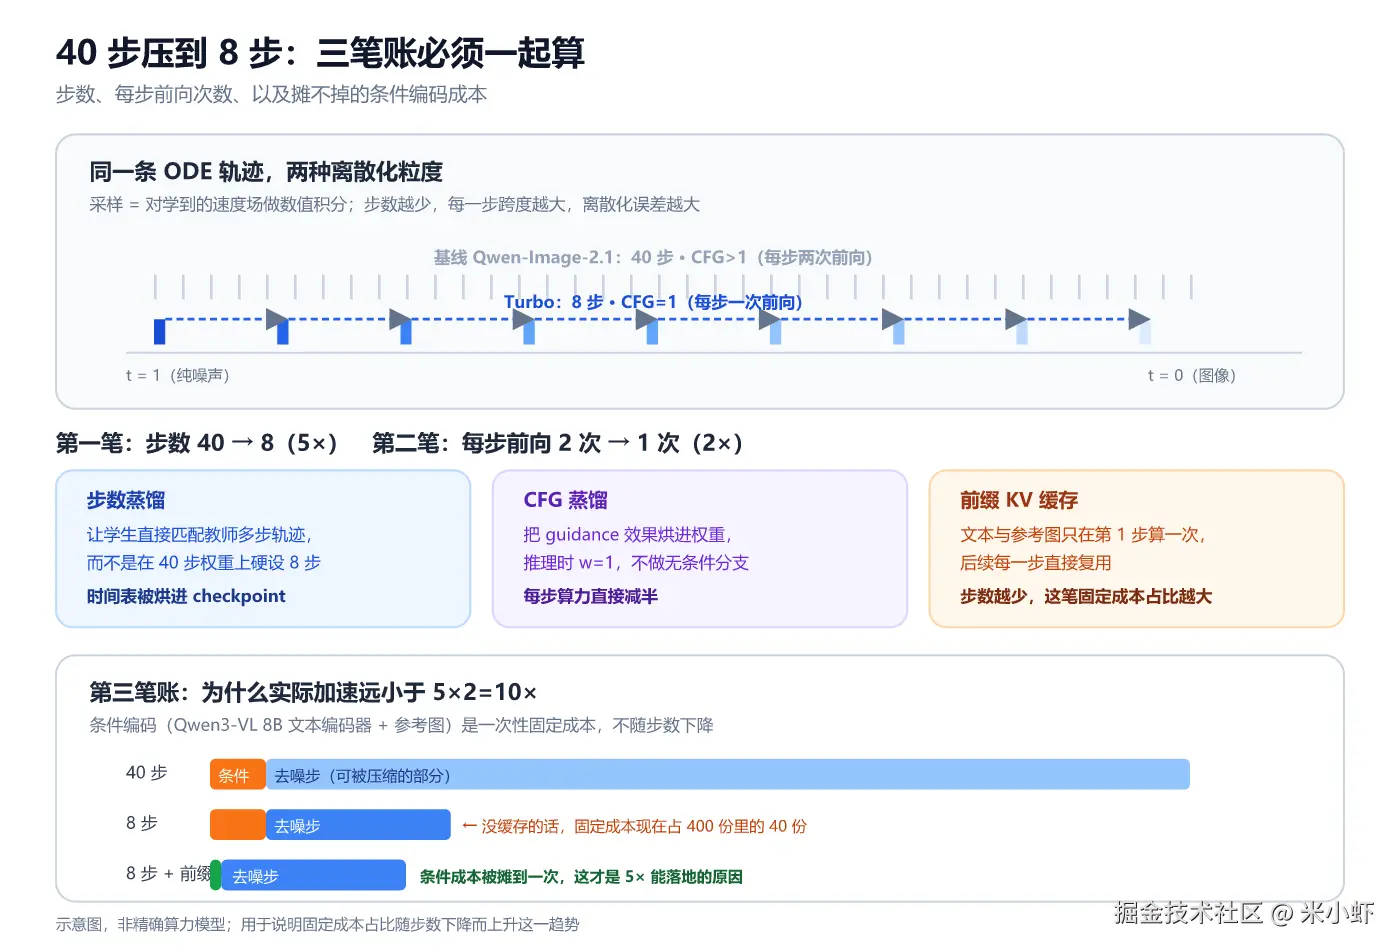
一、先讲清楚一件事:步数是离散化步数
现在的图像生成模型基本都跑 Flow Matching。它不学「怎么去噪」,而是学一个速度场:
arduino
dx_t / dt = v_θ(x_t, t, c)

x_t : t 时刻的图像状态(t 从 1 的纯噪声走到 0 的干净图)
c   : 条件(文本指令、参考图)
v_θ : 神经网络学到的速度场
生成图像 = 对这个常微分方程做数值积分。 而步数,就是积分的离散化步数。
用欧拉法,一步走:
arduino
x_{t-Δt} = x_t + Δt · v_θ(x_t, t, c)步数越少,每一步的 Δt 越大 。而欧拉法在每步有 O(Δt²) 的局部截断误差------跨度翻 5 倍,单步误差涨 25 倍,还会沿轨迹累积。
这就解释了那个最常见的错误操作。
二、为什么不能在 40 步权重上直接设 8 步
很多人的第一反应是:num_inference_steps=8 不就完事了?
不行。原因是速度场只在它被训练时的步长分布上才是准的。
训练时模型见过的都是小 Δt 的相邻状态对。你让它一步跨过训练时五段路的距离,它的预测就落在了分布外------轨迹会偏离,出来的图会崩。
正确的做法不是改采样参数,而是改模型:训练一个学生,让它直接学会「大步走」。
scss
教师:ODE_N(v_T, x_0, c)   ← N 步积分的结果(N=40)
学生:ODE_K(v_S, x_0, c)   ← K 步积分的结果(K=8)

训练目标:L = E ‖ ODE_K(v_S, x_0, c) − ODE_N(v_T, x_0, c) ‖²
这就是**步数蒸馏(step distillation)**的核心:让学生 K 步的输出去匹配教师 N 步的输出。
社区里这条路有好几个变体------渐进式蒸馏(逐步对折步数)、一致性蒸馏(强制轨迹自洽)、Shortcut / MeanFlow(匹配平均速度场而非仅终点)、对抗蒸馏。它们解决的是同一个问题的不同侧面:只在终点做监督,误差会在积分过程中累积,训练方差大;所以有人改成匹配速度场,提供更稠密的过程监督。
Qwen 没有公开 Turbo 用的是哪一种。但有一个可观察的证据:8 步时间表被烘进了 checkpoint 里。
三、第一笔账:时间表被锁死,这是特性不是 bug
Turbo 的 8 步 sigma 序列(保存在权重里):
1.0, 0.978453, 0.95418, 0.926626, 0.89508, 0.845148, 0.704534, 0.414568, 0注意这个形状:前面密、后面疏(前几步每步只走 0.02 左右,最后一步从 0.41 直接跳到 0)。这符合生成过程的常识------早期决定大结构,需要细走;后期只是补细节,可以大步跨。
关键工程细节:
ini
❌ 只设 num_inference_steps = 8      → 不会覆盖已保存的时间表
✅ 显式传 sigmas 参数                 → 才会真正改
⚠️ 其他时间表 → Qwen 明确说未测试这个设计是对的:少步模型的可用时间表是蒸馏过程的产物,不是可以自由调的超参。把它锁进权重,避免用户调到一条模型没学过的轨迹上。
代价是灵活性:你失去了「用 15 步换一点质量」这个选项,除非你自己去试未测试的 sigma 序列。
四、第二笔账:CFG=1,每步从两次前向变成一次
Classifier-Free Guidance 的公式:
scss
v_cfg(x_t, t, c, w) = (1 − w) · v_θ(x_t, t, ∅)  +  w · v_θ(x_t, t, c)
                       └── 无条件分支 ──┘        └── 条件分支 ──┘
当引导强度 w > 1 时,每一步要跑两次前向 ------一次带条件,一次不带(把条件替换成空)。这就是 CFG 的隐性成本:算力直接翻倍。
Turbo 默认 CFG=1,意味着:
ini
w = 1 → v_cfg = v_θ(x_t, t, c) → 每步一次前向,无条件分支消失这又是 2×。
但 CFG=1 不是把参数调成 1 就完事------那样会丢掉 guidance 带来的提示词跟随度。它靠的是 CFG 蒸馏:把「教师在高 guidance 下的输出」烘进学生权重,让学生在无 guidance 时就能复现那个效果。
同类技术的公开记录印证了这是通用做法。Bria 的 FIBO-lite 把自己的两阶段蒸馏写得很清楚:第一阶段把 CFG=5 的教师蒸馏成 CFG=1 的学生(每步算力减半),第二阶段再做少步蒸馏(步数减少),两者相乘才是总加速。腾讯混元视频 1.5 的技术文档也是同样的两段式结构。
所以 Turbo 的「8 步」这个数字具有误导性 :它不是单纯把 40 除以 5,而是 步数 5× 与 每步 2× 两件事叠在一起。
五、第三笔账:那笔摊不掉的条件编码成本
这是本文最想强调的一点,也是为什么实际加速比往往低于 5×2=10× 的原因。
看下 Qwen-Image-2.1 的结构:
| 组件 | 规格 |
|---|---|
| 视觉生成器 | 单流 DiT,32 层,7B 参数,block-causal 注意力 |
| 文本编码器 | Qwen3-VL 8B(同时编码指令和参考图) |
| VAE | 64 通道 RGBA 自编码器,16× 空间压缩(原生透明通道) |
| 调度器 | Flow Matching + 欧拉离散 + 动态 shift |
注意文本编码器是 8B ------比生成器还大。而它的输入(指令文本、参考图)在每一步去噪中完全不变。
每步成本 = 条件编码(固定,不随步数变) + 一次 DiT 前向(随步数线性变)

40 步:固定成本占总成本 ≈ 1/40 → 几乎可以忽略
8 步 :固定成本占总成本 ≈ 1/8  → 成为显著项
步数越少,固定成本占比越大。 这正是少步生成的悖论:你把可变部分砍掉了 80%,剩下的固定部分就变得显眼了。
Qwen 的解法是 prefix KV 缓存:
第 1 步:完整计算文本 token 与参考图 token 的 KV
第 2~8 步:直接复用这份缓存,不再重算条件
代码里就是 use_kv_cache=True。文档明确写了那句话:「因为只有 8 步,缓存的前缀覆盖了条件编码成本的大部分。」
反过来说也成立:40 步的模型做前缀缓存收益有限(固定成本本来就摊薄了),8 步的模型必须做。 这就是为什么「少步」和「前缀缓存」在 Turbo 里是绑定的一对,而不是两个独立优化。
六、理想丰满,现实骨感:五个坑
1. 没有 Turbo 专属的 benchmark
公开的分数只有一个:基础版 Qwen-Image-2.1 在 Qwen-Image-Bench 上拿 60.28 (厂商公布,Qwen 称之为开源权重最高分)。Turbo 自己的分数没有公布。
这意味着「8 步和 40 步质量差多少」这个问题,官方没有给答案。在 Turbo 的对比表里,这一栏写的是 "Not disclosed"。
2. 蒸馏有质量代价,只是没人量化它
从同类技术的公开记录看,这是普遍规律,不是秘密:
| 来源 | 公开表述 |
|---|---|
| Bria FIBO-lite | 蒸馏后相比 CFG=5 的完整模型有「轻微质量下降」 |
| 腾讯混元视频 1.5 | 12 步为推荐平衡,8 步「质量损失极小」,4 步「质量略有降低,适合快速原型」 |
换句话说:少步是拿质量换速度的连续光谱,8 步大致落在「可接受」区间,4 步以下才明显掉。 但具体掉多少、掉在哪些类别上(精细纹理?复杂构图?长文本排版?),Qwen 没给。
3. 时间表锁死 + 社区对固定欧拉有质疑
ComfyUI 社区在发布当天就做了复现。Kijai 的两条观察值得记录:
- 保存的时间表接近 ComfyUI 的
linear_quadratic调度器且未施加 shift; - 他没有见过固定欧拉时间表在 turbo 类 checkpoint 上胜过随机采样器。
这是经验之谈不是结论,但它指向一个真实风险:蒸馏出来的时间表可能与特定的随机性假设耦合,换成别的采样器未必更好。官方说其他时间表未测试,那就真的别乱试。
4. 许可是研究许可
Turbo 与基础版都用 Qwen Research License,商业自部署需要单独向阿里申请。
横向对比一下就更清楚了:
| 模型 | 生成器 | 默认步数 | 许可 | 硬件参考 |
|---|---|---|---|---|
| Qwen-Image-2.1-Turbo | 7B | 8 | Qwen Research License | 未公开 |
| Qwen-Image-2.1(基础) | 7B | 40 | Qwen Research License | 11 GB(GGUF)/ 24 GB(INT8-FP8,Unsloth 估算) |
| Z-Image-Turbo | 6B | 8 | Apache 2.0 | 可装进 16 GB |
| FLUX.2 klein 9B | 9B | 4 NFEs | 非商业 | 约 29 GB,RTX 4090 起 |
同门的 Z-Image-Turbo 是 Apache 2.0。如果你的场景要商用自部署,Turbo 目前不是最省事的选择。
5. 工程摩擦不小
跑起来需要:
- 从源码安装 Diffusers
transformers >= 5.17.0- Diffusers PR #14950(这个 PR 才支持"由 pipeline 配置的采样 sigmas")
也就是说,稳定版 Diffusers 目前跑不了。Comfy-Org 在几小时内做了重新打包(bf16 完整权重、INT8 convrot 量化版、以及一个 rank 178 的 LoRA 抽取版,可以叠在基础模型上而不是换 checkpoint)------社区响应很快,但这本身就说明官方渠道还没铺平。
API 侧反而简单 :阿里云百炼按张计价,Turbo ¥0.1/张(120 RPM) ,Pro ¥0.25/张(20 RPM)------便宜 2.5 倍,速率上限 6 倍。
七、生产现实:什么场景赚,什么场景亏
| 场景 | 判断 | 理由 |
|---|---|---|
| 高吞吐批量出图(电商主图、素材生成) | 最赚 | 单张成本降 2.5×,速率上限升 6×,且固定成本被前缀缓存摊掉 |
| 交互式编辑(改一版看一版) | 很赚 | 迭代速度就是产品体验;8 步让"改完立刻看"变得可行 |
| 多参考图编辑(最多 10 张参考) | 尤其赚 | 参考图编码是固定成本大头,前缀缓存收益最大 |
| 需要透明通道的素材(贴纸、商品合成) | 有独特优势 | 64 通道 RGBA VAE 原生输出,不需要额外的抠图通道 |
| 2K 高清成品图 | 看质量容忍度 | 2K 是官方支持上限(2048×2048 / 2752×1536),但少步在高分辨率下的细节退化没有公开数据 |
| 精细排版 / 长文字海报 | 先自己测 | 少步最容易掉的就是小尺度细节,官方 showcase 里有排版类但无量化对比 |
| 商用自部署 | 暂缓 | 研究许可 + 需单独的商业授权;同门 Z-Image-Turbo 是 Apache 2.0 |
| 想要自由调步数 | 不合适 | 时间表锁死,改步数等于进入未测试区域 |
一条实用建议 :如果你已经有现成的 40 步流程,不要直接换 Turbo 出成品。先用 Turbo 做批量筛选与草稿,把候选缩小,再用 Pro 出终稿。 这个两级结构比"全部换成 Turbo"更稳,也更省。
八、选型决策树
markdown
你要的是速度还是质量上限?
│
├─ 质量上限(单张成品、精修)──→ 用 Pro / 基础版 40 步
│
└─ 速度 ──→ 你的流程里有没有「固定条件、多次去噪」的结构?
              │
              ├─ 有(批量同 prompt、多参考图编辑、反复迭代)
              │   └─ 8 步 + 前缀缓存,收益最大
              │
              └─ 没有(每张图条件都全新)
                  └─ 固定成本摊不掉,实际加速会明显低于 5×
                     先量一次再决定
四条实践建议:
- 别只比步数,比端到端墙钟时间。 条件编码是大头,它不随步数下降。
- 前缀缓存要显式打开 (
use_kv_cache=True)。在 8 步场景下它不是可选项。 - 别碰 sigma 参数,除非你准备自己做质量回归。官方明说其他时间表未测试。
- 商用前先确认许可。 研究许可和 Apache 2.0 之间的差别,可能在法务那里卡两周。
九、我的判断
第一,少步生成的瓶颈已经从「算法」转移到「成本结构」。
蒸馏本身是成熟技术了------渐进式、一致性、Shortcut/MeanFlow、对抗蒸馏,社区有足够多的可选方案。真正决定落地速度的,是固定成本占多少:当你把可变部分砍掉 80%,剩下那 20% 里的固定部分就成了新问题。Qwen 把前缀缓存和 8 步绑在一起发布,说明他们很清楚这一点。
第二,「8 步」这个数字会被持续压低,但收益会递减。
从 40 到 8 是 5 倍;从 8 到 4 只有 2 倍,而质量代价明显上升(混元的公开记录:8 步「损失极小」,4 步「略有降低」)。同时固定成本占比从 1/8 涨到 1/4,加速比会更剧烈地偏离步数比 。下一步真正的空间不在步数,而在把条件编码本身变便宜------比如更小的文本编码器,或者把条件预计算成可复用的缓存产物。
第三,厂商不公布 Turbo 分数这件事,本身就是信息。
基础版有 60.28 分,Turbo 一栏是 "Not disclosed"。在「速度提升 5 倍」这种卖点面前不放出质量对比,通常意味着对比不占优,或者至少不够稳定。在自己做质量回归之前,把 Turbo 当草稿工具而非成品工具,是最稳妥的定位。
第四,最值得盯的下一个信号是开源许可。
同一个团队手里就有 Apache 2.0 的 Z-Image-Turbo,而 Qwen-Image-2.1-Turbo 是研究许可。如果少步技术在开源许可下追平闭源 API 的出图质量,图像生成的成本结构会再断一次崖。 在那之前,API 侧 ¥0.1/张 的价格已经足够低,低到"自己买卡部署"这件事对大多数团队不再划算。
参考
- Qwen-Image-2.1-Turbo :Hugging Face / ModelScope 模型页,2026-10-09 发布。8 步 sigma 时间表、block-causal 注意力、Qwen3-VL 8B 文本编码器、64 通道 RGBA VAE、Flow Matching + 欧拉离散 + 动态 shift、
use_kv_cache=True前缀缓存、Diffusers PR #14950 依赖。 - Qwen-Image-2.1(基础版):GitHub QwenLM/Qwen-Image-2.1,40 步默认,最多 10 张参考图,Qwen-Image-Bench 60.28(厂商公布)。
- API 定价:阿里云百炼 qwen-image-2.1-turbo ¥0.1/张(120 RPM)、qwen-image-2.1-pro ¥0.25/张(20 RPM)。
- 同类蒸馏实践(用于说明普遍规律,非 Qwen 数据):Bria FIBO-lite 两阶段蒸馏(CFG 蒸馏 + Shortcutting Flow Matching,明确标注"轻微质量下降");腾讯 HunyuanVideo 1.5 模型蒸馏文档(CFG 蒸馏约 2×、步数蒸馏 50→8-12 步约 5×,12 步推荐、4 步质量略降)。
- 社区复现观察 :ComfyUI
#qwen-image频道,Kijai 关于固定欧拉时间表与随机采样器的评论(个人经验,非基准测试)。
说明:Qwen 未公布 Turbo 的独立 benchmark 分数,文中所有质量相关表述均已标注来源级别或明确声明为"未公开"。同类蒸馏的质量代价引用自 Bria 与腾讯的公开文档,用于说明该技术的普遍规律,不等同于 Qwen-Image-2.1-Turbo 的实测表现。配图为作者自制,其中成本构成图为示意性质,非精确算力模型。