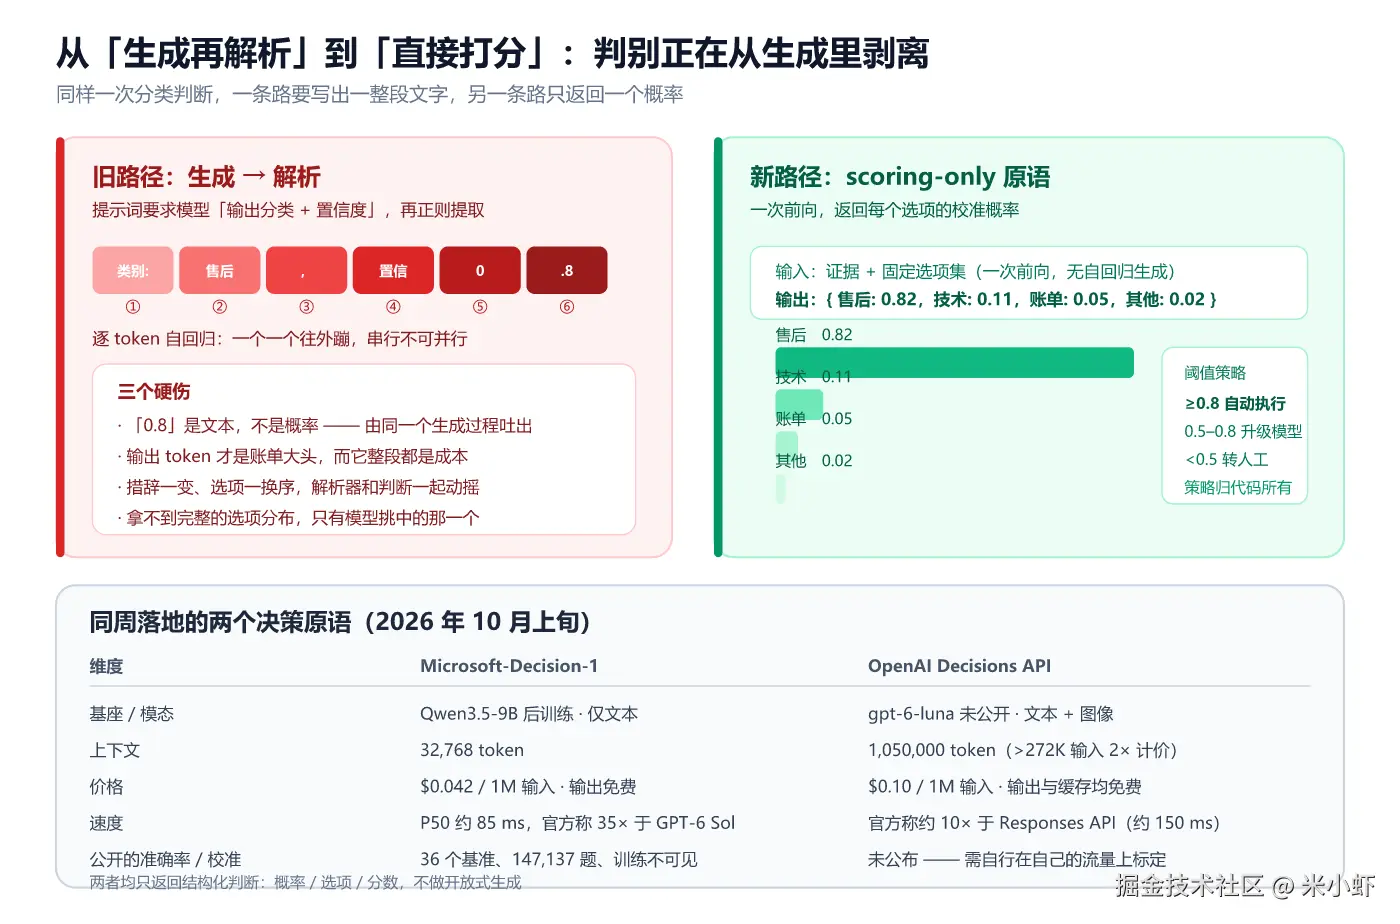
你想让模型判断一张工单属于哪个部门。 常规做法是写一段提示词:「请输出分类结果,并给出置信度」。 模型回一段话:
类别:售后,置信度:0.8。你再用正则把0.8抠出来。这段代码里藏着三个问题:那个 0.8 是文本不是概率 ,它和前后几个字出自同一个自回归过程; 你为整段输出付了 token 钱 ,而真正有用的只有两个词; 你拿不到完整的选项分布,只有模型最后挑中的那一个。
2026 年 10 月上旬,一周之内,两家大厂把这条链路换掉了:微软发布 Microsoft-Decision-1,OpenAI 把 Decisions API 推进公开 beta。它们都不生成文字,只返回概率。
一、旧范式的原罪:用生成模型干判别的活
把「分类」交给一个自回归语言模型,本质上是在用一把瑞士军刀拧螺丝。代价具体落在四处:
1. 输出是串行的。 模型要一个 token 一个 token 地把 类别:售后,置信度:0.8 蹦完。而分类任务本身不需要任何序列生成------答案是一个闭集里的概率分布。
2. 置信度是「说出来的」,不是「算出来的」。 模型写 0.8,和它写 售后 走的是同一套下一个 token 预测机制。这个数字没有义务与真实命中率对齐------它只是一段看起来像数字的文本。
3. 成本结构错位。 API 账单里输出 token 通常比输入贵数倍,而分类任务的价值密度极低:为一整句话付费,换回两个词。
4. 无法阈值化。 你拿到一个词和一个自称的置信度,但拿不到「技术 0.11 / 账单 0.05 / 其他 0.02」这个完整分布。没有分布就没法做「高于 0.8 自动执行、0.5--0.8 转大模型、低于 0.5 转人工」这类策略。
还有一个工程上更烦的:解析链路会漂移。 措辞一改、选项一换序、模型一升级,正则就失效。
二、新原语:一次前向,返回分布
Microsoft-Decision-1 的做法很直接:对 Qwen3.5-9B 做后训练,让它做单次通过的决策打分(single-pass decision scoring)。 给定一组固定选项,它为每个选项返回一个校准概率。
支持的形式(来自 Foundry 模型卡):
| 形式 | 说明 |
|---|---|
| yes / no | 布尔判断 |
| 选择题 | 从固定选项集中返回每个选项的概率 |
| 评分(rating) | 有序等级 |
| rubric 评分 | 对 AI 回答、对 Agent 提议的动作打分 |
| 依据核查 | 对照给定证据判断是否有据 |
| 显式弃权 | 提供「无法判断」这类选项 |
注意最后一行的 abstention。一个不能说「我不知道」的分类器,在生产里是危险的------这就是为什么「无法判断」必须是一个一等选项,而不是让模型硬猜。
OpenAI 的 Decisions API 把同样的想法收敛成三种问题类型(POST /v1/decisions,2026-10-06 进入公开 beta):
predicate  →  返回条件成立的概率(0 到 1)
choice     →  返回你给的选项中的一个值 + 每个选项的概率 + 一个 confidence 字段
score      →  对有序等级做概率加权平均
score 那个设计值得一提。官方例子:三个等级的概率分别是 0.1、0.7、0.2,返回 0×0.1 + 1×0.7 + 2×0.2 = 1.1。这个 1.1 落在「有变通方案」和「完全阻塞」之间------它把离散标签变成了连续量,于是阈值可以设在任意位置,而不是被标签粒度卡死。
微软和 OpenAI 都明确划了边界:需要任意 JSON 结构就用 Structured Outputs,需要模型请求工具就用 function calling。决策接口只管判断这一件事。
三、微软公开的三组数字
微软在公告里给了三组可验证的东西,值得拆开看。
速度
| 对比对象 | 结果 |
|---|---|
| GPT-6 Sol | P50 快约 35×(GPT-6 Sol 实测 3.01 秒) |
| H2O-Lightning-4B v1.1(次快) | 快约 2.5× |
| 官方换算 P50 | 约 85 ms,p95 约 125 ms |
有意思的是第三方实测对不上:OpenRouter 页面记录的 Azure 提供者 P50 延迟是 0.30 秒 ,比官方的 85 ms 高出三倍多。差额来自网络往返与路由开销,不是模型本身。这条差异本身就是有用的信息:决策模型的延迟优势很容易被调用链路吃掉------如果你的 20 步工作流每一步都要跨公网打一次 API,85 ms 会变成 300 ms,20 步就是 6 秒。
微软自己在公告里算过这笔账:给 20 个串行决策每步多加 100 毫秒,整条工作流就多 2 秒。
质量泛化
36 个基准、147,137 道题,全部对训练不可见;覆盖路由、排序、长上下文、多语言、分布外、推理与安全。微软还从公开榜单 JevBench 上取了几个头部模型,放到这 36 个基准上重测。
结果是 Microsoft-Decision-1 平均准确率 83.5% 领先,Quyet-1.0-Large 为 81.9%。
必须打的折扣:这些基准全部由微软自己跑。 被比较的六个模型(Quyet-1.0-Large、Surogate Rune 26B-A4B、GPT-6 Luna Decisions、deck-31B、H2O-Lightning-4B、Strands-Decider 2B)的分数也是微软测出来的。这是厂商自述,不是第三方复现。
鲁棒性(这一组最值得学)
微软的方法:把同一个请求做 8 种扰动,测判断翻转的比例。
扰动包括:措辞改写、选项描述变化、选项重排、键名变化、无害的格式噪声。
结果:
- 平均翻转率 1.3%
- 选项描述被改写时:0 次翻转
- 选项被反转或打乱时:0 次翻转
为什么要专门训这个?因为生产环境里,状态和指令会被改写、选项会被重排、键名会变------这些都不应该实质改变判断。 一个在选项顺序变化下会改变答案的分类器,等于没有答案。
顺带一提:校准分数是 92.2,略低于 Quyet-1.0-Large 的 93.1(厂商公布值)。最快的不一定是最准的,最准的也不一定校准最好------这三项本来就是独立的指标。
四、校准:概率是 API 的一部分,不是装饰
微软在公告里写了一句很关键的话:
概率本身是 API 的一部分,不只是一个排序分数。 应用用置信度来决定何时执行、何时推迟、何时请求复核,所以一个 90% 的预测,在代表性样本上应该大约 9 次对 1 次错。
这就是「校准概率」和「口头置信度」的分界线:校准是一个可以测量的性质,做法是把预测按概率分桶,看每个桶的真实命中率是否落在桶的中心附近。
OpenAI 那边恰好缺了这一块------它的文档明确没有公布 Decisions 端点的准确率或校准数据,只建议调用方「用自己应用流量里的标注样本来设定阈值」。
这个差异对工程决策影响很大:
校准概率可用  → 阈值即策略,模型给估计,代码拥有决策权
校准未知      → 阈值只能靠自己标数据标定,且每次换模型都要重标
如果概率没校准,你设的 0.8 阈值可能实际对应 60% 命中率------而这个错误会静默地一直错下去。
五、理想丰满,现实骨感:四类边界
1. 闭集是硬约束
所有任务必须表达成预先定义的选项或评分 rubric。开放式规划、自由写作、解释推理过程,全都不在射程内。微软的排除清单写得很清楚:不做开放式生成、对话、翻译、摘要。
这意味着你在系统设计阶段就得把决策点枚举出来。如果你的任务连选项都列不出来,说明它不是一个决策问题。
2. 涉人的重大决策被明令排除
Foundry 目录规则明确禁止将 Microsoft-Decision-1 用作涉及人的重大决策的唯一决策者。招聘筛选、信贷审批、医疗分诊------这些场景里它只能当辅助信号,不能当裁判。
3. 闭源权重 + 厂商自测
Microsoft-Decision-1 从开源的 Qwen3.5-9B 后训练而来,但权重不开放,只能通过 Foundry 或 OpenRouter 调用。所有基准都是厂商跑的。
OpenAI 那边更窄:目前只支持 gpt-6-luna 一个模型,beta 状态,图片必须是内联 base64(不支持 URL 或 file_id)。
4. 依赖依赖项的依赖
Turbo 类决策模型会持续更新权重(OpenRouter 页面写明「权重持续更新,API 形状保持不变」)。这对稳定性是好事,但也意味着你的阈值可能在某次静默更新后失效。解决方案只有一个:保留一份标注测试集,定期回归。
六、两个 API 的正面对比
| 维度 | Microsoft-Decision-1 | OpenAI Decisions API |
|---|---|---|
| 基座 / 模态 | Qwen3.5-9B 后训练 · 仅文本 | gpt-6-luna(未公开)· 文本 + 图像 |
| 上下文 | 32,768 token | 1,050,000 token(>272K 输入 2× 计价) |
| 价格 | $0.042 / 1M 输入,输出免费 | $0.10 / 1M 输入,输出与缓存读写均免费 |
| 速度(官方) | P50 约 85 ms,35× 于 GPT-6 Sol | 约 10× 于 Responses API(DevDay 口径约 150 ms vs 1.6 s) |
| 第三方实测延迟 | OpenRouter 记录 P50 约 0.30 s | 未见独立实测 |
| 准确率 / 校准 | 36 基准 × 147,137 题,83.5% 准确率、校准 92.2 | 未公布 |
| 状态 | GA(Foundry + OpenRouter) | 公开 beta,GA 预计数周内 |
| 合规 | --- | ZDR、HIPAA 可选;美欧数据驻留 |
选型直觉 :需要图像输入、超长上下文或合规数据驻留 → OpenAI;需要便宜、快、且有公开的准确率与校准数据 → 微软。两者都不是万能的,且都在文本侧之外留了缺口------微软没有多模态,OpenAI 没有公布质量数据。
七、生产现实:什么场景赚,什么场景亏
微软公开了四个内部落地,这四个案例比任何 benchmark 都有信息量:
| 场景 | 做法 | 结果(微软自述) |
|---|---|---|
| Xbox Research | 把 1 万多条玩家反馈归入研究者预设的主题 | 质量与 GPT-6 Sol 相当,快 14× ,便宜 200× |
| Copilot 质控 | 给对话与 Agent 回答打分 | 与 GPT5.6 Luna 相当,快 100× |
| 故障响应 | 从日志、工单、通话、消息里检索相关知识 | 优于并快于原 LLM 方案 |
| Microsoft Discovery | 用 rubric 给实验打分,驱动 Agent 自适应重规划 | 一致性 46× ,速度 3×,重规划环节快近 4× |
从这四个案例能提炼出判据:
赚的场景
- 决策点可以枚举成闭集(路由、分类、意图识别、合规筛查)
- 决策数量大、单次价值低(标注、内容过滤、搜索相关性)
- 决策在关键路径上且串行(Agent 的每一步守卫、自适应重规划)
- 下游需要阈值策略(自动执行 / 升级 / 转人工)
亏的场景
- 需要先解释再判断(决策模型不给推理过程)
- 选项集随输入动态变化且无法预先枚举
- 单次决策的输入极长,而输出侧节省微不足道
- 涉及人的重大决策(被明令排除)
一个容易被忽略的坑 :决策模型的价值在于高频。Xbox 那个案例便宜 200× 的前提是一次处理 1 万条。如果你的应用一天只做 50 次判断,省下的钱不够抵消新增一条链路的维护成本。
八、选型决策树
markdown
这个判断的候选答案能不能预先列全?
│
├─ 不能 ──→ 别用决策模型,回到生成 + 结构化输出
│
└─ 能 ──→ 下游需不需要「阈值 → 不同处置」?
           │
           ├─ 需要 ──→ 概率必须校准。你有没有自己的标注集?
           │             │
           │             ├─ 有 ──→ 上;上线前在自己的数据上跑校准曲线
           │             └─ 没有 ──→ 先标 200~500 条,否则阈值是拍脑袋
           │
           └─ 只需要一个标签 ──→ 便宜优先;但要测 8 种扰动下的翻转率
四条实践建议:
- 先测翻转率,再测准确率。 一个准确率 85% 但选项换序就翻答案的模型,比准确率 80% 但稳定的模型更危险。微软的 8 扰动方法可以照抄。
- 保留一份不参与指令编写的测试集。 OpenAI 文档自己就这么建议------用自己流量里的标注样本定阈值。
- 把弃权做成一等选项。 「无法判断」必须是可返回的答案,否则模型会在不确定时硬猜,而你会把它当确定值用。
- 模型答案与授权分离。 概率只是估计,阈值和动作归你的代码。这样换模型、调阈值都不用重写下游集成。
九、我的判断
第一,这是一次真正的分层,不是又一个模型发布。
过去两年我们习惯让一个模型干完所有事:理解证据、发明 schema、解释自己、触发动作。决策接口把这四件事拆开,让模型只交出一个可测量的估计,把策略交还代码。这个分层带来的好处是架构性的:概率可以校准、可以分桶监控、可以比较版本、可以不动下游就调阈值。
第二,最值得盯的指标不是准确率,是校准和翻转率。
准确率告诉你「平均对不对」,校准告诉你「0.8 是不是真的 80%」,翻转率告诉你「换个说法还稳不稳」。后两个才决定这个东西能不能上生产。目前只有微软公开了这两项,OpenAI 一项都没给。
第三,成本结构变了,但没变干净。
输出免费是真实的节省(微软 0.042/M输入、输出0;OpenAI $0.10/M 输入、输出与缓存均免费)。但延迟是新的瓶颈------官方 85 ms 和 OpenRouter 实测 0.30 s 之间那 220 ms,是网络与路由吃掉的。如果你在关键路径上串了 20 个决策,先算网络账,再算模型账。
第四,下一个信号是开源权重会不会跟上。
目前这个品类的玩家已经不少:Quyet-1.0-Large(Gemma-4-31B-it LoRA 合并,Apache-2.0)、H2O-Lightning-4B(Qwen3.5-4B,Apache-2.0)、deck-31B、Strands-Decider 2B、Surogate Rune 26B-A4B。两个 Apache-2.0 的存在说明这条路不依赖闭源。如果这个品类出现一个校准数据公开的开源权重模型,它才是真正能被放进生产关键路径的形态------因为权重固定,阈值才不会在静默更新后失效。
在那之前,决策模型最稳妥的用法是:让它做守卫和路由,别让它做终审。
参考
- Microsoft-Decision-1 官方公告:Microsoft Command Line,2026-10-09,作者 Achint Srivastava(Office of the CTO)。含 36 基准对比、8 种扰动鲁棒性测试、四个内部落地案例、被比较模型清单。
- Microsoft-Decision-1 定价与可用性:Microsoft Foundry 目录 / OpenRouter 页面。$0.042/1M 输入,输出免费,32,768 token 上下文,2026-10-09 上线。
- OpenAI Decisions API :OpenAI 开发者文档 Decisions 指南(
POST /v1/decisions),2026-10-06 进入公开 beta,仅支持 gpt-6-luna,三种问题类型 predicate / choice / score。 - 对比模型:Quyet-1.0-Large、Surogate Rune 26B-A4B、GPT-6 Luna Decisions、deck-31B、H2O-Lightning-4B、Strands-Decider 2B(微软公告附录列出)。
说明:本文中的准确率、延迟、校准、鲁棒性数字均为微软官方自述或 OpenAI 官方文档口径,未经第三方独立复现;OpenRouter 记录的实测延迟与微软官方口径存在差异,文中已并列给出。OpenAI 未公布 Decisions 端点的准确率与校准数据,文中已明确标注。配图为作者自制。