主从复制可以保存数据副本,但主库故障后,普通从库不会自动接管写请求。Redis Sentinel 负责监控实例、判断故障、选择新主库、重配复制关系,并向客户端提供当前主库地址。
Sentinel 提高的是故障恢复自动化程度。它不能让切换过程没有任何中断,也不能把异步复制变成强一致复制。
一、Sentinel 的职责与边界
Sentinel 主要承担四类工作:
- 监控:检查主库、从库和其他 Sentinel 是否可达。
- 通知:通过事件和 API 报告实例状态变化。
- 自动故障转移:主库被确认故障后,提升合适的从库。
- 服务发现:告诉客户端当前主库和从库地址。
Sentinel 不是代理服务器。业务命令不会经过 Sentinel 转发,客户端仍然直接连接 Redis 数据节点。
Sentinel 适用于一个主库及其从库组成的复制组。Redis Cluster 自带分片和故障转移机制,不使用 Sentinel 管理 Cluster 主节点。
二、最小配置表达了什么
典型配置:
conf
sentinel monitor mymaster 10.0.0.10 6379 2
sentinel down-after-milliseconds mymaster 10000
sentinel failover-timeout mymaster 180000
sentinel parallel-syncs mymaster 1mymaster是复制组的逻辑名称,客户端通过它查询当前主库。10.0.0.10 6379是初始主库地址,不是永久不变的地址。2是判断主库客观下线所需的quorum。down-after-milliseconds是单个 Sentinel 判断实例不可达的时间阈值。failover-timeout参与控制故障转移重试和状态超时。parallel-syncs限制故障转移后同时重新同步到新主库的从库数量。
Sentinel 会自动发现从库和其他 Sentinel,并重写自己的配置文件。配置目录必须可写,否则拓扑变更无法可靠持久化。
三、主观下线与客观下线
1. 主观下线 SDOWN
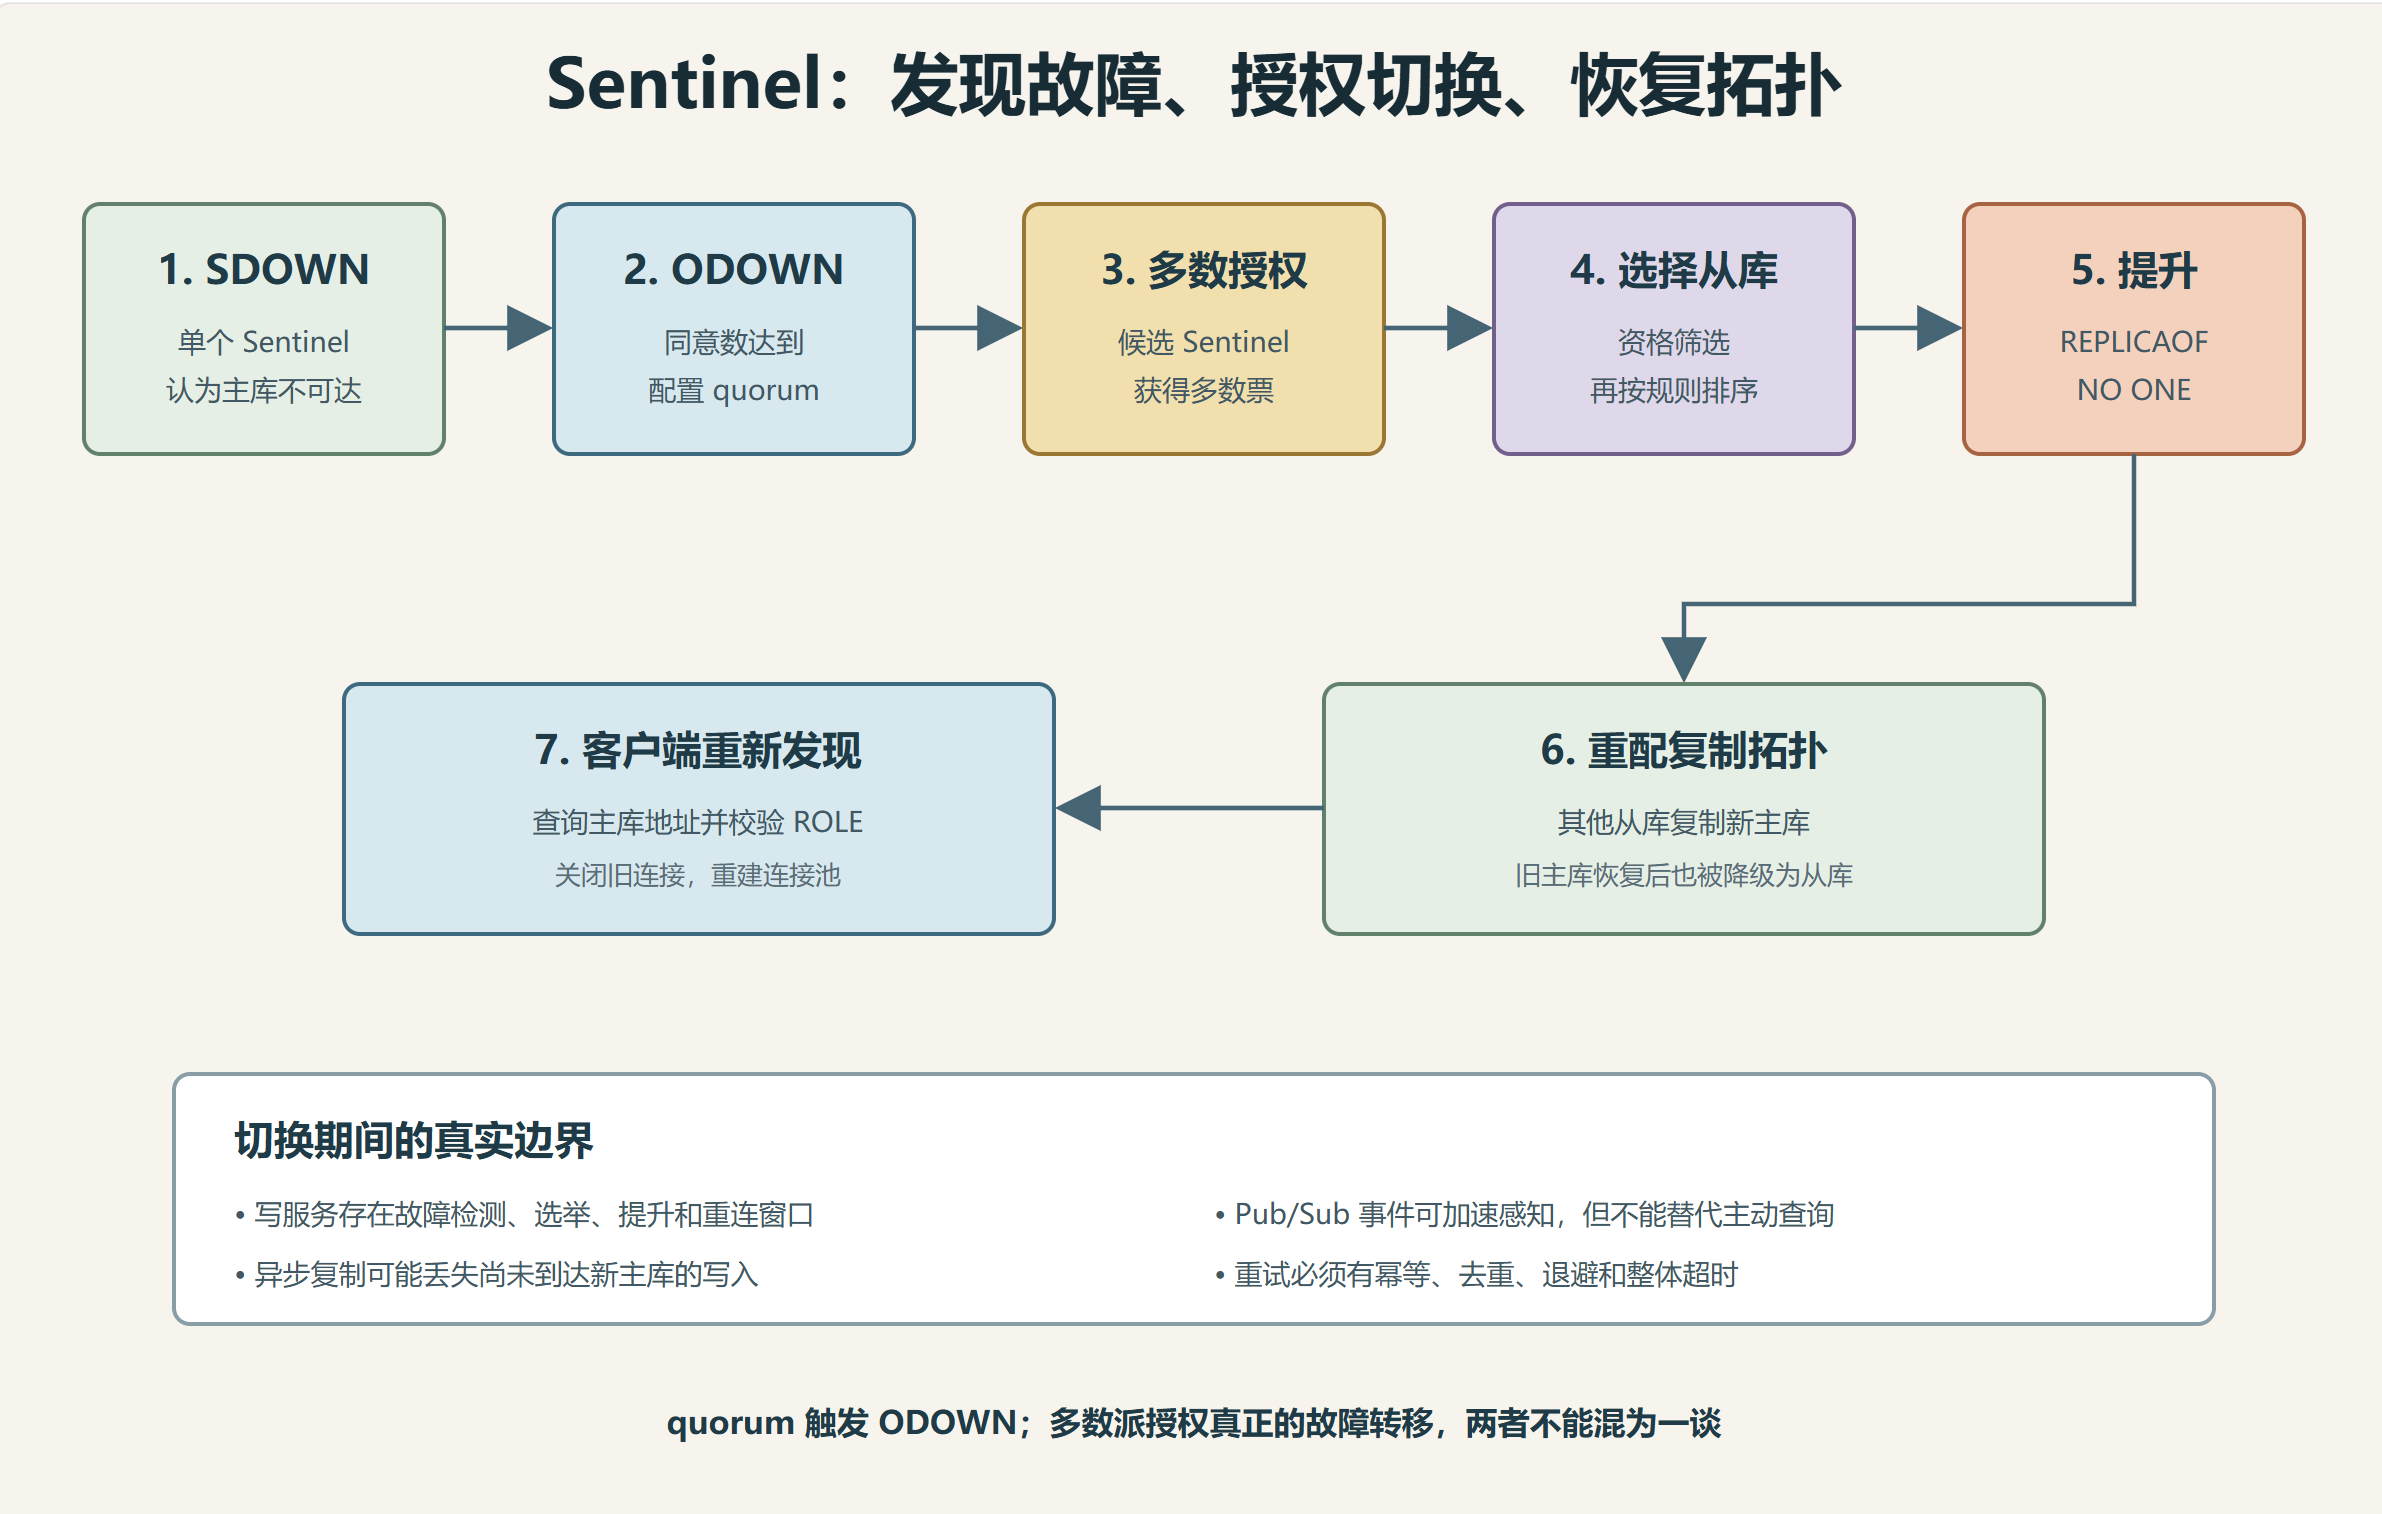
每个 Sentinel 独立向被监控实例发送 PING 等命令。如果一个实例持续超过 down-after-milliseconds 无法正常响应,这个 Sentinel 会把它标记为主观下线(Subjectively Down,SDOWN)。
SDOWN 只代表一个 Sentinel 的本地判断。原因可能是真实宕机,也可能是:
- Sentinel 自身网络故障。
- Sentinel 与主库之间的链路分区。
- 主库事件循环长时间阻塞。
- 宿主机调度停顿或网络拥塞。
从库或其他 Sentinel 被判定 SDOWN,不会触发主库故障转移。只有主库需要进一步形成客观判断。
2. 客观下线 ODOWN
某个 Sentinel 判断主库 SDOWN 后,会询问其他 Sentinel 是否也认为主库不可达。当同意数量达到该主库配置的 quorum,主库会被标记为客观下线(Objectively Down,ODOWN)。
需要特别区分:
quorum决定何时进入 ODOWN。- 真正授权执行故障转移,还必须获得 Sentinel 总数的多数票。
例如有 5 个 Sentinel,quorum = 2:
- 两个 Sentinel 同意,就可以触发 ODOWN。
- 但至少三个 Sentinel 可达并完成授权,故障转移才能真正执行。
因此,quorum 配得小可以更敏感地发现故障,但无法绕过多数派安全限制。
四、为什么通常部署奇数个 Sentinel
三个 Sentinel 可以容忍一个 Sentinel 故障后仍保留两票多数;五个 Sentinel 可以容忍两个故障后仍保留三票多数。
两个 Sentinel 即使把 quorum 配成 1,真正执行故障转移仍需要两票多数。任意一个 Sentinel 不可达时,自动切换就无法获得授权。
奇数部署不能消除网络分区,但可以在相同节点数下更有效地形成多数派。Sentinel 应分布在独立故障域,而不是全部部署在同一台机器或同一宿主机上。
五、故障转移由哪个 Sentinel 执行
ODOWN 形成后,Sentinel 会进行一轮领导者授权:
- 候选 Sentinel 请求其他 Sentinel 授权自己执行本轮故障转移。
- 每个 Sentinel 在一个配置纪元中只投一次票。
- 候选者需要获得多数票;如果配置的
quorum大于多数票,还需要达到更高的quorum。 - 获得授权的 Sentinel 使用唯一配置纪元执行切换。
如果本轮没有候选者获得足够票数,Sentinel 会等待后重新尝试。网络拥塞、时钟跳变和节点暂停都会延长切换时间。
这里的领导者不是永久主 Sentinel。它只负责某个主库的一次故障转移,其他 Sentinel 仍持续监控并传播最新配置。
六、怎样选择新主库
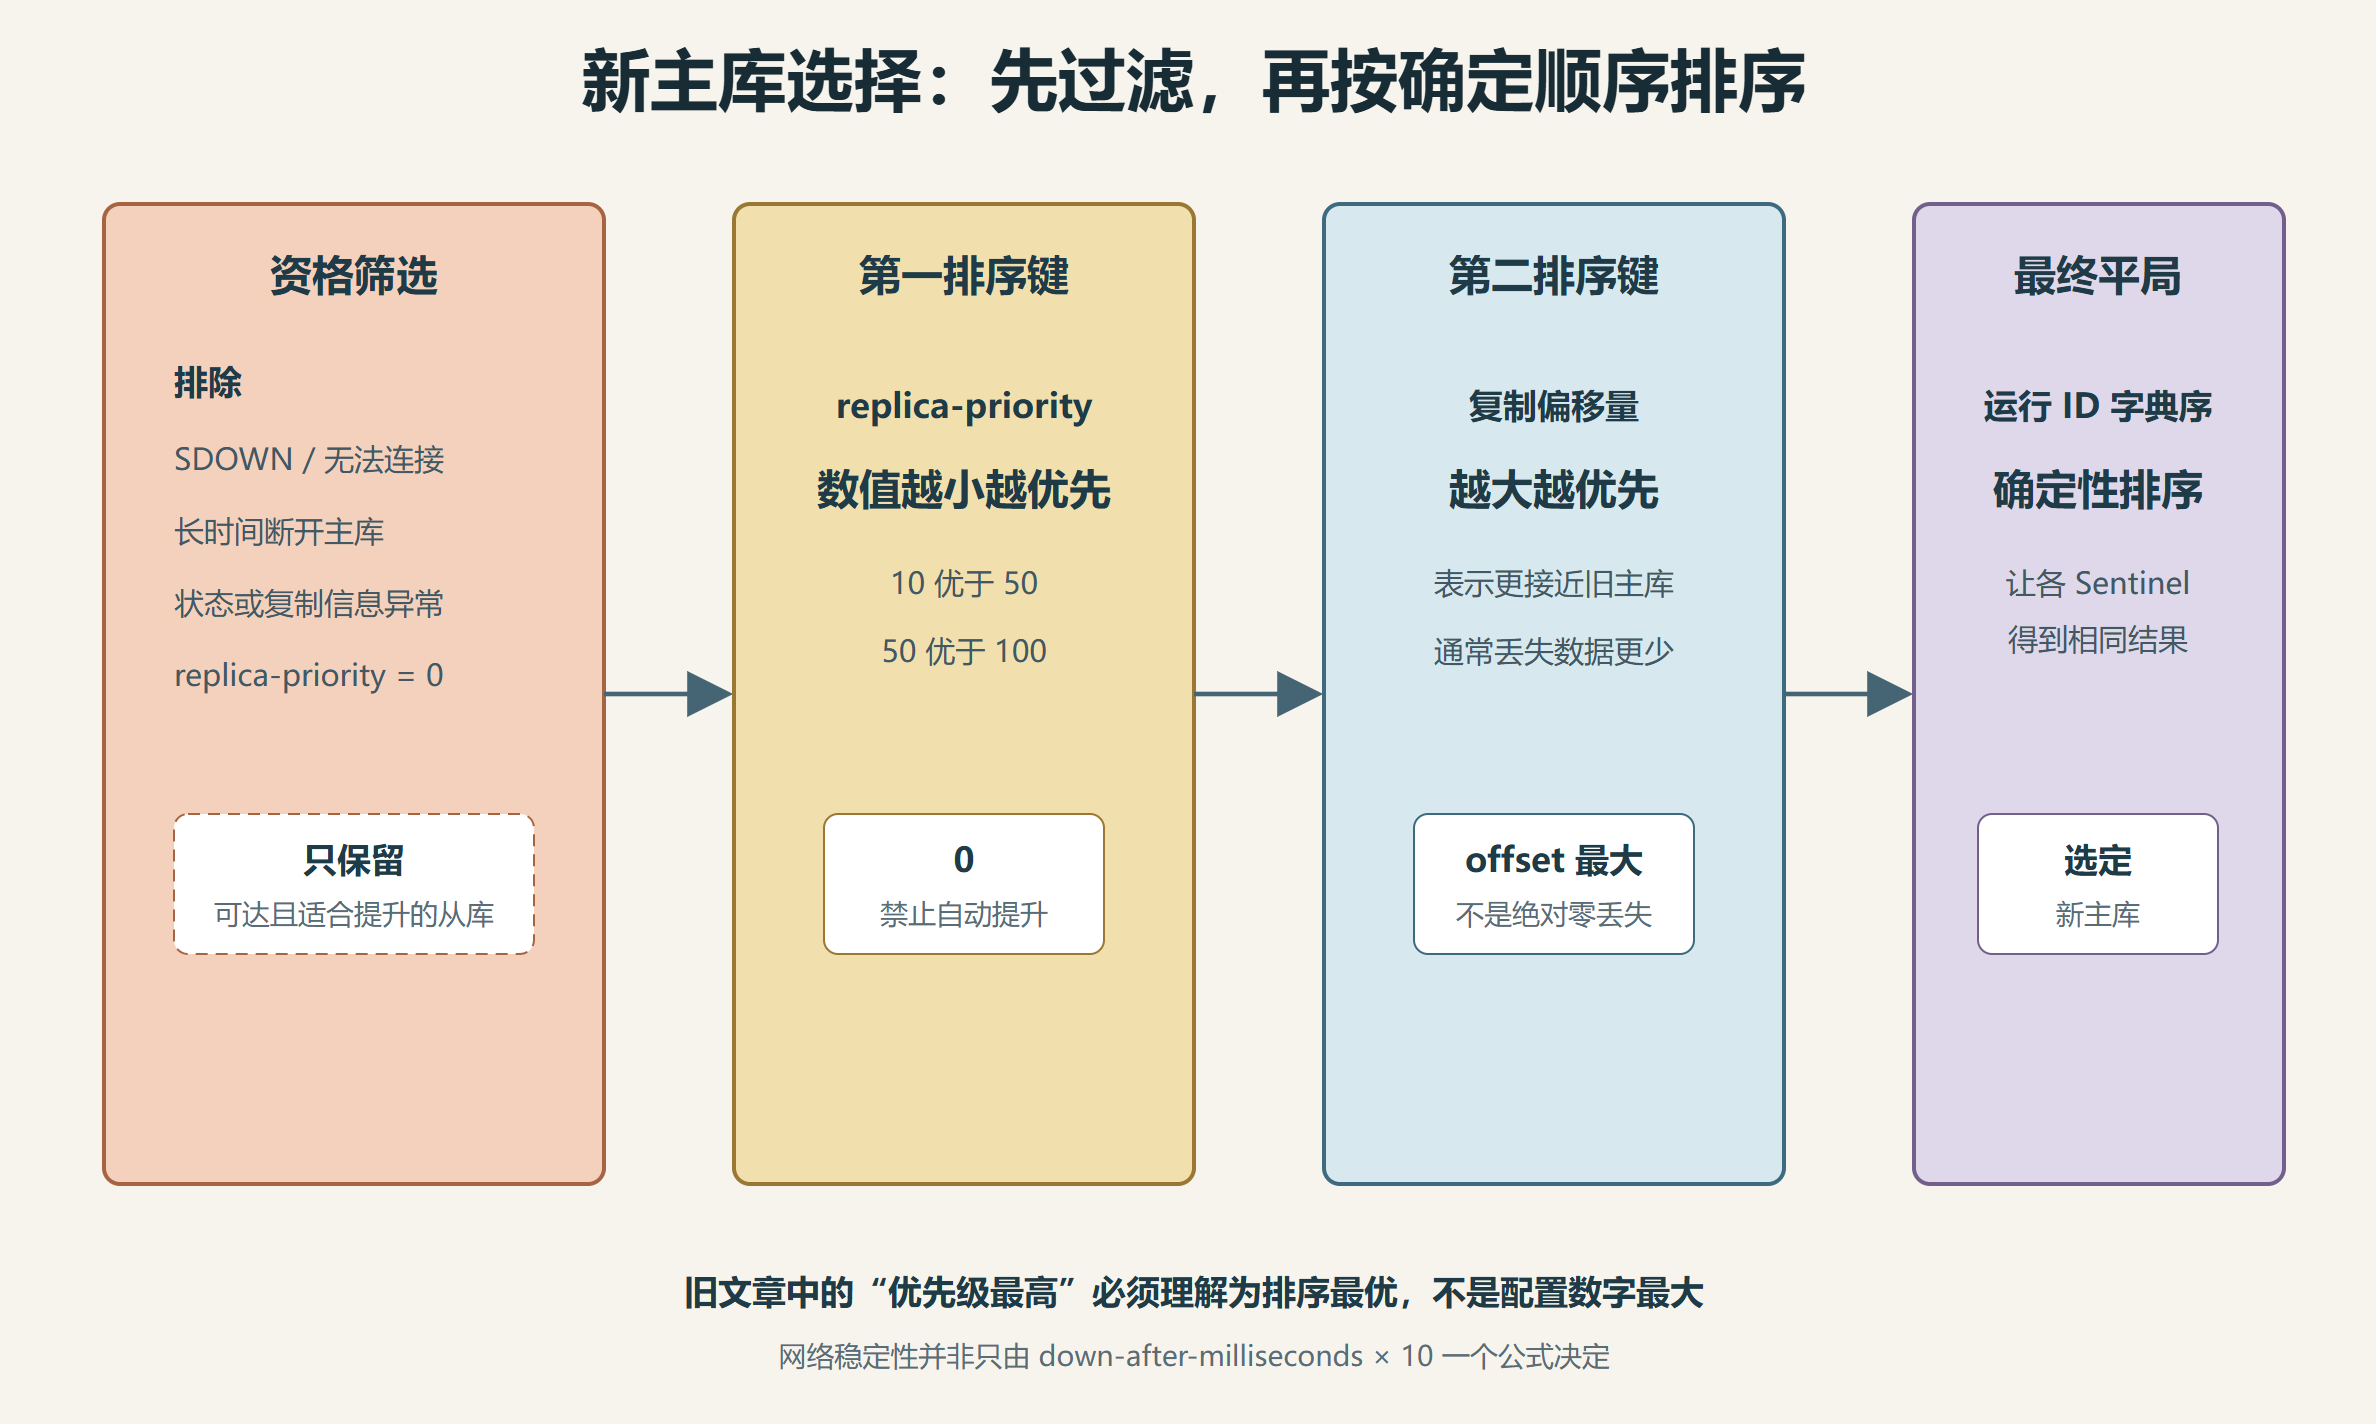
Sentinel 不会随机选择从库。流程可以分成资格筛选和有序排序。
1. 先排除不合格从库
常见排除条件包括:
- 从库被当前 Sentinel 判断为 SDOWN,或复制连接、角色和状态不满足提升条件。ODOWN 是针对主库形成的客观下线判断,不应套用到普通从库筛选上。
- 长时间与旧主库断开,复制状态不可信。
- 从库优先级为
0,明确禁止被提升。 - 实例状态、复制信息或网络连接不满足提升条件。
旧文章常把断连过滤简化为 down-after-milliseconds × 10。实际源码还会结合主库下线持续时间、复制链路状态和故障转移上下文,不应把单个乘法公式当作完整规则。
2. 按优先级排序
配置:
conf
replica-priority 100数值越小,提升优先级越高。 0 表示永不参与自动提升。
这与"数字越大优先级越高"的直觉相反,配置时必须特别注意。
3. 比较复制偏移量
优先级相同时,复制偏移量更大的从库通常拥有更新的数据,会排在前面。这可以减少故障转移造成的数据丢失,但无法恢复尚未复制到任何从库的写入。
4. 使用运行 ID 字典序打破平局
优先级和复制偏移量都相同时,Sentinel 使用实例运行 ID 的字典序打破平局,使多个 Sentinel 能得出一致结果。运行 ID 会在实例重启后变化,它只是确定性平局规则,不应被当成可配置的业务优先级。
七、提升与重配复制关系
负责故障转移的 Sentinel 会执行:
- 向目标从库发送
REPLICAOF NO ONE。 - 通过
INFO/ROLE确认它已经成为主库。 - 发布新的主库配置和配置纪元。
- 让其他从库执行
REPLICAOF <new-primary> <port>。 - 旧主库恢复后,把它重配置为新主库的从库。
当新主库提升成功后,Sentinel 就可以把故障转移视为成功;其他从库可能仍在重新同步。parallel-syncs 越小,同时重同步的从库越少,业务可用副本受影响的范围通常更小,但整个拓扑恢复更慢;越大,恢复更快,却可能同时有更多从库处于旧读、返回错误或加载 RDB 的状态,具体行为还受从库版本与 replica-serve-stale-data 等配置影响。
八、切换期间客户端会发生什么
Sentinel 故障转移包含故障检测、ODOWN 协商、授权选举、从库提升和客户端重连,写服务一定存在中断窗口。
客户端可能遇到:
- 原主库连接超时或断开。
- 向旧主库写入时报只读、连接或角色错误。
- Sentinel 尚未形成新配置。
- 连接到已过期地址。
- 请求结果不确定:服务端可能已执行,但响应在断线中丢失。
客户端不能简单地把失败写入缓存后立即向业务返回成功,除非这些请求已经进入另一个可靠、可恢复的持久化队列。否则客户端自身崩溃会让"已确认"的写入永久丢失。
正确策略是:
- 使用支持 Sentinel 的客户端和连接池。
- 配置多个 Sentinel 地址和复制组名称,而不是硬编码主库 IP。
- 连接失败后重新向 Sentinel 查询当前主库。
- 用
ROLE或INFO replication校验目标实例确实是主库。 - 关闭连接池中的旧连接,重建到新主库的连接。
- 对可重试写操作使用幂等键、请求 ID 或业务去重。
- 设置有界重试、退避和整体超时,避免切换期间形成重试风暴。
九、客户端如何发现当前主库
Sentinel-aware 客户端使用:
text
SENTINEL get-master-addr-by-name mymaster典型流程是:
- 依次尝试配置的 Sentinel 列表。
- 查询复制组当前主库地址。
- 连接目标 Redis 并执行
ROLE验证角色。 - 发生断线时重新从 Sentinel 开始解析,而不是盲目重连旧 IP。
- 可使用
SENTINEL SENTINELS刷新本地 Sentinel 地址列表。
Sentinel 的 +switch-master 等 Pub/Sub 事件适合监控和加速感知,但 Pub/Sub 不保存历史,客户端断线时可能漏掉事件。因此,事件订阅不能替代主动服务发现和角色校验。
十、旧主库恢复为什么仍有风险
旧主库与多数派失联时,可能仍接受客户端写入。另一侧 Sentinel 多数派又提升了新主库,于是短时间内出现两个可写节点,也就是脑裂窗口。
旧主库重新连接后会被降级为从库,并用新主库数据覆盖自身状态。在旧主库孤立期间写入、但没有传播到新主库的数据可能丢失。
可以使用:
conf
min-replicas-to-write 1
min-replicas-max-lag 10
限制主库在没有足够健康从库时继续写入,缩小脑裂写入窗口。但它依赖 ACK 和时间阈值,不能提供严格的同步一致性。
十一、关键配置怎样取舍
down-after-milliseconds
过小:网络抖动、长命令或宿主机暂停容易触发误判。
过大:真实故障发现慢,写服务中断时间增加。
应根据网络 P99/P999 延迟、Redis 尾延迟、运维暂停时间和业务 RTO 压测,而不是机械设置成几秒。
failover-timeout
影响故障转移重试、同一主库再次发起故障转移的等待和从库重配置节奏。设置过小会让正常但较慢的同步不断被判失败;设置过大则会拖慢失败恢复。
parallel-syncs
控制故障转移后同时向新主库同步的从库数。需要在拓扑恢复速度、主库资源压力和可读副本数量之间取舍。
十二、如何监控 Sentinel
常用命令:
text
SENTINEL MASTER mymaster
SENTINEL REPLICAS mymaster
SENTINEL SENTINELS mymaster
SENTINEL CKQUORUM mymaster
SENTINEL GET-MASTER-ADDR-BY-NAME mymaster
重点检查:
flags中是否存在s_down、o_down。- 当前已知 Sentinel 数和可达多数派。
- 从库数量、复制延迟与提升优先级。
last-ok-ping-reply、s-down-time、o-down-time。config-epoch和当前主库地址是否在各 Sentinel 间收敛。- Sentinel 配置文件是否可写、重写是否成功。
+sdown、+odown、+try-failover、+elected-leader、+switch-master、-failover-abort-*等事件。
SENTINEL CKQUORUM 可以检查当前可达 Sentinel 是否同时满足 ODOWN quorum 和故障转移多数派要求,适合上线和故障演练前检查。
十三、Sentinel 检查清单与答案
1. quorum = 2 是否表示两个 Sentinel 就一定能完成切换?
**不一定。**它只表示两个 Sentinel 可以形成 ODOWN。真正执行故障转移仍需要 Sentinel 总数的多数授权。
2. 从库优先级数字越大是否越容易被提升?
不是。 replica-priority 数字越小越优先,0 表示禁止提升。
3. Sentinel 是否让写服务完全无中断?
**不能。**故障检测、选举、提升和客户端重连都需要时间。
4. 客户端只订阅 +switch-master 是否足够?
**不够。**Pub/Sub 事件可能丢失。客户端必须能主动查询当前主库并校验角色。
5. Sentinel 是否会代理业务请求?
**不会。**客户端直接连接 Redis 数据节点,Sentinel 只提供监控、切换和服务发现。
6. 旧主库恢复后是否会自动成为主库?
**不会。**它通常会被重配置成新主库的从库,孤立期间未同步的写入可能被覆盖。
7. 三个 Sentinel 都部署在同一台主机是否具备三节点容错?
**不具备。**主机、机架或网络故障会同时带走全部 Sentinel。必须跨独立故障域部署。
十四、核心结论
Sentinel 故障转移可以概括为:
- 单个 Sentinel 超时后形成 SDOWN。
- 达到
quorum后形成 ODOWN。 - 获得多数派授权的 Sentinel 执行本轮切换。
- 按资格、低数值优先级、高复制偏移量和运行 ID 字典序选择新主库。
- 提升新主库并重配置其他从库。
- Sentinel-aware 客户端重新发现地址、校验角色并重建连接。
真正的高可用不只取决于 Sentinel 数量,还取决于故障域分布、复制延迟、客户端重试语义、脑裂保护、持久化和定期故障演练。