感知这个词,在这门技术里和另一个词始终缠在一起,就是遥感。遥感是个模糊的词,和哲学差不多,没有明确的定义,所以不同的人给不同的定义,谁也不能说别人错。定义可以各说各的,不影响它做事。
一、感知与遥感
摄影测量与遥感学会给的定义落在不接触三个字上:用某种装置,在与被观测对象不发生物理接触的前提下,取得关于它的信息。信息的来源有两类,一类是对象自己在辐射,一类是对象在反射别的辐射。定义里说的对象也不限于物,现象也算在内,所以遥感既探物,也探事。
地理信息行业的定义松得多,直接把遥感说成对地球表面的远距离观测,把地球表面或者环境当作被观测的对象。还有人把它压成一句话:用电磁波探测目标,就是遥感。这句话粗,边界却清楚,因为光也是电磁波,光学遥感和微波遥感就一起进了同一个框架。
读文献碰到遥感这个词,先看是谁在什么语境下说的。不同领域的人对同一个词的宽容度不一样,口径不对齐,讨论容易走岔。
二、主动与被动的分野
把视角换一下,站到传感器的位置上,用第一人称看。
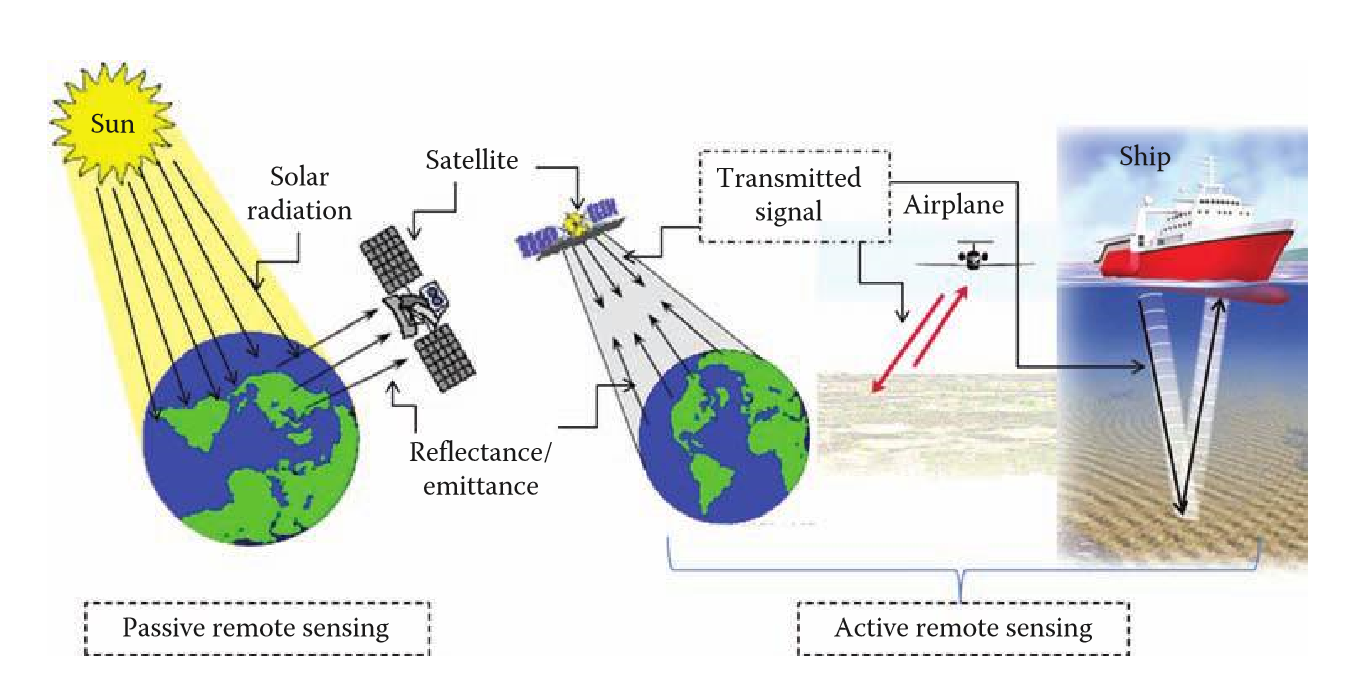
主动的意思是,传感器想观测就能观测,因为它自己发信号、自己收信号,不受制于人。被动正好相反,传感器只能接住别人已有的东西。光学是被动的,靠的是太阳,光照条件不满足就什么都看不见,前面挡一块板子就看不见了。
被动的极端例子是中微子。不是谁朝着地球发中微子,是它自己从星系核里穿过来,几乎不和任何物质反应,探测的人只能等着它撞上物质。
两者的代价和好处都很清楚。主动不受制于人,但要发信号,要暴露自己。被动不发信号,对军用设备来说这件事的意义极大,只潜伏在那里观测,不暴露自己。
被动要解决的痛点,是不受制于外辐射源。这个痛点有一个很直白的类比:南北极有极昼的那段时间,太阳一直挂在天上,什么时候都能看。外辐射源足够多、足够密,被动感知也能随时工作。雷达里外辐射源够不够,决定了被动这条路能不能立起来。外辐射源雷达本身就是很早就成熟的体制,广播、电视、通信基站的信号都可以拿来用,现在多出来的这批低轨卫星信号,只是把可用的辐射源从地面推到了天上。
主动与被动的差别主要在体制和约束条件上,观测条件一旦成立,信号进来之后的处理流程是同一套。成像算法尤其如此,被动成像用的还是主动成像那一套算法,区别只在参考信号从哪来。
图源:据讲者随堂讲义整理(原图出处未标注)
三、遥感的头一百年
光学这一支的历史最长。最早的那张照片出自法国人之手,1826 年前后,曝光要几个小时,拍的是窗外的屋顶和院子。
相机后来被装到气球上,从空中俯拍城市,得到的影像第一次显示了城市从地面看不见的格局。再往后相机被送到火箭上,越过大气层,第一次从太空回望地球。
1957 年苏联把第一颗人造卫星送上天。三年之后,美国用一颗小卫星完成了第一次从卫星平台的对地观测,影像还很模糊。
从 1960 年代到 1980 年代,各国陆续把光学载荷送上去,这份名单越往后越长,美国、苏联、欧洲空间局、日本、加拿大,一家接一家。气象、资源、海洋、军事各有各的线,轨道的选择跟着任务走:气象要反复观测同一个地区,就上极轨和静止轨道;资源普查要细节,就把轨道高度压低。
中国的时序短一些。第一颗人造卫星 1970 年上天,第一颗极轨气象卫星风云一号要到 1988 年才发射。第一颗气象卫星是 1960 年上去的,两个年份之间隔了 28 年。
这个 28 年有技术上的后果。起步的早晚会一路拖下去,因为载荷、平台、数据链路、地面处理是一条完整的链,前面缺一环,后面补不上。光学卫星如此,微波卫星更明显。
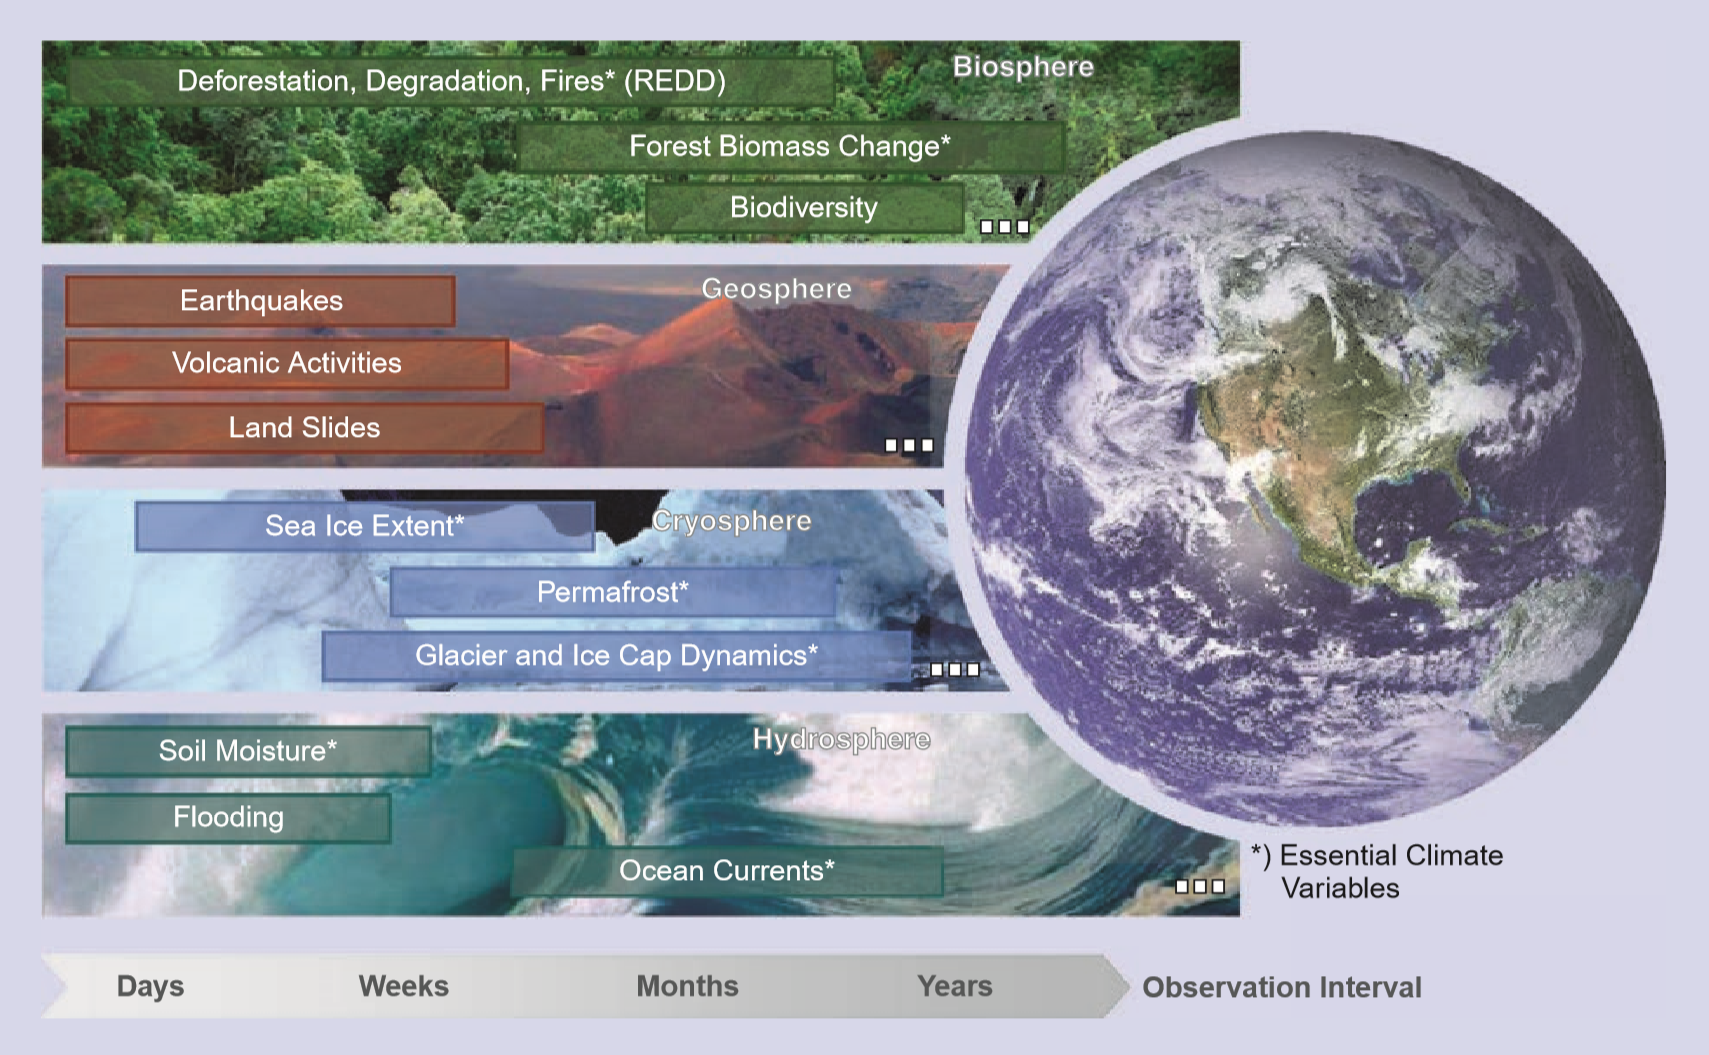
到 2016 年前后,天上的对地观测载荷已经是不同频率、不同模态、不同轨道的一整套东西,观测周期从两三天覆盖到两三年。识别一次地震前兆要按天算,看一座城市的下沉要按年算,尺度不同,对数据保存时长的要求也不同。
早年遥感还被当作一种艺术形式看待,第一批航拍照片里有相当一部分的用途,就是让人看看城市长什么样。早期影像的判读全靠人眼,影像上有什么、是什么,都要凭经验去认,把影像变成数字再在数字上做统计和分类,是很久以后的事。
图源:据讲者随堂讲义整理(原图出处未标注)
四、微波遥感比光学难在哪
光学遥感先被做出来,所以这一行的人对光学最熟。
遥感卫星用的频段都是有名字的:P 波段 0.3 到 1 GHz,L 波段 1 到 2 GHz,S 波段 2 到 4 GHz,C 波段 4 到 8 GHz,X 波段 8 到 12 GHz,Ku 波段 12 到 18 GHz,K 波段 18 到 27 GHz,Ka 波段 26.5 到 40 GHz。频率越高,波长越短,同口径下能分辨的细节越多,大气和降雨带来的衰减也越重。选哪个频段,就是在分辨力和穿透力之间做交换。
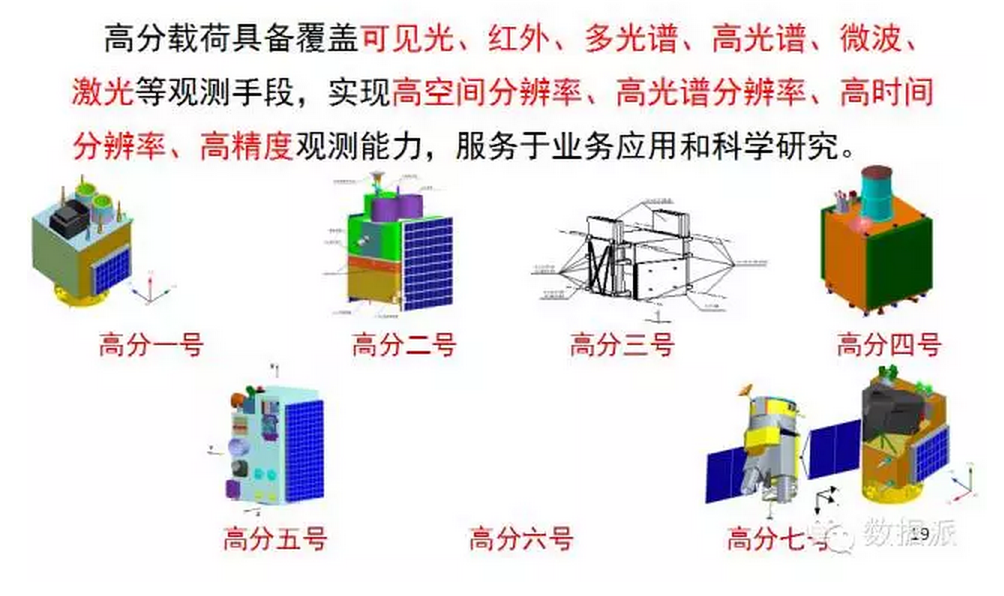
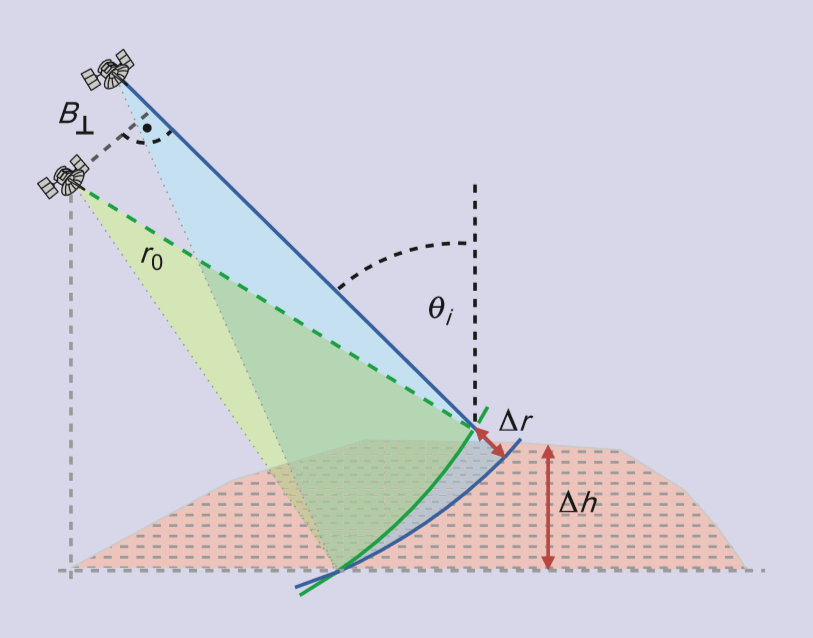
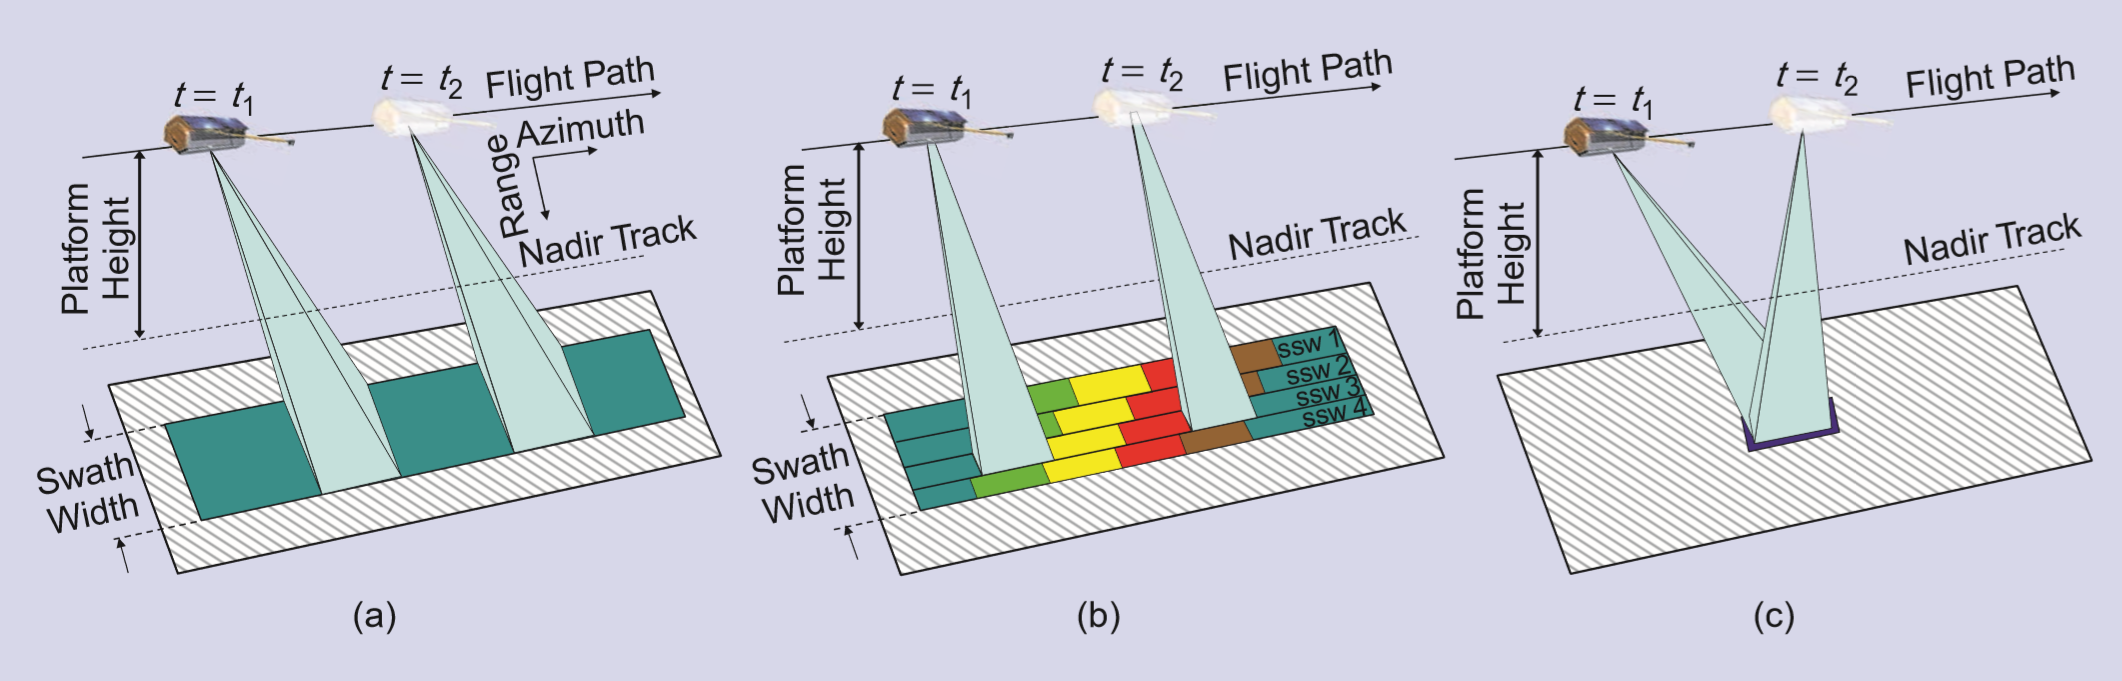
中国的微波载荷空了很长时间。高分一号、二号都是光学,一直到 2016 年高分三号带着 C 波段合成孔径雷达上天,这块空白才补上。四号是 2015 年前后发射的,仍然走光学。光学载荷能先做出来,微波载荷要再等好几年,这是微波比光学难的最直接证据。波长长还带来另一个难处,同样的物理孔径在微波上对应的波束宽得多,要靠波束去分辨细节就得把孔径做大,合成孔径就是从这里来的。
难在集成度和系统复杂度。微波载荷要把发射、接收、定标、数据处理连成一整套,还要和平台的供电、热控配合,每一环的要求都比光学载荷更硬。同一个平台上,光学载荷拍完就能下传,微波载荷还得先把回波变成图像,这个转换本身吃掉大量算力和时间。
图源:据讲者随堂讲义整理(原图出处未标注)
五、平台、链路与数据的层级
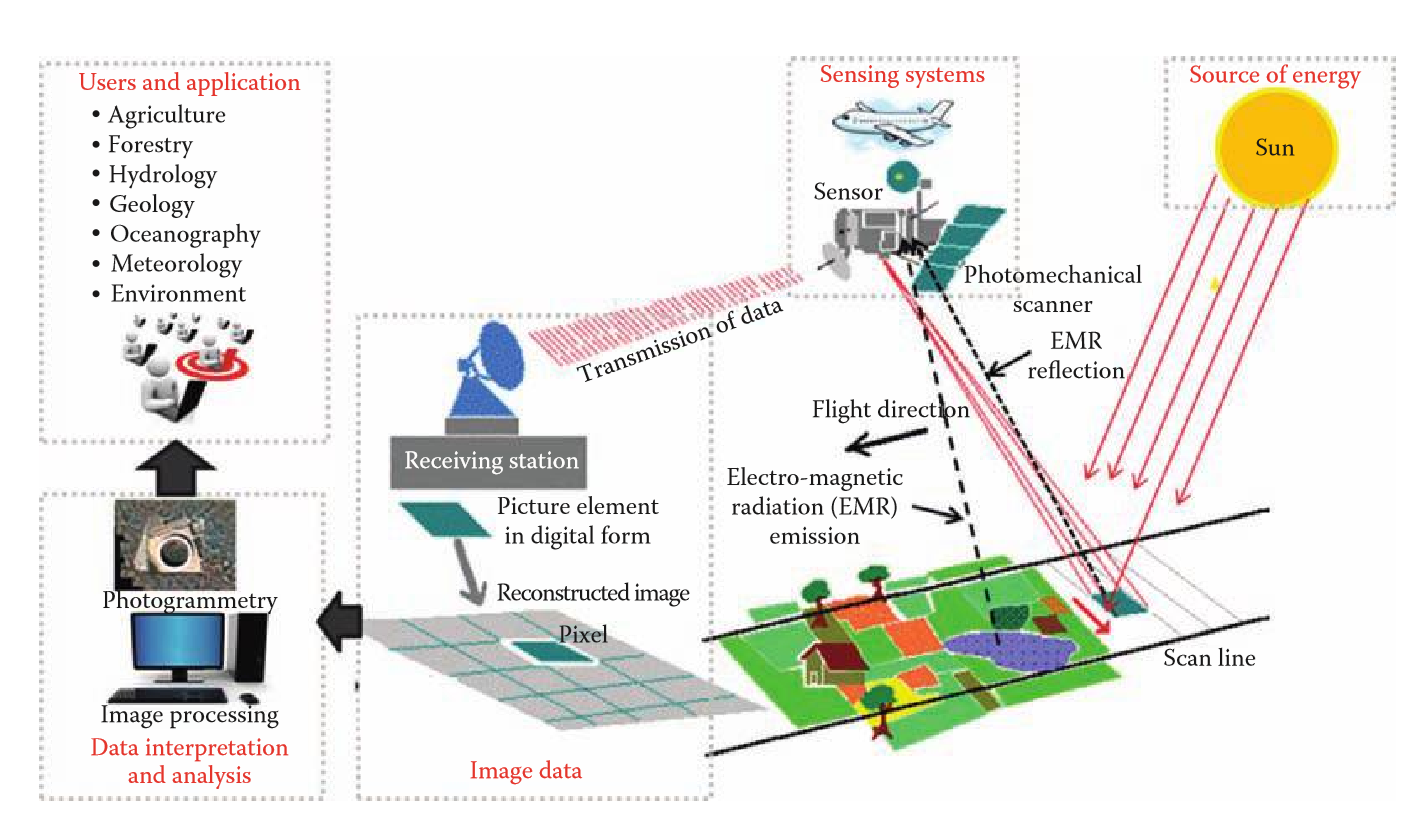
平台决定传感器的叫法。放在地面叫地基,装在飞机上叫机载,放在卫星上叫星载,装在导弹上叫弹载。换个平台只是换个约定,事情本身是同一件,变的是尺寸、供电和观测几何。不同平台要解决的问题也不一样,机载要求体积小、重量轻,星载要求供电和数据回传能力跟得上,地基没有这些约束,可以把设备做大、把算力堆厚。同一套方法换到另一个平台上,往往要重新做一遍设计。
数据要回到人手上。人在地面,数据在天上,中间必然有一段星地链路。原始数据也好,经过层层处理的数据产品也好,都得通过这条链路下传。链路是双向的,数据往下走,指令和状态往上走,地面站与平台相互配合。
数据是分层级的,从 level 0 排到 level 9,越往上越是产品。下行收到的原始数据是 level 0,做完辐射定标和几何校正往上一层,做成标准产品再往上一层。层级越高,体量反而越小,因为处理的过程中信息被压成了指标。检查处理前的数据与已经形成产品的数据是两码事,混在一起谈会出问题。
终端这一环今天变了。手机上的 AI 工具人人都在用,遥感领域也在往终端侧放模型。可穿戴设备能读出呼吸和心跳,同样的思路往下推,人在广场上走,动作、行为、呼吸、心跳都可以被不接触的传感器读到。这类能力用在什么地方是另一个层面的问题。
感知要拿走的是不接触条件下的目标或环境信息,再从这些信息里推断目标是什么、在做什么。往大处走是空间探测与资源勘探,往小处走是生物医学与安全检查,采集、下传、处理、分发这一套结构不变,换个对象就是一门新的应用。
图源:据讲者随堂讲义整理(原图出处未标注)
六、分辨率的四个坐标
遥感里讲分辨率,习惯拆成四个坐标一起看。空间分辨率是地面采样距离,也就是图像上能分开的最小地面细节,Gonzalez 与 Woods 在 2002 年的著作里就是这么定义的;同一景里,采样间隔可以比系统本身能达到的空间分辨率还细,量级从不足一米到几十米都有,Shaw 与 Burke 在 2003 年给过范围。谱分辨率说的是能分多少个波段、每个波段有多宽,波段分得越细,越能把不同地物的光谱指纹区分开。辐射分辨率是传感器对入射反射率的灵敏度,落到工程上就是对回波强度做几位量化,常见的是 8 位,也就是 256 级。时间分辨率是同一地区被重复观测一遍的周期,周期越短,越能抓住变化快的过程。
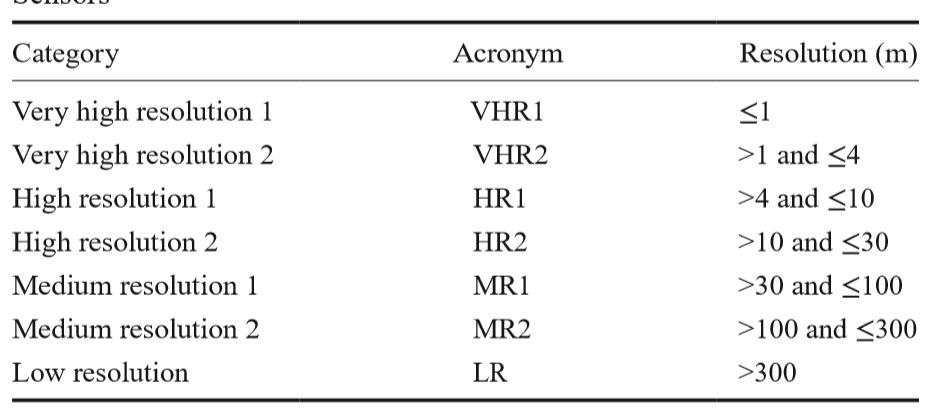
图源:据讲者随堂讲义整理(分级依据 Shaw & Burke, 2003)
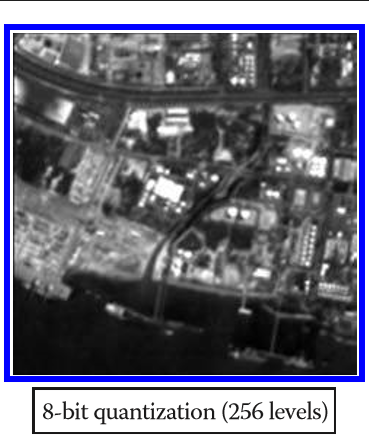
图源:据讲者随堂讲义整理(ESRI GIS Dictionary, 2014)
把这四个坐标放在一处才完整。空间分辨率越高,看到的细节越多,但覆盖面积和重访周期往往要让步;时间分辨率高,意味着能盯住变化,但单景的细节要妥协。谱和辐射决定的,是能不能把地物认准、把强弱分清。
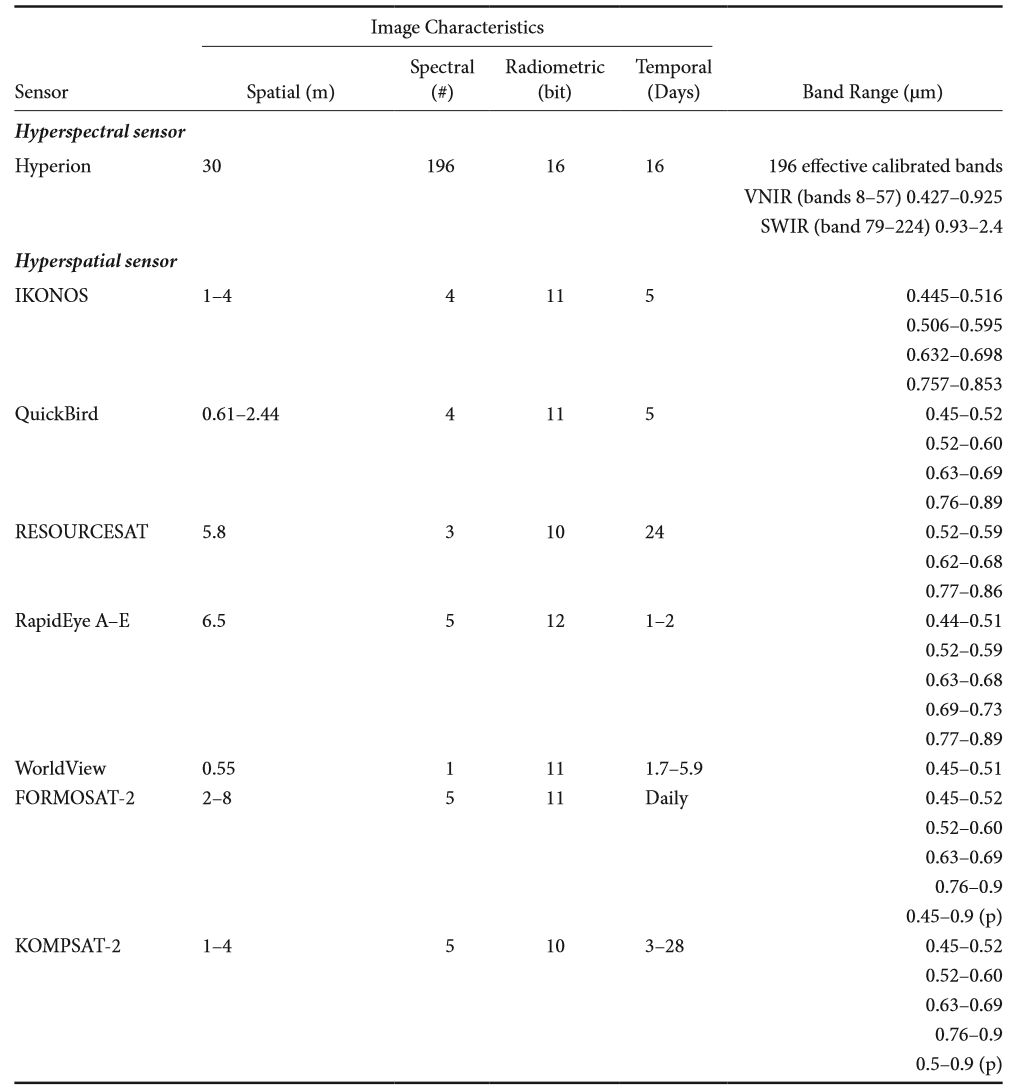
图源:据讲者随堂讲义整理(原图出处未标注)
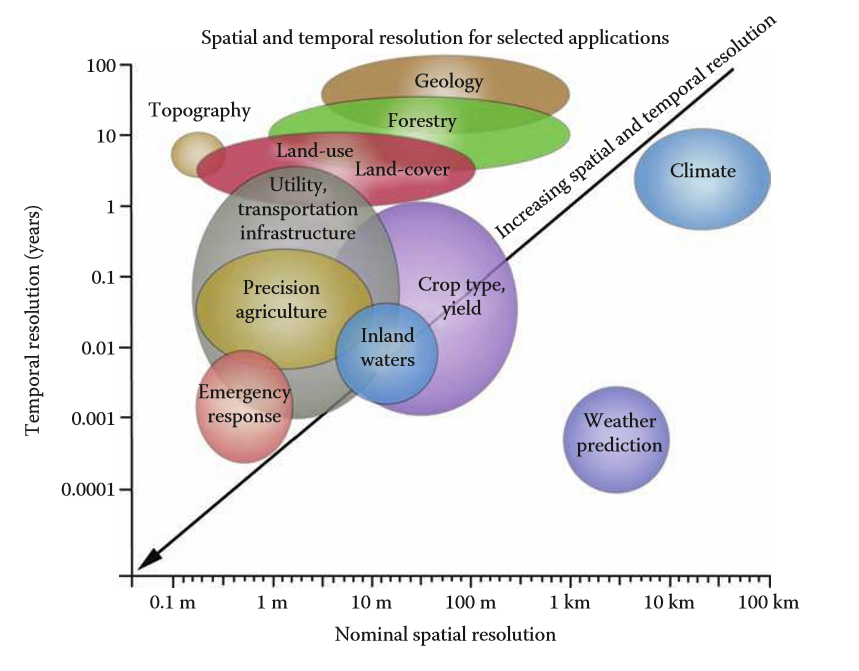
图源:据讲者随堂讲义整理(原图出处未标注)
不同应用对两个维度的要求落在不同区间。地质与林业可以容忍粗一些的空间分辨率和以年计的重访,精准农业与内陆水体要的是米级细节加高频重访,天气预报与气候监测反过来,空间上粗一点无妨,时间上必须密。
图源:据讲者随堂讲义整理(原图出处未标注)
七、往下看,也往上看
从天空往下看,看到的除了地貌,还有物理过程。
地震之前,地下的岩石会先变形和破裂。有一种被广泛讨论的解释是,岩石破裂时化学键断裂会释放电荷,岩石体积足够大的时候,聚集起来的电荷能形成足够强的电场,扰动三百多公里高度上的电离层。这条链反过来用,就是监测电离层的异常,去推断地表下面发生了什么。中国发射过一颗专门做这件事的电磁监测试验卫星。这条链上的信号很弱,观测到的异常与地震之间是不是一一对应,一直是这个方向上的问题。
另一类是慢变化。城市地面沉降是典型例子,地铁沿线每年下沉一点点,这是有实测数据支撑的。把不同时间对同一片区域的观测做相干处理,能测出毫米到厘米量级的形变,拿这个数据做风险评估。
光学载荷给的是另一类线索。火山喷发前后的热异常、地震之后地表破裂的位置,可以直接看出来。微波看的形变和光学看的热与纹理,落在同一片地面上是两套不同的物理量。
反过来往上看的例子是射电天文。从地面观测黑洞,是天文学者做的一件被动探测的事。要看清事件视界,需要极高的角分辨率,而角分辨率由波长和口径共同决定:
θ=λD(7-1) \theta = \dfrac{\lambda}{D} \tag{7-1} θ=Dλ(7-1)
波长可以往毫米波段压,压到 1.3 毫米已经接近极限,剩下的只能靠口径。按这个式子反推,要看清黑洞需要几千公里的口径,地球上造不出这样一面镜子。
办法是把分布在全球的望远镜连起来。用甚长基线干涉把各处记录下来的信号做相干合成,等效出一台口径接近地球直径的虚拟望远镜。这类合成对时间同步的要求极高,每台望远镜都要配高稳定度的原子钟。事件视界望远镜把八台射电望远镜联成一张网,2017 年 4 月完成第一次全球联合观测,出来的数据网络传不动,只能把硬盘用飞机送到处理中心,再交给超级计算机做相关。2019 年发布的第一张黑洞照片,就是这条路线第一次走通的结果。
分辨率的瓶颈是口径。口径到了物理极限,只能换一种方式去凑。
图源:据讲者随堂讲义整理(原图出处未标注)
图源:据讲者随堂讲义整理(原图出处未标注)
八、把许多小口径拼成一个
同样的思路从天文搬到雷达。要从地面看清三十八万公里外的月球,需要的口径同样大得造不出来。月球比黑洞近得多,难度小一些,卡住的还是口径。
真实孔径的做法是用天线阵形成一个窄波束,让波束扫过要看的区域,逐点取值。分辨率由波束宽度决定,波束越窄分辨得越细,波束宽度又由口径和距离共同决定。拿一支激光笔去扫一件古董是同样的动作,光斑小,扫过去就能把细节一个点一个点读出来。距离一远,同样的口径对应的光斑就变大,要维持光斑的尺寸,只能把口径跟着距离一起放大。
这个口径有多大,可以拿具体数算一遍。设平台高度为 R,工作波长为 λ,要求的地面分辨率为 ρ,需要的最小真实口径是
D=λRρ(8-1) D = \dfrac{\lambda R}{\rho} \tag{8-1} D=ρλR(8-1)
把高度取 430 公里、波长取 1 厘米、分辨率取 1 米代进去,
D=0.01×4.3×1051=4.3×10³ m(8-2) D = \dfrac{0.01 \times 4.3 \times 10^{5}}{1} = 4.3 \times 10^{3}\ \mathrm{m} \tag{8-2} D=10.01×4.3×105=4.3×10³ m(8-2)
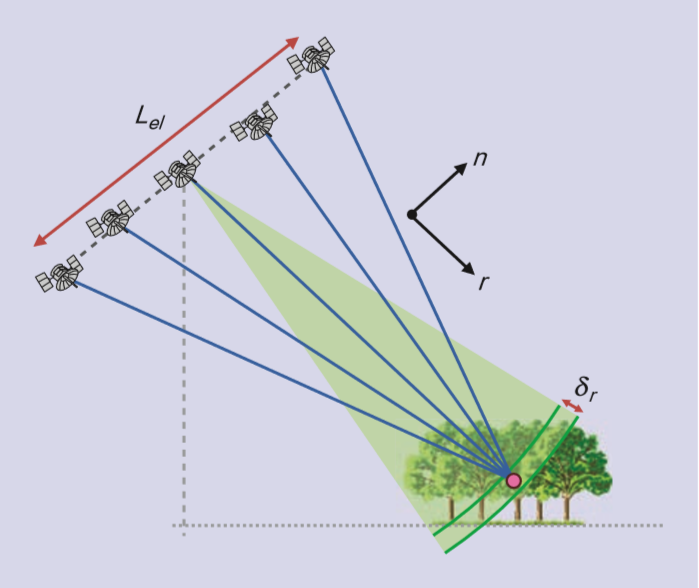
四千三百米。这个口径造不出来,也没有必要造,因为平台自己在动,逐点采下来的数据在计算机里合成之后,等效的就是这么一个口径。合成的是数据,不是天线,用时间去换空间,一次飞行就等于扫过了一个四千三百米长的口径。
美国的做法是拿一台大天线当发射机,用一组中等口径的天线当接收阵。绿岸天文台的百米口径望远镜在 2020 年底加装了雷达发射机,发射功率 700 瓦,比一台家用微波炉还低,工作频率 13.9 GHz,回波由甚长基线阵的十架 25 米天线接收。2021 年 9 月公布的月面图像聚焦在月球正面的第谷环形山,分辨率约 5 米,覆盖 200 公里乘 175 公里,像素约 14 亿。
美国在行星雷达上的积累更早。喷气推进实验室的行星雷达、加州 70 米口径的金石太阳系雷达、波多黎各 305 米口径的阿雷西博望远镜,长期承担小行星的定轨和形貌测量,其中阿雷西博已经倒塌。这套体系冲着行星防御去:近地小行星里直径一百四十米以上的估计有两万多颗,已经发现的不到一半,光学望远镜负责发现,雷达负责精确定轨和测形貌。
中国走的是另一条路,把许多小口径直接铺开。中国复眼的全称是超大分布孔径雷达高分辨率深空域主动观测设施,分三期建设。一期在重庆两江新区明月山,4 部 16 米口径雷达,2022 年 12 月完成安装调试,开机就拍出国内首幅地基三维月面图。二期 2023 年 2 月在重庆云阳的中洲岛开工,25 部 30 米口径雷达,目标是千万公里外的小行星探测与成像。三期计划把单元数量扩到上百部,观测距离要从千万公里推到上亿公里,名字里的复眼就是从这里来的。
阵列放在地面而不是天上,理由很实在。地面上有资源,设备可以做大,供电不成问题,算力可以堆,坏了能修。搬到星上,重量、供电、在轨计算三样都要重新设计一遍。同样的分辨率,地基方案容易实现得多。
这件事背后是 0 到 1 和 1 到 100 的区别。别人已经做过的事情再做一遍,就是重复别人的工作,花掉的力气和得到的增量不成比例。概念验证之后,只要投入资金和人力,多数事情都能做成,难的是最开始那一步,许多科研事情就隔着薄薄一层纸。每个人都是自己的囚徒,认知层次打不开,就跨不过这一步。
图源:据讲者随堂讲义整理(原图出处未标注)
九、成像的两件基本操作
成像里最基本的操作只有两件:一件是对信号本身做的操作,一件是频率上的滤波。其余的算法都是在这两件上的改进。分析一个信号,可以只在时间域做,也可以换到频率域做,两种做法看到的是同一件事的不同侧面。
频率这个概念上有一处含混。信号课里学过瞬时频率,它和频谱不是一回事。频谱是对整个信号做调和分析得到的描述,像一份族谱,把一个信号里所有的频率成分摊开;瞬时频率问的是此刻的频率。对单频信号,两者看起来一样;对频率不断变化的信号,两者差得很远。本科信号课里讲幅度调制和相位调制,那时候频率还是一个常数,到了这里,频率成了时间的函数。
此刻的频率怎么定义:开一个窗,窗口宽度足够小,小到窗里只跨过一次过零,就得到一个频率值。让窗口沿时间轴滑过去,就得到一条随时间变化的频率曲线。这就是短时傅里叶分析,也叫时频分析:
X(t,Ω)=∫x(τ)w(τ−t)e−jΩτdτ(9-1) X(t,\Omega) = \int x(\tau) w(\tau - t) e^{-j\Omega\tau} d\tau \tag{9-1} X(t,Ω)=∫x(τ)w(τ−t)e−jΩτdτ(9-1)
它放弃全局,只对窗口里那一小段负责。窗口一开,别的地方就不用管了。
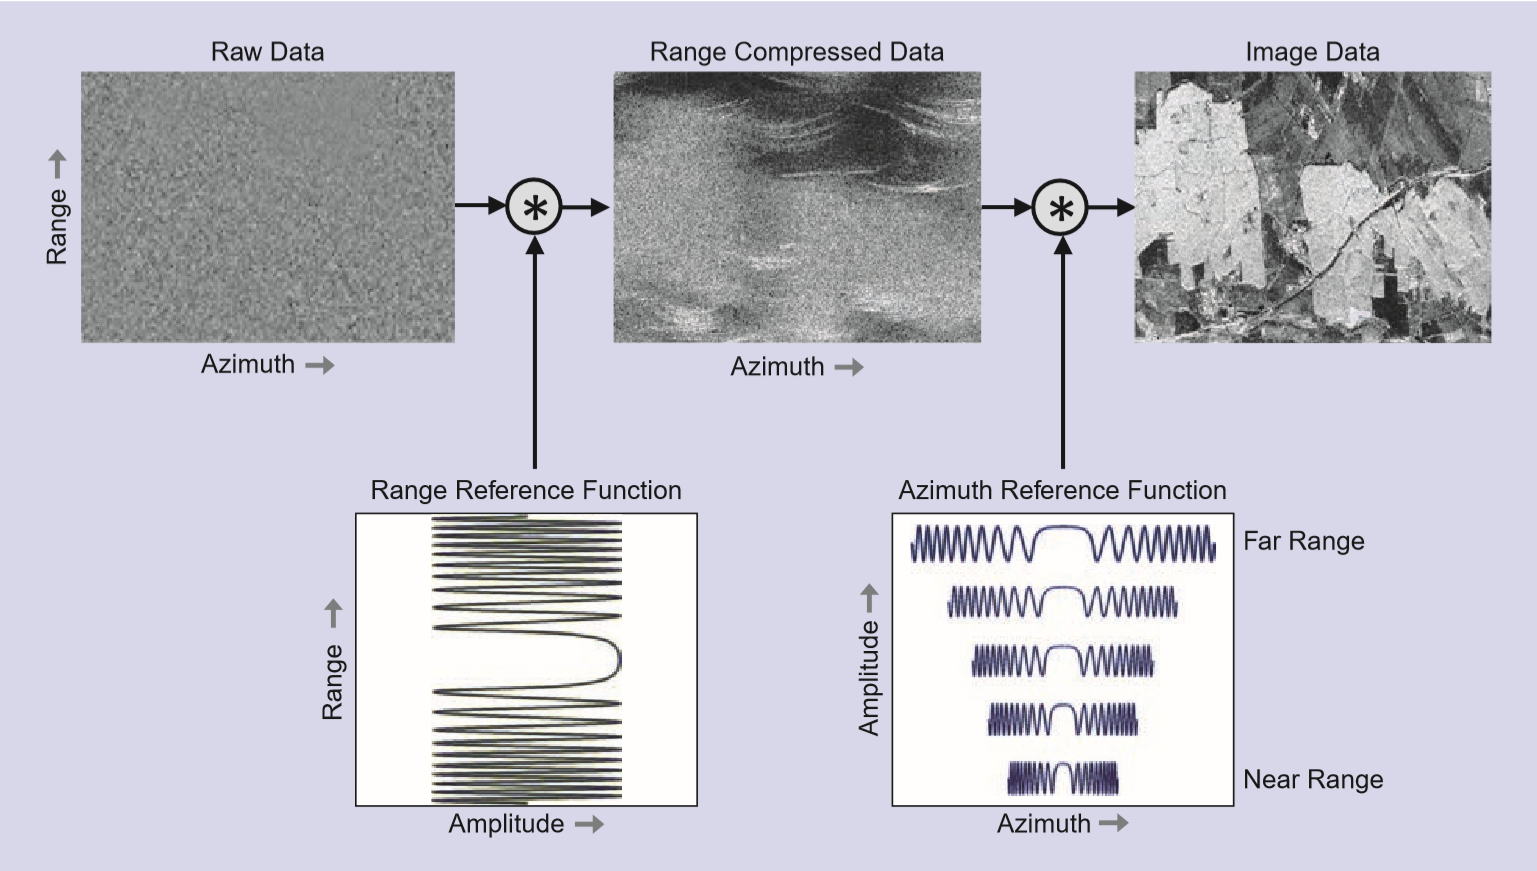
它和成像的关系很直接。发射信号是 s(t),回波是它的延迟副本,延迟量对应目标的距离。把发射信号和回波沿时间轴滑动相乘再求和,什么时候得到最大值,什么时候就是时延。这个滑动相乘再求和的动作就是卷积:
y(t)=∫x(τ)h(t−τ)dτ(9-2) y(t) = \int x(\tau) h(t - \tau) d\tau \tag{9-2} y(t)=∫x(τ)h(t−τ)dτ(9-2)
匹配滤波是它的近亲:
R(t)=∫x∗(τ)y(τ+t)dτ(9-3) R(t) = \int x^{*}(\tau) y(\tau + t) d\tau \tag{9-3} R(t)=∫x∗(τ)y(τ+t)dτ(9-3)
两者的形式几乎一样,差别在一个共轭。共轭和翻转不是一回事,共轭动的是相位,翻转动的是时间顺序,两者不能互相替代,匹配滤波两个动作都要用。共轭对复标量不满足齐次性,严格说不是复线性运算,所以匹配滤波整体是线性的,里面却带着一个非线性的动作。卷积还有另一种写法,在时域是滑动相乘再求和,到频域就是两个频谱相乘,频域滤波和时域卷积是同一件事的两种看法。
匹配滤波有一个很好的物理图像。把收到的信号在时间上倒过来,让它沿着原路走回去。去的时候各分量在散射体上散开了,回来的时候按同一条路径倒着走,就会在出发点重新对齐,叠成一个极大值。喊一声 hello,传到接收机那里听起来是倒过来的,匹配滤波做的就是这件倒放的事。
模板从哪来,主动和被动在这里才真正分开。主动雷达知道自己的发射信号,直接拿它当模板。被动雷达不知道对方发的是什么,只知道大概长什么样子,那就得准备一组不同尺寸、不同形状的模板,一起和回波做匹配,哪个响应大就认为像哪一个。这组模板就是滤波器组。被动的情况天然是多假设的,多出来的假设把后面的工作量整体抬了一档。
滤波器组的响应出来之后,问题从检测变成识别。某一处有亮点,不代表那里有真目标,还要判断它是什么。识别的压力落到后面的处理上。
图源:据讲者随堂讲义整理(原图出处未标注)
十、卷积核从哪来
模板是怎么定出来的,这个问题要单独说。
最朴素的做法是指纹式匹配:拿一千张章鱼的照片,把待判别的图像和每一张逐点滑动相乘,看哪一张最像。问题很快会暴露,章鱼转个角度、换个光照、换一下摆放的位置,一千张里可能一张都对不上。哪怕这一千张都是高清照片,也一样匹配不到。最原始的指纹识别就是这么做的,所以它挑剔。
换一个问法就不一样。不问整张像不像,改问最有辨识度的局部特征在不在。章鱼之所以是章鱼,靠的是一些局部结构,不是整幅画面的排布。
做法是把图像切成很多小片,看每一片和模板的响应。姿态和光照带来的麻烦就此绕开,因为图像信息本身是冗余的,局部特征会在不同位置反复出现。这就是卷积网络的基本结构。
关键的一步在模板的来源。模板不再是人工设计的,而是从已知标签的样本里学出来的:一千张已知是章鱼的图片进去,训练出一组卷积核,卷积核在图像上扫一遍给出一组响应,这组响应被压成一个低维的特征向量,再送进分类器判定。整个过程有标签可用,属于监督学习:
z=softmax(Wf(x))(10-1) \mathbf{z} = \mathrm{softmax}\left(W \mathbf{f}(x)\right) \tag{10-1} z=softmax(Wf(x))(10-1)
这里 f(x) 是卷积层提出的特征向量,W 是分类器的权重。网络所做的工作是把高维的像素空间搬到一个低维的特征空间,让类别在低维空间里可以被一条边界分开。特征向量的维数远小于像素数,这一步降维是分类器能工作的前提。
同一层的所有位置共享同一组卷积核。如果不共享,每个位置配一个模板,参数量会随着图像尺寸一起涨,图像一大就失控;共享之后,参数量只和核的大小、通道数有关,与图像尺寸无关。
学不出来的时候就加大容量。模板不够用,就用更高维的模板,更多通道、更大的核,再往下走还会逐级下采样,让后面的层处理更抽象的特征,一直加到能把类别分开为止。网络变深变宽,扩的就是这个容量。这条路能走通,背后是一大堆工程上的麻烦。
十一、雷达数据自己就是大数据
遥感的数据量,按 2019 年的统计已经到了 PB 量级,也就是 10 的 15 次方字节。做一个参照,地球上树木的数量在万亿这个量级,也就是 10 的 12 次方。这里有一个变化:过去是拿到一份数据去解一个问题,现在是先把大量数据攒下来,再从里面找问题。
行业里用四个词描述大数据:体量大、种类多、价值密度、速度快。种类多说的是模态,不同传感器、不同观测条件形成的数据属于不同的模态,把多个模态放在一起,这件事本身就是价值。如果数据只有一种模态,传统理论就够用了,犯不上叫大数据。
体量和速度要连起来看。数据量大本身不是价值,能在可接受的时间内取出有用的东西才是价值。解决一个问题要花上百年,那就不需要再做了。速度是方法能不能落地的前提。
科学研究的范式从实验、理论、计算一路走到数据密集型挖掘,再从数据密集型挖掘走到把数据直接交给模型。前几步都要求人先把问题想清楚,最后一步把这一步也交了出去。
具体到雷达和遥感,面对的是海量、异构、来源不受自己控制的数据。能不能从这些数据里挖出单份数据里看不到的规律,决定了这一行接下来该怎么做。数据从哪来已经不成问题,传感器能轻松把数据拿到手,服务器也能把数据存下来,难的是把数据变成结论的那一步。
十二、落到非合作卫星
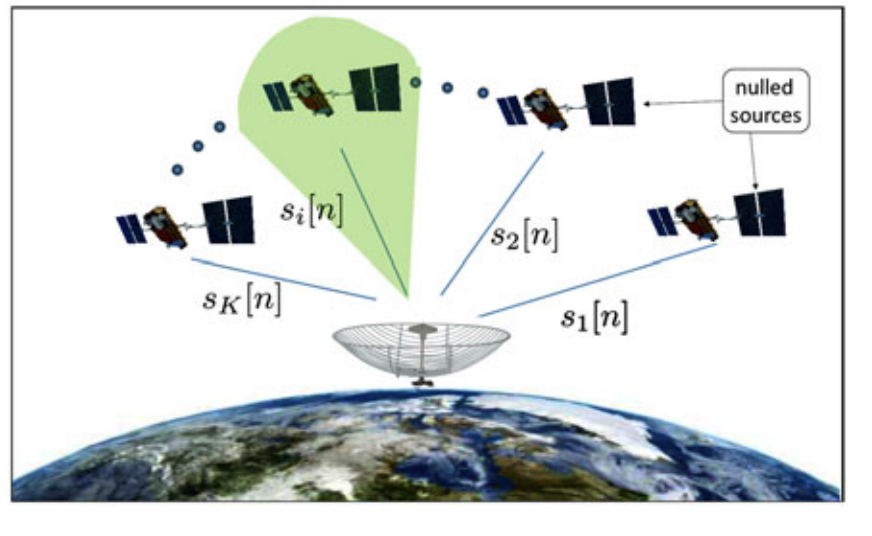
回到第二节那组对照。被动感知要解决的是不受制于外辐射源,而这个前提今天变了。天上已经有数以万计的低轨卫星在向下播发信号,这些信号不是为谁发的,但可以收。外辐射源从够不够的问题,变成了用不用得起的问题。实验里用到的是四家不同的低轨星座,OneWeb、星链、铱星和 Orbcomm,它们分属不同的运营商,信号结构、频段、调制方式都不一样,用多家星座,一方面是几何上有更多选择,另一方面也是因为被动这条路本来就得来者不拒。
被动感知到这里就和导航接上了。把低轨卫星当作外辐射源来用,拿到的观测量是多普勒,多普勒里带着接收机与卫星之间的相对运动信息,只要知道卫星在哪,就能反过来定接收机的位置:
fD=−r˙λ(12-1) f_{D} = -\dfrac{\dot{r}}{\lambda} \tag{12-1} fD=−λr˙(12-1)
式中 r 上加一点表示接收机与卫星之间距离的变化率。低轨卫星的速度在 6.6 到 7.8 公里每秒之间,带来的多普勒比地面辐射源大出好几个量级,信息量也就更足。
难点集中在星历上。卫星的轨道根数由两行根数文件公布,用这些根数加轨道确定算法传播之后,位置误差到了公里量级,速度误差到了米每秒量级。低轨卫星上未必装原子钟,也不像导航卫星那样把轨道根数和钟差修正播发出来。更根本的一条是,要从卫星的授时信号里拿到观测值,得先知道信号结构,而私营运营商很少公开自己的发射信号。再加上低轨的高动态,相干处理间隔被压得很短,短到攒不起足够的信号功率。
整套框架分三级:捕获、跟踪、差分导航,前面的输出是后面的输入。难度几乎都压在最先那一级。论文最核心的问题是:如果拿不到对方的通信码,这件事还能不能做。
捕获要对付的是不知道信号结构。做法是用广义似然比检测,把多普勒频率当作信号子空间来匹配,先检出最强的那颗卫星,再把这个子空间置零去找下一颗,一颗一颗顺序地检,把在视卫星的数量和各自的多普勒一起估出来。置零就是把已经找到的那颗从搜索空间里划掉,剩下的信号里不再被它遮住。
图源:S. Shahcheraghi, J. Saroufim, and Z. M. Kassas, "Acquisition, Doppler Tracking, and Differential LEO-Aided IMU Navigation with Uncooperative Satellites," IEEE Aerospace and Electronic Systems Magazine, vol. 40, no. 5, pp. 54--72, May 2025, doi: 10.1109/MAES.2025.3529404,原文 Figure 3。
带整数约束调制和不带的信号要分开处理。不带整数约束调制的信号在一个相干处理间隔里有明显的周期结构,用基于最大似然的检测器;带整数约束调制的信号用基于傅里叶变换的检测器,得到的多普勒频率无模糊。两类信号分开走,是因为周期序列能被利用的方式不一样。
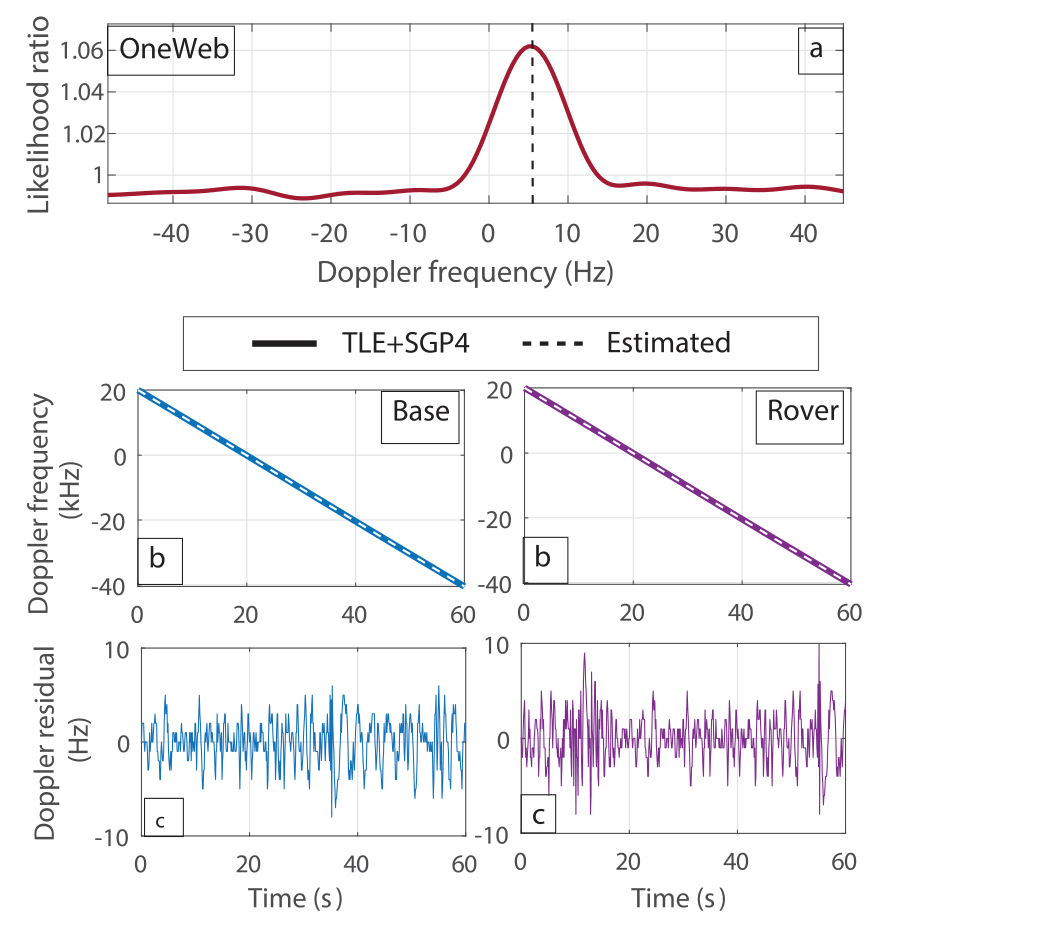
跟踪用卡尔曼滤波,同时跟多普勒和多普勒变化率。低轨卫星过顶的几十秒里,多普勒从二十千赫兹一路扫到负四十千赫兹,滤波器要跟住这条近似线性的斜坡,同时把噪声压下去。
图源:Shahcheraghi 等,IEEE Aerospace and Electronic Systems Magazine,2025,doi: 10.1109/MAES.2025.3529404,原文 Figure 8。
图里三个面板是一条链上的三段。最上面是捕获,似然比在真实多普勒处耸起一个尖峰;中间是跟踪,虚线是估计值,实线是用根数和轨道确定算法预测的值,两条几乎重合;最下面是残差,也就是跟踪误差,落在正负几赫兹之间。
导航那一步靠差分。位置已知的基准站和位置未知的流动站同时观测同一批卫星,两边测到的多普勒相减:
ΔfD=fDrover−fDbase(12-2) \Delta f_{D} = f_{D}^{\mathrm{rover}} - f_{D}^{\mathrm{base}} \tag{12-2} ΔfD=fDrover−fDbase(12-2)
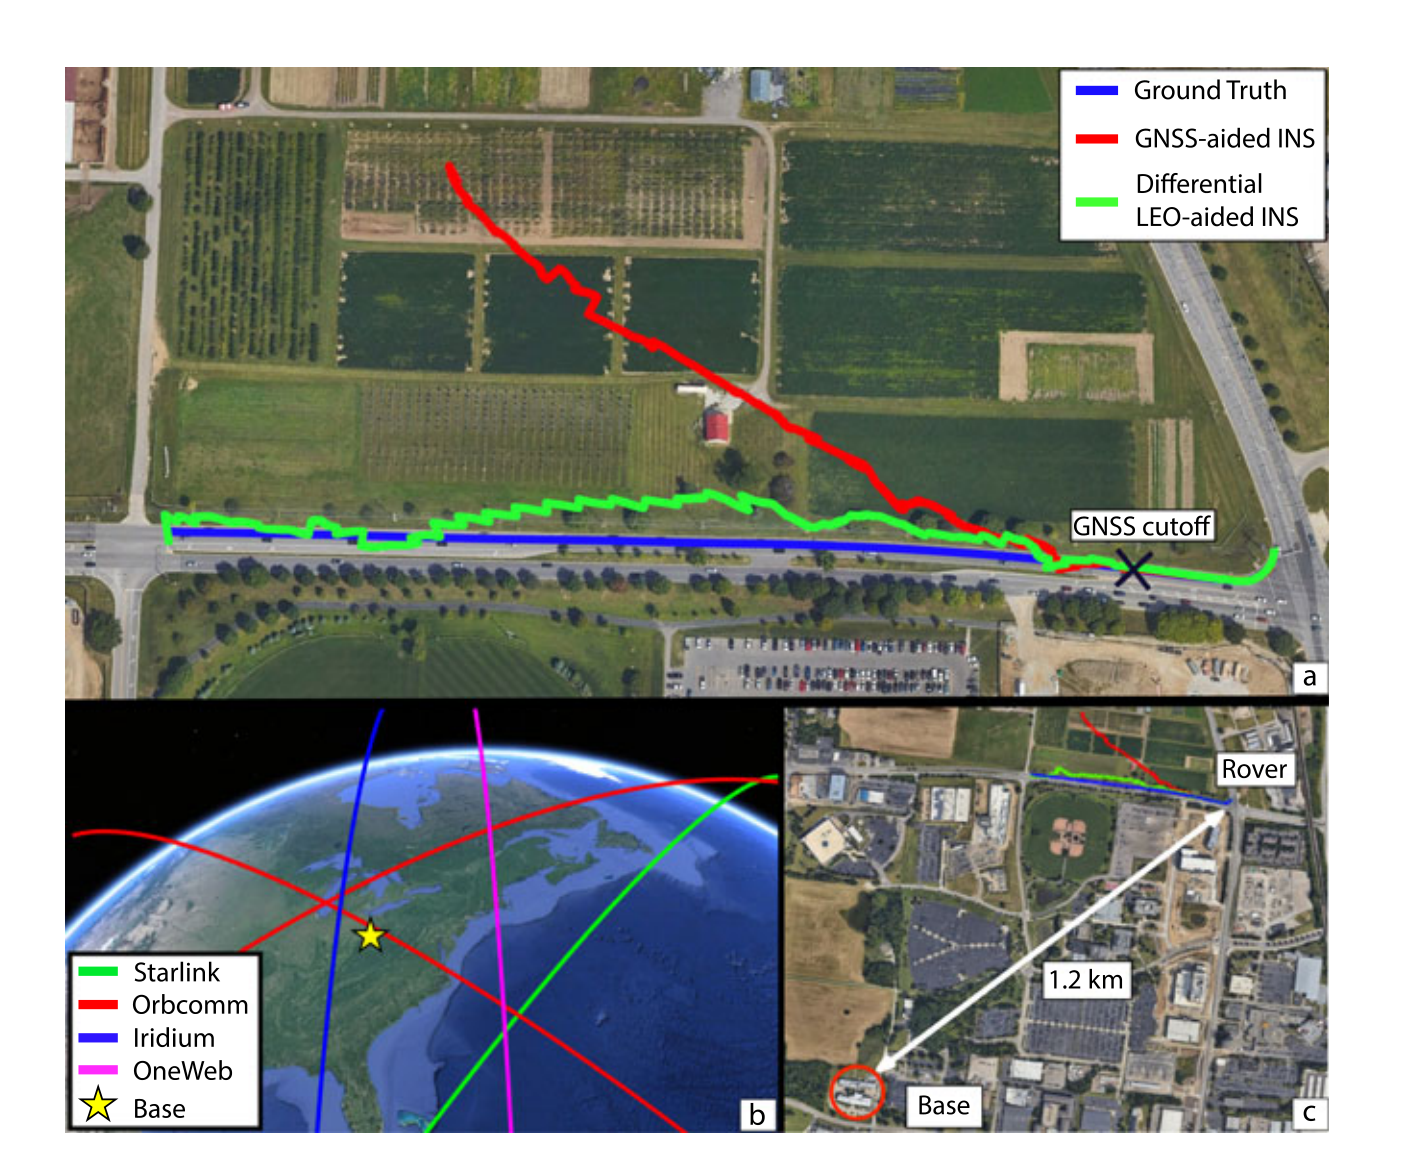
基站架在俄亥俄州立大学的实验室里,用的是和流动站同一套低轨天线配置,两边的采样设备各自带恒温晶振,用来压低各自的钟漂。两颗接收机共有的卫星钟误差在这一步被消掉,共有的星历误差也被大幅压低。代价是流动站得能收到基准站的数据,两者之间要有一条通信链路,还要保持时间同步。剩下的误差里包括接收机之间的同步模糊,可以靠在基准站那边微调根数的历元时间来压下去。流动站上装一台高度计、一个工业级惯性测量单元、一台导航卫星接收机和一台接收低轨信号的接收机,导航卫星断开之后,用扩展卡尔曼滤波把差分多普勒与惯性测量单元紧耦合起来。
论文报告的结果是这样的。实验在俄亥俄州哥伦布进行,流动的车辆在 60 秒里行驶了 540 米,其中后 40 秒行驶的 492 米里,导航卫星信号被虚拟切断。
| 指标 | 导航卫星辅助惯导 | 差分低轨辅助惯导 |
|---|---|---|
| 三维位置均方根误差(米) | 87.74 | 7.62 |
| 末段位置误差(米) | 212.51 | 12.20 |
| 星座组合 | 位置均方根误差(米) | 末段位置误差(米) |
|---|---|---|
| 单颗星链 | 83.12 | 150.12 |
| 单颗 OneWeb | 46.61 | 92.45 |
| 单颗铱星 | 44.62 | 70.64 |
| 两颗 Orbcomm | 9.12 | 12.22 |
| 星链加 OneWeb | 42.45 | 90.21 |
| 铱星加 Orbcomm | 8.32 | 14.31 |
| 四种星座共用 | 7.62 | 12.20 |
表里最后两行要看清。单颗星链的跟踪时段只有 7 秒,短到不足以修正已经累积起来的惯导误差,单独用几乎没有帮助。它跟踪得短有原因,实验点落在星链辐射方向图主瓣没有覆盖的区域,接收到的功率低,处理时只能靠相干叠加更多的周期来补。两颗 Orbcomm 的多普勒符号相反,一颗在远离、一颗在接近,频率间隔很大,捕获时不用置零就能把它们分开。两颗 Orbcomm 单独用就把误差压到 9.12 米,和一颗铱星组合是 8.32 米,四种星座全用是 7.62 米。多星座的价值来自同时有足够多的几何约束。
图源:Shahcheraghi 等,IEEE Aerospace and Electronic Systems Magazine,2025,doi: 10.1109/MAES.2025.3529404,原文 Figure 13。
轨迹图里,红色是用导航卫星辅助惯导解出来的轨迹,导航信号被切断之后一路偏出去;绿色是差分低轨辅助解出来的,贴着蓝色真值走。
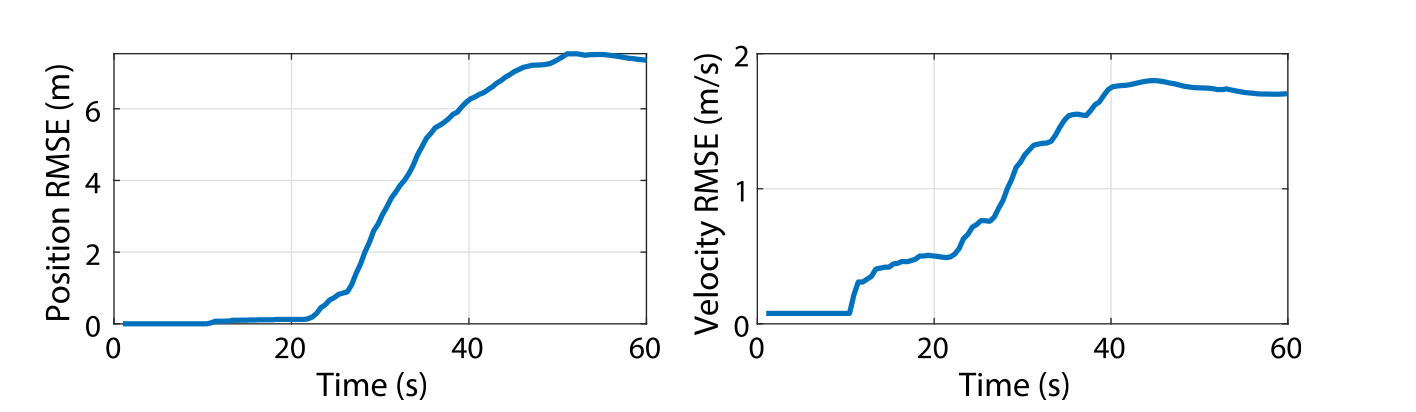
图源:Shahcheraghi 等,IEEE Aerospace and Electronic Systems Magazine,2025,doi: 10.1109/MAES.2025.3529404,原文 Figure 14。
误差曲线把这件事拆成两条。位置误差在导航信号切断后持续增长约 30 秒,然后停住;速度误差在观测开始 10 秒后上升,最后 20 秒稳定在每秒 1.8 米左右。速度误差先动、位置误差后累积,说明滤波器一直在把速度的信息往位置里灌。
开头那组对照,到这里闭合了。主动感知不受制于人,代价是要发信号;被动感知不发信号,代价是受制于外辐射源。低轨星座把这个代价削掉了一大半,剩下的是信号处理的事。不知道对方发的是什么,就把它当作一个待估计的未知量,交给检测和滤波去处理,这一半可以自己把握。