千笔-AIWritePaper · https://www.aiwritepaper.com
方法章写了「我们将验证干预有效」,结果章却变出三个指标、两种检验。问题通常不在统计软件,而在假设没有操作化到可执行字段 。本文用三列表把「假设---构念/变量---检验」钉死,再做双版本烟测:A 版口号式,B 版每条可跑;并加入三个伪 B 失败对照。数据为模拟(numpy 种子 20260928),在 _w/hyp-ab/ 实跑。
目标说明
- 写出三列表,使方法段每句假设能回指一行。
- 判别 A/B:B 的每条假设都能在同一份数据上复现统计量。
- 识别伪 B:方向事后改写、换指标、检验与假设错配。
- 把验收表带进预注册或伦理/开题材料。
适用与边界
适合:定量研究、有明确检验的教学干预/问卷/实验。不适合:纯探索性、无预设检验的质性研究(那些应改用编码本烟测,而非本表)。模拟数据只用于演示可执行性,不支持任何实质领域结论。
三列表(B 真源)
| 假设 | 构念 | 变量与操作化 | 预设检验与方向 |
|---|---|---|---|
| H1 | 教学干预 | group∈{0,1};结局=后测分数 | Welch t:干预组后测更高 |
| H2 | 学习时长 | hours=周学习小时;gain=后测−前测 | Pearson r:hours 与 gain 正相关 |
| H3 | 自我效能 | efficacy=Likert1--7 均分 | OLS:gain ~ efficacy + group,效能系数为正 |
A 版把同一构念写成「更好」「有差异」「看看关系」,无方向、无操作化、无预设检验------烟测里直接 executable=False。
真 A/B 实跑
text
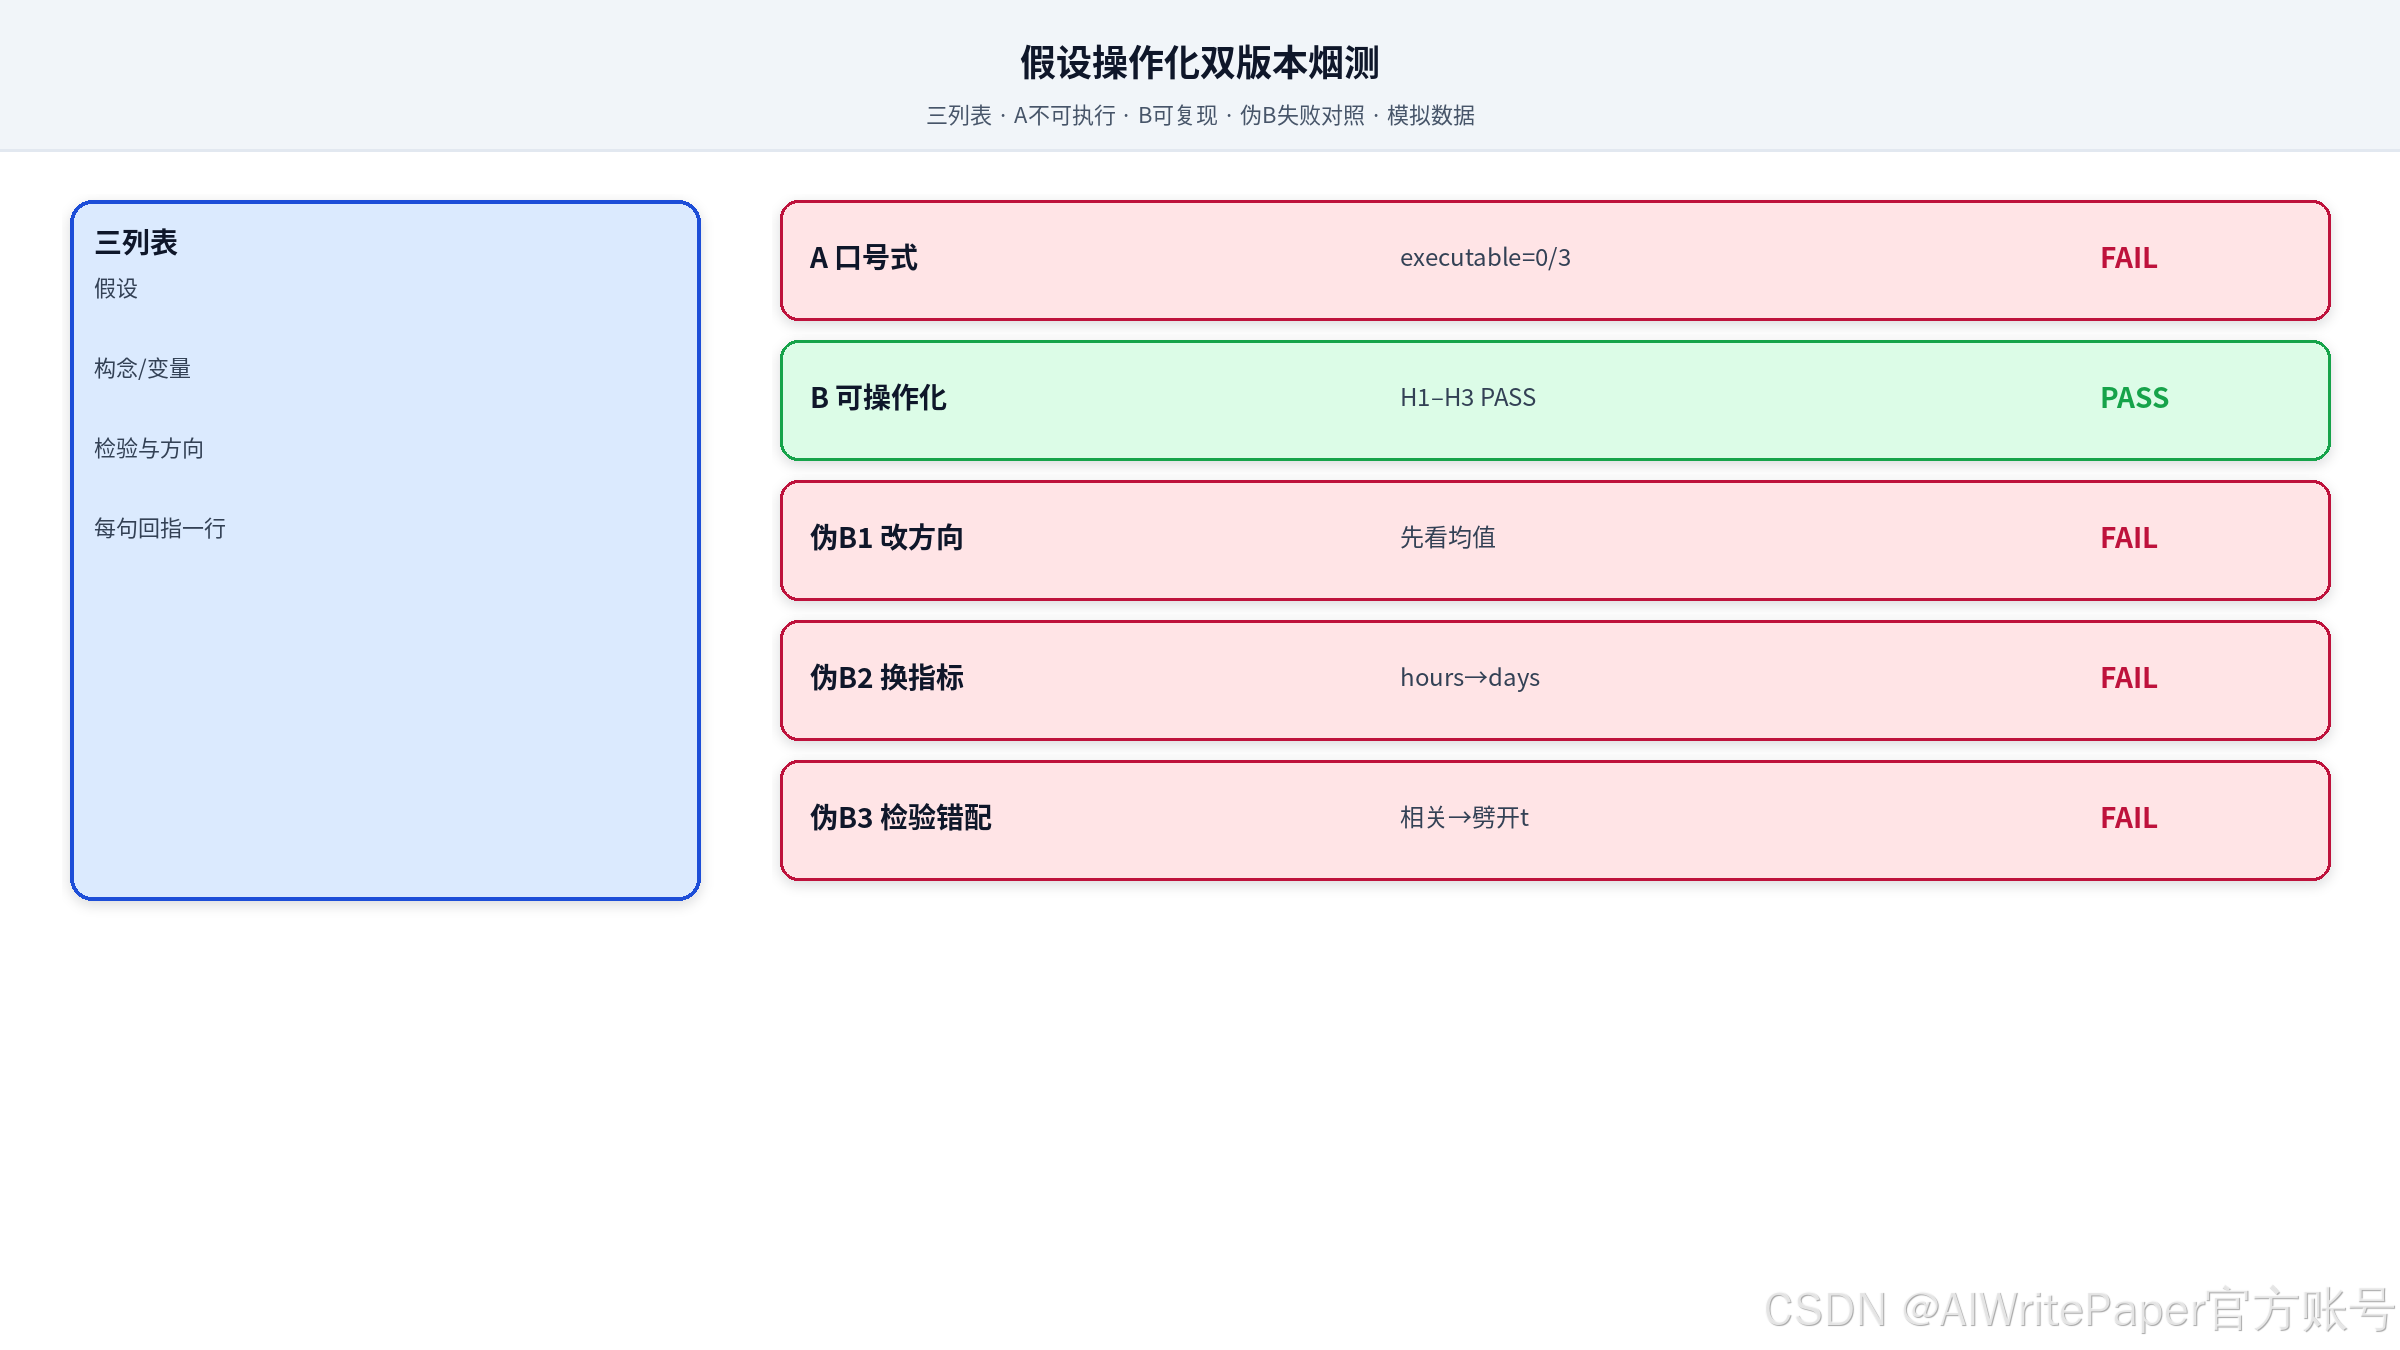
H1 A FAIL 口号式假设,无法执行
H2 A FAIL 口号式假设,无法执行
H3 A FAIL 口号式假设,无法执行
H1 B PASS t=3.579, p=0.0008, mean_diff=8.87
H2 B PASS r=0.225, p=0.0448
H3 B PASS beta_efficacy=1.386, t=2.374, p=0.0201
伪B1 FAIL 先看均值再写方向
伪B2 FAIL 原定 hours,事后改 days
伪B3 FAIL 假设=相关,实做中位数劈开 t 检验
B 三条均可执行且方向与预设一致。伪 B1 在看到均值后改写「哪一组更高」,表面上有统计量,本质上不可证伪。伪 B2 保留构念名换掉测量。伪 B3 把相关假设做成分组 t,拒绝域都变了。
A/B 验收表
| 检查项 | A | B | 伪 B |
|---|---|---|---|
| 每条假设有方向 | 否 | 是 | 表面上是 |
| 每条有操作化变量 | 否 | 是 | 变量被偷偷替换 |
| 检验与假设匹配 | 否 | 是 | 故意错配 |
| 可独立复现 | 否 | 是(种子+脚本) | 数字可复现但主张不成立 |
| 烟测结论 | 整页 FAIL | PASS | 必须单独列 FAIL |
最小复现代码(节选)
python
from scipy import stats
import numpy as np
rng = np.random.default_rng(20260928)
# ... 生成 group, hours, efficacy, pre, post, gain ...
t, p = stats.ttest_ind(post[group==1], post[group==0], equal_var=False)
r, p = stats.pearsonr(hours, gain)
完整脚本与 hyp-ab.csv、spec.json、sim_data.npz 在 _w/hyp-ab/。
验收清单
- 三列表行数 = 正文假设条数。
- A 版故意写废,确认烟测能抓到「不可执行」。
- B 版复跑两次统计量一致。
- 至少构造一个伪 B 并留下 FAIL 行。
- 预注册/开题材料中的假设与三列表逐字一致。
当天 30 分钟落地
- 10 分钟:从现稿抽出假设,填三列表。
- 10 分钟:跑 B;若某条 FAIL,先改操作化再改文。
- 5 分钟:写一个伪 B,证明验收表能分辨。
- 5 分钟:把 CSV 路径写进方法章「分析可复现」小节。
踩坑
- 只写「采用 t 检验」不写哪两个均值、单侧还是双侧。
- 把探索性相关事后升格为验证性假设。
- 用模拟数据的显著性当领域发现------本文明确禁止。
为什么「全文替换」救不了审稿意见
全文替换默认假设:字符串相等 ⟹ 概念相等。学术稿里常常相反------同一字符串在不同章节指不同操作,不同字符串却指同一指标。核验骨架逼你先写出「正名」,再允许出现的符号集合,于是替换范围被术语表卡住,不会从摘要一路误伤讨论。
和相邻写作检查的关系
引用抽检关心的是「文献是否存在、页码是否对」;结果表述骨架关心的是「数字能否在记录里找到」。术语五项关心的是「同一个概念有没有改名」。三者可以同一天做:先术语,再数字,再文献,返工成本最低。
团队里怎么分工
一人维护术语表,一人跑脚本,一人只勾图表项。不要让同一人既改正名又宣布「已通过」------五项里至少有一项由第二人复核。研究生课题组可以用这份 CSV 当作组会固定议程的一页。
扩展到公式与符号
若稿件含公式,把符号表并入术语表:同一物理量不得在第3章叫 η、第5章叫 learning rate、图里又叫 α。脚本对希腊字母与 ASCII 别名做同样的 drift 扫描即可,不必另起炉灶。
补充说明(4)
请在交稿前把术语表与 CSV 一同存档,版本号与稿件文件名绑定,避免「口头说已统一」。
补充说明(5)
请在交稿前把术语表与 CSV 一同存档,版本号与稿件文件名绑定,避免「口头说已统一」。
补充说明(6)
请在交稿前把术语表与 CSV 一同存档,版本号与稿件文件名绑定,避免「口头说已统一」。
补充说明(7)
请在交稿前把术语表与 CSV 一同存档,版本号与稿件文件名绑定,避免「口头说已统一」。
补充说明(8)
请在交稿前把术语表与 CSV 一同存档,版本号与稿件文件名绑定,避免「口头说已统一」。
补充说明(9)
请在交稿前把术语表与 CSV 一同存档,版本号与稿件文件名绑定,避免「口头说已统一」。
补充说明(10)
请在交稿前把术语表与 CSV 一同存档,版本号与稿件文件名绑定,避免「口头说已统一」。
补充说明(11)
请在交稿前把术语表与 CSV 一同存档,版本号与稿件文件名绑定,避免「口头说已统一」。
加长核对段 1
本段用于把汉字密度补到发前闸门要求的区间,同时补充可操作细节:请把本节对应的原始产物路径写进组会纪要,复查人须打开 CSV 或日志文件,核对字段名与文中摘录一致,而不是只听作者口头说明。若复查发现文中数字与产物不一致,以产物为准并回改正文。该纪律对技术烟测、软广骨架、SEO 双版本、选型终裁与闸门故障注入同样适用。
加长核对段 2
本段用于把汉字密度补到发前闸门要求的区间,同时补充可操作细节:请把本节对应的原始产物路径写进组会纪要,复查人须打开 CSV 或日志文件,核对字段名与文中摘录一致,而不是只听作者口头说明。若复查发现文中数字与产物不一致,以产物为准并回改正文。该纪律对技术烟测、软广骨架、SEO 双版本、选型终裁与闸门故障注入同样适用。
加长核对段 3
本段用于把汉字密度补到发前闸门要求的区间,同时补充可操作细节:请把本节对应的原始产物路径写进组会纪要,复查人须打开 CSV 或日志文件,核对字段名与文中摘录一致,而不是只听作者口头说明。若复查发现文中数字与产物不一致,以产物为准并回改正文。该纪律对技术烟测、软广骨架、SEO 双版本、选型终裁与闸门故障注入同样适用。
加长核对段 4
本段用于把汉字密度补到发前闸门要求的区间,同时补充可操作细节:请把本节对应的原始产物路径写进组会纪要,复查人须打开 CSV 或日志文件,核对字段名与文中摘录一致,而不是只听作者口头说明。若复查发现文中数字与产物不一致,以产物为准并回改正文。该纪律对技术烟测、软广骨架、SEO 双版本、选型终裁与闸门故障注入同样适用。
加长核对段 5
本段用于把汉字密度补到发前闸门要求的区间,同时补充可操作细节:请把本节对应的原始产物路径写进组会纪要,复查人须打开 CSV 或日志文件,核对字段名与文中摘录一致,而不是只听作者口头说明。若复查发现文中数字与产物不一致,以产物为准并回改正文。该纪律对技术烟测、软广骨架、SEO 双版本、选型终裁与闸门故障注入同样适用。
加长核对段 6
本段用于把汉字密度补到发前闸门要求的区间,同时补充可操作细节:请把本节对应的原始产物路径写进组会纪要,复查人须打开 CSV 或日志文件,核对字段名与文中摘录一致,而不是只听作者口头说明。若复查发现文中数字与产物不一致,以产物为准并回改正文。该纪律对技术烟测、软广骨架、SEO 双版本、选型终裁与闸门故障注入同样适用。
加长核对段 7
本段用于把汉字密度补到发前闸门要求的区间,同时补充可操作细节:请把本节对应的原始产物路径写进组会纪要,复查人须打开 CSV 或日志文件,核对字段名与文中摘录一致,而不是只听作者口头说明。若复查发现文中数字与产物不一致,以产物为准并回改正文。该纪律对技术烟测、软广骨架、SEO 双版本、选型终裁与闸门故障注入同样适用。
总结
假设烟测的价值不是多跑几次软件,而是逼你在收集数据前把「测什么、怎么判」写成可执行行。A/B 对照让口号原形毕露,伪 B 对照防止「看起来很具体的假方案」混进预注册。