我正在做一个 AI 音视频产品 Vimorph,先聊聊它的整体设计
我正在开发一个 AI 音视频产品,叫 Vimorph。第一篇先介绍它的功能范围、系统分工,以及目前代码里几处值得展开讲的设计。
用一个场景来说明:把一段中文产品介绍视频做成英文版。识别原话、翻译、生成配音、加字幕,最后再合成视频,表面上是一条顺序流程。实际操作时,还会碰到产品名需要校正、译文需要改写、某一句配音需要重做的情况。
Vimorph 把这些步骤放在一个可以继续编辑的工作台里。视频翻译是这篇的例子,它也能串起项目里的语音、素材和后台任务。
一段视频换个语言,要处理哪些事
假设视频里有一句"这个收纳盒可以放进抽屉"。原话识别正确之后,英文译文还要适合朗读,声音的长度也要放得进对应画面。字幕则受阅读速度和显示空间限制,未必适合逐字照搬口播。
因此,Vimorph 的分段模型分别保存 sourceText、translatedText、dubbingText 和 subtitleText,对应原文、译文、配音文本和字幕文本。配音文本和字幕文本未单独填写时,各自回退到译文;需要精修时再分别修改。
主线可以简化为下面的顺序,ASR 是语音识别,TTS 是语音合成:
text
上传视频 → 预处理 → ASR → 翻译 → TTS
                                 ↓
                      校对、试听与片段调整
                                 ↓
                        最终视频与字幕合成
实际执行还有分支。预处理后会投递背景音分离作业;导入原文字幕的任务可以跳过 ASR;翻译完成后是否自动投递 TTS,要看任务状态。TTS 完成后,任务既可以等待人工确认,也可以按自动确认设置继续合成。
Vimorph 目前包含什么
项目的 Web 工作台有视频翻译、文字转语音、转写、音频工作室和音色工具等入口。
有文案时,可以从文字转语音开始;有视频时,进入识别、翻译与配音流程;需要组织多段内容时,则在音频工作室里编辑。音色库、音色设计和录音克隆是声音相关的入口,录音素材应来自自己或已获授权的来源。
音频工作室的目录按章节和片段组织。长稿可以分成几个章节,再在章节内查看片段;目录里的章节菜单提供重命名、删除等操作,也会提示失败片段。章节和视频分段各有编辑入口,第一篇先介绍它们在系统里的位置。
此外,项目还有人声与背景音分离,以及浏览器内的格式转换、裁剪等媒体工具。它们服务于不同的素材处理环节,第一篇先讲这些入口背后的分工,后续再进入具体模块。
系统分工:页面、任务和外部服务
当前技术组成如下,版本依据仓库的依赖声明:
| 部分 | 技术 | 主要分工 |
|---|---|---|
| Web | Next.js 15、React 19、TypeScript | 工作台、分段与字幕编辑、预览、任务状态 |
| 后端 | Java 21、Spring Boot 3.3.6 | 业务接口、任务编排、外部服务接入 |
| 数据库 | MySQL、MyBatis-Plus | 保存分段、任务与执行状态 |
| 文件存储 | 本地与腾讯云 COS 实现 | 管理输入素材和生成文件 |
| 媒体处理 | 服务端 FFmpeg、浏览器端 ffmpeg.wasm | 视频合成与本地媒体工具 |
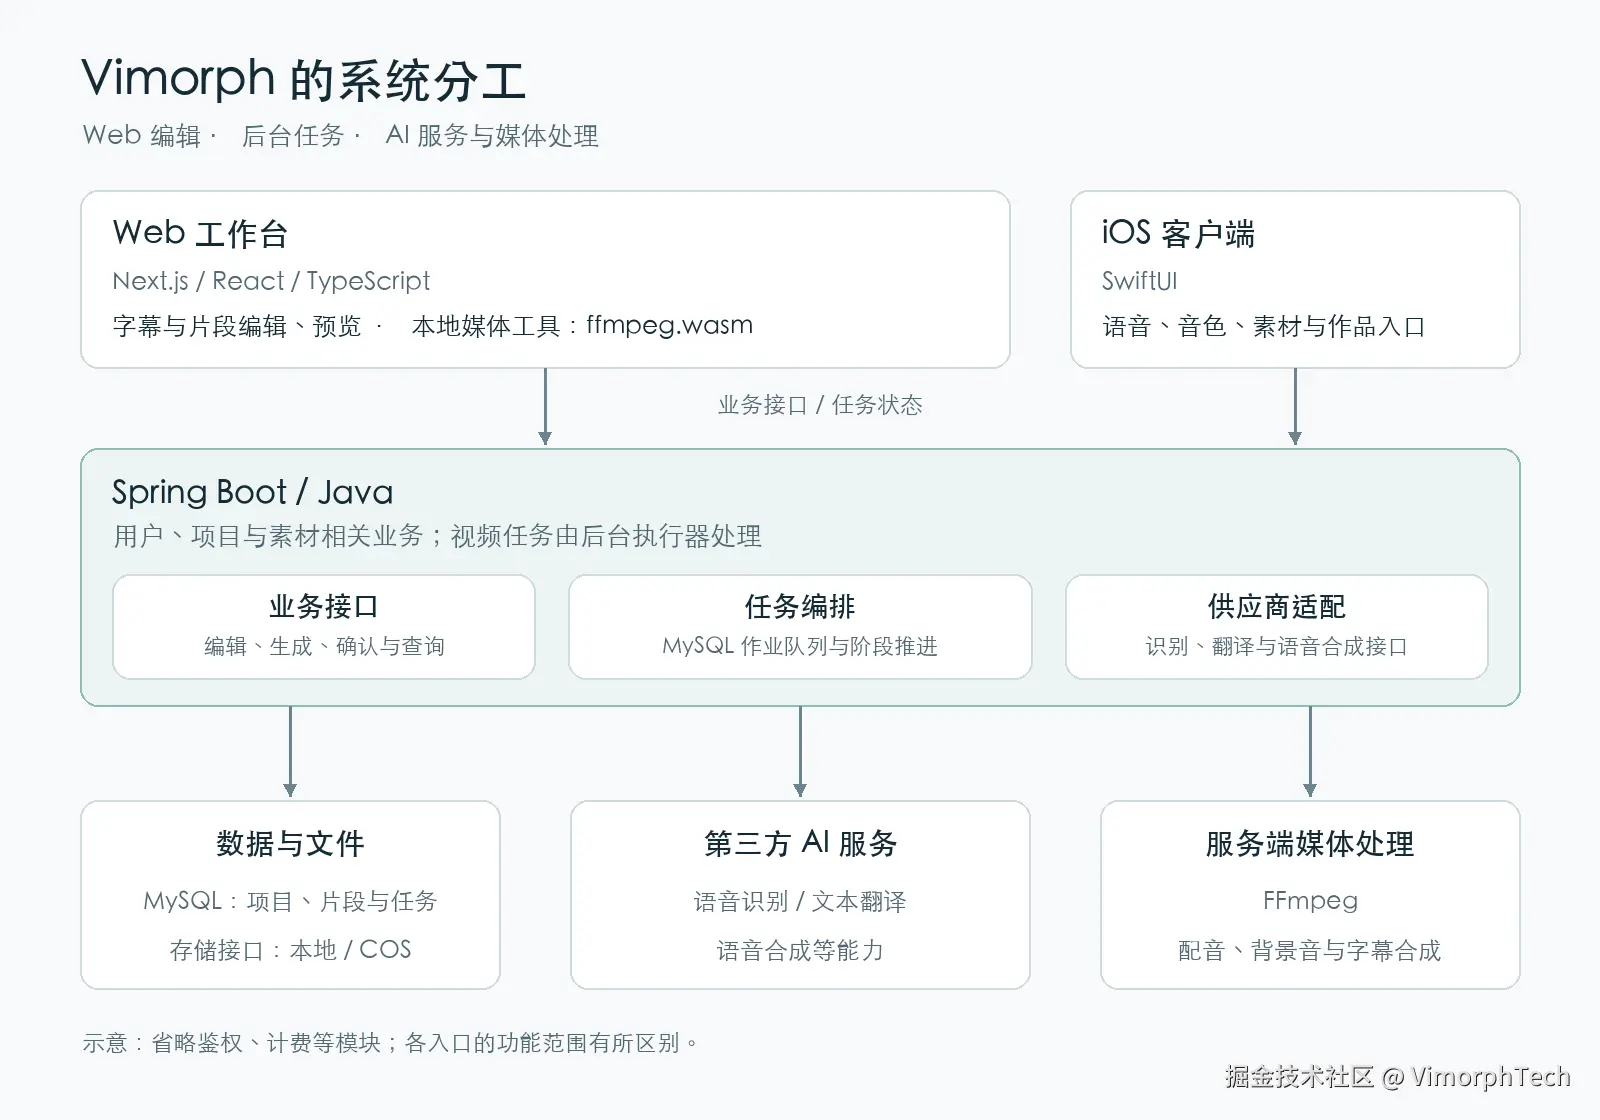
图中只展示主要分工,省略鉴权、计费等模块;连线表示主要关系,不是完整调用时序。
Web 和移动端的功能范围需要分别看待。本文的字幕与分段编辑在 Web 工作台;当前 iOS 路由里有语音、音色、素材和作品入口,两端并没有按相同的编辑器范围来介绍。
三个值得继续拆开的设计
沿着这条流程,下面几个实现会直接影响工作台的使用和维护。
长任务怎么展示进展、处理失败
外部识别服务要等待结果,媒体合成也需要时间。页面创建任务之后,需要知道当前进行到哪一步;失败之后,也需要知道是识别、配音还是合成出了问题。
视频翻译的作业队列有 MySQL 实现。后台执行器认领作业,交给对应的 Handler 处理,再由工作流推进后续阶段。前端通过轮询刷新任务数据,把进展展示在工作台里。
实现中包含延迟重试、租约续期和过期运行作业的恢复入口。续租让长任务继续持有作业,过期恢复为执行进程中断后的重新调度留下通道。不过,重新领到作业之后是否会重复调用供应商、重复生成文件,还需要围绕具体副作用验证。
生成之后,给人工修改留出位置
识别结果里的产品名可能需要修改,一句译文也可能要拆成两段。Web 侧有修改分段、合并、拆分和单段重新配音的调用入口。
修改配音文本时,模型会增加 scriptVersion,把音频标为 OUTDATED,并设置 dirty。模型方法本身没有调用 TTS,保存修改和生成声音是两个操作。合成完成后,audioScriptVersion 记录音频对应的文案版本,音频状态变为 READY。
单段合成失败有分段级错误状态,工作流的对应失败分支保留整个任务继续编辑的空间。最终合成的 Handler 会检查分段的 dirty 标记和音频是否缺失,需要时先补充配音,再交给合成器。
当前修改字幕文本也会把分段标为 dirty。四种文本分开保存之后,重算范围仍要继续看后续处理逻辑,不能仅凭字段独立就判断哪些操作一定不会触发配音。
接入多家语音服务,业务层调用什么
不同供应商的音色标识、参数和返回方式各有差异。项目用接口与路由组织具体实现,让业务流程通过统一入口调用。
下面是语音合成的接口节选,依赖项目中的 SpeechSynthesisOptions,不能单独运行:
java
public interface ProviderSpeechSynthesizer {

    String provider();

    byte[] synthesize(String text, String voice, SpeechSynthesisOptions options);
}
provider() 标识供应商,synthesize() 接收文本、音色和选项,返回音频字节。选项包含模型、输出格式、语言和语速等参数;TTS 路由层根据供应商选择具体实现。
ASR 则要处理异步提交与结果查询。当前路由会把供应商标识带进返回的任务 ID,查询时再解析标识,定位对应实现。ASR 的提交链与 TTS 路由采用不同策略,参数支持和异常处理仍需到各自实现里核查。
浏览器和服务端各做一部分媒体处理
浏览器媒体工具使用 ffmpeg.wasm,封装了引擎加载、文件写入、命令执行与结果读取。任务结束时清理输入和输出文件,释放引擎时回收 Blob URL。多线程模式会检查 crossOriginIsolated 和设备并发能力。
格式转换、裁剪等操作可以在浏览器内处理,运行表现受设备资源和浏览器环境影响。视频翻译的最终合成有服务端 FFmpeg 实现,用来组合视频、配音片段、字幕和背景音。本地媒体工具与完整翻译流程各有分工。
第一篇先讲结构,效果留给实际素材
这篇记录的是当前源码里的实现结构。识别效果、配音质量和处理耗时,还需要按具体素材评估:产品名是否正确,译文是否适合朗读,配音长度是否合适,字幕能不能在对应时间内读完。
服务超时、进程中断和用户连续编辑时的行为,也需要实际运行记录。代码里有重试与恢复入口,不代表这些场景已经全部验证完成。后续实战文章会附上环境、操作步骤和结果。
这个系列接下来可以从浏览器媒体处理、多家 TTS 接入、视频翻译阶段推进和 MySQL 队列里选更小的题目展开。第一篇先把整体关系交代清楚,后面的代码和实验才有上下文。
项目入口:Vimorph。后续继续记录具体实现与验证结果。