我在写一个开源的 Mac 歌词软件 Lyrimuse:识别你正在放的歌,把逐字歌词显示在桌面、菜单栏、刘海下面或者一个完整的歌词窗口里。做到后来发现,显示反而是简单的部分,最花时间的是另一件事:找到的歌词,到底是不是你正在听的这一版。
这篇讲我是怎么解决这个问题的。
为什么「拿第一个不为空的」不行
大部分歌词工具的做法差不多:按顺序问几个歌词源,网易云没有就问 QQ 音乐,QQ 音乐没有就问下一家,拿到第一个不为空的就用。
问题在于,同一首歌在歌词源里通常不止一个版本:录音室版、现场版、伴奏版、剪辑版、混音版、重新灌录的英文版。按歌名和歌手去搜,搜出来的第一个往往不是你在放的那一版。
最典型的是现场专辑。你放的是演唱会版,拿到的是录音室版的词,前几句看着没问题,等到观众欢呼、歌手说几句话,后面就整段对不上了。
所以 Lyrimuse 换了个思路:十二个源一起查,每份结果都打分,选分最高的。
整体流程
markdown
本地曲目信息(歌手 / 歌名 / 专辑 / 时长)
        │
        ▼
十二个源并发查询(网易云、QQ、酷狗、酷我、咪咕、Musixmatch、LRCLIB、
LyricFind、Deezer、AMLL、汽水音乐,连了账号的话还有 Apple Music)
        │
        ▼
资格审核:不合格的直接否决
        │
        ▼
逐项打分,再做几步需要全体候选一起比较的检查
        │
        ▼
选最高分,把整个过程记下来
引擎是 Go 写的,在后台跑;App 是 Swift 写的,只负责显示。
第一关:资格审核
有些结果连打分的资格都没有,直接否决:
- 不是真的带时间轴的歌词:纯文本,或者带时间戳的行太少。
- 语言明显不对:歌手和歌名都没有汉字,歌词却一大半是汉字。
- 只有署名:整份只有作词、作曲、编曲,或者就是一行「纯音乐,请欣赏」。
- 提不出最后一句的时间:后面的时长判断没法做。
还有一道针对逐字歌词的检查。有的源会返回一份只覆盖前面一小段的逐字时间轴,看起来是逐字歌词,后面全是空的。实测这种残片只覆盖到全曲的两成左右,正常的逐字歌词最低也有八成五,所以逐字时间轴结束得太早(不到整首歌词一半)就当它没有逐字。
第二关:打分
下面是现在的打分表。每一项分值都是拿真实曲库回放、对比结果定下来的,后面会拿几首歌举例。
| 看什么 | 分值 | 说明 |
|---|---|---|
| 时长吻合 | +100 到 +300 | 歌词最后一句的时间跟歌曲时长比,越接近分越高。偏差超过 25% 不给分 |
| 歌词比歌还长 | -700 | 最后一句比歌曲结束还晚 5 秒以上,物理上不可能是同一版 |
| 时长明显不符 | -500 | 最后一句离歌曲结束差得太远 |
| 源自报的曲长不符 | -400 | 有的源会告诉你它那首歌多长,跟本地差 12% 以上就扣 |
| 有逐字时间轴 | +400 | 能做逐字高亮 |
| 跟当前播放器同一家 | +250 | 在 QQ 音乐里放,就偏向 QQ 音乐的词,因为时间轴最可能对得上 |
| 版本标记不一致 | -600 | 歌名、专辑名里的 Live、Remix、伴奏、Edit、English ver. 这类标记两边对不上 |
| 另一场演出 | -600 | 两边都是现场版,但演唱会的名字完全不同 |
| 时间轴整体错开 | -600 | 跟其它几家对齐的歌词比,整份都提前或推后了几秒 |
| 间奏里多出一段 | -600 | 别家在这里都是十几秒的空白,它却塞了好几句词 |
| 专辑吻合 | +40 到 +150 | 只加不减,专辑对不上不算负证据 |
| 歌名吻合 | +30 到 +120 | 完全一致最多,去掉括号后一致、双语名一致的少一些 |
| 几家内容一致 | +150 / +250 | 一家或两家以上给出的正文基本一样,说明这份可信 |
| 带翻译 / 读音 | +50 / +30 | 同样对得上时,优先选能显示翻译的 |
| 行数 | 每行 +1,最多 200 |
「几家内容一致」用的是正文的 3-gram 相似度,超过 0.55 算一致。这里有个细节:有些源其实共用同一份数据,比如 Deezer 和 LyricFind 背后是同一个歌词供应商,这种只能算一家,不然它俩互相印证,平白多拿一份分。
三个例子:打分是怎么起作用的
1. 原版和单曲剪辑版
Prince 的《Diamonds and Pearls (2023 Remaster)》,本地时长 283 秒。候选里有两份看起来都很像(下表是一次实际评估的分项记录):
| 候选 | 时长 | 逐字 | 行数 | 专辑 | 歌名 | 几家一致 | 版本标记 | 合计 |
|---|---|---|---|---|---|---|---|---|
| QQ 音乐《Diamonds and Pearls (2023 Remaster)》 | +291 | +400 | +118 | +150 | +120 | 0 | 0 | 1079 |
| 酷狗《Diamonds And Pearls (Edit)》,260 秒 | +299 | +400 | +53 | 0 | +60 | +250 | -600 | 462 |
酷狗那份是单曲剪辑版。只看时长,它反而更接近,而且还有另外两家的正文印证它。决定胜负的是版本标记:本地没有「Edit」,候选有,扣 600。
这里「edit」只按整词匹配,因为它是「edition」的前缀,按子串匹配会把所有 Deluxe Edition 的专辑都当成剪辑版。另外,「Remaster」刻意不算版本标记:重新母带处理的还是同一次录音,时间轴是同一条。
2. 日文原曲和英文版
優里的《ドライフラワー》,有一个重新灌录的英文版。原曲 285.6 秒,英文版 285.7 秒,只差 0.1 秒,照着原曲编曲重录的另一语种版本,时长天然几乎一样,时长这一项完全分不开它俩。
能分开它们的是版本标记:歌名里的「English ver.」跟「粤语版」「国语版」「日语版」「韩语版」一样,算作语种版本。本地是原曲、候选标着英文版,扣 600,日文原曲那份就胜出了。
3. 同样是现场版,但不是同一场
方大同《公园 (Live版)》,候选里有两份现场版:一份是这张现场专辑的,一份是另一场演唱会的。两边都标着 Live,版本标记一致,上面那条检查不会起作用。
所以有专门的「另一场演出」检查:本地专辑名本身带现场标记,候选也是现场录音,两边去掉歌手名和「Live」「演唱会」这类通用词之后,剩下的身份词(场馆、巡演名、年份)完全没有交集,就判定为另一场,扣 600。四个条件缺一不可,只要两边有一个共同的身份词,就当作同一场,不会误伤。最后选中的是 QQ 音乐那份同一场的,1090 分。
两个设计取舍
不给任何歌词源固定加分
很容易想到的做法是给几个「质量好」的源固定加点分。我拿 250 首歌做过对照:这样的固定加分改变了 69 首歌的选择,其中没有一次是把错的改成对的,反而有 6 次把对的改成了错的。所以现在不设任何固定偏好,同分时按固定顺序决胜。
唯一保留的偏好是动态的:你在哪个播放器里放,就偏向那家的歌词(+250)。理由不是那家质量好,而是它的时间轴跟你的播放器最可能对得上。
重扣但不否决
除了第一关的否决,其它扣分再多,分数最低也只到 1。也就是说,一份存疑的歌词也比没有歌词强:只有在找不到更好的时候,它才会被用上。
第三关:选出来,并且能查
选最高分的那份,歌词、翻译、读音、逐字时间轴都跟着它走,不会这家拿正文、那家拿翻译拼在一起。
每一轮评估都会记下来:这次问了哪些源、谁应答了、每份候选每一项得了多少分、因为什么被否决,以及最后谁赢了。App 的歌词管理窗口里有个「解析决策」面板,直接把这份记录摊开给你看。
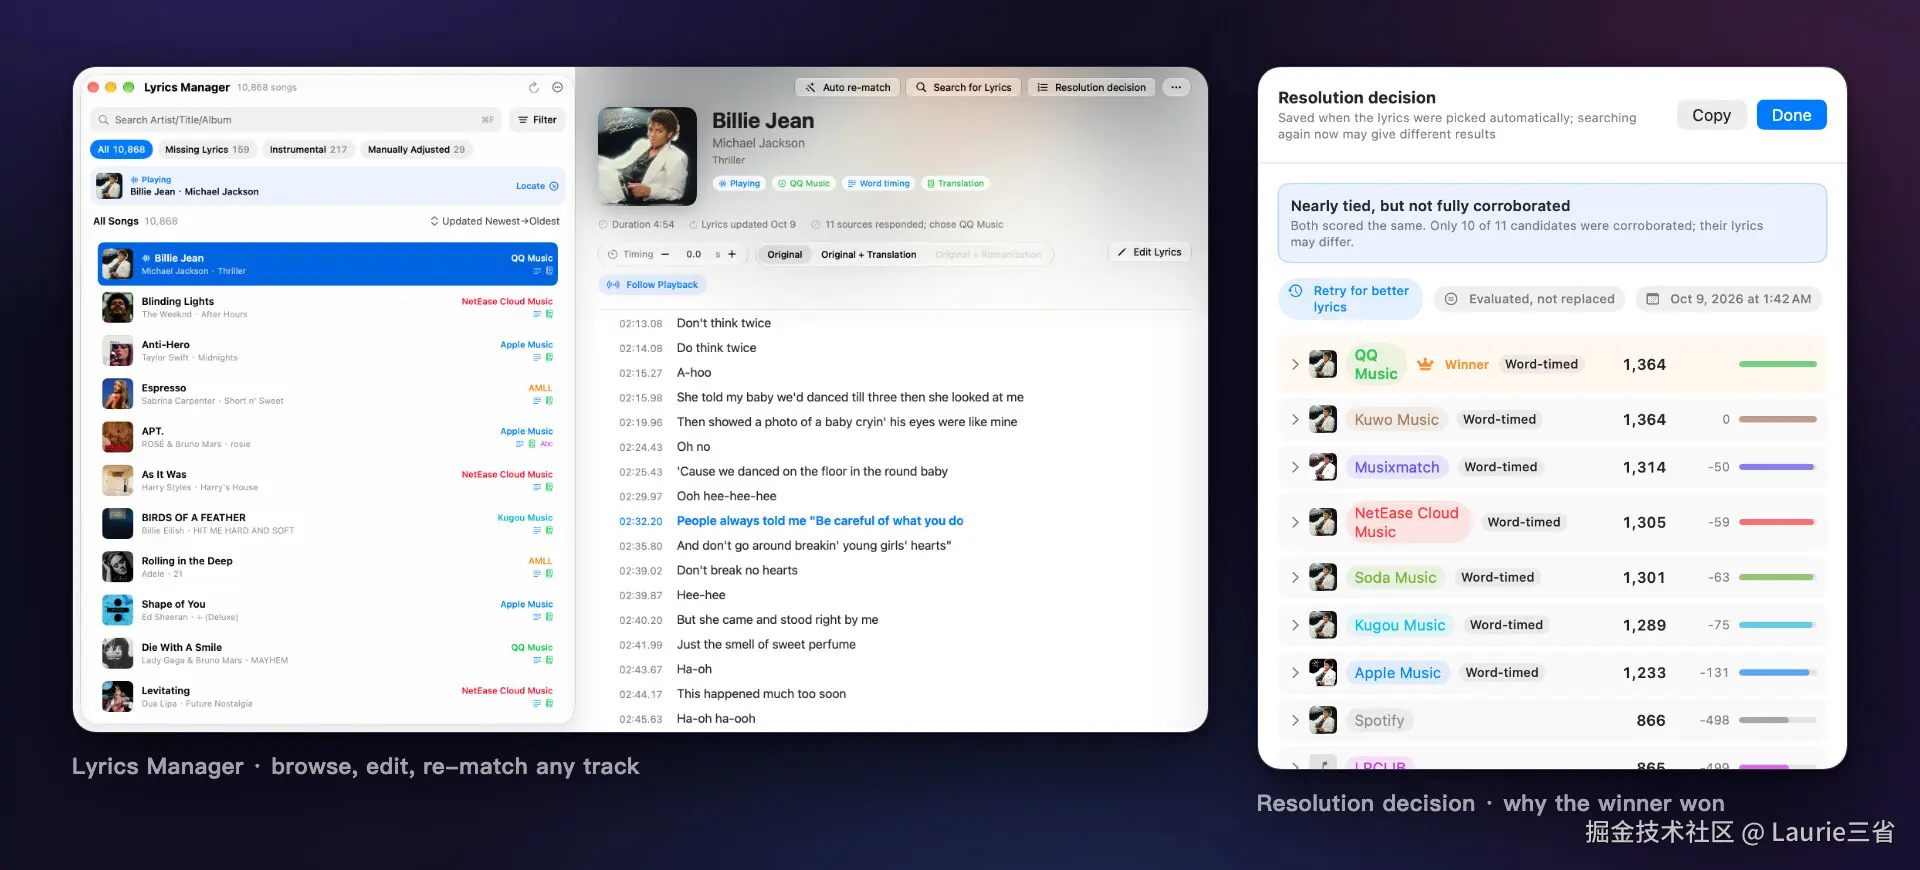
这个面板最大的用处是查错:觉得哪首歌配得不对,打开面板就能看到赢的那份赢在哪一项、对的那份输在哪一项,不用猜。
改规则之前,先过回归测试
打分规则会一直调整,最怕的是改好一首歌、改坏另外三首。所以仓库里有一套歌词搜索的回归样本:每个样本是一首真实曲目各个源的原始应答,加上已经确认正确的结论。样本覆盖了华语、英文、日文、韩文、粤语、语种版本、同场和另一场现场版、版本标记错配、多歌手合唱、各类否决、纯音乐等情况。
两个细节:
- 正确答案不能直接信缓存。每个样本的冠军都要通过一组独立的判断:歌名对得上、版本一致、自报时长偏差在 3% 以内、至少有另一个源印证正文。缓存里那份只是旁证。
- 样本里的歌词正文是置乱过的。真实歌词放进 git 仓库等于再分发,所以采集时把正文做了一次一一对应的字符替换,时间戳、标点、署名行原样保留,保证打分用到的特征替换前后完全一样。写入前会拿替换前后的打分结果做对比,有一项不一样就拒绝入库。
配合打分的几个设置
- 匹配算法:默认「智能」,就是上面这套打分;也可以改成「顺序优先」,不打分,按你排的顺序用第一个有结果的源。
- 随匹配算法更新重新选择:新版本改了打分规则以后,在后台把已经找到的歌词重新评估一遍,有更合适的就换上。
- 锁定手选歌词:你自己从搜索结果里挑的那份,以后的自动匹配都不会换掉它。
最后
Lyrimuse 免费开源(GPL-3.0),macOS 14 及以上,支持 Apple Music、Spotify、网易云音乐、QQ音乐、酷狗音乐、汽水音乐、KKBOX、Amazon Music 和 Kaset,浏览器里的 YouTube Music、Spotify 网页版也行。打分的代码在仓库的 lyrimuse-engine 目录下。
如果你遇到配错的歌,欢迎在 GitHub 上提 issue,附上「解析决策」面板里的记录,对我来说就是下一条规则的来源。