LRU算法
一、1.什么是LRU算法?
LRU算法(Least Recently Used)是一种替换最近最少使用的页面置换算法,在计算机内存管理中经常使用。它的基本思想是将最近没有被使用的页面从内存中淘汰出去,留下最近被使用的页面在内存中,以达到缓解内存紧张的目的。
算法原理:
LRU算法是一种基于时间局部性原理的页面置换算法,其核心思想是淘汰最近最少使用的页面,仅保留最近被使用的页面。
当需要装入一个新的页面时,LRU算法会检查现有内存块中是否有该页面,如果有,则直接使用;如果没有,则需要淘汰最近最少使用的页面,并将新页面装入内存。
具体来说,LRU算法通过维护一个"页面访问历史链表"来跟踪内存中的页面使用情况。其中,链表头表示最近被使用的页面,链表尾表示最近未被使用的页面。当需要淘汰页面时,LRU算法会选择链表尾的页面进行淘汰。
举个简单的例子,安卓手机都可以吧软件放在后台运行,比如我先后打开了"设置"、"手机管家"、"日历",那么现在他们在后台排列的顺序是这样的:
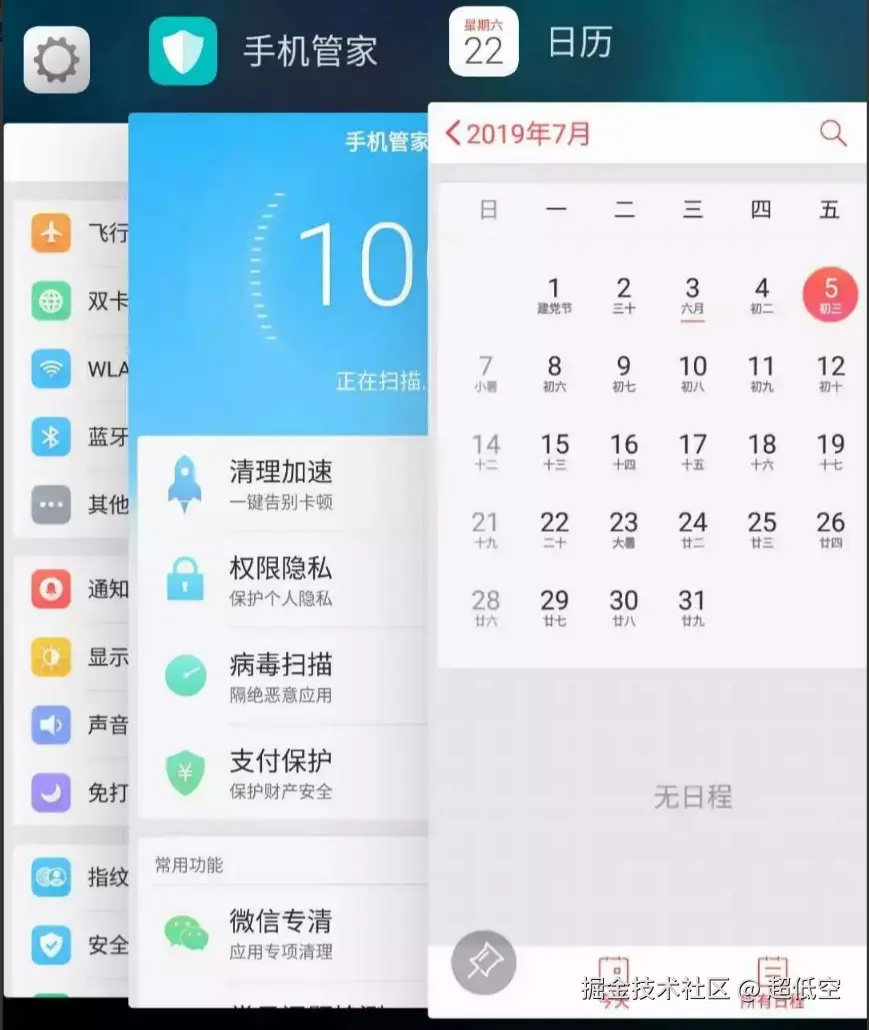
但是这时候如果我访问了一下"设置"界面,那么"设置"就会被提前到第一个,变成这样:
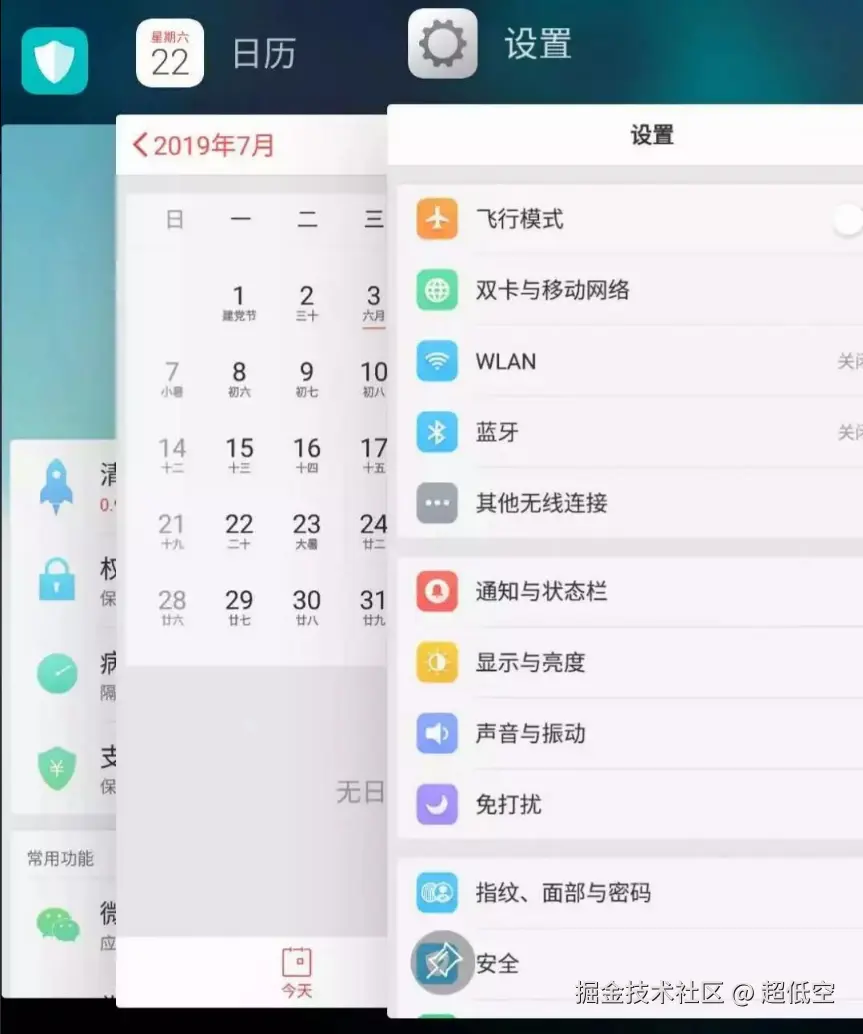
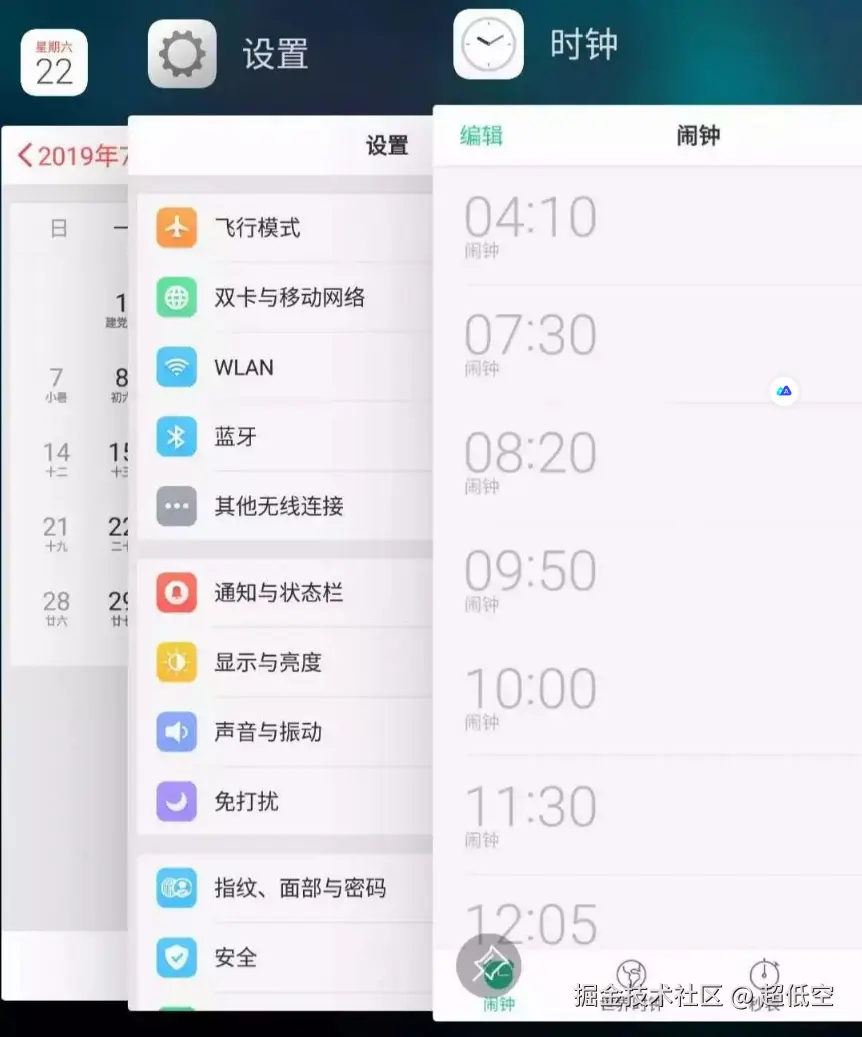
假设我的手机只允许我同时打开3个应用程序,现在已经满了。那么如果我新开了一个应用"时钟",就必须关闭一个应用为"时钟"腾出一个位置,那么关闭哪个呢?
按照LRU的策略,就关最底下的"手机管家",因为那是最久未使用的,然后把新开的应用放到最上面:
现在你应该理解LRU策略了,当然还有其他缓存策略,比如不要按访问的时序来淘汰,而是按访问频率(LFU策略)来淘汰等等,各有应用场景。
二、LRU算法设计原理:
我们可以总结出 LRU算法数据结构必要的条件:查找快,插入快,删除快,有顺序之分。
因为必须有顺序之分,以区分最近使用的和久未使用的数据;而且我们要在 cache 中查找键是否已存在;如果容量满了要删除最后一个数据;每次访问还要把数据插入到队头。
那么,什么数据结构同时符合上述条件呢?
1、哈希表查找快,但是数据无固定顺序;
2、链表有顺序之分,插入删除快,但是查找慢。
所以结合一下,形成一种新的数据结构:哈希 链表。
LRU 缓存算法的核心数据结构就是哈希链表,双向链表和 哈希表 的结合体。这个数据结构长这样:
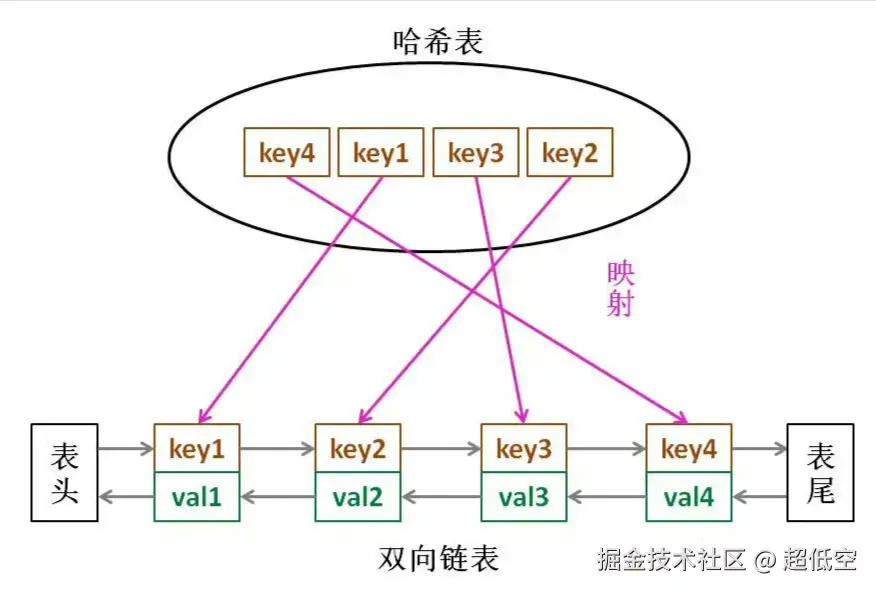
借助哈希表赋予了链表快速查找的特性嘛:可以快速查找某个 key 是否存在缓存(链表)中,同时可以快速删除、添加节点。
举例插入(set)
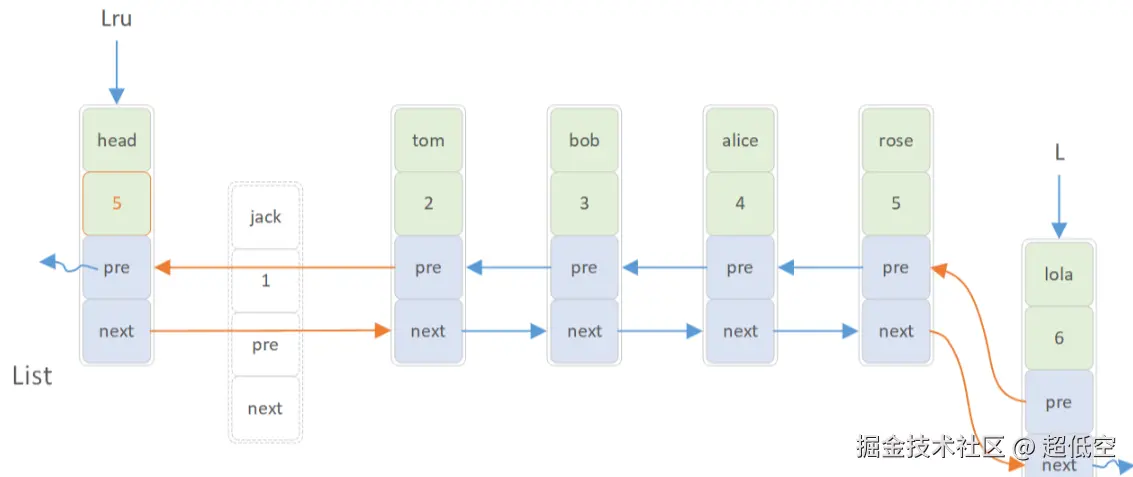
L_LEN: 快速表的最大长度
此处涉及三点:
(1)List 的长度 < L_LEN 时,尾部的插入,这个没什么好说的,创捷节点,指针连接即可;
(2)但当 List 的长度 > L_LEN 时,尾部插入的同时,还需要释放第一个节点;
(3)List 插入或删除的同时,还需要在哈希表中进行同步操作。
插入操作如图所示,
第(1)种只需要尾端插入即可。
第(2)种则还需释放第一个节点。
AndroidX之LruCache库内部也是使用LinkedHashMap对数据进行管理:
arduino
public class LruCache<K, V> {
    private final LinkedHashMap<K, V> map;
    /** Size of this cache in units. Not necessarily the number of elements. */
    private int size; // 当前大小
    private int maxSize; // 最大容量
    private int putCount; // put次数
    private int createCount; // 创建次数
    private int evictionCount; // 回收次数
    private int hitCount; // 命中次数
    private int missCount; // 未命中次数


    public LruCache(int maxSize) {
        if (maxSize <= 0) {
            throw new IllegalArgumentException("maxSize <= 0");
        }
        this.maxSize = maxSize;
        //accessOrder为true,即按访问排序
        this.map = new LinkedHashMap<K, V>(0, 0.75f, true);
    }

}
LinkedHashMap
LinkedHashMap继承自HashMap,它的多种操作都是建立在HashMap操作的基础上的。同HashMap不同的是,LinkedHashMap维护了一个Entry的双向链表,保证了插入的Entry中的顺序。这也是Linked的含义。结构图如下:
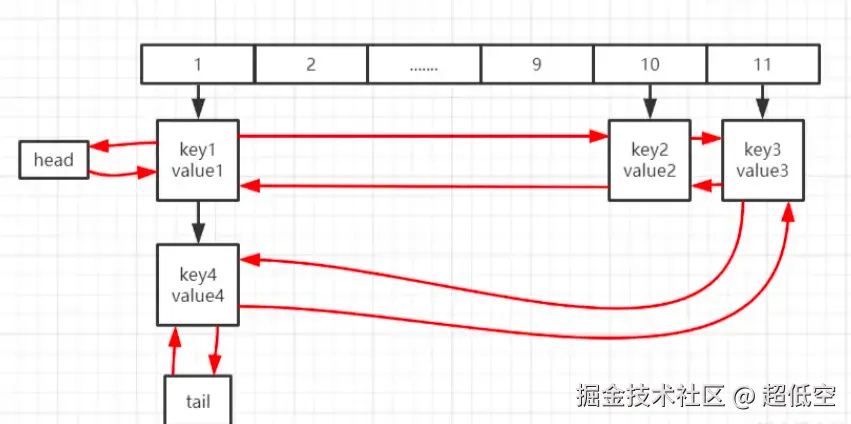
插入顺序为key1,key2,key3,key4,那么就会维护一个红线所示的双向链表。
可以说,LinkedHashMap=HashMap+双向链表利用LinkedHashMap的特点,既可以很方便的实现LRU算法,又可以高效的访问元素,即每次命中元素,都将该元素置于链表尾部(先删除,再添加),这样就能保证头部元素是最久未使用的元素,一旦缓存空间占满,则可替换掉头部元素,而LinkedHashMap也为我们提供了标志位accessOrder和removeEldestEntry(eldest)方法来实现LRU算法。
- 如果accessOrder为true的话,则会把访问过的元素放在链表后面,放置顺序是访问的顺序
removeEldestEntry(eldest)供用户覆写,如果返回true,则删除最久未使用的元素
三、LRU算法流程:
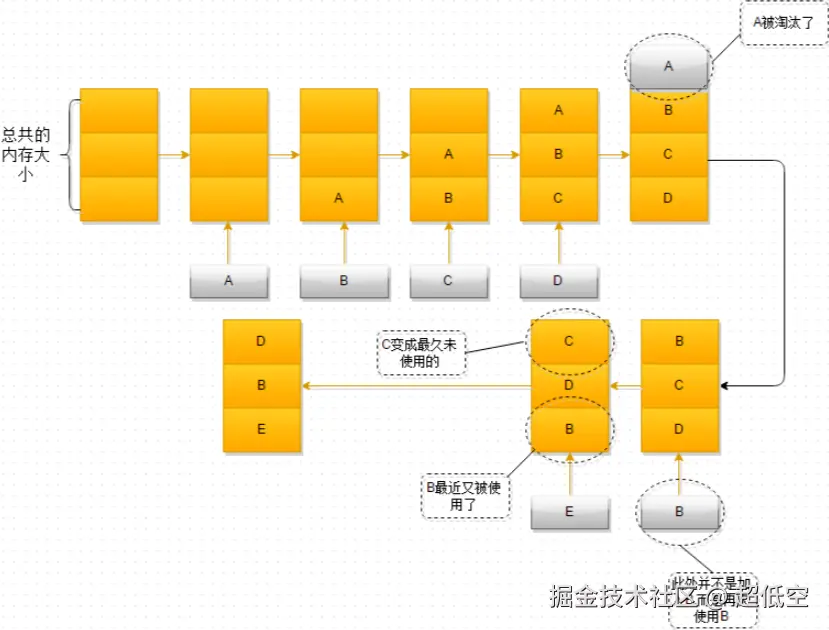
LRU算法的流程可以概括为以下几个步骤:
- 初始化内存页面访问历史链表为空。
- 读取输入的页面请求,检查该页面是否在内存中。
- 如果页面在内存中,则将该页面移到链表头,表示该页面是最近使用的页面。
- 如果页面不在内存中,则淘汰链表尾的页面,并将新页面插入链表头。
- 重复步骤2-4,直到所有页面请求都被处理完毕。
四、LRU算法优点:
- LRU算法能够最大限度地利用内存,因为它仅保留最近被使用的页面。
- LRU算法能够较好地预测未来的页面使用情况,因为它利用了时间局部性原理。
五、LRU算法缺点:
如果一个不是经常使用的数据,偶尔或者周期性的被使用,那么该数据会被加到LRU链表头部,而这种不经常使用的数据,放在链表头部,占用了空间;一直等到LRU淘汰完,才会被剔除链表; 如果这种数据一次性过多,那么链表数据都是这种无用的数据,从而会导致缓存命中率低下,影响系统性能;
六、LRU算法应用场景:
- Web浏览器缓存:在浏览网页时,Web浏览器会默认将最近访问的网页保存在缓存中,以便快速响应用户的后续请求。当缓存空间不足时,可以使用LRU算法清除最近最少使用的缓存。
- 数据库查询缓存:为了加快数据库查询的响应速度,常常会使用缓存技术。当使用LRU算法来替换缓存中的数据时,可以使最常使用的数据保留在缓存中,从而提高数据库查询的性能。
- 图像处理:在进行图像处理操作时,比如图像缩放、旋转等,经常需要对图像进行操作,每次操作需要对图像进行一次读写操作。当内存不足时,使用LRU算法可以将最少使用的图像淘汰,释放出空间给正在处理的图像。
- 垃圾回收器:在Java等语言的垃圾回收算法中,使用LRU算法来优化堆内存的管理。当堆内存不足时,可以通过LRU算法清理最近最少使用的对象,释放内存空间。