ECC:一个Agent操作系统的深度拆解
Claude Code 很好用。用它写代码的人越来越多了。但它有三个问题,用久了都会碰到。
第一,它没有跨会话记忆。今天你把测试命令改成 npm run test:ci,明天开新会话它又敲 npm test。第二,长任务会偏。30 轮工具调用之后,Agent 的注意力已经不在最初的任务目标上了------Transformer 的注意力衰减是物理规律,不是 Claude 笨。Anthropic 的工程师证实过:超过 40 轮对话,模型会产生"幽闭恐惧",开始加速收尾、跳过测试、用 TODO 敷衍。第三,它的代码审查不可靠。LLM 天然会编造问题------它想"帮忙",所以即使代码没问题也会建议"考虑加错误处理"。或者反过来,真问题漏了,假问题报一堆。
社区给出的解决方案之一,是 ECC(Everything Claude Code)。目前 209k GitHub stars,406 个 skills,63 个 agents。但这些数字不重要。重要的是它怎么处理上面三个问题------以及它的设计里哪些值得借鉴的东西。
反幻觉工程:怎么让 LLM 做代码审查不说废话
LLM 做 code review 的致命缺陷是编造问题。你给它一段代码,它天然想"帮忙"------十个发现里七个是噪音。两次之后你就不看了。
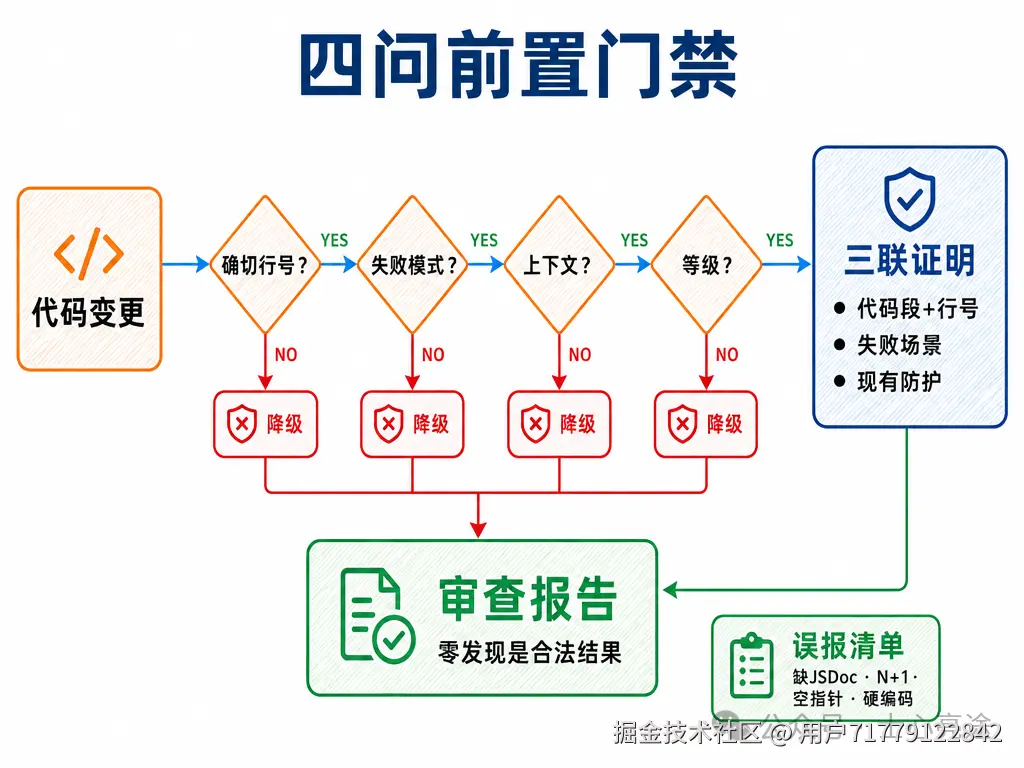
ECC 的 code-reviewer agent 用了一个很硬的解法:在输出层加了一道事实核查门禁。
四问前置门禁
在写任何发现之前,必须回答四个问题。有一个答案是"否",就降级或删除:
-
能引用确切行号?
"认证层某处有问题"直接删掉。模糊发现不具可操作性。
-
能描述具体失败模式?
什么输入→什么状态→什么坏结果。说不出触发条件就是模式匹配,不是审查。
-
读了周围上下文?
调用了谁、谁调用了它、有没有测试。很多表面问题在上一层已经被处理了。
-
严重等级可辩护?
缺 JSDoc 永远不是 HIGH。测试文件里的一个
any永远不是 CRITICAL。等级注水比遗漏发现更快摧毁信任。
然后有一条更极端的规则:零发现是合法结果。
"A clean review is a valid review. Do not manufacture findings to justify the invocation."
代码没问题就说没问题。不要为了证明自己干过活硬编三条建议。LLM 的讨好倾向在这种文化下最坏事------"审查者"必须接受"什么都没发现"是正常产出。
不仅如此,任何标注 HIGH 或 CRITICAL 的发现必须附带"三联证明":精确代码段 + 行号、具体失败场景(输入/状态/结果)、为什么现有防护没拦住它。三缺一就降级。你不能说"这个函数可能空指针"------得指出哪一行、什么条件触发、为什么 TypeScript 的类型守卫没覆盖到。
更狠的是误报清单。ECC 直接列出了 12 种 LLM reviewer 最常犯的错,告诉模型"这些不要报"。比如"考虑加错误处理"------如果 caller 或框架已经处理了。"N+1 查询"------如果循环只迭代 4 个元素。"Math.random() 不安全"------用于动画不是加密。"应该用 TypeScript"------这是 JS 项目。
每一条都来自真实误报。这不是"写更好的 prompt",是从实战中提取的反模式清单。两者的区别:前者是在猜模型怎么想,后者是根据模型实际犯过的错反向约束。
这些规则放在 code review 工具里,但背后有一个通用的原则:给 LLM 加输出约束,不是在 prompt 里写"请谨慎",是给它一道程序化的门禁------先自查,再输出。
本能学习:Agent 怎么从使用中变聪明
Claude Code 原生没有跨会话记忆。今天你纠正了它的命名风格,明天开新会话它又忘了。
ECC 的做法不是存一个设置文件。它建了一套本能学习系统------让 Agent 从你的每一次交互中提取模式。
v1 的方案是用 skills 做观察。问题是 skills 的触发取决于 Claude 自己的判断------触发率只有 50-80%。这意味着 20-50% 的交互根本没被观察到。学习不完整。
v2 做了一个关键切换:改用 Hooks。Hooks 是确定性的------每次工具调用,100% 触发,不管你说了什么、Claude 怎么判断。
完整的数据流是这样的:
bash
你敲命令 → PreToolUse hook 捕获交互 → 写入 observations.jsonl → 后台 Haiku agent 定时分析(不占主会话 token,默认每 5 分钟) → 识别重复模式 → 提取为"本能" → 给信心评分 → 本能聚集 → 进化为 skill / command / agent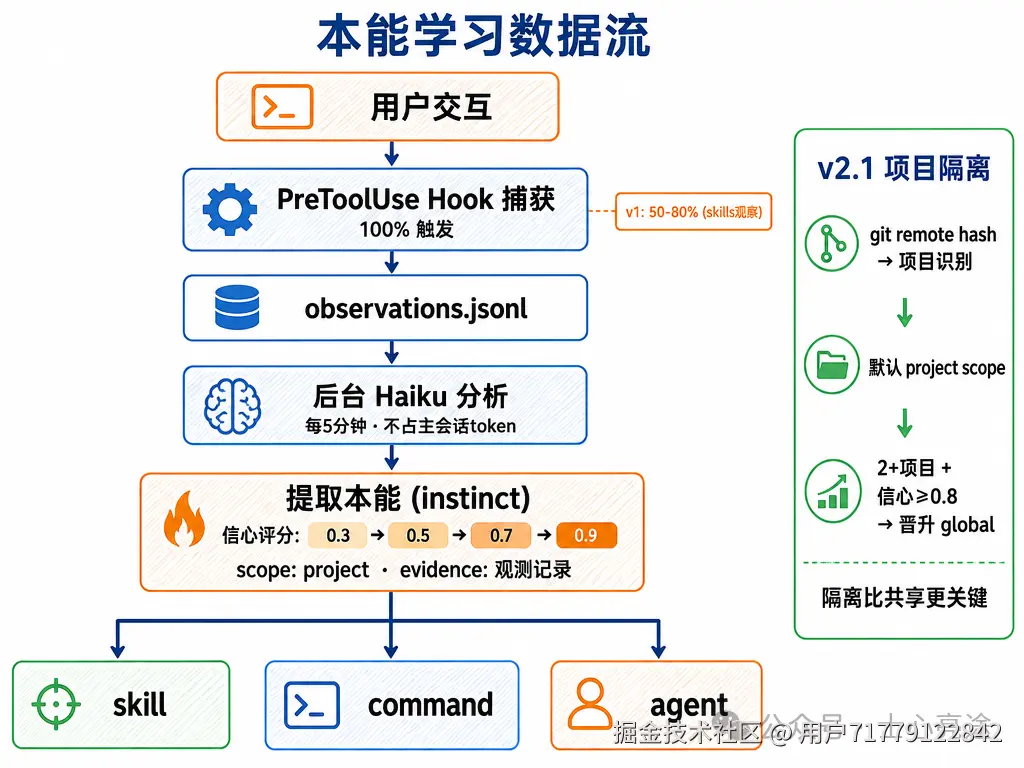
本能学习数据流
举个例子。你在 React 项目里写了 5 次函数式组件,中间有一次你手动把 class 组件改成了函数式。Hooks 捕捉到这些交互,后台 Haiku 分析后发现规律,生成一条本能:
bash
id: prefer-functional-style trigger: "when writing new components" confidence: 0.7 # 0.3试探 → 0.5中等 → 0.7确认 → 0.9锁定 scope: project # 只在当前项目生效 evidence: - Observed 5 instances of functional component usage - User corrected class-based component to functional on 2025-01-15注意三件事。
第一,每一条本能都有证据链。不是说"AI 觉得你喜欢这个",而是"观测到 5 次 + 1 月 15 号那次你亲手改过"。可追溯、可反驳。
第二,信心是动态的。如果你后来开始写 class 组件而不纠正,信心会降。如果持续符合模式,信心会升。0.3 只是试探性建议,0.9 就是默认行为。
第三,v2.1 的默认隔离。v2.0 的本能是全局的------你在 React 项目里形成的"用函数式组件"本能,会被应用到 Python 项目。垃圾。v2.1 通过 git remote URL hash 识别项目,本能默认项目级。同一个本能在 2+ 项目中出现且平均信心 ≥ 0.8,才自动晋升全局。
这个设计原则极其重要但很少有人讨论:在 Agent 学习中,"隔离"比"共享"更关键。 大部分经验是上下文相关的(React hooks 怎么用、Django 目录怎么排),只有极少数通用(始终验证输入、跟着项目现有风格)。默认共享反而会污染。
还有一个细节值得注意:学习数据为什么不放在 ~/.claude/ 下面?因为 Claude Code 的 sensitive-path guard 禁止 agent 写入非标准路径------这是一个安全机制。ECC 把数据放在 ~/.local/share/ 下面绕过了它。这不是投机取巧,是真实世界里的冲突:安全机制和自学习机制会打架。ECC 的做法是不关安全、找合规路径。这个取舍本身就是一个设计决策。
两个支撑系统:自诊断和自动拦截
除了 code review 和自学习,ECC 还有两个让 Agent 更可靠的设计。
Agent Introspection 是一套结构化的自诊断流程。当 Agent 跑飞了------比如不停重试同一个命令、上下文膨胀导致推理退化、连接被拒绝------它不是盲目重试,而是先匹配已知失败模式:
| 症状 | 检查什么 | | --- | --- | | 达到最大工具调用次数 | 检查最近 N 次调用的重复模式 | | 上下文溢出 / 推理退化 | 检查上下文中的重复内容和低信号内容 | | 连接被拒绝 | 验证服务是否活着、端口是否正确 | | 文件写入后消失 | 检查 cwd、git 分支是否漂移 | | 测试修了还是失败 | 隔离确切的失败测试用例 |
核心原则一句话:先验证世界状态,别急着重试。 错误做法是用不同的措辞重试三次。正确做法是:捕获故障→分类→跑一个直接检查→只有检查支持才改方案。这就像开车------发现走错路了,不是猛踩油门换方向,是先停下来看地图。
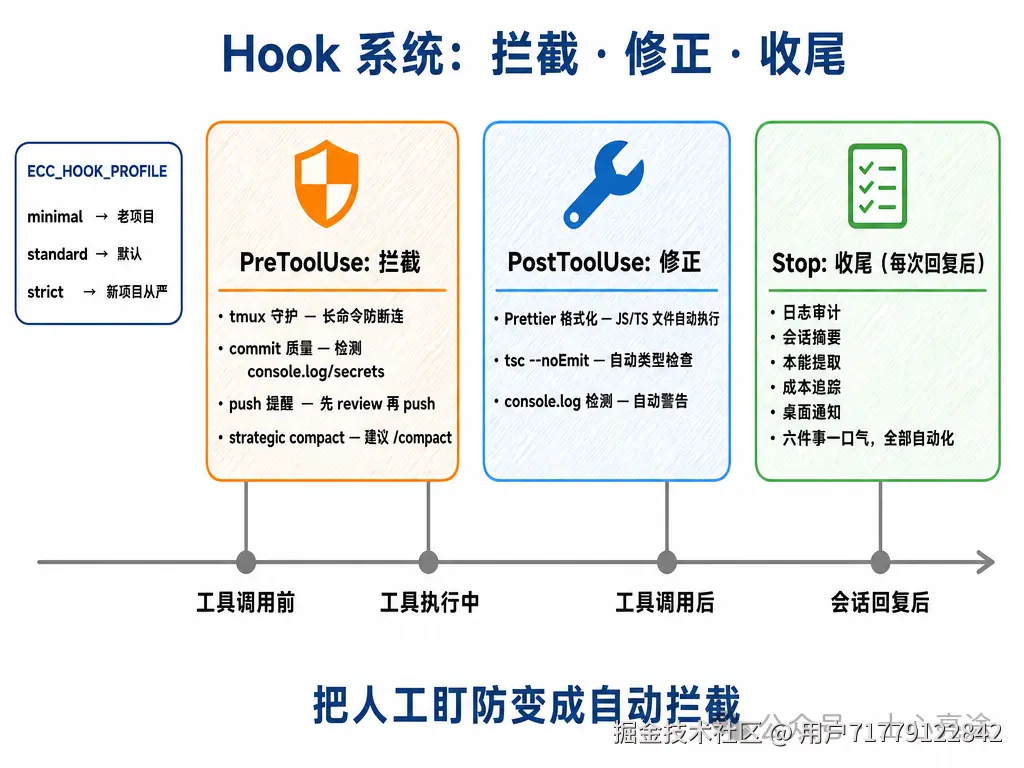
Hook 系统 则承担了"自动化 guard"的角色。通过一个环境变量控制强度------ECC_HOOK_PROFILE=minimal 用于老项目(别烦我)、standard 默认、strict 新项目从严。
具体做了什么?每次 git push 之前自动扫有没有 console.log 残留。每次写入 JS 文件后自动跑 Prettier。每次编辑 .ts 文件后自动跑 tsc --noEmit。长命令自动建议进 tmux 防止断连。这些事让人来记,记不住;让 hook 来守,不会忘。
PreToolUse hook 负责拦截、PostToolUse hook 负责修正、Stop hook 负责每次回复后的收尾------六件事一口气做完:日志审计、会话摘要、本能提取、成本追踪、桌面通知。全部自动化。
Hook系统三分工
回到架构:ECC 到底在解决什么
把前面讲的收起来,ECC 是一个五层结构:
bash
Rules(约束层)→ Agents(执行层)→ Skills(方法层)→ Hooks(拦截层)→ 自学习(进化层)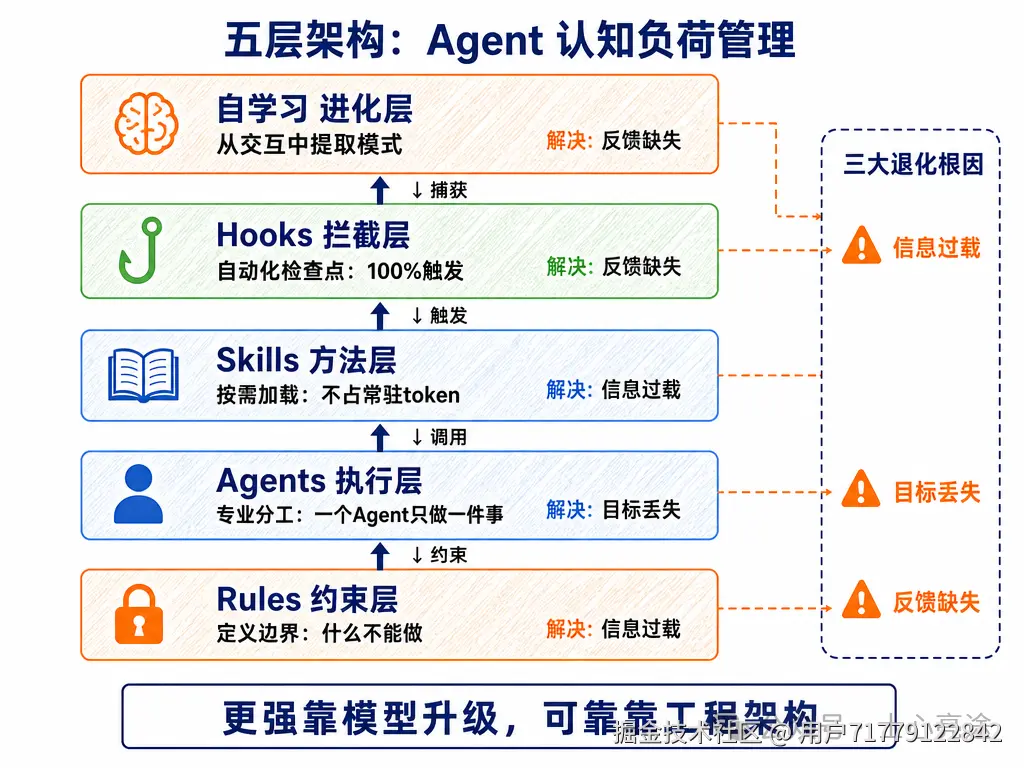
五层架构
这五层解决的是同一个根本问题:Agent 在长任务中会退化。退化的原因有三个:
-
信息过载
:上下文越长,模型注意力越散。Rules 减少决策空间("什么不能做"比"什么能做"更快缩小范围),Skills 按需加载不占常驻 token。
-
目标丢失
:50 轮之后最初的意图模糊了。Agents 把大任务拆成小任务,每个 agent 只盯一件事,互不污染上下文。
-
反馈缺失
:没人告诉它对还是错。Hooks 自动检查关键节点,自学习从每次交互中提取信号。
这三件事,没有一个靠"升级模型"解决。更强的模型靠训练,可靠的 Agent 靠工程。
ECC 还有一个容易被忽略的设计:它的 406 个 skills 不是 Claude Code 专属的。SKILL.md 是最小可移植单元------描述触发条件、工作流和约束,不嵌入任何平台的假设。同一套资产可以在 Claude Code、Codex、Cursor、OpenCode 等 7 个平台上用。这意味着你不会被任何一个 AI 编码工具锁定。今天 Claude Code 跑流程,明天切 Codex,你的规则和方法还在。
ECC 拆完了。你对它的理解是什么?有没有在实际项目中用过、踩过坑?欢迎在评论区聊聊你的使用体验和看法。