先花一分钟搞清楚一件事:一个 Agent 干一次活,内部到底发生了什么。
用户发一句话 → 模型理解意图 → 决定调某个工具 → 工具去查库、调接口 → 结果回填给模型 → 模型再生成答案。中间任何一环都可能翻车。
以前我们做后端,翻车了就是抛异常,try-catch 一兜、打个日志、返回默认值,万事大吉。但我把 Agent 接进生产之后发现,这套"祖传的兜底"突然不好使了------不是语法坏了,是它兜不住 Agent 特有的"错"。
为什么 try-catch 兜不住
因为 try-catch 兜的是异常------那种运行时抛出来的、一眼就知道错在哪的 Exception。但 Agent 的错误往往是"看起来对、其实是错":
- 模型输出的 JSON 缺了个字段;
- 调错了工具;
- 把"退款金额"填成了"订单金额"。
这些在代码层面根本不抛异常。函数正常返回了,返回值也合法(就是个字符串),只是语义错了。你用 try-catch 拦什么?根本拦不到。
Agent 的错,大部分是"无异常的错误"。 这句话我想让你先记住,后面五个模式全是围着它转的。
我用的 5 个兜底模式
1. 不信任输出,先校验再重试
模型输出不可信,就当它是外部输入。工具入参进业务逻辑前,先过 Schema 校验 + 业务规则校验:
java
@Tool(description = "按订单号查询订单摘要")
public OrderSummary queryOrder(@NotBlank @Pattern(regexp = "^[A-Z0-9]{16,24}$") String orderId) {
    if (!orderService.belongsTo(orderId, currentUserId())) {
        throw new BizException("无权查询该订单");
    }
    return orderService.queryByIdAndUser(orderId, currentUserId());
}
校验失败抛异常,让框架把错误回喂给模型,让它换个参数重新试。这就是"校验 + 重试"取代了"裸 catch"。
这里注意:校验本身用的是异常(抛 BizException),但它的目的是让框架接管重试,而不是打个日志就完事。这是和传统 try-catch 最大的区别。
2. 显式 fallback
网络挂了、模型 500 了、上游超时了,这些才算传统异常。但这类异常的正确姿势不是"catch 了打个日志",而是降级:
主模型不可用就切备用模型;工具 A 失败就换工具 B;实在不行,给用户一个明确提示,而不是一句冷冰冰的"系统异常"。
java
try {
    return primaryModel.chat(req);
} catch (TimeoutException e) {
    return fallbackModel.chat(req); // 降级到备用模型
}
3. 超时 + 熔断
模型调用慢起来能把你整个线程池拖死。所以每一步调用都要有显式 timeout,连续失败还要熔断,避免雪崩。
这在普通 RPC 里是标配,但在 Agent 里特别容易被忘------因为默认 HTTP 客户端超时经常是 30 秒甚至更久,一个慢模型就能让整个 Agent 卡住。把模型当成"不可信的下游",该用的治理手段一个都别省。
4. 人机确认
有些操作,参数全对、权限也有,照样不该让 AI 决定------退款、删除、改金额。这类"不确定但影响大"的操作,兜底方式不是 catch,是升级给人:生成一条待确认的审批流,人点了才执行。
5. 记录 + 可恢复
出错了要能追溯、能重放。每次工具调用记下"谁、什么工具、什么参数(脱敏)、结果",失败尤其要记完整。这套审计不只是为了追责,更是为了你能复现和修复。
五道防线是一条有顺序的纵深
五个模式合起来,是有先后顺序的一条防御链,画出来长这样:
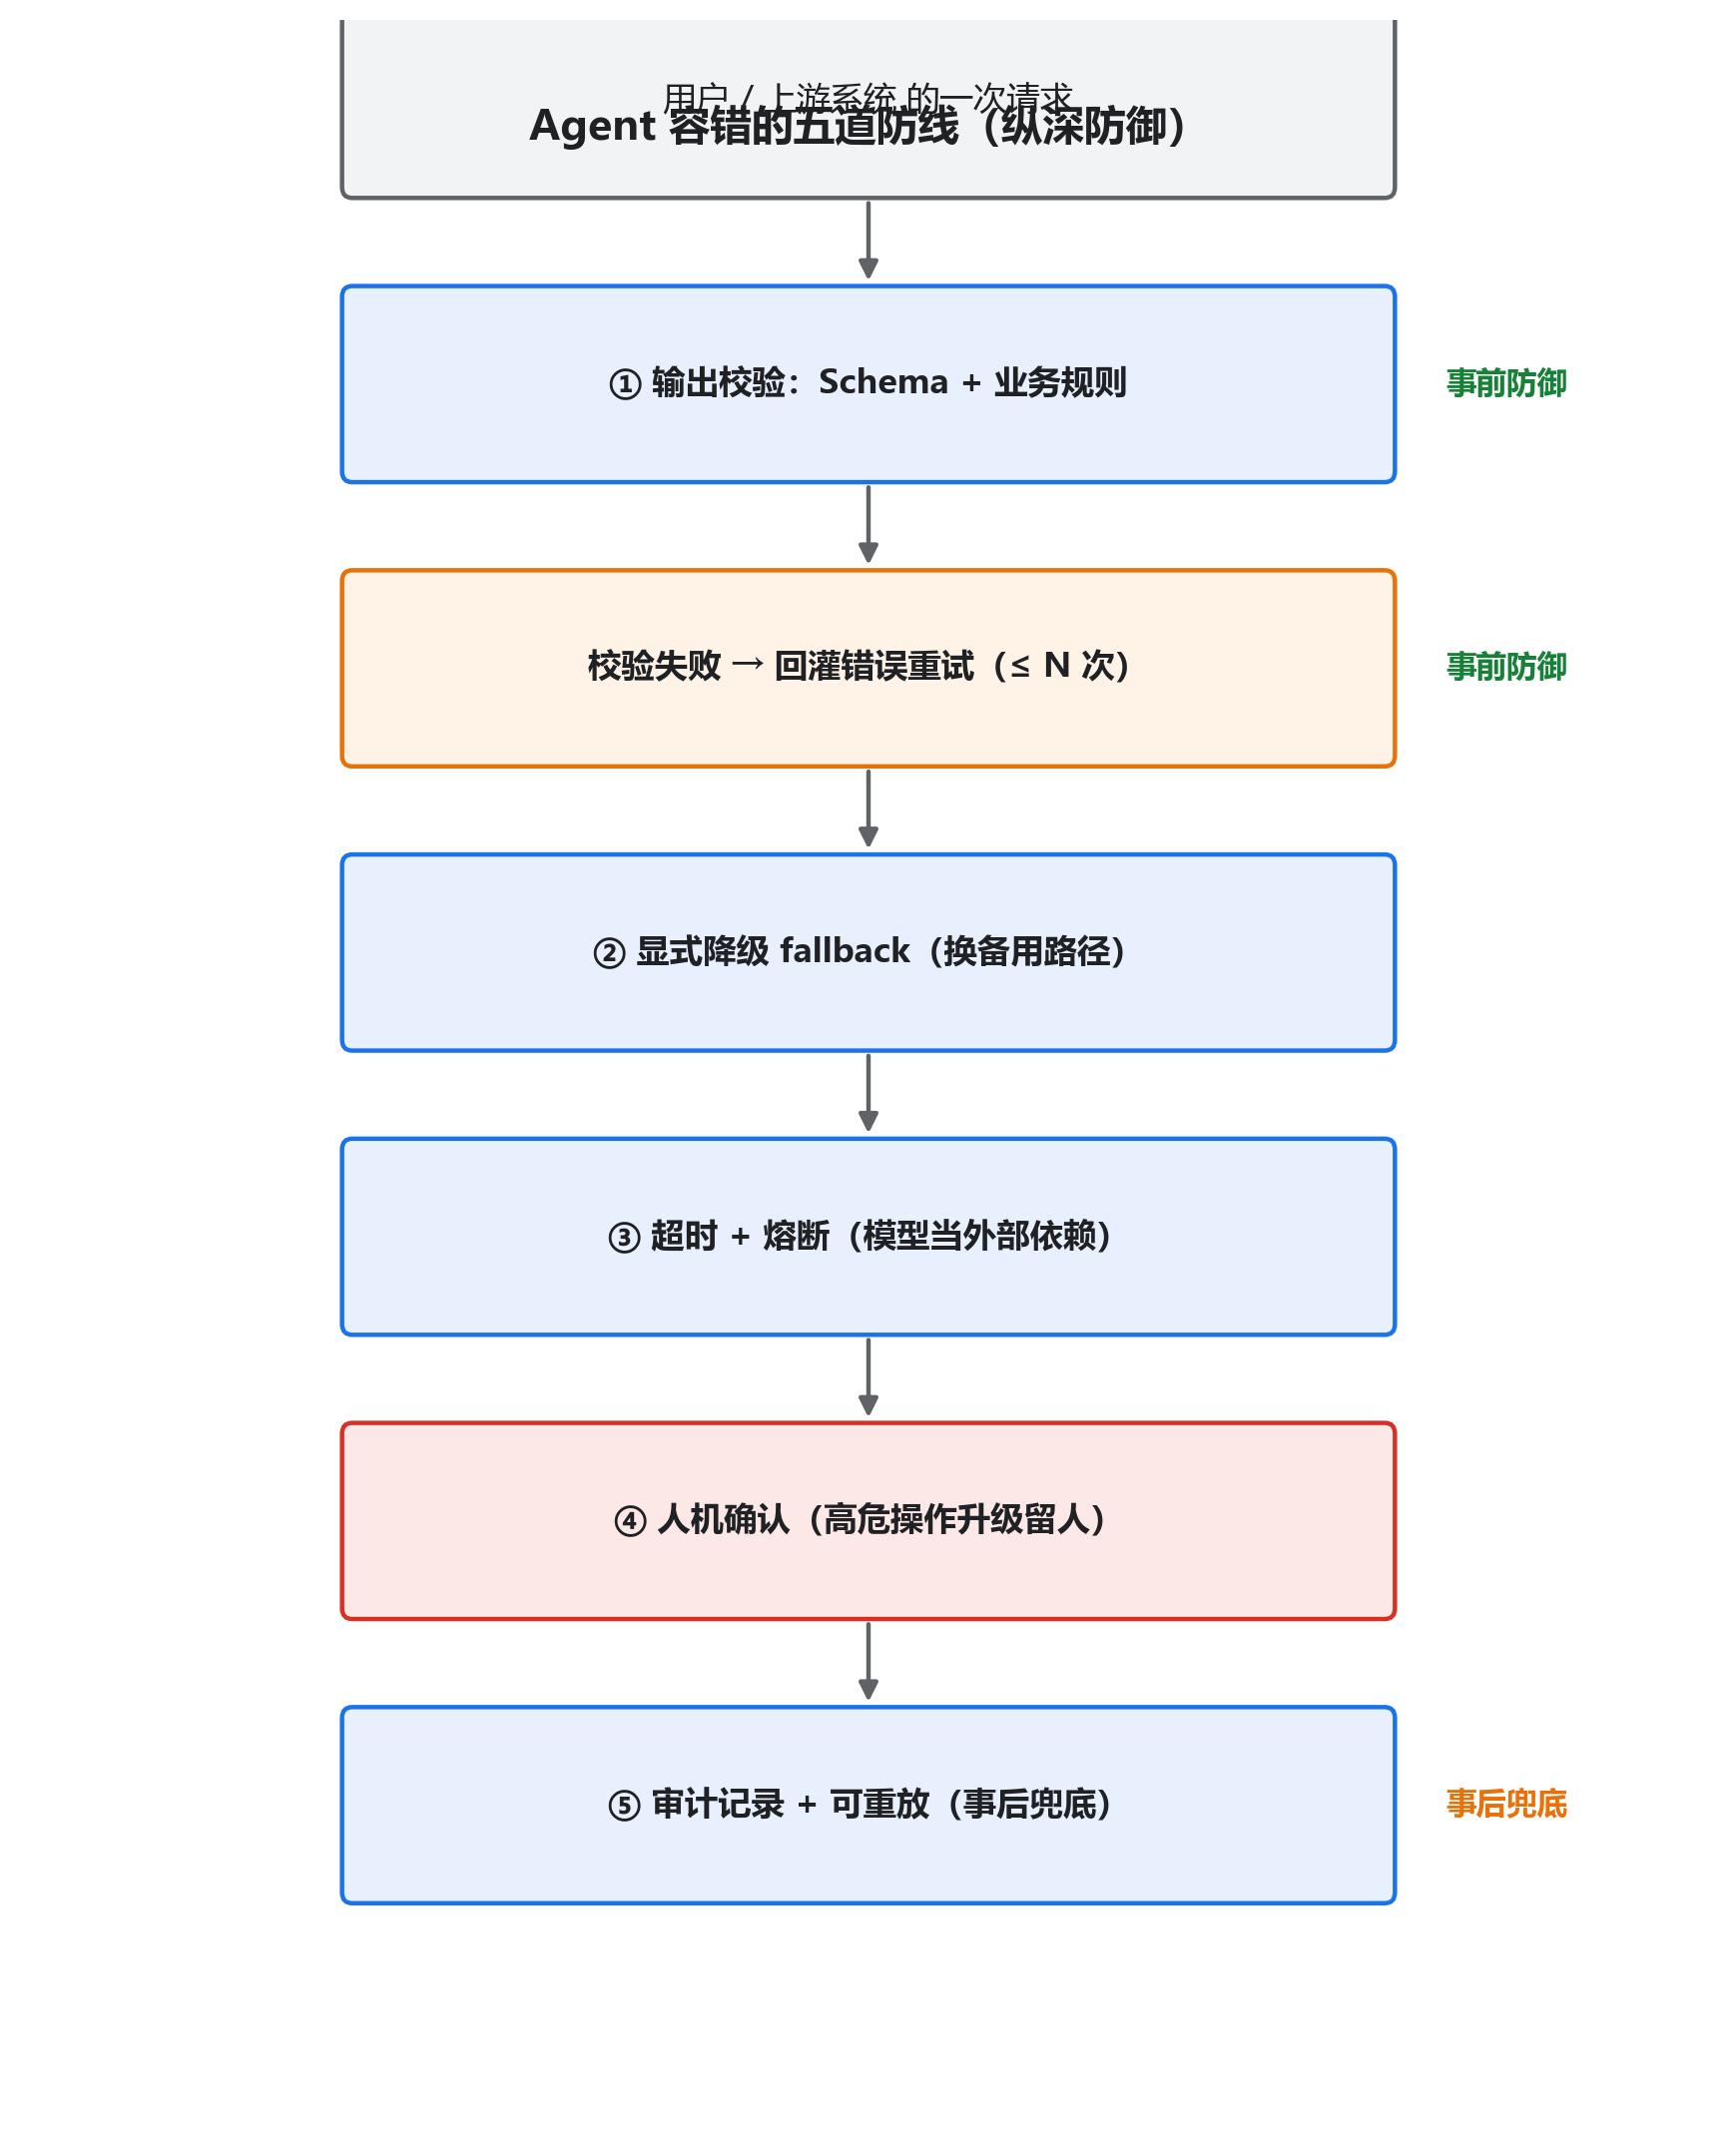
看这张图的关键,是分清事前 和事后:
- 前四道(校验重试、降级、超时熔断、人机确认)是事前防御,目标是把错误拦在执行之前;
- 最后一道(审计、可重放)是事后兜底,目标是让已经发生的错能追回去、能修。
顺序不能乱:只有事前四道都拦不住的时候,才轮到事后那一层来收拾残局。
写在最后
想明白之后,其实就一句话:try-catch 是"事后兜底",Agent 需要的是"事前防御 + 事后兜底"一起上。
try-catch 没死,只是从"唯一的兜底手段"降级成了"兜底的一部分"。真正兜住 Agent 的,是上面这一整套防御纵深。
下一篇聊聊可观测性------真出了问题,你怎么看清 Agent 到底卡在哪一步。